
Kurs
Retrieval Augmented Generation (RAG) mit LangChain
3 Std.
20.5K
Klassische RAG-Systeme rufen Dokument-Snippets anhand semantischer Ähnlichkeit ab – das funktioniert gut bei einfachen Fragen. Wenn Anfragen jedoch Informationen aus mehreren Dokumenten verknüpfen oder über verbundene Konzepte schlussfolgern müssen, stößt die Vektorsuche an Grenzen. Das System holt Fragmente, ohne zu verstehen, wie sie zusammenhängen.
GraphRAG behandelt Dokumente nicht als isolierte Häppchen. Es baut einen Wissensgraphen, der Entitäten und ihre Beziehungen erfasst. Diese Struktur erlaubt es, Verbindungen zu durchlaufen und Fragen zu beantworten, die Informationen aus mehreren Quellen zusammenführen. Es ist eine von mehreren fortgeschrittenen RAG-Techniken, die die Grenzen des einfachen Retrievals überwinden.
GraphRAG ist eine Retrieval-Augmented-Generation-Technik, die Dokumente als Wissensgraphen statt als Vektoreinbettungen darstellt. Anstatt Text in unabhängige Chunks zu zerlegen, extrahiert GraphRAG Entitäten (Menschen, Organisationen, Konzepte, Ereignisse) und deren Beziehungen und organisiert sie zu einer vernetzten Graphstruktur.
Anschließend setzt das GraphRAG-System Community-Detection-Algorithmen ein, um Cluster verwandter Entitäten zu identifizieren, und generiert hierarchische Zusammenfassungen dieser Cluster. Wenn eine Anfrage eintrifft, kann GraphRAG entweder gezielt Entitäts-Nachbarschaften für fokussierte Fragen traversieren oder Map-Reduce auf Community-Zusammenfassungen ausführen, um korpusweite Synthesen zu erzeugen.
Schauen wir uns nun die Mechanik genauer an. So wird klar, warum graphbasiertes Retrieval entstanden ist und welche Lücke es schließt.
Das Hauptproblem bei klassischem RAG ist nicht das Retrieval oder die Generierung, sondern die Repräsentation. Dokumente werden in Chunks zerschnitten, und jeder Chunk wird zu einem isolierten Vektor im Embedding Space. Die ursprüngliche Struktur – Überschriften, Erzählfluss, welche Absätze worauf verweisen – wird plattgewalzt.
Das führt zu Problemen bei Fragen, die Informationen kombinieren müssen. Frag „What are the main themes across these documents?“ und die Vektorsuche liefert Chunks mit dem Wort „themes“ oder verwandten Begriffen. Doch relevante Fragmente zu finden, ist nicht dasselbe wie Muster im Korpus zu verstehen. Das System kann Informationen nicht auf Ebene des Ganzen zusammenführen, weil es nur einzelne Teile sieht – nie das Gesamtbild.
Multi-Hop-Reasoning stößt auf dasselbe Hindernis. Hängt die Antwort darauf, ein Konzept A mit B und dann mit C zu verbinden, ruft traditionelles RAG jeden Chunk unabhängig von der Query-Ähnlichkeit ab. Ist B nicht nahe an der Frage, wird es womöglich gar nicht geholt – die Kette reißt. Das System findet Endpunkte, verpasst aber den Weg dazwischen.
Es gibt zudem ein Missverhältnis zwischen Retrieval und Kontext. Du kannst zwanzig sehr relevante Chunks abrufen – sie alle in ein Prompt zu stopfen, garantiert nicht, dass das LLM sie gut nutzt. Die „Lost in the Middle“-Arbeit zeigt, dass LLMs dazu neigen, Informationen am Anfang und Ende des Kontextfensters zu bevorzugen und das in der Mitte zu übersehen. Mehr Retrieval bedeutet nicht automatisch bessere Antworten.
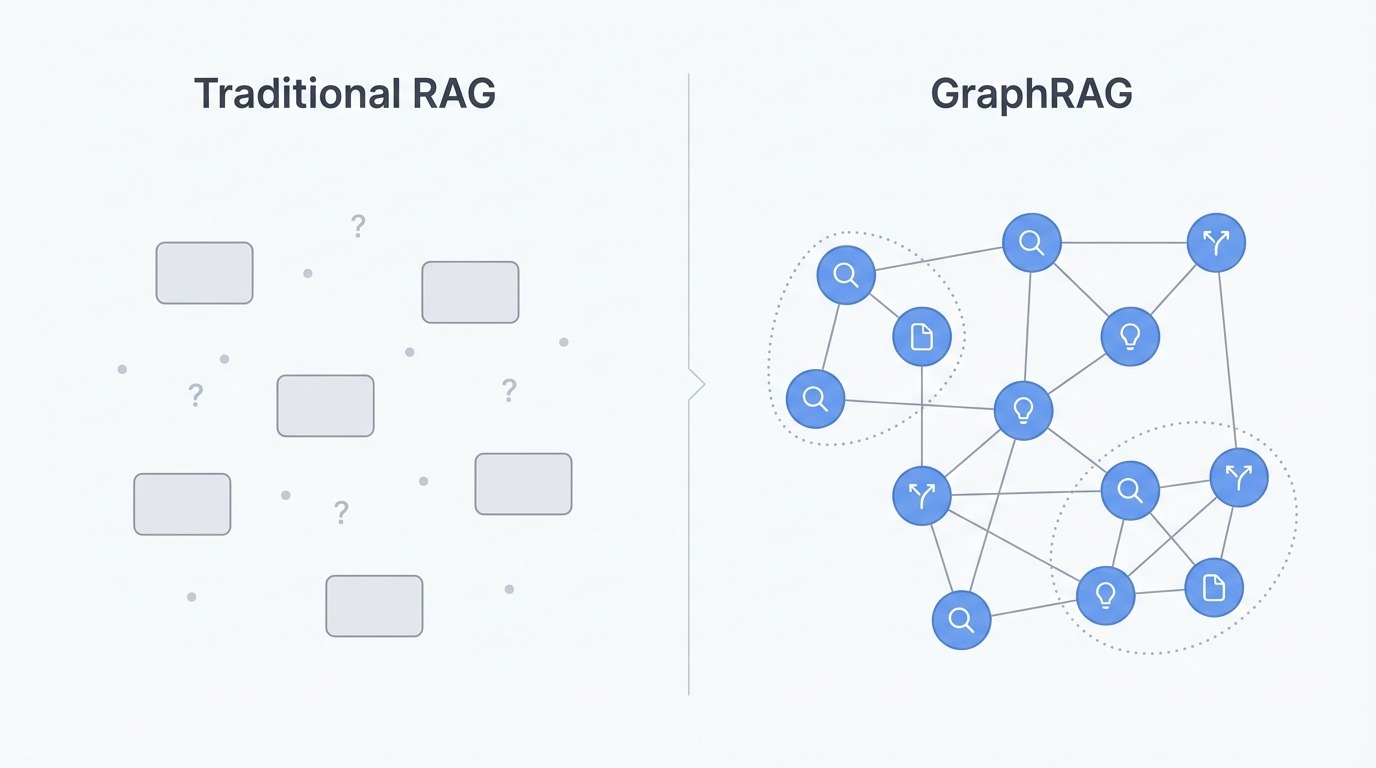
Vergleich von klassischem RAG und GraphRAG. Grafik: Autor.
GraphRAG umgeht diese Grenzen, indem es die Repräsentation grundsätzlich ändert. Statt Chunks baut es einen Wissensgraphen, in dem Entitäten zu Knoten und Beziehungen zu Kanten werden. Personen, Organisationen, Orte, Konzepte und Ereignisse werden mitsamt ihren Verbindungen aus den Quelldokumenten extrahiert. So bleibt die Struktur erhalten, die beim Chunking verloren geht.
Mit dem Graphen wendet das System Community Detection (typischerweise den Leiden-Algorithmus) an, um verwandte Entitäten zu Gruppen zu clustern. Diese Cluster entstehen auf mehreren Ebenen – manche eng und spezifisch, andere breiter und thematischer. Die Gruppierungen ergeben sich aus echten Verbindungen in den Daten, nicht aus Dokumentgrenzen oder Chunkgrößen.
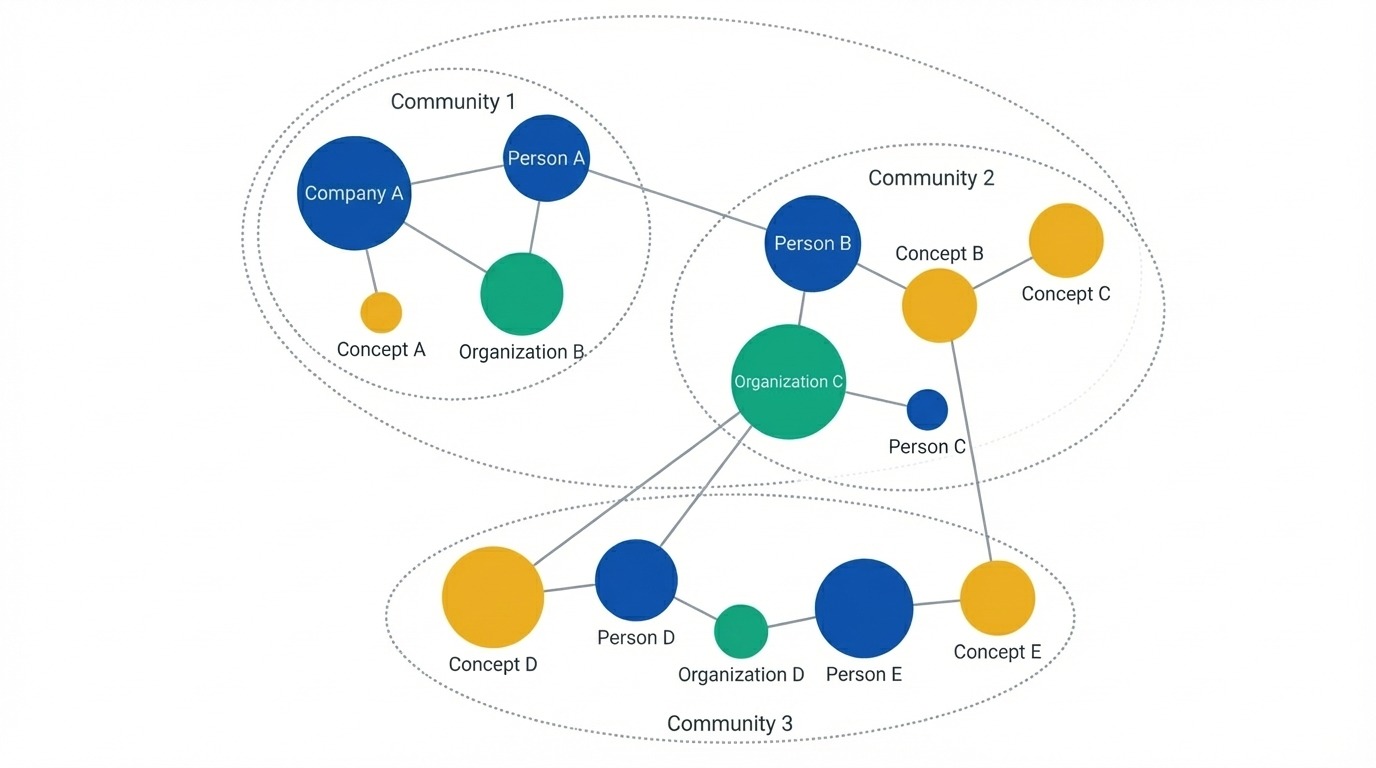
Wissensgraph mit Entitäten als Knoten. Grafik: Autor.
Für globale Fragen erzeugt GraphRAG Zusammenfassungen für jede Community vorab, noch bevor Nutzeranfragen eintreffen. Fragt jemand „What are the main themes?“, durchsucht das System nicht passende Textstellen. Stattdessen führt es eine Map-Reduce-Operation aus: Jede Community-Zusammenfassung liefert eine Teilausgabe auf Basis ihres Graphausschnitts, die anschließend zu einer finalen Antwort zusammengeführt wird. So kann GraphRAG über den gesamten Korpus schlussfolgern, ohne tausende Chunks abzurufen.
Für Multi-Hop-Fragen ersetzt Graph-Traversierung die Ähnlichkeitssuche. Das System kann von Entität zu Entität über Kanten laufen und Konzeptketten folgen, die die Vektorsuche verpassen würde. Wenn A mit B und B mit C verbunden ist, kennt der Graph diesen Pfad und kann ihm folgen.
GraphRAG zahlt sich aus, wenn deine Fragen ein Verständnis über den gesamten Korpus benötigen. Wenn Nutzer häufig nach Themen, Mustern oder Zusammenfassungen großer Dokumentensammlungen fragen, ist graphbasiertes Retrieval klassischen Chunking-Ansätzen überlegen. Gleiches gilt für Domänen mit reichen Entitätsbeziehungen, etwa Organigramme, Zitationsnetzwerke in der Forschung oder Rechtsfälle, bei denen Verbindungen entscheidend sind.
Für einfache Faktenabfragen („What is X's phone number?“) oder kleine Dokumentmengen reicht klassisches RAG und ist günstiger im Betrieb. GraphRAG bringt Mehraufwand bei Indexierung und LLM-Aufrufen – der Nutzen sollte die Investition rechtfertigen. Starte mit Standard-RAG und wechsle zu GraphRAG, wenn du an die Grenzen stößt.
Die Tabelle unten fasst die Trade-offs zusammen. Traditionelles RAG punktet bei Einfachheit und Kosten, während GraphRAG vorne liegt, wenn Synthese oder verbundenes Reasoning gefragt ist.
|
Aspekt |
Klassisches RAG |
GraphRAG |
|
Datenrepräsentation |
Isolierte Text-Chunks als Vektoren |
Wissensgraph mit Entitäten und Beziehungen |
|
Strukturerhalt |
Geht beim Chunking verloren |
Bleibt über Graphkanten erhalten |
|
Globale Anfragen |
Schwach (liefert Fragmente, kann nicht synthetisieren) |
Stark (Map-Reduce über Community-Zusammenfassungen) |
|
Multi-Hop-Reasoning |
Begrenzt (unabhängiger Chunk-Abruf) |
Nativ (Graphtraversierung folgt Verbindungen) |
|
Indexierungskosten |
Niedrig (nur Embeddings) |
Hoch (LLM-Extraktion + Embedding + Clustering) |
|
Abfragekosten |
Niedrig |
Variabel (lokal günstig, global teuer) |
|
Am besten geeignet für |
Faktenabfragen, kleine Korpora |
Themenfragen, verbundene Domänen |
Die Pipeline hat zwei Phasen: Indexierung baut den Graphen, Abfragen nutzen ihn.
Die Indexierung verwandelt Rohdokumente in eine Wissensstruktur – in fünf Schritten:
Der Extraktionsschritt ist dort, wo die meisten LLM-Aufrufe stattfinden. Jeder Chunk wird mit einem Prompt verarbeitet, der das Modell bittet, Entitäten und Beziehungen zu identifizieren. Ein Chunk mit „OpenAI released GPT-4“ erzeugt Entitäten für beides plus eine Beziehung, die sie verbindet. In demselben Durchlauf wird der Beziehungstyp erfasst. Da jeder Chunk einen LLM-Aufruf erfordert, ist die Indexierung der teuerste Teil der Pipeline. Die Abfragezeit ist vergleichsweise günstig, weil die schwere Arbeit bereits erledigt ist.
Die Graphkonstruktion übernimmt die Entitätsauflösung – das ist knifflig. „OpenAI“, „Open AI“ und „the company“ können sich in verschiedenen Chunks auf dieselbe Entität beziehen. Das System führt diese Duplikate zusammen, um einen sauberen Graphen zu erzeugen.
Community Detection nutzt den Leiden-Algorithmus, um natürliche Gruppierungen auf mehreren Ebenen zu finden. Level 0 enthält enge Cluster aus 5–10 verwandten Entitäten. Höhere Ebenen bündeln diese zu breiteren Themen. Ein Korpus über KI-Unternehmen könnte Level-0-Communities für einzelne Firmen haben, Level 1 für „KI-Labs“ und „Chiphersteller“ und Level 2 für das gesamte Tech-Ökosystem. Jede Community erhält dann eine LLM-generierte Zusammenfassung, die beschreibt, wofür der Cluster steht. Diese Zusammenfassungen werden vorab berechnet, bevor Anfragen eintreffen.
Das Endergebnis ist kein reiner Retrieval-Index. Es ist eine strukturierte Repräsentation: Graph plus Zusammenfassungen – bereit für unterschiedliche Abfragewege.
Ist der Graph erstellt, werden Anfragen an unterschiedliche Retrieval-Strategien geroutet:
Die abgerufenen Inhalte (Zusammenfassungen, Entitäten, Beziehungen, Quelltexte) werden zu einem Prompt zusammengesetzt, und das LLM erzeugt die finale Antwort. Jede Strategie bedient unterschiedliche Fragetypen – die wir gleich aufschlüsseln.
GraphRAG bietet drei unterschiedliche Retrieval-Strategien – jeweils passend für andere Fragetypen. Die richtige Wahl hängt davon ab, ob du breite Synthese, konkrete Entitätsinfos oder etwas dazwischen brauchst.
Globale Suche beantwortet Fragen, die das Verständnis eines gesamten Korpus erfordern. Fragen wie „What are the main themes in this document collection?“ oder „What patterns emerge across these reports?“ benötigen aggregierte Informationen aus dem Gesamten – nicht nur ein paar passende Chunks.
Der Mechanismus ist Map-Reduce über Community-Zusammenfassungen. In der Map-Phase wird jede Zusammenfassung unabhängig verarbeitet: Das System bittet ein LLM, relevante Punkte zu extrahieren und deren Wichtigkeit zu bewerten. In der Reduce-Phase werden die höchstbewerteten Punkte aller Communities zu einem finalen Prompt aggregiert, den das LLM zu einer kohärenten Antwort verdichtet.
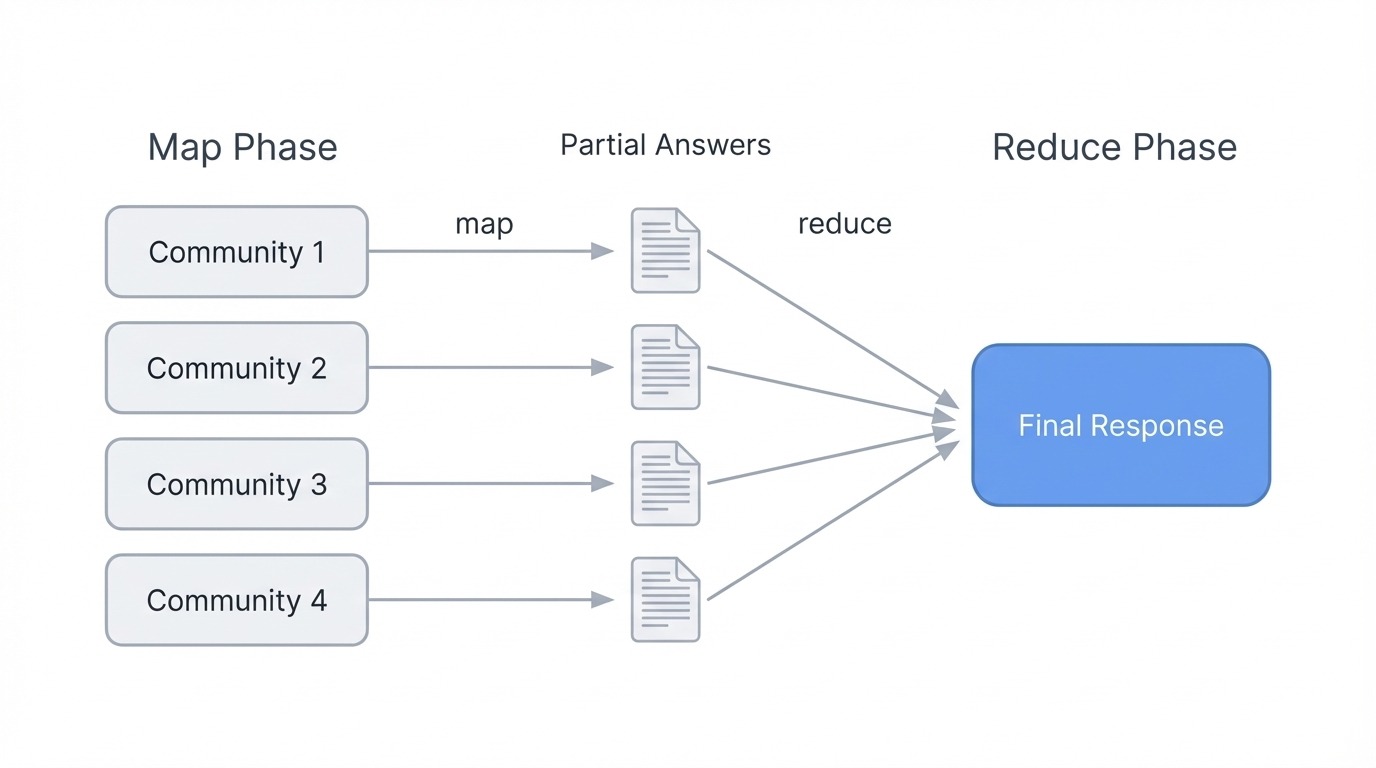
Globale GraphRAG-Suche mit Map-Reduce. Grafik: Autor
Das funktioniert, weil Community-Zusammenfassungen bereits erfassen, worum es in jedem Cluster geht. Das System muss keine tausenden Chunks abrufen, sondern schlussfolgert über vorab berechnete Beschreibungen, die die Graphstruktur auf der gewählten Hierarchieebene repräsentieren. Niedrigere Ebenen (kleinere, engere Communities) liefern detailliertere Antworten, kosten aber mehr LLM-Aufrufe. Höhere Ebenen laufen schneller, können aber Nuancen verpassen.
Globale Suche ist rechenintensiver als die anderen Modi, da alle Communities verarbeitet werden. Nutze sie, wenn Fragen wirklich ein Verständnis des gesamten Korpus verlangen – nicht für spezifische Fakten.
Die lokale Suche beantwortet entitätsspezifische Fragen. „What are the healing properties of chamomile?“ oder „What did Acme Corp announce about their Q3 earnings?“ zielen auf bestimmte Entitäten und die dazugehörigen Informationen.
Der Retrieval-Prozess beginnt damit, die zum Query passenden Entitäten im Graphen zu identifizieren. Diese Entitäten werden zu Einstiegspunkten für die Traversierung. Von jedem Startknoten holt das System verbundene Entitäten, Beziehungen zwischen ihnen, zugehörige Behauptungen/Fakten sowie die Community-Reports, zu denen diese Entitäten gehören. Außerdem werden die ursprünglichen Text-Chunks geladen, die mit diesen Entitäten verknüpft sind – so erhält das LLM sowohl strukturierte Graphdaten als auch Quelltext.
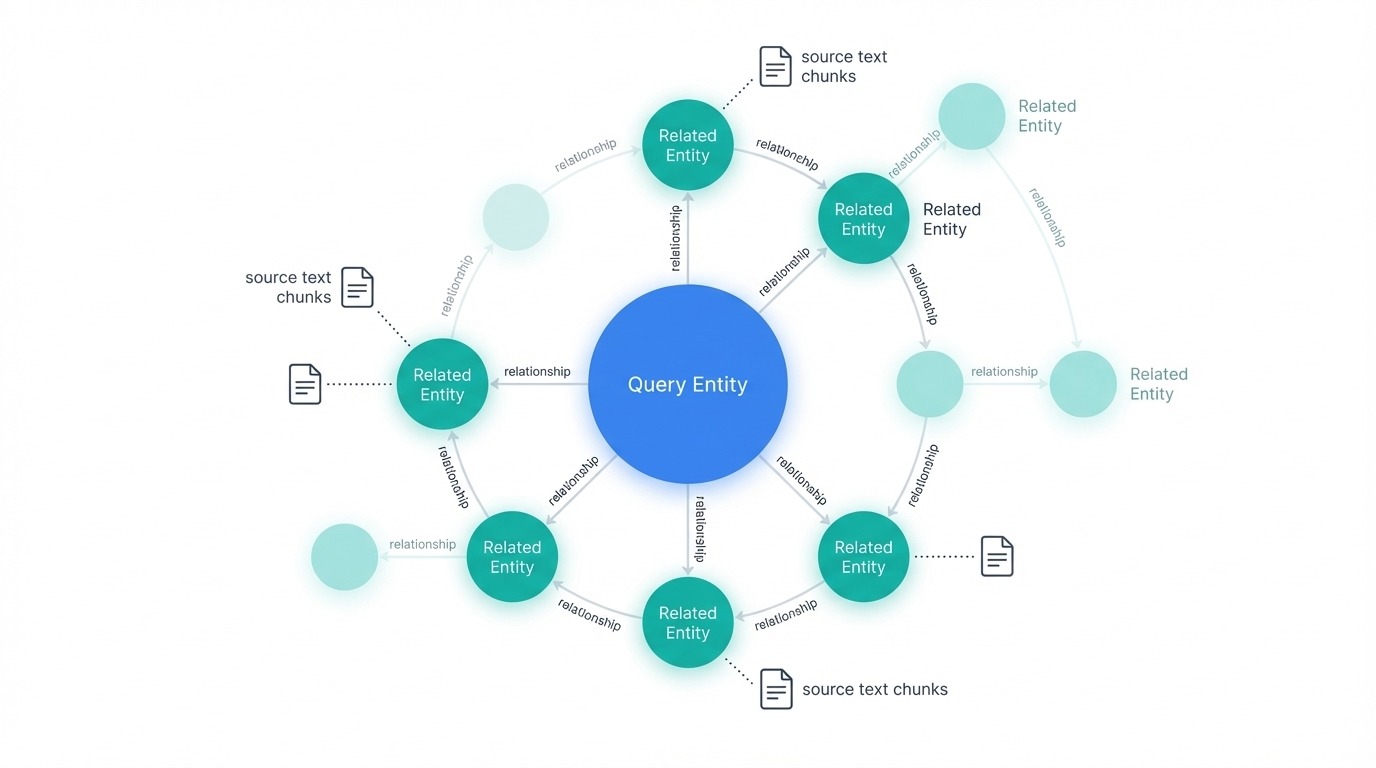
GraphRAG lokale Suche mit verwandten Knoten. Grafik: Autor
Alle Kandidateninformationen werden gerankt und gefiltert, um ins Kontextfenster zu passen. Das LLM erzeugt daraufhin eine Antwort, die sich auf die abgerufenen Inhalte stützt. Da sich die lokale Suche auf eine Nachbarschaft im Graphen fokussiert statt auf das Ganze, läuft sie schneller und günstiger als die globale Suche.
Wähle die lokale Suche, wenn Fragen sich auf konkrete Dinge, Personen, Organisationen oder Konzepte in deinen Dokumenten beziehen.
DRIFT (Dynamic Reasoning and Inference with Flexible Traversal) liegt zwischen global und lokal. Es bedient komplexe Anfragen, die sowohl breiten Kontext als auch konkrete Details brauchen.
Der Prozess hat drei Phasen. Erstens vergleicht die Primer-Phase die Query mit den semantisch relevantesten Community-Zusammenfassungen und erzeugt eine Anfangsantwort samt Nachfragen. Zweitens nimmt die Follow-up-Phase diese Fragen und setzt lokale Suche ein, um gezielt zu vertiefen – sie erzeugt Zwischenantworten und fokussiertere Nachfragen. Drittens bündelt die Output-Phase alles zu gerankten Ergebnissen, die globale Einblicke und lokale Details ausbalancieren.
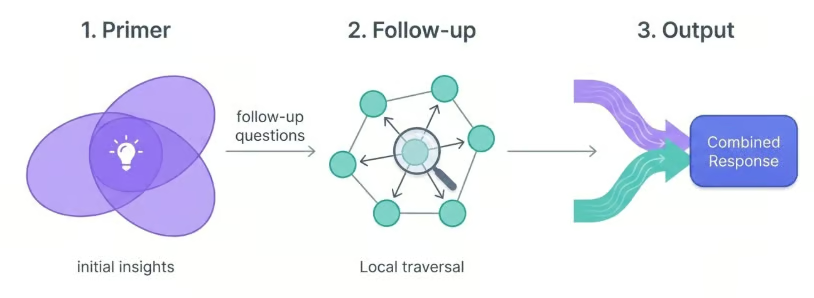
Dreiphasiger DRIFT-Suchprozess in GraphRAG. Grafik: Autor.
Der Nutzen von DRIFT liegt im erweiterten Startpunkt der Suche. Durch den Einstieg auf Community-Ebene werden mehr Fakten erfasst als bei reiner lokaler Suche. Durch die anschließende Verfeinerung über lokale Traversierung vermeidest du jedoch die Kosten einer vollständigen globalen Suche.
Nutze DRIFT für Fragen wie „How do the challenges facing Company X compare to broader industry trends?“, bei denen du sowohl spezifische Entitätsinformationen als auch thematischen Kontext brauchst.
|
Aspekt |
Global |
Lokal |
DRIFT |
|
Am besten für |
Korpusweite Themen und Muster |
Spezifische Entitätsfragen |
Komplexe Anfragen, die beides brauchen |
|
Mechanismus |
Map-Reduce über Community-Zusammenfassungen |
Traversierung von Entitäts-Nachbarschaften |
Primer → Follow-up → Output |
|
Geschwindigkeit |
Am langsamsten (verarbeitet alle Communities) |
Am schnellsten (fokussierte Traversierung) |
Mittel (startet breit, grenzt ein) |
|
Kosten |
Am höchsten |
Am niedrigsten |
Mittel |
|
Beispielfrage |
"What are the main themes?" |
"What did Company X announce?" |
"How does X compare to industry trends?" |
GraphRAG bietet außerdem eine einfache Vektorsuche als Fallback für triviale Anfragen, bei denen Graphtraversierung überdimensioniert wäre. Für die meisten Anwendungsfälle reichen jedoch global, lokal und DRIFT.
Dieser Abschnitt führt dich Schritt für Schritt durch den Aufbau eines GraphRAG-Systems mit Microsofts Referenzimplementierung. Wir arbeiten mit einem kleinen Korpus aus Paul-Graham-Essays über Startups, damit die Beispiele lauffähig und die Kosten überschaubar bleiben. Wenn du neu in der Kombination aus Wissensgraphen und Retrieval-Systemen bist, deckt das Knowledge-Graph-RAG-Tutorial die Grundlagen ab.
Erstelle ein Projektverzeichnis, initialisiere es mit uv und installiere dann das Paket graphrag. Die Bibliothek hat viele Abhängigkeiten (237 Pakete inklusive PyTorch) – die Installation dauert etwa fünf Minuten:
mkdir ragtest && cd ragtest
 uv init
 uv add graphrag
 graphrag init --root .
Das generiert die Projektstruktur:
ragtest/
 ├── .env                	# API key configuration
 ├── settings.yaml       	# Pipeline settings
 ├── prompts/            	# LLM prompt templates
 │   ├── extract_graph.txt
 │   ├── summarize_descriptions.txt
 │   └── ...
 └── input/              	# Your source documents go here
Das Verzeichnis prompts/ enthält die Templates, die GraphRAG für Entitätsextraktion und Zusammenfassungen nutzt. Du kannst sie für domänenspezifische Anforderungen anpassen – die Defaults funktionieren für allgemeinen Text gut.
Füge Textdateien in das Verzeichnis input/ ein. Für dieses Tutorial verwenden wir drei Paul-Graham-Essays über Startups. Seine Website nutzt minimales HTML mit Inhalten in <font>-Tags, daher extrahiert ein einfacher Parser den Text sauber:
import urllib.request
 from html.parser import HTMLParser

 class TextExtractor(HTMLParser):
 	def __init__(self):
     	super().__init__()
     	self.text = []
     	self.in_font = False

 	def handle_starttag(self, tag, attrs):
     	if tag == 'font':
         	self.in_font = True

 	def handle_endtag(self, tag):
     	if tag == 'font':
         	self.in_font = False

 	def handle_data(self, data):
     	if self.in_font:
         	self.text.append(data)

 essays = {
 	"startupideas": "http://paulgraham.com/startupideas.html",
     "do_things_that_dont_scale": "http://paulgraham.com/ds.html",
 	"startup_growth": "http://paulgraham.com/growth.html"
 }

 for name, url in essays.items():
 	with urllib.request.urlopen(url) as response:
     	html = response.read().decode('utf-8')
 	parser = TextExtractor()
 	parser.feed(html)
 	text = ' '.join(parser.text)
 	with open(f"input/{name}.txt", "w") as f:
     	f.write(text)
 	print(f"Saved {name}.txt ({len(text.split())} words)")
Saved startupideas.txt (3000 words)
Saved do_things_that_dont_scale.txt (3000 words)
Saved startup_growth.txt (3000 words)Insgesamt etwa 9.000 Wörter über drei thematisch verbundene Essays – genug, um sinnvolle Entitätsbeziehungen zu sehen, ohne hohe API-Kosten zu verursachen.
Bearbeite .env und füge deinen OpenAI-API-Schlüssel hinzu:
GRAPHRAG_API_KEY=your-openai-api-key-hereDie Standard-settings.yaml funktioniert direkt, aber du möchtest vielleicht das Modell anpassen. Die Datei nutzt standardmäßig gpt-4o-mini – ein guter Kompromiss aus Kosten und Qualität. Alle Optionen findest du in der vollständigen Konfigurationsreferenz:
models:
   default_chat_model:
 	type: openai_chat
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: gpt-4o-mini
 	model_supports_json: true
 	concurrent_requests: 25

   default_embedding_model:
 	type: openai_embedding
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: text-embedding-3-small
Weitere wichtige Einstellungen in der Konfiguration:
chunks:
   size: 1200  	# Tokens per chunk
   overlap: 100	# Overlap between chunks

 extract_graph:
   entity_types: [organization, person, geo, event]
   max_gleanings: 1	# Additional extraction passes

 cluster_graph:
max_cluster_size: 10Baue den Wissensgraphen mit:
graphrag index --root .Die Pipeline verarbeitet die Dokumente durch Entitätsextraktion, Graphkonstruktion und Community Detection:
├── Loading Input (InputFileType.text) - 3 files loaded (0 filtered) ───
 ├── create_base_text_units
 ├── create_final_documents
 ├── extract_graph
 ├── finalize_graph
 ├── create_final_entities
 ├── create_final_relationships
 ├── create_final_text_units
 ├── create_base_entity_graph
 ├── create_communities
 ├── create_final_communities
 ├── create_community_reports
 ├── generate_text_embeddings
 ⠋ GraphRAG Indexer
 ├── All workflows completed successfully
Jeder Schritt baut auf dem vorherigen auf. Die Phase extract_graph verursacht die meisten LLM-Aufrufe, während create_communities den Leiden-Algorithmus auf verwandte Entitäten anwendet.
Bei unseren drei Essays ist die Indexierung in etwa zwei Minuten fertig. Du kannst die Ergebnisse prüfen, indem du die Parquet-Dateien lädst oder die Zeilenzahlen checkst:
Die Ausgaben liegen in output/ als Parquet-Dateien:
output/
 ├── documents.parquet
 ├── entities.parquet
 ├── relationships.parquet
 ├── text_units.parquet
 ├── communities.parquet
 ├── community_reports.parquet
 └── lancedb/      	# Vector embeddings
Das Parquet-Format hält alles portabel. Du kannst die Dateien mit pandas laden, Entitäten inspizieren, Beziehungen durchstöbern oder Extraktionsprobleme debuggen. Das gesamte Projektverzeichnis ist klein genug für Versionsverwaltung (unter 10 MB für diesen Korpus) – schließe lediglich die .env mit deinem API-Schlüssel aus.
GraphRAG bietet drei Abfragemodi. Probieren wir alle aus.
Globale Suche für Themenfragen:
graphrag query \
 	--root . \
 	--method global \
 	--query "What are the main themes and lessons about startups in these essays?"
SUCCESS: Global Search Response:
The essays present several interconnected themes about startups:
**Growth as the defining characteristic**: A startup isn't just a new company—it's
specifically designed for rapid growth. This growth orientation shapes everything
from idea selection to daily decision-making. The essays suggest using weekly
growth rate as a compass for all strategic choices.
**The power of doing unscalable things**: Counterintuitively, successful startups
often begin with manual, labor-intensive approaches. Stripe's founders would
physically set up new users on the spot. Airbnb's founders went door-to-door
recruiting hosts. These unscalable tactics bootstrap the initial user base.
**Ideas emerge from problems, not brainstorming**: The best startup ideas come
from founders solving their own problems or noticing gaps while "living in the
future." Deliberately trying to generate ideas tends to produce plausible-sounding
but ultimately weak concepts.
**User relationships matter early**: Early users provide irreplaceable feedback.
Founders should go beyond standard customer service to create exceptional
experiences, gathering insights that shape the product.Die Antwort synthetisiert Themen über alle drei Essays hinweg – etwas, das bei traditionellem RAG viele Chunks erfordern würde. Die globale Suche nutzte stattdessen Community-Zusammenfassungen und liefert so einen kohärenten Überblick.
Lokale Suche für entitätsspezifische Fragen:
graphrag query \
 	--root . \
 	--method local \
 	--query "What role does Y Combinator play according to these essays?"
SUCCESS: Local Search Response:
Y Combinator functions as both an accelerator and a testing ground for startup
principles. According to the essays, YC provides:
**Funding and validation**: YC offers initial funding that lets founders focus
on building rather than fundraising. The program validates ideas through its
selection process.
**Growth measurement framework**: YC tracks startups by weekly growth rate,
with 5-7% weekly growth considered good and 10% exceptional. This metric-driven
approach forces founders to confront whether they're making real progress.
**Network effects**: B2B startups at YC gain immediate access to hundreds of
potential customers—other YC companies. Stripe leveraged this extensively in
its early days.
**Demo Day as forcing function**: The program's structure, culminating in Demo
Day presentations to investors, creates urgency that pushes founders to ship
and iterate quickly.Die lokale Suche traversierte den Graphen ausgehend von der Entität Y Combinator und zog verbundene Konzepte wie Wachstumsmetriken, Stripe und Demo Day heran. Die Antwort bleibt eng am Inhalt der Essays statt am Allgemeinwissen.
DRIFT-Suche für Fragen, die Breite und Tiefe brauchen:
graphrag query \
 	--root . \
 	--method drift \
 	--query "How do the essays describe the relationship between startup ideas and user problems?"
SUCCESS: Drift Search Response:
The essays establish a direct link between viable startup ideas and genuine user
problems through several mechanisms:
**Organic discovery over invention**: Rather than brainstorming ideas, founders
should notice problems they personally experience. Microsoft, Apple, Google, and
Facebook all started this way—founders building something they themselves needed.
**The "well" vs "shallow hole" distinction**: Good ideas serve a small number of
users who desperately need the solution (a narrow, deep well) rather than many
users with mild interest (a broad, shallow hole). Depth of need matters more
than breadth of appeal initially.
**Feedback loops as validation**: Engaging directly with early users reveals
whether the problem is real and the solution fits. This feedback shapes the
product more than any amount of planning.
**Problem-first, solution-second**: The essays warn against "sitcom startup
ideas"—concepts that sound plausible but don't address real pain points. A
social network for pet owners sounds reasonable but lacks urgent demand.DRIFT startete breit mit Community-Kontext zur Startup-Philosophie und zoomte dann in spezifische Beispiele wie die Brunnen-Analogie und „Sitcom-Ideen“. Das Ergebnis verbindet thematische Einordnung mit konkreten Details aus dem Quelltext.
Für Produktionssysteme nutze direkt die Python-API. Der Ablauf hat drei Teile: Konfiguration laden, indexierte Daten laden und Abfragen ausführen.
Zuerst richtest du die Konfiguration ein, lädst Umgebungsvariablen und parst die Settings-Datei:
import os
 import yaml
 from pathlib import Path
 from dotenv import load_dotenv
 from graphrag.config.create_graphrag_config import create_graphrag_config

 ROOT_DIR = Path(".")

 # Load environment variables and config
 load_dotenv(ROOT_DIR / ".env")
 with open(ROOT_DIR / "settings.yaml") as f:
 	yaml_content = f.read()
 yaml_content = os.path.expandvars(yaml_content)  # Expand ${VAR} references
 settings = yaml.safe_load(yaml_content)
 config = create_graphrag_config(values=settings, root_dir=str(ROOT_DIR))
Als Nächstes lädst du alle indexierten Daten aus den Parquet-Dateien. GraphRAG speichert Entitäten, Beziehungen, Communities und Text-Chunks separat:
import pandas as pd

 output_dir = ROOT_DIR / "output"
 entities = pd.read_parquet(output_dir / "entities.parquet")
 communities = pd.read_parquet(output_dir / "communities.parquet")
 community_reports = pd.read_parquet(output_dir / "community_reports.parquet")
 text_units = pd.read_parquet(output_dir / "text_units.parquet")
 relationships = pd.read_parquet(output_dir / "relationships.parquet")

 print(f"Loaded {len(entities)} entities, {len(relationships)} relationships")
Loaded 74 entities, 89 relationshipsZum Schluss führst du Abfragen über die Async-API aus. Die Funktion local_search nimmt alle DataFrames und Query-Parameter entgegen:
import asyncio
 from graphrag.api import local_search

 async def run_query(query: str):
 	response, context = await local_search(
     	config=config,
     	entities=entities,
     	communities=communities,
         community_reports=community_reports,
     	text_units=text_units,
     	relationships=relationships,
     	covariates=None,
     	community_level=2,
     	response_type="Multiple Paragraphs",
     	query=query,
 	)
 	return response

 query = "What advice do the essays give about finding startup ideas?"
 response = asyncio.run(run_query(query))
 print(response)
The essays provide several valuable insights into finding startup ideas:
Focus on Growth: A startup is designed to grow quickly. Founders should commit
to seeking ideas that can scale significantly, as this distinguishes startups
from ordinary businesses.
Identify Unmet Needs: Successful startups arise from recognizing problems that
need solving. Founders who can see different problems, particularly those
addressable through technology, are more likely to develop effective solutions.
Leverage Personal Insights: Many successful startups originate from the unique
insights of their founders, often stemming from personal experiences or
frustrations. This personal connection leads to more authentic solutions.
Explore Overlooked Markets: Founders should think outside the box and explore
markets that may be overlooked. Successful startups often emerge from ideas
that seem obvious to the founders but aren't yet recognized broadly.Die Python-API gibt dir volle Kontrolle darüber, welche Daten du lädst, welche Community-Ebene du abfragst und wie Antworten formatiert werden. Für Anwendungen mit eigenem Retrieval-Logikbedarf oder zur Integration in bestehende Systeme ist das der richtige Weg.
Klassisches RAG funktioniert – bis es das nicht mehr tut. Du merkst die Grenze, wenn Nutzer nach Themen oder Mustern fragen und statt einer stringenten Antwort ein Sammelsurium lose zusammenhängender Chunks bekommen. Genau dieses Problem löst GraphRAG, indem es Chunks gegen einen Wissensgraphen mit vorab berechneten Community-Zusammenfassungen tauscht.
Die Kosten sind real. Die Indexierung verbraucht viele LLM-Aufrufe, und auch die globale Suche ist nicht billig. Für kleine Dokumentsammlungen oder einfache Nachschlagenfragen bleib bei der Vektorsuche.
Wenn dein Korpus jedoch reiche Verbindungen zwischen Entitäten hat und deine Nutzer diese Verknüpfungen brauchen, zahlt sich GraphRAG aus. Wähle den Abfragetyp passend zur Frage: global für Themen, lokal für spezifische Entitäten, DRIFT, wenn du beides brauchst. Die Implementierung ist überschaubar, sobald du sie einmal durchgespielt hast, und die Parquet-Ausgaben machen Inspektion und Debugging einfach.
Lerne mit DataCamp
Kurs
Kurs
Kurs