
Kursus
Retrieval Augmented Generation (RAG) dengan LangChain
3 jam
20.8K
Sistem RAG tradisional mengambil potongan dokumen berdasarkan kesamaan semantik, yang bekerja baik untuk pertanyaan sederhana. Namun saat kueri membutuhkan penyusunan informasi yang tersebar di banyak dokumen atau penalaran melalui konsep-konsep yang saling terhubung, pencarian vektor tidak memadai. Sistem mengumpulkan fragmen tanpa memahami bagaimana fragmen tersebut saling terkait.
GraphRAG tidak memperlakukan dokumen sebagai potongan yang terisolasi. Ia membangun knowledge graph yang menangkap entitas dan relasinya. Struktur ini memungkinkan sistem menelusuri koneksi dan menjawab pertanyaan yang memerlukan penggabungan informasi dari banyak sumber. Ini adalah salah satu dari beberapa teknik RAG tingkat lanjut yang mengatasi keterbatasan pengambilan dasar.
GraphRAG adalah teknik retrieval-augmented generation yang merepresentasikan dokumen sebagai knowledge graph alih-alih embedding vektor. Alih-alih memecah teks menjadi potongan yang dicari secara independen, GraphRAG mengekstrak entitas (pikirkan orang, organisasi, konsep, peristiwa) dan relasi di antara mereka, lalu mengorganisasikannya ke dalam struktur graf yang saling terhubung.
Sistem GraphRag kemudian menerapkan algoritma deteksi komunitas untuk mengidentifikasi klaster entitas terkait dan menghasilkan ringkasan untuk klaster-klaster ini pada tingkat hierarki. Saat kueri masuk, GraphRAG dapat menelusuri lingkungan entitas tertentu untuk pertanyaan yang terarah atau menjalankan operasi map-reduce di atas ringkasan komunitas untuk sintesis skala korpus.
Sekarang mari kita lihat mekanismenya lebih dekat. Ini akan membantu kita memahami mengapa pengambilan berbasis graf muncul dan celah apa yang diisinya.
Masalah inti pada RAG tradisional bukan di pengambilan atau generasi, melainkan pada representasi. Dokumen dipecah menjadi potongan, dan setiap potongan menjadi vektor terisolasi yang melayang di ruang embedding. Apa pun struktur yang ada di sumber asli—judul, alur naratif, paragraf mana merujuk ke apa—menjadi rata dan hilang.
Ini menimbulkan masalah untuk pertanyaan yang memerlukan penggabungan informasi. Tanyakan "Apa tema utama di dokumen-dokumen ini?" dan pencarian vektor akan mengembalikan potongan yang mengandung kata "tema" atau istilah terkait. Namun menemukan fragmen relevan tidak sama dengan memahami pola di seluruh korpus. Sistem tidak punya cara untuk menyatukan info dalam skala besar karena ia hanya melihat potongan individu, bukan gambaran utuh.
Penalaran multi-hop menemui hambatan serupa. Misal jawaban bergantung pada menghubungkan konsep A ke B lalu C. RAG tradisional mengambil tiap potongan secara independen berdasarkan kemiripan dengan kueri. Jika B tidak dekat dengan pertanyaan, ia mungkin tidak terambil sama sekali, memutus rantai. Sistem menemukan titik ujung tetapi melewatkan jalur di antaranya.
Ada juga ketidakselarasan antara pengambilan dan konteks. Anda bisa mengambil dua puluh potongan yang sangat relevan, tetapi memasukkan semuanya ke dalam prompt tidak menjamin LLM akan menggunakannya dengan baik. Makalah "lost in the middle" menunjukkan bahwa LLM cenderung berfokus pada informasi di awal dan akhir jendela konteks, sering mengabaikan yang terkubur di tengah. Lebih banyak pengambilan tidak otomatis berarti jawaban lebih baik.
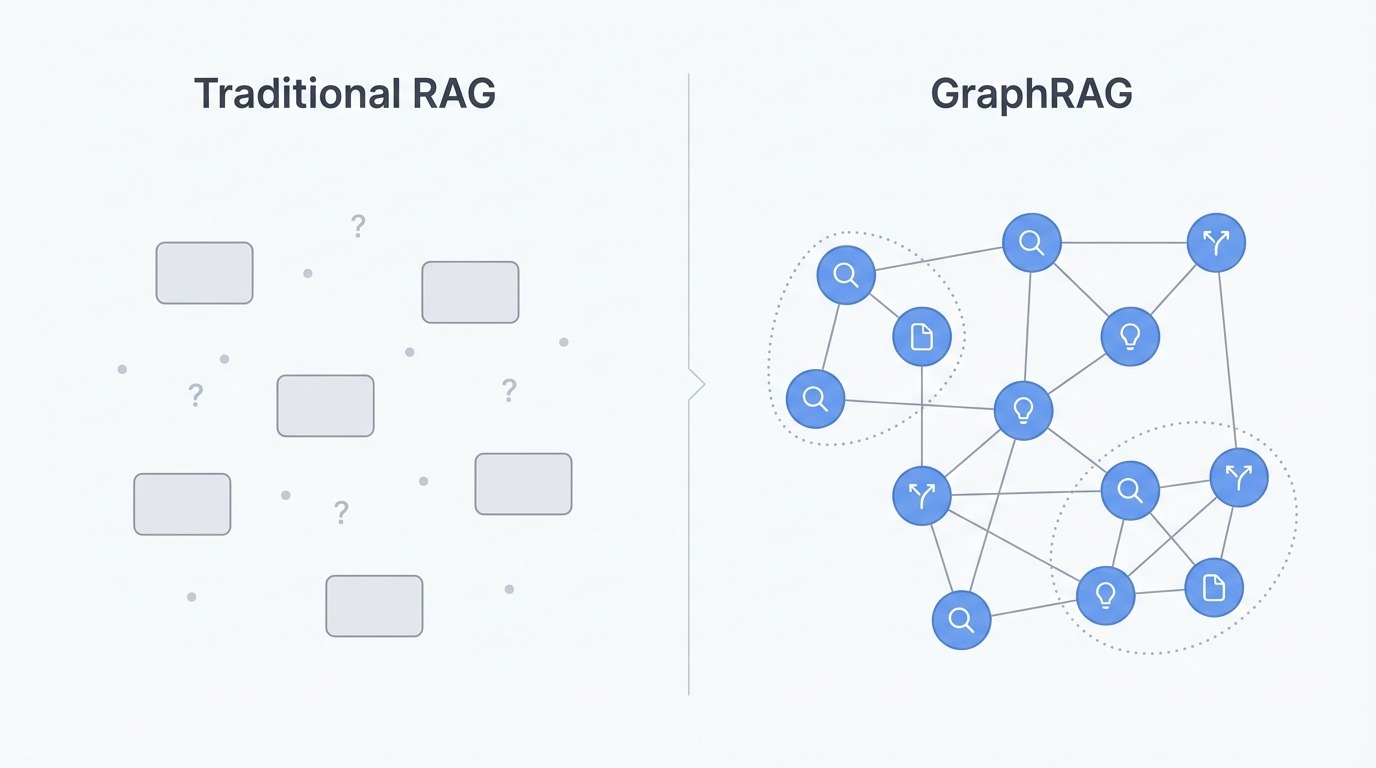
Perbandingan RAG tradisional versus GraphRAG. Gambar oleh Penulis.
GraphRAG mengatasi keterbatasan ini dengan mengubah representasi sepenuhnya. Alih-alih potongan, ia membangun knowledge graph di mana entitas menjadi node dan relasi menjadi edge. Orang, organisasi, lokasi, konsep, dan peristiwa diekstrak dari dokumen sumber beserta bagaimana mereka saling terhubung. Ini mempertahankan struktur yang hilang saat melakukan chunking.
Dengan graf siap, sistem menerapkan deteksi komunitas (biasanya algoritma Leiden) untuk mengelompokkan entitas terkait ke dalam grup. Klaster ini terbentuk pada beberapa tingkat, ada yang ketat dan spesifik, ada yang luas dan tematik. Pengelompokan ini berasal dari koneksi nyata dalam data, bukan dari batas dokumen atau ukuran potongan.
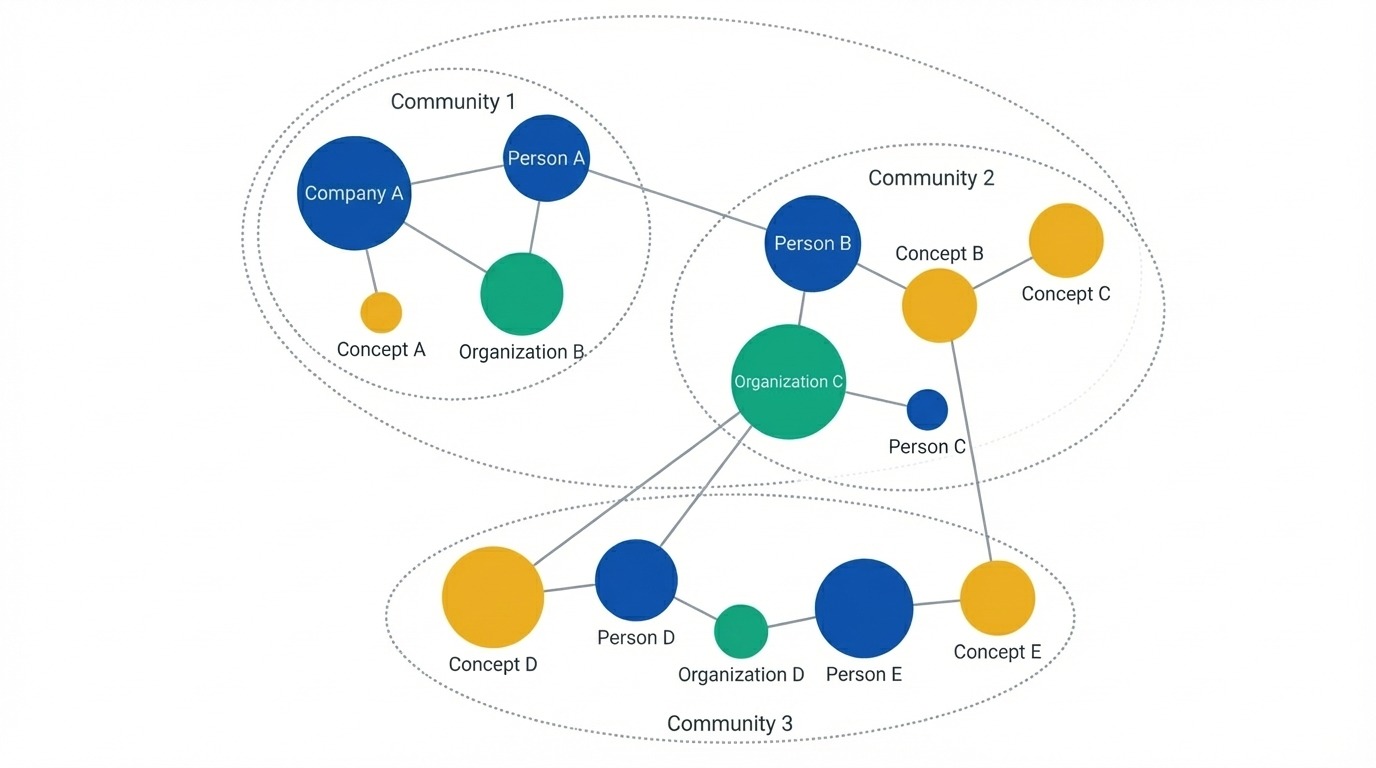
Knowledge graph yang menampilkan entitas sebagai node. Gambar oleh Penulis.
Untuk pertanyaan global, GraphRAG membuat ringkasan untuk setiap komunitas sebelum kueri pengguna datang. Ketika seseorang bertanya "Apa tema utamanya?", sistem tidak mencari teks yang cocok. Sebagai gantinya, ia menjalankan operasi map-reduce: setiap ringkasan komunitas menghasilkan jawaban parsial berdasarkan bagiannya di graf, lalu semua bagian digabungkan menjadi respons akhir. Ini memungkinkan GraphRAG bernalar di seluruh korpus tanpa mengambil ribuan potongan.
Untuk pertanyaan multi-hop, penelusuran graf menggantikan pencarian kemiripan. Sistem dapat menelusuri edge dari entitas ke entitas, mengikuti rantai konseptual yang akan terlewat oleh pencarian vektor. Jika A terhubung ke B dan B ke C, graf mengetahui jalur itu ada dan dapat mengikutinya.
GraphRAG menguntungkan ketika pertanyaan Anda membutuhkan pemahaman skala korpus. Jika pengguna sering bertanya tentang tema, pola, atau ringkasan di koleksi dokumen besar, pengambilan berbasis graf akan mengungguli pendekatan chunking. Begitu pula untuk domain dengan relasi entitas yang kaya, seperti bagan organisasi perusahaan, jaringan sitasi riset, atau sejarah perkara hukum di mana mengikuti koneksi itu penting.
Untuk pencarian fakta sederhana ("Berapa nomor telepon X?") atau set dokumen kecil, RAG tradisional bekerja baik dan lebih murah dijalankan. GraphRAG menambah overhead pada waktu pengindeksan dan panggilan LLM, jadi manfaatnya perlu sebanding dengan investasinya. Mulailah dengan RAG standar dan beralih ke GraphRAG saat Anda menemui batasannya.
Tabel di bawah merangkum komprominya. RAG tradisional unggul dalam kesederhanaan dan biaya, sementara GraphRAG lebih unggul saat pertanyaan memerlukan sintesis atau penalaran terhubung.
|
Aspek |
RAG tradisional |
GraphRAG |
|
Representasi data |
Potongan teks terisolasi sebagai vektor |
Knowledge graph dengan entitas dan relasi |
|
Pelestarian struktur |
Hilang saat chunking |
Dipertahankan melalui edge graf |
|
Kueri global |
Buruk (mengambil fragmen, tidak bisa menyintesis) |
Kuat (map-reduce atas ringkasan komunitas) |
|
Penalaran multi-hop |
Terbatas (pengambilan potongan independen) |
Natif (penelusuran graf mengikuti koneksi) |
|
Biaya pengindeksan |
Rendah (hanya embedding) |
Tinggi (ekstraksi LLM + embedding + klastering) |
|
Biaya kueri |
Rendah |
Bervariasi (lokal murah, global mahal) |
|
Terbaik untuk |
Pencarian fakta, korpus kecil |
Pertanyaan tematik, domain terhubung |
Pipeline memiliki dua fase: pengindeksan membangun graf, kueri menggunakannya.
Pengindeksan mengubah dokumen mentah menjadi struktur pengetahuan melalui lima langkah:
Langkah ekstraksi adalah tempat sebagian besar panggilan LLM terjadi. Setiap potongan diproses dengan prompt yang meminta model mengidentifikasi entitas dan relasi. Sebuah potongan yang menyebut "OpenAI merilis GPT-4" menghasilkan entitas untuk keduanya, plus relasi yang menghubungkannya. Pada lintasan yang sama juga ditangkap tipe relasinya. Karena setiap potongan memerlukan panggilan LLM, pengindeksan adalah bagian pipeline yang mahal. Waktu kueri relatif murah karena pekerjaan berat sudah dilakukan.
Konstruksi graf menangani resolusi entitas, yang bisa rumit. "OpenAI," "Open AI," dan "perusahaan" mungkin semuanya merujuk ke entitas yang sama di potongan berbeda. Sistem menggabungkan duplikat ini untuk membuat graf yang bersih.
Deteksi komunitas menerapkan algoritma Leiden untuk menemukan pengelompokan alami pada beberapa tingkat. Level 0 mungkin berisi klaster rapat berisi 5–10 entitas terkait. Level lebih tinggi mengelompokkan itu menjadi tema yang lebih luas. Sebuah korpus tentang perusahaan AI bisa memiliki komunitas level-0 untuk perusahaan individu, level-1 untuk "lab AI" dan "produsen chip," dan level-2 yang menangkap seluruh ekosistem teknologi. Setiap komunitas kemudian mendapatkan ringkasan yang dihasilkan LLM yang menggambarkan representasi klaster tersebut. Ringkasan ini dihitung terlebih dahulu sebelum kueri pengguna datang.
Hasil akhirnya bukan indeks pengambilan. Ini adalah representasi terstruktur: graf plus ringkasan, siap untuk dikuery dengan berbagai cara.
Dengan graf yang telah dibangun, kueri diarahkan ke strategi pengambilan yang berbeda:
Konten yang diambil (ringkasan, entitas, relasi, teks sumber) disusun menjadi sebuah prompt, dan LLM menghasilkan jawaban akhir. Setiap strategi melayani tipe pertanyaan yang berbeda, yang akan kita uraikan selanjutnya.
GraphRAG menawarkan tiga strategi pengambilan yang berbeda, masing-masing cocok untuk tipe pertanyaan tertentu. Memilih yang tepat tergantung apakah Anda memerlukan sintesis luas, informasi entitas spesifik, atau sesuatu di antaranya.
Pencarian global menjawab pertanyaan yang memerlukan pemahaman seluruh korpus. Pertanyaan seperti "Apa tema utama dalam koleksi dokumen ini?" atau "Pola apa yang muncul di laporan-laporan ini?" membutuhkan informasi yang diagregasi dari mana-mana, bukan diambil dari beberapa potongan yang cocok.
Mekanismenya adalah map-reduce atas ringkasan komunitas. Pada fase map, setiap ringkasan komunitas diproses secara independen: sistem meminta LLM mengekstrak poin relevan dan menilai kepentingannya. Pada fase reduce, poin dengan peringkat tertinggi dari semua komunitas diagregasi ke dalam prompt akhir, dan LLM menyintesisnya menjadi respons yang koheren.
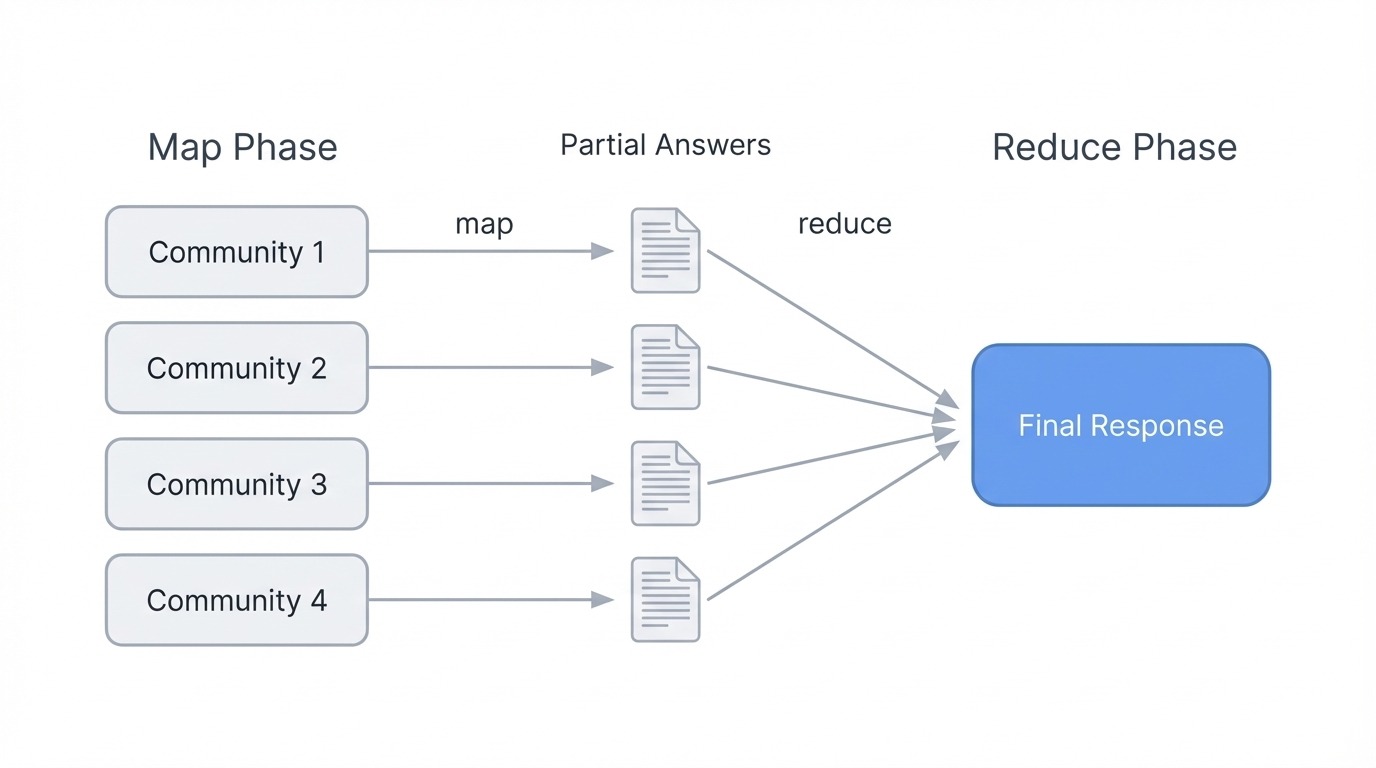
Pencarian global GraphRAG menggunakan map-reduce. Gambar oleh Penulis
Ini bekerja karena ringkasan komunitas sudah menangkap apa yang diwakili setiap klaster entitas. Sistem tidak perlu mengambil ribuan potongan. Sebagai gantinya, ia bernalar atas deskripsi yang telah dihitung yang merepresentasikan struktur graf pada tingkat hierarki apa pun yang Anda pilih. Level lebih rendah (komunitas lebih kecil dan rapat) memberikan jawaban lebih detail tetapi berbiaya lebih banyak panggilan LLM. Level lebih tinggi (pengelompokan lebih luas) berjalan lebih cepat namun bisa kehilangan nuansa.
Pencarian global secara komputasional lebih berat daripada mode lain karena memproses semua komunitas. Gunakan saat pertanyaan benar-benar membutuhkan pemahaman skala korpus, bukan fakta spesifik.
Pencarian lokal menangani pertanyaan khusus entitas. "Apa khasiat penyembuhan chamomile?" atau "Apa yang diumumkan Acme Corp tentang pendapatan Q3 mereka?" menargetkan entitas tertentu dan informasi yang terhubung dengannya.
Proses pengambilan dimulai dengan mengidentifikasi entitas mana dalam graf yang terkait dengan kueri. Entitas-entitas ini menjadi titik masuk untuk penelusuran. Dari setiap node awal, sistem menarik entitas yang terhubung, relasi di antara mereka, klaim atau fakta terkait, dan laporan komunitas tempat entitas itu berada. Ia juga mengambil potongan teks asli yang ditautkan ke entitas tersebut, memberi LLM data graf terstruktur sekaligus teks sumber.
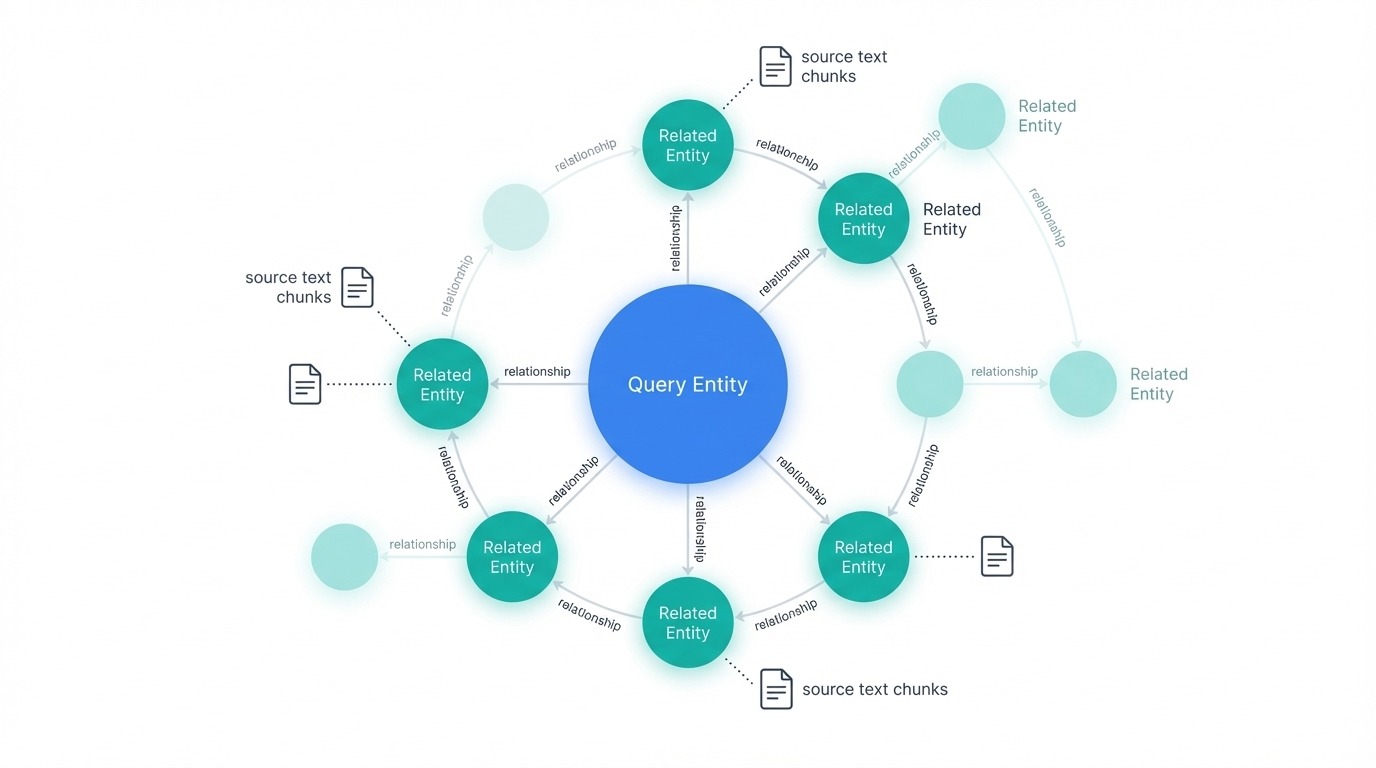
Pencarian lokal GraphRAG dengan node terkait. Gambar oleh Penulis
Semua informasi kandidat ini diperingkat dan difilter agar muat dalam jendela konteks. LLM kemudian menghasilkan jawaban yang tertopang oleh konten yang diambil. Karena pencarian lokal berfokus pada lingkungan graf alih-alih keseluruhan, ini berjalan lebih cepat dan lebih murah daripada pencarian global.
Pilih pencarian lokal ketika pertanyaan menyoal hal, orang, organisasi, atau konsep spesifik yang disebutkan dalam dokumen Anda.
DRIFT (Dynamic Reasoning and Inference with Flexible Traversal) berada di antara global dan lokal. Ia menangani kueri kompleks yang memerlukan konteks luas dan detail spesifik sekaligus.
Prosesnya memiliki tiga fase. Pertama, fase primer membandingkan kueri dengan ringkasan komunitas yang paling relevan secara semantik dan menghasilkan jawaban awal beserta pertanyaan lanjutan. Kedua, fase tindak lanjut mengambil pertanyaan tersebut dan menerapkan pencarian lokal untuk mengebor area spesifik, menghasilkan jawaban antara dan tindak lanjut yang lebih terarah. Ketiga, fase keluaran menggabungkan semuanya menjadi hasil berperingkat yang menyeimbangkan wawasan global dengan detail lokal.
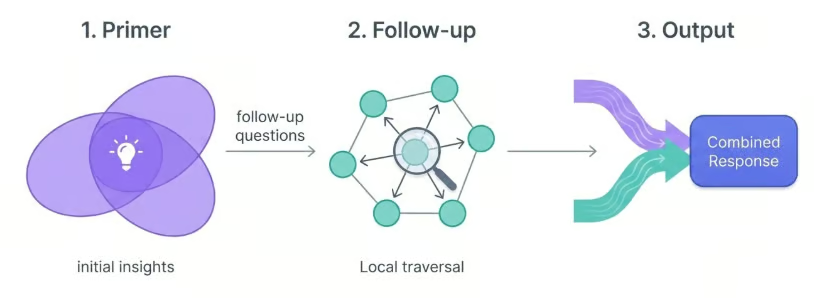
Proses tiga fase pencarian DRIFT GraphRAG. Gambar oleh Penulis.
Yang membuat DRIFT berguna adalah bagaimana ia memperluas titik awal pencarian. Dengan memulai dari konteks tingkat komunitas, ia mengambil variasi fakta yang lebih luas dibanding pencarian lokal murni. Namun dengan pemurnian melalui penelusuran lokal, ia menghindari biaya pencarian global penuh.
Gunakan DRIFT untuk pertanyaan seperti "Bagaimana tantangan yang dihadapi Perusahaan X dibandingkan tren industri yang lebih luas?" ketika Anda membutuhkan informasi entitas spesifik dan konteks tematik sekaligus.
|
Aspek |
Global |
Lokal |
DRIFT |
|
Terbaik untuk |
Tema dan pola skala korpus |
Pertanyaan entitas spesifik |
Kueri kompleks yang butuh keduanya |
|
Mekanisme |
Map-reduce atas ringkasan komunitas |
Penelusuran lingkungan entitas |
Fase primer → tindak lanjut → keluaran |
|
Kecepatan |
Paling lambat (memproses semua komunitas) |
Paling cepat (penelusuran terfokus) |
Sedang (mulai luas, mempersempit) |
|
Biaya |
Tertinggi |
Terendah |
Sedang |
|
Contoh kueri |
"Apa tema utamanya?" |
"Apa yang diumumkan Perusahaan X?" |
"Bagaimana X dibandingkan tren industri?" |
GraphRAG juga menyediakan pencarian vektor dasar sebagai fallback untuk kueri sederhana di mana penelusuran graf berlebihan. Namun untuk sebagian besar use case, memilih antara global, lokal, dan DRIFT sudah mencakup kebutuhan Anda.
Bagian ini membahas pembuatan sistem GraphRAG menggunakan implementasi referensi Microsoft. Kita akan bekerja dengan korpus kecil esai Paul Graham tentang startup agar contoh dapat dijalankan dan biayanya wajar. Jika Anda baru menggabungkan knowledge graph dengan sistem pengambilan, tutorial knowledge graph RAG membahas konsep dasarnya.
Buat direktori proyek dan inisialisasi dengan uv, lalu instal paket graphrag. Pustaka ini memiliki dependensi besar (237 paket termasuk PyTorch), jadi harapkan instalasi memakan waktu sekitar lima menit:
mkdir ragtest && cd ragtest
 uv init
 uv add graphrag
 graphrag init --root .
Ini menghasilkan struktur proyek:
ragtest/
 ├── .env                	# API key configuration
 ├── settings.yaml       	# Pipeline settings
 ├── prompts/            	# LLM prompt templates
 │   ├── extract_graph.txt
 │   ├── summarize_descriptions.txt
 │   └── ...
 └── input/              	# Your source documents go here
Direktori prompts/ berisi templat yang digunakan GraphRAG untuk ekstraksi entitas dan peringkasan. Anda dapat menyesuaikannya untuk kebutuhan domain spesifik, meski default-nya sudah baik untuk teks umum.
Tambahkan berkas teks ke direktori input/. Untuk tutorial ini, kita menggunakan tiga esai Paul Graham tentang startup. Situsnya menggunakan HTML minimal dengan konten dibungkus dalam tag <font>, jadi parser sederhana dapat mengekstrak teks dengan bersih:
import urllib.request
 from html.parser import HTMLParser

 class TextExtractor(HTMLParser):
 	def __init__(self):
     	super().__init__()
     	self.text = []
     	self.in_font = False

 	def handle_starttag(self, tag, attrs):
     	if tag == 'font':
         	self.in_font = True

 	def handle_endtag(self, tag):
     	if tag == 'font':
         	self.in_font = False

 	def handle_data(self, data):
     	if self.in_font:
         	self.text.append(data)

 essays = {
 	"startupideas": "http://paulgraham.com/startupideas.html",
     "do_things_that_dont_scale": "http://paulgraham.com/ds.html",
 	"startup_growth": "http://paulgraham.com/growth.html"
 }

 for name, url in essays.items():
 	with urllib.request.urlopen(url) as response:
     	html = response.read().decode('utf-8')
 	parser = TextExtractor()
 	parser.feed(html)
 	text = ' '.join(parser.text)
 	with open(f"input/{name}.txt", "w") as f:
     	f.write(text)
 	print(f"Saved {name}.txt ({len(text.split())} words)")
Saved startupideas.txt (3000 words)
Saved do_things_that_dont_scale.txt (3000 words)
Saved startup_growth.txt (3000 words)Sekitar 9.000 kata total dari tiga esai yang terhubung secara tematik, cukup untuk melihat relasi entitas yang bermakna tanpa menimbulkan biaya API besar.
Edit .env untuk menambahkan OpenAI API key Anda:
GRAPHRAG_API_KEY=your-openai-api-key-hereBerkas settings.yaml default bekerja langsung, tetapi Anda mungkin ingin menyesuaikan model. Berkas ini menggunakan gpt-4o-mini secara default, yang menyeimbangkan biaya dan kualitas. Lihat referensi konfigurasi lengkap untuk semua opsi yang tersedia:
models:
   default_chat_model:
 	type: openai_chat
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: gpt-4o-mini
 	model_supports_json: true
 	concurrent_requests: 25

   default_embedding_model:
 	type: openai_embedding
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: text-embedding-3-small
Pengaturan lain yang patut dicatat di konfigurasi:
chunks:
   size: 1200  	# Tokens per chunk
   overlap: 100	# Overlap between chunks

 extract_graph:
   entity_types: [organization, person, geo, event]
   max_gleanings: 1	# Additional extraction passes

 cluster_graph:
max_cluster_size: 10Bangun knowledge graph dengan:
graphrag index --root .Pipeline memproses dokumen melalui ekstraksi entitas, konstruksi graf, dan deteksi komunitas:
├── Loading Input (InputFileType.text) - 3 files loaded (0 filtered) ───
 ├── create_base_text_units
 ├── create_final_documents
 ├── extract_graph
 ├── finalize_graph
 ├── create_final_entities
 ├── create_final_relationships
 ├── create_final_text_units
 ├── create_base_entity_graph
 ├── create_communities
 ├── create_final_communities
 ├── create_community_reports
 ├── generate_text_embeddings
 ⠋ GraphRAG Indexer
 ├── All workflows completed successfully
Setiap langkah dibangun di atas langkah sebelumnya. Fase extract_graph menyumbang sebagian besar panggilan LLM, sementara create_communities menerapkan algoritma Leiden untuk mengelompokkan entitas terkait.
Dengan tiga esai kita, pengindeksan selesai sekitar dua menit. Anda dapat memeriksa hasilnya dengan memuat berkas parquet atau memeriksa jumlah baris:
Output berada di output/ sebagai berkas parquet:
output/
 ├── documents.parquet
 ├── entities.parquet
 ├── relationships.parquet
 ├── text_units.parquet
 ├── communities.parquet
 ├── community_reports.parquet
 └── lancedb/      	# Vector embeddings
Format parquet membuat semuanya portabel. Anda dapat memuat berkas-berkas ini dengan pandas untuk memeriksa entitas, menelusuri relasi, atau mendebug masalah ekstraksi. Seluruh direktori proyek cukup kecil untuk version control (di bawah 10MB untuk korpus ini), cukup kecualikan berkas .env yang berisi API key Anda.
GraphRAG menyediakan tiga mode kueri. Mari coba masing-masing.
Pencarian global untuk pertanyaan tematik:
graphrag query \
 	--root . \
 	--method global \
 	--query "What are the main themes and lessons about startups in these essays?"
SUCCESS: Global Search Response:
The essays present several interconnected themes about startups:
**Growth as the defining characteristic**: A startup isn't just a new company—it's
specifically designed for rapid growth. This growth orientation shapes everything
from idea selection to daily decision-making. The essays suggest using weekly
growth rate as a compass for all strategic choices.
**The power of doing unscalable things**: Counterintuitively, successful startups
often begin with manual, labor-intensive approaches. Stripe's founders would
physically set up new users on the spot. Airbnb's founders went door-to-door
recruiting hosts. These unscalable tactics bootstrap the initial user base.
**Ideas emerge from problems, not brainstorming**: The best startup ideas come
from founders solving their own problems or noticing gaps while "living in the
future." Deliberately trying to generate ideas tends to produce plausible-sounding
but ultimately weak concepts.
**User relationships matter early**: Early users provide irreplaceable feedback.
Founders should go beyond standard customer service to create exceptional
experiences, gathering insights that shape the product.Respons menyintesis tema di ketiga esai, sesuatu yang dengan RAG tradisional memerlukan pengambilan dan pemrosesan banyak potongan. Pencarian global menarik dari ringkasan komunitas, memberi pandangan tingkat tinggi yang koheren.
Pencarian lokal untuk pertanyaan spesifik entitas:
graphrag query \
 	--root . \
 	--method local \
 	--query "What role does Y Combinator play according to these essays?"
SUCCESS: Local Search Response:
Y Combinator functions as both an accelerator and a testing ground for startup
principles. According to the essays, YC provides:
**Funding and validation**: YC offers initial funding that lets founders focus
on building rather than fundraising. The program validates ideas through its
selection process.
**Growth measurement framework**: YC tracks startups by weekly growth rate,
with 5-7% weekly growth considered good and 10% exceptional. This metric-driven
approach forces founders to confront whether they're making real progress.
**Network effects**: B2B startups at YC gain immediate access to hundreds of
potential customers—other YC companies. Stripe leveraged this extensively in
its early days.
**Demo Day as forcing function**: The program's structure, culminating in Demo
Day presentations to investors, creates urgency that pushes founders to ship
and iterate quickly.Pencarian lokal menelusuri graf mulai dari entitas Y Combinator, menarik konsep terkait seperti metrik pertumbuhan, Stripe, dan Demo Day. Jawabannya tetap berpijak pada apa yang benar-benar dikatakan esai tentang YC, bukan pengetahuan umum.
Pencarian DRIFT untuk pertanyaan yang membutuhkan keluasan dan kekhususan:
graphrag query \
 	--root . \
 	--method drift \
 	--query "How do the essays describe the relationship between startup ideas and user problems?"
SUCCESS: Drift Search Response:
The essays establish a direct link between viable startup ideas and genuine user
problems through several mechanisms:
**Organic discovery over invention**: Rather than brainstorming ideas, founders
should notice problems they personally experience. Microsoft, Apple, Google, and
Facebook all started this way—founders building something they themselves needed.
**The "well" vs "shallow hole" distinction**: Good ideas serve a small number of
users who desperately need the solution (a narrow, deep well) rather than many
users with mild interest (a broad, shallow hole). Depth of need matters more
than breadth of appeal initially.
**Feedback loops as validation**: Engaging directly with early users reveals
whether the problem is real and the solution fits. This feedback shapes the
product more than any amount of planning.
**Problem-first, solution-second**: The essays warn against "sitcom startup
ideas"—concepts that sound plausible but don't address real pain points. A
social network for pet owners sounds reasonable but lacks urgent demand.DRIFT memulai luas dengan konteks tingkat komunitas tentang filosofi startup, lalu mengebor contoh spesifik seperti analogi sumur dan ide sitcom. Hasilnya memadukan wawasan tematik dengan detail konkret dari teks sumber.
Untuk sistem produksi, gunakan API Python secara langsung. Prosesnya memiliki tiga bagian: memuat konfigurasi, memuat data yang diindeks, dan menjalankan kueri.
Pertama, siapkan konfigurasi dengan memuat variabel lingkungan dan mengurai berkas pengaturan:
import os
 import yaml
 from pathlib import Path
 from dotenv import load_dotenv
 from graphrag.config.create_graphrag_config import create_graphrag_config

 ROOT_DIR = Path(".")

 # Load environment variables and config
 load_dotenv(ROOT_DIR / ".env")
 with open(ROOT_DIR / "settings.yaml") as f:
 	yaml_content = f.read()
 yaml_content = os.path.expandvars(yaml_content)  # Expand ${VAR} references
 settings = yaml.safe_load(yaml_content)
 config = create_graphrag_config(values=settings, root_dir=str(ROOT_DIR))
Selanjutnya, muat semua data yang diindeks dari berkas parquet. GraphRAG menyimpan entitas, relasi, komunitas, dan potongan teks secara terpisah:
import pandas as pd

 output_dir = ROOT_DIR / "output"
 entities = pd.read_parquet(output_dir / "entities.parquet")
 communities = pd.read_parquet(output_dir / "communities.parquet")
 community_reports = pd.read_parquet(output_dir / "community_reports.parquet")
 text_units = pd.read_parquet(output_dir / "text_units.parquet")
 relationships = pd.read_parquet(output_dir / "relationships.parquet")

 print(f"Loaded {len(entities)} entities, {len(relationships)} relationships")
Loaded 74 entities, 89 relationshipsTerakhir, jalankan kueri menggunakan API async. Fungsi local_search menerima semua dataframe plus parameter kueri:
import asyncio
 from graphrag.api import local_search

 async def run_query(query: str):
 	response, context = await local_search(
     	config=config,
     	entities=entities,
     	communities=communities,
         community_reports=community_reports,
     	text_units=text_units,
     	relationships=relationships,
     	covariates=None,
     	community_level=2,
     	response_type="Multiple Paragraphs",
     	query=query,
 	)
 	return response

 query = "What advice do the essays give about finding startup ideas?"
 response = asyncio.run(run_query(query))
 print(response)
The essays provide several valuable insights into finding startup ideas:
Focus on Growth: A startup is designed to grow quickly. Founders should commit
to seeking ideas that can scale significantly, as this distinguishes startups
from ordinary businesses.
Identify Unmet Needs: Successful startups arise from recognizing problems that
need solving. Founders who can see different problems, particularly those
addressable through technology, are more likely to develop effective solutions.
Leverage Personal Insights: Many successful startups originate from the unique
insights of their founders, often stemming from personal experiences or
frustrations. This personal connection leads to more authentic solutions.
Explore Overlooked Markets: Founders should think outside the box and explore
markets that may be overlooked. Successful startups often emerge from ideas
that seem obvious to the founders but aren't yet recognized broadly.API Python memberi Anda kendali penuh atas data mana yang dimuat, tingkat komunitas mana yang diquery, dan bagaimana memformat respons. Untuk aplikasi yang memerlukan logika pengambilan khusus atau integrasi dengan sistem yang ada, ini jalur yang tepat.
RAG tradisional bekerja baik sampai tidak lagi. Anda akan tahu ketika pengguna menanyakan tema atau pola dan mendapatkan tumpukan potongan yang longgar kaitannya alih-alih jawaban koheren. Itulah masalah yang diselesaikan GraphRAG dengan menukar potongan menjadi knowledge graph dengan ringkasan komunitas yang dihitung sebelumnya.
Namun biayanya nyata. Pengindeksan menghabiskan banyak panggilan LLM, dan pencarian global juga tidak murah. Untuk koleksi dokumen kecil atau pencarian langsung, tetaplah dengan pencarian vektor.
Tetapi jika korpus Anda memiliki koneksi kaya antar entitas dan pengguna Anda peduli pada koneksi tersebut, GraphRAG akan terbayar. Pilih tipe kueri sesuai pertanyaannya: global untuk tema, lokal untuk entitas spesifik, DRIFT saat Anda membutuhkan keduanya. Implementasinya tidak rumit setelah Anda mencobanya sekali, dan output parquet memudahkan inspeksi dan debug.
Belajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



