
{count, plural, one {कोर्स} other {कोर्स}}
LangChain के साथ Retrieval Augmented Generation (RAG)
{hours} घंटा
21K
पारंपरिक RAG सिस्टम अर्थ-समानता के आधार पर दस्तावेज़ों के हिस्से निकालते हैं, जो सीधे-सीधे सवालों के लिए अच्छा काम करता है। लेकिन जब क्वेरी में कई दस्तावेज़ों में बिखरी जानकारी को समेटना या जुड़े हुए कॉन्सेप्ट्स पर तर्क करना ज़रूरी हो, तो वेक्टर सर्च कम पड़ जाती है। सिस्टम टुकड़े तो निकालता है, पर उनके आपसी रिश्ते को नहीं समझता।
GraphRAG दस्तावेज़ों को अलग-थलग हिस्सों की तरह नहीं देखता। यह एक नॉलेज ग्राफ़ बनाता है जो एंटिटीज़ और उनके रिश्तों को कैप्चर करता है। यह संरचना सिस्टम को कनेक्शनों पर चलने और कई स्रोतों से जानकारी जोड़कर जवाब देने देती है। यह उन्नत RAG तकनीकों में से एक है जो बेसिक रीट्रीवल की सीमाओं को संबोधित करती हैं।
GraphRAG एक रीट्रीवल-ऑगमेंटेड जनरेशन तकनीक है जो दस्तावेज़ों को वेक्टर एम्बेडिंग्स की बजाय नॉलेज ग्राफ़ के रूप में दर्शाती है। टेक्स्ट को स्वतंत्र रूप से खोजे जाने वाले हिस्सों में तोड़ने के बजाय, GraphRAG एंटिटीज़ (जैसे व्यक्ति, संगठन, कॉन्सेप्ट, घटनाएँ) और उनके बीच के रिश्ते निकालकर इस जानकारी को एक आपस में जुड़े ग्राफ़ ढांचे में संगठित करती है।
इसके बाद GraphRag सिस्टम समुदाय-पहचान एल्गोरिद्म का उपयोग कर संबंधित एंटिटीज़ के क्लस्टर तलाशता है और इन्हें पदानुक्रमित स्तरों पर संक्षेपों में बदलता है। जब कोई क्वेरी आती है, तो GraphRAG या तो लक्षित सवालों के लिए विशिष्ट एंटिटी-नेबरहुड्स में ट्रैवर्स करती है या पूरे कॉर्पस के संश्लेषण के लिए समुदाय-संक्षेपों पर मैप-रिड्यूस चलाती है।
अब ज़रा मैकेनिक्स पर करीब से नज़र डालते हैं। इससे समझेंगे कि ग्राफ़-आधारित रीट्रीवल क्यों आया और यह कौन-सी कमी पूरी करता है।
पारंपरिक RAG की मूल समस्या रीट्रीवल या जनरेशन नहीं, बल्कि रिप्रेज़ेंटेशन है। दस्तावेज़ हिस्सों में बँट जाते हैं, और हर हिस्सा एम्बेडिंग स्पेस में तैरता हुआ एक अलग-थलग वेक्टर बन जाता है। मूल दस्तावेज़ में मौजूद संरचना—हेडिंग्स, नैरेटिव फ्लो, किस पैराग्राफ़ ने किसकी ओर इशारा किया—सब कुछ समतल हो जाता है।
यह उन सवालों में दिक्कत बनता है जिनमें जानकारी जोड़नी पड़ती है। पूछिए, "इन दस्तावेज़ों में मुख्य थीम क्या हैं?" और वेक्टर सर्च ऐसे हिस्से लौटाएगा जिनमें "themes" शब्द या उससे जुड़े टर्म्स हैं। पर प्रासंगिक टुकड़े ढूँढ लेना, कॉर्पस-पार पैटर्न समझ लेने के बराबर नहीं है। सिस्टम के पास जानकारी को बड़े स्तर पर जोड़ने का तरीका नहीं है क्योंकि वह केवल अलग-अलग हिस्से देखता है, पूरी तस्वीर नहीं।
मल्टी-हॉप रीज़निंग में भी यही दीवार आती है। मान लीजिए जवाब कॉन्सेप्ट A को B और फिर C से जोड़ने पर निर्भर है। पारंपरिक RAG हर हिस्से को क्वेरी से समानता के आधार पर स्वतंत्र रूप से निकालता है। अगर B सवाल से पर्याप्त समान नहीं है, तो वह निकलेगा ही नहीं और कड़ी टूट जाएगी। सिस्टम सिरों तक तो पहुँचता है पर बीच का रास्ता नहीं पकड़ पाता।
एक और बात है रीट्रीवल-कॉन्टेक्स्ट का बेमेल। आप बीस बहुत प्रासंगिक हिस्से निकाल सकते हैं, पर उन्हें प्रॉम्प्ट में ठूँस देने से यह गारंटी नहीं कि LLM उनका उपयोग अच्छे से करेगा। "लॉस्ट इन द मिडल" पेपर दिखाता है कि LLM प्रायः अपने कॉन्टेक्स्ट विंडो की शुरुआत और अंत की जानकारी पर ध्यान देते हैं और बीच की चीज़ें नज़रअंदाज़ हो जाती हैं। ज़्यादा रीट्रीवल का मतलब अपने-आप बेहतर जवाब नहीं होता।
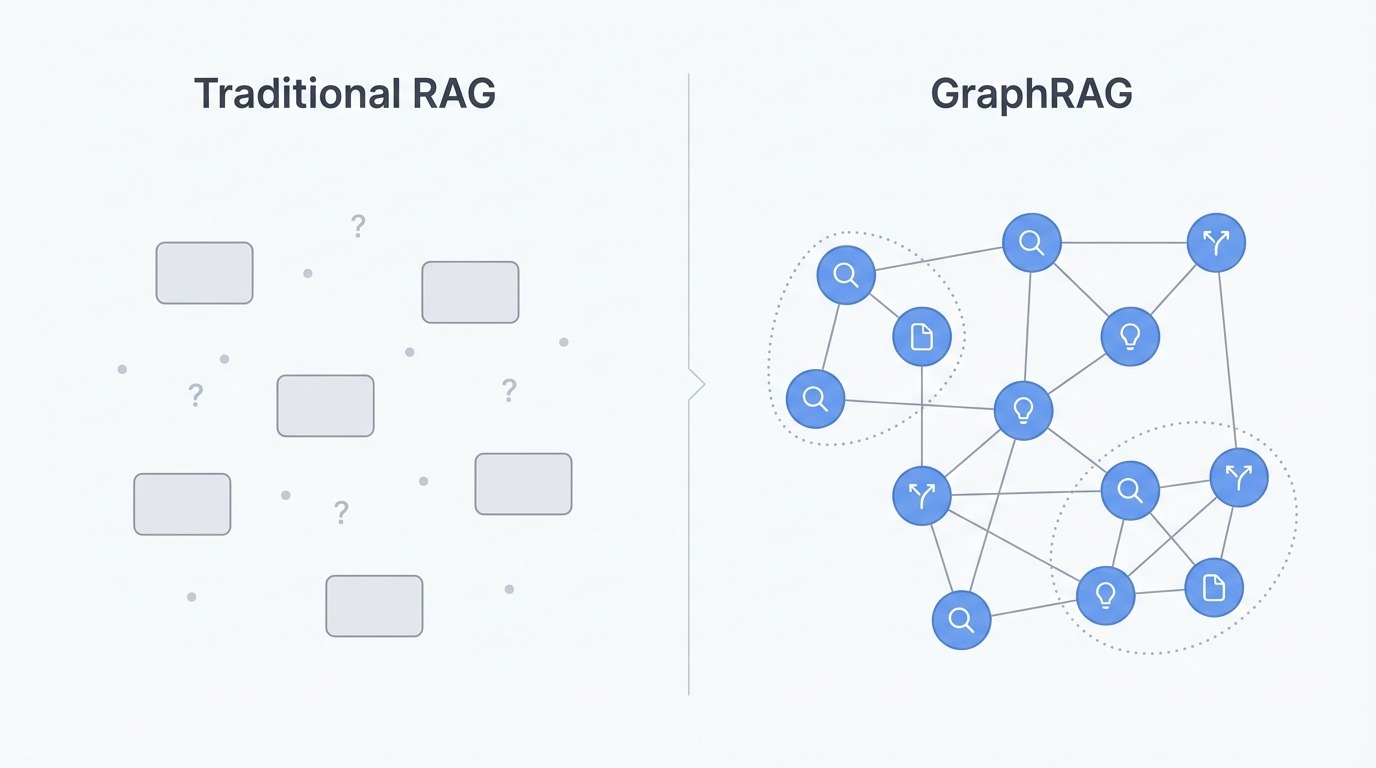
पारंपरिक RAG बनाम GraphRAG की तुलना। चित्र: लेखक द्वारा।
GraphRAG इन सीमाओं को रिप्रेज़ेंटेशन ही बदलकर दूर करता है। हिस्सों के बजाय, यह एक नॉलेज ग्राफ़ बनाता है जहाँ एंटिटीज़ नोड्स बनती हैं और रिश्ते एजेज़। लोग, संगठन, स्थान, कॉन्सेप्ट और घटनाएँ स्रोत दस्तावेज़ों से उनके आपसी कनेक्शनों सहित निकाली जाती हैं। इससे वह संरचना बची रहती है जिसे चंकिंग खत्म कर देती है।
ग्राफ़ बन जाने के बाद, सिस्टम समुदाय-पहचान (आम तौर पर Leiden एल्गोरिद्म) लागू करके संबंधित एंटिटीज़ को समूहों में क्लस्टर करता है। ये क्लस्टर कई स्तरों पर बनते हैं—कुछ सघन और विशिष्ट, कुछ व्यापक और थीमैटिक। ये समूह दस्तावेज़ी सीमाओं या हिस्सों के आकार से नहीं, बल्कि डेटा में वास्तविक कनेक्शनों से बनते हैं।
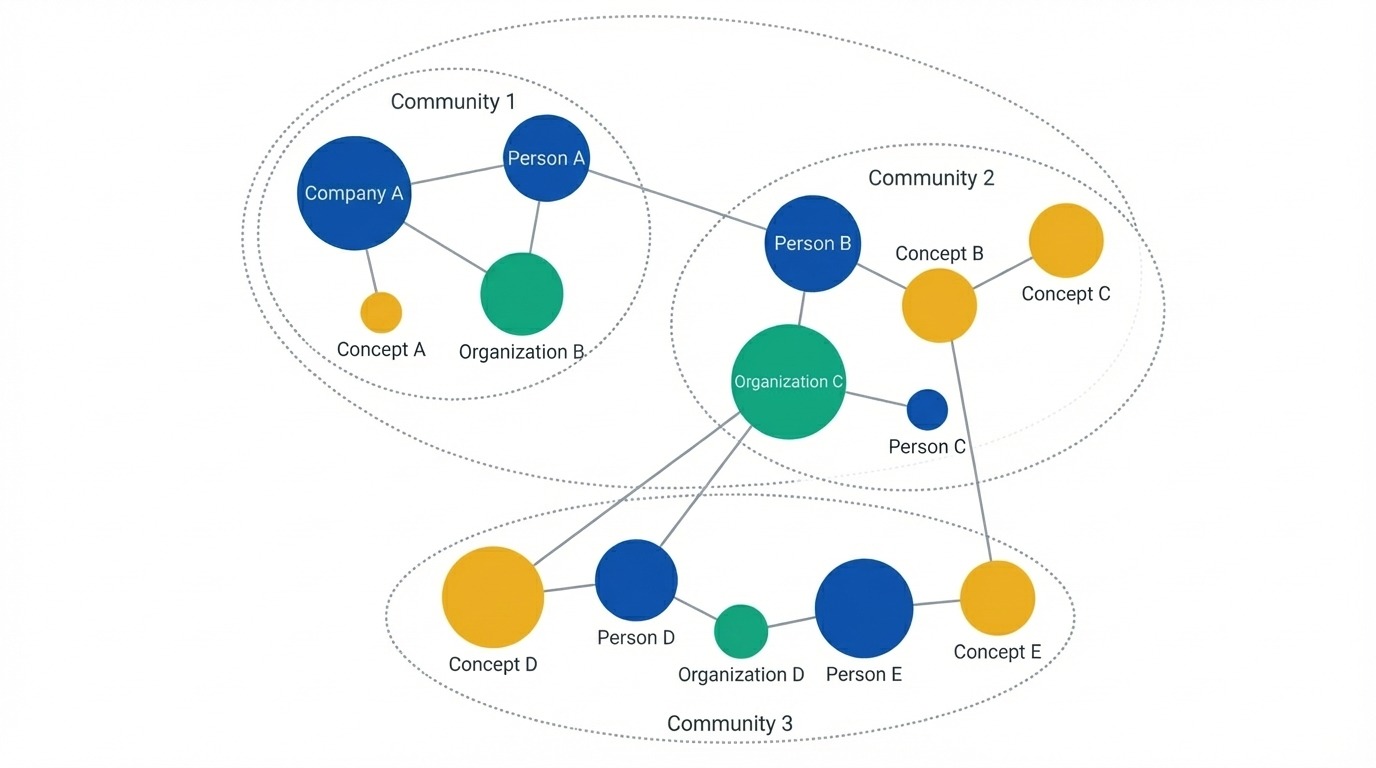
नॉलेज ग्राफ़ जिसमें एंटिटीज़ नोड्स के रूप में दिखती हैं। चित्र: लेखक द्वारा।
वैश्विक सवालों के लिए, GraphRAG उपयोगकर्ता क्वेरी आने से पहले ही हर समुदाय के संक्षेप तैयार कर देता है। जब कोई पूछता है "मुख्य थीम क्या हैं?", सिस्टम मैचिंग टेक्स्ट नहीं ढूँढ़ता। इसके बजाय यह मैप-रिड्यूस ऑपरेशन चलाता है: हर समुदाय-संक्षेप अपने ग्राफ़ के हिस्से के आधार पर आंशिक जवाब बनाता है, फिर सभी आंशिक जवाब मिलकर अंतिम उत्तर बनाते हैं। इससे GraphRAG हज़ारों हिस्से निकाले बिना पूरे कॉर्पस पर तर्क कर पाता है।
मल्टी-हॉप सवालों के लिए समानता-आधारित खोज की जगह ग्राफ़ ट्रैवर्सल आती है। सिस्टम एंटिटी से एंटिटी तक एजेज़ पर चल सकता है, उन संकल्पनात्मक कड़ियों का पीछा करते हुए जिन्हें वेक्टर सर्च छोड़ देती है। अगर A से B और B से C जुड़ा है, तो ग्राफ़ उस रास्ते को जानता है और उसे फ़ॉलो कर सकता है।
जब आपके सवालों में पूरे कॉर्पस की समझ ज़रूरी हो, तब GraphRAG फ़ायदा देता है। अगर उपयोगकर्ता अक्सर बड़ी दस्तावेज़-संग्रहों में थीम, पैटर्न या संक्षेप पूछते हैं, तो ग्राफ़-आधारित रीट्रीवल, चंकिंग अप्रोच से बेहतर काम करेगा। यही बात उन डोमेनों पर भी लागू होती है जहाँ एंटिटीज़ के रिश्ते समृद्ध होते हैं—जैसे कंपनी के ऑर्ग चार्ट, शोध उद्धरण नेटवर्क, या कानूनी केस इतिहास जहाँ कनेक्शनों का पीछा करना अहम है।
साधारण तथ्य-जांच ("X का फ़ोन नंबर क्या है?") या छोटे दस्तावेज़-सेट के लिए, पारंपरिक RAG ठीक है और सस्ता भी। GraphRAG में इंडेक्सिंग समय और LLM कॉल—दोनों का ओवरहेड जुड़ता है, इसलिए लाभ निवेश के लायक होना चाहिए। पहले मानक RAG से शुरू करें और जब उसकी सीमाएँ आएँ, तब GraphRAG पर जाएँ।
नीचे तालिका में समझौते का सार है। पारंपरिक RAG सादगी और लागत में जीतता है, जबकि सिंथेसिस या कनेक्टेड रीज़निंग चाहिए तो GraphRAG आगे निकलता है।
|
पहलू |
पारंपरिक RAG |
GraphRAG |
|
डेटा का प्रतिनिधित्व |
अलग-थलग टेक्स्ट हिस्से वेक्टर के रूप में |
एंटिटीज़ और रिश्तों वाला नॉलेज ग्राफ़ |
|
संरचना का संरक्षण |
चंकिंग के दौरान खो जाती है |
ग्राफ़ एजेज़ के माध्यम से बनी रहती है |
|
वैश्विक क्वेरीज़ |
कमज़ोर (टुकड़े निकालता है, संयोजित नहीं कर पाता) |
मज़बूत (समुदाय-संक्षेपों पर मैप-रिड्यूस) |
|
मल्टी-हॉप रीज़निंग |
सीमित (स्वतंत्र हिस्सों का रीट्रीवल) |
मौलिक (ग्राफ़ ट्रैवर्सल कनेक्शनों का पीछा करता है) |
|
इंडेक्सिंग लागत |
कम (सिर्फ एम्बेडिंग) |
उच्च (LLM एक्सट्रैक्शन + एम्बेडिंग + क्लस्टरिंग) |
|
क्वेरी लागत |
कम |
बदलती (स्थानीय सस्ती, वैश्विक महंगी) |
|
सर्वोत्तम उपयोग |
तथ्य-जांच, छोटे कॉर्पस |
थीमैटिक सवाल, कनेक्टेड डोमेन |
पाइपलाइन के दो चरण हैं: इंडेक्सिंग ग्राफ़ बनाती है, क्वेरींग उसका उपयोग करती है।
इंडेक्सिंग पाँच चरणों में कच्चे दस्तावेज़ों को नॉलेज संरचना में बदलती है:
सबसे ज़्यादा LLM कॉल एक्सट्रैक्शन चरण में होती हैं। हर चंक को एक प्रॉम्प्ट से प्रोसेस किया जाता है जो मॉडल से एंटिटीज़ और रिश्ते पहचानने को कहता है। जिस चंक में "OpenAI ने GPT-4 जारी किया" है, वहाँ दोनों के एंटिटी बनेंगे और उन्हें जोड़ने वाला रिश्ता भी। इसी पास में रिलेशनशिप टाइप भी कैप्चर होता है। चूँकि हर चंक के लिए LLM कॉल चाहिए, इंडेक्सिंग पाइपलाइन का महंगा हिस्सा है। क्वेरी समय अपेक्षाकृत सस्ता पड़ता है क्योंकि भारी काम पहले ही हो चुका होता है।
ग्राफ़ कंस्ट्रक्शन एंटिटी रेज़ोल्यूशन सँभालता है, जो पेचीदा हो सकता है। "OpenAI", "Open AI" और "the company" अलग-अलग हिस्सों में एक ही एंटिटी को दर्शा सकते हैं। सिस्टम इन डुप्लिकेट्स को मिलाकर साफ़ ग्राफ़ बनाता है।
कम्युनिटी डिटेक्शन Leiden एल्गोरिद्म लगाकर कई स्तरों पर प्राकृतिक समूह बनाती है। लेवल 0 में 5–10 संबंधित एंटिटीज़ के सघन क्लस्टर हो सकते हैं। ऊँचे स्तर उन्हें व्यापक थीमों में समूहित करते हैं। AI कंपनियों के कॉर्पस में लेवल-0 पर अलग-अलग कंपनियाँ, लेवल-1 पर "AI लैब्स" और "चिप निर्माता", और लेवल-2 पर पूरा टेक इकोसिस्टम आ सकता है। हर कम्युनिटी को फिर LLM-जनित संक्षेप मिलता है जो बताता है कि वह क्लस्टर क्या दर्शाता है। ये संक्षेप उपयोगकर्ता क्वेरी से पहले ही प्री-कम्प्यूट किए जाते हैं।
अंतिम नतीजा कोई रीट्रीवल इंडेक्स नहीं, बल्कि एक संरचित प्रतिनिधित्व है: ग्राफ़ प्लस संक्षेप—विभिन्न तरीकों से क्वेरी करने के लिए तैयार।
ग्राफ़ बन जाने के बाद, क्वेरी अलग-अलग रीट्रीवल रणनीतियों तक रूट होती हैं:
निकाला गया कंटेंट (संक्षेप, एंटिटीज़, रिश्ते, स्रोत टेक्स्ट) एक प्रॉम्प्ट में जोड़ा जाता है, और LLM अंतिम उत्तर जनरेट करता है। हर रणनीति अलग-अलग सवालों के लिए उपयुक्त है, जिनका विवरण आगे है।
GraphRAG तीन अलग रीट्रीवल रणनीतियाँ देता है, और हर एक अलग तरह के सवालों के लिए उपयुक्त है। सही चुनाव इस पर निर्भर करता है कि आपको व्यापक संश्लेषण चाहिए, किसी विशिष्ट एंटिटी की जानकारी चाहिए, या दोनों का मेल।
ग्लोबल सर्च वे सवाल हल करता है जिनमें पूरे कॉर्पस की समझ चाहिए। जैसे "इस दस्तावेज़-संग्रह में मुख्य थीम क्या हैं?" या "इन रिपोर्ट्स में कौन-से पैटर्न उभरते हैं?"—यह जानकारी हर जगह से समेटनी पड़ती है, कुछ मिलते-जुलते हिस्से निकालकर नहीं।
इसका मैकेनिज़्म कम्युनिटी संक्षेपों पर मैप-रिड्यूस है। मैप चरण में हर कम्युनिटी संक्षेप को स्वतंत्र रूप से प्रोसेस किया जाता है: सिस्टम LLM से प्रासंगिक बिंदु निकालने और उनकी महत्ता रेट करने को कहता है। रिड्यूस चरण में सभी कम्युनिटीज़ से सर्वाधिक-रेटेड बिंदुओं को अंतिम प्रॉम्प्ट में जोड़ा जाता है, और LLM उन्हें एक सुगठित उत्तर में पिरो देता है।
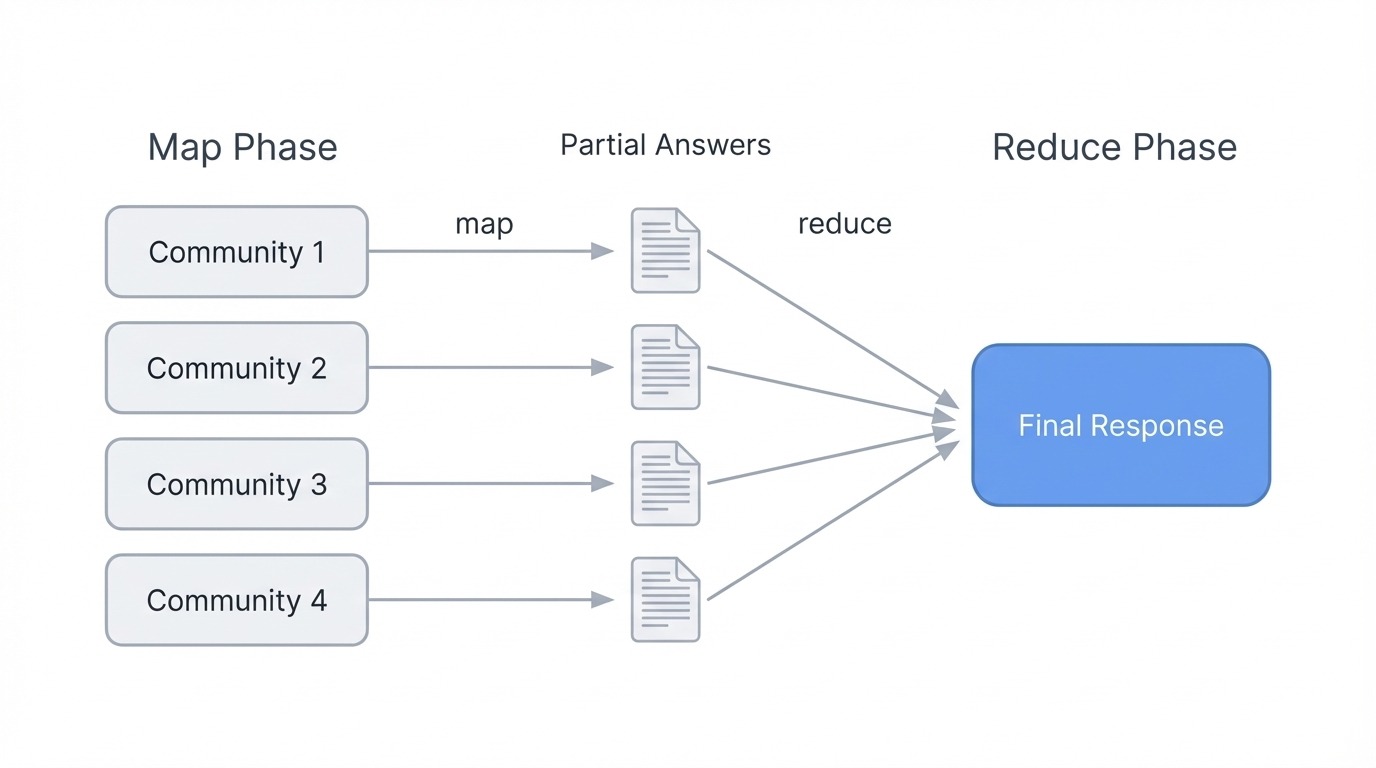
मैप-रिड्यूस के साथ GraphRAG ग्लोबल सर्च। चित्र: लेखक द्वारा
यह इसलिए काम करता है क्योंकि कम्युनिटी संक्षेप पहले से बताते हैं कि हर एंटिटी-क्लस्टर किस बारे में है। सिस्टम को हज़ारों हिस्से निकालने की ज़रूरत नहीं पड़ती। इसके बजाय, यह प्री-कम्प्यूटेड विवरणों पर तर्क करता है जो आपके चुने पदानुक्रम स्तर पर ग्राफ़ की संरचना दर्शाते हैं। निचले स्तर (छोटे, सघन समुदाय) ज़्यादा विवरण देते हैं लेकिन LLM कॉल अधिक लगती हैं। ऊँचे स्तर (विस्तृत समूह) तेज़ चलते हैं पर बारीकियाँ छूट सकती हैं।
ग्लोबल सर्च अन्य मोड्स की तुलना में संगणकीय रूप से भारी है क्योंकि यह सभी कम्युनिटीज़ को प्रोसेस करता है। इसे तभी उपयोग करें जब सवालों में सचमुच पूरे कॉर्पस की समझ चाहिए, न कि विशिष्ट तथ्यों की।
लोकल सर्च एंटिटी-विशिष्ट सवालों को सँभालता है। "कैमोमाइल के उपचारात्मक गुण क्या हैं?" या "Acme Corp ने अपने Q3 अर्निंग्स के बारे में क्या घोषणा की?"—ये विशेष एंटिटीज़ और उनसे जुड़ी जानकारी को निशाना बनाते हैं।
रीट्रीवल प्रक्रिया क्वेरी से सम्बंधित ग्राफ़ की एंटिटीज़ पहचानने से शुरू होती है। ये एंटिटीज़ ट्रैवर्सल के एंट्री पॉइंट बनती हैं। हर प्रारंभिक नोड से, सिस्टम जुड़े हुए एंटिटीज़, उनके बीच के रिश्ते, उनसे जुड़े दावे या तथ्य, और वे जिन कम्युनिटी रिपोर्ट्स में हैं—सब खींचता है। यह उन एंटिटीज़ से लिंक्ड मूल टेक्स्ट हिस्से भी निकालता है, जिससे LLM को संरचित ग्राफ़ डेटा और स्रोत टेक्स्ट—दोनों मिलते हैं।
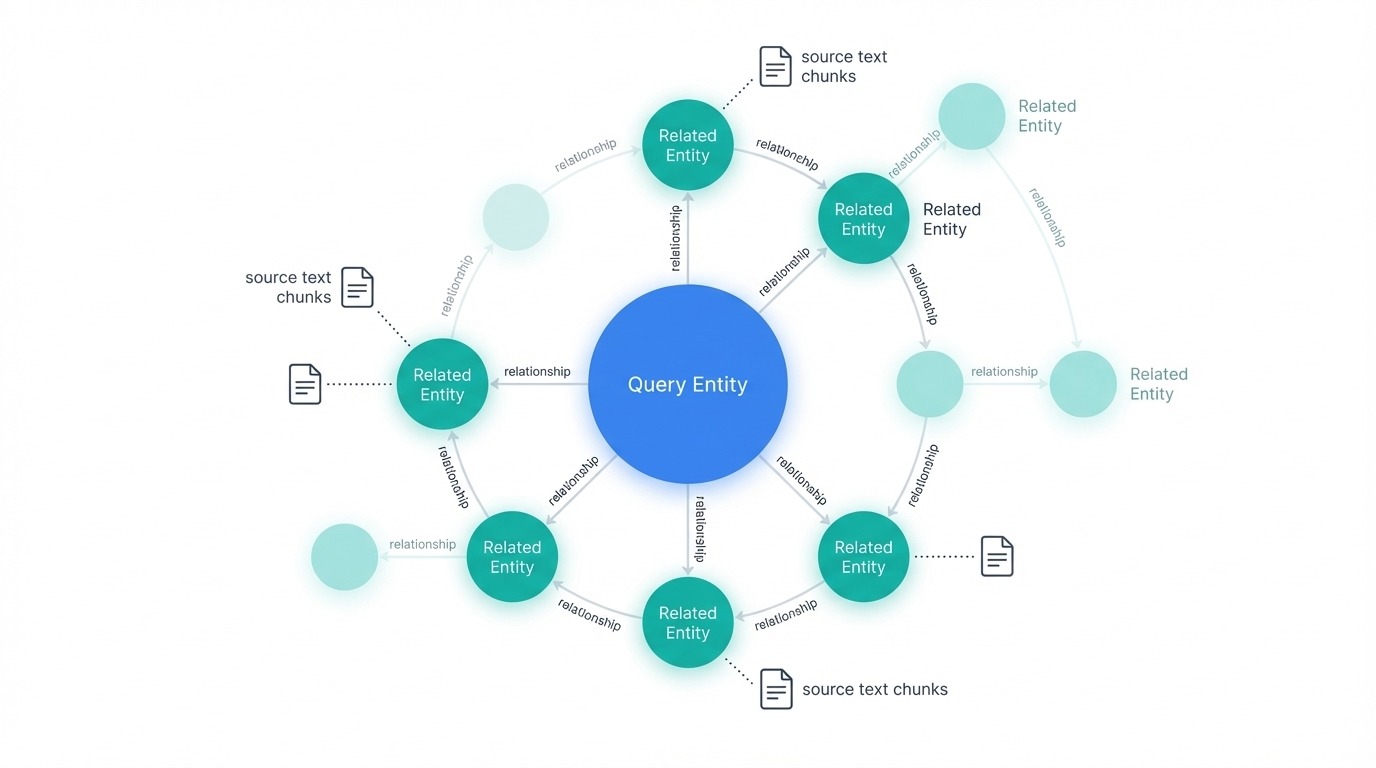
संबंधित नोड्स के साथ GraphRAG लोकल सर्च। चित्र: लेखक द्वारा
यह सारी संभावित जानकारी रैंक और फ़िल्टर करके कॉन्टेक्स्ट विंडो में फिट की जाती है। फिर LLM निकाले गए कंटेंट पर आधारित उत्तर बनाता है। क्योंकि लोकल सर्च पूरे ग्राफ़ के बजाय उसके एक नेबरहुड पर केंद्रित रहती है, यह ग्लोबल सर्च से तेज़ और सस्ती होती है।
जब सवाल किसी खास चीज़, व्यक्ति, संगठन या कॉन्सेप्ट से जुड़े हों, तो लोकल सर्च चुनें।
DRIFT (Dynamic Reasoning and Inference with Flexible Traversal) ग्लोबल और लोकल के बीच बैठता है। यह वे जटिल क्वेरी सँभालता है जिनमें व्यापक संदर्भ और विशिष्ट विवरण—दोनों चाहिए।
प्रक्रिया तीन चरणों की है। पहले, प्राइमर चरण में क्वेरी की सबसे अर्थ-संबंधी कम्युनिटी संक्षेपों से तुलना कर एक प्रारंभिक उत्तर और फॉलो-अप सवाल बनाए जाते हैं। दूसरे, फॉलो-अप चरण में उन्हीं सवालों पर लोकल सर्च लगाकर विशिष्ट क्षेत्रों में गहराई से जाते हैं, बीच के उत्तर और अधिक लक्षित फॉलो-अप बनाते हैं। तीसरे, आउटपुट चरण में सब कुछ मिलाकर ऐसे रैंक्ड नतीजे दिए जाते हैं जो वैश्विक अंतर्दृष्टि और स्थानीय विशिष्टताओं का संतुलन रखते हैं।
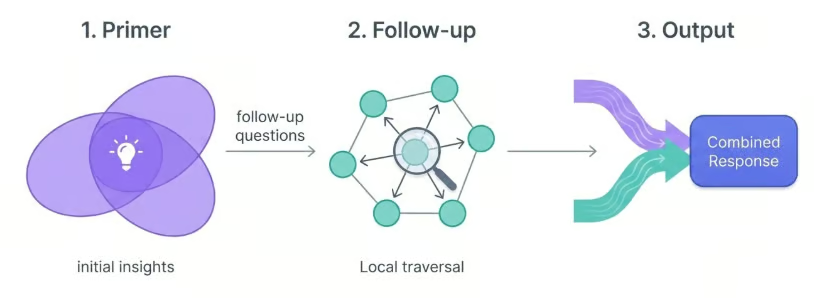
GraphRAG DRIFT सर्च की तीन-चरणीय प्रक्रिया। चित्र: लेखक द्वारा।
DRIFT की उपयोगिता इसकी विस्तृत शुरुआती बिंदु से आती है। कम्युनिटी-स्तरीय संदर्भ से शुरू करके, यह लोकल सर्च की तुलना में तथ्यों की व्यापक शृंखला निकालता है। पर लोकल ट्रैवर्सल से परिष्कृत होकर, यह फुल ग्लोबल सर्च की लागत से बच जाता है।
DRIFT का उपयोग उन सवालों के लिए करें जैसे "कंपनी X की चुनौतियाँ व्यापक उद्योग प्रवृत्तियों से कैसे तुलना करती हैं?" जहाँ आपको विशिष्ट एंटिटी की जानकारी और थीमैटिक संदर्भ—दोनों चाहिए।
|
पहलू |
ग्लोबल |
लोकल |
DRIFT |
|
सर्वोत्तम उपयोग |
कॉर्पस-पार थीम और पैटर्न |
विशिष्ट एंटिटी सवाल |
दोनों की ज़रूरत वाले जटिल सवाल |
|
मैकेनिज़्म |
कम्युनिटी संक्षेपों पर मैप-रिड्यूस |
एंटिटी नेबरहुड ट्रैवर्सल |
प्राइमर → फॉलो-अप → आउटपुट चरण |
|
गति |
सबसे धीमी (सभी कम्युनिटीज़ प्रोसेस) |
सबसे तेज़ (फ़ोकस्ड ट्रैवर्सल) |
मध्यम (विस्तृत से शुरू, संकुचित) |
|
लागत |
सबसे अधिक |
सबसे कम |
मध्यम |
|
उदाहरण क्वेरी |
"मुख्य थीम क्या हैं?" |
"कंपनी X ने क्या घोषणा की?" |
"X उद्योग प्रवृत्तियों से कैसे तुलना करता है?" |
GraphRAG एक बुनियादी वेक्टर सर्च भी देता है जो सरल क्वेरीज़ के लिए फ़ॉलबैक बनता है जहाँ ग्राफ़ ट्रैवर्सल ज़रूरत से ज़्यादा होगा। लेकिन ज़्यादातर उपयोग मामलों में ग्लोबल, लोकल और DRIFT में से चुनना पर्याप्त होता है।
यह अनुभाग Microsoft के रेफ़रेंस इम्प्लीमेंटेशन के साथ GraphRAG सिस्टम बनाने की प्रक्रिया समझाता है। उदाहरण चलाने योग्य और लागत उचित रखने के लिए हम स्टार्टअप्स पर Paul Graham के छोटे से कॉर्पस के साथ काम करेंगे। यदि आप नॉलेज ग्राफ़ और रीट्रीवल सिस्टम को साथ मिलाने में नए हैं, तो नॉलेज ग्राफ़ RAG ट्यूटोरियल बुनियादी अवधारणाएँ कवर करता है।
एक प्रोजेक्ट डायरेक्टरी बनाएँ और उसे uv से इनिशियलाइज़ करें, फिर graphrag पैकेज इंस्टॉल करें। लाइब्रेरी की निर्भरताएँ बड़ी हैं (PyTorch सहित 237 पैकेज), इसलिए इंस्टॉलेशन में लगभग पाँच मिनट लग सकते हैं:
mkdir ragtest && cd ragtest
 uv init
 uv add graphrag
 graphrag init --root .
यह प्रोजेक्ट संरचना तैयार करता है:
ragtest/
 ├── .env                	# API key configuration
 ├── settings.yaml       	# Pipeline settings
 ├── prompts/            	# LLM prompt templates
 │   ├── extract_graph.txt
 │   ├── summarize_descriptions.txt
 │   └── ...
 └── input/              	# Your source documents go here
prompts/ डायरेक्टरी में वे टेम्पलेट्स होते हैं जिन्हें GraphRAG एंटिटी एक्सट्रैक्शन और समरीकरण के लिए उपयोग करता है। आप इन्हें डोमेन-विशिष्ट ज़रूरतों के अनुसार कस्टमाइज़ कर सकते हैं, हालाँकि डिफ़ॉल्ट सामान्य टेक्स्ट के लिए अच्छे से काम करते हैं।
टेक्स्ट फ़ाइलें input/ डायरेक्टरी में जोड़ें। इस ट्यूटोरियल के लिए, हम स्टार्टअप्स पर Paul Graham के तीन निबंधों का उपयोग करेंगे। उनकी वेबसाइट में न्यूनतम HTML है जिसमें कंटेंट <font> टैग्स में लिपटा है, इसलिए एक सिंपल पार्सर टेक्स्ट को साफ़-सुथरा निकाल देता है:
import urllib.request
 from html.parser import HTMLParser

 class TextExtractor(HTMLParser):
 	def __init__(self):
     	super().__init__()
     	self.text = []
     	self.in_font = False

 	def handle_starttag(self, tag, attrs):
     	if tag == 'font':
         	self.in_font = True

 	def handle_endtag(self, tag):
     	if tag == 'font':
         	self.in_font = False

 	def handle_data(self, data):
     	if self.in_font:
         	self.text.append(data)

 essays = {
 	"startupideas": "http://paulgraham.com/startupideas.html",
     "do_things_that_dont_scale": "http://paulgraham.com/ds.html",
 	"startup_growth": "http://paulgraham.com/growth.html"
 }

 for name, url in essays.items():
 	with urllib.request.urlopen(url) as response:
     	html = response.read().decode('utf-8')
 	parser = TextExtractor()
 	parser.feed(html)
 	text = ' '.join(parser.text)
 	with open(f"input/{name}.txt", "w") as f:
     	f.write(text)
 	print(f"Saved {name}.txt ({len(text.split())} words)")
Saved startupideas.txt (3000 words)
Saved do_things_that_dont_scale.txt (3000 words)
Saved startup_growth.txt (3000 words)तीन थीमैटिक रूप से जुड़े निबंधों में कुल लगभग 9,000 शब्द—इतने कि बिना बड़ा API खर्च किए सार्थक एंटिटी रिश्ते दिख सकें।
अपना OpenAI API key जोड़ने के लिए .env एडिट करें:
GRAPHRAG_API_KEY=your-openai-api-key-hereडिफ़ॉल्ट settings.yaml बॉक्स से बाहर काम करता है, पर आप मॉडल समायोजित करना चाह सकते हैं। फ़ाइल डिफ़ॉल्ट रूप से gpt-4o-mini उपयोग करती है, जो लागत और गुणवत्ता में संतुलन रखता है। सभी उपलब्ध विकल्पों के लिए पूर्ण कॉन्फ़िगरेशन संदर्भ देखें:
models:
   default_chat_model:
 	type: openai_chat
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: gpt-4o-mini
 	model_supports_json: true
 	concurrent_requests: 25

   default_embedding_model:
 	type: openai_embedding
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: text-embedding-3-small
कॉन्फ़िग में अन्य उल्लेखनीय सेटिंग्स:
chunks:
   size: 1200  	# Tokens per chunk
   overlap: 100	# Overlap between chunks

 extract_graph:
   entity_types: [organization, person, geo, event]
   max_gleanings: 1	# Additional extraction passes

 cluster_graph:
max_cluster_size: 10नॉलेज ग्राफ़ बनाइए:
graphrag index --root .पाइपलाइन दस्तावेज़ों को एंटिटी एक्सट्रैक्शन, ग्राफ़ कंस्ट्रक्शन और कम्युनिटी डिटेक्शन से गुज़ारती है:
├── Loading Input (InputFileType.text) - 3 files loaded (0 filtered) ───
 ├── create_base_text_units
 ├── create_final_documents
 ├── extract_graph
 ├── finalize_graph
 ├── create_final_entities
 ├── create_final_relationships
 ├── create_final_text_units
 ├── create_base_entity_graph
 ├── create_communities
 ├── create_final_communities
 ├── create_community_reports
 ├── generate_text_embeddings
 ⠋ GraphRAG Indexer
 ├── All workflows completed successfully
हर चरण पिछले पर आधारित होता है। extract_graph चरण में ज़्यादातर LLM कॉल होती हैं, जबकि create_communities में Leiden एल्गोरिद्म लागू कर संबंधित एंटिटीज़ को क्लस्टर किया जाता है।
हमारे तीन निबंधों के साथ, इंडेक्सिंग लगभग दो मिनट में पूरी हो जाती है। आप पार्के फ़ाइलें लोड करके या रो काउंट देखकर नतीजों की जाँच कर सकते हैं:
आउटपुट output/ में पार्के फ़ाइलों के रूप में रहता है:
output/
 ├── documents.parquet
 ├── entities.parquet
 ├── relationships.parquet
 ├── text_units.parquet
 ├── communities.parquet
 ├── community_reports.parquet
 └── lancedb/      	# Vector embeddings
पार्के फ़ॉर्मेट सब कुछ पोर्टेबल रखता है। आप इन फ़ाइलों को pandas से लोड करके एंटिटीज़ देखें, रिश्ते ब्राउज़ करें, या एक्सट्रैक्शन समस्याएँ डिबग करें। पूरा प्रोजेक्ट डायरेक्टरी वर्ज़न कंट्रोल के लिए पर्याप्त छोटा है (इस कॉर्पस के लिए 10MB से कम), बस अपनी API key वाली .env फ़ाइल को एक्सक्लूड करें।
GraphRAG तीन क्वेरी मोड देता है। चलिए हर एक आज़माते हैं।
ग्लोबल सर्च थीमैटिक सवालों के लिए:
graphrag query \
 	--root . \
 	--method global \
 	--query "What are the main themes and lessons about startups in these essays?"
SUCCESS: Global Search Response:
The essays present several interconnected themes about startups:
**Growth as the defining characteristic**: A startup isn't just a new company—it's
specifically designed for rapid growth. This growth orientation shapes everything
from idea selection to daily decision-making. The essays suggest using weekly
growth rate as a compass for all strategic choices.
**The power of doing unscalable things**: Counterintuitively, successful startups
often begin with manual, labor-intensive approaches. Stripe's founders would
physically set up new users on the spot. Airbnb's founders went door-to-door
recruiting hosts. These unscalable tactics bootstrap the initial user base.
**Ideas emerge from problems, not brainstorming**: The best startup ideas come
from founders solving their own problems or noticing gaps while "living in the
future." Deliberately trying to generate ideas tends to produce plausible-sounding
but ultimately weak concepts.
**User relationships matter early**: Early users provide irreplaceable feedback.
Founders should go beyond standard customer service to create exceptional
experiences, gathering insights that shape the product.यह जवाब तीनों निबंधों में फैली थीम्स का संश्लेषण करता है—जो पारंपरिक RAG में कई हिस्से निकालकर और प्रोसेस करके करना पड़ता। ग्लोबल सर्च ने इसकी जगह कम्युनिटी संक्षेपों से खींचकर एक सुसंगत उच्च-स्तरीय दृश्य दिया।
एंटिटी-विशिष्ट सवालों के लिए लोकल सर्च:
graphrag query \
 	--root . \
 	--method local \
 	--query "What role does Y Combinator play according to these essays?"
SUCCESS: Local Search Response:
Y Combinator functions as both an accelerator and a testing ground for startup
principles. According to the essays, YC provides:
**Funding and validation**: YC offers initial funding that lets founders focus
on building rather than fundraising. The program validates ideas through its
selection process.
**Growth measurement framework**: YC tracks startups by weekly growth rate,
with 5-7% weekly growth considered good and 10% exceptional. This metric-driven
approach forces founders to confront whether they're making real progress.
**Network effects**: B2B startups at YC gain immediate access to hundreds of
potential customers—other YC companies. Stripe leveraged this extensively in
its early days.
**Demo Day as forcing function**: The program's structure, culminating in Demo
Day presentations to investors, creates urgency that pushes founders to ship
and iterate quickly.लोकल सर्च ने Y Combinator एंटिटी से शुरू होकर ग्राफ़ में ट्रैवर्स किया, और ग्रोथ मेट्रिक्स, Stripe व Demo Day जैसे जुड़े कॉन्सेप्ट्स खींचे। जवाब YC के बारे में इन्हीं निबंधों की बातों पर आधारित रहा, न कि सामान्य ज्ञान पर।
विस्तार और विशिष्टता—दोनों चाहने वाले सवालों के लिए DRIFT सर्च:
graphrag query \
 	--root . \
 	--method drift \
 	--query "How do the essays describe the relationship between startup ideas and user problems?"
SUCCESS: Drift Search Response:
The essays establish a direct link between viable startup ideas and genuine user
problems through several mechanisms:
**Organic discovery over invention**: Rather than brainstorming ideas, founders
should notice problems they personally experience. Microsoft, Apple, Google, and
Facebook all started this way—founders building something they themselves needed.
**The "well" vs "shallow hole" distinction**: Good ideas serve a small number of
users who desperately need the solution (a narrow, deep well) rather than many
users with mild interest (a broad, shallow hole). Depth of need matters more
than breadth of appeal initially.
**Feedback loops as validation**: Engaging directly with early users reveals
whether the problem is real and the solution fits. This feedback shapes the
product more than any amount of planning.
**Problem-first, solution-second**: The essays warn against "sitcom startup
ideas"—concepts that sound plausible but don't address real pain points. A
social network for pet owners sounds reasonable but lacks urgent demand.DRIFT ने स्टार्टअप दर्शन पर कम्युनिटी-स्तरीय संदर्भ से व्यापक शुरुआत की, फिर ‘well’ एनालॉजी और ‘sitcom ideas’ जैसे विशिष्ट उदाहरणों में उतरा। नतीजा थीमैटिक अंतर्दृष्टि और स्रोत टेक्स्ट से ठोस विवरण—दोनों का मेल बना।
प्रोडक्शन सिस्टम के लिए सीधे Python API का उपयोग करें। प्रक्रिया तीन भागों में है: कॉन्फ़िगरेशन लोड करना, इंडेक्स्ड डेटा लोड करना, और क्वेरी चलाना।
पहले, परिवेश वैरिएबल्स लोड करके और सेटिंग्स फ़ाइल पार्स करके कॉन्फ़िगरेशन सेट करें:
import os
 import yaml
 from pathlib import Path
 from dotenv import load_dotenv
 from graphrag.config.create_graphrag_config import create_graphrag_config

 ROOT_DIR = Path(".")

 # Load environment variables and config
 load_dotenv(ROOT_DIR / ".env")
 with open(ROOT_DIR / "settings.yaml") as f:
 	yaml_content = f.read()
 yaml_content = os.path.expandvars(yaml_content)  # Expand ${VAR} references
 settings = yaml.safe_load(yaml_content)
 config = create_graphrag_config(values=settings, root_dir=str(ROOT_DIR))
अगला, पार्के फ़ाइलों से सारा इंडेक्स्ड डेटा लोड करें। GraphRAG एंटिटीज़, रिश्ते, कम्युनिटीज़ और टेक्स्ट हिस्सों को अलग-अलग स्टोर करता है:
import pandas as pd

 output_dir = ROOT_DIR / "output"
 entities = pd.read_parquet(output_dir / "entities.parquet")
 communities = pd.read_parquet(output_dir / "communities.parquet")
 community_reports = pd.read_parquet(output_dir / "community_reports.parquet")
 text_units = pd.read_parquet(output_dir / "text_units.parquet")
 relationships = pd.read_parquet(output_dir / "relationships.parquet")

 print(f"Loaded {len(entities)} entities, {len(relationships)} relationships")
Loaded 74 entities, 89 relationshipsअंत में, async API का उपयोग कर क्वेरी चलाएँ। local_search फ़ंक्शन सभी डेटा फ़्रेम और क्वेरी पैरामीटर्स लेता है:
import asyncio
 from graphrag.api import local_search

 async def run_query(query: str):
 	response, context = await local_search(
     	config=config,
     	entities=entities,
     	communities=communities,
         community_reports=community_reports,
     	text_units=text_units,
     	relationships=relationships,
     	covariates=None,
     	community_level=2,
     	response_type="Multiple Paragraphs",
     	query=query,
 	)
 	return response

 query = "What advice do the essays give about finding startup ideas?"
 response = asyncio.run(run_query(query))
 print(response)
The essays provide several valuable insights into finding startup ideas:
Focus on Growth: A startup is designed to grow quickly. Founders should commit
to seeking ideas that can scale significantly, as this distinguishes startups
from ordinary businesses.
Identify Unmet Needs: Successful startups arise from recognizing problems that
need solving. Founders who can see different problems, particularly those
addressable through technology, are more likely to develop effective solutions.
Leverage Personal Insights: Many successful startups originate from the unique
insights of their founders, often stemming from personal experiences or
frustrations. This personal connection leads to more authentic solutions.
Explore Overlooked Markets: Founders should think outside the box and explore
markets that may be overlooked. Successful startups often emerge from ideas
that seem obvious to the founders but aren't yet recognized broadly.Python API आपको यह पूर्ण नियंत्रण देता है कि कौन-सा डेटा लोड करना है, किस कम्युनिटी स्तर पर क्वेरी करनी है, और जवाबों को कैसे फ़ॉर्मैट करना है। जिन अनुप्रयोगों में कस्टम रीट्रीवल लॉजिक चाहिए या मौजूदा सिस्टम्स के साथ एकीकरण करना है, उनके लिए यही रास्ता है।
पारंपरिक RAG तब तक ठीक काम करता है जब तक नहीं करता। आपको पता चल जाएगा कि आप दीवार से टकरा गए हैं, जब उपयोगकर्ता थीम या पैटर्न पूछेंगे और उन्हें सुसंगत उत्तर के बजाय ढीले-ढाले संबंधित हिस्सों का जथ्था मिलेगा। GraphRAG यही समस्या हल करता है—हिस्सों की जगह नॉलेज ग्राफ़ और प्री-कम्प्यूटेड कम्युनिटी संक्षेपों का उपयोग करके।
हालाँकि लागत वास्तविक है। इंडेक्सिंग में LLM कॉल्स खूब लगती हैं, और ग्लोबल सर्च भी सस्ता नहीं। छोटे दस्तावेज़-संग्रह या सीधे लुकअप्स के लिए वेक्टर सर्च पर टिके रहें।
पर अगर आपके कॉर्पस में एंटिटीज़ के बीच समृद्ध कनेक्शन हैं और आपके उपयोगकर्ताओं को वे कनेक्शन मायने रखते हैं, तो GraphRAG फ़ायदा देता है। अपने सवाल के हिसाब से क्वेरी प्रकार चुनें: थीम के लिए ग्लोबल, विशिष्ट एंटिटी के लिए लोकल, और दोनों के लिए DRIFT। एक बार चलाकर देख लेने पर इम्प्लीमेंटेशन जटिल नहीं लगता, और पार्के आउटपुट से सब कुछ देखना-समझना और डिबग करना आसान हो जाता है।
DataCamp के साथ सीखें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}