

Cours
Retrieval Augmented Generation (RAG) avec LangChain
3 h
21.2K
S'entraîner et cursus vos progrès.
Continuer Avec GoogleLes systèmes RAG classiques retrouvent des extraits de documents sur la base de la similarité sémantique, ce qui fonctionne pour des questions simples. Mais dès qu'une requête exige de synthétiser des informations disséminées dans plusieurs documents ou de raisonner à travers des concepts liés, la recherche vectorielle atteint ses limites. Le système récupère des fragments sans comprendre leurs liens.
GraphRAG ne traite pas les documents comme des blocs isolés. Il construit un graphe de connaissances qui capture les entités et leurs relations. Cette structure permet de parcourir les connexions et de répondre à des questions nécessitant la mise en relation d'informations issues de multiples sources. C'est l'une des techniques RAG avancées qui comblent les limites de la simple recherche.
GraphRAG est une approche de génération augmentée par la recherche qui représente les documents comme des graphes de connaissances plutôt que comme de simples embeddings vectoriels. Plutôt que de découper le texte en blocs recherchés indépendamment, GraphRAG extrait des entités (personnes, organisations, concepts, événements) et les relations entre elles, et organise ces informations dans une structure de graphe interconnectée.
Le système GraphRAG applique ensuite des algorithmes de détection de communautés pour identifier des grappes d'entités liées et génère des résumés à différents niveaux hiérarchiques. Lorsqu'une requête arrive, GraphRAG peut soit parcourir des voisinages d'entités pour des questions ciblées, soit lancer des opérations map-reduce sur les résumés de communautés pour une synthèse à l'échelle du corpus.
Regardons de plus près la mécanique. Cela aide à comprendre pourquoi la recherche par graphe est apparue et quel manque elle comble.
Le véritable problème du RAG traditionnel n'est pas la recherche ni la génération, c'est la représentation. Les documents sont découpés en blocs, et chaque bloc devient un vecteur isolé qui flotte dans l'espace d'embedding. Toute la structure initiale — titres, fil narratif, références entre paragraphes — est aplatie et perdue.
Cela pose problème pour les questions qui exigent de combiner des informations. Demandez : « Quels sont les grands thèmes de ces documents ? » et la recherche vectorielle renverra des blocs contenant le mot « thèmes » ou des termes voisins. Mais trouver des fragments pertinents n'est pas comprendre les motifs à l'échelle d'un corpus. Le système ne peut pas agréger l'information, car il ne voit que des pièces isolées, jamais l'ensemble.
Le raisonnement multi-étapes bute sur le même mur. Si la réponse à une question dépend de la chaîne A → B → C, le RAG traditionnel récupère chaque bloc indépendamment, selon la similarité avec la requête. Si B est éloigné de la question, il peut ne jamais être retrouvé, brisant la chaîne. Le système trouve des points d'arrivée mais manque le chemin entre eux.
Il faut aussi considérer le décalage entre recherche et contexte. Vous pouvez récupérer vingt blocs très pertinents, mais les entasser dans un prompt ne garantit pas que le LLM les exploitera correctement. L'article « lost in the middle » montre que les LLM se concentrent sur le début et la fin de la fenêtre de contexte, en négligeant souvent le cœur. Plus de recherche ne signifie pas automatiquement de meilleures réponses.
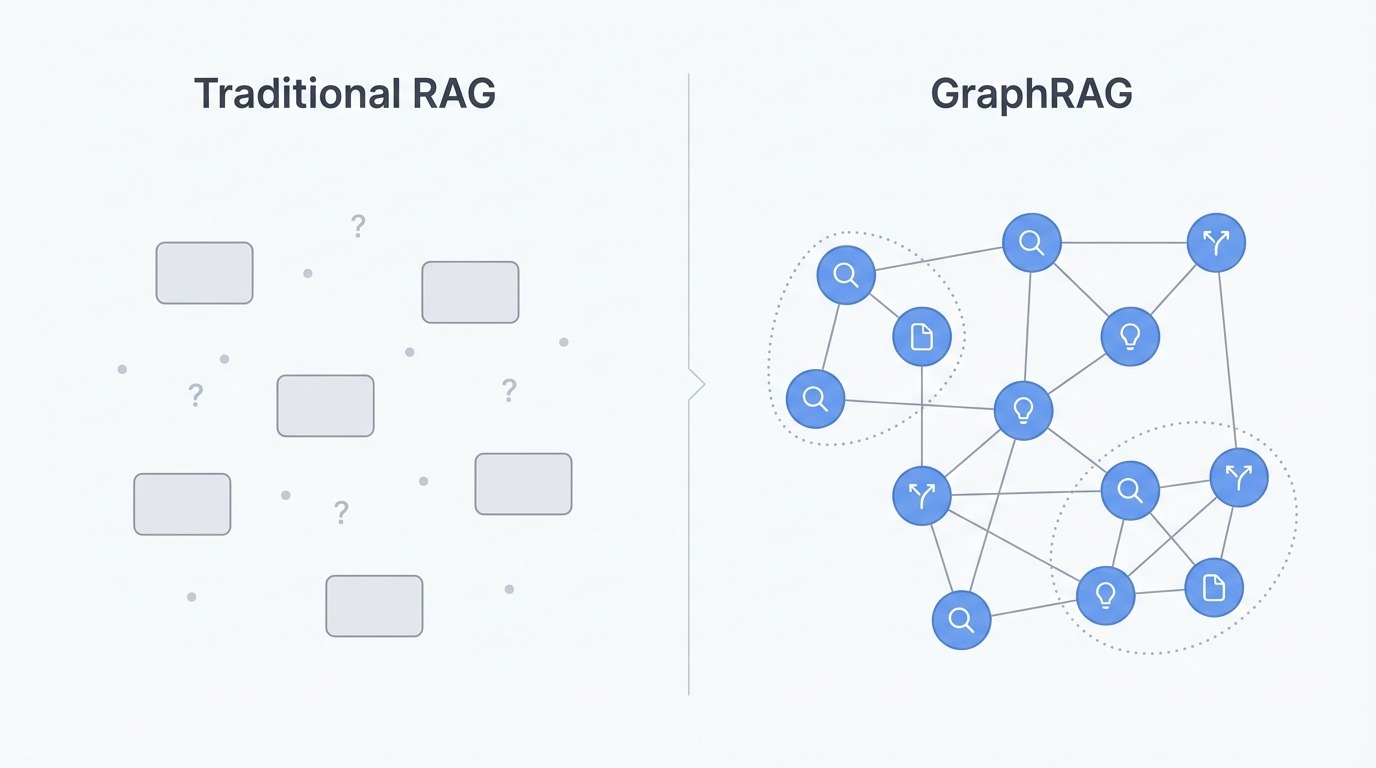
Comparaison entre RAG traditionnel et GraphRAG. Image de l'auteur.
GraphRAG contourne ces limites en changeant radicalement de représentation. Au lieu de blocs, il construit un graphe de connaissances où les entités deviennent des nœuds et les relations des arêtes. Personnes, organisations, lieux, concepts et événements sont extraits des documents sources, ainsi que leurs connexions. Cela préserve la structure que le découpage détruit.
Une fois le graphe en place, le système applique une détection de communautés (généralement l'algorithme de Leiden) pour regrouper les entités liées. Ces clusters se forment à plusieurs niveaux : certains serrés et spécifiques, d'autres plus larges et thématiques. Les regroupements résultent de connexions réelles dans les données, et non des frontières de documents ou de la taille des blocs.
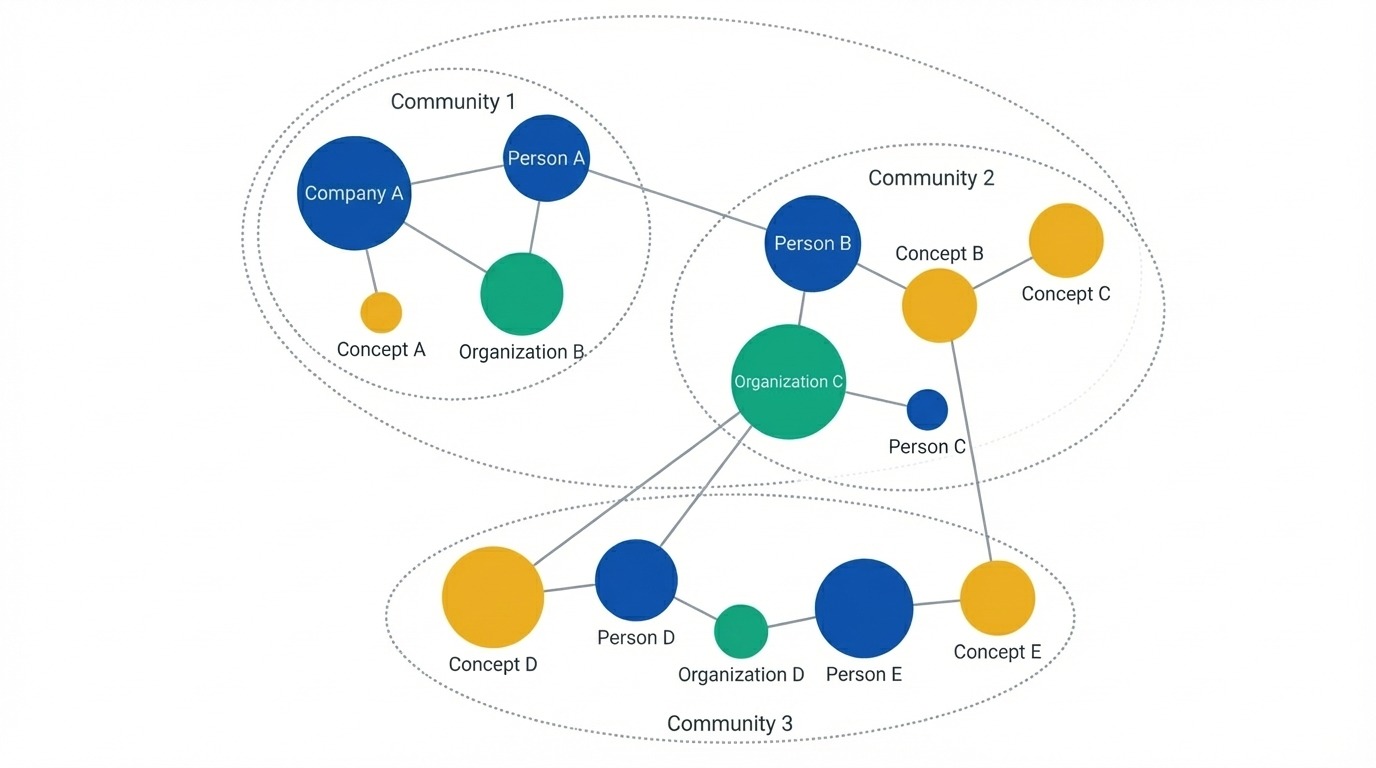
Graphe de connaissance affichant les entités comme nœuds. Image de l'auteur.
Pour des questions globales, GraphRAG pré-génère des résumés pour chaque communauté avant même la première requête. Quand quelqu'un demande « Quels sont les principaux thèmes ? », le système ne cherche pas un texte correspondant. Il effectue une opération map-reduce : chaque résumé de communauté produit une réponse partielle basée sur sa partie du graphe, puis ces réponses sont combinées en une synthèse finale. GraphRAG peut ainsi raisonner à l'échelle d'un corpus entier sans récupérer des milliers de blocs.
Pour les questions multi-étapes, le parcours de graphe remplace la recherche par similarité. Le système peut suivre les arêtes d'entité en entité, le long de chaînes conceptuelles que la recherche vectorielle manquerait. Si A est lié à B puis à C, le graphe connaît ce chemin et peut le suivre.
GraphRAG prend tout son sens lorsque vos questions nécessitent une compréhension à l'échelle du corpus. Si vos utilisateurs posent souvent des questions sur les thèmes, les motifs ou les synthèses à travers de vastes collections de documents, la recherche par graphe surclassera les approches par découpage. Même constat pour les domaines riches en relations entre entités : organigrammes d'entreprise, réseaux de citations scientifiques ou jurisprudence où les liens comptent.
Pour des recherches factuelles simples (« Quel est le numéro de téléphone de X ? ») ou de petits ensembles de documents, le RAG traditionnel suffit et coûte moins cher. GraphRAG ajoute de la charge à l'indexation et aux appels LLM : le bénéfice doit donc justifier l'investissement. Commencez par du RAG standard et passez à GraphRAG quand vous atteignez ses limites.
Le tableau ci-dessous résume les compromis. Le RAG traditionnel l'emporte en simplicité et en coût, tandis que GraphRAG prend l'avantage lorsque les questions exigent de la synthèse ou un raisonnement sur des concepts liés.
|
Aspect |
RAG traditionnel |
GraphRAG |
|
Représentation des données |
Blocs de texte isolés en vecteurs |
Graphe de connaissances (entités et relations) |
|
Préservation de la structure |
Perdue lors du découpage |
Maintenue via les arêtes du graphe |
|
Requêtes globales |
Faible (retrouve des fragments, peine à synthétiser) |
Fort (map-reduce sur les résumés de communautés) |
|
Raisonnement multi-étapes |
Limité (recherche indépendante par bloc) |
Natif (parcours de graphe suivant les connexions) |
|
Coût d'indexation |
Faible (embeddings uniquement) |
Élevé (extraction LLM + embeddings + clustering) |
|
Coût de requête |
Faible |
Variable (local bon marché, global coûteux) |
|
Idéal pour |
Recherches factuelles, petits corpus |
Questions thématiques, domaines connectés |
Le pipeline comporte deux phases : l'indexation construit le graphe, les requêtes l'exploitent.
L'indexation transforme des documents bruts en une structure de connaissances en cinq étapes :
L'extraction concentre l'essentiel des appels LLM. Chaque bloc est traité avec un prompt demandant d'identifier entités et relations. Un bloc mentionnant « OpenAI a publié GPT-4 » produit deux entités, plus une relation qui les relie, avec le type de relation. Comme chaque bloc nécessite un appel LLM, l'indexation est la partie coûteuse du pipeline. Le temps de requête est relativement faible car le gros du travail est déjà fait.
La construction du graphe gère la résolution d'entités, un point délicat. « OpenAI », « Open AI » et « l'entreprise » peuvent renvoyer à la même entité dans différents blocs. Le système fusionne ces doublons pour obtenir un graphe propre.
La détection de communautés applique l'algorithme de Leiden pour dégager des regroupements naturels à plusieurs niveaux. Le niveau 0 peut contenir des grappes serrées de 5à 10 entités liées. Les niveaux supérieurs agrègent ces groupes en thèmes plus larges. Un corpus sur les entreprises de l'IA pourrait avoir des communautés de niveau 0 pour chaque entreprise, un niveau 1 pour « AI labs » et « fabricants de puces », puis un niveau 2 pour l'ensemble de l'écosystème. Chaque communauté reçoit un résumé généré par LLM qui décrit ce qu'elle représente. Ces résumés sont pré-calculés avant toute requête utilisateur.
Le résultat final n'est pas un simple index de recherche, mais une représentation structurée : un graphe et des résumés, prêts à être interrogés de différentes manières.
Une fois le graphe construit, les requêtes sont orientées vers différentes stratégies de recherche :
Le contenu récupéré (résumés, entités, relations, texte source) est assemblé dans un prompt, et le LLM génère la réponse finale. Chaque stratégie répond à un type de question différent, que nous détaillons ci-dessous.
GraphRAG propose trois stratégies de recherche, chacune adaptée à un type de question. Le bon choix dépend d'un besoin de synthèse large, d'informations précises sur une entité, ou d'un équilibre entre les deux.
La recherche globale répond aux questions qui exigent de comprendre un corpus entier. Des questions comme « Quels sont les grands thèmes de cette collection ? » ou « Quels motifs ressortent à travers ces rapports ? » nécessitent une agrégation d'informations, pas juste quelques blocs correspondants.
Le mécanisme s'appuie sur un map-reduce des résumés de communautés. En phase map, chaque résumé est traité indépendamment : on demande à un LLM d'extraire les points pertinents et d'en noter l'importance. En phase reduce, les points les mieux notés de toutes les communautés sont agrégés dans un prompt final, et le LLM les synthétise en une réponse cohérente.
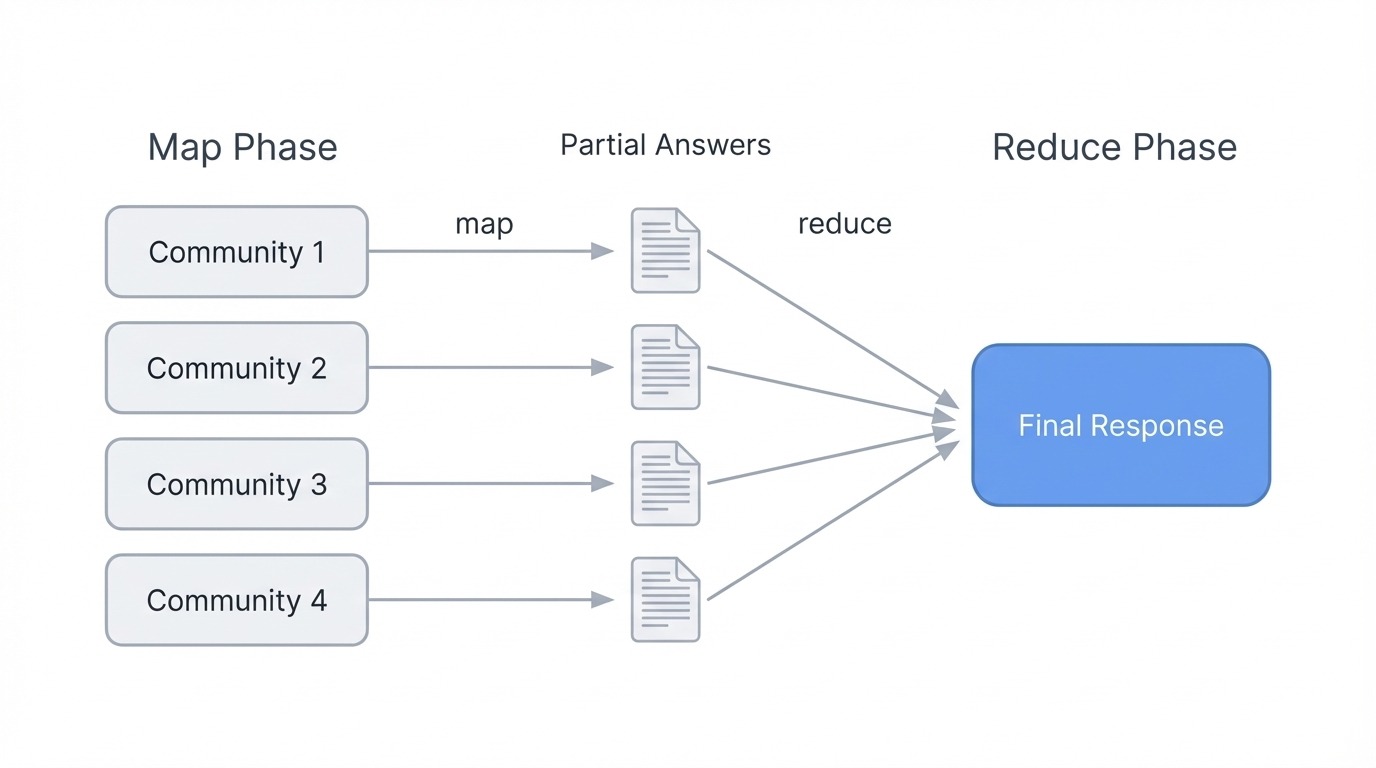
Recherche globale GraphRAG avec map-reduce. Image de l'auteur
Cela fonctionne car les résumés de communautés capturent déjà l'essence de chaque cluster d'entités. Le système n'a pas besoin de récupérer des milliers de blocs : il raisonne à partir de descriptions pré-calculées représentant la structure du graphe au niveau hiérarchique choisi. Les niveaux bas (communautés petites et serrées) offrent des réponses plus détaillées mais coûtent plus d'appels LLM. Les niveaux élevés (regroupements larges) sont plus rapides mais moins fins.
La recherche globale est plus lourde que les autres modes puisqu'elle traite toutes les communautés. Utilisez-la lorsque la question exige réellement une compréhension à l'échelle du corpus, et non un fait précis.
La recherche locale gère les questions centrées sur une entité. « Quelles sont les propriétés apaisantes de la camomille ? » ou « Qu'a annoncé Acme Corp sur ses résultats du T3 ? » ciblent des entités particulières et les informations liées.
La recherche commence par identifier les entités du graphe liées à la requête. Elles deviennent des points d'entrée pour le parcours. Depuis chaque nœud de départ, le système extrait les entités connectées, leurs relations, les énoncés ou faits associés, ainsi que les rapports de communauté correspondants. Il récupère aussi les blocs de texte d'origine liés à ces entités, offrant au LLM des données structurées et le texte source.
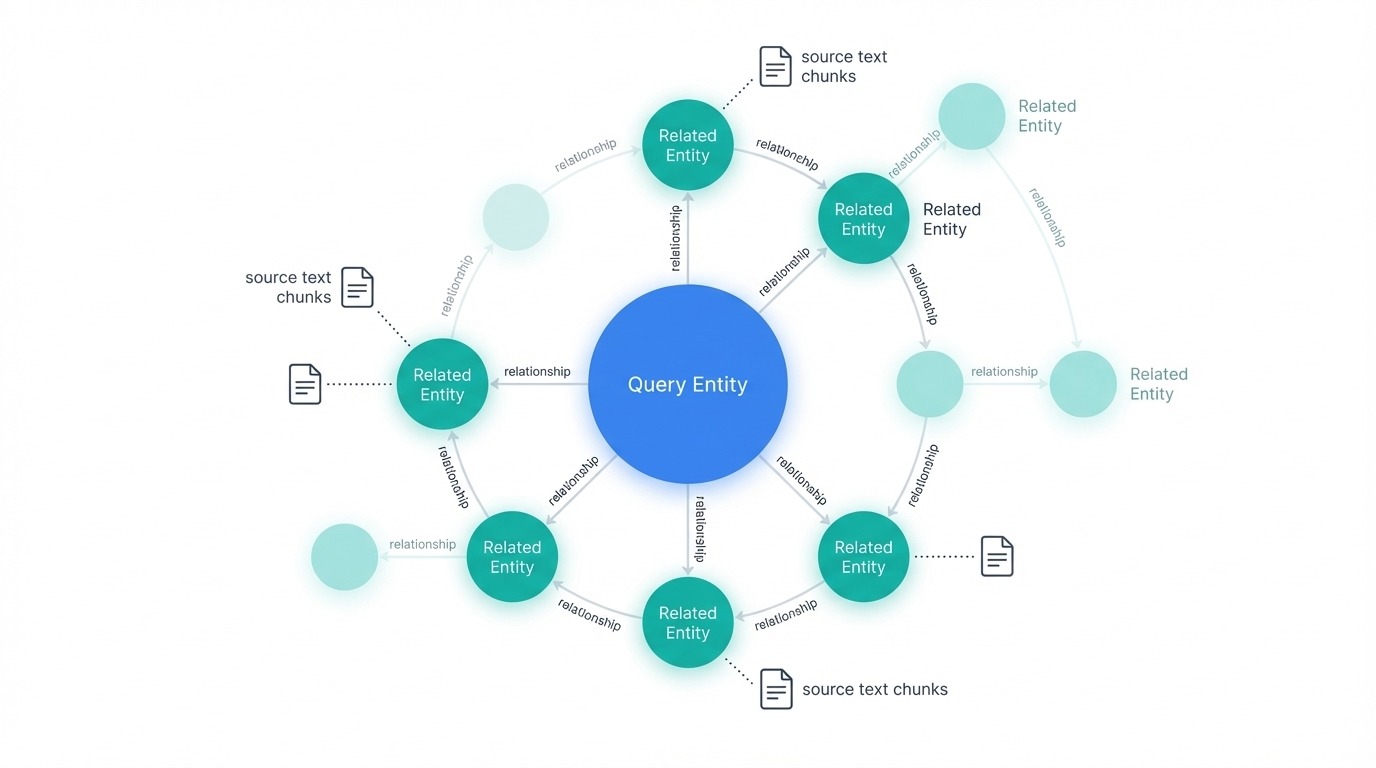
Recherche locale GraphRAG avec nœuds liés. Image de l'auteur
Toutes ces informations candidates sont ensuite classées et filtrées pour tenir dans la fenêtre de contexte. Le LLM génère alors une réponse fondée sur le contenu récupéré. Parce qu'elle se concentre sur un voisinage du graphe, la recherche locale est plus rapide et moins coûteuse que la globale.
Privilégiez la recherche locale lorsque les questions portent sur des choses, personnes, organisations ou concepts spécifiques mentionnés dans vos documents.
DRIFT (Dynamic Reasoning and Inference with Flexible Traversal) se situe entre global et local. Elle gère des requêtes complexes qui exigent à la fois du contexte large et des détails précis.
Le processus comporte trois phases. D'abord, la phase d'amorçage compare la requête aux résumés de communautés les plus pertinents sémantiquement et génère une réponse initiale assortie de questions de relance. Ensuite, la phase de suivi applique une recherche locale à ces relances pour creuser des zones précises, produisant des réponses intermédiaires et de nouvelles questions ciblées. Enfin, la phase de sortie combine le tout en résultats hiérarchisés, à l'équilibre entre vision globale et spécificités locales.
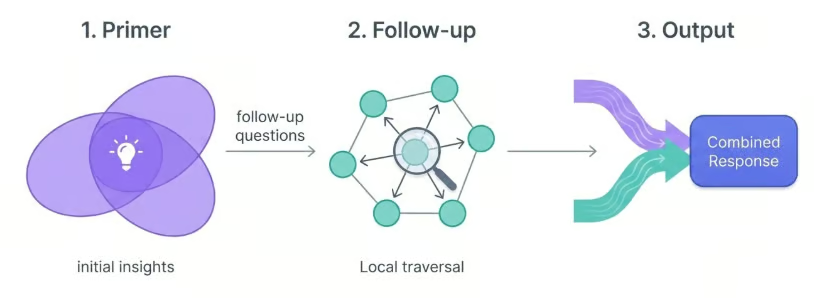
Processus en trois phases de la recherche DRIFT. Image de l'auteur.
L'intérêt de DRIFT est d'élargir intelligemment le point de départ de la recherche. En commençant par le contexte au niveau des communautés, elle récupère une variété de faits plus étendue qu'une recherche locale pure. En raffinant ensuite par parcours local, elle évite le coût d'une recherche globale complète.
Utilisez DRIFT pour des questions comme « Comment les difficultés de l'entreprise X se comparent-elles aux tendances du secteur ? », où vous avez besoin à la fois d'informations spécifiques sur une entité et d'un contexte thématique.
|
Aspect |
Globale |
Locale |
DRIFT |
|
Idéal pour |
Thèmes et motifs à l'échelle du corpus |
Questions sur des entités spécifiques |
Requêtes complexes exigeant les deux |
|
Mécanisme |
Map-reduce sur des résumés de communautés |
Parcours du voisinage d'entités |
Phases amorçage → suivi → sortie |
|
Vitesse |
La plus lente (traite toutes les communautés) |
La plus rapide (parcours ciblé) |
Moyenne (commence large, affine) |
|
Coût |
Le plus élevé |
Le plus faible |
Moyen |
|
Exemple de requête |
« Quels sont les grands thèmes ? » |
« Qu'a annoncé l'entreprise X ? » |
« Comment X se compare-t-elle aux tendances du secteur ? » |
GraphRAG propose également une recherche vectorielle de base comme filet de sécurité pour les requêtes simples, lorsque le parcours de graphe serait disproportionné. Mais dans la plupart des cas, choisir entre global, local et DRIFT couvre vos besoins.
Cette section vous guide pour construire un système GraphRAG en utilisant l'implémentation de référence de Microsoft. Nous travaillerons sur un petit corpus d'essais de Paul Graham sur les startups, afin que les exemples restent exécutables à coût raisonnable. Si vous débutez dans la combinaison graphes de connaissances et systèmes de recherche, le tutoriel RAG avec graphe de connaissances couvre les concepts fondamentaux.
Créez un répertoire de projet et initialisez-le avec uv, puis installez le paquet graphrag. La bibliothèque a beaucoup de dépendances (237 paquets dont PyTorch), prévoyez environ cinq minutes d'installation :
mkdir ragtest && cd ragtest
 uv init
 uv add graphrag
 graphrag init --root .
Cela génère la structure du projet :
ragtest/
 ├── .env                	# Configuration de la clé API
 ├── settings.yaml       	# Paramètres du pipeline
 ├── prompts/            	# Modèles de prompts pour LLM
 │   ├── extract_graph.txt
 │   ├── summarize_descriptions.txt
 │   └── ...
 └── input/              	# Vos documents sources ici
Le répertoire prompts/ contient les modèles utilisés par GraphRAG pour l'extraction d'entités et la résumé. Vous pouvez les adapter à votre domaine, même si les défauts fonctionnent bien pour du texte généraliste.
Ajoutez des fichiers texte dans le répertoire input/. Pour ce tutoriel, nous utiliserons trois essais de Paul Graham sur les startups. Son site contient un HTML minimal avec le contenu dans des balises <font>, donc un parseur simple suffit pour extraire le texte proprement :
import urllib.request
 from html.parser import HTMLParser

 class TextExtractor(HTMLParser):
 	def __init__(self):
     	super().__init__()
     	self.text = []
     	self.in_font = False

 	def handle_starttag(self, tag, attrs):
     	if tag == 'font':
         	self.in_font = True

 	def handle_endtag(self, tag):
     	if tag == 'font':
         	self.in_font = False

 	def handle_data(self, data):
     	if self.in_font:
         	self.text.append(data)

 essays = {
 	"startupideas": "http://paulgraham.com/startupideas.html",
     "do_things_that_dont_scale": "http://paulgraham.com/ds.html",
 	"startup_growth": "http://paulgraham.com/growth.html"
 }

 for name, url in essays.items():
 	with urllib.request.urlopen(url) as response:
     	html = response.read().decode('utf-8')
 	parser = TextExtractor()
 	parser.feed(html)
 	text = ' '.join(parser.text)
 	with open(f"input/{name}.txt", "w") as f:
     	f.write(text)
 	print(f"Saved {name}.txt ({len(text.split())} words)")
Saved startupideas.txt (3000 words)
Saved do_things_that_dont_scale.txt (3000 words)
Saved startup_growth.txt (3000 words)Environ 9 000 mots au total sur trois essais liés thématiquement : suffisant pour observer des relations d'entités sans coûts API élevés.
Modifiez .env pour ajouter votre clé API OpenAI :
GRAPHRAG_API_KEY=your-openai-api-key-hereLe settings.yaml par défaut fonctionne d'emblée, mais vous pouvez ajuster le modèle. Le fichier utilise gpt-4o-mini par défaut, un bon compromis coût/qualité. Consultez la référence de configuration complète pour toutes les options :
models:
   default_chat_model:
 	type: openai_chat
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: gpt-4o-mini
 	model_supports_json: true
 	concurrent_requests: 25

   default_embedding_model:
 	type: openai_embedding
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: text-embedding-3-small
Autres paramètres notables :
chunks:
   size: 1200  	# Tokens par bloc
   overlap: 100	# Chevauchement entre blocs

 extract_graph:
   entity_types: [organization, person, geo, event]
   max_gleanings: 1	# Passes d'extraction supplémentaires

 cluster_graph:
max_cluster_size: 10Construisez le graphe de connaissances avec :
graphrag index --root .Le pipeline enchaîne l'extraction d'entités, la construction du graphe et la détection de communautés :
├── Loading Input (InputFileType.text) - 3 files loaded (0 filtered) ───
 ├── create_base_text_units
 ├── create_final_documents
 ├── extract_graph
 ├── finalize_graph
 ├── create_final_entities
 ├── create_final_relationships
 ├── create_final_text_units
 ├── create_base_entity_graph
 ├── create_communities
 ├── create_final_communities
 ├── create_community_reports
 ├── generate_text_embeddings
 ⠋ GraphRAG Indexer
 ├── All workflows completed successfully
Chaque étape s'appuie sur la précédente. La phase extract_graph concentre l'essentiel des appels LLM, tandis que create_communities applique l'algorithme de Leiden pour regrouper les entités liées.
Avec nos trois essais, l'indexation prend environ deux minutes. Vous pouvez inspecter les résultats en chargeant les fichiers Parquet ou en vérifiant les volumes :
La sortie est écrite dans output/ au format Parquet :
output/
 ├── documents.parquet
 ├── entities.parquet
 ├── relationships.parquet
 ├── text_units.parquet
 ├── communities.parquet
 ├── community_reports.parquet
 └── lancedb/      	# Embeddings vectoriels
Le format Parquet garantit la portabilité. Vous pouvez charger ces fichiers avec pandas pour inspecter les entités, parcourir les relations ou diagnostiquer les problèmes d'extraction. Le répertoire du projet reste suffisamment léger pour être versionné (moins de 10 Mo pour ce corpus) ; excluez simplement le fichier .env qui contient votre clé API.
GraphRAG propose trois modes de requête. Testons-les.
Recherche globale pour des questions thématiques :
graphrag query \
 	--root . \
 	--method global \
 	--query "What are the main themes and lessons about startups in these essays?"
SUCCESS: Global Search Response:
The essays present several interconnected themes about startups:
**Growth as the defining characteristic**: A startup isn't just a new company—it's
specifically designed for rapid growth. This growth orientation shapes everything
from idea selection to daily decision-making. The essays suggest using weekly
growth rate as a compass for all strategic choices.
**The power of doing unscalable things**: Counterintuitively, successful startups
often begin with manual, labor-intensive approaches. Stripe's founders would
physically set up new users on the spot. Airbnb's founders went door-to-door
recruiting hosts. These unscalable tactics bootstrap the initial user base.
**Ideas emerge from problems, not brainstorming**: The best startup ideas come
from founders solving their own problems or noticing gaps while "living in the
future." Deliberately trying to generate ideas tends to produce plausible-sounding
but ultimately weak concepts.
**User relationships matter early**: Early users provide irreplaceable feedback.
Founders should go beyond standard customer service to create exceptional
experiences, gathering insights that shape the product.La réponse synthétise les thèmes des trois essais, ce qui nécessiterait, en RAG traditionnel, de retrouver et traiter de nombreux blocs. La recherche globale s'est appuyée sur les résumés de communauté, offrant une vue d'ensemble cohérente.
Recherche locale pour des questions liées à une entité :
graphrag query \
 	--root . \
 	--method local \
 	--query "What role does Y Combinator play according to these essays?"
SUCCESS: Local Search Response:
Y Combinator functions as both an accelerator and a testing ground for startup
principles. According to the essays, YC provides:
**Funding and validation**: YC offers initial funding that lets founders focus
on building rather than fundraising. The program validates ideas through its
selection process.
**Growth measurement framework**: YC tracks startups by weekly growth rate,
with 5-7% weekly growth considered good and 10% exceptional. This metric-driven
approach forces founders to confront whether they're making real progress.
**Network effects**: B2B startups at YC gain immediate access to hundreds of
potential customers—other YC companies. Stripe leveraged this extensively in
its early days.
**Demo Day as forcing function**: The program's structure, culminating in Demo
Day presentations to investors, creates urgency that pushes founders to ship
and iterate quickly.La recherche locale a parcouru le graphe à partir de l'entité Y Combinator, intégrant des concepts liés comme les métriques de croissance, Stripe et le Demo Day. La réponse reste ancrée dans le contenu des essais, sans extrapoler.
Recherche DRIFT pour allier ampleur et précision :
graphrag query \
 	--root . \
 	--method drift \
 	--query "How do the essays describe the relationship between startup ideas and user problems?"
SUCCESS: Drift Search Response:
The essays establish a direct link between viable startup ideas and genuine user
problems through several mechanisms:
**Organic discovery over invention**: Rather than brainstorming ideas, founders
should notice problems they personally experience. Microsoft, Apple, Google, and
Facebook all started this way—founders building something they themselves needed.
**The "well" vs "shallow hole" distinction**: Good ideas serve a small number of
users who desperately need the solution (a narrow, deep well) rather than many
users with mild interest (a broad, shallow hole). Depth of need matters more
than breadth of appeal initially.
**Feedback loops as validation**: Engaging directly with early users reveals
whether the problem is real and the solution fits. This feedback shapes the
product more than any amount of planning.
**Problem-first, solution-second**: The essays warn against "sitcom startup
ideas"—concepts that sound plausible but don't address real pain points. A
social network for pet owners sounds reasonable but lacks urgent demand.DRIFT a démarré au niveau des communautés (philosophie startup), puis a creusé des exemples concrets comme l'analogie du puits et les « sitcom ideas ». Le résultat allie vision thématique et détails issus du texte source.
Pour la production, utilisez directement l'API Python. Trois étapes : charger la configuration, charger les données indexées, exécuter des requêtes.
Commencez par charger les variables d'environnement et analyser le fichier de paramètres :
import os
 import yaml
 from pathlib import Path
 from dotenv import load_dotenv
 from graphrag.config.create_graphrag_config import create_graphrag_config

 ROOT_DIR = Path(".")

 # Load environment variables and config
 load_dotenv(ROOT_DIR / ".env")
 with open(ROOT_DIR / "settings.yaml") as f:
 	yaml_content = f.read()
 yaml_content = os.path.expandvars(yaml_content)  # Expand ${VAR} references
 settings = yaml.safe_load(yaml_content)
 config = create_graphrag_config(values=settings, root_dir=str(ROOT_DIR))
Ensuite, chargez toutes les données indexées à partir des fichiers Parquet. GraphRAG stocke séparément entités, relations, communautés et blocs de texte :
import pandas as pd

 output_dir = ROOT_DIR / "output"
 entities = pd.read_parquet(output_dir / "entities.parquet")
 communities = pd.read_parquet(output_dir / "communities.parquet")
 community_reports = pd.read_parquet(output_dir / "community_reports.parquet")
 text_units = pd.read_parquet(output_dir / "text_units.parquet")
 relationships = pd.read_parquet(output_dir / "relationships.parquet")

 print(f"Loaded {len(entities)} entities, {len(relationships)} relationships")
Loaded 74 entities, 89 relationshipsEnfin, lancez des requêtes via l'API async. La fonction local_search prend tous les DataFrames et les paramètres de requête :
import asyncio
 from graphrag.api import local_search

 async def run_query(query: str):
 	response, context = await local_search(
     	config=config,
     	entities=entities,
     	communities=communities,
         community_reports=community_reports,
     	text_units=text_units,
     	relationships=relationships,
     	covariates=None,
     	community_level=2,
     	response_type="Multiple Paragraphs",
     	query=query,
 	)
 	return response

 query = "What advice do the essays give about finding startup ideas?"
 response = asyncio.run(run_query(query))
 print(response)
The essays provide several valuable insights into finding startup ideas:
Focus on Growth: A startup is designed to grow quickly. Founders should commit
to seeking ideas that can scale significantly, as this distinguishes startups
from ordinary businesses.
Identify Unmet Needs: Successful startups arise from recognizing problems that
need solving. Founders who can see different problems, particularly those
addressable through technology, are more likely to develop effective solutions.
Leverage Personal Insights: Many successful startups originate from the unique
insights of their founders, often stemming from personal experiences or
frustrations. This personal connection leads to more authentic solutions.
Explore Overlooked Markets: Founders should think outside the box and explore
markets that may be overlooked. Successful startups often emerge from ideas
that seem obvious to the founders but aren't yet recognized broadly.L'API Python vous donne le contrôle sur les données chargées, le niveau de communauté interrogé et le format des réponses. Pour des applications exigeant une logique de recherche personnalisée ou une intégration avec des systèmes existants, c'est la voie à suivre.
Le RAG traditionnel convient... jusqu'au moment où il ne suffit plus. Vous saurez que vous avez atteint ses limites lorsque des questions sur les thèmes ou les motifs renverront un assemblage de fragments plutôt qu'une réponse cohérente. C'est précisément ce que résout GraphRAG en remplaçant les blocs par un graphe de connaissances et des résumés de communautés pré-calculés.
Le coût est réel. L'indexation consomme des appels LLM, et la recherche globale n'est pas économique non plus. Pour un petit ensemble de documents ou des recherches factuelles, restez sur la recherche vectorielle.
Mais si votre corpus présente des connexions riches entre entités et que vos utilisateurs en dépendent, GraphRAG vaut l'investissement. Choisissez la stratégie selon la question : globale pour les thèmes, locale pour les entités spécifiques, DRIFT lorsque vous avez besoin des deux. L'implémentation devient simple après une première mise en place, et la sortie au format Parquet facilite l'inspection et le débogage.
Formez-vous avec DataCamp
Cours
Cours
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
Kurtis Pykes
9 min
blog
blog
Kurtis Pykes
15 min
Tutoriel
Tutoriel
Josef Waples
8 min
Tutoriel
Laiba Siddiqui
14 min



