
Curso
Retrieval Augmented Generation (RAG) com LangChain
3 h
20.5K
Sistemas de RAG tradicionais recuperam trechos de documentos com base em similaridade semântica, o que funciona bem para perguntas diretas. Mas quando as consultas exigem sintetizar informações espalhadas por vários documentos ou raciocinar sobre conceitos conectados, a busca vetorial fica devendo. O sistema recupera fragmentos sem entender como eles se relacionam.
O GraphRAG não trata documentos como pedaços isolados. Ele constrói um grafo de conhecimento que captura entidades e seus relacionamentos. Essa estrutura permite percorrer conexões e responder perguntas que exigem reunir informações de várias fontes. É uma entre várias técnicas avançadas de RAG que superam as limitações da recuperação básica.
GraphRAG é uma técnica de geração aumentada por recuperação que representa documentos como grafos de conhecimento em vez de embeddings vetoriais. Em vez de quebrar o texto em blocos pesquisados de forma independente, o GraphRAG extrai entidades (pense em pessoas, organizações, conceitos, eventos) e os relacionamentos entre elas, organizando tudo em uma estrutura de grafo interconectada.
O sistema GraphRag então aplica algoritmos de detecção de comunidades para identificar agrupamentos de entidades relacionadas e gera resumos para esses agrupamentos em níveis hierárquicos. Quando chega uma consulta, o GraphRAG pode percorrer vizinhanças específicas de entidades para perguntas pontuais ou executar operações de map-reduce sobre os resumos das comunidades para sínteses de todo o corpus.
Agora vamos olhar mais de perto a mecânica. Isso ajuda a entender por que a recuperação baseada em grafos surgiu e qual lacuna ela preenche.
O problema central do RAG tradicional não é a recuperação nem a geração, é a representação. Os documentos são divididos em blocos, e cada bloco vira um vetor isolado flutuando no espaço de embeddings. Toda a estrutura do original — títulos, fluxo narrativo, qual parágrafo se refere a quê — é achatada e se perde.
Isso gera problemas para perguntas que exigem combinar informações. Se você pergunta "Quais são os principais temas nestes documentos?", a busca vetorial retorna blocos com a palavra "temas" ou termos relacionados. Mas achar fragmentos relevantes não é o mesmo que entender padrões em um corpus. O sistema não consegue reunir informações em escala porque só enxerga peças individuais, nunca o todo.
Raciocínio multi-hop esbarra no mesmo muro. Digamos que a resposta dependa de conectar o conceito A ao B e depois ao C. O RAG tradicional recupera cada bloco de forma independente, com base na similaridade à consulta. Se B não estiver próximo da pergunta, pode nem ser recuperado, quebrando a cadeia. O sistema encontra os pontos finais, mas perde o caminho entre eles.
Também existe um descompasso entre recuperação e contexto. Você pode recuperar vinte blocos altamente relevantes, mas enfiá-los todos no prompt não garante que o LLM vai usá-los bem. O artigo "lost in the middle" mostra que LLMs tendem a focar nas informações no começo e no fim da janela de contexto, muitas vezes ignorando o que fica no meio. Mais recuperação não significa automaticamente melhores respostas.
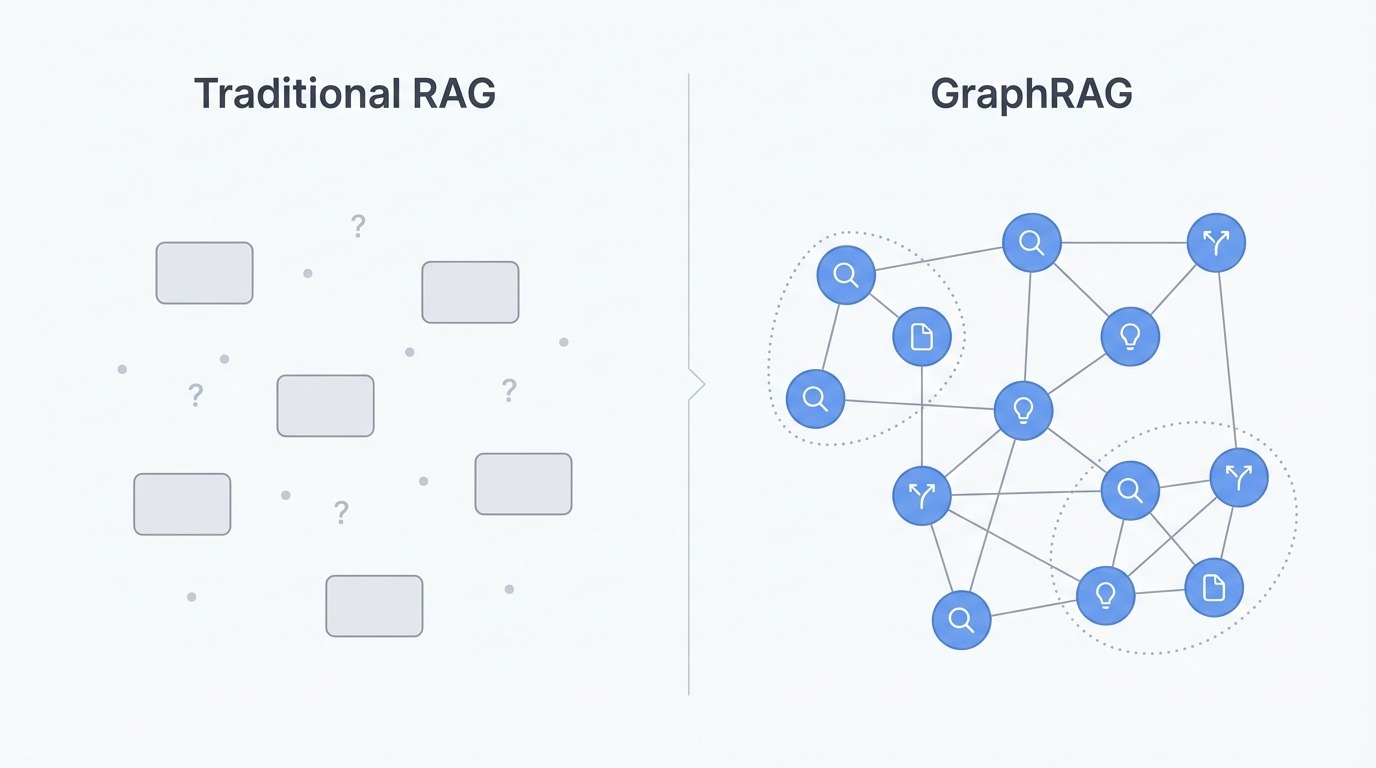
Comparação entre RAG tradicional e GraphRAG. Imagem do autor.
O GraphRAG contorna essas limitações mudando totalmente a representação. Em vez de blocos, ele constrói um grafo de conhecimento onde entidades viram nós e relacionamentos viram arestas. Pessoas, organizações, locais, conceitos e eventos são extraídos dos documentos de origem junto com como se conectam entre si. Isso preserva a estrutura que a fragmentação joga fora.
Com o grafo pronto, o sistema aplica detecção de comunidades (geralmente o algoritmo Leiden) para agrupar entidades relacionadas. Esses clusters se formam em múltiplos níveis: alguns bem específicos, outros mais amplos e temáticos. Os agrupamentos surgem de conexões reais nos dados, não de limites de documentos ou tamanhos de blocos.
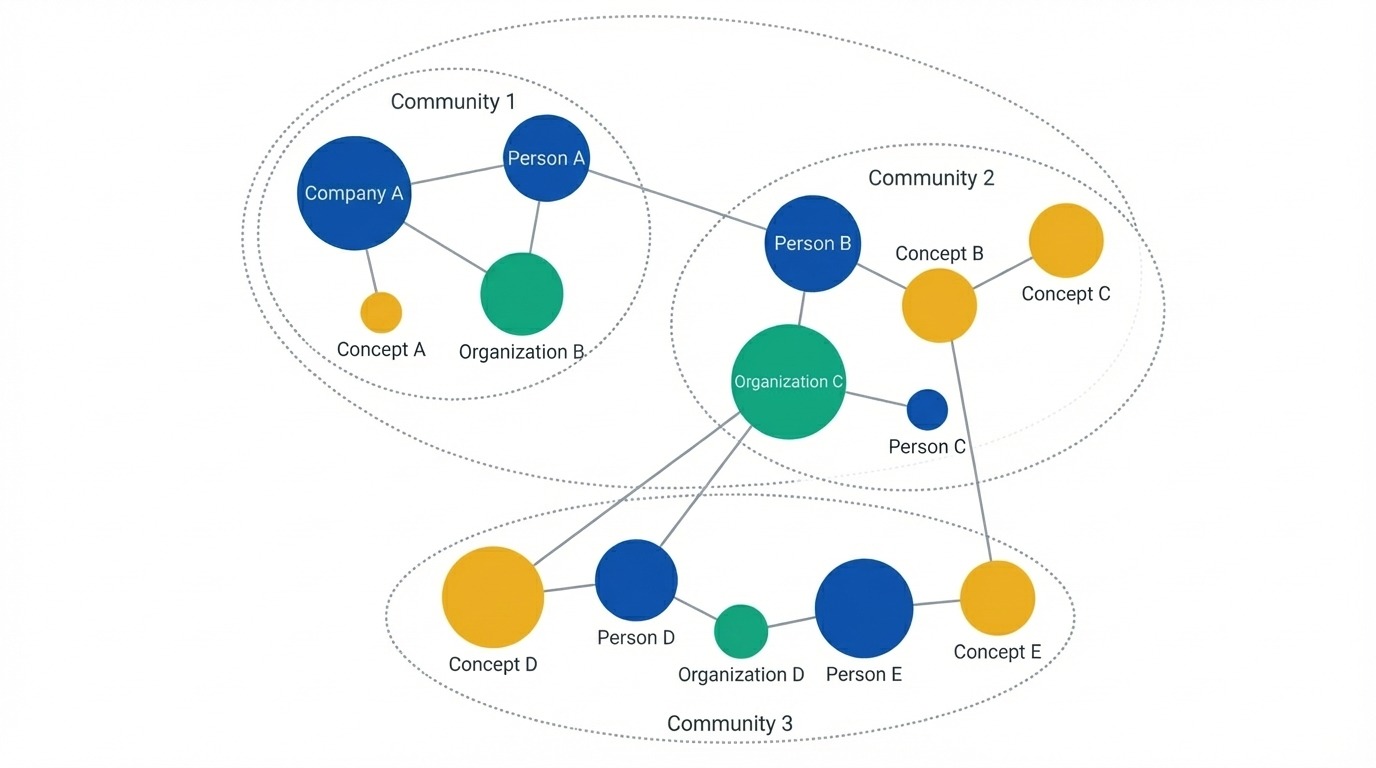
Grafo de conhecimento mostrando entidades como nós. Imagem do autor.
Para perguntas globais, o GraphRAG pré‑gera resumos para cada comunidade antes mesmo de qualquer consulta. Quando alguém pergunta "Quais são os principais temas?", o sistema não busca textos que batem com a frase. Em vez disso, roda um map-reduce: cada resumo de comunidade produz uma resposta parcial com base em sua fatia do grafo e, depois, todas as parciais são combinadas em uma resposta final. Isso permite ao GraphRAG raciocinar sobre todo o corpus sem precisar recuperar milhares de blocos.
Para perguntas multi-hop, a travessia do grafo substitui a busca por similaridade. O sistema pode caminhar de aresta em aresta, seguindo cadeias conceituais que a busca vetorial perderia. Se A conecta a B que conecta a C, o grafo sabe que esse caminho existe e consegue segui-lo.
O GraphRAG brilha quando suas perguntas exigem entendimento do corpus como um todo. Se os usuários frequentemente pedem temas, padrões ou resumos em grandes coleções de documentos, a recuperação baseada em grafos supera abordagens de fragmentação. O mesmo vale para domínios ricos em relações entre entidades, como organogramas de empresas, redes de citação acadêmica ou históricos de jurisprudência, onde seguir conexões faz diferença.
Para buscas factuais simples ("Qual é o telefone de X?") ou conjuntos pequenos de documentos, o RAG tradicional funciona bem e custa menos. O GraphRAG adiciona sobrecarga tanto no tempo de indexação quanto em chamadas ao LLM, então o ganho precisa compensar o investimento. Comece com RAG padrão e migre para GraphRAG quando esbarrar nas limitações.
A tabela abaixo resume os trade-offs. O RAG tradicional vence em simplicidade e custo, enquanto o GraphRAG se destaca quando as perguntas exigem síntese ou raciocínio conectado.
|
Aspecto |
RAG tradicional |
GraphRAG |
|
Representação dos dados |
Blocos de texto isolados como vetores |
Grafo de conhecimento com entidades e relacionamentos |
|
Preservação da estrutura |
Perdida na fragmentação |
Mantida pelas arestas do grafo |
|
Consultas globais |
Fraco (recupera fragmentos, não sintetiza) |
Forte (map-reduce sobre resumos de comunidades) |
|
Raciocínio multi‑hop |
Limitado (recuperação independente de blocos) |
Nativo (travessia do grafo segue conexões) |
|
Custo de indexação |
Baixo (apenas embedding) |
Alto (extração com LLM + embedding + clusterização) |
|
Custo da consulta |
Baixo |
Varia (local é barato, global é caro) |
|
Melhor para |
Buscas factuais, corpora pequenos |
Perguntas temáticas, domínios conectados |
O pipeline tem duas fases: a indexação constrói o grafo; as consultas o utilizam.
A indexação transforma documentos brutos em uma estrutura de conhecimento em cinco etapas:
A etapa de extração é onde ocorrem a maioria das chamadas ao LLM. Cada bloco é processado com um prompt pedindo ao modelo para identificar entidades e relacionamentos. Um bloco que menciona "OpenAI lançou o GPT-4" gera entidades para ambos, além de um relacionamento ligando-os. A mesma passada captura o tipo de relacionamento. Como cada bloco exige uma chamada ao LLM, a indexação é a parte mais cara do pipeline. O tempo de consulta é relativamente barato porque o trabalho pesado já foi feito.
A construção do grafo cuida da resolução de entidades, que é delicada. "OpenAI", "Open AI" e "a empresa" podem se referir à mesma entidade em blocos diferentes. O sistema mescla essas duplicatas para criar um grafo limpo.
A detecção de comunidades aplica o algoritmo Leiden para encontrar agrupamentos naturais em vários níveis. O nível 0 pode conter clusters enxutos de 5–10 entidades relacionadas. Níveis mais altos agrupam esses clusters em temas mais amplos. Um corpus sobre empresas de IA pode ter comunidades de nível 0 para empresas individuais, nível 1 para "laboratórios de IA" e "fabricantes de chips", e nível 2 capturando todo o ecossistema de tecnologia. Cada comunidade então recebe um resumo gerado por LLM descrevendo o que aquele cluster representa. Esses resumos são pré‑computados antes de qualquer consulta do usuário.
O resultado final não é um índice de recuperação. É uma representação estruturada: grafo + resumos, pronta para ser consultada de diferentes maneiras.
Com o grafo construído, as consultas são roteadas para diferentes estratégias de recuperação:
O conteúdo recuperado (resumos, entidades, relacionamentos, texto de origem) é montado em um prompt, e o LLM gera a resposta final. Cada estratégia atende a tipos de perguntas diferentes, que vamos detalhar a seguir.
O GraphRAG oferece três estratégias de recuperação distintas, cada uma adequada a um tipo de pergunta. A escolha certa depende de você precisar de uma síntese ampla, informações específicas de entidades ou algo no meio do caminho.
A busca global responde perguntas que exigem entender um corpus inteiro. Questões como "Quais são os principais temas nesta coleção?" ou "Que padrões surgem nesses relatórios?" precisam de informação agregada de todos os lados, não apenas de alguns blocos que batem com a consulta.
O mecanismo é map-reduce sobre os resumos das comunidades. Na fase map, cada resumo é processado de forma independente: o sistema pede a um LLM para extrair pontos relevantes e avaliar sua importância. Na fase reduce, os pontos mais bem avaliados de todas as comunidades são agregados em um prompt final, e o LLM os sintetiza em uma resposta coerente.
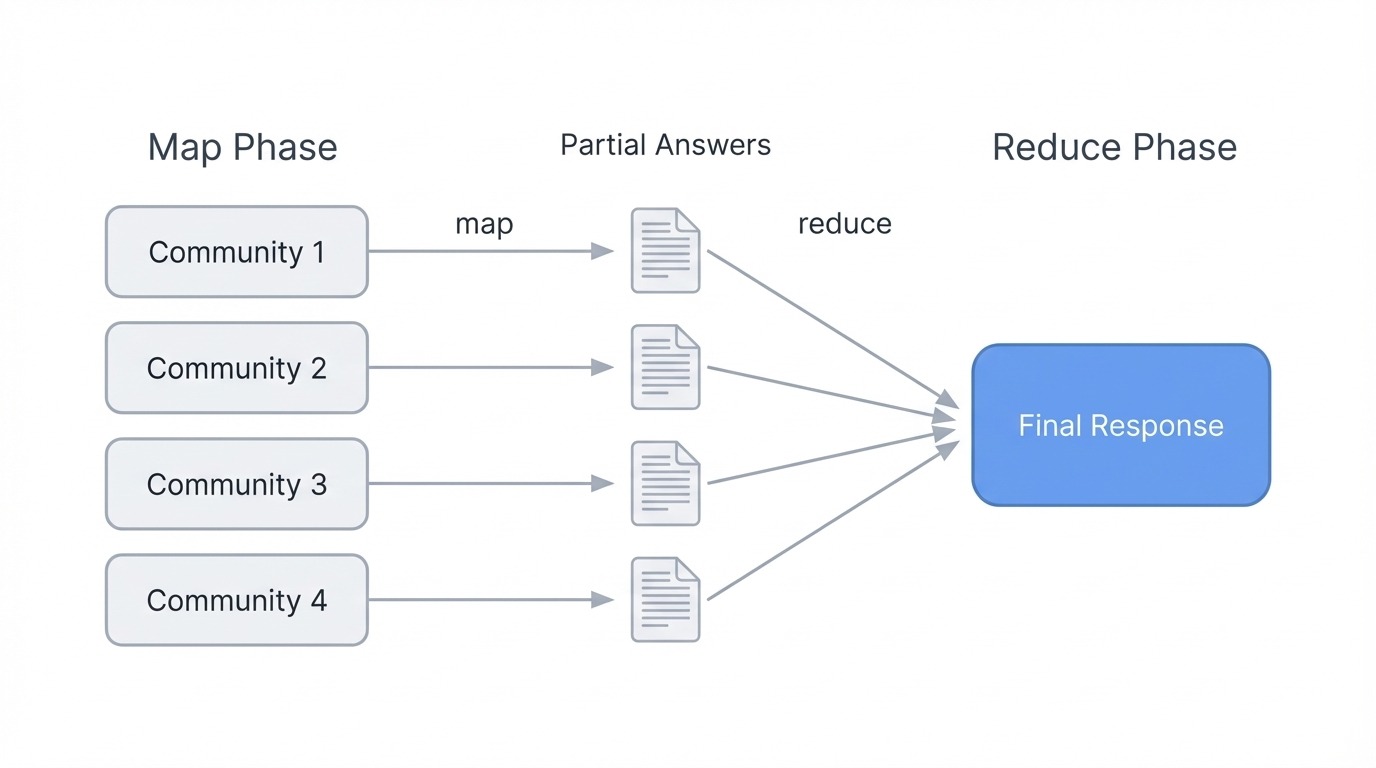
Busca global do GraphRAG usando map-reduce. Imagem do autor
Isso funciona porque os resumos das comunidades já capturam sobre o que é cada cluster de entidades. O sistema não precisa recuperar milhares de blocos. Em vez disso, raciocina sobre descrições pré‑computadas que representam a estrutura do grafo no nível hierárquico escolhido. Níveis mais baixos (comunidades menores e mais coesas) geram respostas mais detalhadas, mas custam mais chamadas ao LLM. Níveis mais altos (agrupamentos mais amplos) rodam mais rápido, mas podem perder nuances.
A busca global é computacionalmente mais pesada que os outros modos por processar todas as comunidades. Use quando a pergunta realmente precisa de entendimento de todo o corpus, não de fatos pontuais.
A busca local cuida de perguntas específicas sobre entidades. "Quais são as propriedades medicinais da camomila?" ou "O que a Acme Corp anunciou sobre os resultados do 3º trimestre?" têm como alvo entidades particulares e as informações conectadas a elas.
O processo começa identificando quais entidades no grafo se relacionam à consulta. Essas entidades viram pontos de entrada para a travessia. A partir de cada nó inicial, o sistema puxa entidades conectadas, relacionamentos entre elas, quaisquer afirmações ou fatos associados e os relatórios de comunidade a que pertencem. Também recupera os blocos de texto originais vinculados a essas entidades, oferecendo ao LLM tanto dados estruturados do grafo quanto texto de origem.
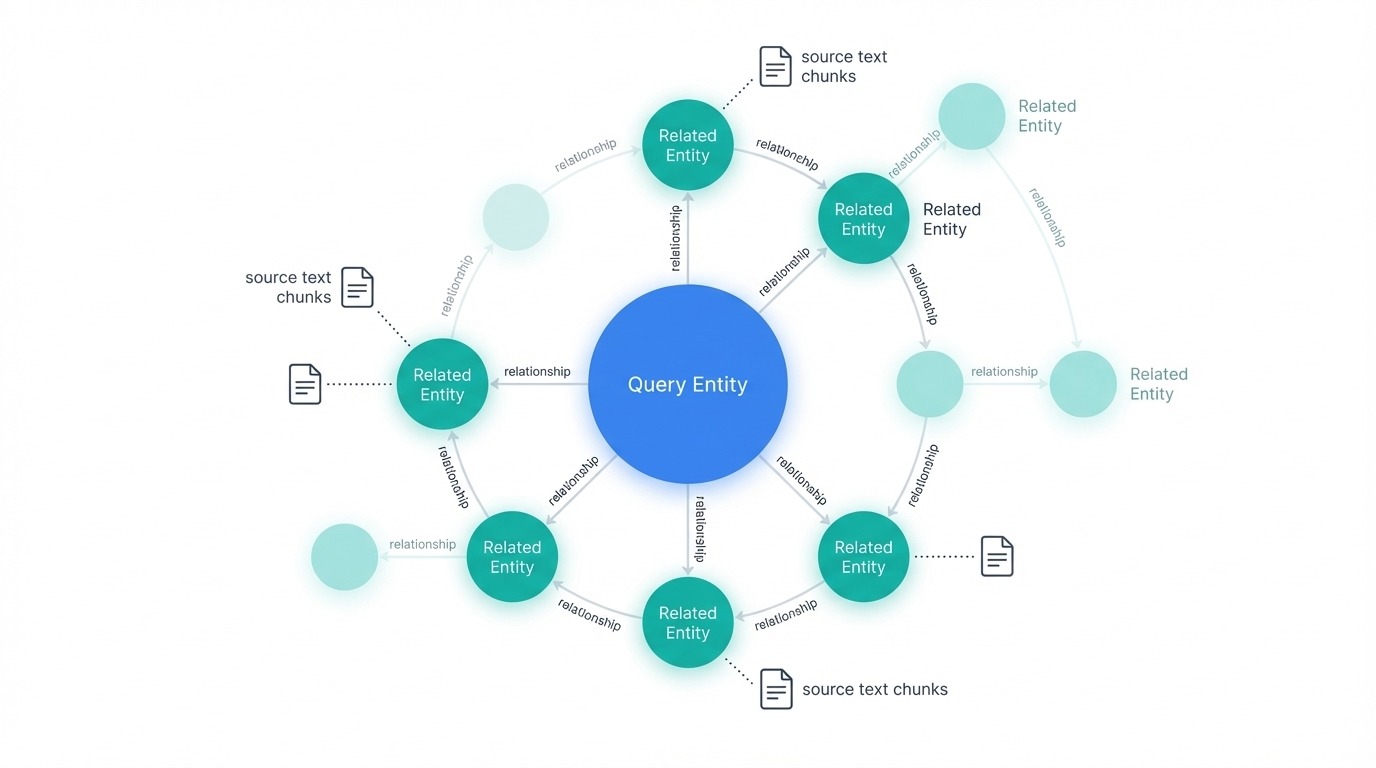
Busca local do GraphRAG com nós relacionados. Imagem do autor
Todas essas informações candidatas são ranqueadas e filtradas para caber na janela de contexto. O LLM então gera uma resposta fundamentada no conteúdo recuperado. Como a busca local foca em uma vizinhança do grafo, e não no grafo inteiro, ela roda mais rápido e custa menos que a busca global.
Escolha a busca local quando as perguntas tratam de coisas, pessoas, organizações ou conceitos específicos mencionados nos seus documentos.
DRIFT (Dynamic Reasoning and Inference with Flexible Traversal) fica entre a global e a local. Ela atende consultas complexas que exigem contexto amplo e detalhes específicos.
O processo tem três fases. Primeiro, a fase de aquecimento compara a consulta com os resumos de comunidades semanticamente mais relevantes e gera uma resposta inicial com perguntas de acompanhamento. Segundo, a fase de acompanhamento pega essas perguntas e aplica a busca local para aprofundar áreas específicas, produzindo respostas intermediárias e follow-ups mais focados. Terceiro, a fase de saída combina tudo em resultados ranqueados que equilibram insights globais com detalhes locais.
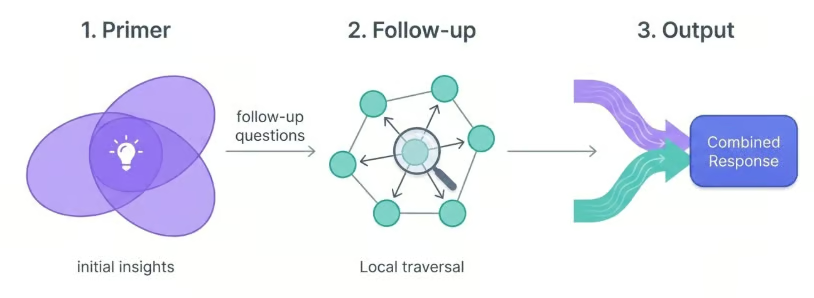
Processo em três fases da busca DRIFT do GraphRAG. Imagem do autor.
O que torna o DRIFT útil é como ele amplia o ponto de partida da busca. Ao começar com o contexto em nível de comunidade, ele recupera uma variedade maior de fatos do que a busca local pura. Mas, ao refinar por meio da travessia local, evita o custo da busca global completa.
Use DRIFT para perguntas como "Como os desafios da Empresa X se comparam às tendências mais amplas do setor?", em que você precisa tanto de informações específicas de entidades quanto de contexto temático.
|
Aspecto |
Global |
Local |
DRIFT |
|
Melhor para |
Temas e padrões no corpus inteiro |
Perguntas sobre entidades específicas |
Consultas complexas que precisam de ambos |
|
Mecanismo |
Map-reduce em resumos de comunidades |
Travessia da vizinhança de entidades |
Fases de aquecimento → acompanhamento → saída |
|
Velocidade |
Mais lenta (processa todas as comunidades) |
Mais rápida (travessia focada) |
Média (começa amplo, afunila) |
|
Custo |
Mais alto |
Mais baixo |
Médio |
|
Exemplo de consulta |
"Quais são os principais temas?" |
"O que a Empresa X anunciou?" |
"Como X se compara às tendências do setor?" |
O GraphRAG também oferece uma busca vetorial básica como fallback para consultas simples, em que percorrer o grafo seria exagero. Mas, na maioria dos casos, escolher entre global, local e DRIFT cobre o que você precisa.
Esta seção mostra como construir um sistema GraphRAG usando a implementação de referência da Microsoft. Vamos trabalhar com um corpus pequeno de ensaios do Paul Graham sobre startups para manter os exemplos executáveis e os custos sob controle. Se você está começando a combinar grafos de conhecimento com sistemas de recuperação, o tutorial de RAG com grafo de conhecimento cobre os conceitos fundamentais.
Crie um diretório de projeto e inicialize com uv, depois instale o pacote graphrag. A biblioteca tem muitas dependências (237 pacotes incluindo PyTorch), então a instalação deve levar cerca de cinco minutos:
mkdir ragtest && cd ragtest
 uv init
 uv add graphrag
 graphrag init --root .
Isso gera a estrutura do projeto:
ragtest/
 ├── .env                	# Configuração da chave de API
 ├── settings.yaml       	# Configurações do pipeline
 ├── prompts/            	# Templates de prompts para LLM
 │   ├── extract_graph.txt
 │   ├── summarize_descriptions.txt
 │   └── ...
 └── input/              	# Seus documentos de origem vão aqui
O diretório prompts/ contém os templates que o GraphRAG usa para extração de entidades e sumarização. Você pode personalizá-los para necessidades específicas do seu domínio, embora os padrões funcionem bem para texto geral.
Adicione arquivos de texto ao diretório input/. Para este tutorial, usaremos três ensaios de Paul Graham sobre startups. O site dele usa HTML mínimo com o conteúdo envolto em tags <font>, então um parser simples extrai o texto facilmente:
import urllib.request
 from html.parser import HTMLParser

 class TextExtractor(HTMLParser):
 	def __init__(self):
     	super().__init__()
     	self.text = []
     	self.in_font = False

 	def handle_starttag(self, tag, attrs):
     	if tag == 'font':
         	self.in_font = True

 	def handle_endtag(self, tag):
     	if tag == 'font':
         	self.in_font = False

 	def handle_data(self, data):
     	if self.in_font:
         	self.text.append(data)

 essays = {
 	"startupideas": "http://paulgraham.com/startupideas.html",
     "do_things_that_dont_scale": "http://paulgraham.com/ds.html",
 	"startup_growth": "http://paulgraham.com/growth.html"
 }

 for name, url in essays.items():
 	with urllib.request.urlopen(url) as response:
     	html = response.read().decode('utf-8')
 	parser = TextExtractor()
 	parser.feed(html)
 	text = ' '.join(parser.text)
 	with open(f"input/{name}.txt", "w") as f:
     	f.write(text)
 	print(f"Saved {name}.txt ({len(text.split())} words)")
Saved startupideas.txt (3000 words)
Saved do_things_that_dont_scale.txt (3000 words)
Saved startup_growth.txt (3000 words)Cerca de 9.000 palavras no total em três ensaios tematicamente conectados — o suficiente para ver relações significativas entre entidades sem estourar os custos de API.
Edite o .env para adicionar sua chave de API da OpenAI:
GRAPHRAG_API_KEY=your-openai-api-key-hereO settings.yaml padrão funciona pronto para uso, mas você pode querer ajustar o modelo. O arquivo usa gpt-4o-mini por padrão, equilibrando custo e qualidade. Veja a referência completa de configuração para todas as opções disponíveis:
models:
   default_chat_model:
 	type: openai_chat
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: gpt-4o-mini
 	model_supports_json: true
 	concurrent_requests: 25

   default_embedding_model:
 	type: openai_embedding
 	auth_type: api_key
 	api_key: ${GRAPHRAG_API_KEY}
 	model: text-embedding-3-small
Outras configurações importantes no arquivo:
chunks:
   size: 1200  	# Tokens por bloco
   overlap: 100	# Sobreposição entre blocos

 extract_graph:
   entity_types: [organization, person, geo, event]
   max_gleanings: 1	# Passadas adicionais de extração

 cluster_graph:
max_cluster_size: 10Construa o grafo de conhecimento com:
graphrag index --root .O pipeline processa os documentos por extração de entidades, construção do grafo e detecção de comunidades:
├── Loading Input (InputFileType.text) - 3 files loaded (0 filtered) ───
 ├── create_base_text_units
 ├── create_final_documents
 ├── extract_graph
 ├── finalize_graph
 ├── create_final_entities
 ├── create_final_relationships
 ├── create_final_text_units
 ├── create_base_entity_graph
 ├── create_communities
 ├── create_final_communities
 ├── create_community_reports
 ├── generate_text_embeddings
 ⠋ GraphRAG Indexer
 ├── All workflows completed successfully
Cada etapa se apoia na anterior. A fase extract_graph concentra a maior parte das chamadas ao LLM, enquanto create_communities aplica o algoritmo Leiden para agrupar entidades relacionadas.
Com nossos três ensaios, a indexação termina em cerca de dois minutos. Você pode inspecionar os resultados carregando os arquivos parquet ou conferindo as contagens de linhas:
A saída fica em output/ como arquivos parquet:
output/
 ├── documents.parquet
 ├── entities.parquet
 ├── relationships.parquet
 ├── text_units.parquet
 ├── communities.parquet
 ├── community_reports.parquet
 └── lancedb/      	# Embeddings vetoriais
O formato parquet mantém tudo portável. Você pode carregar esses arquivos com pandas para inspecionar entidades, navegar por relacionamentos ou depurar problemas de extração. O diretório do projeto todo é pequeno o suficiente para versionamento (menos de 10 MB para este corpus); apenas exclua o arquivo .env com sua chave de API.
O GraphRAG oferece três modos de consulta. Vamos testar cada um.
Busca global para perguntas temáticas:
graphrag query \
 	--root . \
 	--method global \
 	--query "What are the main themes and lessons about startups in these essays?"
SUCCESS: Global Search Response:
The essays present several interconnected themes about startups:
**Growth as the defining characteristic**: A startup isn't just a new company—it's
specifically designed for rapid growth. This growth orientation shapes everything
from idea selection to daily decision-making. The essays suggest using weekly
growth rate as a compass for all strategic choices.
**The power of doing unscalable things**: Counterintuitively, successful startups
often begin with manual, labor-intensive approaches. Stripe's founders would
physically set up new users on the spot. Airbnb's founders went door-to-door
recruiting hosts. These unscalable tactics bootstrap the initial user base.
**Ideas emerge from problems, not brainstorming**: The best startup ideas come
from founders solving their own problems or noticing gaps while "living in the
future." Deliberately trying to generate ideas tends to produce plausible-sounding
but ultimately weak concepts.
**User relationships matter early**: Early users provide irreplaceable feedback.
Founders should go beyond standard customer service to create exceptional
experiences, gathering insights that shape the product.A resposta sintetiza temas dos três ensaios — algo que, no RAG tradicional, exigiria recuperar e processar muitos blocos. A busca global puxou dos resumos das comunidades, oferecendo uma visão coesa em alto nível.
Busca local para perguntas específicas sobre entidades:
graphrag query \
 	--root . \
 	--method local \
 	--query "What role does Y Combinator play according to these essays?"
SUCCESS: Local Search Response:
Y Combinator functions as both an accelerator and a testing ground for startup
principles. According to the essays, YC provides:
**Funding and validation**: YC offers initial funding that lets founders focus
on building rather than fundraising. The program validates ideas through its
selection process.
**Growth measurement framework**: YC tracks startups by weekly growth rate,
with 5-7% weekly growth considered good and 10% exceptional. This metric-driven
approach forces founders to confront whether they're making real progress.
**Network effects**: B2B startups at YC gain immediate access to hundreds of
potential customers—other YC companies. Stripe leveraged this extensively in
its early days.
**Demo Day as forcing function**: The program's structure, culminating in Demo
Day presentations to investors, creates urgency that pushes founders to ship
and iterate quickly.A busca local percorreu o grafo a partir da entidade Y Combinator, puxando conceitos conectados como métricas de crescimento, Stripe e Demo Day. A resposta fica ancorada no que os ensaios realmente dizem sobre a YC, e não em conhecimento geral.
Busca DRIFT para perguntas que exigem amplitude e especificidade:
graphrag query \
 	--root . \
 	--method drift \
 	--query "How do the essays describe the relationship between startup ideas and user problems?"
SUCCESS: Drift Search Response:
The essays establish a direct link between viable startup ideas and genuine user
problems through several mechanisms:
**Organic discovery over invention**: Rather than brainstorming ideas, founders
should notice problems they personally experience. Microsoft, Apple, Google, and
Facebook all started this way—founders building something they themselves needed.
**The "well" vs "shallow hole" distinction**: Good ideas serve a small number of
users who desperately need the solution (a narrow, deep well) rather than many
users with mild interest (a broad, shallow hole). Depth of need matters more
than breadth of appeal initially.
**Feedback loops as validation**: Engaging directly with early users reveals
whether the problem is real and the solution fits. This feedback shapes the
product more than any amount of planning.
**Problem-first, solution-second**: The essays warn against "sitcom startup
ideas"—concepts that sound plausible but don't address real pain points. A
social network for pet owners sounds reasonable but lacks urgent demand.O DRIFT começou amplo com contexto em nível de comunidade sobre a filosofia de startups e depois se aprofundou em exemplos específicos, como a analogia do poço e as "sitcom ideas". O resultado combina insight temático com detalhes concretos do texto-fonte.
Para ambientes de produção, use a API Python diretamente. O processo tem três partes: carregar a configuração, carregar os dados indexados e executar consultas.
Primeiro, configure carregando variáveis de ambiente e lendo o arquivo de configurações:
import os
 import yaml
 from pathlib import Path
 from dotenv import load_dotenv
 from graphrag.config.create_graphrag_config import create_graphrag_config

 ROOT_DIR = Path(".")

 # Load environment variables and config
 load_dotenv(ROOT_DIR / ".env")
 with open(ROOT_DIR / "settings.yaml") as f:
 	yaml_content = f.read()
 yaml_content = os.path.expandvars(yaml_content)  # Expand ${VAR} references
 settings = yaml.safe_load(yaml_content)
 config = create_graphrag_config(values=settings, root_dir=str(ROOT_DIR))
Em seguida, carregue todos os dados indexados dos arquivos parquet. O GraphRAG armazena entidades, relacionamentos, comunidades e blocos de texto separadamente:
import pandas as pd

 output_dir = ROOT_DIR / "output"
 entities = pd.read_parquet(output_dir / "entities.parquet")
 communities = pd.read_parquet(output_dir / "communities.parquet")
 community_reports = pd.read_parquet(output_dir / "community_reports.parquet")
 text_units = pd.read_parquet(output_dir / "text_units.parquet")
 relationships = pd.read_parquet(output_dir / "relationships.parquet")

 print(f"Loaded {len(entities)} entities, {len(relationships)} relationships")
Loaded 74 entities, 89 relationshipsPor fim, rode consultas usando a API assíncrona. A função local_search recebe todos os dataframes e parâmetros da consulta:
import asyncio
 from graphrag.api import local_search

 async def run_query(query: str):
 	response, context = await local_search(
     	config=config,
     	entities=entities,
     	communities=communities,
         community_reports=community_reports,
     	text_units=text_units,
     	relationships=relationships,
     	covariates=None,
     	community_level=2,
     	response_type="Multiple Paragraphs",
     	query=query,
 	)
 	return response

 query = "What advice do the essays give about finding startup ideas?"
 response = asyncio.run(run_query(query))
 print(response)
The essays provide several valuable insights into finding startup ideas:
Focus on Growth: A startup is designed to grow quickly. Founders should commit
to seeking ideas that can scale significantly, as this distinguishes startups
from ordinary businesses.
Identify Unmet Needs: Successful startups arise from recognizing problems that
need solving. Founders who can see different problems, particularly those
addressable through technology, are more likely to develop effective solutions.
Leverage Personal Insights: Many successful startups originate from the unique
insights of their founders, often stemming from personal experiences or
frustrations. This personal connection leads to more authentic solutions.
Explore Overlooked Markets: Founders should think outside the box and explore
markets that may be overlooked. Successful startups often emerge from ideas
that seem obvious to the founders but aren't yet recognized broadly.A API Python dá controle total sobre quais dados carregar, qual nível de comunidade consultar e como formatar as respostas. Para aplicações que exigem lógica de recuperação personalizada ou integração com sistemas existentes, este é o caminho.
O RAG tradicional funciona bem — até deixar de funcionar. Você vai perceber o limite quando os usuários pedirem temas ou padrões e receberem um amontoado de blocos vagamente relacionados em vez de uma resposta coesa. É isso que o GraphRAG resolve ao trocar blocos por um grafo de conhecimento com resumos de comunidades pré‑computados.
O custo é real. A indexação consome muitas chamadas ao LLM, e a busca global também não é barata. Para coleções pequenas ou consultas diretas, fique com a busca vetorial.
Mas se o seu corpus tem conexões ricas entre entidades e seus usuários se importam com essas conexões, o GraphRAG compensa. Escolha o tipo de consulta de acordo com a necessidade: global para temas, local para entidades específicas, DRIFT quando precisar dos dois. A implementação não é complicada depois da primeira vez, e a saída em parquet facilita inspecionar e depurar tudo.
Aprenda com a DataCamp
Curso
Curso
Curso