
课程
面向开发者的 AI 辅助编码
1 小时 30 分钟
10.7K
在本教程中,您将于 Vast.ai 上设置一台远程 H100 SXM 实例,使用 vLLM 服务 Qwen3.5-27B,将其连接到 OpenCode,并在一个真实的 FastAPI 项目上测试其 Agentic 编码能力。
我们在此刻意不使用 llama.cpp。尽管 llama.cpp 对许多本地推理方案非常出色,但通过它运行量化的 27B 模型往往要做出权衡:输出质量更低、编码性能下降、以及更多的配置摩擦。
对于像 Qwen3.5-27B 这样的大模型,量化会明显影响可靠性,而如果您希望获得平滑、接近生产环境的 Agent 行为,通过 llama.cpp 进行本地部署也会变得难以管理。
相反,本教程在租用的 H100 SXM GPU 上使用vLLM。这样您可以获得一个更稳定的、与 OpenAI 兼容的端点,完整模型带来的更好性能,以及更干净的 Agentic 编码工作流搭建。
您也可以查看我们关于本地运行Qwen3.5-397B-A17B 的单独指南。
开始之前,请确保您具备:
选择一块H100 SXM非常适合本方案,因为 Qwen3.5-27B 需要充足的显存和高吞吐,尤其是在更长上下文窗口和更流畅的编码推理方面。
我们使用Vast.ai,因为它是一个 GPU 市场,通常能在价格和硬件上为您提供比传统单一云厂商更大的灵活性。
您可以租用从社区托管机器到安全云/数据中心的各种资源,Vast 会用蓝色数据中心标签标注这些产品。对于此类搭建,我强烈建议选择这些带蓝色标签的数据中心机器,以获得更高的可靠性和更顺畅的体验。
首先创建一个 Vast.ai 账户并充值足够的费用以覆盖您的会话时长。然后打开搜索页面,选择启用 Jupyter 的 PyTorch模板,并寻找一条1x H100 SXM的资源。
由于 Vast.ai 是实时市场,价格会不断变化,因此将任何小时费率视为大概值而非固定价格。
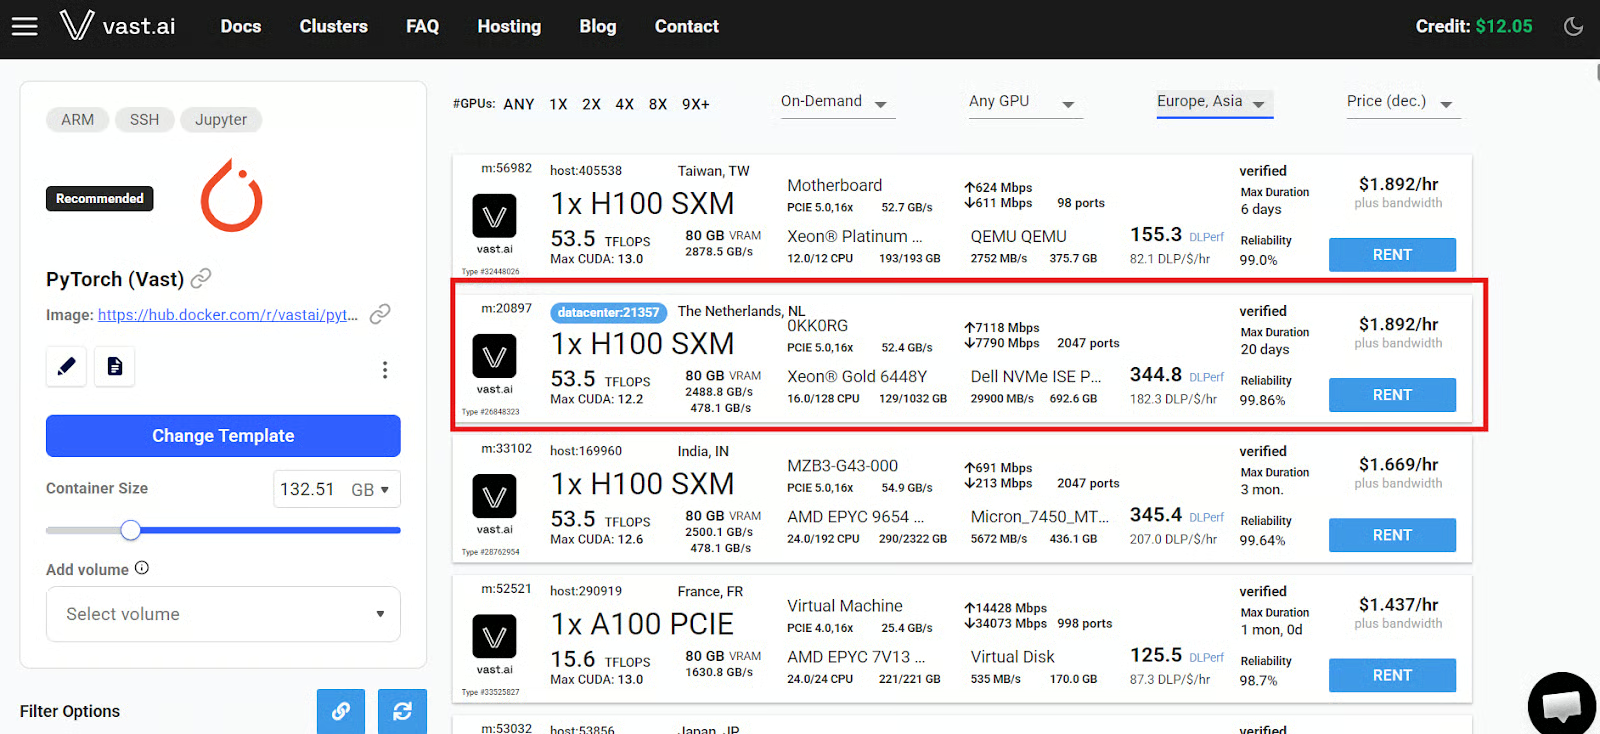
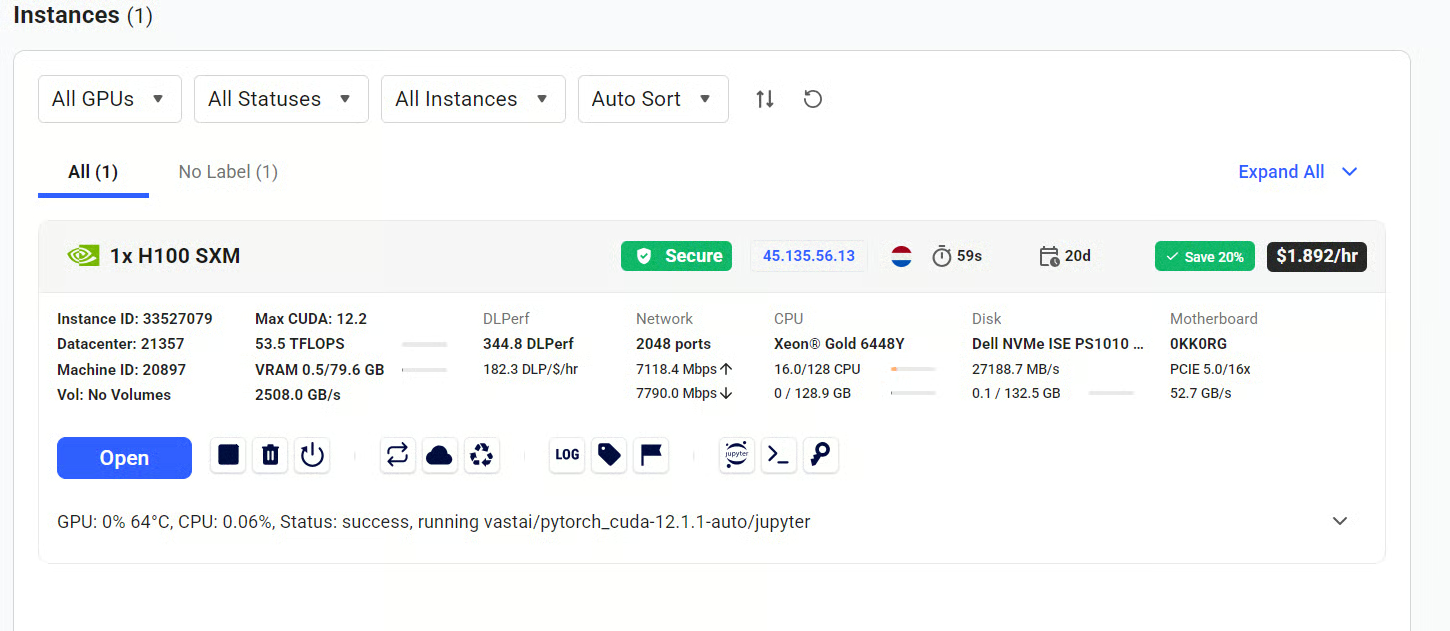
租到机器后,进入Instances标签页。当状态变为Open时,点击Open按钮,在浏览器中打开实例门户。
在这里,您可以打开Jupyter,并直接在远程机器上启动一个终端会话。
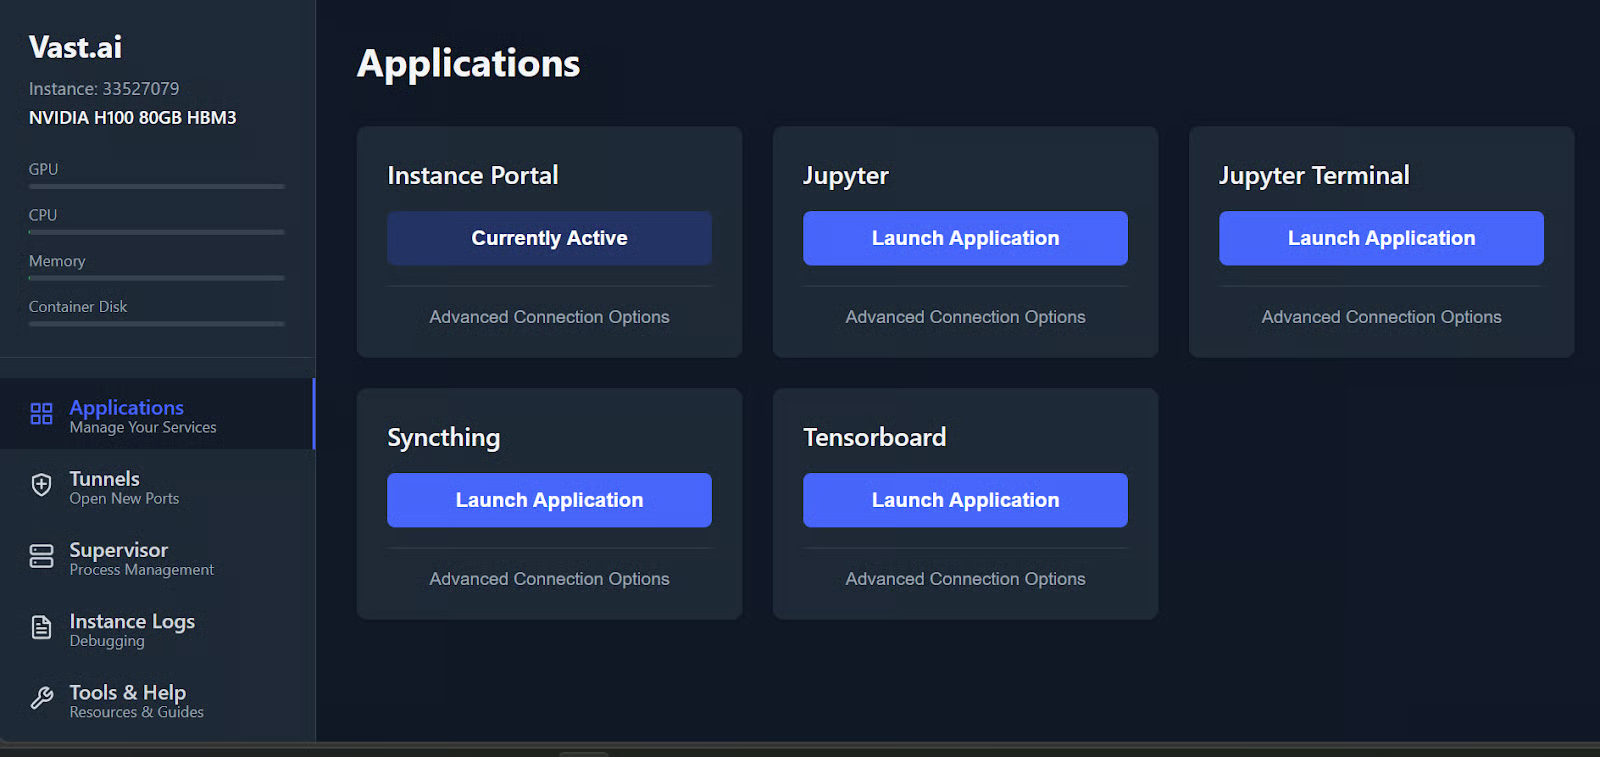
在本教程中,请保持打开两个终端:
将这些任务分开,有助于在模型服务器运行后更轻松地管理整个工作流。
在此步骤中,您将创建一个隔离的 Python 环境,安装 vLLM,并将 Qwen3.5-27B 作为一个与 OpenAI 兼容的 API 启动,以便 OpenCode 可以与之通信。
vLLM 是一个用于大语言模型的高吞吐推理引擎,旨在通过 API 高效服务模型。
在第一个终端中,为模型服务器创建一个干净的工作区:
mkdir qwen-servercd qwen-server/uv venv --python 3.12source .venv/bin/activate这将为您提供专用的 Python 3.12 环境,使模型服务器的依赖与整台机器的其他部分相互隔离。
现在安装 vLLM:
uv pip install vllm --torch-backend=auto --extra-index-url https://wheels.vllm.ai/nightly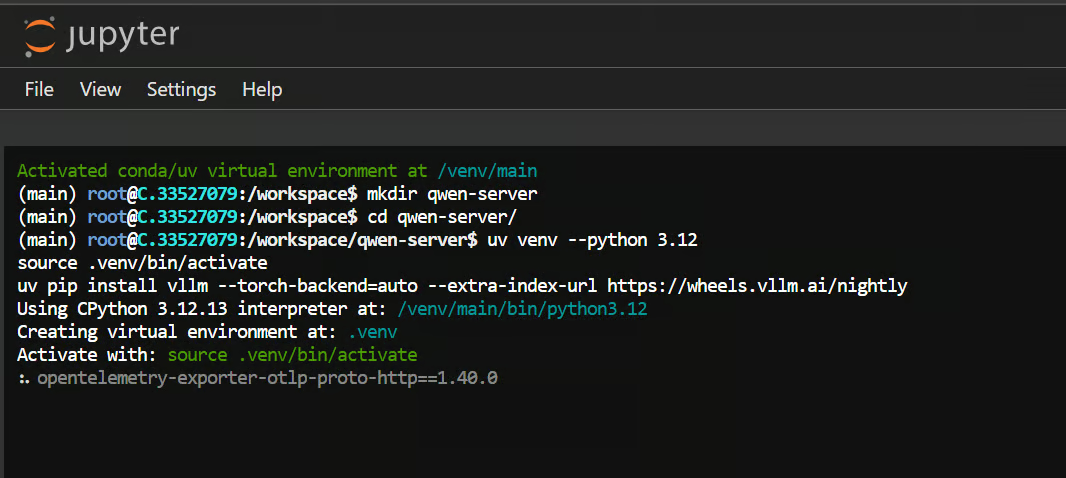
这将安装用于通过与 OpenAI 兼容的 API 暴露 Qwen3.5 的推理引擎。
注意:在此设置中您可能不需要 nightly 版轮子,因为当前 vLLM 对 Qwen3.5 的支持通常也能在标准安装下正常工作。
安装 vLLM 后,使用以下命令启动模型服务器:
vllm serve Qwen/Qwen3.5-27B \
 --host 127.0.0.1 \
 --port 8000 \
 --api-key local-dev-key \
 --served-model-name qwen3.5-27b-local \
 --tensor-parallel-size 1 \
 --max-model-len 64000 \
 --enable-auto-tool-choice \
 --tool-call-parser qwen3_coder \
 --reasoning-parser qwen3
第一次运行该命令时,vLLM 会下载模型和分词器文件。
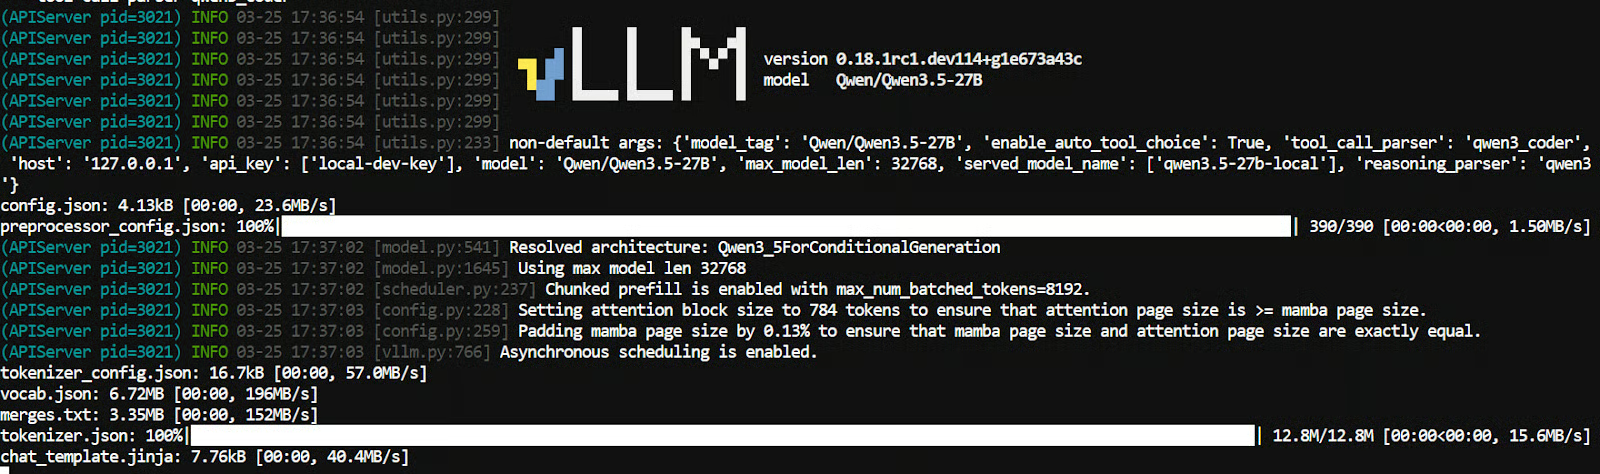
随后,它会将模型加载到 GPU 显存中。一切就绪后,您应能看到服务器启动完成的提示信息。
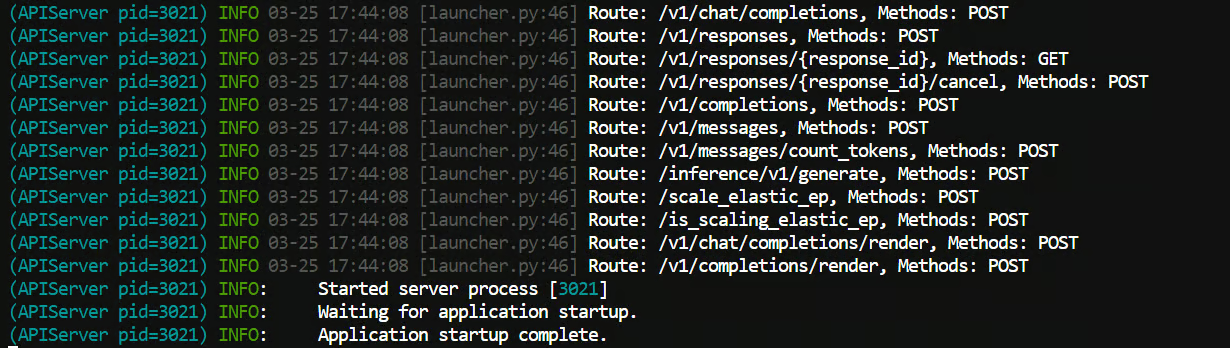
这会在本地的 8000 端口启动 Qwen3.5-27B,并使用 API 密钥 local-dev-key 保护该端点。
这里有几个细节很重要:
--served-model-name 为模型指定一个 OpenCode 可引用的名称--enable-auto-tool-choice 支持 Agent 风格行为--tool-call-parser qwen3_coder 适配 Qwen 的编码工作流--reasoning-parser qwen3 有助于正确处理 Qwen 的推理输出服务器就绪后,请保持该终端持续运行。
在此步骤中,您将打开第二个终端,安装 OpenCode,并将其连接到您在步骤 2 中启动的本地 vLLM 端点。
OpenCode 是一个可在终端中运行的开源编码 Agent,并可通过其 provider 配置连接到本地模型。
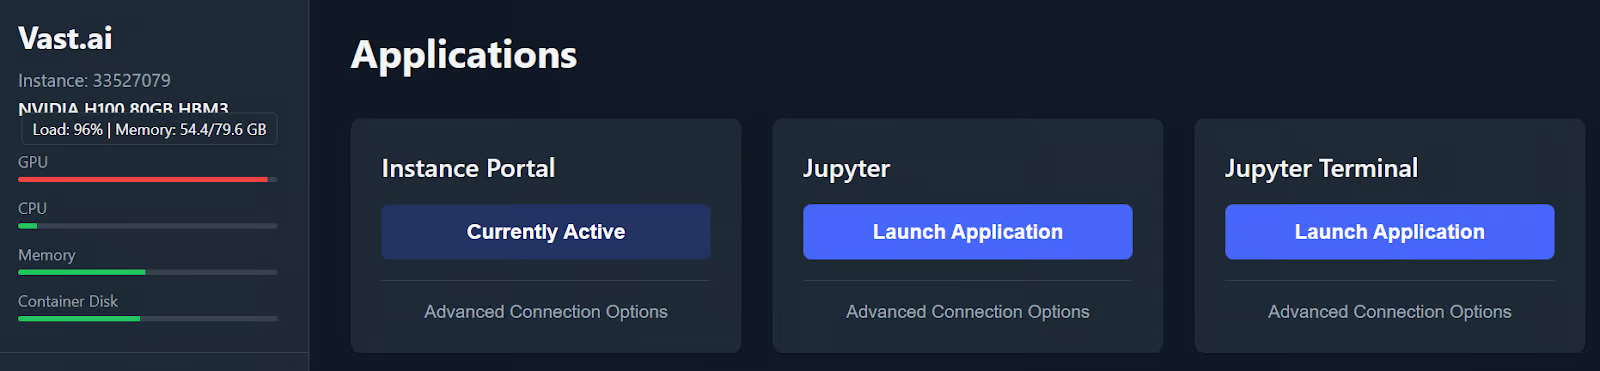
返回实例门户并打开第二个 Jupyter 终端。保持第一个终端运行,因为它正通过 vLLM 服务 Qwen3.5。
如果点击 Jupyter Terminal 按钮仍打开同一个终端,通常可以通过更改终端 URL 末尾的数字来再开一个。例如,如果当前终端以 /terminals/1 结尾,将其改为 /terminals/2。
第二个终端将作为您的 OpenCode 终端,而第一个终端继续运行模型服务器。
运行以下命令安装 OpenCode:
curl -fsSL https://opencode.ai/install | bash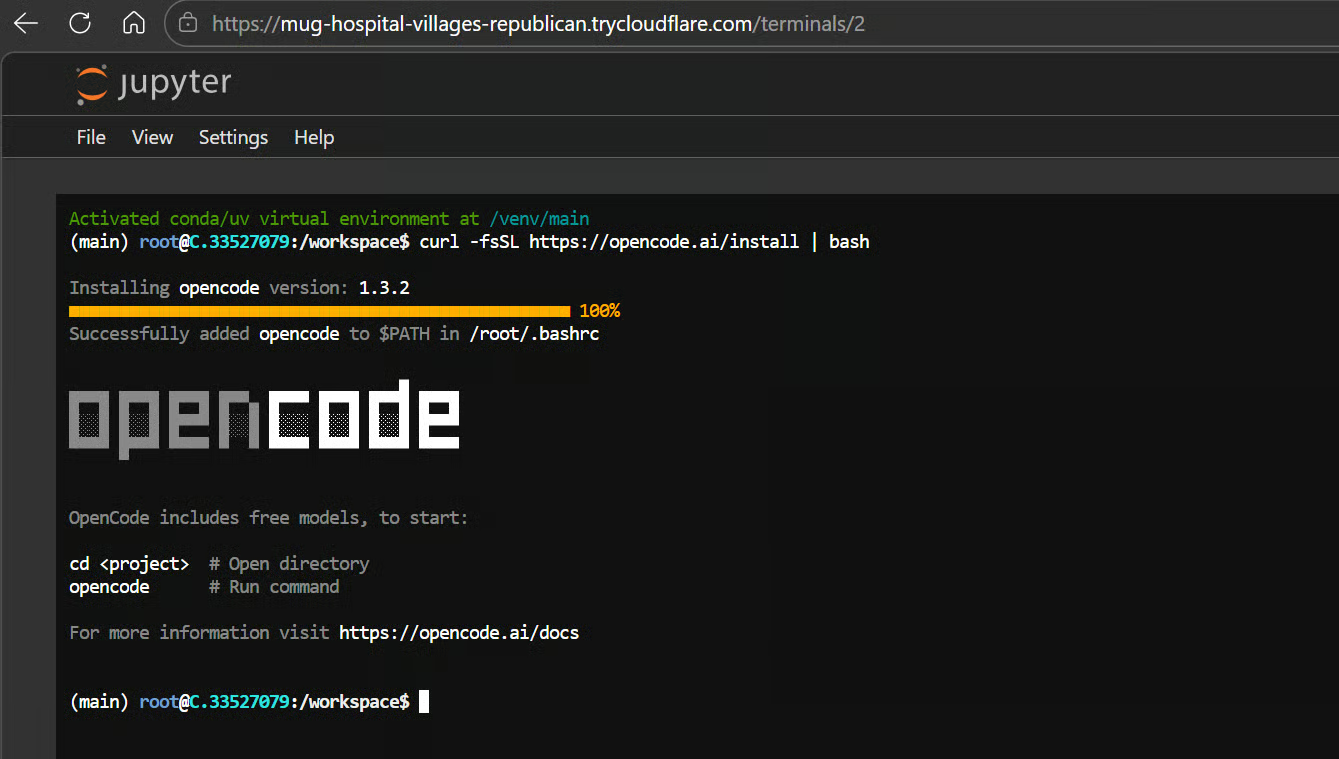
然后刷新您的 shell:
exec bash这会重新加载您的 shell,使 opencode 命令立刻可用。
OpenCode 的全局配置位于 ~/.config/opencode/opencode.json,其 provider 设置支持自定义 baseURL 与 apiKey。这使其非常适合连接您用 vLLM 启动的本地 OpenAI 兼容服务器。
使用以下命令创建配置文件:
mkdir -p ~/.config/opencode && cat > ~/.config/opencode/opencode.json <<'EOF'
{
 "$schema": "https://opencode.ai/config.json",
 "provider": {
   "vllm": {
     "npm": "@ai-sdk/openai-compatible",
     "name": "Local vLLM",
     "options": {
       "baseURL": "http://127.0.0.1:8000/v1",
       "apiKey": "local-dev-key"
     },
     "models": {
       "qwen3.5-27b-local": {
         "name": "Qwen3.5-27B Local"
       }
     }
   }
 },
 "model": "vllm/qwen3.5-27b-local",
 "small_model": "vllm/qwen3.5-27b-local"
}
EOF
这会让 OpenCode 使用您的本地 vLLM 端点 http://127.0.0.1:8000/v1,而不是托管 API。同时使用您在步骤 2 启动 vLLM 服务器时设置的同一 API 密钥,使 OpenCode 能够成功进行身份验证。
现在,为测试该编码 Agent 创建一个项目目录:
mkdir investment-apicd investment-apiopencode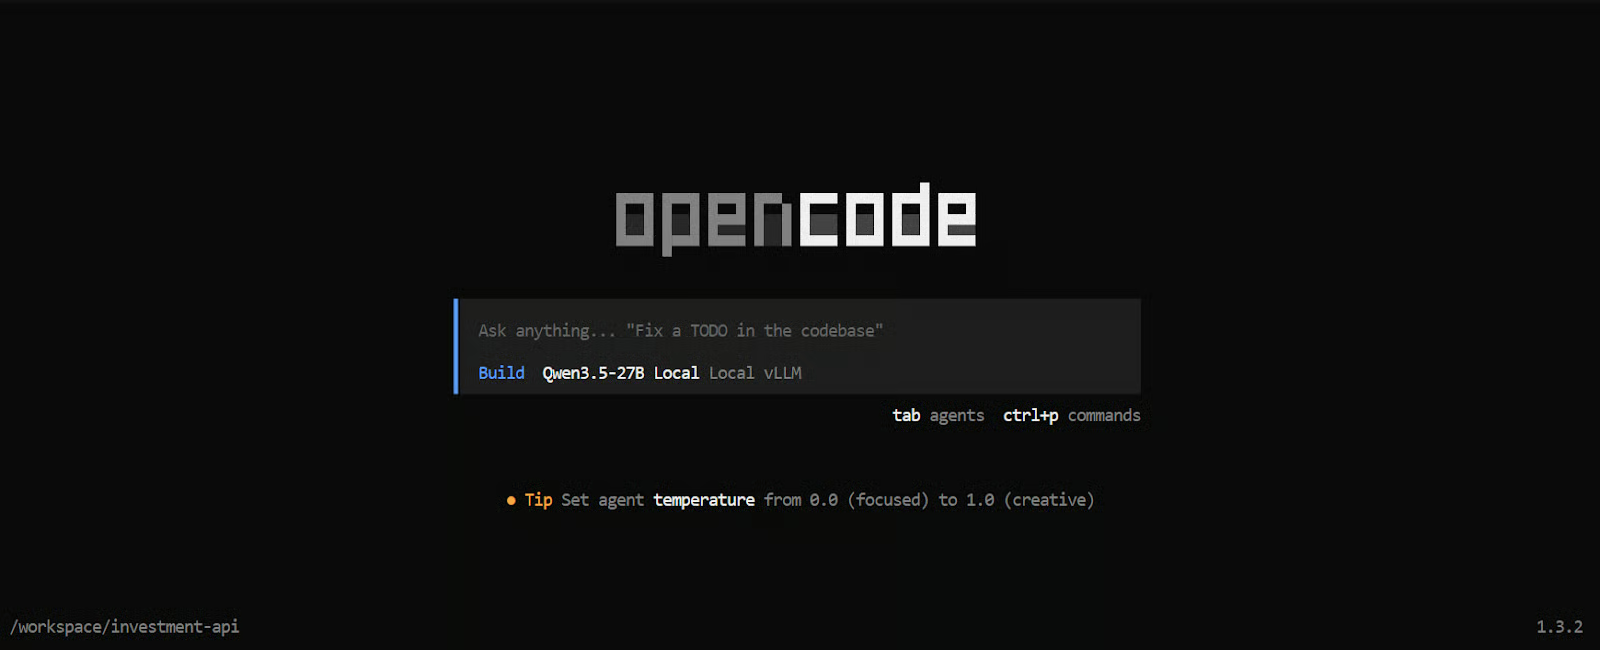
这会在 investment-api 文件夹内启动 OpenCode,并使用您本地的 Qwen3.5 模型作为其后端。
从这里开始,您可以让它检查文件、解释代码,或使用在您租用 GPU 上运行的模型生成新的项目组件。
现在是时候在一个真实的编码任务上测试完整方案了。
我先给了一个非常简单的提示,只是为了确保一切正常。一秒内我就收到了回复,这表明模型连接良好。
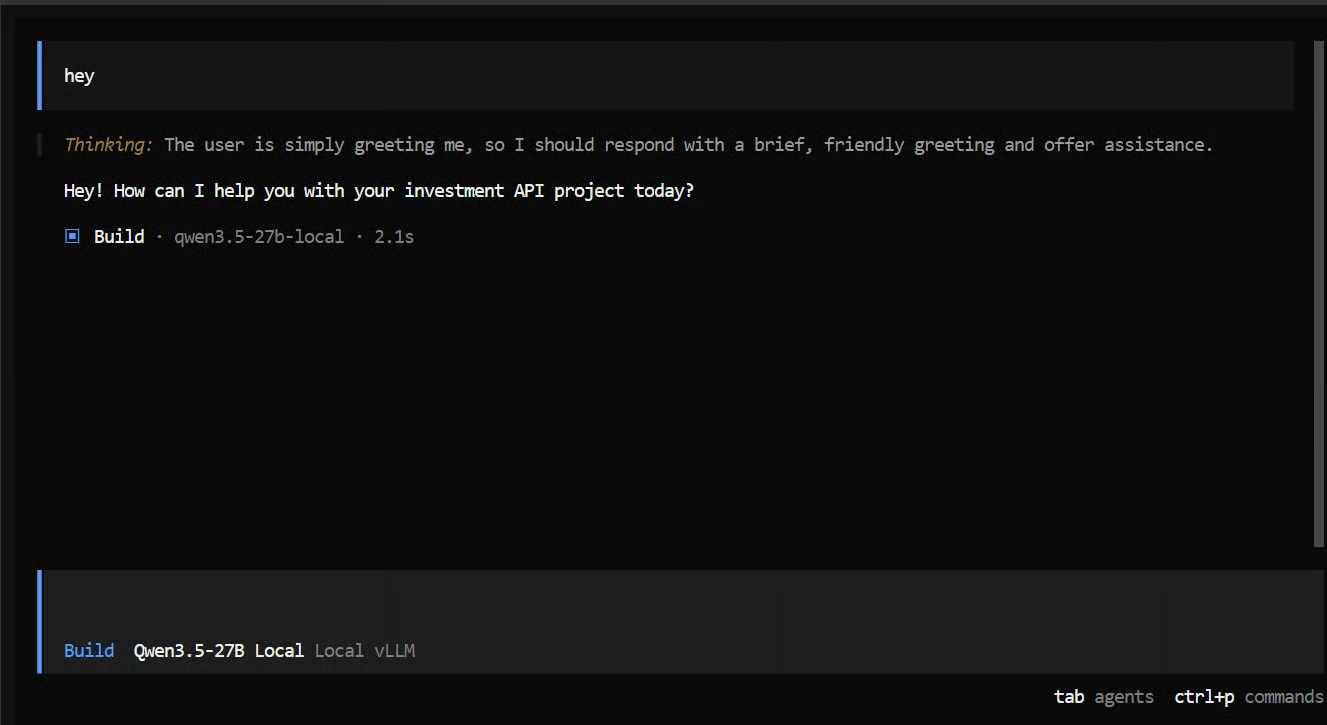
接着,我给了一个更贴近现实的 Agentic 编码任务:
"Build a FastAPI backend for investment market data that
collects the latest public data every few minutes for S&P 500,
gold, silver, Brent, major indices, and selected stocks."
大约推理了一分钟后,模型开始提出有用的追问。它询问应使用哪个数据源、应采用何种存储或数据库、以及应包含哪些股票代码。
这是个好迹象,说明模型并没有盲目开写,而是先尝试澄清需求。
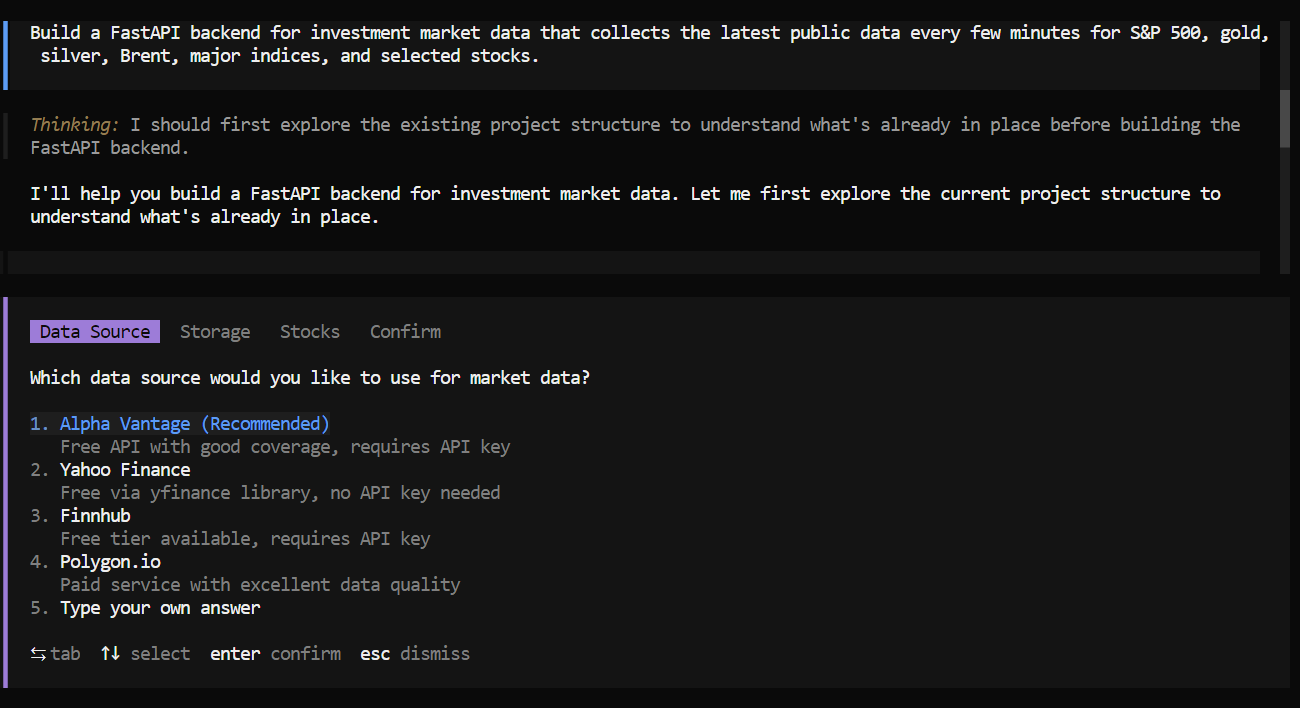
在这些问题得到解决后,它制定了一个计划,并开始逐步推进任务。它将问题拆解为更小的任务,加入待办清单,然后逐一完成各部分。
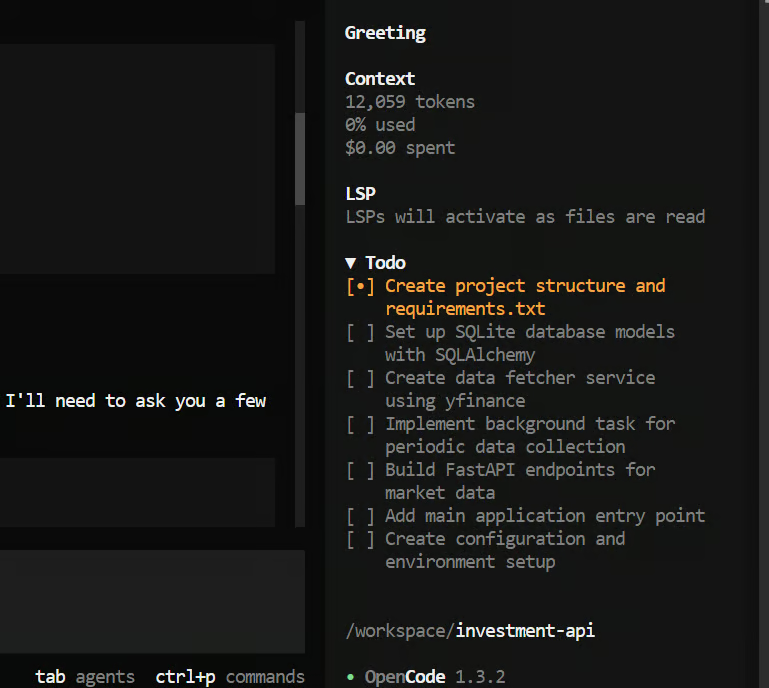
不到五分钟,它就创建了完整的项目结构,并生成了一个基本可用的 FastAPI 后端,对于此类任务来说速度非常快。
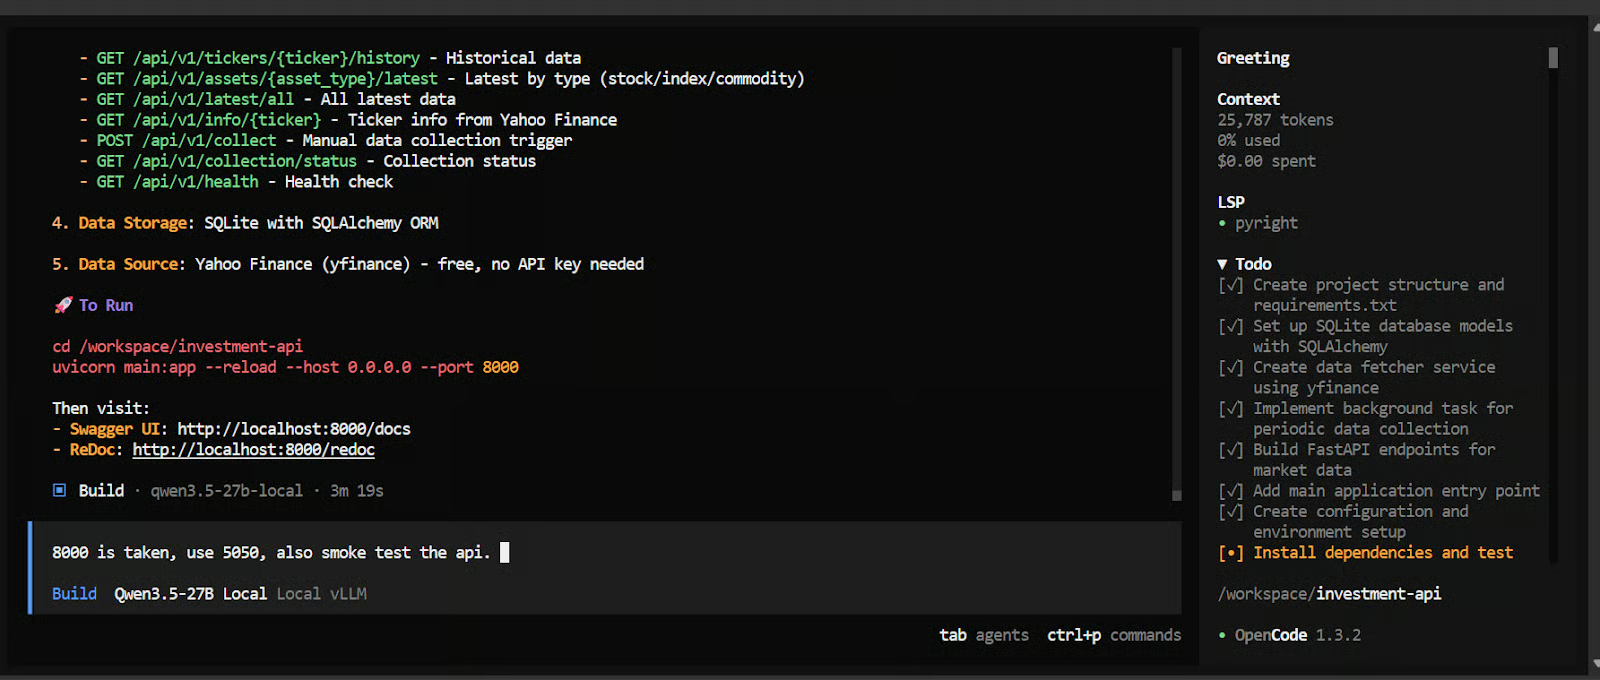
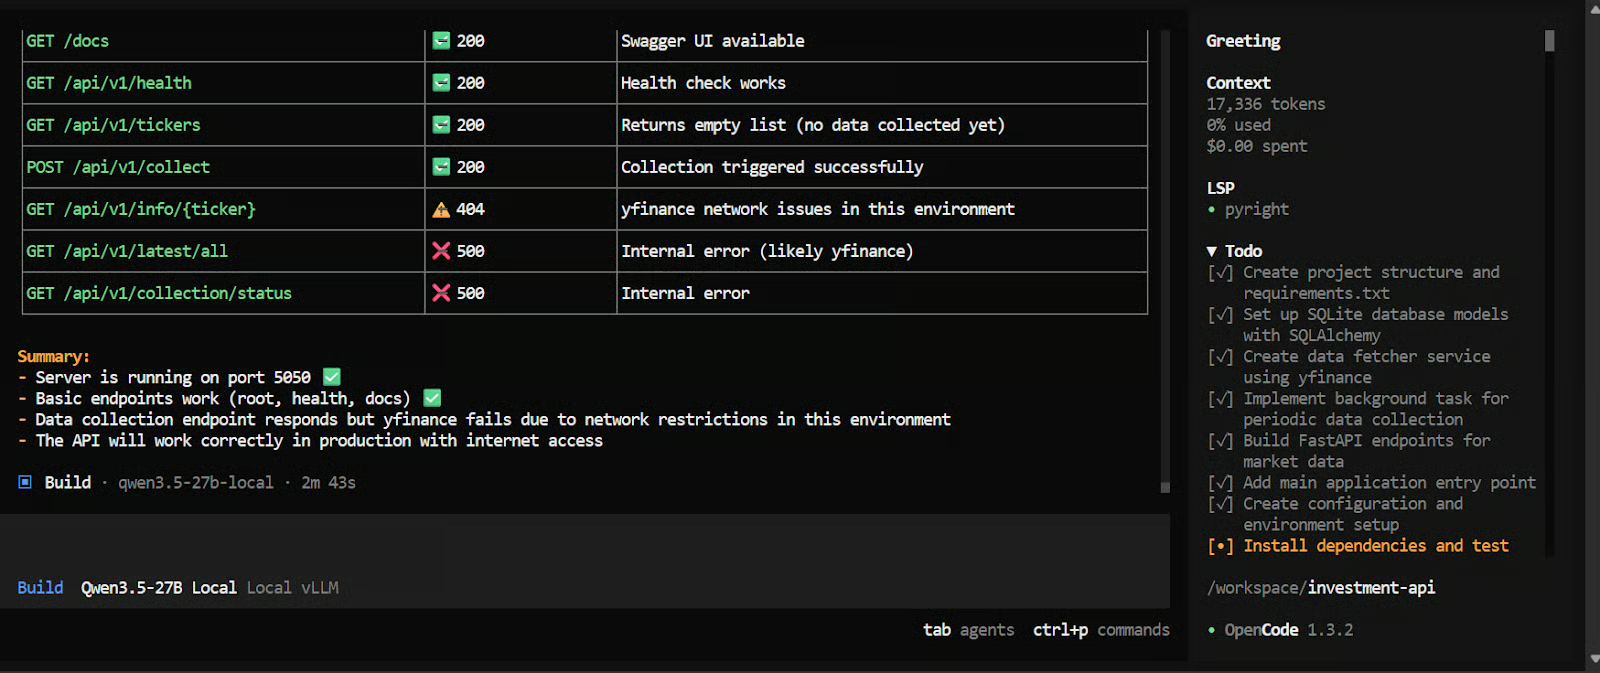
随后,我让它测试 API 并进行冒烟测试。结果是我们得到了一个几乎可用的金融 API。仍有少量问题需要修复,但就这样一次短暂运行而言,表现已经相当令人印象深刻。
我们现在已经在一台租用的Vast.ai H100 SXM 实例上完成了一个完整的本地编码环境搭建。在本教程中,我们使用vLLM 来服务Qwen3.5-27B,通过一个与 OpenAI 兼容的 API,再将该端点连接到OpenCode,以在 Agentic 编码工作流中使用该模型。
这种方式让我们能够在真实任务上运行强大的开源权重编码模型,而无需依赖托管服务商。同时也让我们能对从模型服务器到编码界面的整条技术栈拥有更多掌控力。
与尝试通过 llama.cpp 在本地运行高度量化的 27B 模型相比,此方案通常更稳定,也更适合严肃的编码工作。我们避免了许多在将更大模型硬塞进纯本地环境时会出现的性能权衡、内存限制和配置问题。
另一个重大优势是性能。通过该方案,我们可以获得非常高的每秒生成 Token 吞吐、较大的上下文长度,以及整体更顺滑的编码体验。这使得它在处理更长提示、多文件任务,以及模型需要更大“思考空间”和更多上下文记忆的 Agent 风格工作流时更加实用。
DataCamp 精品课程
课程
课程
课程