阿里巴巴刚刚发布了其最新的大语言模型 Qwen3.5。该模型是对近期发布的 GPT-5.3 Codex 和 Claude Opus 4.6 等新品的回应,这两款模型此前都给我们留下了深刻印象。
据阿里巴巴介绍,Qwen 3.5 是“为智能体时代而生”,这是一款视觉-语言模型,较前代更便宜、更高效,并在多项基准测试中交出了令人瞩目的前沿级成绩单。
阿里同时推出了高级版本 Qwen3.5-Plus,配备 100 万 Token 的上下文窗口,目标直指 Gemini 3。
本文将带您了解 Qwen3.5 和 Qwen3.5-Plus 的关键新特性,评估它们与竞品的对比表现、基准测试结果,并介绍如何获取和使用这些新模型。
也欢迎查阅我们对最新竞品模型的指南,如 Claude Sonnet 4.6 或 GPT-5.3 Instant。
Qwen3.5 是什么?
Qwen3.5 是阿里巴巴大语言模型(LLM)系列的最新一代,即 Qwen3.5-397B-A17B。不同于此前的Qwen3 模型家族,Qwen3.5 将多个专用模型整合为单一的原生视觉-语言模型。与早期 Qwen 模型一样,它以 Apache 2.0 许可证开源。
它被定位为面向消费级与企业级场景的通用基础模型,面向原生多模态与智能体工作流而设计。Qwen3.5-397B-A17B 提供两种模式:
- “Thinking”,适用于需要更深层推理的任务
- “Fast”,适用于日常任务的快速推理
Qwen3.5 与 Qwen3.5-Plus 的对比
Qwen3.5-Plus 是基于 Qwen3.5-397B-A17B 的托管 API 服务,本身并非开源权重模型。其发布说明在这一点上略显混淆:对 Qwen3.5-Plus 的提及可能被理解为一个独立模型,但实际上它是基于同一模型构建的阿里巴巴专有服务。
尽管 Qwen3.5-Plus 基于 Qwen3.5-397B-A17B 模型,但仍有一些差异:它只能通过阿里云 Model Studio 以按 Token 计费的方式访问,或通过Qwen Chat 界面有限制地访问。
Qwen3.5-Plus 的上下文窗口扩展至 100 万 Token,而标准版 Qwen3.5 的上下文窗口为 256K Token。除“Thinking”和“Fast”外,Qwen3.5-Plus 还新增“Auto”模式,具备自适应思考能力,并可在思考之外使用搜索、代码解释器等工具。
Qwen3.5 的关键特性
下面来看一下 Qwen3.5 提供的一些新功能:
原生多模态能力
类似 OpenAI 在近期GPT-5.3 Codex 的发布中将标准与 Codex 模型合并,阿里也将文本、视觉与 UI 交互整合入同一模型。
Qwen3.5 共同训练了文本、图像、UI 截图与结构化内容。它支持视觉问答、文档理解、图表/表格解读,并能进行像素级对齐以识别并与屏幕元素交互。
视觉智能体能力
这引出了 Qwen3.5 的另一个重点。由于对 UI 截图的大量训练,模型能够识别并操作移动端和桌面端界面。这使其可以执行多步工作流,例如:
这使 Qwen3.5 非常适合生产力自动化。通过自然语言指令,您可以让视觉智能体跨多个应用执行操作,完成复杂工作流。它甚至能够在长时间交互序列中保持状态,从而实现稳健的工具与应用编排。
更强的性能与效率
Qwen3.5 是一款相当庞大的模型,总参数量为 3970 亿,但得益于专家混合(MoE) 架构,每个 Token 只激活 170 亿参数。简而言之,它具备超大模型的智能,同时拥有更小模型的速度与成本优势。
在实际表现上,与 Qwen3-Max 相比,Qwen3.5 397B-A17B 在长上下文任务(256k Token)的解码速度快 19 倍,在标准工作流上快 8.6 倍。关键在于,这种速度并未以智能为代价;凭借文本与视频的早期融合,它在推理与编程能力上仍可与 Qwen3-Max 持平,并优于 Qwen3-VL。
更优的成本效率
性能提升的同时,该模型也带来了成本方面的优化。
此外,原生 FP8 流水线(以 8 位精度而非常见的 16 位处理数据)使 Qwen3.5 的运行内存占用减少 50%。这意味着计算可以更快完成,在万亿 Token 规模下可带来超过 10% 的速度提升。
Qwen3.5 还具备高达 25 万的词表,能够用更少的 Token 表达复杂概念。配合多 Token 预测,模型可在一步中“猜测”多个后续词语,从而在 201 种语言中实现 10%—60% 的 Token 成本下降。
Qwen3.5 的研发方式
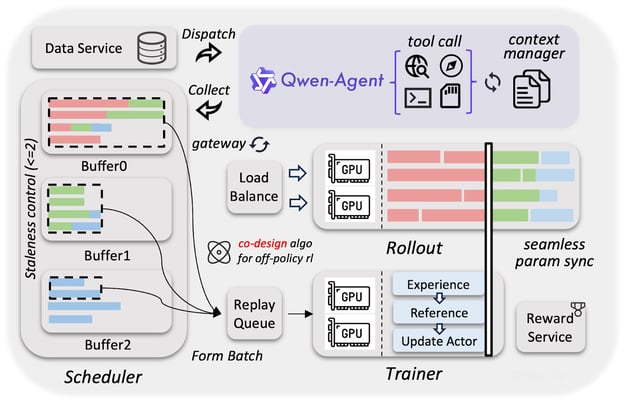
Qwen3.5 的开发采用了定制化基础设施,使多模态与智能体模型的训练(几乎)与纯文本模型一样快速且经济。其训练的特殊方法主要体现在三大要素:
数据质量
阿里团队采集的视觉-文本数据量远超 Qwen3 模型家族,但进行了非常严格的筛选以确保高质量输入。由此得到的高质量数据集,让 3970 亿参数的模型能够匹敌如 Qwen3-Max 等 1 万亿参数级模型的智能水平。
异构基础设施
视觉与语言部分分别、同时训练。由于彼此无需等待对方计算,重叠带来的效率使训练吞吐量几乎可与纯文本模型持平。
异步强化学习
通过使用 FP8 压缩(本质上以一半比特存储数值)与猜测式解码(前瞻性预测),智能体在后台训练无需等待的情况下,可同时运行成千上万项任务。此举在不显著牺牲质量的前提下加速了训练,让 Qwen3.5 以 3—5 倍的速度掌握复杂的智能体技能,如 UI 点击或多步任务。
Qwen3.5 基准评测
阿里新模型的性能已在多项任务上得到验证。我们将重点关注其在智能体与多模态工作流方面的结果,以及更通用的推理能力。
智能体工作流
与 Qwen3 系列相比,Qwen3.5 提升最大的领域是智能体工作流。
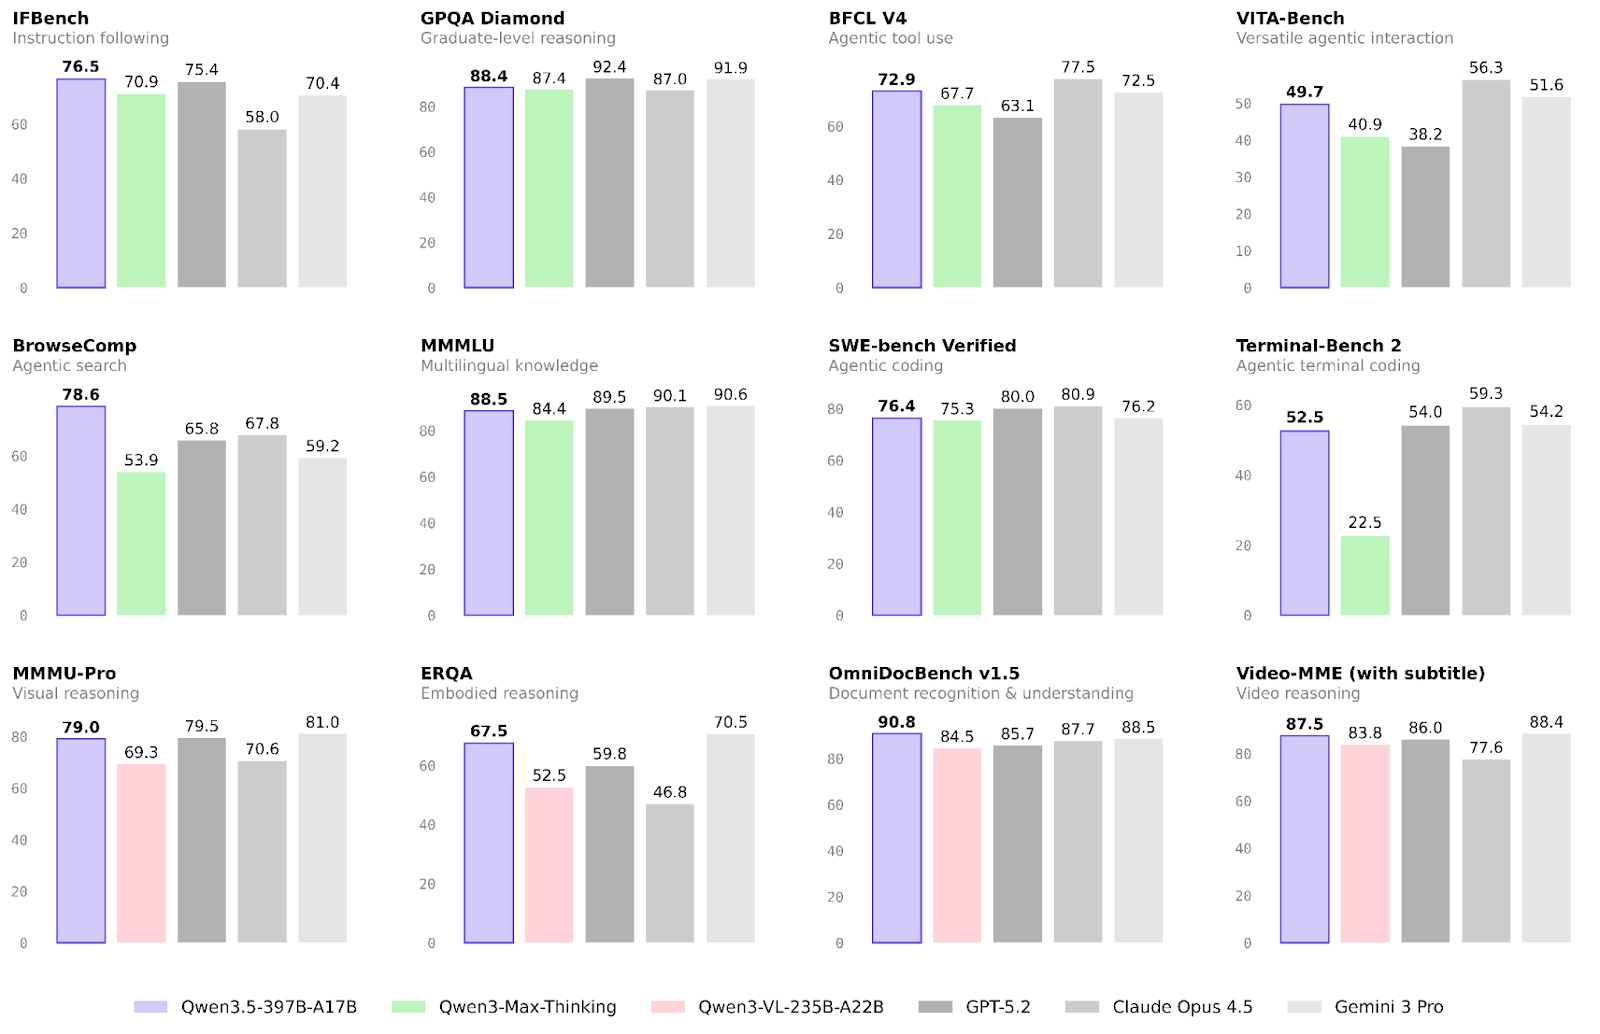
- 终端编码智能体:在 Terminal-Bench 2.0 上出现了最显著的跃升:Qwen3.5 得分 52.5,而 Qwen3-Max-Thinking 仅为 22.5,并可与Gemini 3 Pro(54.2)竞争。不过,与当前领先者、近期发布的GPT-5.3 Codex(77.3)相比,仍有较大差距。
- 搜索智能体:这似乎是 Qwen3.5 的最大强项。它在 BrowseComp 中取得了 78.6 的高分,远超 Gemini 3 Pro(59.2),位居第二,仅次于Claude Opus 4.6(84.0)。
多模态
多模态也是相较于上一代模型家族提升显著的领域,尤其体现在具身推理与文档识别方面:
- 具身推理:Qwen3.5 在 ERQA 中得分 67.5,显著高于 Qwen3-VL(52.5),几乎与 Gemini 3 Pro(70.5)持平。
- 文档识别:Qwen3.5 在 OmniDocBench v1.5 中突破 90% 阈值,以 90.8 的成绩超越了GPT-5.2(85.7)、Claude Opus 4.5(87.7)以及 Gemini 3 Pro(88.5)。
- 视觉推理:在这方面,Qwen3.5 仅略低于 Gemini 3 Pro:在 MMMU-Pro 中得分 79.0,在 Video-MME 中得分 87.5(Gemini 3 Pro:81.0 和 88.4)。
推理、知识与可靠性
推理与知识显然并非本次发布的主要焦点。但这些方面仍有小幅提升,尤其是在可靠性上。
- 指令遵循:在 IFBench 中取得 76.5,Qwen3.5 可靠性表现出色,排名靠前。作为对比,当前领先者 AWS Nova 2.0 Pro 得分为 79.0。
- 研究生水平推理:GPQA Diamond 得分 88.4,较 Qwen3-Max-Thinking(87.4)为小幅提升。
- 多语种知识:Qwen3.5 的 MMMLU 得分为 88.5,低于 Gemini 3 Pro(90.6),但相较上一代模型(84.4)有显著提升。
如何使用 Qwen3.5
与以往类似,Qwen3.5 模型开源,可通过多种方式使用:在聊天应用中直接调用、通过 API 访问、下载本地部署,或集成到自定义系统中。
聊天界面
您可以直接在chat.qwen.ai 这一熟悉的聊天界面中使用 Qwen3.5。
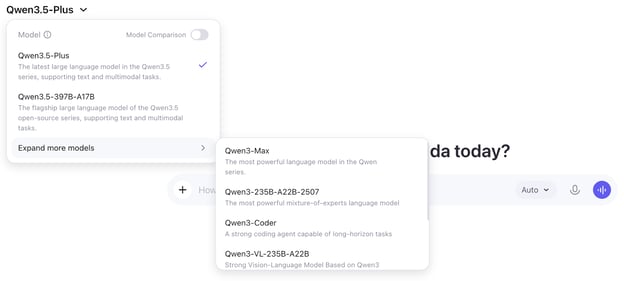
模型选择下拉菜单提供 Qwen3.5-397B-A17B 与 Qwen3.5-Plus 两款模型,以及Qwen3 模型家族中的部分旧版本与Qwen2.5-Max。
API 访问
Qwen 3.5 的 API 访问方式与 Qwen3 相同:通过 ModelScope 的 OpenAI 兼容端点(免费层,按日配额)或 DashScope/Model Studio(付费,包含 Qwen3.5-Plus)。将模型 ID 更新为 qwen3.5-397b-a17b 或 qwen3.5-plus 即可使用。
开源权重与本地部署
如前所述,Qwen3.5-397B-A17B 的模型权重以 Apache 2.0 许可证发布。您可以使用Ollama、LM Studio 或 vLLM 等工具在本地运行 Qwen3.5。
您可以从以下渠道下载权重:
总结
凭借全新的视觉智能体、更强的性能与成本优化,Qwen3.5 的发布相当亮眼,不仅给国内模型带来压力,也对 OpenAI 与 Anthropic 的产品构成挑战。
与今年其他新品(如 GPT-5.3-Codex 和 Claude Opus 4.6)一样,行业的关注点正明显转向智能体 AI。OpenClaw 的迅速走红证明了大众对 AI 实用落地的渴望,而 Qwen3.5、Seedance 2.0 以及传闻中即将发布的 DeepSeek 新品,则显示中国正在快速成为 AI 模型领域的市场引领者。


阿里巴巴刚刚发布了其最新的大语言模型 Qwen3.5。该模型是对近期发布的 GPT-5.3 Codex 和 Claude Opus 4.6 等新品的回应,这两款模型此前都给我们留下了深刻印象。
据阿里巴巴介绍,Qwen 3.5 是“为智能体时代而生”,这是一款视觉-语言模型,较前代更便宜、更高效,并在多项基准测试中交出了令人瞩目的前沿级成绩单。
阿里同时推出了高级版本 Qwen3.5-Plus,配备 100 万 Token 的上下文窗口,目标直指 Gemini 3。
本文将带您了解 Qwen3.5 和 Qwen3.5-Plus 的关键新特性,评估它们与竞品的对比表现、基准测试结果,并介绍如何获取和使用这些新模型。
也欢迎查阅我们对最新竞品模型的指南,如 Claude Sonnet 4.6 或 GPT-5.3 Instant。
Qwen3.5 是什么?
Qwen3.5 是阿里巴巴大语言模型(LLM)系列的最新一代,即 Qwen3.5-397B-A17B。不同于此前的Qwen3 模型家族,Qwen3.5 将多个专用模型整合为单一的原生视觉-语言模型。与早期 Qwen 模型一样,它以 Apache 2.0 许可证开源。
它被定位为面向消费级与企业级场景的通用基础模型,面向原生多模态与智能体工作流而设计。Qwen3.5-397B-A17B 提供两种模式:
Qwen3.5 与 Qwen3.5-Plus 的对比
Qwen3.5-Plus 是基于 Qwen3.5-397B-A17B 的托管 API 服务,本身并非开源权重模型。其发布说明在这一点上略显混淆:对 Qwen3.5-Plus 的提及可能被理解为一个独立模型,但实际上它是基于同一模型构建的阿里巴巴专有服务。
尽管 Qwen3.5-Plus 基于 Qwen3.5-397B-A17B 模型,但仍有一些差异:它只能通过阿里云 Model Studio 以按 Token 计费的方式访问,或通过Qwen Chat 界面有限制地访问。
Qwen3.5-Plus 的上下文窗口扩展至 100 万 Token,而标准版 Qwen3.5 的上下文窗口为 256K Token。除“Thinking”和“Fast”外,Qwen3.5-Plus 还新增“Auto”模式,具备自适应思考能力,并可在思考之外使用搜索、代码解释器等工具。
Qwen3.5 的关键特性
下面来看一下 Qwen3.5 提供的一些新功能:
原生多模态能力
类似 OpenAI 在近期GPT-5.3 Codex 的发布中将标准与 Codex 模型合并,阿里也将文本、视觉与 UI 交互整合入同一模型。
Qwen3.5 共同训练了文本、图像、UI 截图与结构化内容。它支持视觉问答、文档理解、图表/表格解读,并能进行像素级对齐以识别并与屏幕元素交互。
视觉智能体能力
这引出了 Qwen3.5 的另一个重点。由于对 UI 截图的大量训练,模型能够识别并操作移动端和桌面端界面。这使其可以执行多步工作流,例如:
这使 Qwen3.5 非常适合生产力自动化。通过自然语言指令,您可以让视觉智能体跨多个应用执行操作,完成复杂工作流。它甚至能够在长时间交互序列中保持状态,从而实现稳健的工具与应用编排。
更强的性能与效率
Qwen3.5 是一款相当庞大的模型,总参数量为 3970 亿,但得益于专家混合(MoE) 架构,每个 Token 只激活 170 亿参数。简而言之,它具备超大模型的智能,同时拥有更小模型的速度与成本优势。
在实际表现上,与 Qwen3-Max 相比,Qwen3.5 397B-A17B 在长上下文任务(256k Token)的解码速度快 19 倍,在标准工作流上快 8.6 倍。关键在于,这种速度并未以智能为代价;凭借文本与视频的早期融合,它在推理与编程能力上仍可与 Qwen3-Max 持平,并优于 Qwen3-VL。
更优的成本效率
性能提升的同时,该模型也带来了成本方面的优化。
此外,原生 FP8 流水线(以 8 位精度而非常见的 16 位处理数据)使 Qwen3.5 的运行内存占用减少 50%。这意味着计算可以更快完成,在万亿 Token 规模下可带来超过 10% 的速度提升。
Qwen3.5 还具备高达 25 万的词表,能够用更少的 Token 表达复杂概念。配合多 Token 预测,模型可在一步中“猜测”多个后续词语,从而在 201 种语言中实现 10%—60% 的 Token 成本下降。
Qwen3.5 的研发方式
Qwen3.5 的开发采用了定制化基础设施,使多模态与智能体模型的训练(几乎)与纯文本模型一样快速且经济。其训练的特殊方法主要体现在三大要素:
数据质量
阿里团队采集的视觉-文本数据量远超 Qwen3 模型家族,但进行了非常严格的筛选以确保高质量输入。由此得到的高质量数据集,让 3970 亿参数的模型能够匹敌如 Qwen3-Max 等 1 万亿参数级模型的智能水平。
异构基础设施
视觉与语言部分分别、同时训练。由于彼此无需等待对方计算,重叠带来的效率使训练吞吐量几乎可与纯文本模型持平。
异步强化学习
通过使用 FP8 压缩(本质上以一半比特存储数值)与猜测式解码(前瞻性预测),智能体在后台训练无需等待的情况下,可同时运行成千上万项任务。此举在不显著牺牲质量的前提下加速了训练,让 Qwen3.5 以 3—5 倍的速度掌握复杂的智能体技能,如 UI 点击或多步任务。
Qwen3.5 基准评测
阿里新模型的性能已在多项任务上得到验证。我们将重点关注其在智能体与多模态工作流方面的结果,以及更通用的推理能力。
智能体工作流
与 Qwen3 系列相比,Qwen3.5 提升最大的领域是智能体工作流。
多模态
多模态也是相较于上一代模型家族提升显著的领域,尤其体现在具身推理与文档识别方面:
推理、知识与可靠性
推理与知识显然并非本次发布的主要焦点。但这些方面仍有小幅提升,尤其是在可靠性上。
如何使用 Qwen3.5
与以往类似,Qwen3.5 模型开源,可通过多种方式使用:在聊天应用中直接调用、通过 API 访问、下载本地部署,或集成到自定义系统中。
聊天界面
您可以直接在chat.qwen.ai 这一熟悉的聊天界面中使用 Qwen3.5。
模型选择下拉菜单提供 Qwen3.5-397B-A17B 与 Qwen3.5-Plus 两款模型,以及Qwen3 模型家族中的部分旧版本与Qwen2.5-Max。
API 访问
Qwen 3.5 的 API 访问方式与 Qwen3 相同:通过 ModelScope 的 OpenAI 兼容端点(免费层,按日配额)或 DashScope/Model Studio(付费,包含 Qwen3.5-Plus)。将模型 ID 更新为
qwen3.5-397b-a17b或qwen3.5-plus即可使用。开源权重与本地部署
如前所述,Qwen3.5-397B-A17B 的模型权重以 Apache 2.0 许可证发布。您可以使用Ollama、LM Studio 或 vLLM 等工具在本地运行 Qwen3.5。
您可以从以下渠道下载权重:
总结
凭借全新的视觉智能体、更强的性能与成本优化,Qwen3.5 的发布相当亮眼,不仅给国内模型带来压力,也对 OpenAI 与 Anthropic 的产品构成挑战。
与今年其他新品(如 GPT-5.3-Codex 和 Claude Opus 4.6)一样,行业的关注点正明显转向智能体 AI。OpenClaw 的迅速走红证明了大众对 AI 实用落地的渴望,而 Qwen3.5、Seedance 2.0 以及传闻中即将发布的 DeepSeek 新品,则显示中国正在快速成为 AI 模型领域的市场引领者。