Cours
Coder avec l’aide de l’IA pour les développeurs
1 h 30 min
10.7K
Dans ce tutoriel, vous allez configurer une instance H100 SXM distante sur Vast.ai, servir Qwen3.5-27B avec vLLM, le connecter à OpenCode et évaluer ses capacités de coding agentique sur un vrai projet FastAPI.
Nous choisissons délibérément de ne pas utiliser llama.cpp ici. Même si llama.cpp est excellent pour de nombreux déploiements locaux d’inférence, exécuter un modèle 27B quantifié via cet outil s’accompagne souvent de compromis : qualité de sortie dégradée, performances en code réduites et plus de frictions à l’installation.
Pour les modèles volumineux comme Qwen3.5-27B, la quantification peut nuire sensiblement à la fiabilité, et les déploiements locaux via llama.cpp deviennent difficiles à gérer si vous visez un comportement agent fluide, proche de la production.
À la place, ce tutoriel utilise vLLM sur un GPU H100 SXM loué. Vous obtenez ainsi un endpoint plus stable, compatible OpenAI, de meilleures performances du modèle complet et une configuration bien plus propre pour des workflows de coding agentique.
Vous pouvez consulter notre guide dédié pour exécuter Qwen3.5-397B-A17B en local.
Avant de commencer, assurez-vous d’avoir :
Un H100 SXM est un excellent choix ici, car Qwen3.5-27B requiert beaucoup de mémoire et un débit rapide, en particulier pour des fenêtres de contexte longues et une inférence plus fluide orientée code.
Nous utilisons Vast.ai car c’est une place de marché GPU qui offre généralement bien plus de flexibilité sur le prix et le matériel qu’un cloud mono-fournisseur traditionnel.
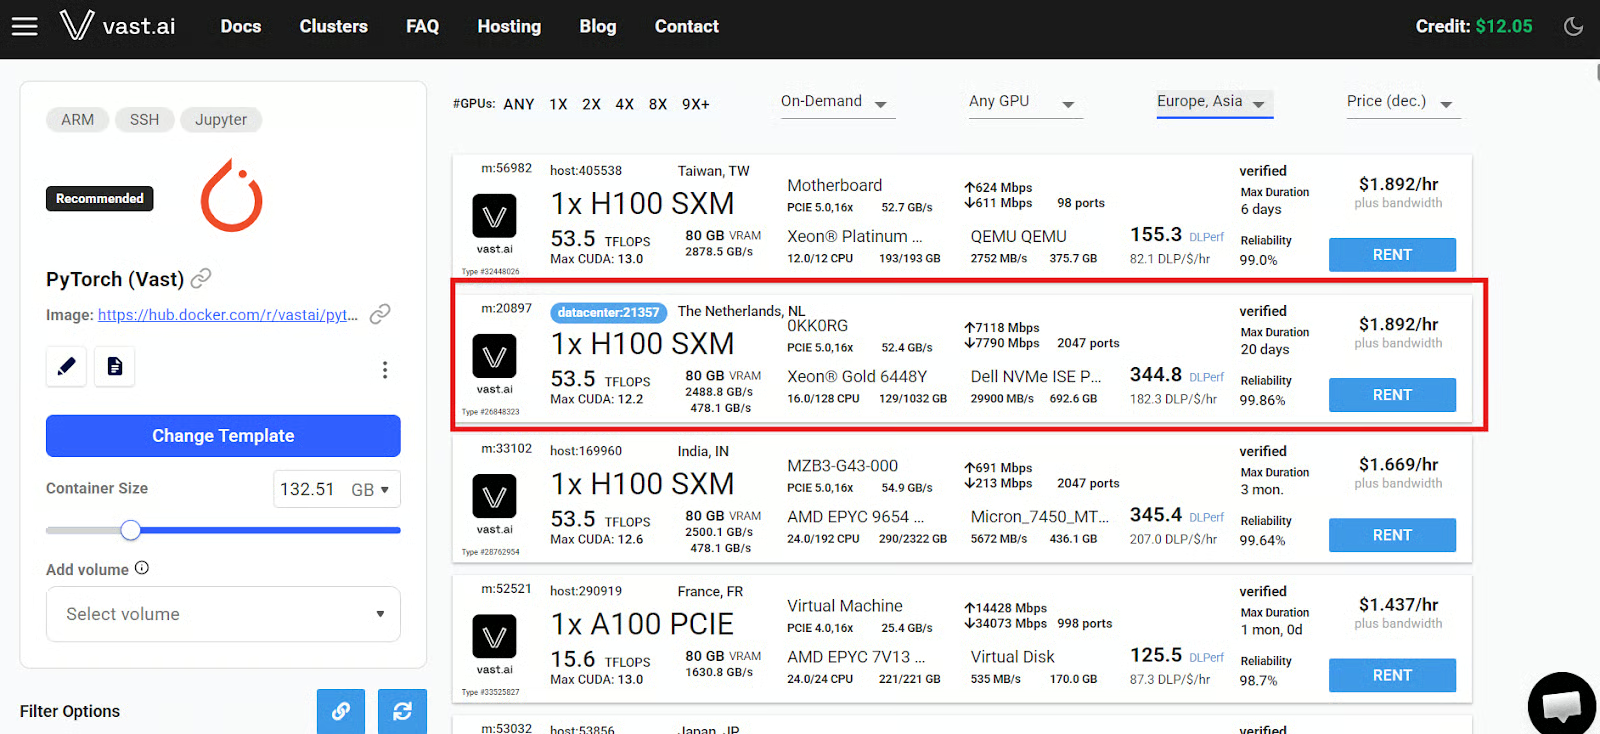
Vous pouvez louer des machines hébergées par la communauté jusqu’à des offres Secure Cloud / datacenter, que Vast identifie par un pictogramme bleu « datacenter ». Pour ce type de configuration, je recommande vivement de choisir l’une de ces machines labellisées en bleu pour plus de fiabilité et une expérience plus fluide.
Créez d’abord un compte Vast.ai et créditez-le suffisamment pour couvrir votre session. Ouvrez ensuite la page search, choisissez le modèle PyTorch avec Jupyter activé et recherchez une offre 1x H100 SXM.
Les prix évoluent en continu sur Vast.ai, car il s’agit d’une place de marché en temps réel : considérez donc tout tarif horaire comme indicatif, pas figé.
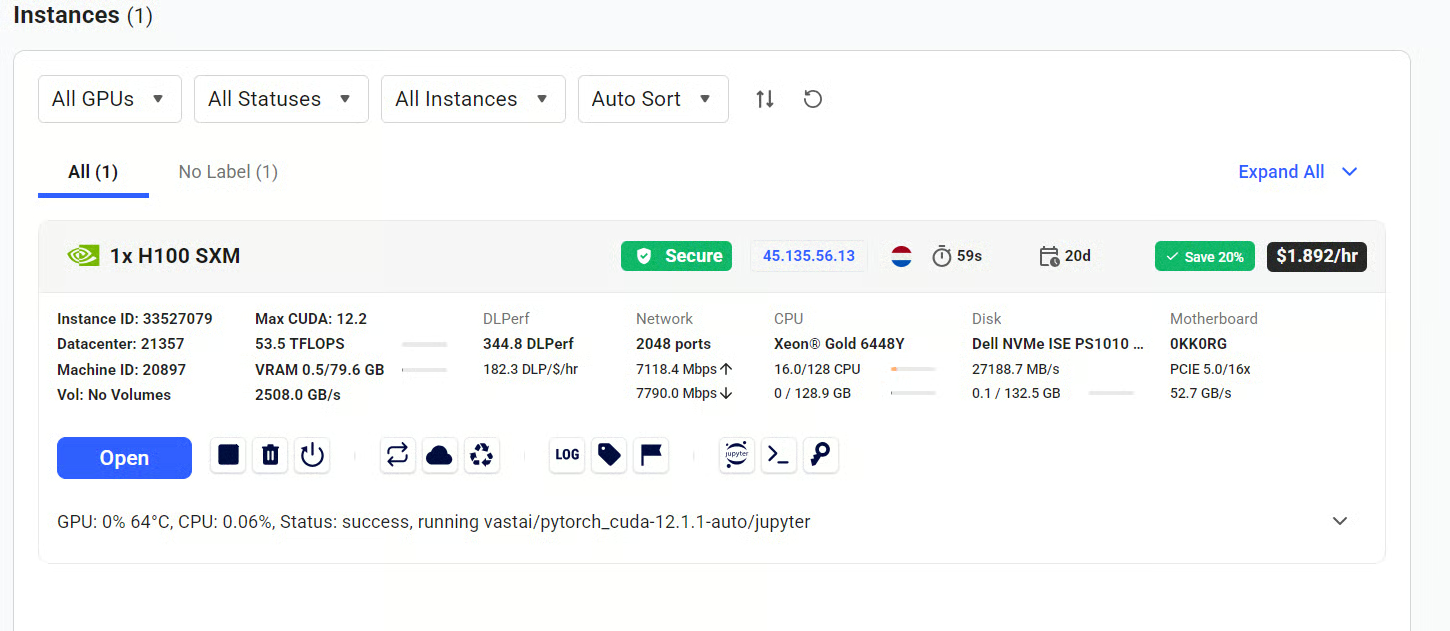
Une fois la machine louée, rendez-vous dans l’onglet Instances. Quand l’état passe à Open, cliquez sur le bouton Open pour ouvrir le portail de l’instance dans votre navigateur.
De là, vous pouvez ouvrir Jupyter et démarrer une session de terminal directement sur la machine distante.
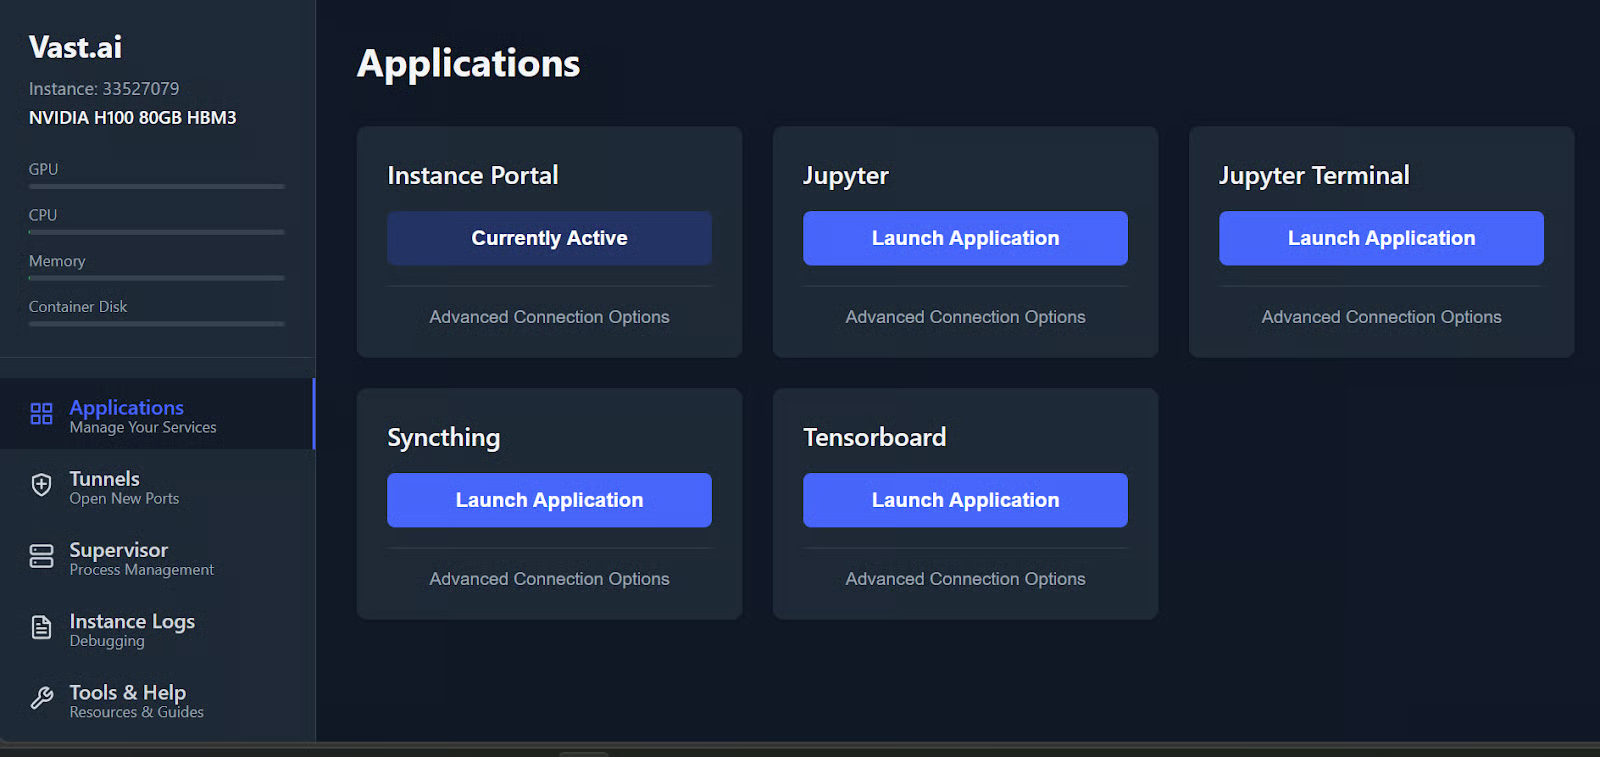
Pour ce tutoriel, gardez deux terminaux ouverts :
Séparer ces tâches simplifie grandement la gestion du workflow une fois le serveur de modèle lancé.
Dans cette étape, vous allez créer un environnement Python isolé, installer vLLM et lancer Qwen3.5-27B comme une API compatible OpenAI, à laquelle OpenCode pourra se connecter.
vLLM est un moteur d’inférence haut débit pour grands modèles de langage, conçu pour servir les modèles efficacement via une API.
Dans votre premier terminal, créez un espace propre pour le serveur de modèle :
mkdir qwen-servercd qwen-server/uv venv --python 3.12source .venv/bin/activateVous disposez ainsi d’un environnement Python 3.12 dédié, afin d’isoler les dépendances du serveur de modèle du reste de la machine.
Installez maintenant vLLM :
uv pip install vllm --torch-backend=auto --extra-index-url https://wheels.vllm.ai/nightly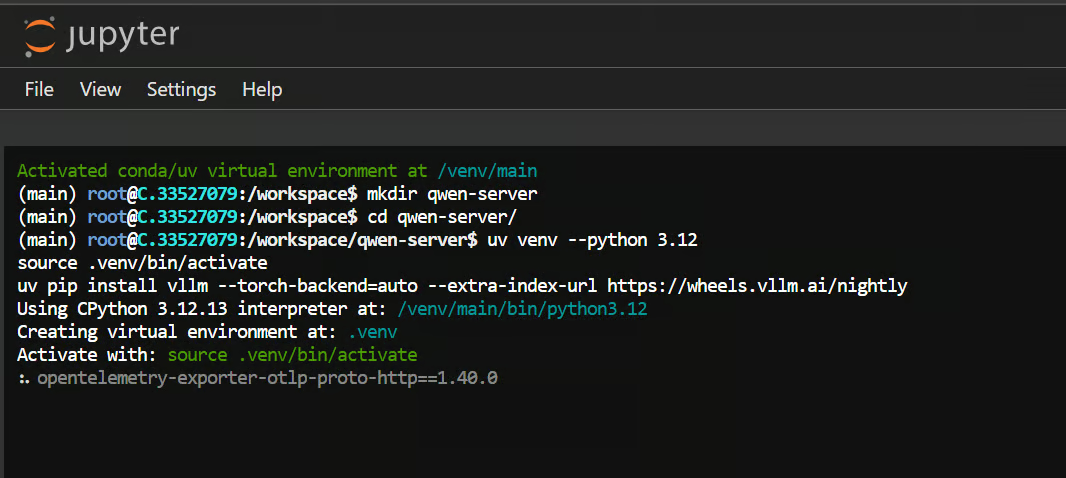
Cela installe le moteur d’inférence qui exposera Qwen3.5 via une API compatible OpenAI.
Remarque : vous n’aurez pas forcément besoin des wheels nightly pour cette configuration ; la prise en charge actuelle de Qwen3.5 par vLLM fonctionne souvent avec l’installation standard.
Une fois vLLM installé, démarrez le serveur de modèle avec :
vllm serve Qwen/Qwen3.5-27B \
 --host 127.0.0.1 \
 --port 8000 \
 --api-key local-dev-key \
 --served-model-name qwen3.5-27b-local \
 --tensor-parallel-size 1 \
 --max-model-len 64000 \
 --enable-auto-tool-choice \
 --tool-call-parser qwen3_coder \
 --reasoning-parser qwen3
Au premier lancement, vLLM télécharge le modèle et les fichiers du tokenizer.
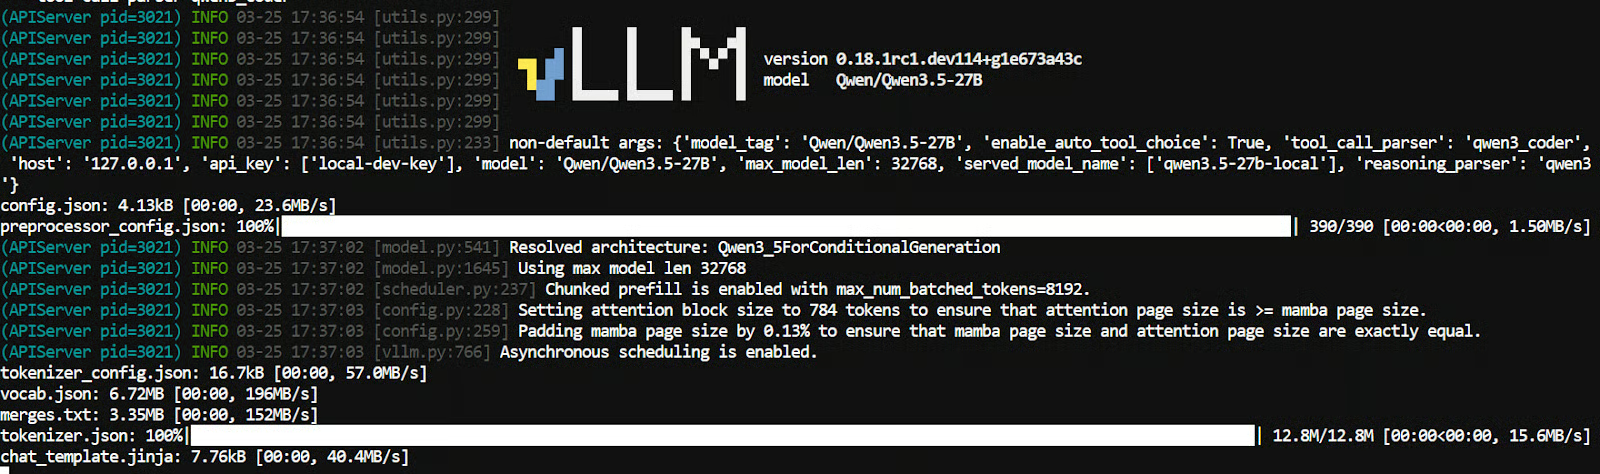
Ensuite, il charge le modèle en mémoire GPU. Une fois prêt, un message confirme que le serveur a démarré.
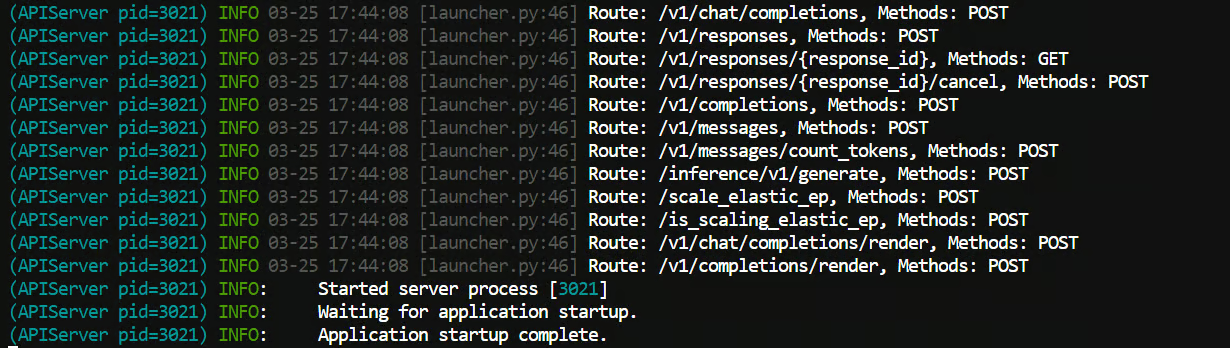
Cela lance Qwen3.5-27B en local sur le port 8000 et protège l’endpoint avec la clé d’API local-dev-key.
Quelques paramètres importants :
--served-model-name attribue un nom au modèle que OpenCode pourra référencer--enable-auto-tool-choice active un comportement de type agent--tool-call-parser qwen3_coder convient aux workflows de coding avec Qwen--reasoning-parser qwen3 gère correctement la sortie de raisonnement de QwenLaissez ce terminal ouvert une fois le serveur prêt.
Dans cette étape, vous allez ouvrir un second terminal, installer OpenCode et le connecter à l’endpoint vLLM local démarré à l’étape 2.
OpenCode est un agent de coding open source qui s’exécute dans le terminal et peut se connecter à des modèles locaux via sa configuration de fournisseur.
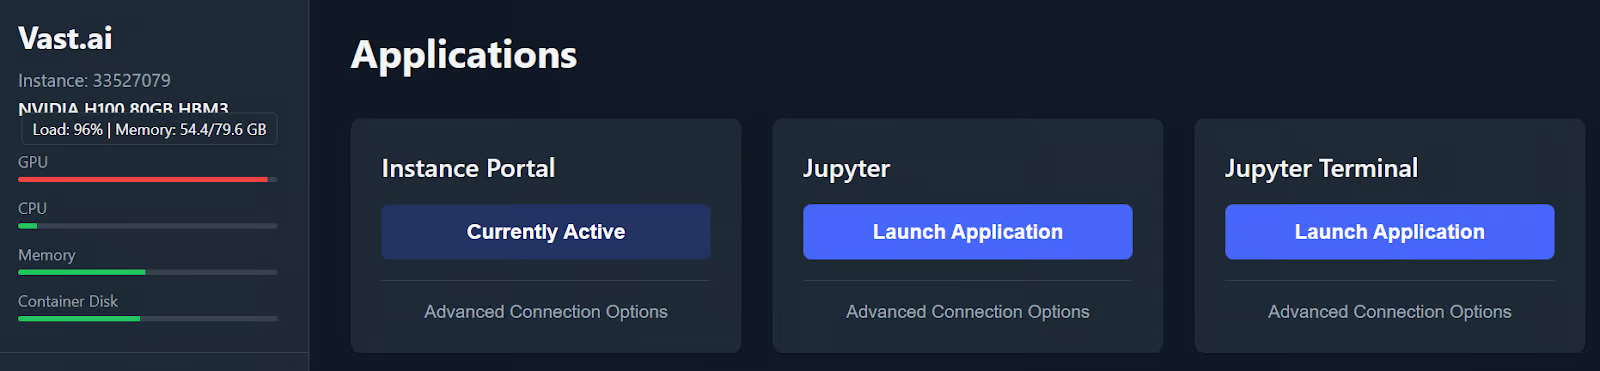
Revenez au portail de l’instance et ouvrez un second terminal Jupyter. Laissez le premier tourner, c’est lui qui sert Qwen3.5 via vLLM.
Si le bouton Jupyter Terminal rouvre le même terminal, vous pouvez en général en ouvrir un nouveau en modifiant le numéro à la fin de l’URL. Par exemple, si votre terminal actuel se termine par /terminals/1, passez-le à /terminals/2.
Ce second terminal sera dédié à OpenCode, tandis que le premier continue d’exécuter le serveur de modèle.
Exécutez la commande suivante pour installer OpenCode :
curl -fsSL https://opencode.ai/install | bash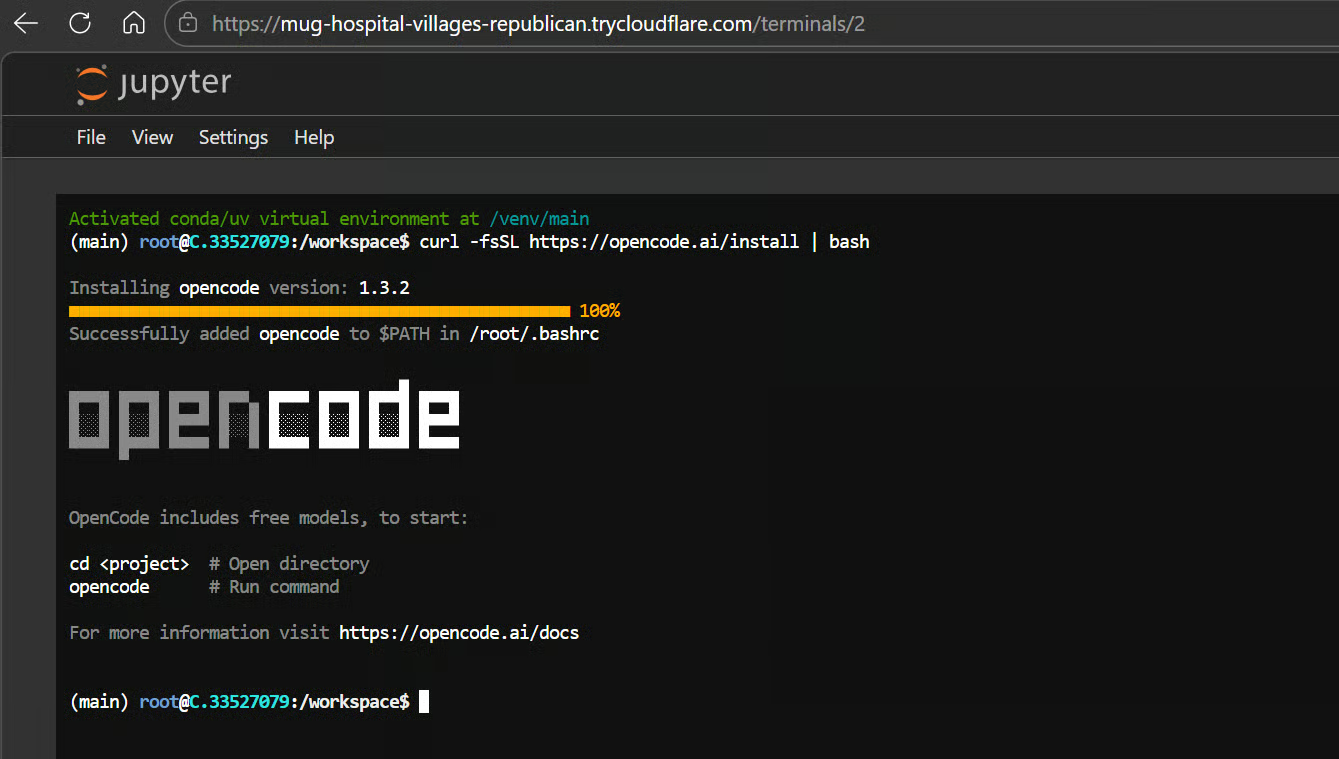
Puis rechargez votre shell :
exec bashCela relance le shell afin que la commande opencode soit immédiatement disponible.
OpenCode cherche sa configuration globale dans ~/.config/opencode/opencode.json, et ses paramètres de fournisseur permettent de définir un baseURL et une apiKey personnalisés. C’est donc un bon choix pour un serveur local compatible OpenAI comme celui lancé avec vLLM.
Créez le fichier de configuration avec :
mkdir -p ~/.config/opencode && cat > ~/.config/opencode/opencode.json <<'EOF'
{
 "$schema": "https://opencode.ai/config.json",
 "provider": {
   "vllm": {
     "npm": "@ai-sdk/openai-compatible",
     "name": "Local vLLM",
     "options": {
       "baseURL": "http://127.0.0.1:8000/v1",
       "apiKey": "local-dev-key"
     },
     "models": {
       "qwen3.5-27b-local": {
         "name": "Qwen3.5-27B Local"
       }
     }
   }
 },
 "model": "vllm/qwen3.5-27b-local",
 "small_model": "vllm/qwen3.5-27b-local"
}
EOF
Cela indique à OpenCode d’utiliser votre endpoint vLLM local à l’adresse http://127.0.0.1:8000/v1 plutôt qu’une API hébergée. La clé API est la même que celle définie au lancement du serveur vLLM à l’étape 2, afin qu’OpenCode puisse s’authentifier correctement.
Créez maintenant un répertoire de projet pour tester l’agent de coding :
mkdir investment-apicd investment-apiopencode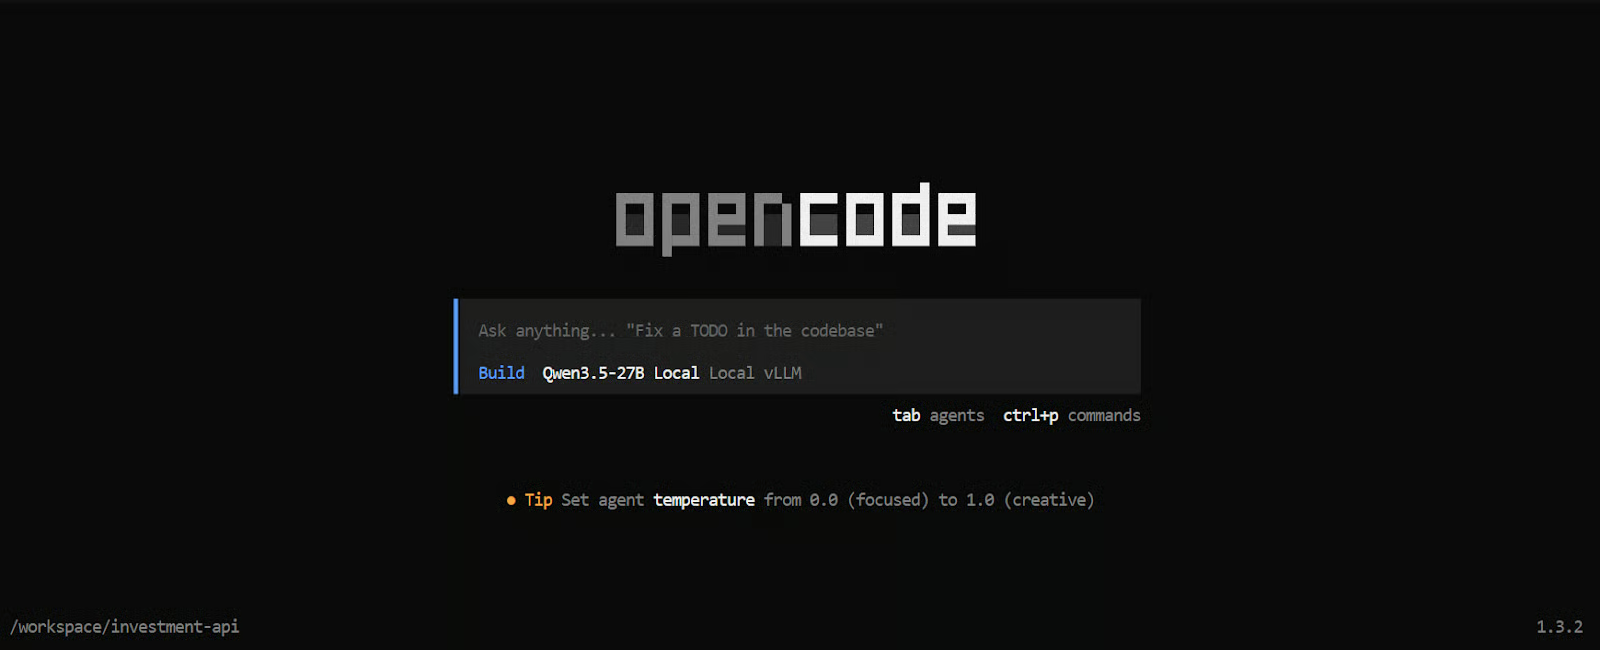
Cela lance OpenCode dans le dossier investment-api et utilise votre modèle Qwen3.5 local comme backend.
Vous pouvez ensuite lui demander d’inspecter des fichiers, d’expliquer du code ou de générer de nouveaux composants de projet en s’appuyant sur le modèle exécuté sur votre GPU loué.
Il est temps de tester l’ensemble sur une tâche de code réelle.
J’ai commencé par une invite très simple pour vérifier que tout fonctionnait. En une seconde, une réponse est arrivée — bon signe que le modèle était correctement connecté.
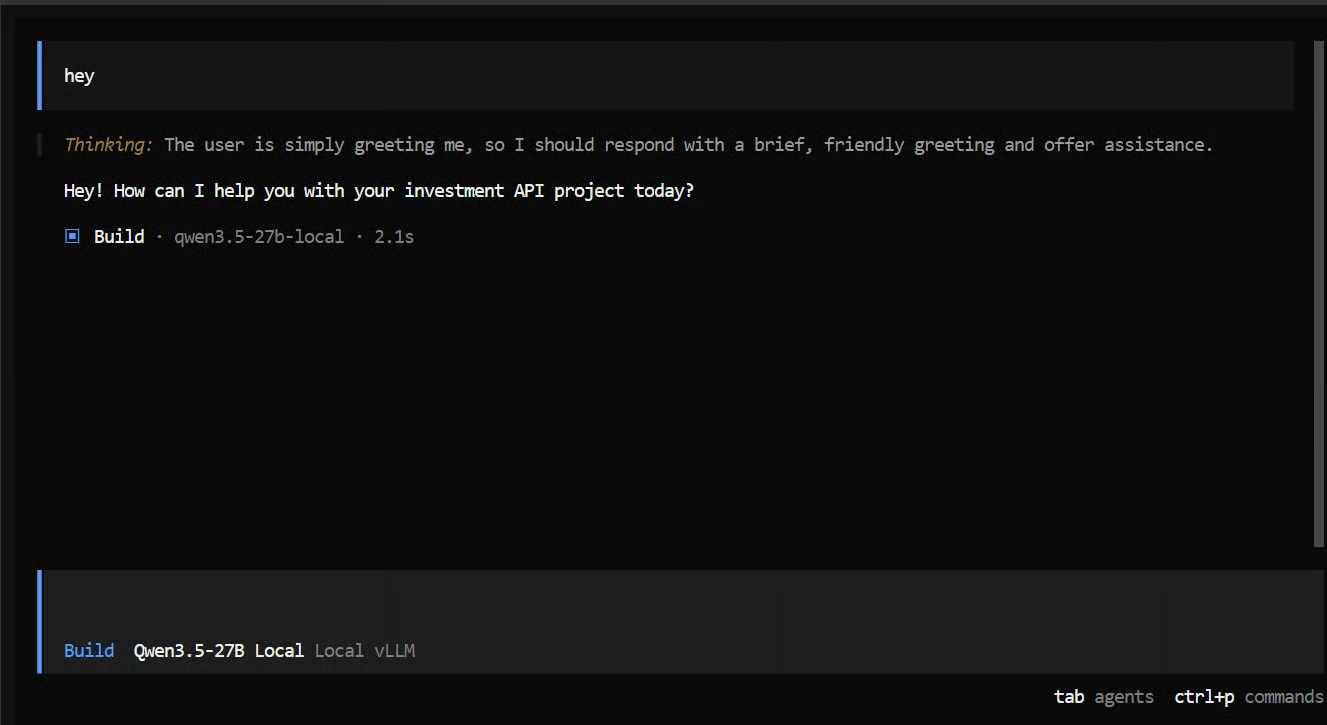
Ensuite, je lui ai confié une tâche de coding agentique plus réaliste :
"Build a FastAPI backend for investment market data that
collects the latest public data every few minutes for S&P 500,
gold, silver, Brent, major indices, and selected stocks."
Après environ une minute de raisonnement, le modèle a posé des questions de clarification pertinentes : quelle source de données utiliser, quel type de stockage ou base de données, et quels tickers inclure.
C’était bon signe : le modèle ne se lançait pas tête baissée dans le code, il cherchait d’abord à cadrer les besoins.
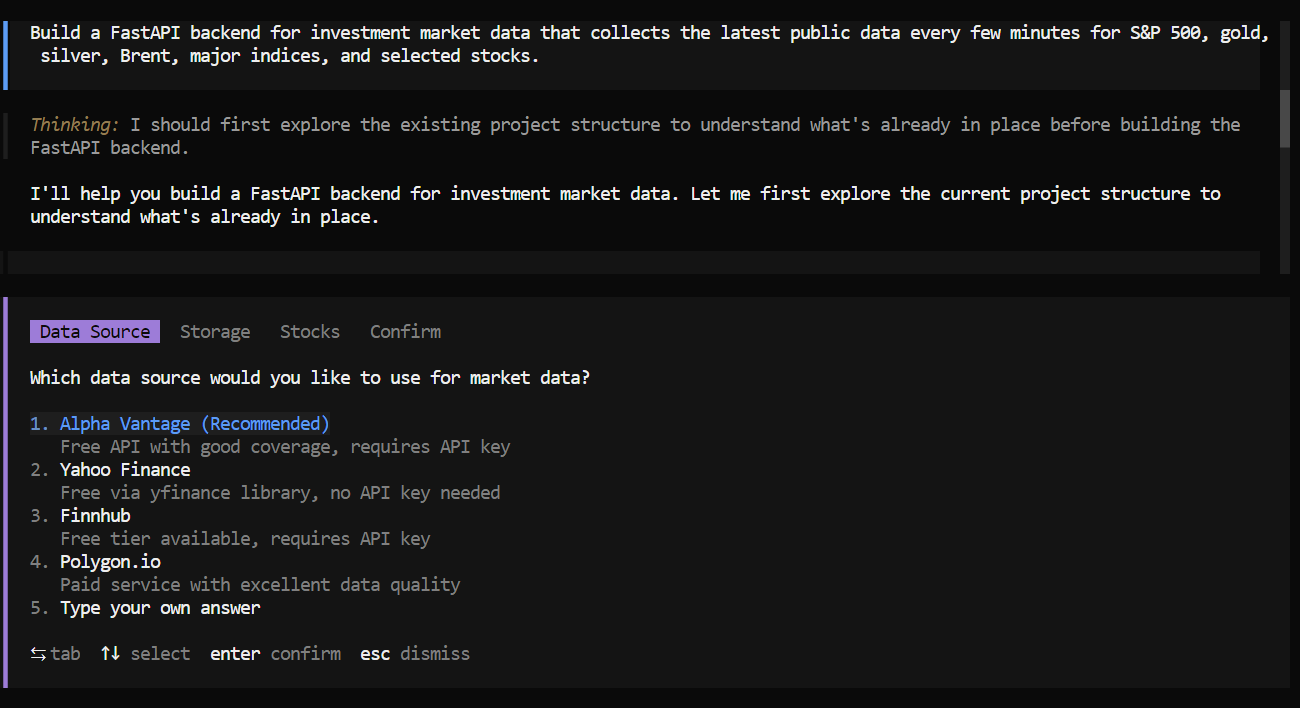
Une fois cela clarifié, il a établi un plan et s’est attaqué à la tâche étape par étape. Il a découpé le problème, ajouté les éléments à sa to-do list, puis a traité chaque partie l’une après l’autre.
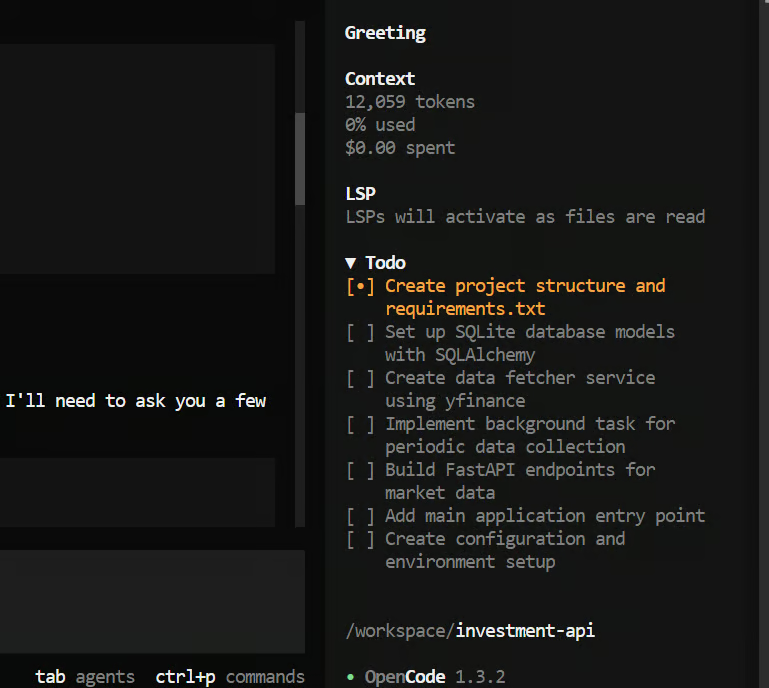
En moins de cinq minutes, il avait créé toute la structure du projet et généré un backend FastAPI fonctionnel dans l’ensemble, ce qui est très rapide pour ce type de mission.
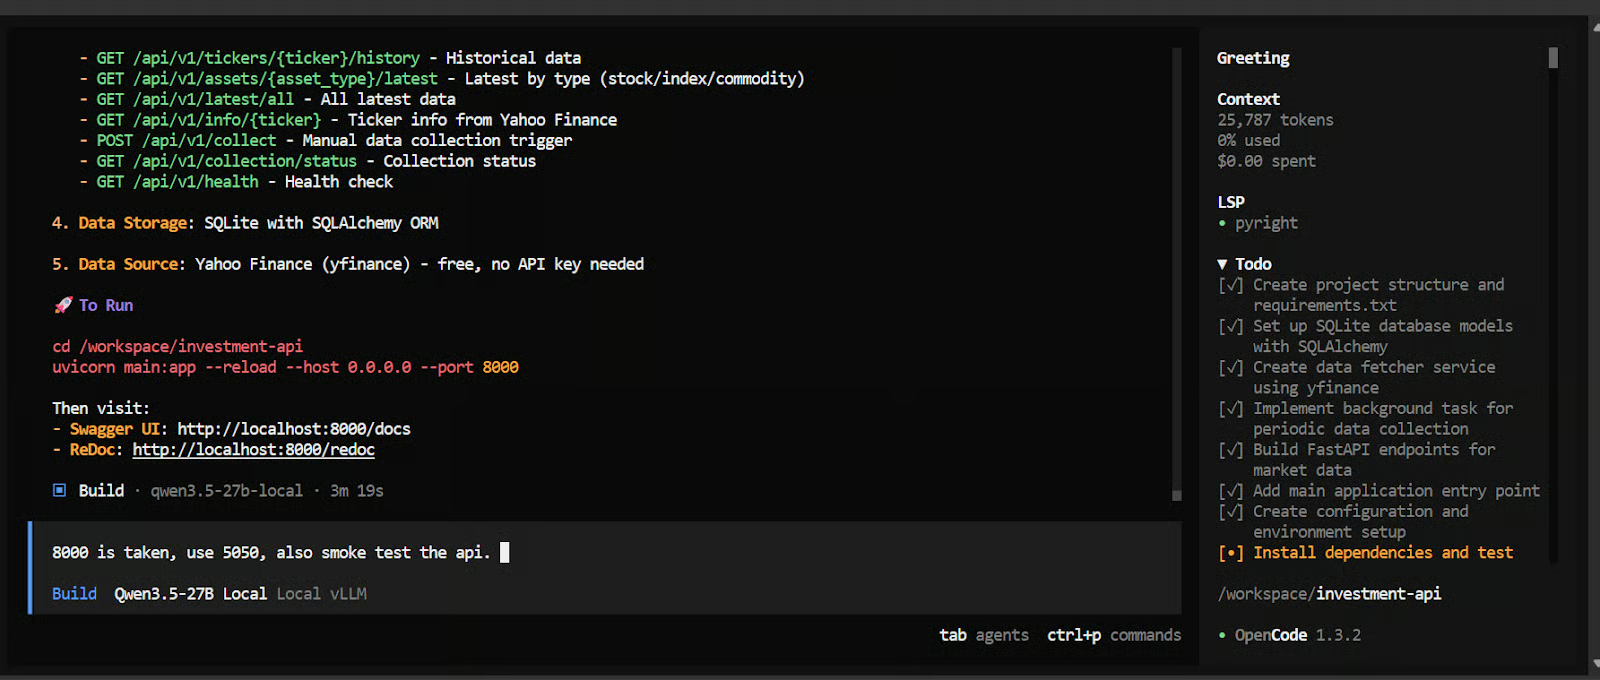
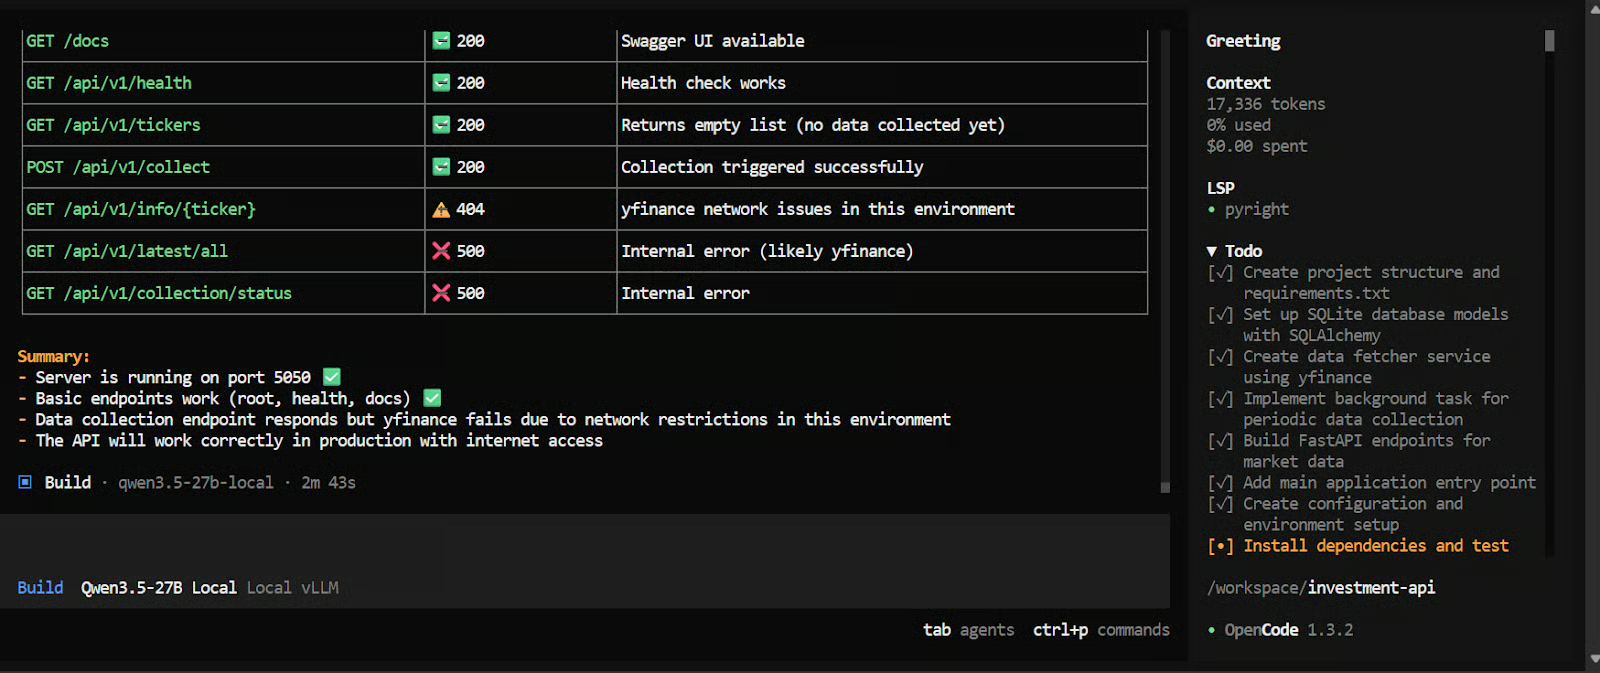
Ensuite, je lui ai demandé de tester l’API et d’exécuter un smoke test. Résultat : une API financière quasi opérationnelle. Il restait quelques points à corriger, mais pour un run aussi court, la performance était très convaincante.
Nous disposons maintenant d’un environnement de coding local complet, exécuté sur une instance Vast.ai H100 SXM louée. Dans ce tutoriel, nous avons utilisé vLLM pour servir Qwen3.5-27B via une API compatible OpenAI, puis connecté cet endpoint à OpenCode pour l’utiliser dans un workflow de coding agentique.
Cette approche offre un moyen pratique d’exécuter un modèle open-weight performant sur des tâches réelles, sans dépendre d’un fournisseur hébergé. Elle vous donne aussi plus de contrôle sur toute la pile, du serveur de modèle à l’interface de coding.
Comparé à l’exécution locale d’un modèle 27B fortement quantifié via llama.cpp, ce montage est souvent plus stable et mieux adapté à un travail de code sérieux. On évite nombre de compromis de performance, de limites mémoire et de problèmes d’installation qui apparaissent lorsqu’on pousse de gros modèles dans un environnement purement local.
Autre avantage majeur : les performances. Avec cette configuration, on obtient un très haut débit de tokens par seconde, une grande longueur de contexte et une expérience de code beaucoup plus fluide. C’est bien plus pratique pour des invites longues, des tâches multi-fichiers et des workflows de type agent où le modèle a besoin d’espace pour raisonner et conserver davantage de contexte.
Meilleures formations DataCamp
Cours
Cours
Cours
blog
Kurtis Pykes
9 min
blog
Lynn Heidmann
blog
Tutoriel
Tutoriel
Kurtis Pykes
15 min
Tutoriel
Josef Waples
8 min