Corso
Programmazione assistita dall'AI per sviluppatori
1 ore 30 min
10.7K
In questo tutorial configurerai un'istanza remota H100 SXM su Vast.ai, servirai Qwen3.5-27B con vLLM, lo collegherai a OpenCode e testerai le sue capacità di coding agentico su un vero progetto FastAPI.
Qui non stiamo usando llama.cpp di proposito. Sebbene llama.cpp sia eccellente per molti setup di inferenza locale, eseguire un modello quantizzato da 27B attraverso di esso spesso comporta compromessi: qualità dell’output inferiore, prestazioni di coding ridotte e più attriti in fase di configurazione.
Per modelli più grandi come Qwen3.5-27B, la quantizzazione può ridurre in modo evidente l’affidabilità e le distribuzioni locali tramite llama.cpp possono diventare difficili da gestire se vuoi un comportamento agentico fluido e vicino alla produzione.
Invece, questo tutorial utilizza vLLM su una GPU H100 SXM a noleggio. Otterrai un endpoint più stabile compatibile con OpenAI, prestazioni migliori dal modello completo e un setup molto più pulito per flussi di lavoro di coding agentico.
Puoi consultare la nostra guida separata per eseguire Qwen3.5-397B-A17B in locale.
Prima di iniziare, assicurati di avere:
Una H100 SXM è un’ottima scelta per questo setup perché Qwen3.5-27B richiede molta memoria e throughput veloce, soprattutto per finestre di contesto più lunghe e un’inferenza fluida orientata al coding.
Usiamo Vast.ai perché è un marketplace di GPU che di solito offre molta più flessibilità su prezzi e hardware rispetto a un cloud tradizionale di un singolo fornitore.
Puoi noleggiare qualsiasi cosa, da macchine ospitate dalla community a offerte Secure Cloud / datacenter, che Vast contrassegna con un bollino blu datacenter. Per un setup come questo, consiglio vivamente di scegliere una di quelle macchine contrassegnate in blu per una migliore affidabilità e un’esperienza più fluida.
Inizia creando un account Vast.ai e aggiungendo credito sufficiente a coprire la sessione. Poi apri la pagina di ricerca, seleziona il template PyTorch con Jupyter abilitato e cerca un’offerta 1x H100 SXM.
I prezzi cambiano continuamente su Vast.ai perché è un marketplace live, quindi considera qualsiasi tariffa oraria come approssimativa e non fissa.
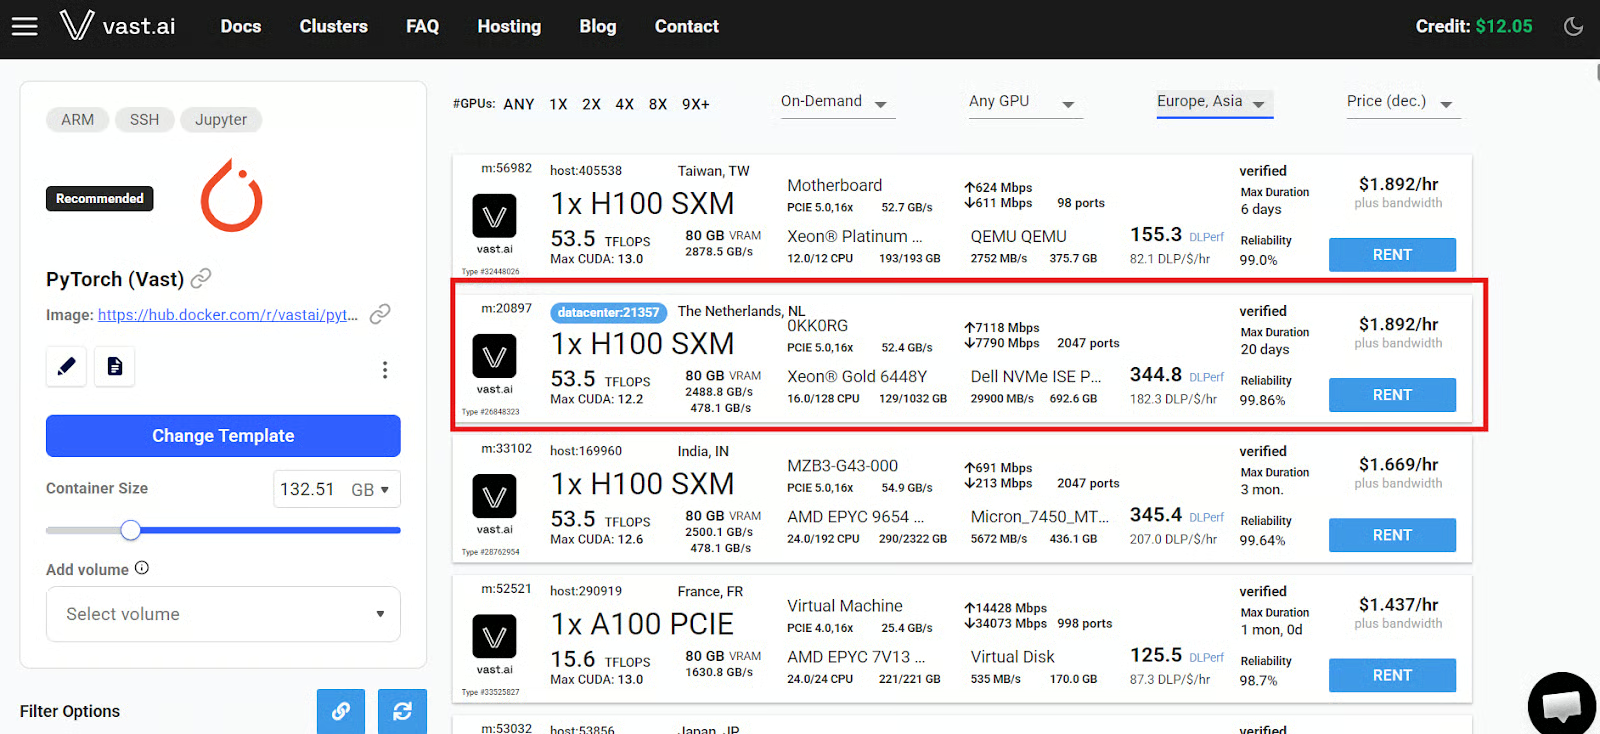
Una volta noleggiata la macchina, vai alla scheda Instances. Quando lo stato passa a Open, clicca sul pulsante Open per aprire il portale dell’istanza nel browser.
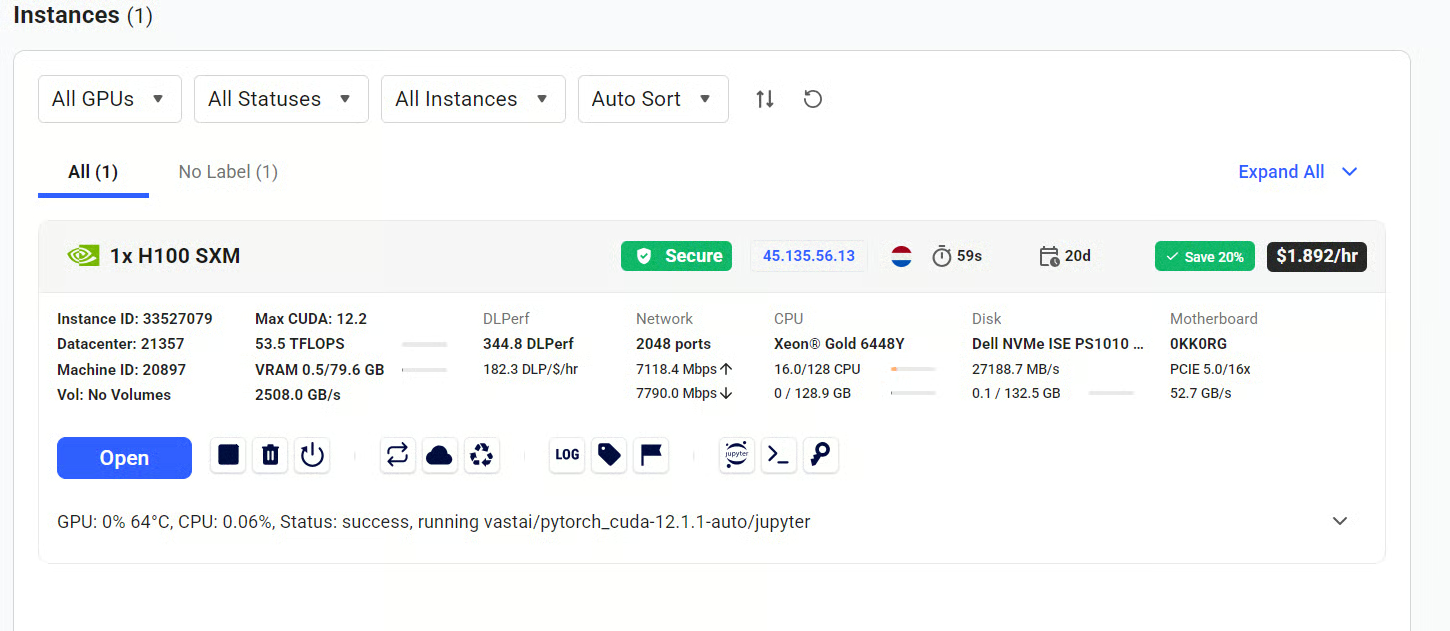
Da lì puoi aprire Jupyter e avviare una sessione di terminale direttamente sulla macchina remota.
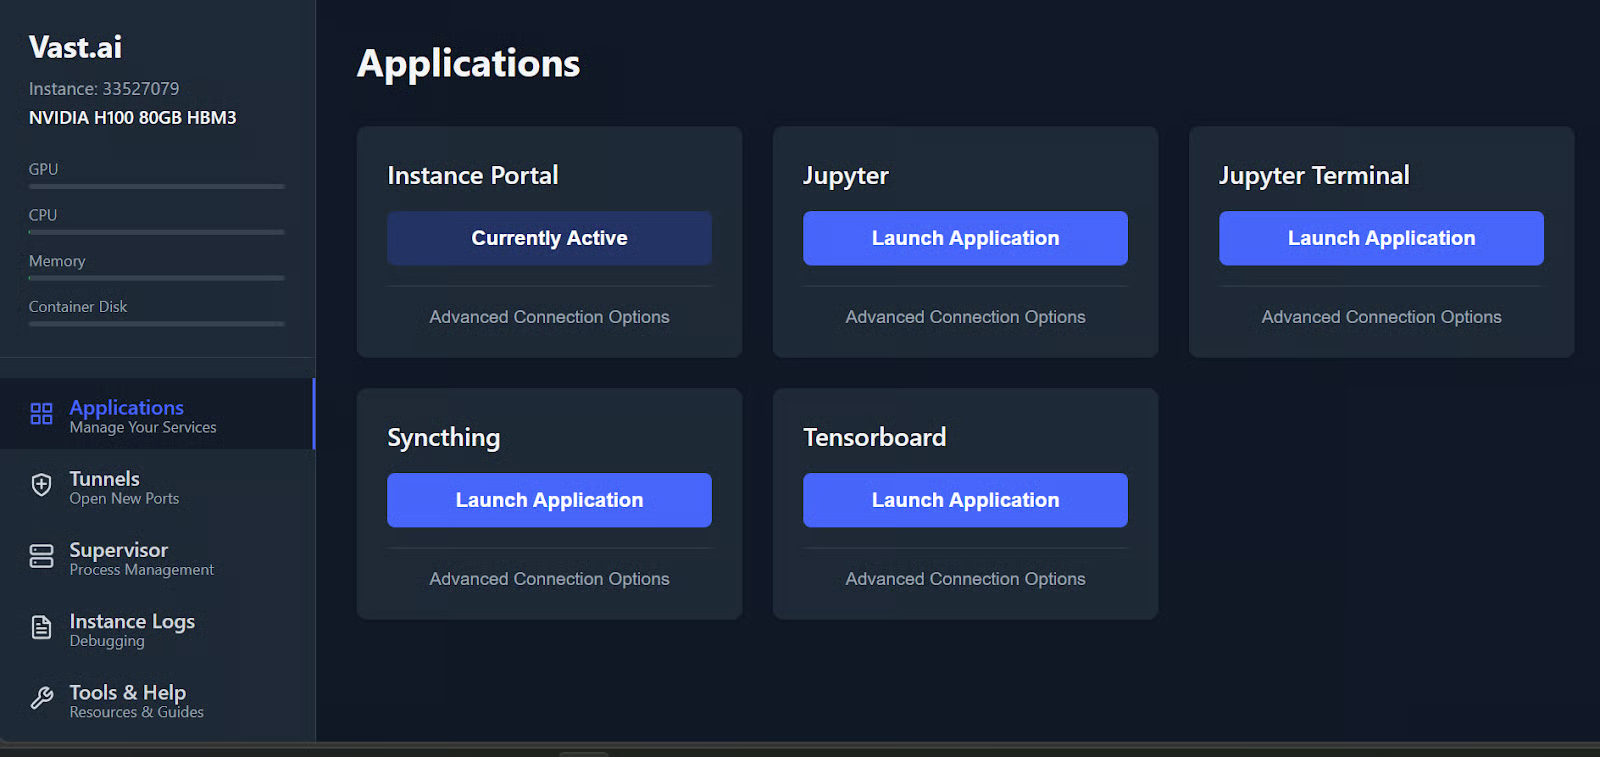
Per questo tutorial, tieni aperti due terminali:
Tenere separate queste attività rende il flusso di lavoro molto più semplice da gestire una volta che il server del modello è in esecuzione.
In questo passaggio creerai un ambiente Python isolato, installerai vLLM e avvierai Qwen3.5-27B come API compatibile con OpenAI a cui OpenCode può connettersi.
vLLM è un motore di inferenza ad alto throughput per LLM, progettato per servire i modelli in modo efficiente tramite API.
Nel primo terminale, crea uno spazio di lavoro pulito per il server del modello:
mkdir qwen-servercd qwen-server/uv venv --python 3.12source .venv/bin/activateQuesto ti dà un ambiente Python 3.12 dedicato, così le dipendenze del server del modello restano isolate dal resto della macchina.
Ora installa vLLM:
uv pip install vllm --torch-backend=auto --extra-index-url https://wheels.vllm.ai/nightly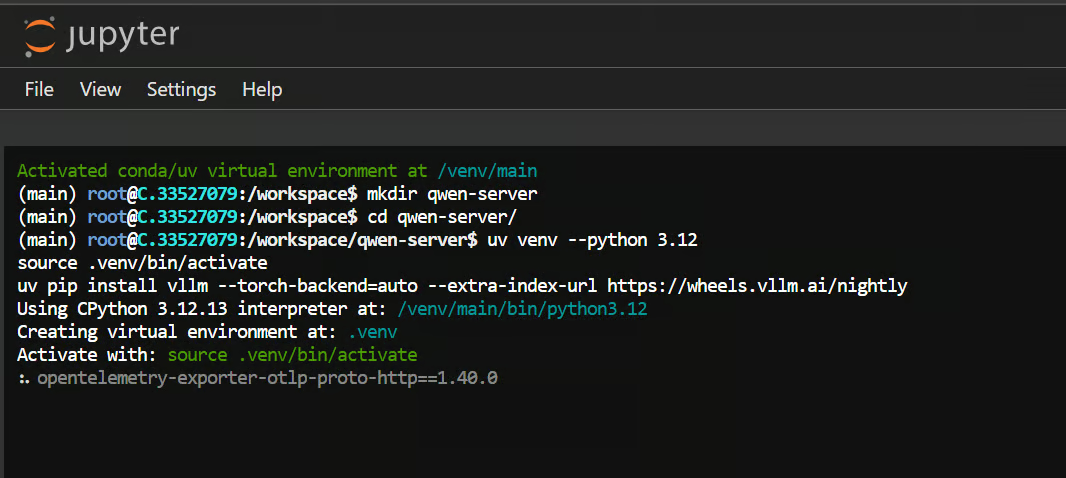
Questo installa il motore di inferenza che esporrà Qwen3.5 tramite un’API compatibile con OpenAI.
Nota: per questo setup potresti non aver bisogno delle nightly wheels, dato che il supporto attuale di vLLM per Qwen3.5 spesso funziona anche con l’installazione standard.
Una volta installato vLLM, avvia il server del modello con:
vllm serve Qwen/Qwen3.5-27B \
 --host 127.0.0.1 \
 --port 8000 \
 --api-key local-dev-key \
 --served-model-name qwen3.5-27b-local \
 --tensor-parallel-size 1 \
 --max-model-len 64000 \
 --enable-auto-tool-choice \
 --tool-call-parser qwen3_coder \
 --reasoning-parser qwen3
La prima volta che esegui questo comando, vLLM scaricherà i file del modello e del tokenizer.
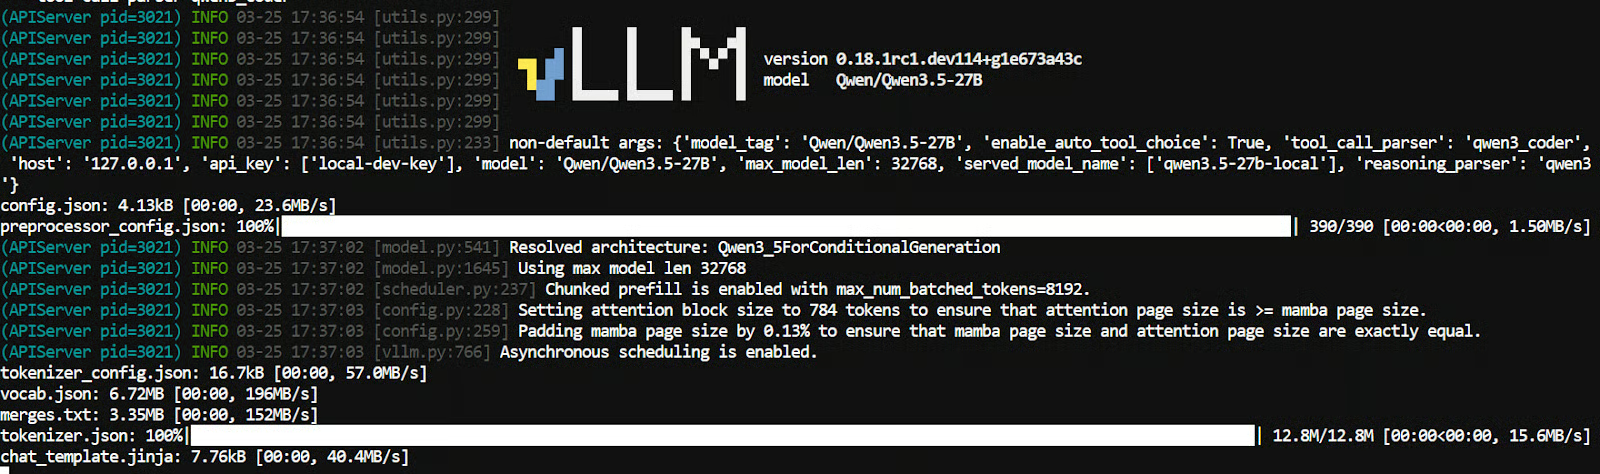
Dopodiché caricherà il modello nella memoria GPU. Quando tutto è pronto, dovresti vedere un messaggio che indica il completamento dell’avvio del server.
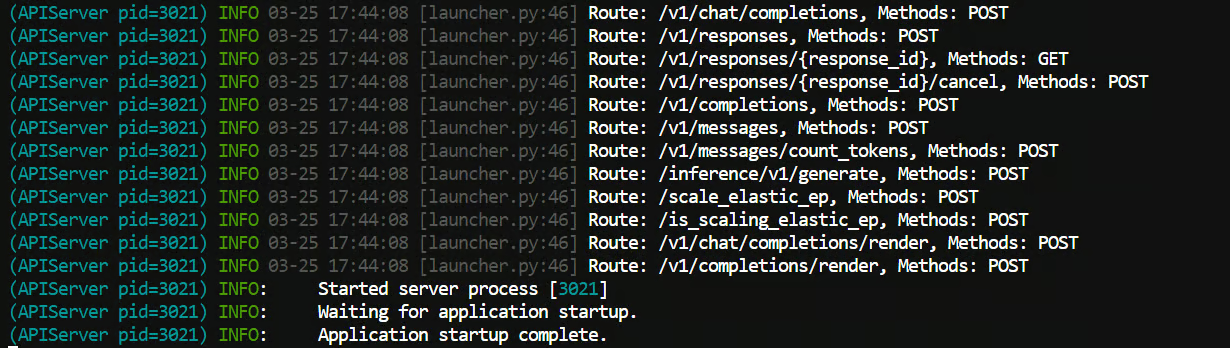
Questo avvia Qwen3.5-27B in locale sulla porta 8000 e protegge l’endpoint con la chiave API local-dev-key.
Ci sono alcuni dettagli importanti:
--served-model-name fornisce un nome al modello a cui OpenCode può fare riferimento--enable-auto-tool-choice abilita il comportamento in stile agente--tool-call-parser qwen3_coder è adatto ai flussi di lavoro di coding con Qwen--reasoning-parser qwen3 aiuta a gestire correttamente l’output di reasoning di QwenLascia questo terminale in esecuzione una volta che il server è pronto.
In questo passaggio aprirai un secondo terminale, installerai OpenCode e lo collegherai all’endpoint vLLM locale avviato nel Passaggio 2.
OpenCode è un agente di coding open-source che può essere eseguito nel terminale e connettersi a modelli locali tramite la sua configurazione del provider.
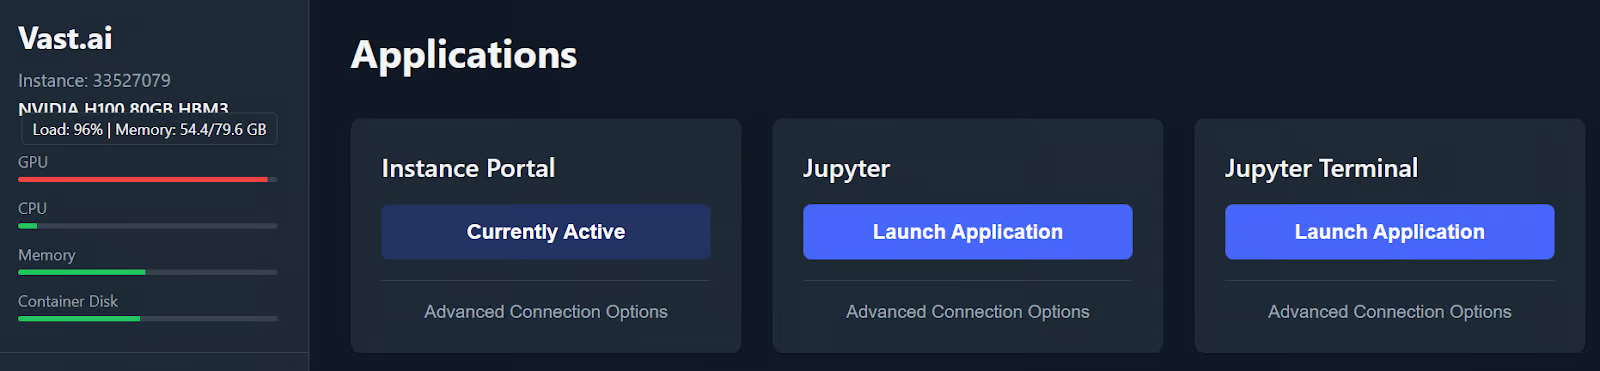
Torna al portale dell’istanza e apri un secondo terminale Jupyter. Mantieni il primo terminale in esecuzione, perché è quello che serve Qwen3.5 tramite vLLM.
Se cliccando il pulsante Jupyter Terminal si apre di nuovo lo stesso terminale, in genere puoi aprirne un altro cambiando il numero alla fine dell’URL del terminale. Ad esempio, se il tuo terminale attuale termina con /terminals/1, cambialo in /terminals/2.
Questo secondo terminale sarà il tuo terminale OpenCode, mentre il primo continuerà a eseguire il server del modello.
Esegui il seguente comando per installare OpenCode:
curl -fsSL https://opencode.ai/install | bash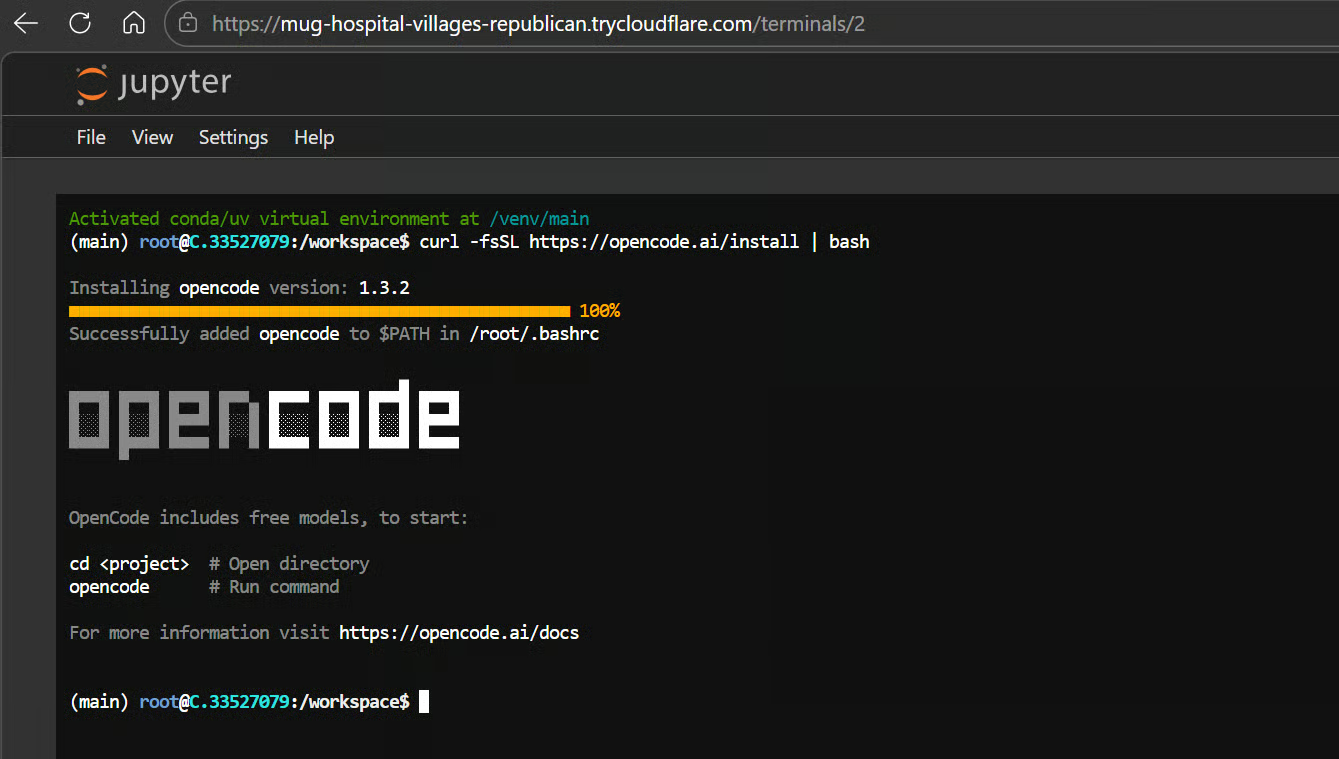
Poi ricarica la shell:
exec bashQuesto ricarica la shell, così il comando opencode è disponibile subito.
OpenCode cerca la sua configurazione globale in ~/.config/opencode/opencode.json e le impostazioni del provider supportano valori personalizzati per baseURL e apiKey. Ciò lo rende ideale per un server locale compatibile con OpenAI come quello che hai avviato con vLLM.
Crea il file di configurazione con:
mkdir -p ~/.config/opencode && cat > ~/.config/opencode/opencode.json <<'EOF'
{
 "$schema": "https://opencode.ai/config.json",
 "provider": {
   "vllm": {
     "npm": "@ai-sdk/openai-compatible",
     "name": "Local vLLM",
     "options": {
       "baseURL": "http://127.0.0.1:8000/v1",
       "apiKey": "local-dev-key"
     },
     "models": {
       "qwen3.5-27b-local": {
         "name": "Qwen3.5-27B Local"
       }
     }
   }
 },
 "model": "vllm/qwen3.5-27b-local",
 "small_model": "vllm/qwen3.5-27b-local"
}
EOF
Questo indica a OpenCode di usare il tuo endpoint vLLM locale all’indirizzo http://127.0.0.1:8000/v1 invece di un’API hosted. Usa anche la stessa chiave API impostata all’avvio del server vLLM nel Passaggio 2, così OpenCode può autenticarsi correttamente.
Ora crea una directory di progetto per testare l’agente di coding:
mkdir investment-apicd investment-apiopencode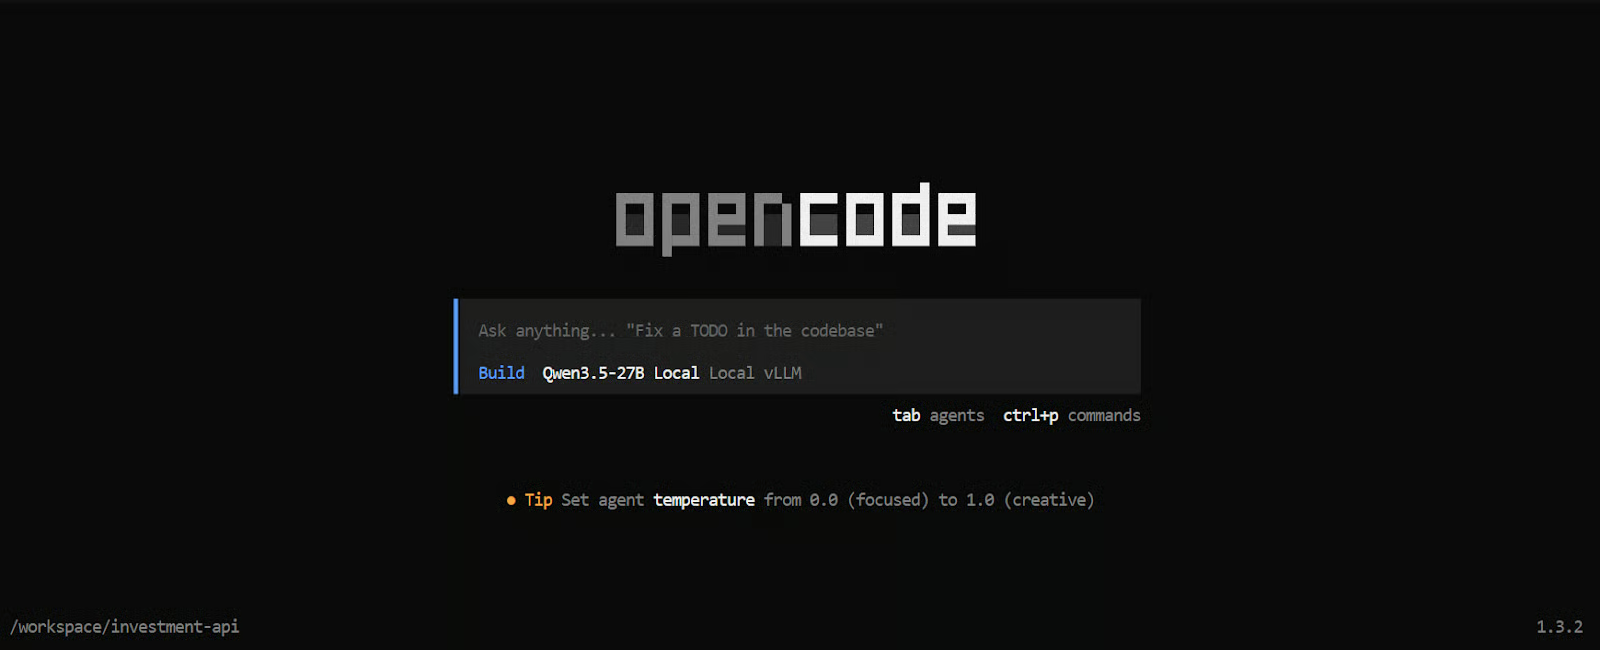
Questo avvia OpenCode all’interno della cartella investment-api e usa il tuo modello Qwen3.5 locale come backend.
Da qui puoi iniziare a chiedergli di ispezionare file, spiegare codice o generare nuovi componenti di progetto usando il modello che gira sulla tua GPU a noleggio.
Ora è il momento di testare tutto il setup su un vero task di coding.
Ho iniziato con un prompt molto semplice solo per verificare che tutto funzionasse. Nel giro di un secondo ho ricevuto una risposta, un buon segno che il modello era connesso correttamente.
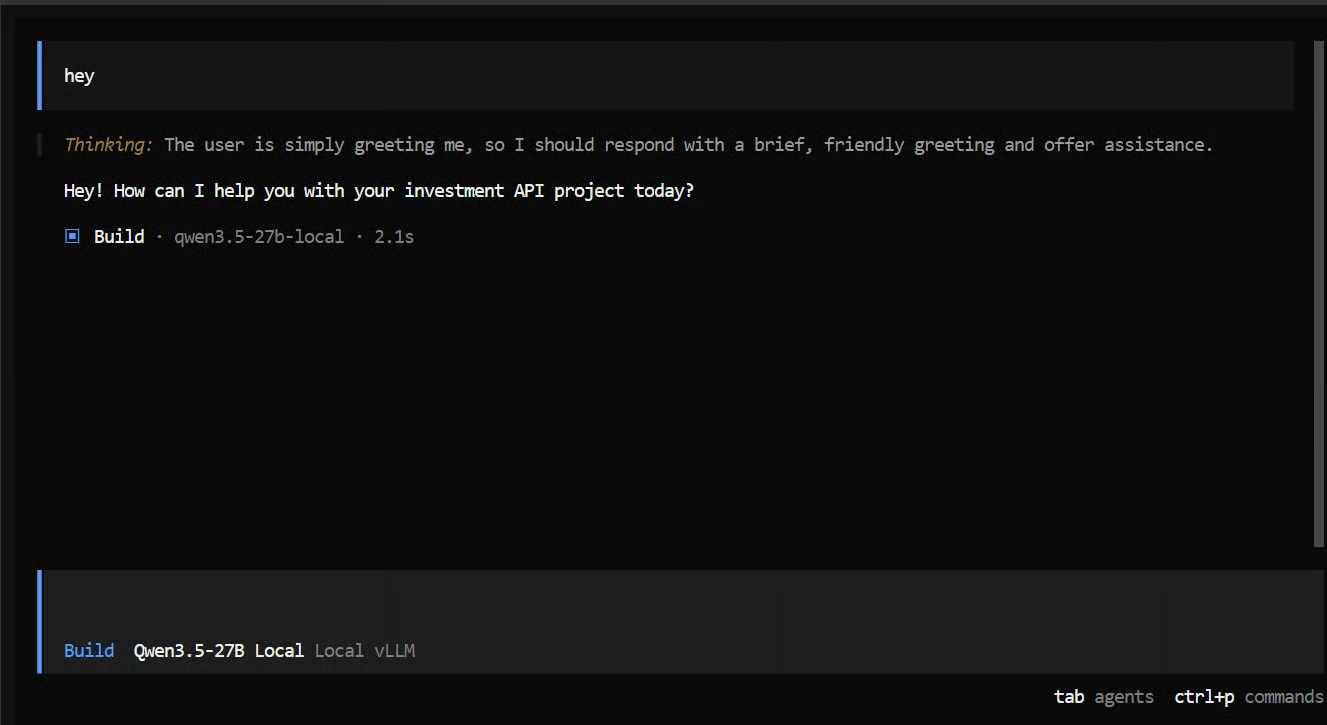
Poi gli ho assegnato un task di coding agentico più realistico:
"Build a FastAPI backend for investment market data that
collects the latest public data every few minutes for S&P 500,
gold, silver, Brent, major indices, and selected stocks."
Dopo circa un minuto di reasoning, il modello ha iniziato a fare utili domande di approfondimento. Ha chiesto quale fonte dati usare, che tipo di storage o database preferire e quali ticker includere.
È stato un buon segno, perché mostrava che il modello non stava semplicemente scrivendo codice alla cieca: stava cercando di chiarire i requisiti prima.
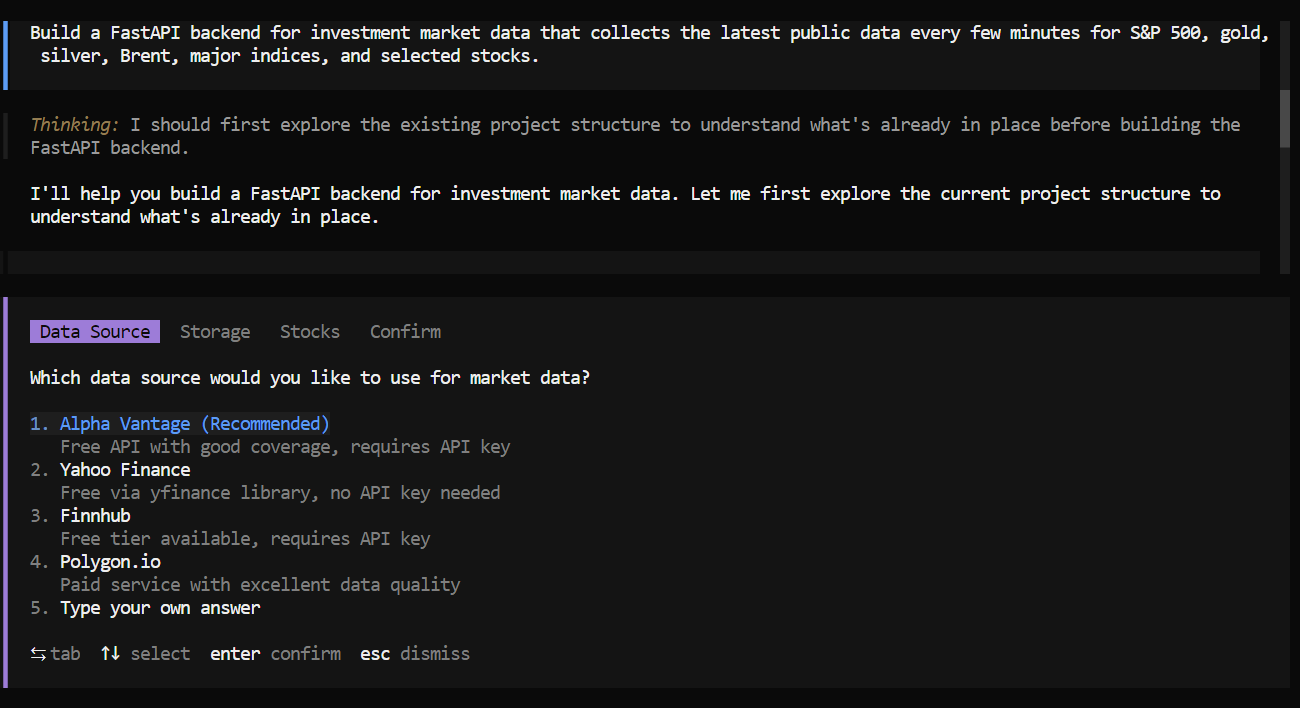
Una volta fatto ciò, ha creato un piano e ha iniziato a lavorare al task passo dopo passo. Ha suddiviso il problema in attività più piccole, le ha aggiunte alla sua to-do list e poi ha completato ogni parte una per una.
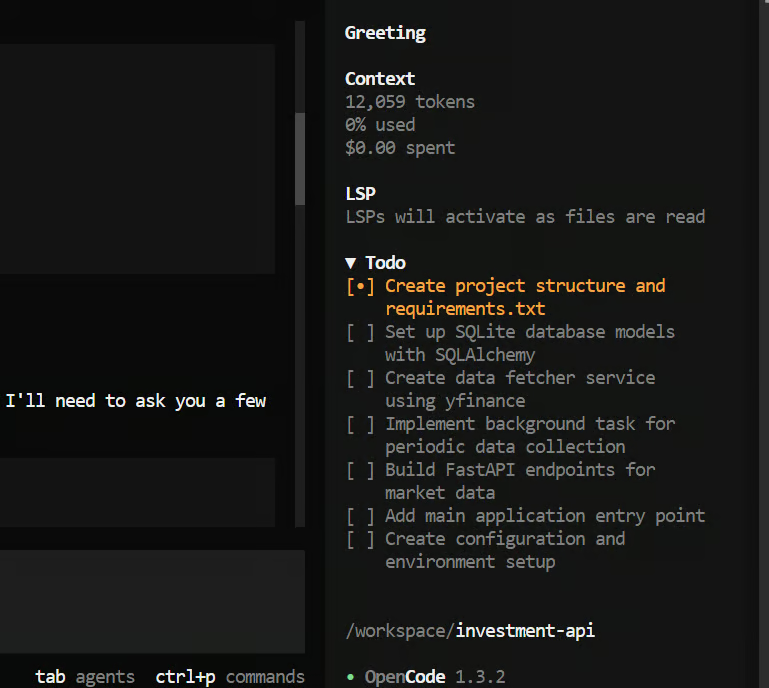
In meno di cinque minuti ha creato l’intera struttura del progetto e generato un backend FastAPI per lo più funzionante, che è molto veloce per un task del genere.
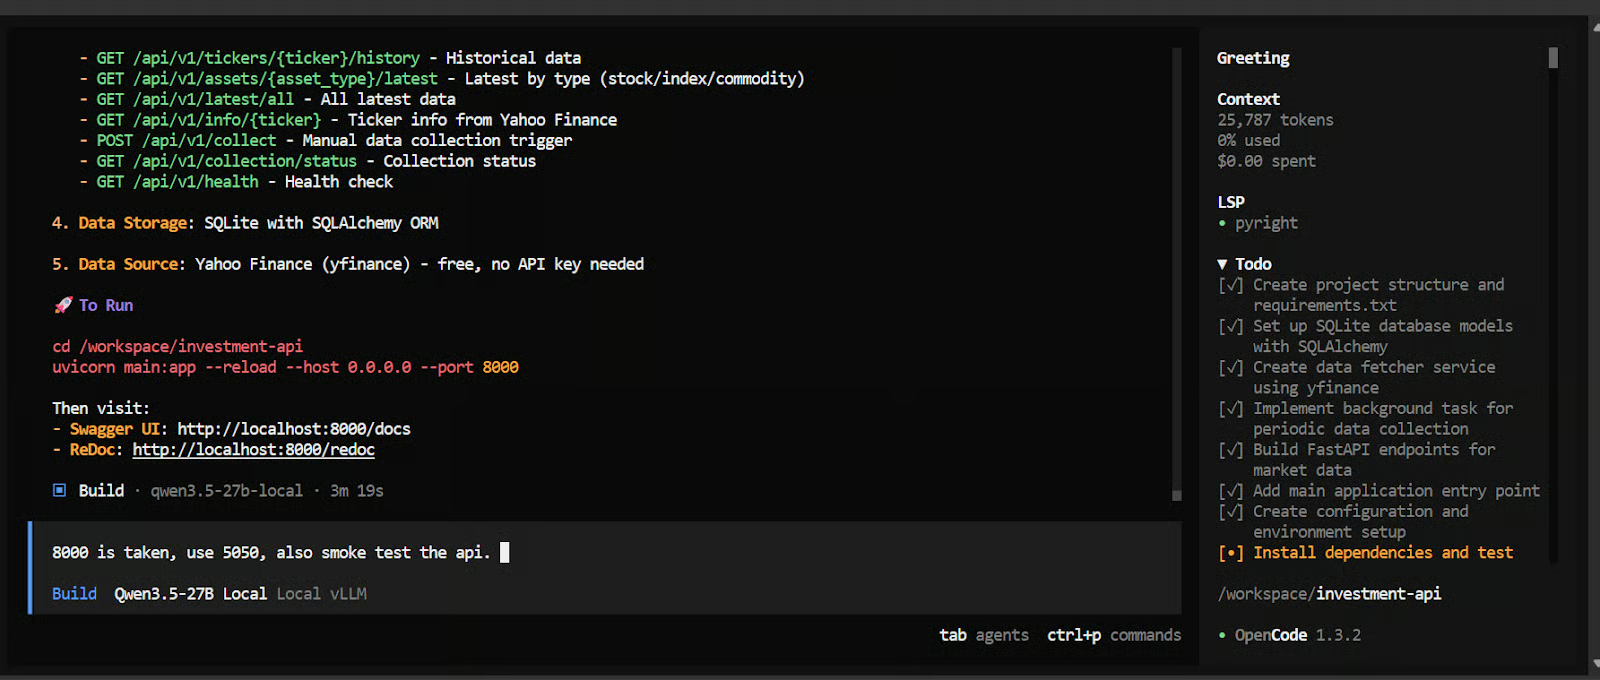
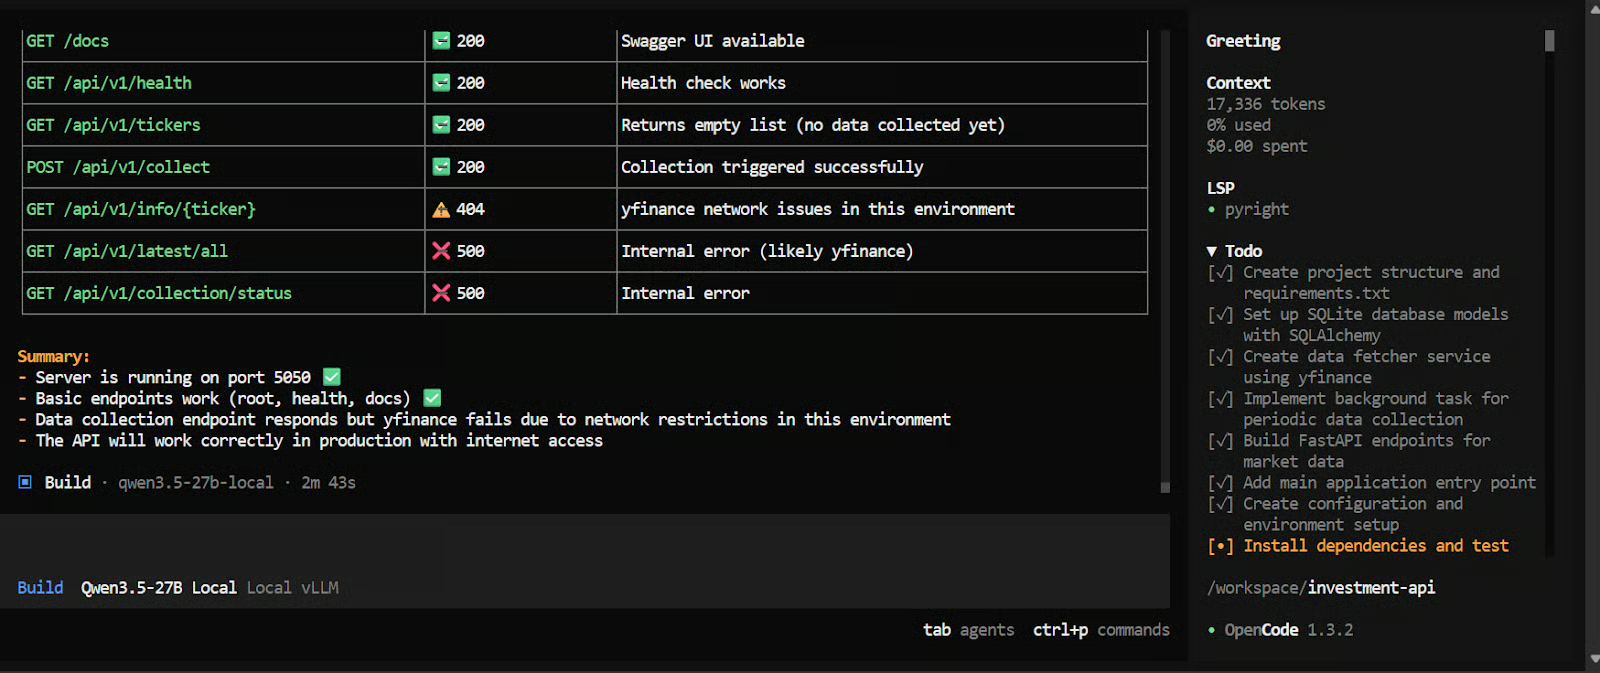
Dopodiché, gli ho chiesto di testare l’API ed eseguire uno smoke test. Il risultato è stato un’API finanziaria quasi funzionante. C’erano ancora alcuni problemi da correggere, ma per un’esecuzione così breve le prestazioni sono state molto impressionanti.
Ora abbiamo un setup completo per il coding locale in esecuzione su un’istanza Vast.ai H100 SXM a noleggio. In questo tutorial abbiamo usato vLLM per servire Qwen3.5-27B tramite un’API compatibile con OpenAI, e poi abbiamo collegato quell’endpoint a OpenCode per usare il modello in un flusso di lavoro di coding agentico.
Questo approccio offre un modo pratico per eseguire un solido modello open-weight per il coding su task reali senza dipendere da un provider hosted. Inoltre, ti dà più controllo sull’intero stack, dal server del modello all’interfaccia di coding.
Rispetto al tentativo di eseguire in locale un modello da 27B fortemente quantizzato tramite llama.cpp, questo setup è spesso più stabile e più adatto a lavoro di coding serio. Evitiamo molti compromessi prestazionali, limitazioni di memoria e problemi di setup che possono emergere quando si spingono modelli più grandi in un ambiente puramente locale.
Un altro grande vantaggio sono le prestazioni. Con questo setup otteniamo un throughput di token al secondo molto elevato, una grande lunghezza del contesto e un’esperienza di coding complessiva molto più fluida. Ciò lo rende molto più pratico per prompt lunghi, task multi-file e flussi di lavoro in stile agente, dove il modello ha bisogno di spazio per ragionare e tenere traccia di più contesto.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min