Qwen3.5 是阿里巴巴最新的 Qwen 模型系列,延续并强化了早期 Qwen 模型在推理、编程和多模态任务上的出色表现。
独立基准评测显示,Qwen3.5-397B-A17B 模型在 LiveCodeBench、AIME26 等广泛使用的测试中得分较高,在多数评分类别中经常优于 GPT-5.2 和 Claude Opus 4.5 等领先模型,并且相较于先前的 Qwen 代际提供了显著更高的吞吐量。
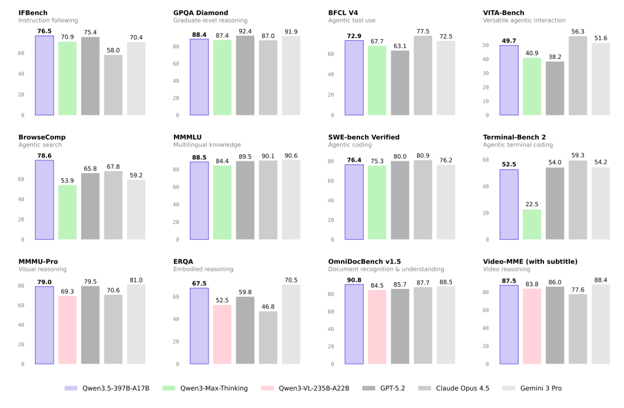
来源:Qwen/Qwen3.5-397B-A17B · Hugging Face
在本教程中,我们将:
- 了解在本地运行 Qwen3.5 的前置条件
- 设置 Hyperbolic AI GPU 虚拟机
- 安装带 CUDA 支持的 llama.cpp
- 从 Hugging Face 下载 Qwen3.5 模型
- 启动一个兼容 OpenAI 的 Qwen3.5 推理服务器
- 使用 OpenAI SDK 测试该服务器
- 用 llama.cpp WebUI 构建一个简单的交易应用
自本指南撰写以来,Qwen 已有更新。如果您使用的是 Blackwell 显卡,在 RTX 5090 上运行 Qwen3.8-27B 是更快的方案,使用 NVFP4 和模型内置的 MTP 草稿头。
Qwen3.5 的硬件与软件先决条件
在本地运行 Qwen3.5 之前,您需要确保硬件和软件均满足流畅推理的要求。本教程中,我们使用配备 141GB VRAM 的 NVIDIA H200 GPU,以及240GB 的系统内存,足以高效运行带有 MoE 卸载的MXFP4_MOE 版本的 Qwen3.5。
作为参考,Unsloth 的 4 位动态量化 UD-Q4_K_XL 约占用214GB 的磁盘空间。它可以直接放在256GB 的 M3 Ultra 上运行,也能在单块 24GB 显存并配备 256GB 内存的机器上表现良好,配合 MoE 卸载可达到每秒 25+ 个 token。更小的 3 位量化可放入192GB 内存内,而更高精度的 8 位版本可能需要高达512GB 的内存与显存总和。
一般而言,为获得最佳性能,VRAM + RAM 的总量应大致匹配您下载的量化模型大小。否则,llama.cpp 会将一部分卸载到 SSD,上下文推理会变慢。
在软件方面,您应安装最新的 NVIDIA GPU 驱动,并配合较新的CUDA Toolkit,以确保与llama.cpp 和 CUDA 加速推理的充分兼容。
如何在本地运行 Qwen 3.5
在准备好先决条件后,下面通过分步指南在本地使用 Qwen 3.5:
1. 设置本地环境
要在本地运行 Qwen3.5,您需要一台强大的 GPU 机器。由于大多数笔记本和台式机没有足够的显存或内存来处理此规模的模型,我们将改用云端 GPU 虚拟机。
本教程使用 Hyperbolic 私有运行该模型。您也可以使用 RunPod、Vast.ai 或您偏好的任意 GPU 虚拟机平台。我们选择 Hyperbolic,是因为它目前提供了一些性价比较高的 GPU 实例。
首先启动一个单块 H200 GPU 的新实例。
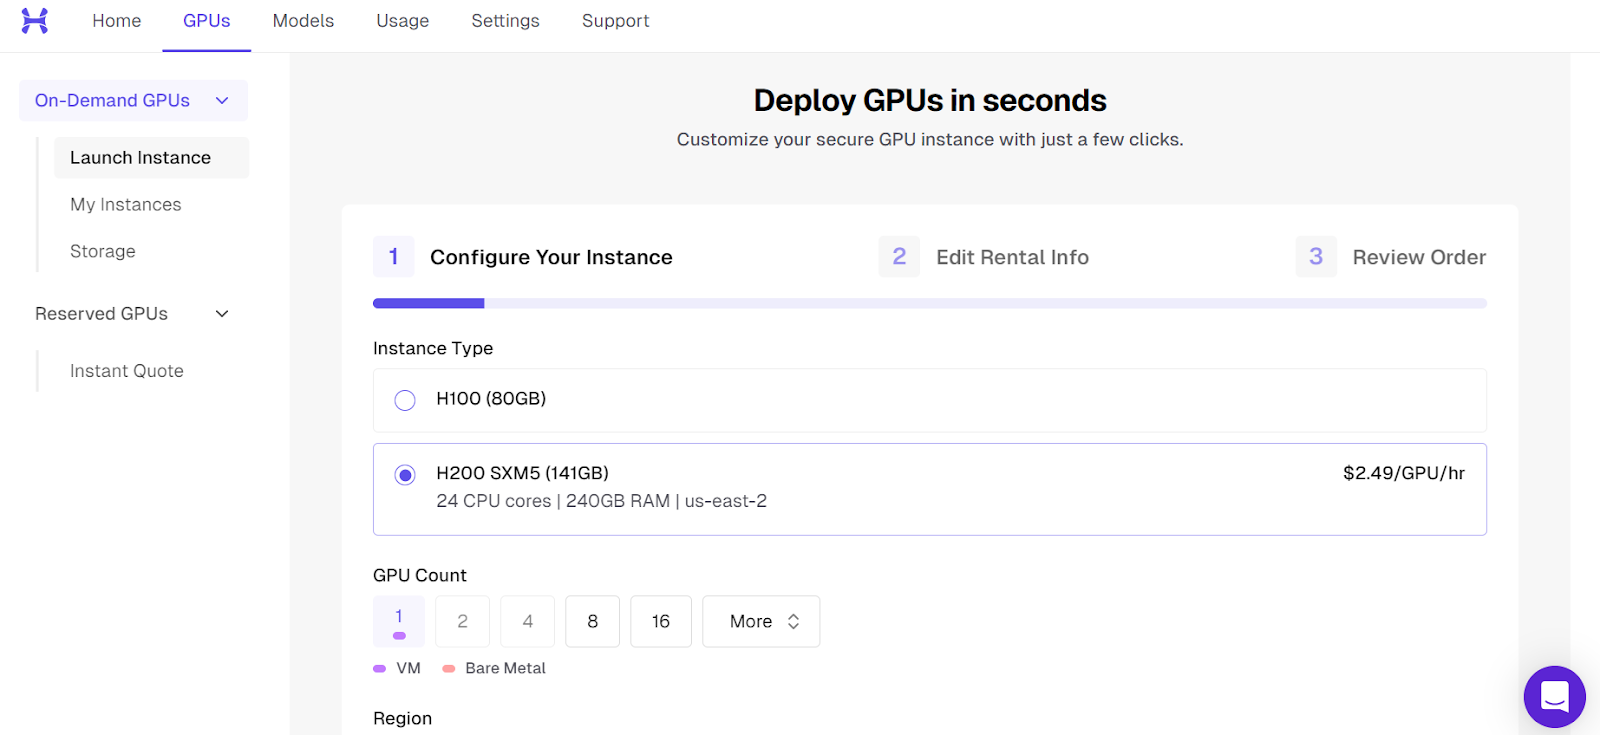
机器启动后,您会看到公网 IP 地址以及从本地终端连接所需的 SSH 命令。
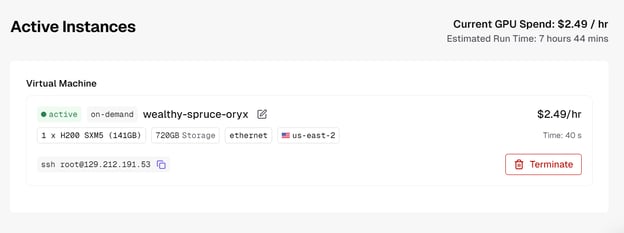
连接前,请确保您已在本地配置 SSH,并在创建虚拟机时添加了公钥。
实例就绪后,使用带端口转发的 SSH 连接。这很重要,因为我们希望通过端口8080 在本地访问 llama.cpp 推理服务器:
ssh -L 8080:localhost:8080 [email protected]技术支持
首次连接时,输入 yes 进行确认,然后使用您的 SSH 密钥进行认证。
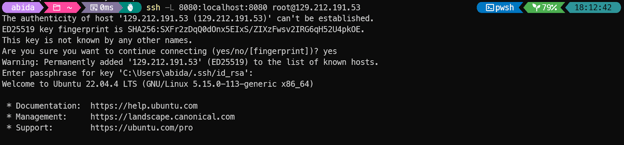
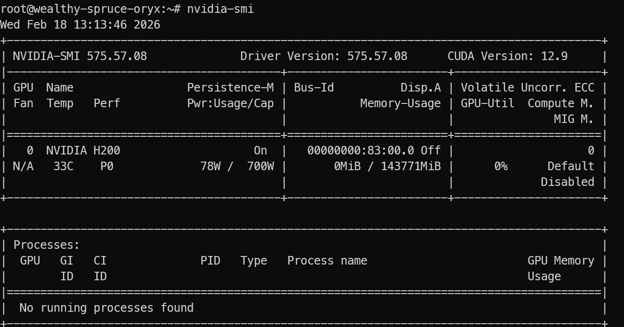
登录后,验证 GPU 是否被正确检测:
nvidia-smi 技术支持
您应当能在输出中看到 NVIDIA H200。
最后,安装下载、构建并运行 llama.cpp 所需的 Linux 软件包:
sudo apt update
sudo apt install pciutils build-essential cmake curl libcurl4-openssl-dev -y技术支持
完成后,您的环境已准备好安装 llama.cpp 并在本地运行 Qwen3.5。
2. 安装带 CUDA 支持的 llama.cpp
llama.cpp 是一个开源的 C/C++ 推理引擎,可用极少配置在本地运行大语言模型,支持 CPU 与 GPU 加速。
首先克隆 llama.cpp 仓库:
git clone https://github.com/ggml-org/llama.cpp技术支持
接着用 CMake 配置启用 CUDA 的构建。我们通过 -DGGML_CUDA=ON 开启 CUDA,并将 CUDA 架构设为 90a,因为我们使用的是 NVIDIA H200(Hopper 架构)。这样可生成针对 Hopper 特性的优化 GPU 代码。
cmake llama.cpp -B llama.cpp/build \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release \
  -DCMAKE_CUDA_ARCHITECTURES="90a"技术支持
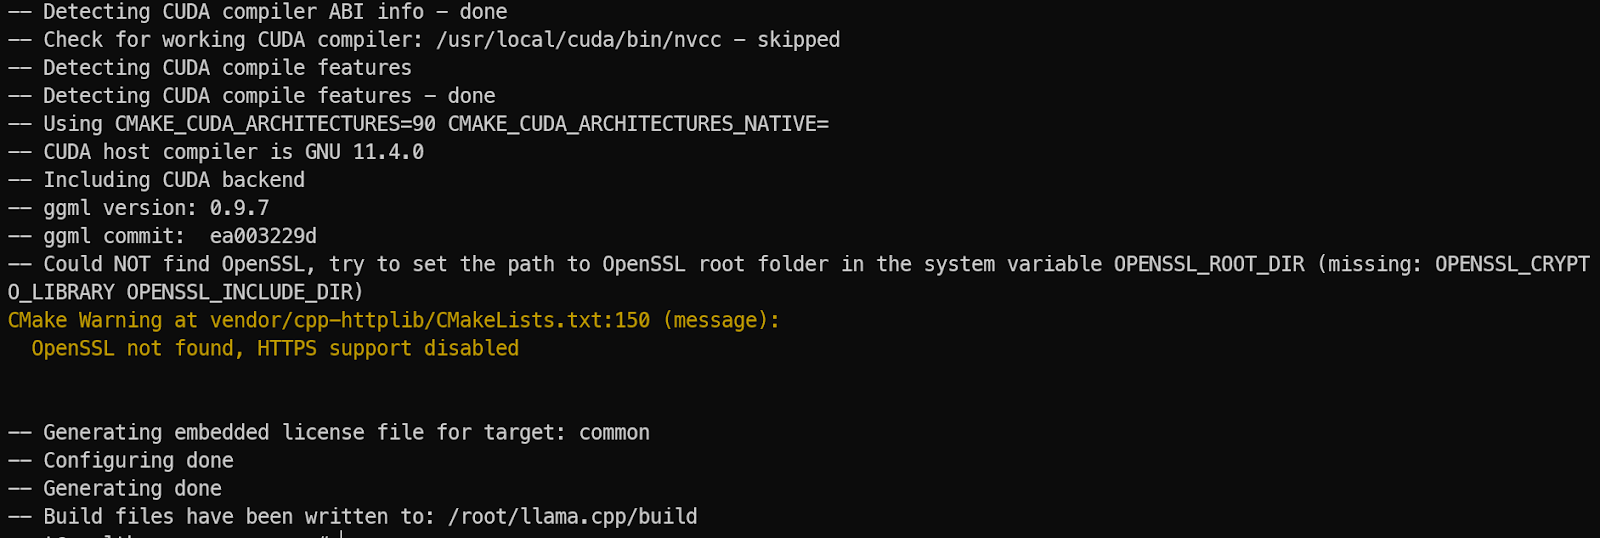
现在编译服务器二进制文件。llama-server 是内置的 REST 服务器,可将 llama.cpp 暴露为一个 API 端点:
cmake --build llama.cpp/build --config Release -j --clean-first --target llama-server技术支持
最后,将编译出的二进制复制到主目录,便于运行:
cp llama.cpp/build/bin/llama-* llama.cpp技术支持
3. 下载 Qwen3.5 模型
安装好 llama.cpp 后,下一步是下载 Qwen3.5 的 GGUF 格式权重文件。文件很大,因此使用 Hugging Face CLI 直接下载到 GPU 机器上是最稳妥的方法。
我们先安装 Python,因为 Hugging Face 的下载工具与认证工具以 Python 包的形式提供。尽管 llama.cpp 本身由 C++ 编写,但用 Python 管理模型下载和传输要方便得多。
先安装 pip:
sudo apt install python3-pip技术支持
然后安装 Hugging Face Hub 客户端和性能辅助工具。hf_transfer 与 hf-xet 能显著加快下载速度,这在拉取数百 GB 的模型文件时尤为重要:
pip -q install -U huggingface_hub hf-xet
pip -q install -U hf_transfer技术支持
现在从 Hugging Face 下载 Qwen3.5 模型。本教程仅获取MXFP4_MOE 变体,它针对高效的 MoE 推理进行了优化:
hf download unsloth/Qwen3.5-397B-A17B-GGUF \
   --local-dir models/Qwen3.5 \
   --include "*MXFP4_MOE*"技术支持

下载完成后,模型文件将位于 models/Qwen3.5,可直接在 llama.cpp 中加载进行本地推理。
4. 在单块 GPU 上启动 Qwen3.5 模型
现在我们可以通过llama-server 启动 Qwen3.5。这将提供一个兼容 OpenAI 的 API 端点,便于本地工具和应用调用。
我们针对单 GPU 进行了三点优化。首先启用 --fit on,让 llama.cpp 自动在GPU 显存与系统内存之间进行平衡,而不是在模型无法完全放入显存时直接失败。
其次,使用更大的上下文窗口 --ctx-size 16384 以处理更长提示。第三,启用 --jinja 并传入 --chat-template-kwargs 控制聊天格式并关闭思维模式,以获得更快、更直接的回复。
使用以下命令运行服务器:
./llama.cpp/llama-server \
    --model models/Qwen3.5/MXFP4_MOE/Qwen3.5-397B-A17B-MXFP4_MOE-00001-of-00006.gguf \
    --alias "Qwen3.5" \
  --host 0.0.0.0 \
  --port 8080 \
  --fit on \
  --jinja \
   --ctx-size 16384 \
   --temp 0.7 \
   --top-p 0.8 \
   --top-k 20 \
   --min-p 0.00 \
   --chat-template-kwargs "{\"enable_thinking\": false}"技术支持
加载模型时,您会注意到它同时占用GPU 显存与系统内存,对于大型 MoE 模型,这是预期行为。
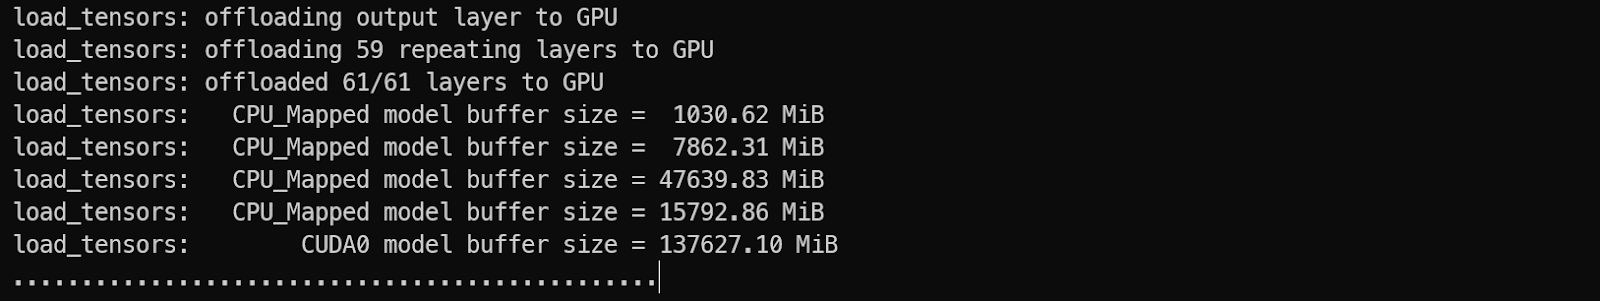
加载完成后,服务器可通过以下地址访问:
0.0.0.0:8080(在虚拟机上)http://127.0.0.1:8080(经 SSH 端口转发后,在您的本地机器上)
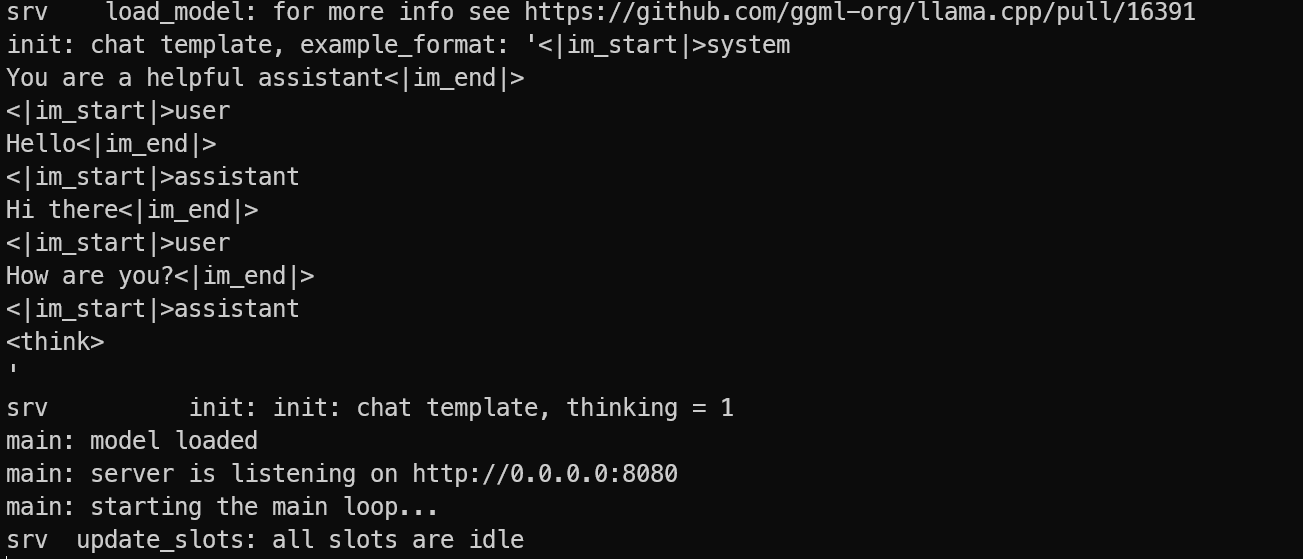
保持服务器运行。在您的本地电脑上,打开一个新终端并重新通过 SSH 端口转发连接:
ssh -L 8080:localhost:8080 [email protected]技术支持
然后通过列出可用模型来测试服务器:
curl -s http://127.0.0.1:8080/v1/models技术支持
如果您在响应中看到Qwen3.5,说明服务器运行正常,您已准备好通过 OpenAI SDK 和本地应用进行调用。

5 使用 OpenAI SDK 测试 Qwen3.5 模型
现在 Qwen3.5 推理服务器已运行,下一步是验证它能与真实客户端应用正确配合。llama.cpp 的一大优势是 llama-server 暴露了一个兼容 OpenAI 的 API,意味着您可以不改代码结构直接使用官方 OpenAI SDK。
首先在本地机器(或在虚拟机内)安装 OpenAI Python 包:
pip install openai 技术支持
现在运行一个简单测试脚本。它连接到您通过端口转发暴露的本地端点 http://127.0.0.1:8080/v1,而不是 OpenAI 的云端服务器。
python3 - <<'PY'
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8080/v1",
    api_key="sk-no-key-required"
)

response = client.chat.completions.create(
    model="Qwen3.5",
    messages=[
        {"role": "user", "content": "Write one sentence about AI agents."}
    ]
)

print(response.choices[0].message.content)
PY技术支持
需要注意的几点:
base_url 指向本地 Qwen3.5 服务器,而非 OpenAI API。api_key 仍为 SDK 所需,但 llama.cpp 不强制鉴权,填任意占位值即可。- 参数
model="Qwen3.5" 与我们启动服务器时设置的别名一致。
若配置正确,您将获得来自模型快速、干净的响应。
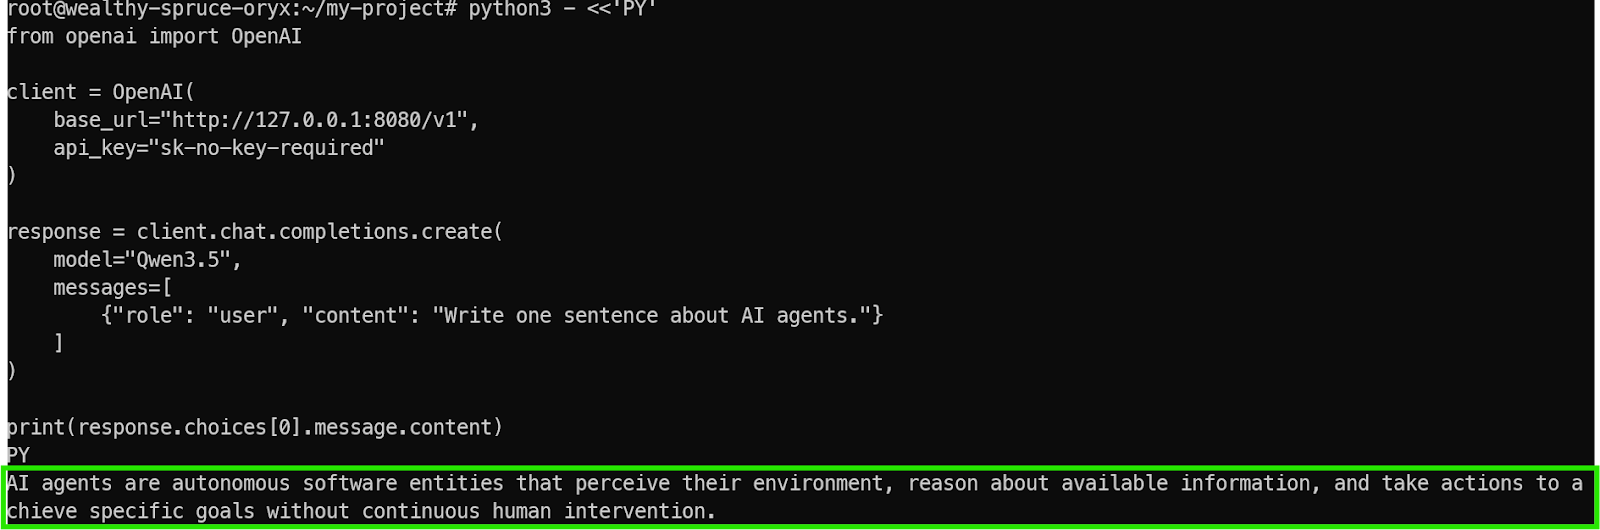
这确认了:
- Qwen3.5 模型已成功加载
- llama.cpp 服务器运行正常
- SSH 端口转发有效
- 端点与 OpenAI 风格的应用完全兼容
此时,您可以将 Qwen3.5 集成到任意已支持 OpenAI API 格式的本地工具、智能体流程或应用中。
6. 使用 Llama.cpp WebUI 构建股票交易 TUI
llama.cpp 自带类似 ChatGPT 的 WebUI,您可以直接在浏览器与模型对话。它适合快速测试、迭代提示词,以及在无需先写客户端脚本的情况下生成代码。
由于我们已经设置了 SSH 端口转发,您可以在本地机器打开 WebUI,它的表现就像服务器在您的笔记本上运行。
默认情况下,WebUI 地址为:
http://127.0.0.1:8080技术支持
如果页面能打开,说明两点:SSH 隧道工作正常,且在 GPU 虚拟机上私有运行的 Qwen3.5 服务器可在本地访问。
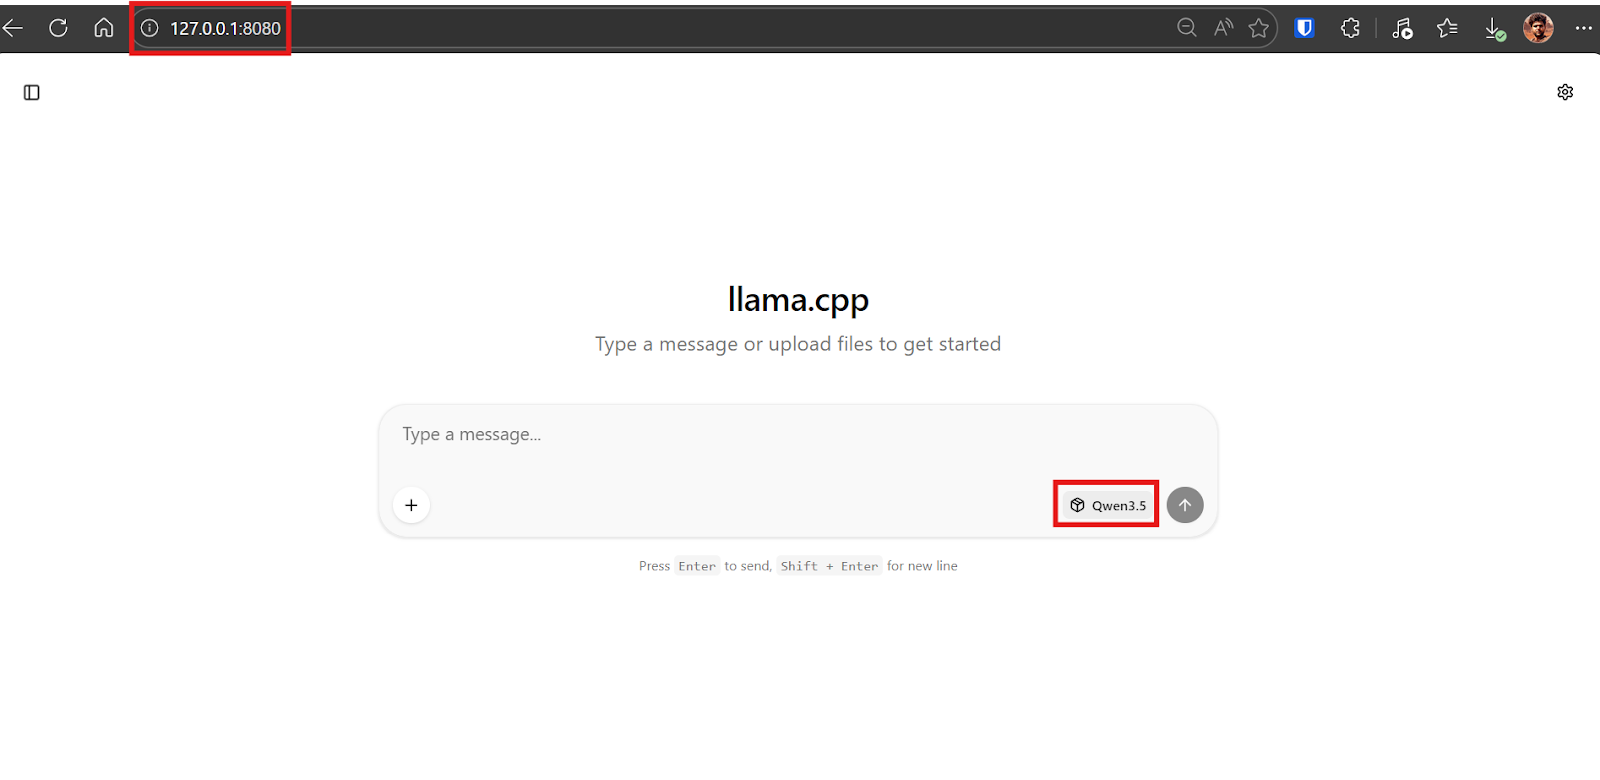
进入 WebUI 后,粘贴以下提示。目标是让模型同时生成 Python 代码和简短的使用指南。
|
构建一个简单的 Python TUI(文本用户界面)“Stock Screener Trainer”,使用 rich 库运行于 python app.py(无需 Web UI)。它应允许我输入一组股票代码,选择一种模式(growth/value/dividend)以及 风险等级(low/med/high),从免费来源获取每个股票代码的基础公共指标,显示实时加载状态,然后渲染一张美观的表格并且包含“按我的评分规则排序的前 5 名”部分,并且带有清晰的“仅供教育用途,非投资建议” 免责声明,并将完整结果保存为 results.csv。
|
几秒内,Qwen3.5 应该会生成一个 app.py 文件,并通常附上如何运行的简短说明。
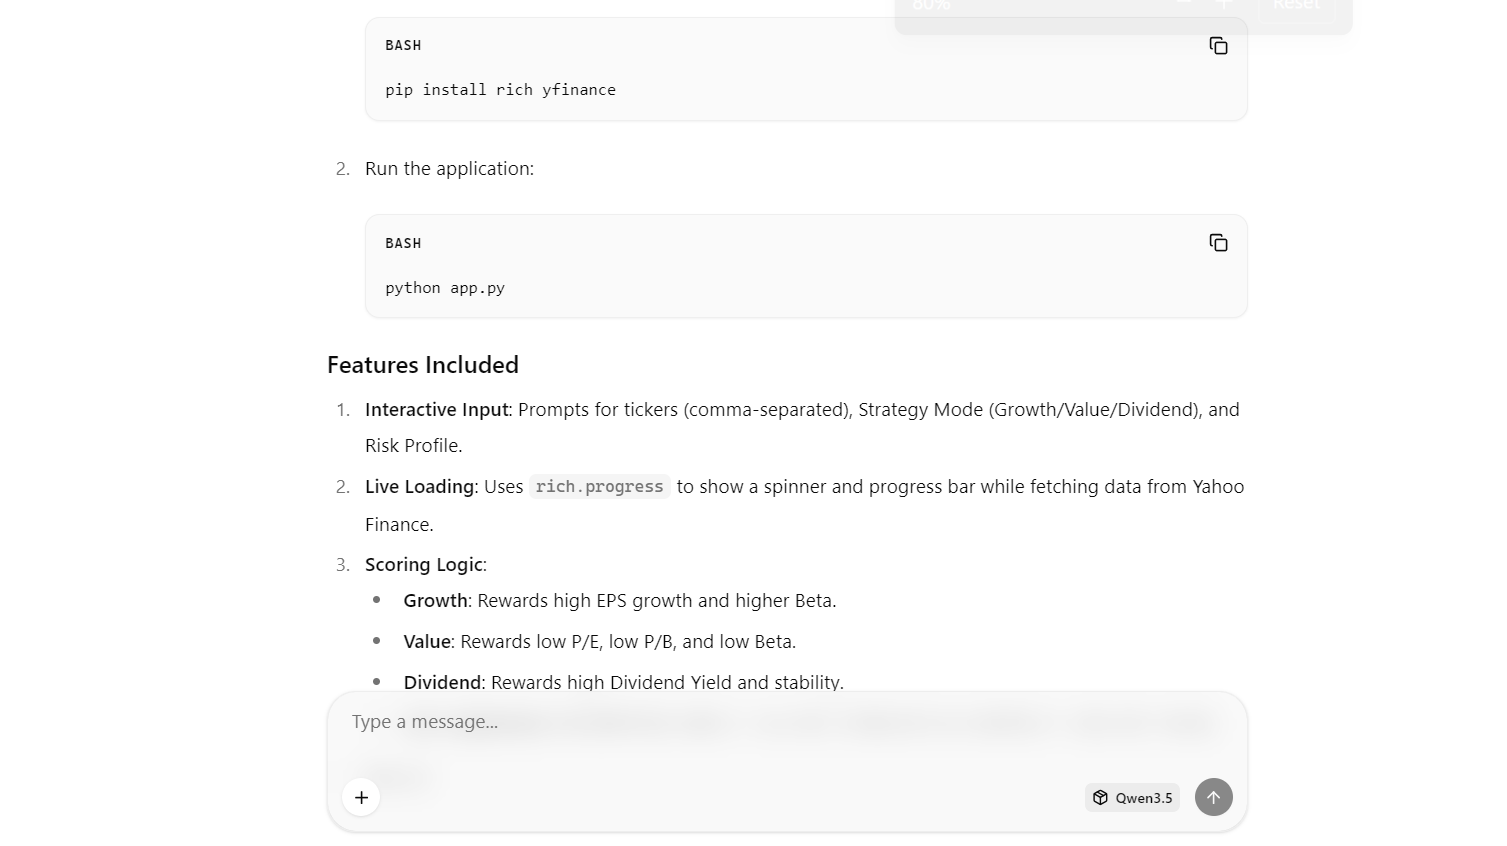
现在切换到您的本地终端(笔记本)。安装生成的应用所需依赖:
pip install rich yfinance技术支持
这将安装:
rich:用于 TUI 的布局、表格、提示与进度指示yfinance:用于拉取免费的公开股票指标
创建名为 app.py 的文件,粘贴模型生成的代码,并运行:
python3 app.py技术支持
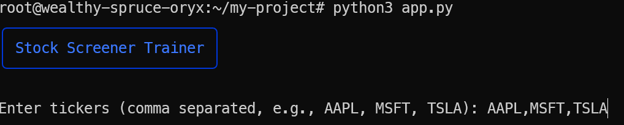
运行脚本后,您应在终端中看到 TUI 正常启动。应用会提示您输入要分析的股票代码,以及偏好的筛选模式和风险等级。
例如,我们用三只热门股票进行了测试。
短暂加载后,工具会返回完整的股票指标表格,按评分规则突出显示结果,并将所有内容保存到 results.csv 文件中。
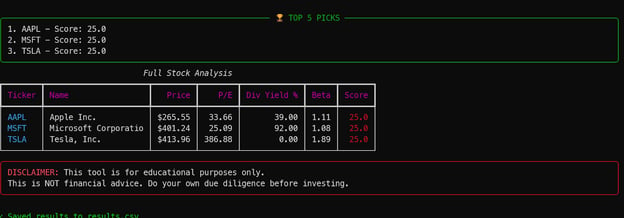
这很好地展示了 Qwen3.5 如何仅凭一个 4 位量化的模型端点和一个简单提示就一次性生成可运行的完整应用。
总结
在本地运行 Qwen3.5,是在保持私有与完全可控的前提下,使用前沿规模模型的有力方式。在本教程中,模型托管在单块 H200 GPU 虚拟机上,通过 SSH 端口转发从本地安全访问,并通过优化的 llama.cpp 兼容 OpenAI 的端点提供服务。
需要注意的一些实际限制:由于一切依赖于活跃的 SSH 隧道,连接必须保持稳定。如果网络中断或会话断开,您会失去对本地端口的访问,往往需要重新连接并重启部分流程。
另一个常见问题是正确构建 llama.cpp。如果未为您的 GPU 指定正确的 CUDA 架构标志,编译时间会更长,且可能无法充分针对硬件优化。预先设置正确架构会在构建时间和性能上带来明显差异。
最后,虽然 4 位的 MXFP4_MOE 量化非常适合高效运行大型模型,但并非总是智能体式编程工作流的理想之选。在使用 Qwen Code CLI、Kilo Code CLI 和 OpenCode 等工具的测试中,模型在更深层推理上表现吃力,并且在较长的生成循环中常发生失败,有时甚至会触发 GPU 不稳定。
更高精度的量化或更小、专注推理的模型,可能更适合稳定的智能体式编程。
想进一步了解智能体式编程,请查看我们的《面向开发者的 AI 辅助编程》课程。也推荐阅读我们关于本地运行 GLM-5 进行智能体式编程的指南。


Qwen3.5 是阿里巴巴最新的 Qwen 模型系列,延续并强化了早期 Qwen 模型在推理、编程和多模态任务上的出色表现。
独立基准评测显示,Qwen3.5-397B-A17B 模型在 LiveCodeBench、AIME26 等广泛使用的测试中得分较高,在多数评分类别中经常优于 GPT-5.2 和 Claude Opus 4.5 等领先模型,并且相较于先前的 Qwen 代际提供了显著更高的吞吐量。
来源:Qwen/Qwen3.5-397B-A17B · Hugging Face
在本教程中,我们将:
自本指南撰写以来,Qwen 已有更新。如果您使用的是 Blackwell 显卡,在 RTX 5090 上运行 Qwen3.8-27B 是更快的方案,使用 NVFP4 和模型内置的 MTP 草稿头。
Qwen3.5 的硬件与软件先决条件
在本地运行 Qwen3.5 之前,您需要确保硬件和软件均满足流畅推理的要求。本教程中,我们使用配备 141GB VRAM 的 NVIDIA H200 GPU,以及240GB 的系统内存,足以高效运行带有 MoE 卸载的MXFP4_MOE 版本的 Qwen3.5。
作为参考,Unsloth 的 4 位动态量化 UD-Q4_K_XL 约占用214GB 的磁盘空间。它可以直接放在256GB 的 M3 Ultra 上运行,也能在单块 24GB 显存并配备 256GB 内存的机器上表现良好,配合 MoE 卸载可达到每秒 25+ 个 token。更小的 3 位量化可放入192GB 内存内,而更高精度的 8 位版本可能需要高达512GB 的内存与显存总和。
一般而言,为获得最佳性能,VRAM + RAM 的总量应大致匹配您下载的量化模型大小。否则,llama.cpp 会将一部分卸载到 SSD,上下文推理会变慢。
在软件方面,您应安装最新的 NVIDIA GPU 驱动,并配合较新的CUDA Toolkit,以确保与llama.cpp 和 CUDA 加速推理的充分兼容。
如何在本地运行 Qwen 3.5
在准备好先决条件后,下面通过分步指南在本地使用 Qwen 3.5:
1. 设置本地环境
要在本地运行 Qwen3.5,您需要一台强大的 GPU 机器。由于大多数笔记本和台式机没有足够的显存或内存来处理此规模的模型,我们将改用云端 GPU 虚拟机。
本教程使用 Hyperbolic 私有运行该模型。您也可以使用 RunPod、Vast.ai 或您偏好的任意 GPU 虚拟机平台。我们选择 Hyperbolic,是因为它目前提供了一些性价比较高的 GPU 实例。
首先启动一个单块 H200 GPU 的新实例。
机器启动后,您会看到公网 IP 地址以及从本地终端连接所需的 SSH 命令。
连接前,请确保您已在本地配置 SSH,并在创建虚拟机时添加了公钥。
实例就绪后,使用带端口转发的 SSH 连接。这很重要,因为我们希望通过端口8080 在本地访问 llama.cpp 推理服务器:
首次连接时,输入 yes 进行确认,然后使用您的 SSH 密钥进行认证。
登录后,验证 GPU 是否被正确检测:
您应当能在输出中看到 NVIDIA H200。
最后,安装下载、构建并运行 llama.cpp 所需的 Linux 软件包:
完成后,您的环境已准备好安装 llama.cpp 并在本地运行 Qwen3.5。
2. 安装带 CUDA 支持的 llama.cpp
llama.cpp 是一个开源的 C/C++ 推理引擎,可用极少配置在本地运行大语言模型,支持 CPU 与 GPU 加速。
首先克隆 llama.cpp 仓库:
接着用 CMake 配置启用 CUDA 的构建。我们通过
-DGGML_CUDA=ON开启 CUDA,并将 CUDA 架构设为 90a,因为我们使用的是 NVIDIA H200(Hopper 架构)。这样可生成针对 Hopper 特性的优化 GPU 代码。现在编译服务器二进制文件。
llama-server是内置的 REST 服务器,可将 llama.cpp 暴露为一个 API 端点:最后,将编译出的二进制复制到主目录,便于运行:
3. 下载 Qwen3.5 模型
安装好 llama.cpp 后,下一步是下载 Qwen3.5 的 GGUF 格式权重文件。文件很大,因此使用 Hugging Face CLI 直接下载到 GPU 机器上是最稳妥的方法。
我们先安装 Python,因为 Hugging Face 的下载工具与认证工具以 Python 包的形式提供。尽管 llama.cpp 本身由 C++ 编写,但用 Python 管理模型下载和传输要方便得多。
先安装 pip:
然后安装 Hugging Face Hub 客户端和性能辅助工具。
hf_transfer与hf-xet能显著加快下载速度,这在拉取数百 GB 的模型文件时尤为重要:现在从 Hugging Face 下载 Qwen3.5 模型。本教程仅获取MXFP4_MOE 变体,它针对高效的 MoE 推理进行了优化:
下载完成后,模型文件将位于
models/Qwen3.5,可直接在 llama.cpp 中加载进行本地推理。4. 在单块 GPU 上启动 Qwen3.5 模型
现在我们可以通过llama-server 启动 Qwen3.5。这将提供一个兼容 OpenAI 的 API 端点,便于本地工具和应用调用。
我们针对单 GPU 进行了三点优化。首先启用
--fit on,让 llama.cpp 自动在GPU 显存与系统内存之间进行平衡,而不是在模型无法完全放入显存时直接失败。其次,使用更大的上下文窗口
--ctx-size 16384以处理更长提示。第三,启用--jinja并传入--chat-template-kwargs控制聊天格式并关闭思维模式,以获得更快、更直接的回复。使用以下命令运行服务器:
加载模型时,您会注意到它同时占用GPU 显存与系统内存,对于大型 MoE 模型,这是预期行为。
加载完成后,服务器可通过以下地址访问:
0.0.0.0:8080(在虚拟机上)http://127.0.0.1:8080(经 SSH 端口转发后,在您的本地机器上)保持服务器运行。在您的本地电脑上,打开一个新终端并重新通过 SSH 端口转发连接:
然后通过列出可用模型来测试服务器:
如果您在响应中看到Qwen3.5,说明服务器运行正常,您已准备好通过 OpenAI SDK 和本地应用进行调用。
5 使用 OpenAI SDK 测试 Qwen3.5 模型
现在 Qwen3.5 推理服务器已运行,下一步是验证它能与真实客户端应用正确配合。llama.cpp 的一大优势是
llama-server暴露了一个兼容 OpenAI 的 API,意味着您可以不改代码结构直接使用官方 OpenAI SDK。首先在本地机器(或在虚拟机内)安装 OpenAI Python 包:
现在运行一个简单测试脚本。它连接到您通过端口转发暴露的本地端点
http://127.0.0.1:8080/v1,而不是 OpenAI 的云端服务器。需要注意的几点:
base_url指向本地 Qwen3.5 服务器,而非 OpenAI API。api_key仍为 SDK 所需,但 llama.cpp 不强制鉴权,填任意占位值即可。model="Qwen3.5"与我们启动服务器时设置的别名一致。若配置正确,您将获得来自模型快速、干净的响应。
这确认了:
此时,您可以将 Qwen3.5 集成到任意已支持 OpenAI API 格式的本地工具、智能体流程或应用中。
6. 使用 Llama.cpp WebUI 构建股票交易 TUI
llama.cpp 自带类似 ChatGPT 的 WebUI,您可以直接在浏览器与模型对话。它适合快速测试、迭代提示词,以及在无需先写客户端脚本的情况下生成代码。
由于我们已经设置了 SSH 端口转发,您可以在本地机器打开 WebUI,它的表现就像服务器在您的笔记本上运行。
默认情况下,WebUI 地址为:
如果页面能打开,说明两点:SSH 隧道工作正常,且在 GPU 虚拟机上私有运行的 Qwen3.5 服务器可在本地访问。
进入 WebUI 后,粘贴以下提示。目标是让模型同时生成 Python 代码和简短的使用指南。
构建一个简单的 Python TUI(文本用户界面)“Stock Screener Trainer”,使用 rich 库运行于 python app.py(无需 Web UI)。它应允许我输入一组股票代码,选择一种模式(growth/value/dividend)以及 风险等级(low/med/high),从免费来源获取每个股票代码的基础公共指标,显示实时加载状态,然后渲染一张美观的表格并且包含“按我的评分规则排序的前 5 名”部分,并且带有清晰的“仅供教育用途,非投资建议” 免责声明,并将完整结果保存为 results.csv。
几秒内,Qwen3.5 应该会生成一个
app.py文件,并通常附上如何运行的简短说明。现在切换到您的本地终端(笔记本)。安装生成的应用所需依赖:
这将安装:
rich:用于 TUI 的布局、表格、提示与进度指示yfinance:用于拉取免费的公开股票指标创建名为
app.py的文件,粘贴模型生成的代码,并运行:运行脚本后,您应在终端中看到 TUI 正常启动。应用会提示您输入要分析的股票代码,以及偏好的筛选模式和风险等级。
例如,我们用三只热门股票进行了测试。
短暂加载后,工具会返回完整的股票指标表格,按评分规则突出显示结果,并将所有内容保存到
results.csv文件中。这很好地展示了 Qwen3.5 如何仅凭一个 4 位量化的模型端点和一个简单提示就一次性生成可运行的完整应用。
总结
在本地运行 Qwen3.5,是在保持私有与完全可控的前提下,使用前沿规模模型的有力方式。在本教程中,模型托管在单块 H200 GPU 虚拟机上,通过 SSH 端口转发从本地安全访问,并通过优化的 llama.cpp 兼容 OpenAI 的端点提供服务。
需要注意的一些实际限制:由于一切依赖于活跃的 SSH 隧道,连接必须保持稳定。如果网络中断或会话断开,您会失去对本地端口的访问,往往需要重新连接并重启部分流程。
另一个常见问题是正确构建 llama.cpp。如果未为您的 GPU 指定正确的 CUDA 架构标志,编译时间会更长,且可能无法充分针对硬件优化。预先设置正确架构会在构建时间和性能上带来明显差异。
最后,虽然 4 位的 MXFP4_MOE 量化非常适合高效运行大型模型,但并非总是智能体式编程工作流的理想之选。在使用 Qwen Code CLI、Kilo Code CLI 和 OpenCode 等工具的测试中,模型在更深层推理上表现吃力,并且在较长的生成循环中常发生失败,有时甚至会触发 GPU 不稳定。
更高精度的量化或更小、专注推理的模型,可能更适合稳定的智能体式编程。
想进一步了解智能体式编程,请查看我们的《面向开发者的 AI 辅助编程》课程。也推荐阅读我们关于本地运行 GLM-5 进行智能体式编程的指南。