
Cursus
AI-ondersteund coderen voor developers
1 uur 30 min
10.7K
In deze tutorial zet je een externe H100 SXM‑instance op via Vast.ai, serve je Qwen3.5-27B met vLLM, koppel je het aan OpenCode en test je de agentic coding‑capaciteiten op een echt FastAPI‑project.
We gebruiken hier bewust niet llama.cpp. Hoewel llama.cpp uitstekend is voor veel lokale inference‑setups, brengt het draaien van een gekwantiseerd 27B‑model er vaak trade‑offs mee: lagere outputkwaliteit, mindere code‑prestatie en meer setup‑frictie.
Voor grotere modellen zoals Qwen3.5-27B kan kwantisatie de betrouwbaarheid merkbaar schaden, en lokale deployments via llama.cpp kunnen lastig worden als je soepel, productieachtig agent‑gedrag wilt.
In plaats daarvan gebruikt deze tutorial vLLM op een gehuurde H100 SXM‑GPU. Dat geeft je een stabielere OpenAI‑compatibele endpoint, betere prestaties van het volledige model en een veel schonere setup voor agentic coding‑workflows.
Bekijk ook onze aparte gids voor het lokaal draaien van Qwen3.5-397B-A17B.
Zorg voordat je begint dat je het volgende hebt:
Een H100 SXM is een sterke keuze voor deze setup, omdat Qwen3.5-27B veel geheugen en snelle doorvoer nodig heeft, zeker voor langere contextvensters en soepelere, code‑gerichte inference.
We gebruiken Vast.ai omdat het een GPU‑marktplaats is die je doorgaans veel meer flexibiliteit geeft qua prijs en hardware dan een traditionele cloud van één aanbieder.
Je kunt alles huren, van community‑gehoste machines tot Secure Cloud / datacenter‑aanbiedingen, die Vast markeert met een blauw datacenterlabel. Voor een setup als deze raad ik sterk aan om zo’n blauw gelabelde datacenter‑machine te kiezen voor meer betrouwbaarheid en een soepelere ervaring.
Begin met het aanmaken van een Vast.ai‑account en voeg genoeg tegoed toe voor je sessie. Open vervolgens de search‑pagina, kies de PyTorch‑template met Jupyter ingeschakeld, en zoek een aanbieding met 1x H100 SXM.
De prijzen veranderen voortdurend op Vast.ai omdat het een live marktplaats is, dus beschouw elk uurtarief als indicatief en niet als vast.
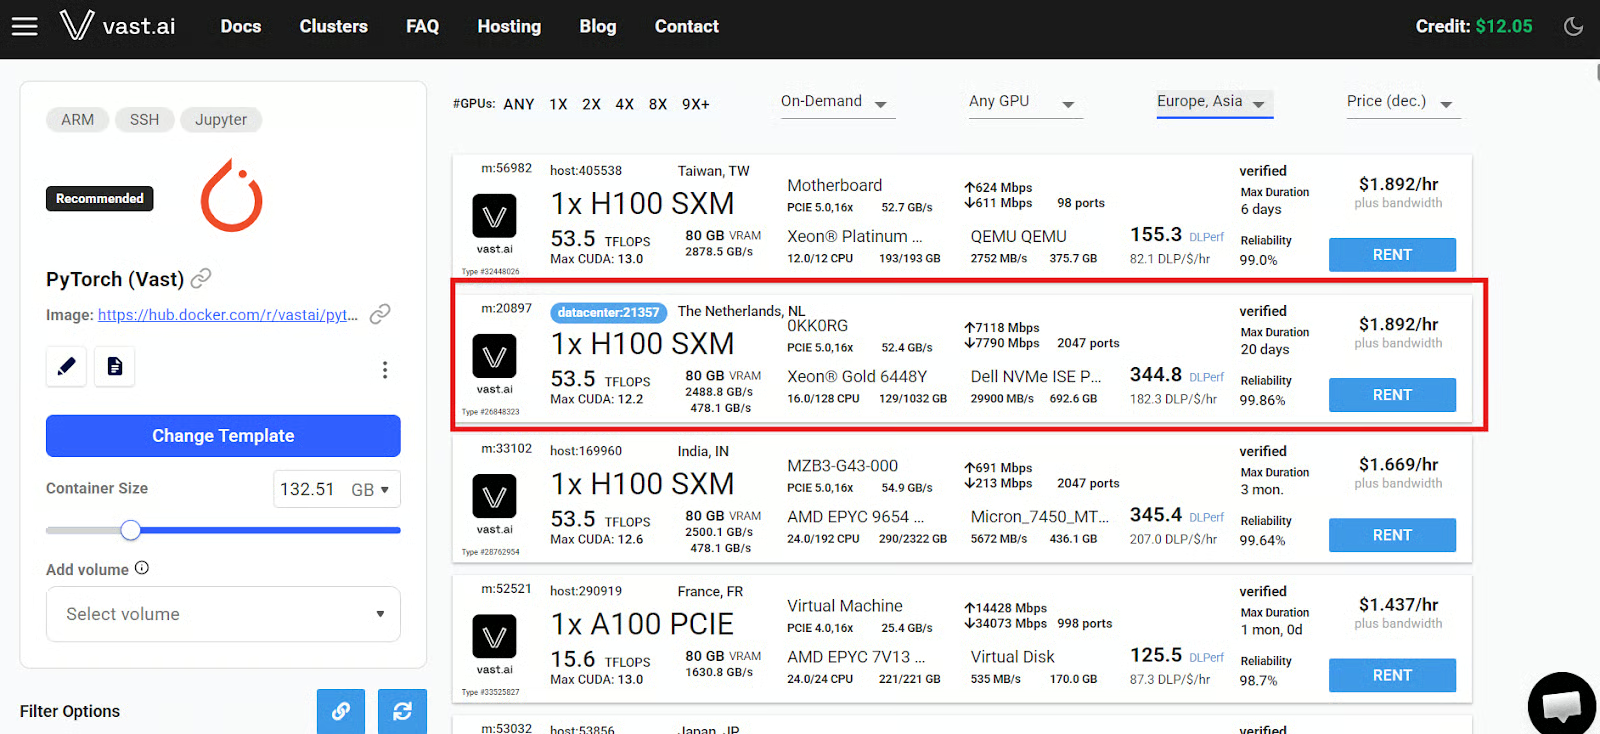
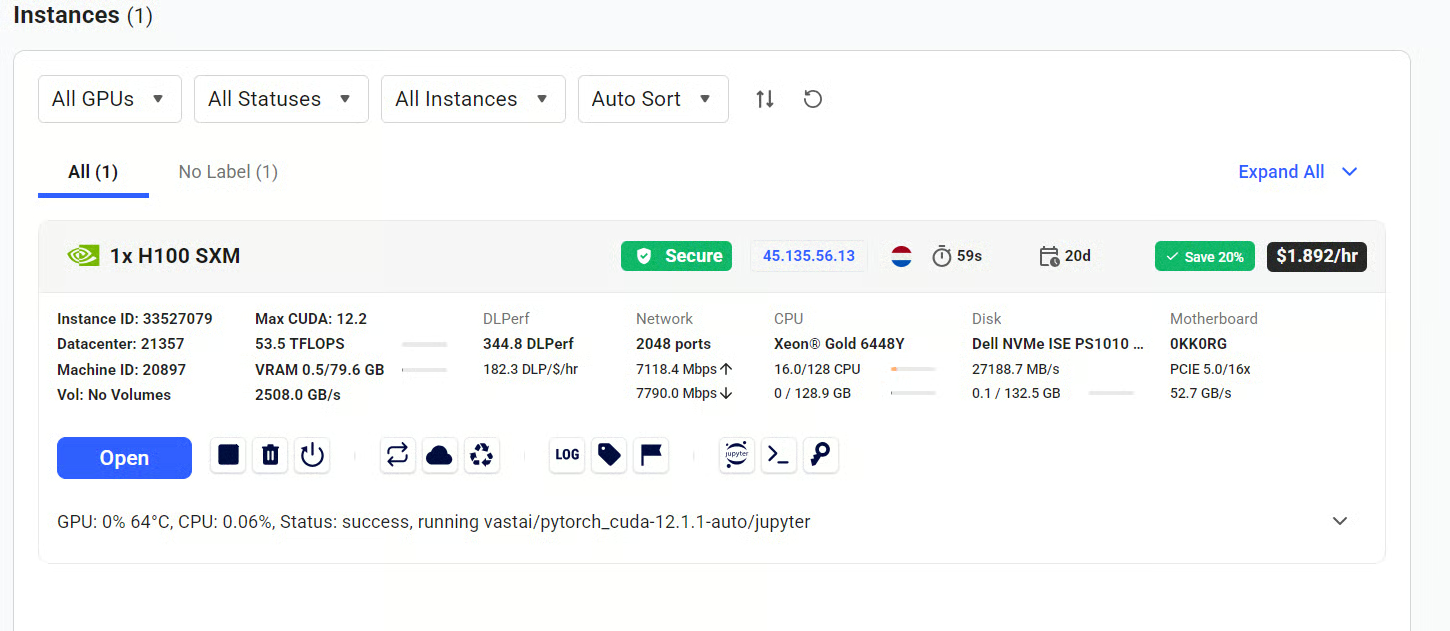
Zodra je de machine huurt, ga je naar het tabblad Instances. Wanneer de status verandert in Open, klik je op de knop Open om de instance‑portal in je browser te openen.
Van daaruit kun je Jupyter openen en direct een terminalsessie starten op de externe machine.
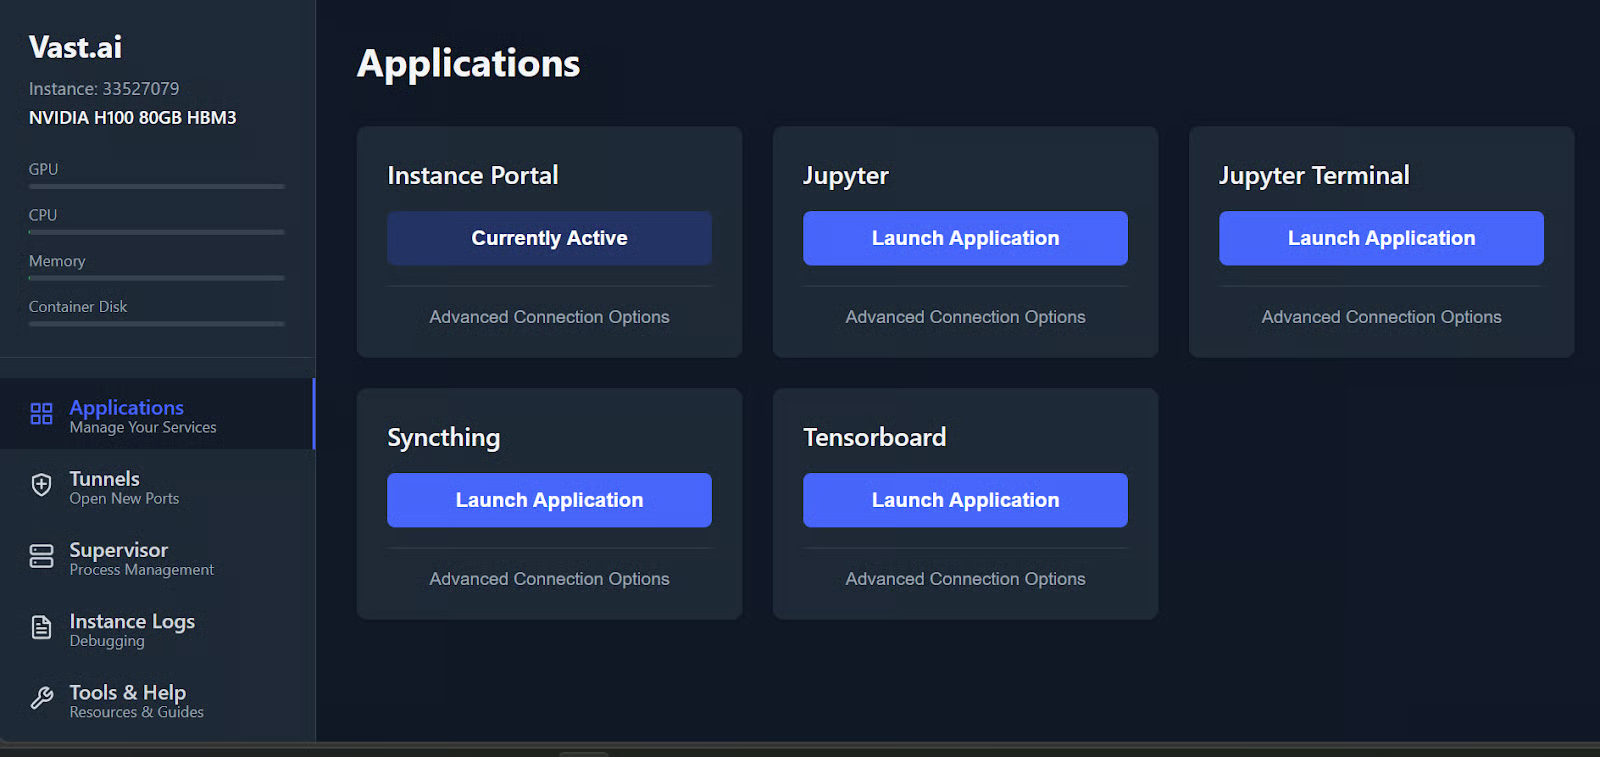
Houd voor deze tutorial twee terminals open:
Deze taken gescheiden houden maakt de workflow veel beheersbaarder zodra de modelserver draait.
In deze stap maak je een geïsoleerde Python‑omgeving, installeer je vLLM en start je Qwen3.5-27B als een OpenAI‑compatibele API waar OpenCode mee kan praten.
vLLM is een high‑throughput inference‑engine voor large language models, ontworpen om modellen efficiënt via een API te serven.
Maak in je eerste terminal een schone workspace voor de modelserver:
mkdir qwen-servercd qwen-server/uv venv --python 3.12source .venv/bin/activateDit geeft je een dedicated Python 3.12‑omgeving zodat de afhankelijkheden van de modelserver geïsoleerd blijven van de rest van de machine.
Installeer nu vLLM:
uv pip install vllm --torch-backend=auto --extra-index-url https://wheels.vllm.ai/nightly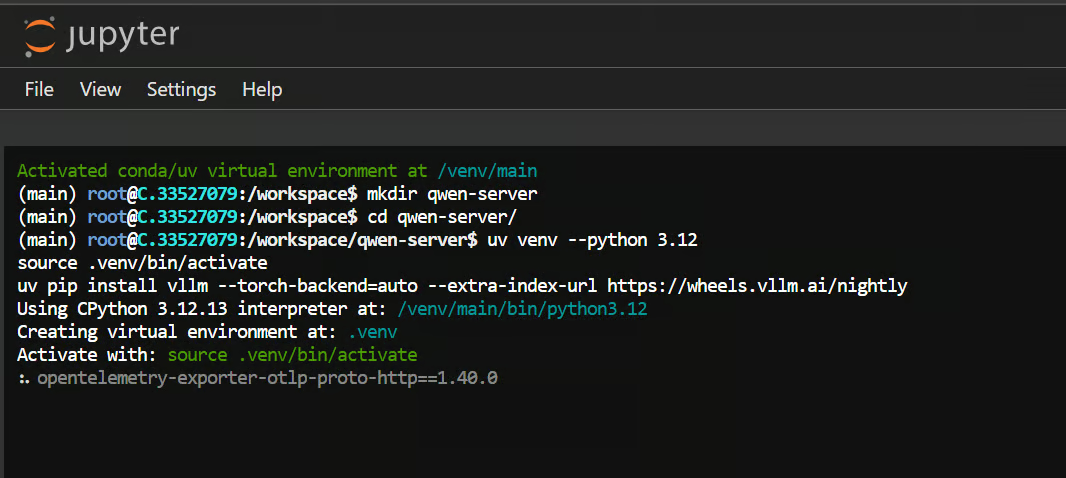
Hiermee installeer je de inference‑engine die Qwen3.5 via een OpenAI‑compatibele API zal exposen.
Let op: Mogelijk heb je de nightly wheels niet nodig voor deze setup, omdat de huidige vLLM‑ondersteuning voor Qwen3.5 vaak ook met de standaardinstallatie werkt.
Zodra vLLM is geïnstalleerd, start je de modelserver met:
vllm serve Qwen/Qwen3.5-27B \
 --host 127.0.0.1 \
 --port 8000 \
 --api-key local-dev-key \
 --served-model-name qwen3.5-27b-local \
 --tensor-parallel-size 1 \
 --max-model-len 64000 \
 --enable-auto-tool-choice \
 --tool-call-parser qwen3_coder \
 --reasoning-parser qwen3
De eerste keer dat je dit commando draait, zal vLLM de model‑ en tokenizerbestanden downloaden.
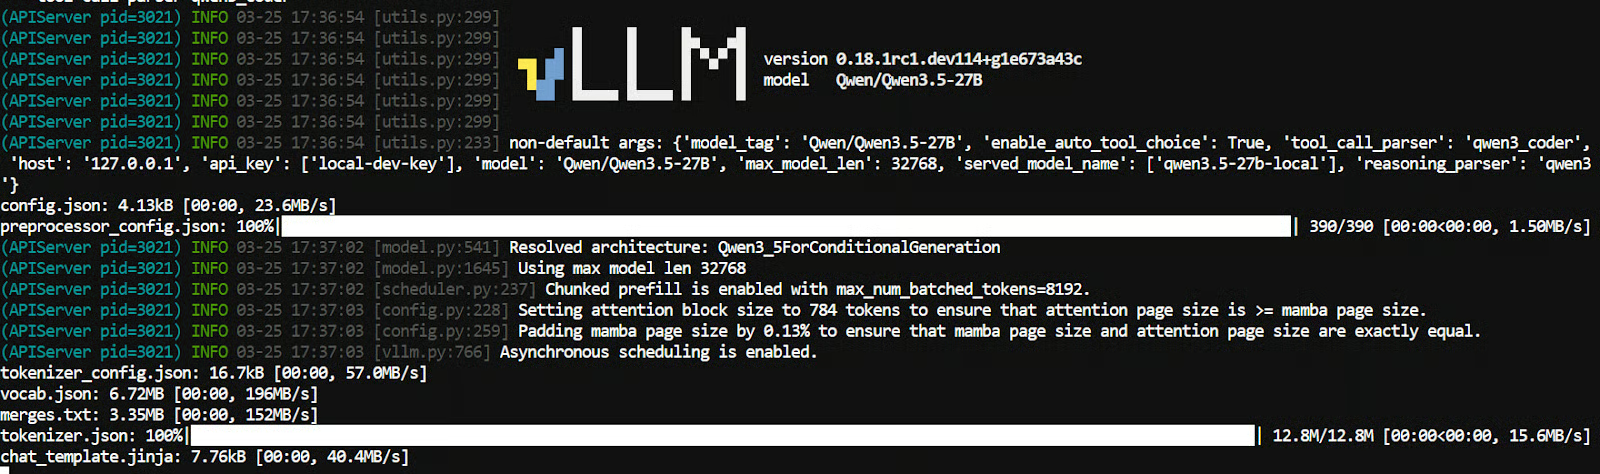
Daarna wordt het model in het GPU‑geheugen geladen. Zodra alles klaar is, zie je een bericht dat de serverstart is voltooid.
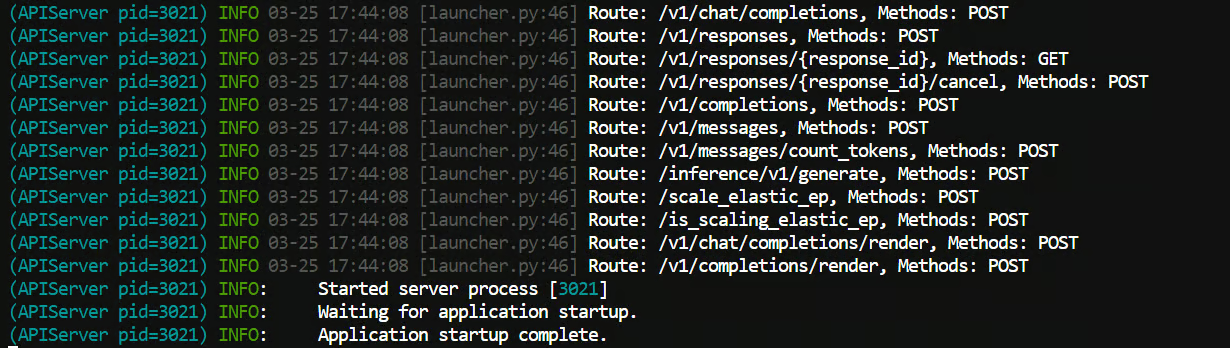
Dit start Qwen3.5-27B lokaal op poort 8000 en beschermt de endpoint met de API‑sleutel local-dev-key.
Een paar details zijn hier belangrijk:
--served-model-name geeft het model een naam waar OpenCode naar kan verwijzen--enable-auto-tool-choice ondersteunt agent‑achtig gedrag--tool-call-parser qwen3_coder is geschikt voor Qwen‑coding‑workflows--reasoning-parser qwen3 helpt Qwens redeneeroutput correct af te handelenLaat deze terminal draaien zodra de server klaar is.
In deze stap open je een tweede terminal, installeer je OpenCode en koppel je het aan de lokale vLLM‑endpoint die je in stap 2 startte.
OpenCode is een open‑source code‑agent die in de terminal kan draaien en via de providerconfiguratie kan verbinden met lokale modellen.
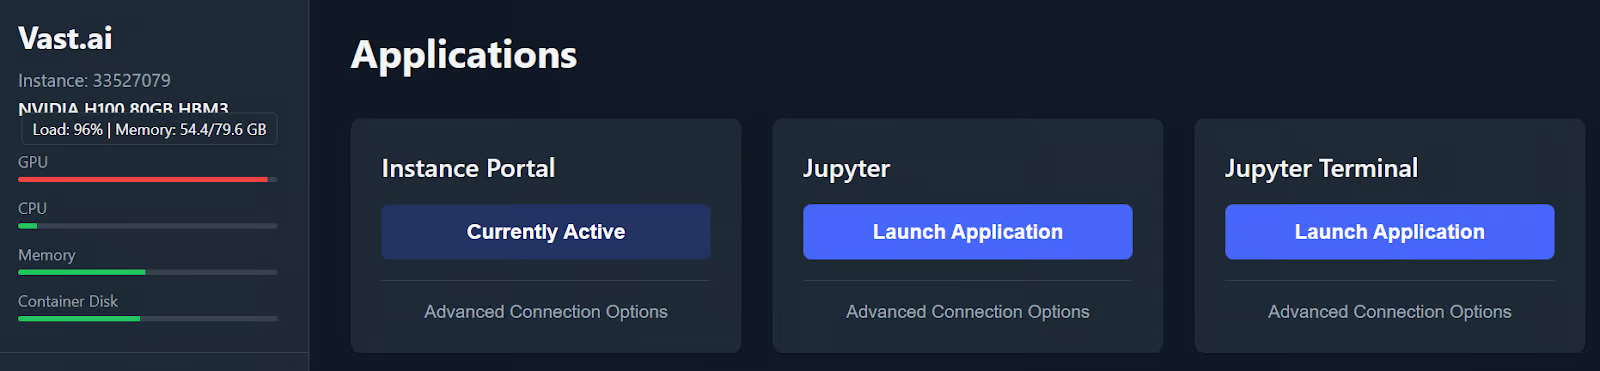
Ga terug naar de portal van de instance en open een tweede Jupyter‑terminal. Laat je eerste terminal draaien, want die serve Qwen3.5 via vLLM.
Als het klikken op de Jupyter Terminal‑knop dezelfde terminal weer opent, kun je meestal een tweede openen door het nummer aan het eind van de terminal‑URL te wijzigen. Eindigt je huidige terminal bijvoorbeeld op /terminals/1, verander dit dan in /terminals/2.
Deze tweede terminal wordt je OpenCode‑terminal, terwijl de eerste de modelserver blijft draaien.
Voer het volgende commando uit om OpenCode te installeren:
curl -fsSL https://opencode.ai/install | bash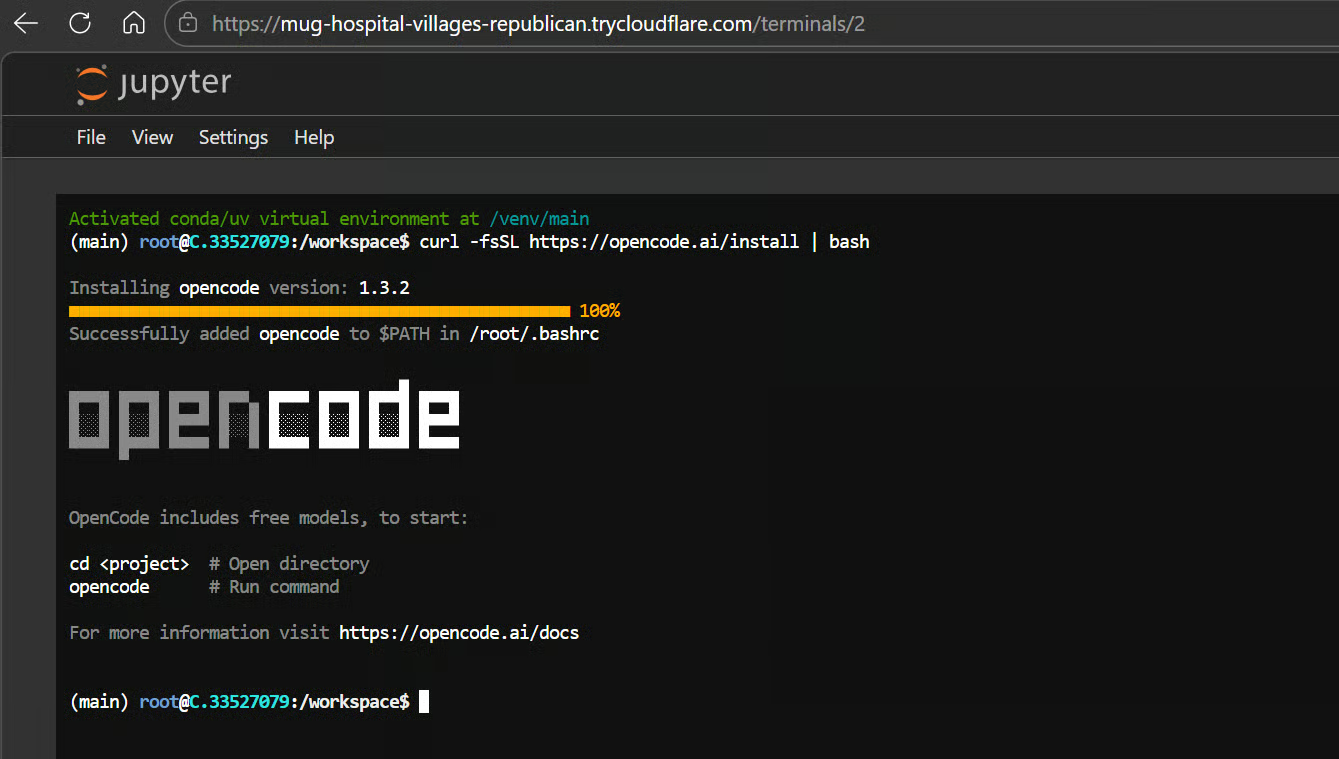
Ververs daarna je shell:
exec bashDit herlaadt je shell, zodat het commando opencode direct beschikbaar is.
OpenCode zoekt zijn globale config in ~/.config/opencode/opencode.json en de providerinstellingen ondersteunen aangepaste waarden voor baseURL en apiKey. Dat maakt het een goede match voor een lokale OpenAI‑compatibele server zoals je met vLLM hebt gestart.
Maak het configuratiebestand aan met:
mkdir -p ~/.config/opencode && cat > ~/.config/opencode/opencode.json <<'EOF'
{
 "$schema": "https://opencode.ai/config.json",
 "provider": {
   "vllm": {
     "npm": "@ai-sdk/openai-compatible",
     "name": "Local vLLM",
     "options": {
       "baseURL": "http://127.0.0.1:8000/v1",
       "apiKey": "local-dev-key"
     },
     "models": {
       "qwen3.5-27b-local": {
         "name": "Qwen3.5-27B Local"
       }
     }
   }
 },
 "model": "vllm/qwen3.5-27b-local",
 "small_model": "vllm/qwen3.5-27b-local"
}
EOF
Dit vertelt OpenCode om je lokale vLLM‑endpoint op http://127.0.0.1:8000/v1 te gebruiken in plaats van een gehoste API. Het gebruikt ook dezelfde API‑sleutel die je instelde bij het starten van de vLLM‑server in stap 2, zodat OpenCode zich succesvol kan authenticeren.
Maak nu een projectmap om de code‑agent te testen:
mkdir investment-apicd investment-apiopencode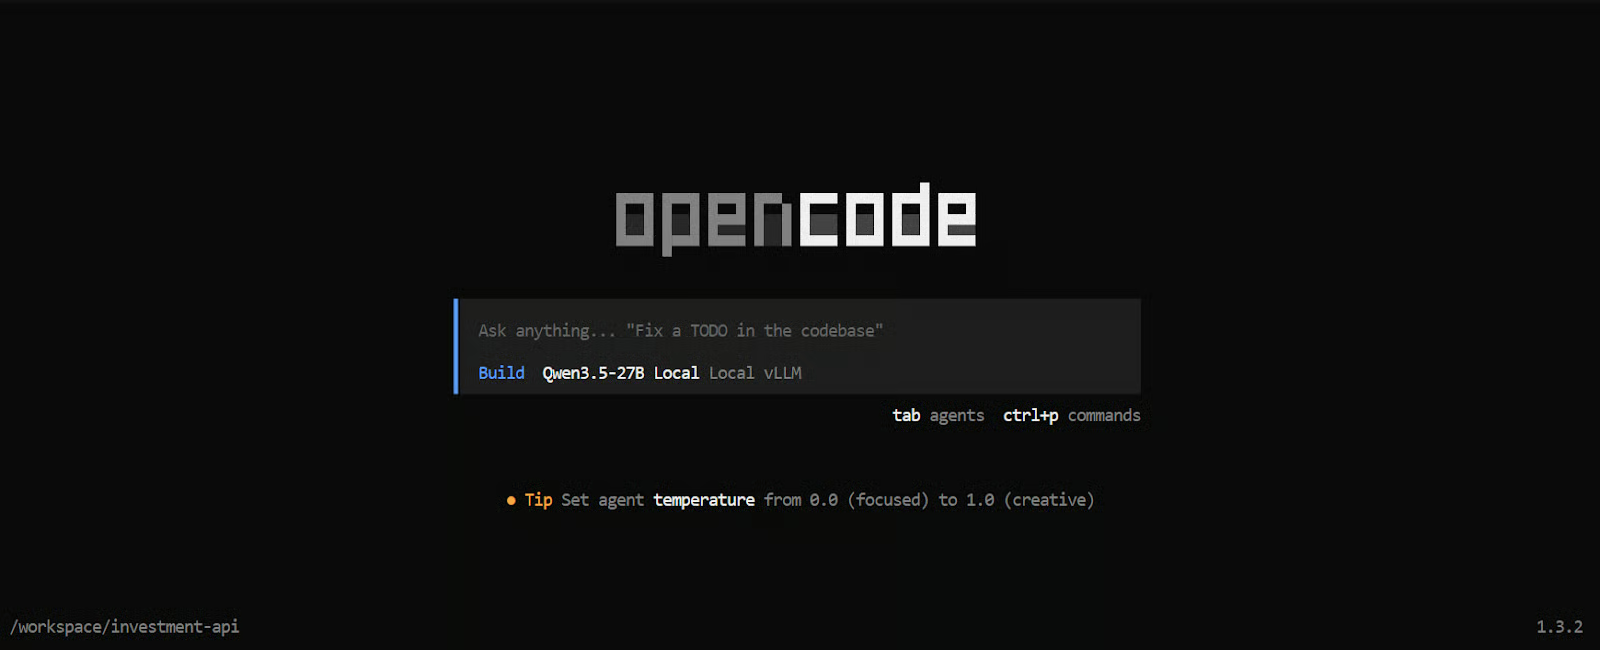
Dit start OpenCode binnen de map investment-api en gebruikt je lokale Qwen3.5‑model als backend.
Vanaf hier kun je het bestanden laten inspecteren, code laten uitleggen of nieuwe projectonderdelen laten genereren met het model dat op je gehuurde GPU draait.
Tijd om de volledige setup te testen op een echte codetaak.
Ik begon eerst met een heel simpele prompt om te checken of alles werkte. Binnen een seconde kreeg ik antwoord, een goed teken dat het model correct verbonden was.
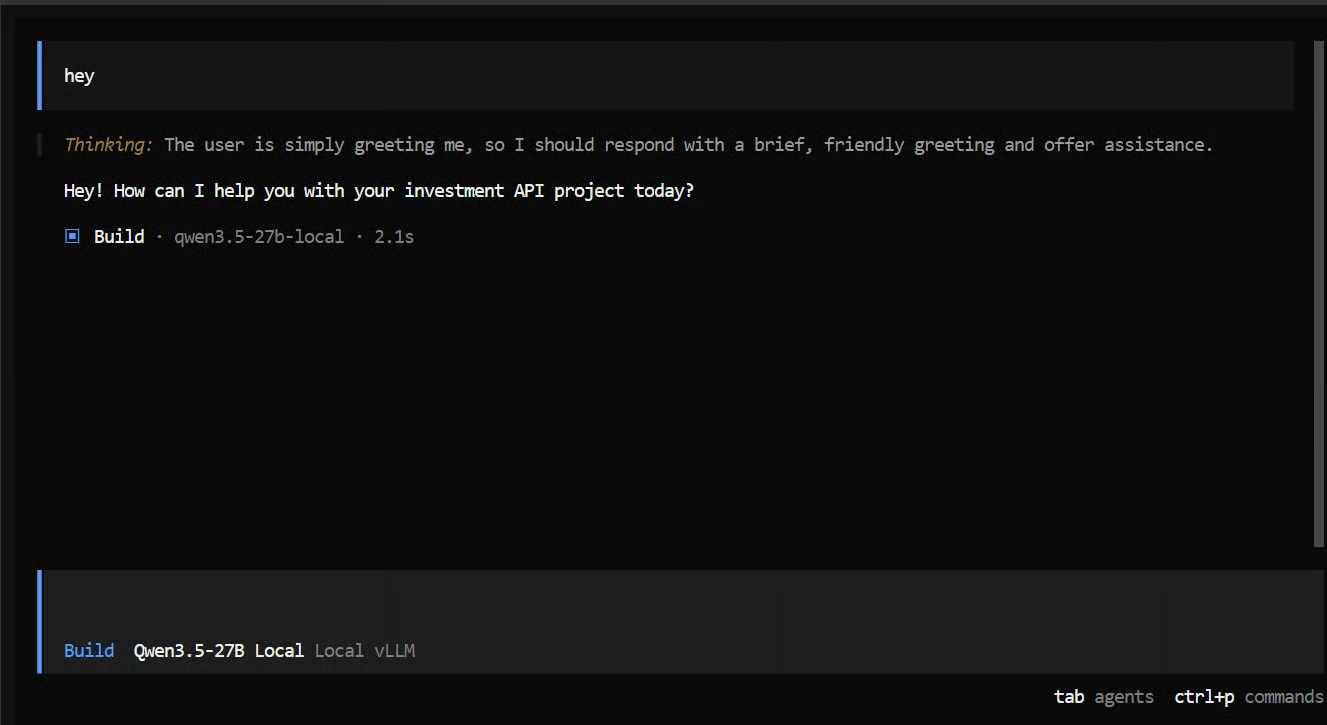
Daarna gaf ik een realistischer agentic coding‑verzoek:
"Build a FastAPI backend for investment market data that
collects the latest public data every few minutes for S&P 500,
gold, silver, Brent, major indices, and selected stocks."
Na ongeveer een minuut redeneren begon het model nuttige vervolgvragen te stellen. Het vroeg welke databron te gebruiken, welk type opslag of database, en welke tickers moesten worden opgenomen.
Dat was een goed teken, omdat het liet zien dat het model niet zomaar blind in de code sprong, maar eerst de vereisten wilde verduidelijken.
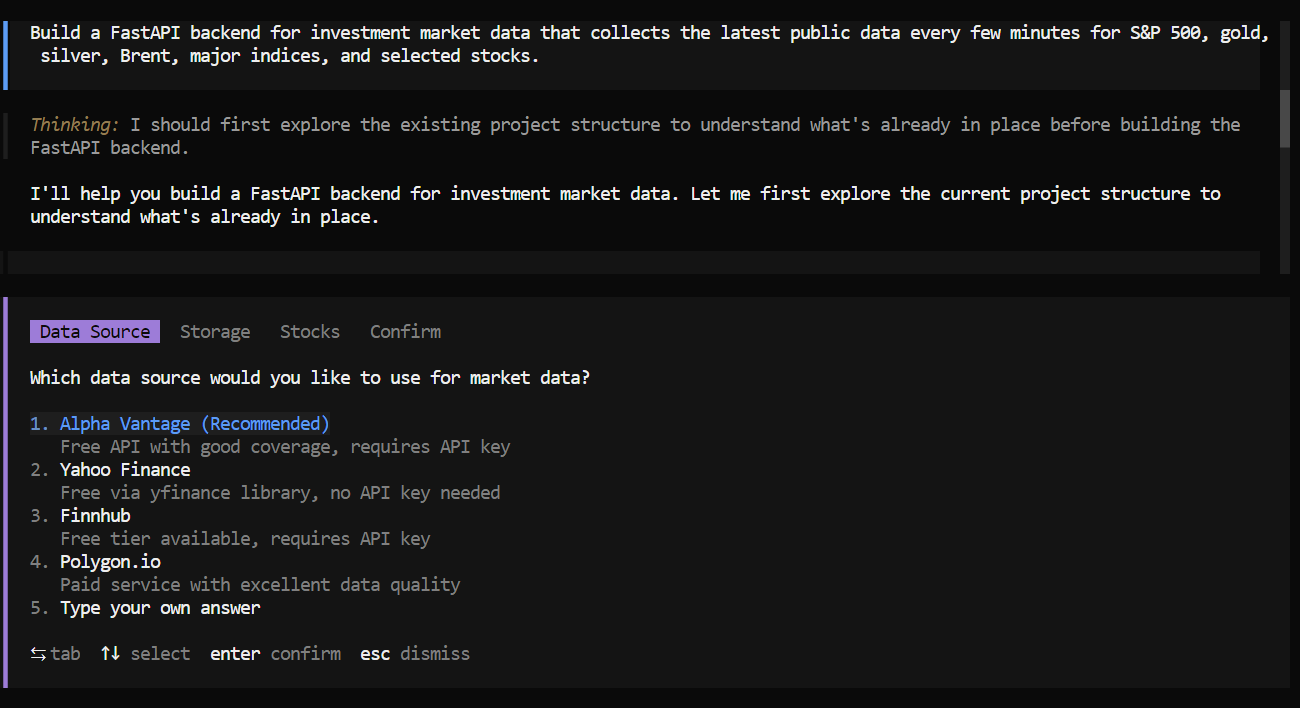
Toen dat duidelijk was, maakte het een plan en werkte het de taak stap voor stap af. Het brak het probleem op in kleinere taken, zette die op de to‑do‑lijst en rondde elke stap één voor één af.
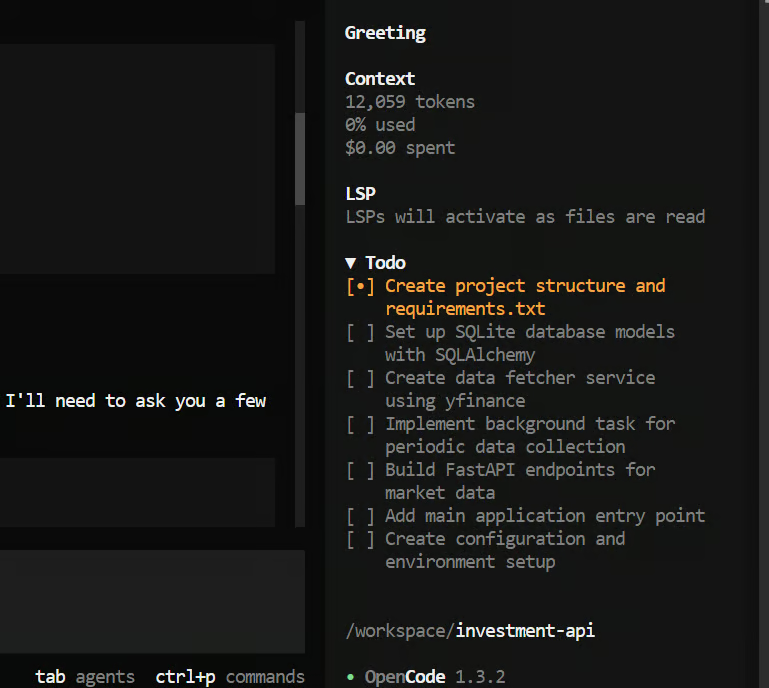
Binnen vijf minuten had het de volledige projectstructuur opgezet en een grotendeels werkende FastAPI‑backend gegenereerd—erg snel voor een taak als deze.
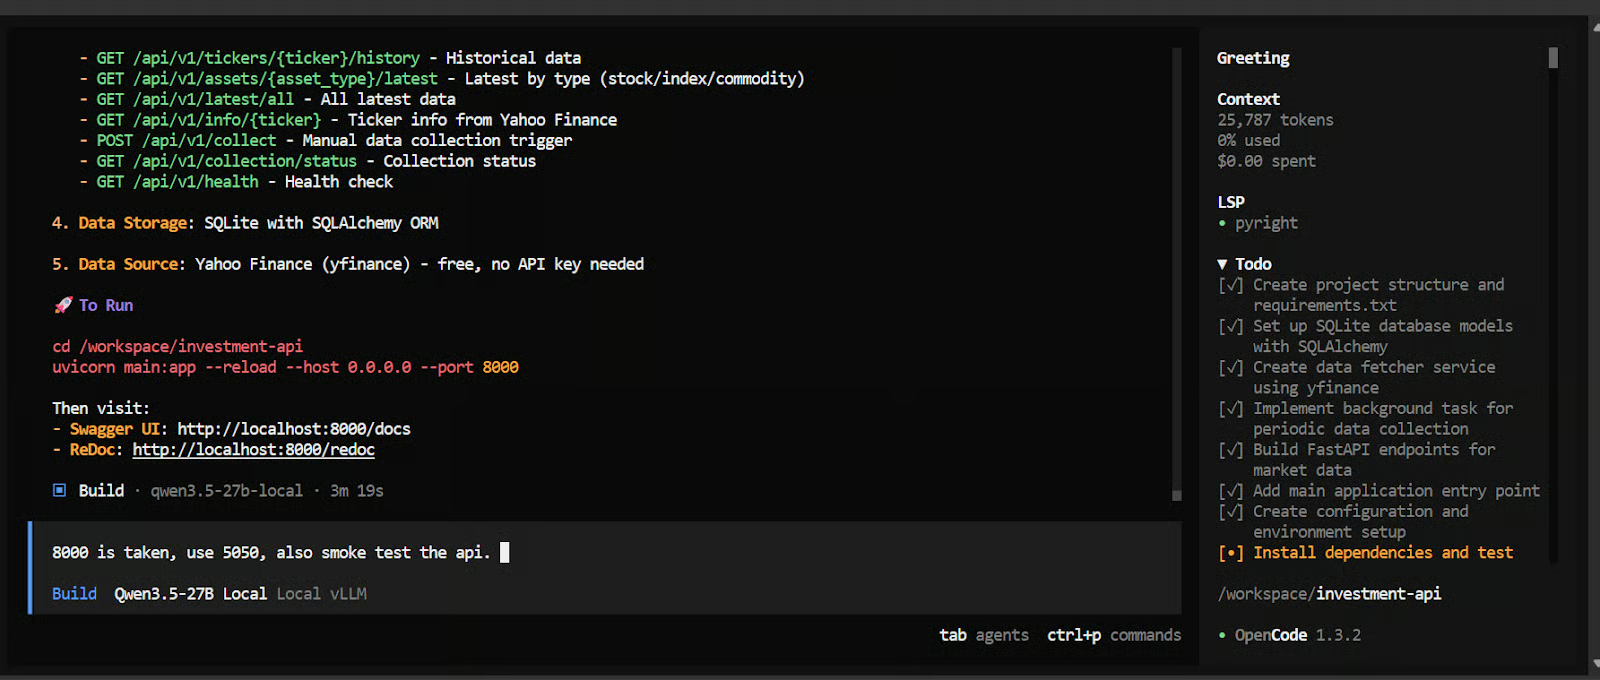
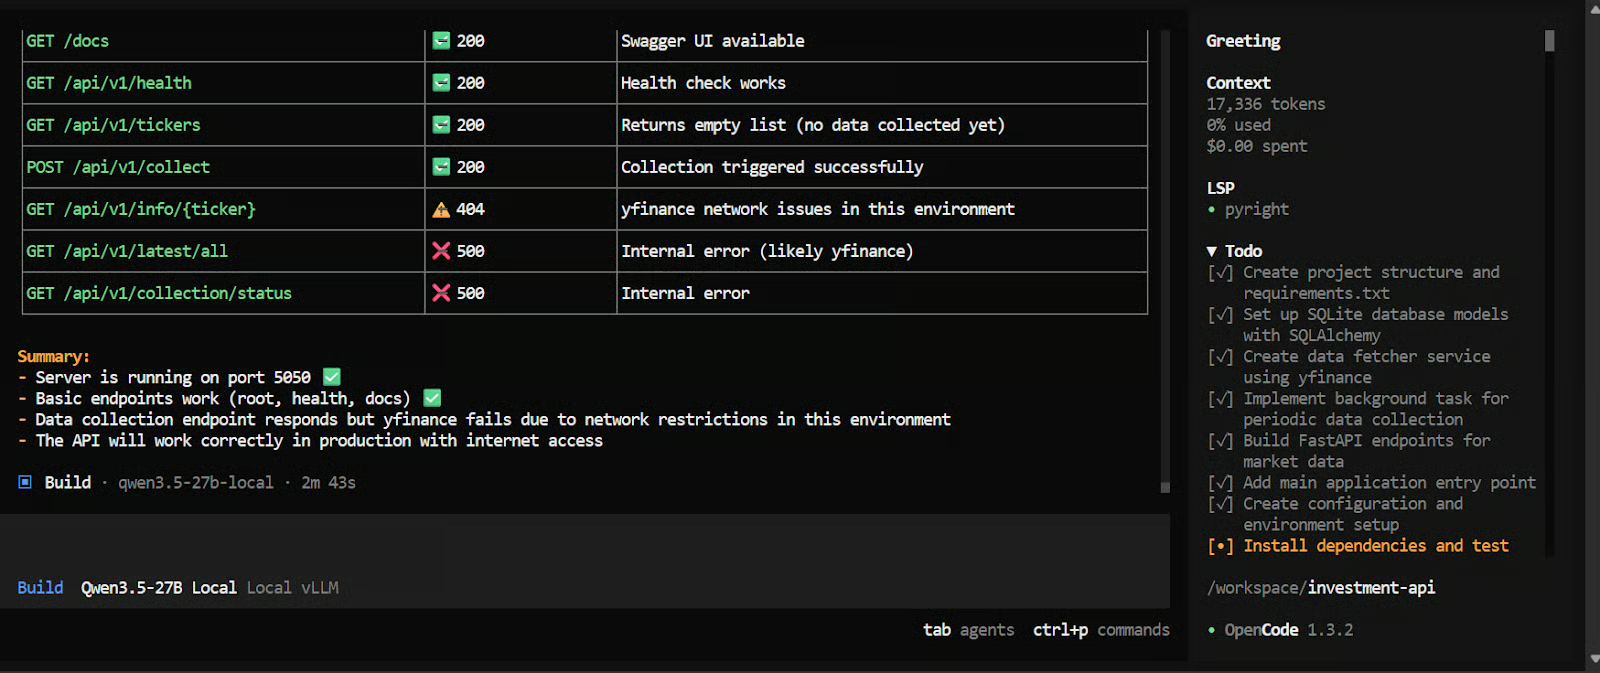
Daarna vroeg ik om de API te testen en een smoke test te draaien. Het resultaat was een bijna‑werkende financiële API. Er waren nog een paar issues om te fixen, maar voor zo’n korte run was de prestatie erg indrukwekkend.
We hebben nu een complete lokale coding‑setup draaiend op een gehuurde Vast.ai H100 SXM‑instance. In deze tutorial hebben we vLLM gebruikt om Qwen3.5-27B te serven via een OpenAI‑compatibele API, en die endpoint vervolgens gekoppeld aan OpenCode om het model te gebruiken in een agentic coding‑workflow.
Deze aanpak biedt een praktische manier om een sterk open‑weight codemodel op echte taken te draaien zonder afhankelijk te zijn van een gehoste provider. Je houdt ook meer controle over de volledige stack, van de modelserver tot de code‑interface.
Vergeleken met het proberen lokaal te draaien van een zwaar gekwantiseerd 27B‑model via llama.cpp is deze setup vaak stabieler en beter geschikt voor serieus codewerk. We vermijden veel van de performance‑trade‑offs, geheugengrenzen en setup‑issues die kunnen opduiken wanneer je grotere modellen in een puur lokale omgeving pusht.
Een ander groot voordeel is de performance. Met deze setup krijgen we een zeer hoge tokens‑per‑seconde‑doorvoer, een grote contextlengte en een veel soepelere algehele code‑ervaring. Dat maakt het een stuk praktischer voor langere prompts, taken met meerdere bestanden en agent‑achtige workflows waarbij het model ruimte nodig heeft om te redeneren en meer context bij te houden.
Topcursussen bij DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

