Curso
Codificação com IA para Desenvolvedores
1 h 30 min
10.7K
Neste tutorial, você vai configurar uma instância remota H100 SXM na Vast.ai, servir o Qwen3.5-27B com vLLM, conectá-lo ao OpenCode e testar sua capacidade de coding orientado a agentes em um projeto real com FastAPI.
Aqui vamos, de propósito, não usar o llama.cpp. Embora o llama.cpp seja excelente para muitas configurações locais de inferência, rodar um modelo quantizado de 27B por ele costuma trazer trade-offs: menor qualidade de saída, queda no desempenho em código e mais atrito na configuração.
Para modelos maiores como o Qwen3.5-27B, a quantização pode afetar visivelmente a confiabilidade, e deploys locais via llama.cpp podem ficar difíceis de administrar se você busca um comportamento de agente mais estável, parecido com produção.
Em vez disso, este tutorial usa vLLM em uma GPU H100 SXM alugada. Isso oferece um endpoint compatível com OpenAI mais estável, melhor performance do modelo completo e uma configuração bem mais limpa para fluxos de trabalho de coding com agentes.
Veja também nosso guia separado sobre como rodar o Qwen3.5-397B-A17B localmente.
Antes de começar, garanta que você tem:
Uma H100 SXM é uma ótima escolha aqui porque o Qwen3.5-27B precisa de bastante memória e alto throughput, especialmente para janelas de contexto maiores e uma inferência mais fluida focada em código.
Estamos usando a Vast.ai porque é um marketplace de GPUs que geralmente dá bem mais flexibilidade de preço e hardware do que uma nuvem tradicional de fornecedor único.
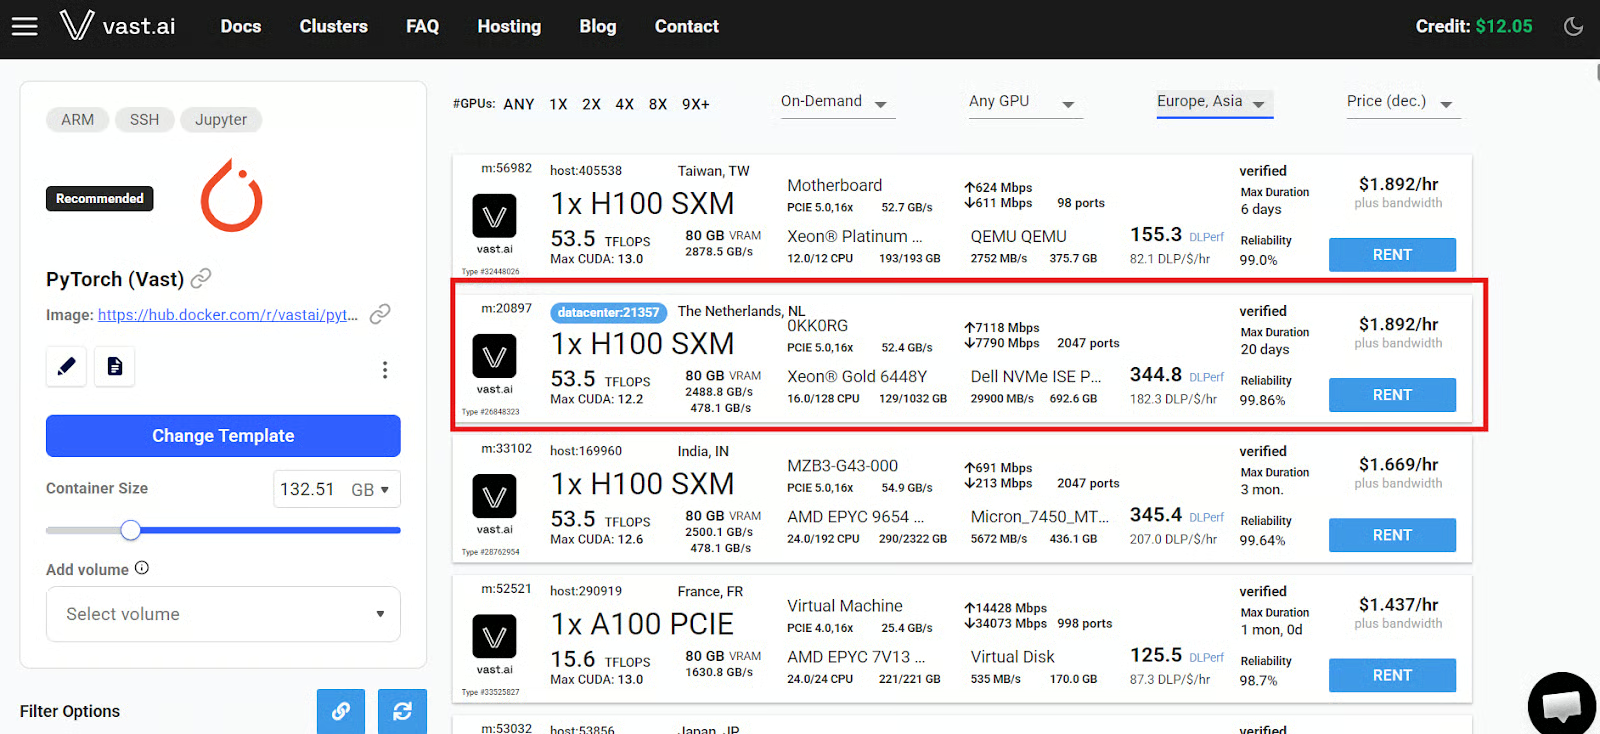
Você pode alugar desde máquinas hospedadas pela comunidade até ofertas de Secure Cloud / datacenter, que a Vast sinaliza com um rótulo azul de datacenter. Para uma configuração como esta, recomendo fortemente escolher uma dessas máquinas com rótulo azul para ter mais confiabilidade e uma experiência mais tranquila.
Comece criando uma conta na Vast.ai e adicionando crédito suficiente para cobrir sua sessão. Depois, abra a página de busca, selecione o template PyTorch com Jupyter habilitado e procure uma oferta de 1x H100 SXM.
Os preços mudam constantemente na Vast.ai por ser um marketplace em tempo real, então trate qualquer valor por hora como aproximado, não fixo.
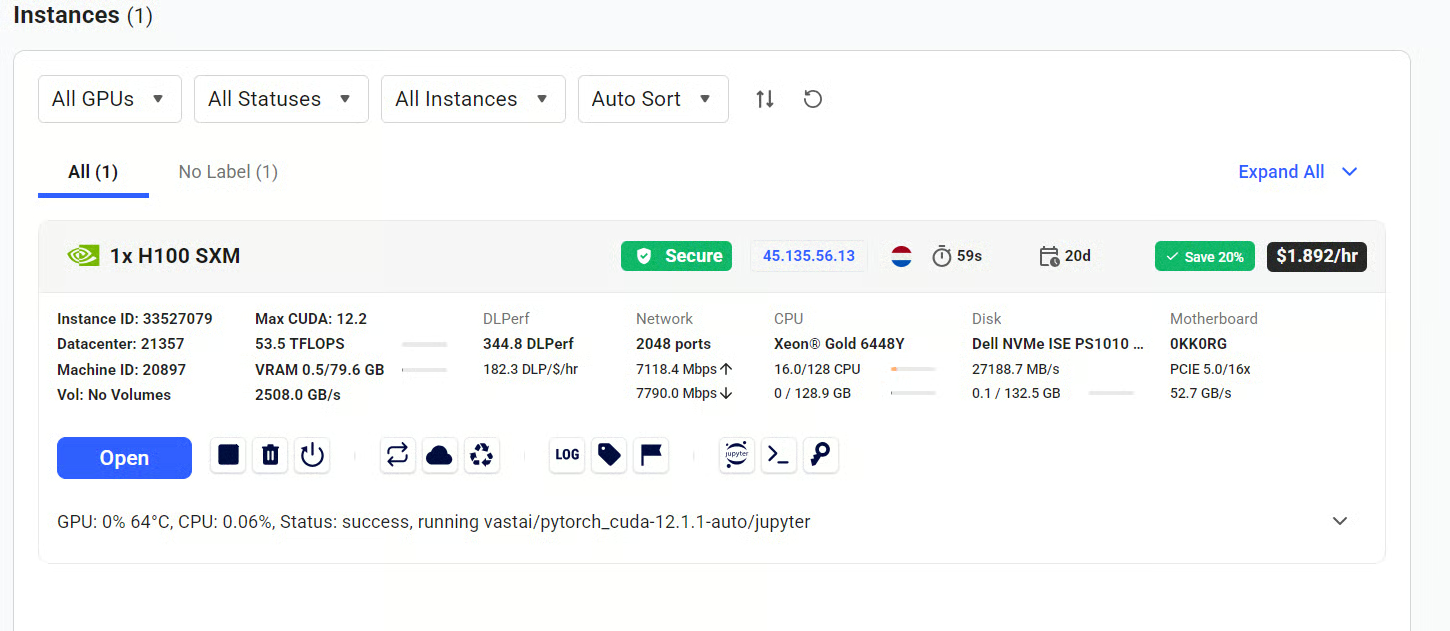
Depois de alugar a máquina, vá até a aba Instances. Quando o status mudar para Open, clique no botão Open para abrir o portal da instância no seu navegador.
A partir daí, você pode abrir o Jupyter e iniciar uma sessão de terminal direto na máquina remota.
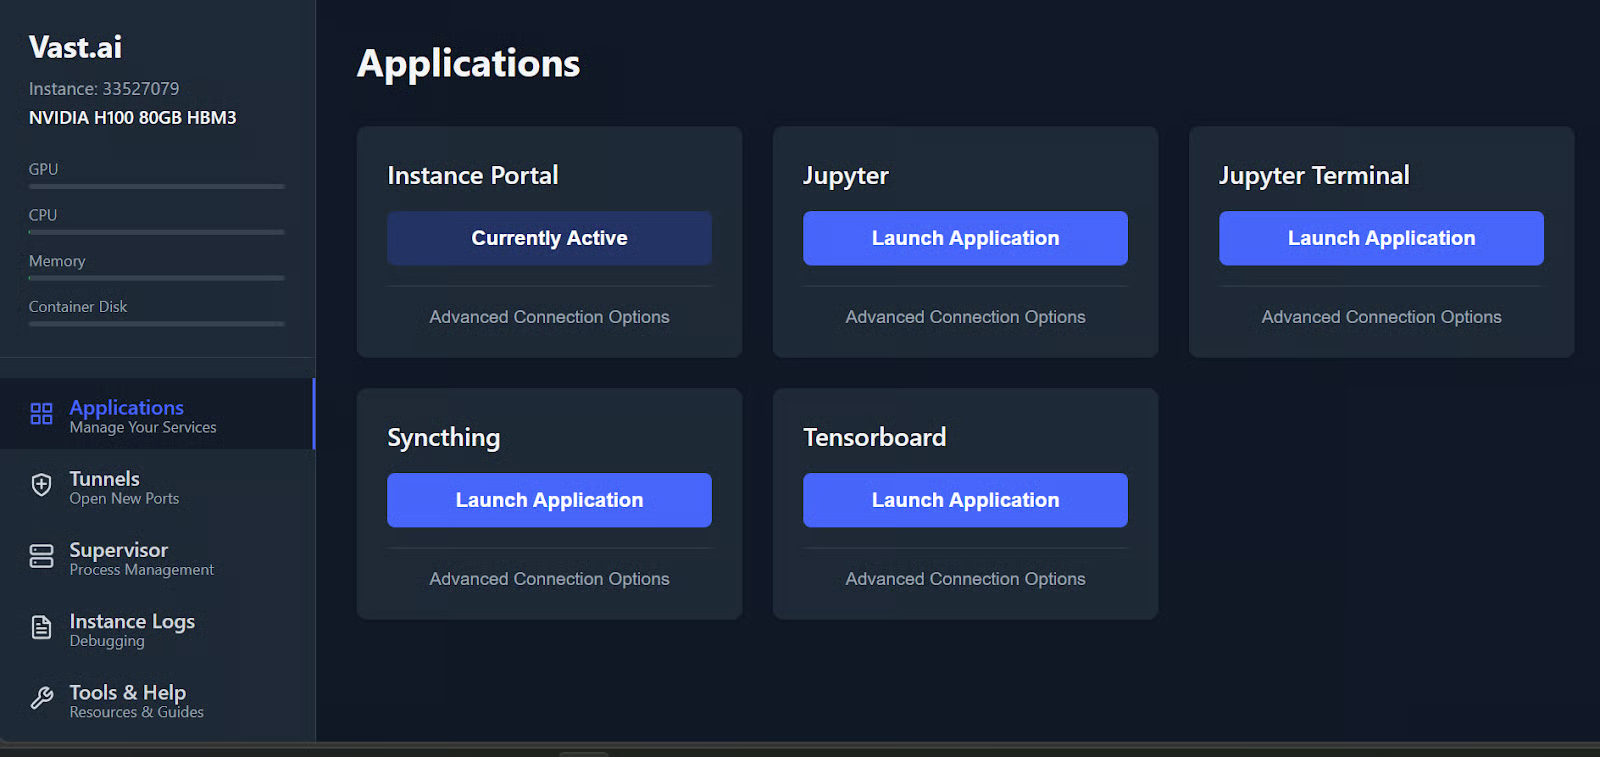
Para este tutorial, mantenha dois terminais abertos:
Manter essas tarefas separadas facilita muito a gestão do fluxo quando o servidor do modelo estiver no ar.
Neste passo, você vai criar um ambiente Python isolado, instalar o vLLM e iniciar o Qwen3.5-27B como uma API compatível com OpenAI que o OpenCode consegue acessar.
vLLM é um mecanismo de inferência de alta vazão para LLMs, projetado para servir modelos de forma eficiente via API.
No primeiro terminal, crie um workspace limpo para o servidor do modelo:
mkdir qwen-servercd qwen-server/uv venv --python 3.12source .venv/bin/activateIsso cria um ambiente dedicado em Python 3.12, mantendo as dependências do servidor do modelo isoladas do restante da máquina.
Agora, instale o vLLM:
uv pip install vllm --torch-backend=auto --extra-index-url https://wheels.vllm.ai/nightly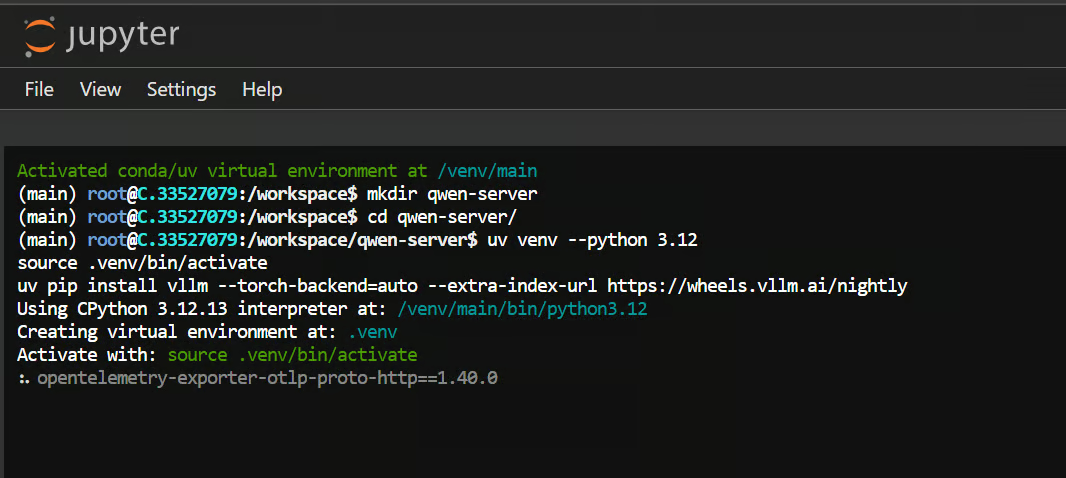
Isso instala o engine de inferência que vai expor o Qwen3.5 por meio de uma API compatível com OpenAI.
Observação: você pode não precisar dos wheels nightly para esta configuração, já que o suporte atual do vLLM ao Qwen3.5 muitas vezes funciona também com a instalação padrão.
Assim que o vLLM estiver instalado, inicie o servidor do modelo com:
vllm serve Qwen/Qwen3.5-27B \
 --host 127.0.0.1 \
 --port 8000 \
 --api-key local-dev-key \
 --served-model-name qwen3.5-27b-local \
 --tensor-parallel-size 1 \
 --max-model-len 64000 \
 --enable-auto-tool-choice \
 --tool-call-parser qwen3_coder \
 --reasoning-parser qwen3
Na primeira execução, o vLLM vai baixar os arquivos do modelo e do tokenizer.
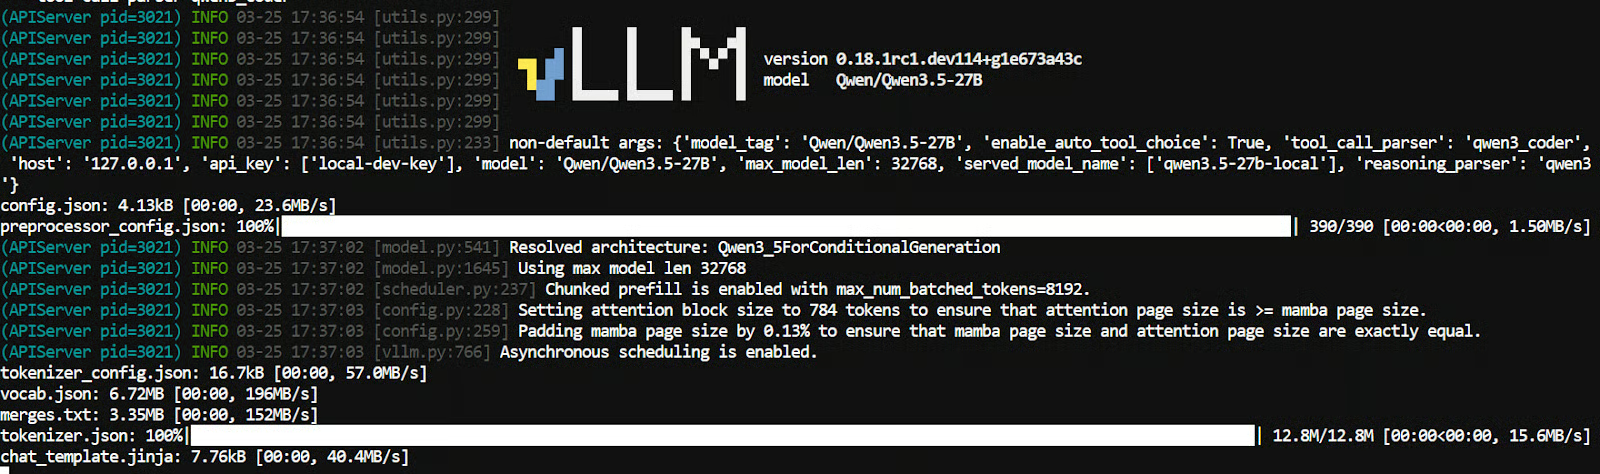
Depois, ele carrega o modelo na memória da GPU. Quando tudo estiver pronto, você verá uma mensagem indicando que o servidor iniciou com sucesso.
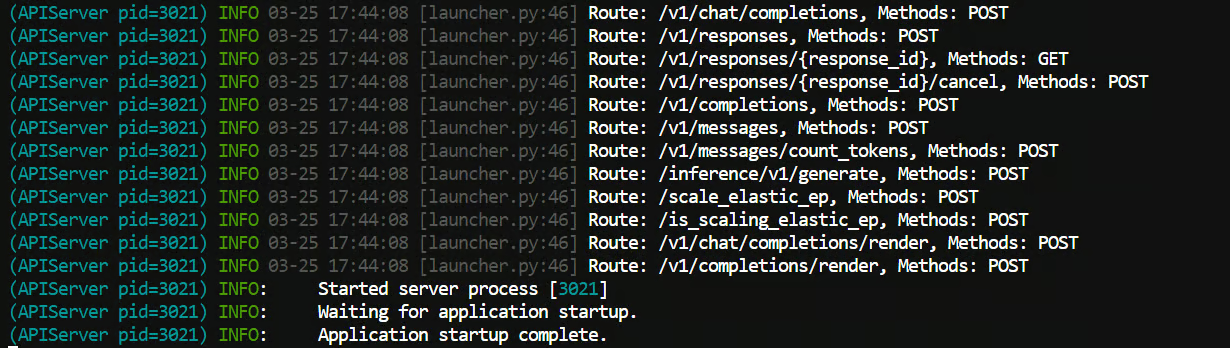
Isso inicia o Qwen3.5-27B localmente na porta 8000 e protege o endpoint com a chave de API local-dev-key.
Alguns detalhes importantes:
--served-model-name dá ao modelo um nome que o OpenCode pode referenciar--enable-auto-tool-choice habilita o comportamento de agente--tool-call-parser qwen3_coder é adequado para fluxos de coding com Qwen--reasoning-parser qwen3 ajuda a tratar corretamente a saída de raciocínio do QwenDeixe esse terminal rodando quando o servidor estiver pronto.
Agora, você vai abrir um segundo terminal, instalar o OpenCode e conectá-lo ao endpoint local do vLLM iniciado no Passo 2.
O OpenCode é um agente de coding open source que roda no terminal e se conecta a modelos locais via configuração de provider.
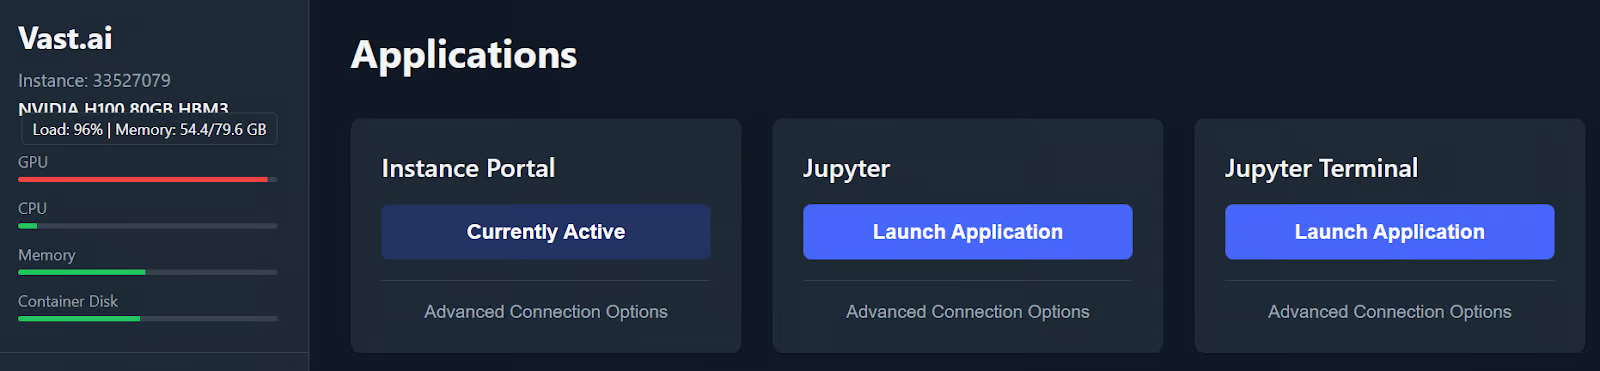
Volte ao portal da instância e abra um segundo terminal do Jupyter. Mantenha o primeiro terminal rodando, pois é ele que está servindo o Qwen3.5 via vLLM.
Se ao clicar no botão de Jupyter Terminal abrir o mesmo terminal de novo, normalmente você consegue abrir outro mudando o número no final da URL do terminal. Por exemplo, se seu terminal atual termina em /terminals/1, troque para /terminals/2.
Este segundo terminal será o seu terminal do OpenCode, enquanto o primeiro continua rodando o servidor do modelo.
Execute o comando abaixo para instalar o OpenCode:
curl -fsSL https://opencode.ai/install | bash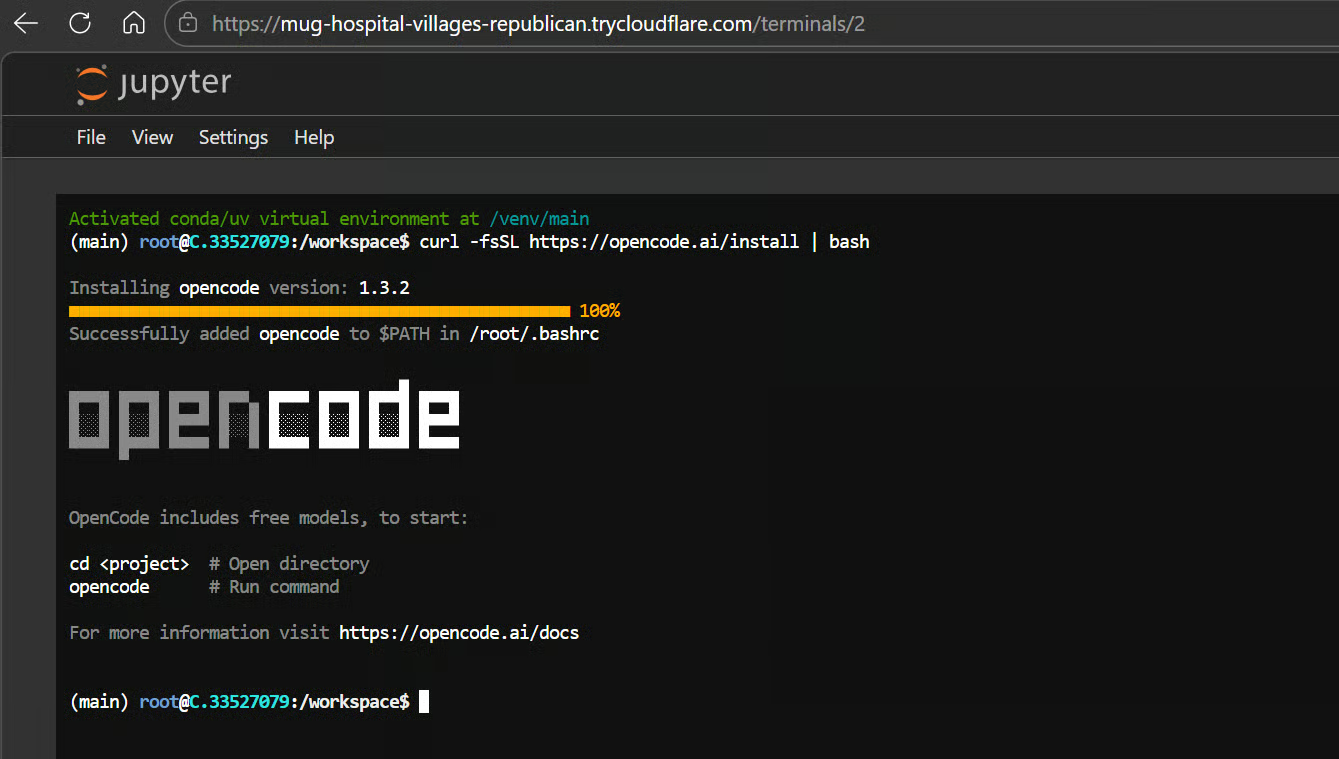
Depois, recarregue seu shell:
exec bashIsso reinicia o shell para que o comando opencode já fique disponível.
O OpenCode procura sua configuração global em ~/.config/opencode/opencode.json e suas definições de provider suportam valores personalizados de baseURL e apiKey. Isso o torna ideal para um servidor local compatível com OpenAI como o que você iniciou com o vLLM.
Crie o arquivo de configuração com:
mkdir -p ~/.config/opencode && cat > ~/.config/opencode/opencode.json <<'EOF'
{
 "$schema": "https://opencode.ai/config.json",
 "provider": {
   "vllm": {
     "npm": "@ai-sdk/openai-compatible",
     "name": "Local vLLM",
     "options": {
       "baseURL": "http://127.0.0.1:8000/v1",
       "apiKey": "local-dev-key"
     },
     "models": {
       "qwen3.5-27b-local": {
         "name": "Qwen3.5-27B Local"
       }
     }
   }
 },
 "model": "vllm/qwen3.5-27b-local",
 "small_model": "vllm/qwen3.5-27b-local"
}
EOF
Isso diz ao OpenCode para usar seu endpoint local do vLLM em http://127.0.0.1:8000/v1 em vez de uma API hospedada. Também usa a mesma chave de API que você definiu ao iniciar o servidor do vLLM no Passo 2, para o OpenCode se autenticar com sucesso.
Agora, crie um diretório de projeto para testar o agente de coding:
mkdir investment-apicd investment-apiopencode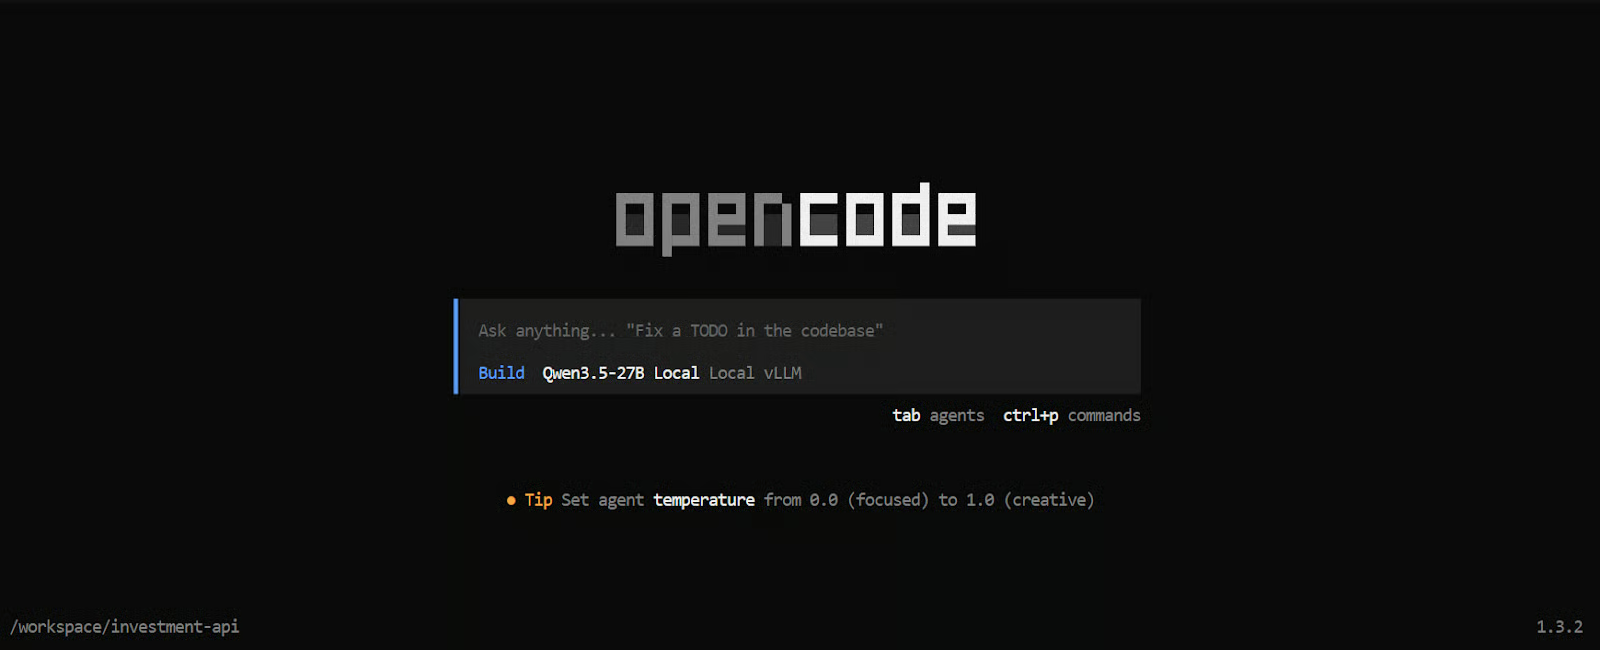
Isso inicia o OpenCode dentro da pasta investment-api e usa seu modelo Qwen3.5 local como backend.
A partir daqui, você pode pedir para inspecionar arquivos, explicar código ou gerar novos componentes do projeto usando o modelo rodando na sua GPU alugada.
Agora é hora de testar toda a configuração em uma tarefa real.
Comecei com um prompt bem simples só para garantir que tudo estava funcionando. Em um segundo recebi uma resposta — um bom sinal de que o modelo estava conectado corretamente.
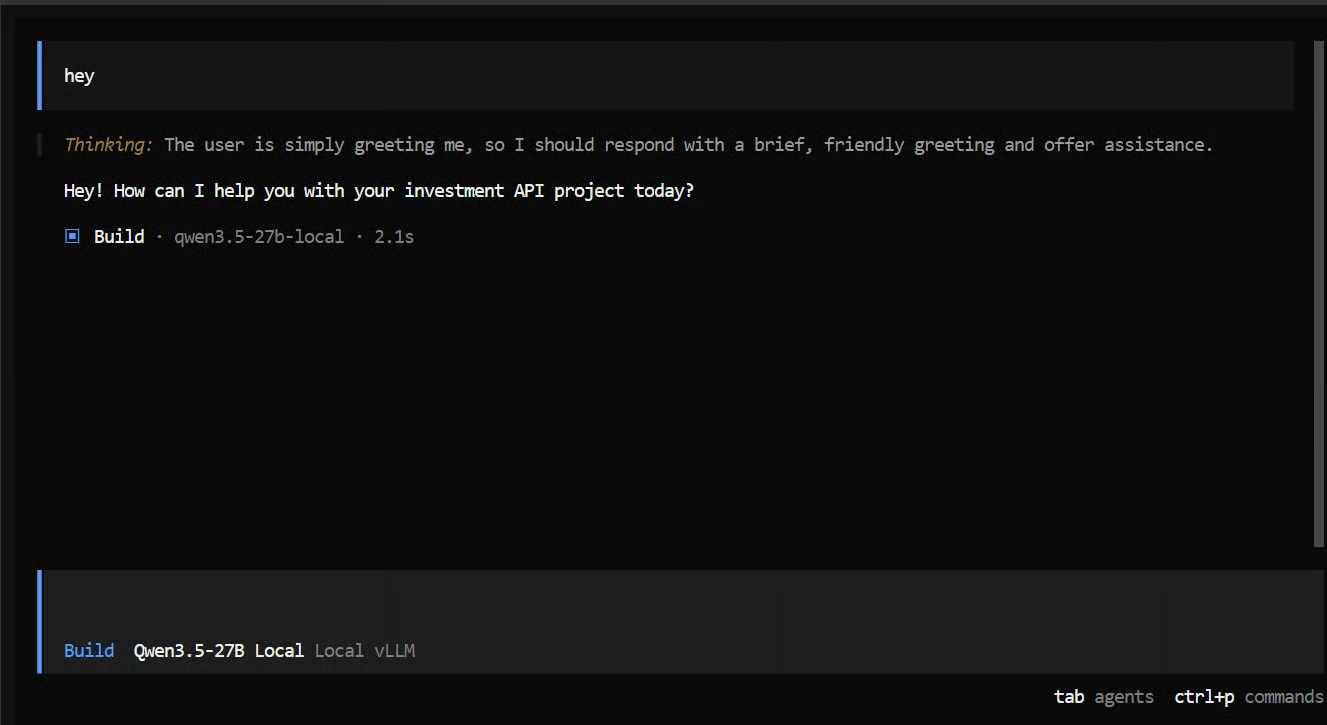
Em seguida, passei uma tarefa mais realista de coding com agente:
"Build a FastAPI backend for investment market data that
collects the latest public data every few minutes for S&P 500,
gold, silver, Brent, major indices, and selected stocks."
Após cerca de um minuto de raciocínio, o modelo começou a fazer perguntas de esclarecimento bem úteis. Perguntou qual fonte de dados usar, que tipo de armazenamento ou banco de dados adotar e quais tickers incluir.
Isso foi um ótimo sinal, pois mostrou que o modelo não estava apenas “saindo codando” sem critério. Primeiro, ele tentou esclarecer os requisitos.
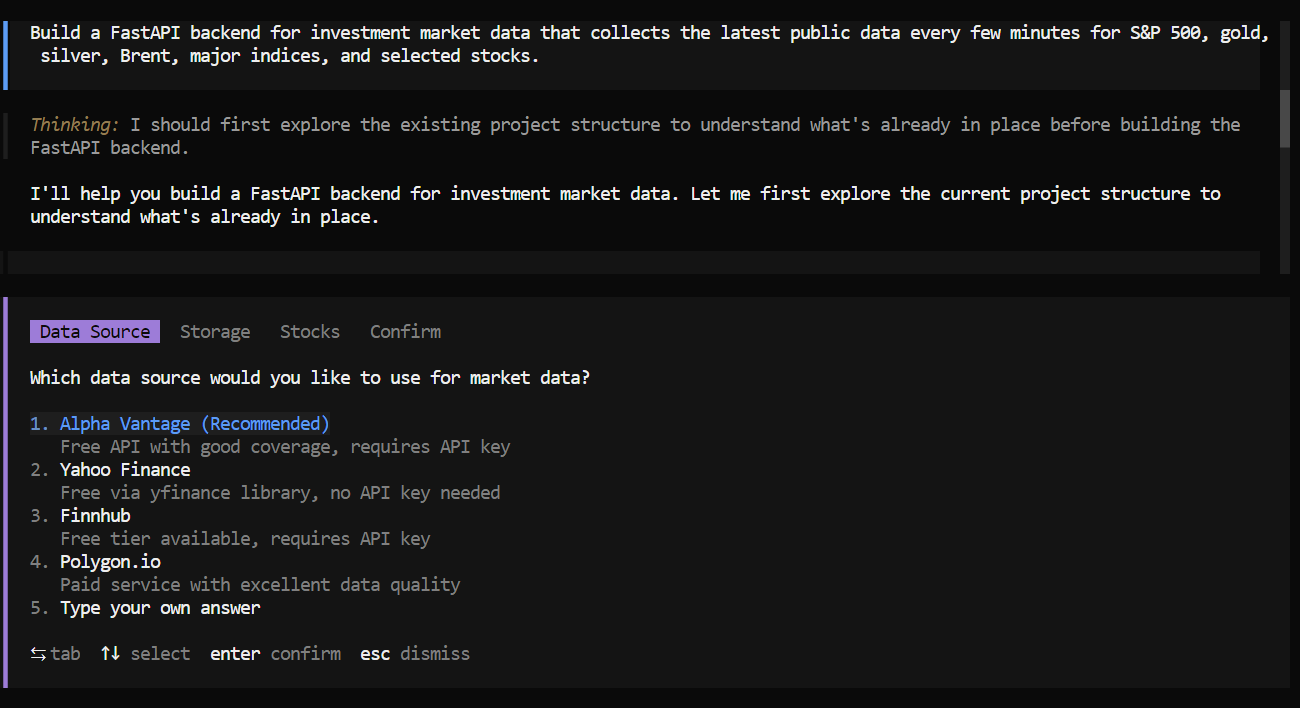
Depois disso, ele criou um plano e começou a executar a tarefa passo a passo. Quebrou o problema em subtarefas, adicionou à sua lista de afazeres e foi concluindo cada parte em sequência.
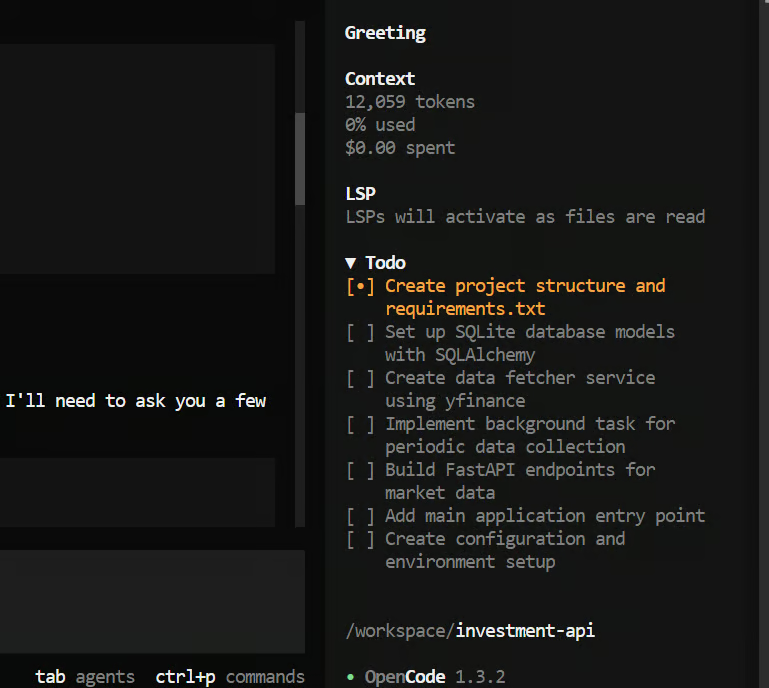
Em menos de cinco minutos, ele criou toda a estrutura do projeto e gerou um backend FastAPI majoritariamente funcional — muito rápido para uma tarefa desse porte.
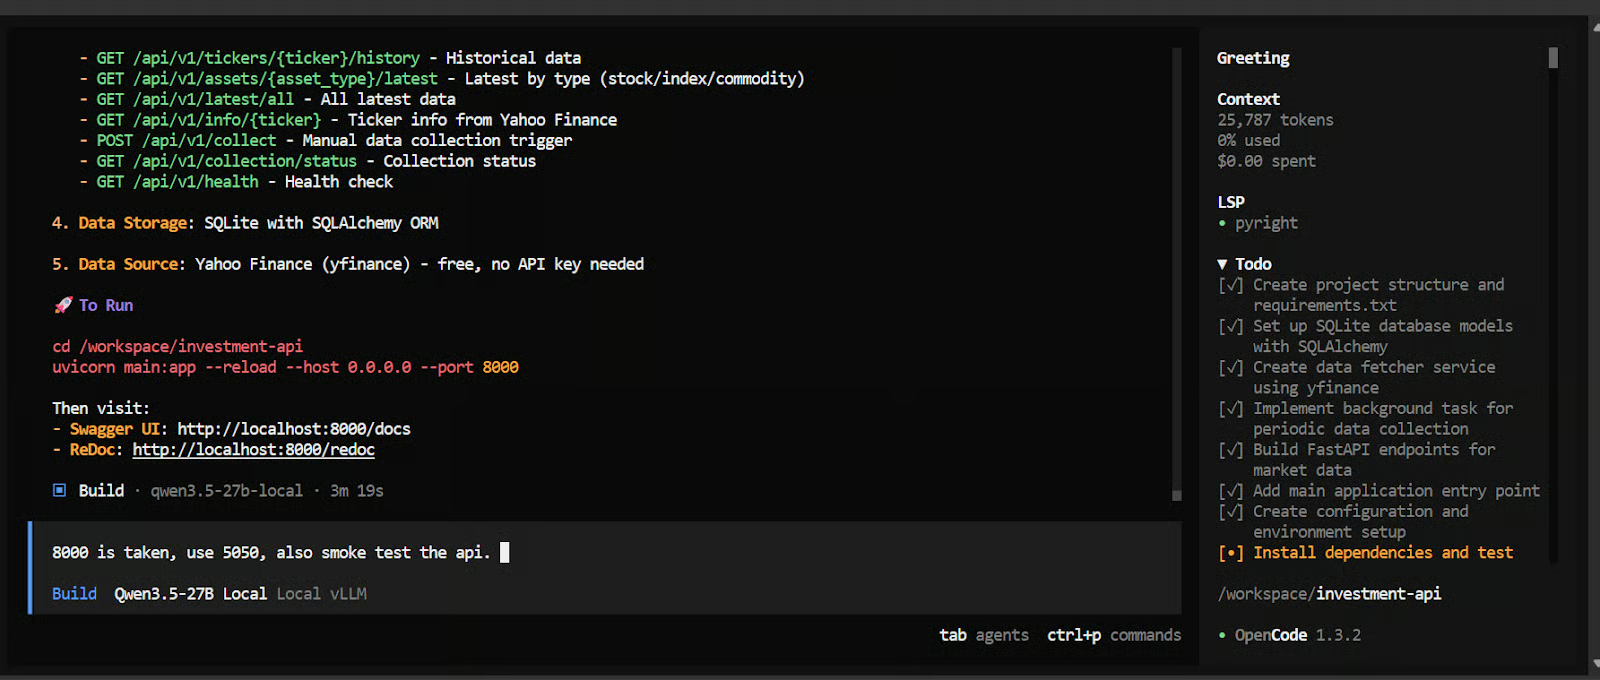
Depois, pedi para testar a API e rodar um smoke test. O resultado foi uma API financeira quase pronta. Ainda havia alguns pontos para ajustar, mas para uma execução curta como esta, o desempenho foi muito impressionante.
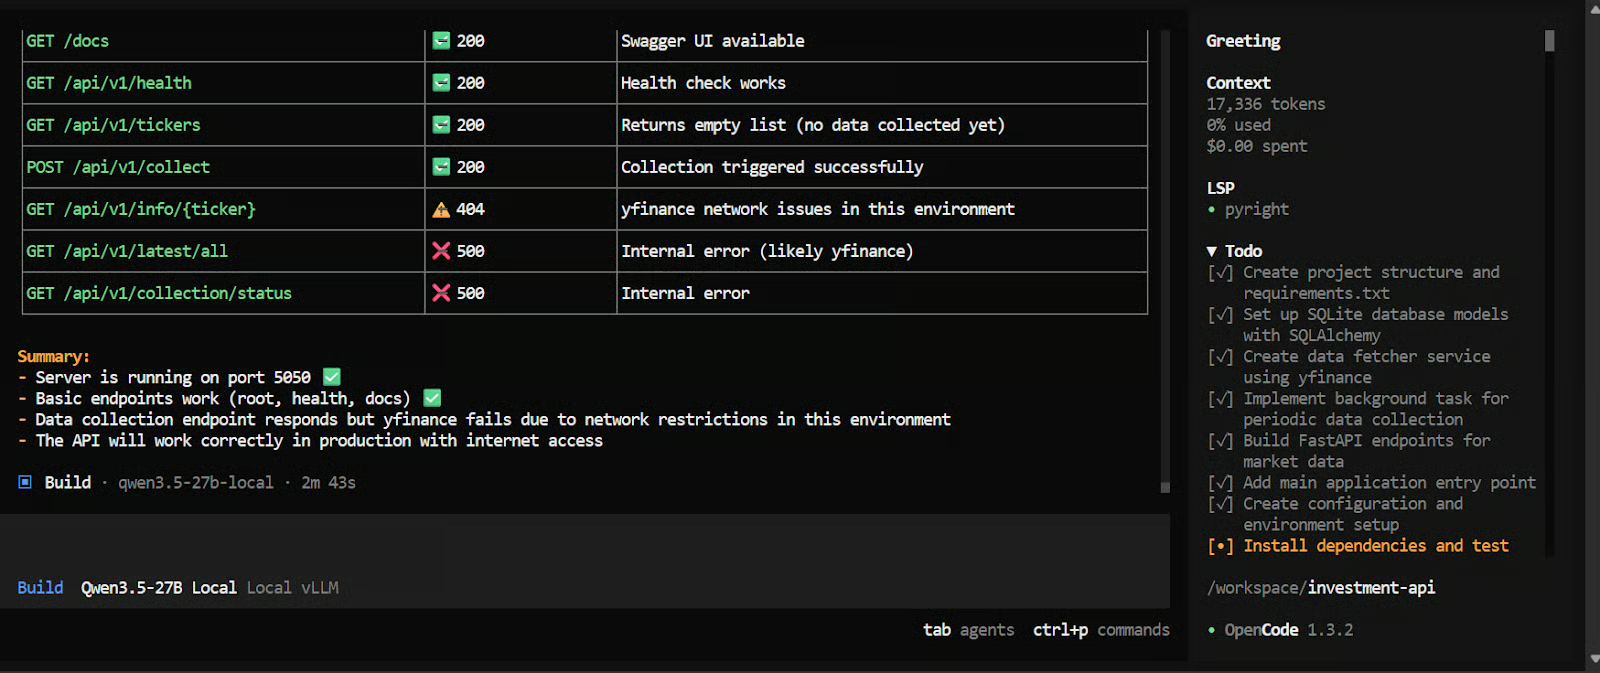
Agora temos um setup completo de coding local rodando em uma instância Vast.ai H100 SXM alugada. Neste tutorial, usamos o vLLM para servir o Qwen3.5-27B por meio de uma API compatível com OpenAI e conectamos esse endpoint ao OpenCode para usar o modelo em um fluxo de trabalho agentic.
Essa abordagem nos dá uma forma prática de rodar um modelo open-weight forte em tarefas reais sem depender de um provedor hospedado. Também nos dá mais controle sobre todo o stack, do servidor do modelo à interface de coding.
Comparado a tentar rodar um modelo de 27B fortemente quantizado localmente via llama.cpp, este setup costuma ser mais estável e mais indicado para trabalho sério com código. Evitamos muitos trade-offs de performance, limitações de memória e problemas de configuração que podem surgir ao forçar modelos grandes em um ambiente 100% local.
Outro grande diferencial é a performance. Com esta configuração, conseguimos um throughput de tokens por segundo muito alto, um comprimento de contexto grande e uma experiência geral de coding bem mais fluida. Isso torna o uso muito mais prático para prompts longos, tarefas com múltiplos arquivos e fluxos agentic, onde o modelo precisa de espaço para raciocinar e manter mais contexto.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
DataCamp Team
4 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Moez Ali
11 min
Tutorial
Moez Ali
12 min
Tutorial