Kurs
Geliştiriciler için Yapay Zeka Destekli Kodlama
1 sa 30 dk
10.7K
Bu eğitimde, Vast.ai üzerinde uzak bir H100 SXM örneği kuracak, Qwen3.5-27B’yi vLLM ile servis edecek, OpenCode’a bağlayacak ve gerçek bir FastAPI projesinde ajan odaklı kodlama becerisini test edeceksiniz.
Burada bilerek kasıtlı olarak llama.cpp kullanmıyoruz. llama.cpp pek çok yerel çıkarım kurulumu için harika olsa da, kuantize edilmiş 27B modeli onunla çalıştırmak genellikle bazı tavizler getirir: daha düşük çıktı kalitesi, düşen kodlama performansı ve daha zahmetli kurulum.
Qwen3.5-27B gibi daha büyük modellerde kuantizasyon güvenilirliği belirgin şekilde zedeleyebilir ve llama.cpp üzerinden yerel dağıtımlar, üretim benzeri akıcı bir ajan davranışı istiyorsanız yönetmesi zor hale gelebilir.
Bunun yerine bu eğitim, kiralanmış bir H100 SXM GPU üzerinde vLLM kullanır. Bu size daha istikrarlı, OpenAI ile uyumlu bir uç nokta, tam modelden daha iyi performans ve ajan odaklı kodlama iş akışları için çok daha temiz bir kurulum sağlar.
Ayrı bir kılavuzumuzda Qwen3.5-397B-A17B’yi yerelde çalıştırmayı görebilirsiniz.
Başlamadan önce şunlara sahip olduğunuzdan emin olun:
H100 SXM bu kurulum için güçlü bir tercihtir; çünkü Qwen3.5-27B özellikle daha uzun bağlam pencereleri ve daha akıcı kodlama odaklı çıkarım için bol bellek ve yüksek aktarım hızına ihtiyaç duyar.
Kullanma nedenimiz Vast.ai’dir; çünkü bu, genellikle tek satıcılı bir buluta kıyasla fiyat ve donanımda çok daha fazla esneklik sunan bir GPU pazaryeridir.
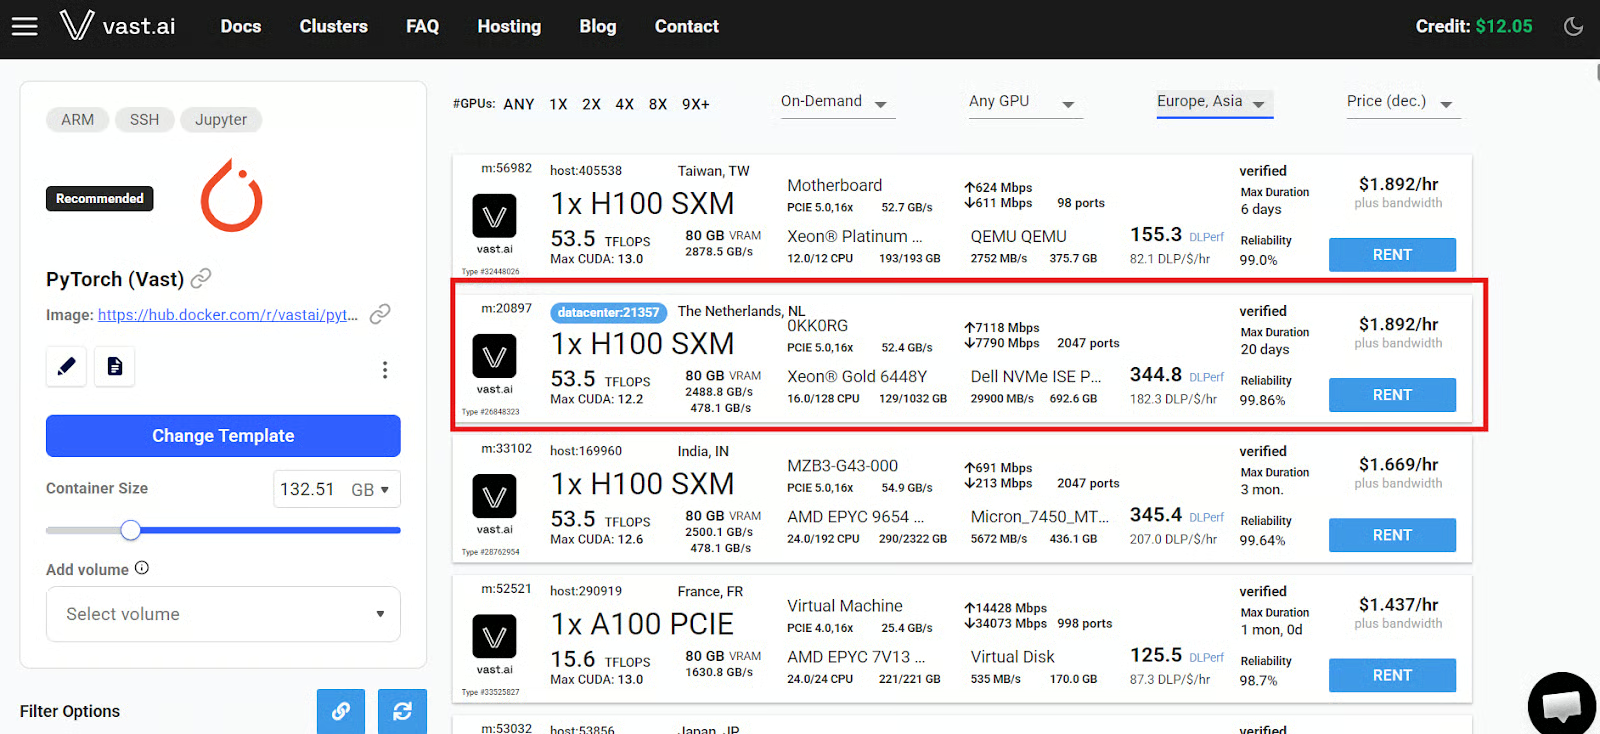
Topluluktan barındırılan makinelerden Secure Cloud / veri merkezi tekliflerine kadar her şeyi kiralayabilirsiniz; Vast bunları mavi veri merkezi etiketi ile işaretler. Bu tür bir kurulum için, daha iyi güvenilirlik ve daha akıcı bir deneyim adına, bu mavi etiketli veri merkezi makinelerinden birini seçmenizi şiddetle tavsiye ederim.
Önce bir Vast.ai hesabı oluşturup oturumunuzu karşılayacak kadar kredi ekleyin. Ardından arama sayfasını açın, Jupyter etkin PyTorch şablonunu seçin ve 1x H100 SXM teklifi arayın.
Vast.ai’de fiyatlandırma canlı bir pazaryeri olduğu için sürekli değişir; bu nedenle saatlik ücreti sabit değil, yaklaşık bir değer olarak değerlendirin.
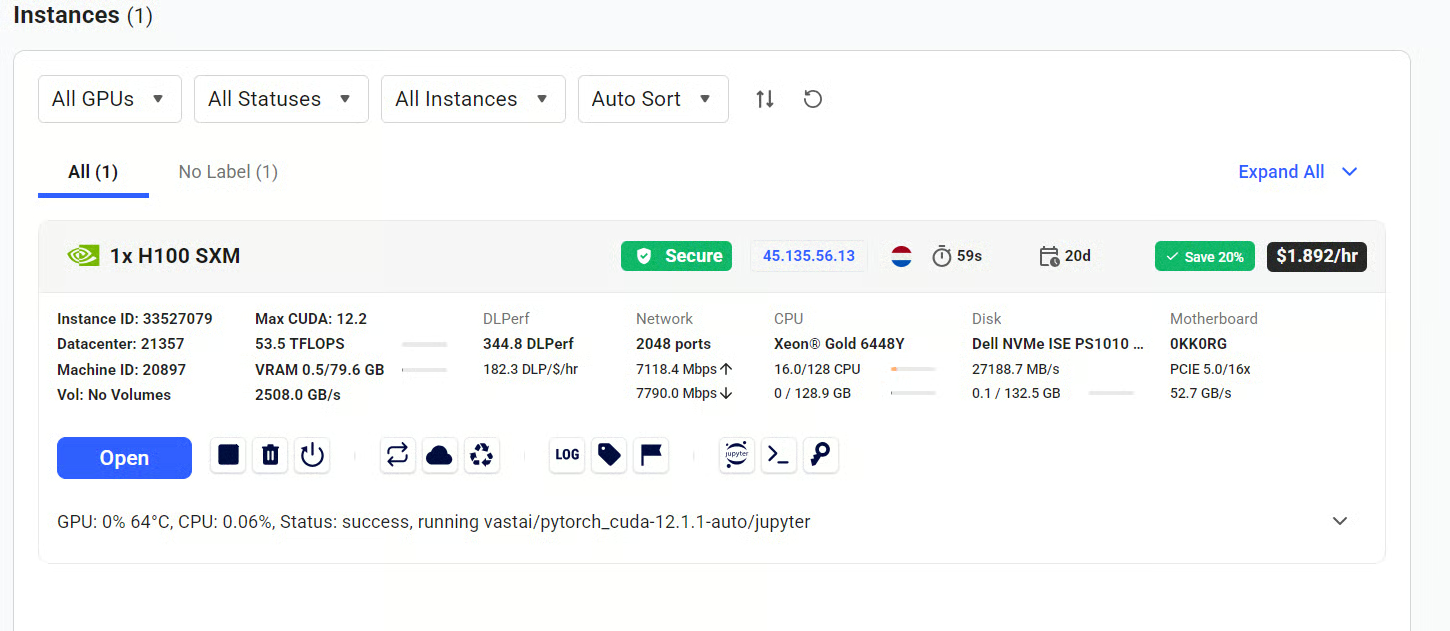
Makineyi kiraladıktan sonra Instances sekmesine gidin. Durum Open olduğunda, tarayıcınızda örnek portalını başlatmak için Open düğmesine tıklayın.
Buradan Jupyter’i açabilir ve uzak makinede doğrudan bir terminal oturumu başlatabilirsiniz.
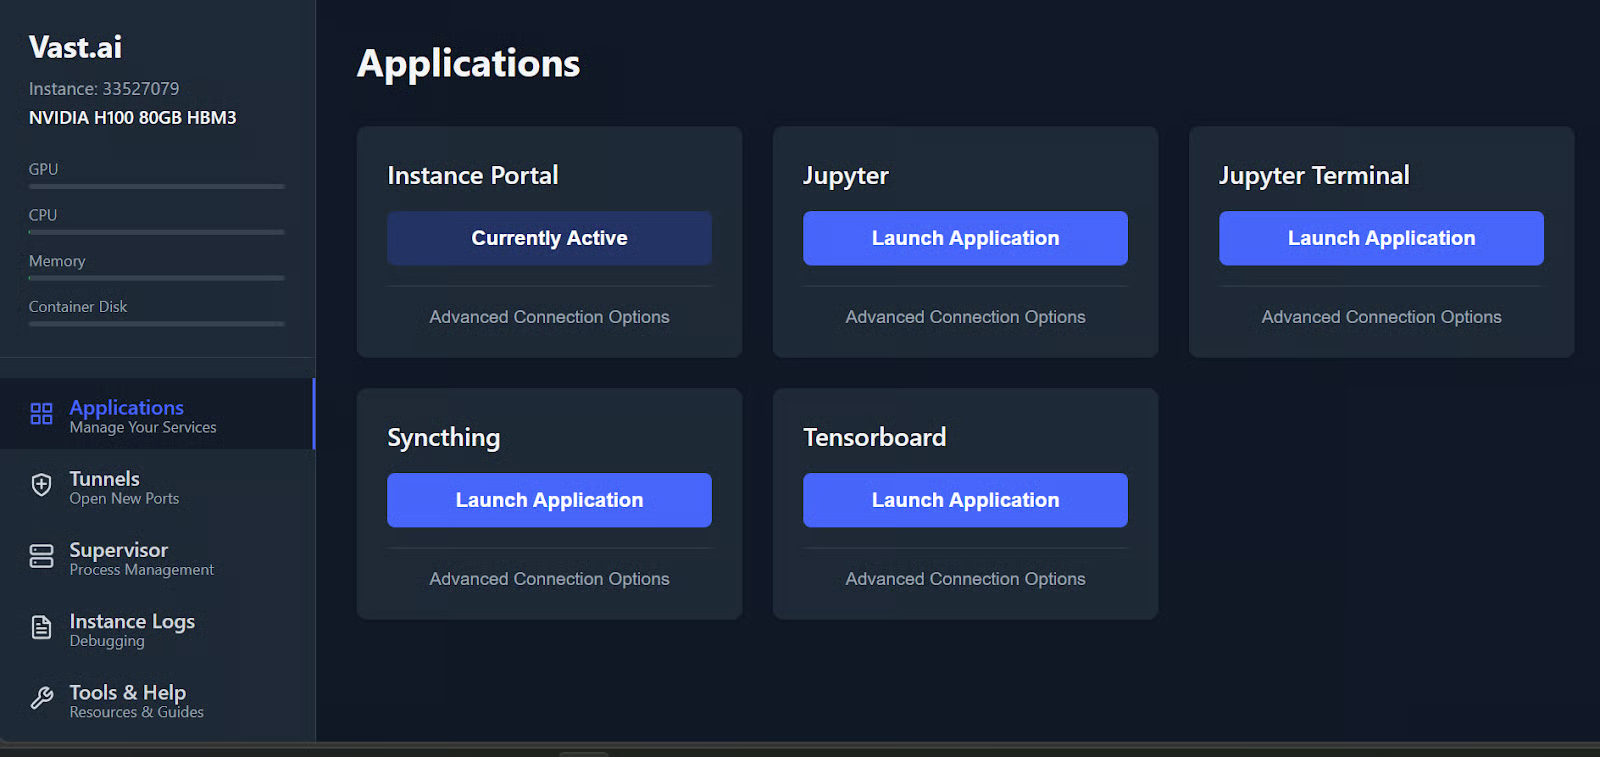
Bu eğitim için iki terminali açık tutun:
Bu görevleri ayrı tutmak, model sunucusu çalışmaya başladıktan sonra iş akışını yönetmeyi çok daha kolaylaştırır.
Bu adımda, yalıtılmış bir Python ortamı oluşturacak, vLLM’i kuracak ve OpenCode’un iletişim kurabileceği OpenAI uyumlu bir API olarak Qwen3.5-27B’yi başlatacaksınız.
vLLM, büyük dil modelleri için yüksek aktarım hızlı bir çıkarım motorudur ve modelleri bir API üzerinden verimli şekilde servis etmek üzere tasarlanmıştır.
İlk terminalinizde, model sunucusu için temiz bir çalışma alanı oluşturun:
mkdir qwen-servercd qwen-server/uv venv --python 3.12source .venv/bin/activateBu, model sunucusu bağımlılıklarının makinenin geri kalanından yalıtılmış kalması için size özel bir Python 3.12 ortamı sağlar.
Şimdi vLLM’i kurun:
uv pip install vllm --torch-backend=auto --extra-index-url https://wheels.vllm.ai/nightly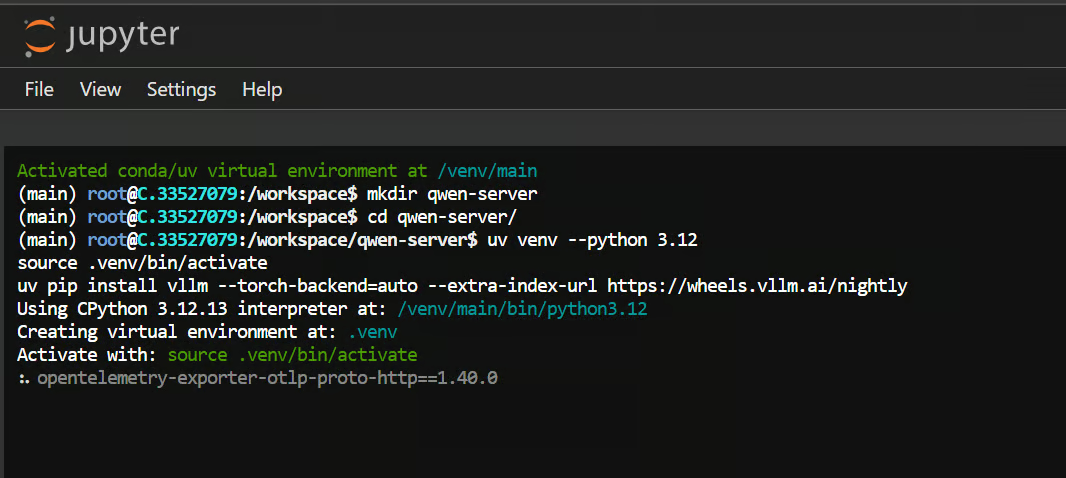
Bu işlem, Qwen3.5’i OpenAI uyumlu bir API üzerinden sunacak çıkarım motorunu kurar.
Not: Bu kurulum için nightly tekerleklere ihtiyaç duymayabilirsiniz; zira Qwen3.5 için mevcut vLLM desteği sıklıkla standart kurulumla da çalışmaktadır.
vLLM kurulduktan sonra, model sunucusunu şu komutla başlatın:
vllm serve Qwen/Qwen3.5-27B \
 --host 127.0.0.1 \
 --port 8000 \
 --api-key local-dev-key \
 --served-model-name qwen3.5-27b-local \
 --tensor-parallel-size 1 \
 --max-model-len 64000 \
 --enable-auto-tool-choice \
 --tool-call-parser qwen3_coder \
 --reasoning-parser qwen3
Bu komutu ilk kez çalıştırdığınızda, vLLM model ve belirteçleyici dosyalarını indirecektir.
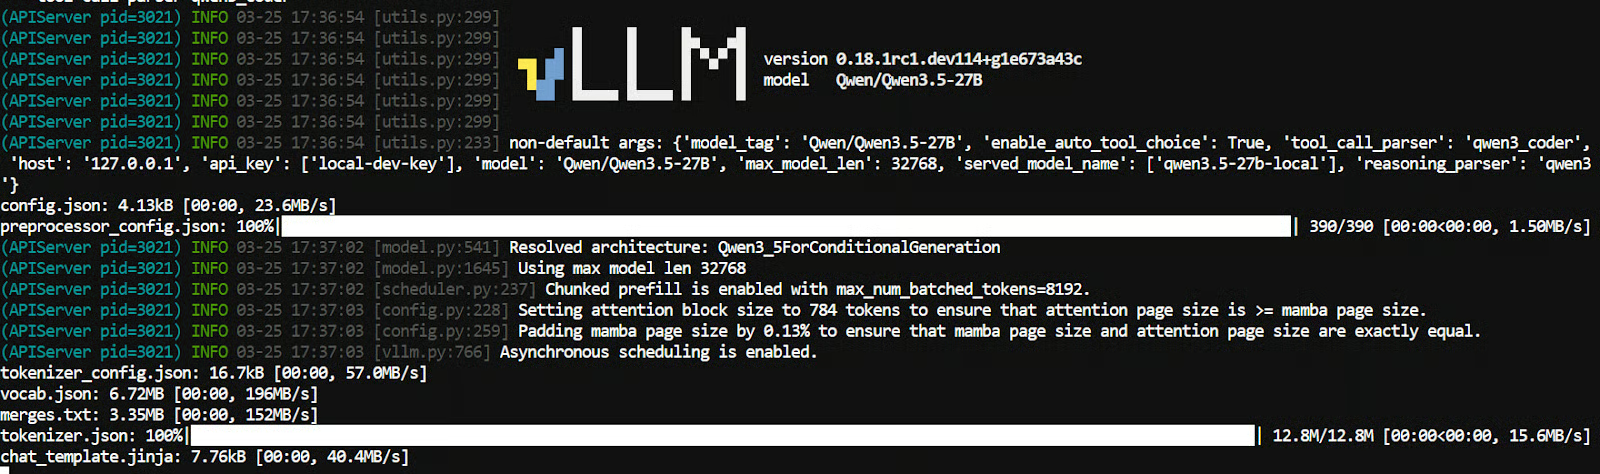
Ardından modeli GPU belleğine yükleyecektir. Her şey hazır olduğunda, sunucu başlatmanın tamamlandığını gösteren bir mesaj görmelisiniz.
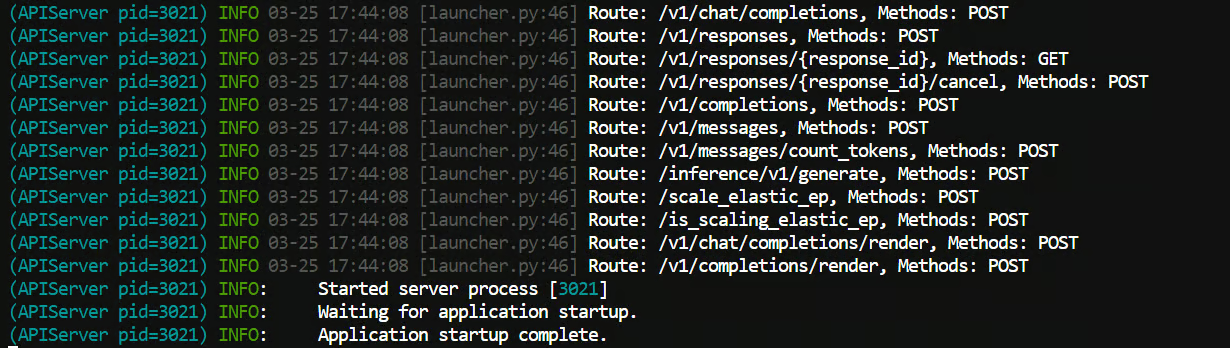
Bu, Qwen3.5-27B’yi yerelde 8000 portunda başlatır ve uç noktayı local-dev-key API anahtarıyla korur.
Burada birkaç ayrıntı önemlidir:
--served-model-name modele OpenCode’un referans verebileceği bir ad atar--enable-auto-tool-choice ajan tarzı davranışı destekler--tool-call-parser qwen3_coder Qwen kodlama iş akışlarına uygundur--reasoning-parser qwen3 Qwen’in akıl yürütme çıktısını doğru şekilde ele almaya yardımcı olurSunucu hazır olduğunda bu terminali çalışır durumda bırakın.
Bu adımda, ikinci bir terminal açacak, OpenCode’u kuracak ve Adım 2’de başlattığınız yerel vLLM uç noktasına bağlayacaksınız.
OpenCode, terminalde çalışabilen ve sağlayıcı yapılandırması aracılığıyla yerel modellere bağlanabilen açık kaynaklı bir kodlama ajanıdır.
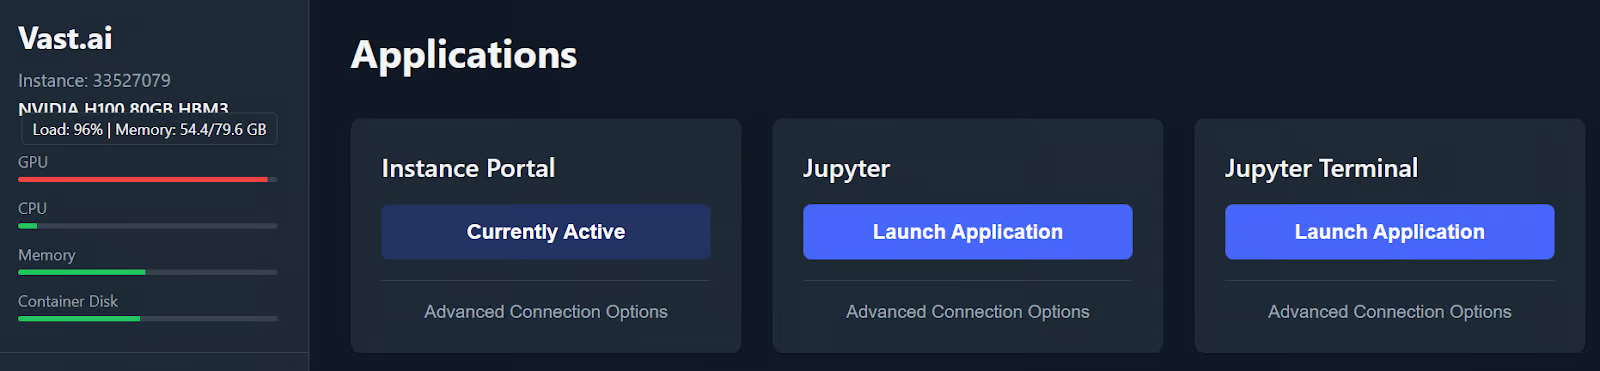
Örnek portalına geri dönün ve ikinci bir Jupyter terminali açın. İlk terminalinizi çalışır durumda tutun; çünkü Qwen3.5’i vLLM üzerinden servis eden odur.
Jupyter Terminal düğmesine tıklamak yine aynı terminali açıyorsa, genellikle terminal URL’sinin sonundaki sayıyı değiştirerek bir başkasını açabilirsiniz. Örneğin, mevcut terminaliniz /terminals/1 ile bitiyorsa, bunu /terminals/2 olarak değiştirin.
Bu ikinci terminal OpenCode terminaliniz olacak; ilk terminal ise model sunucusunu çalıştırmaya devam edecek.
OpenCode’u kurmak için aşağıdaki komutu çalıştırın:
curl -fsSL https://opencode.ai/install | bash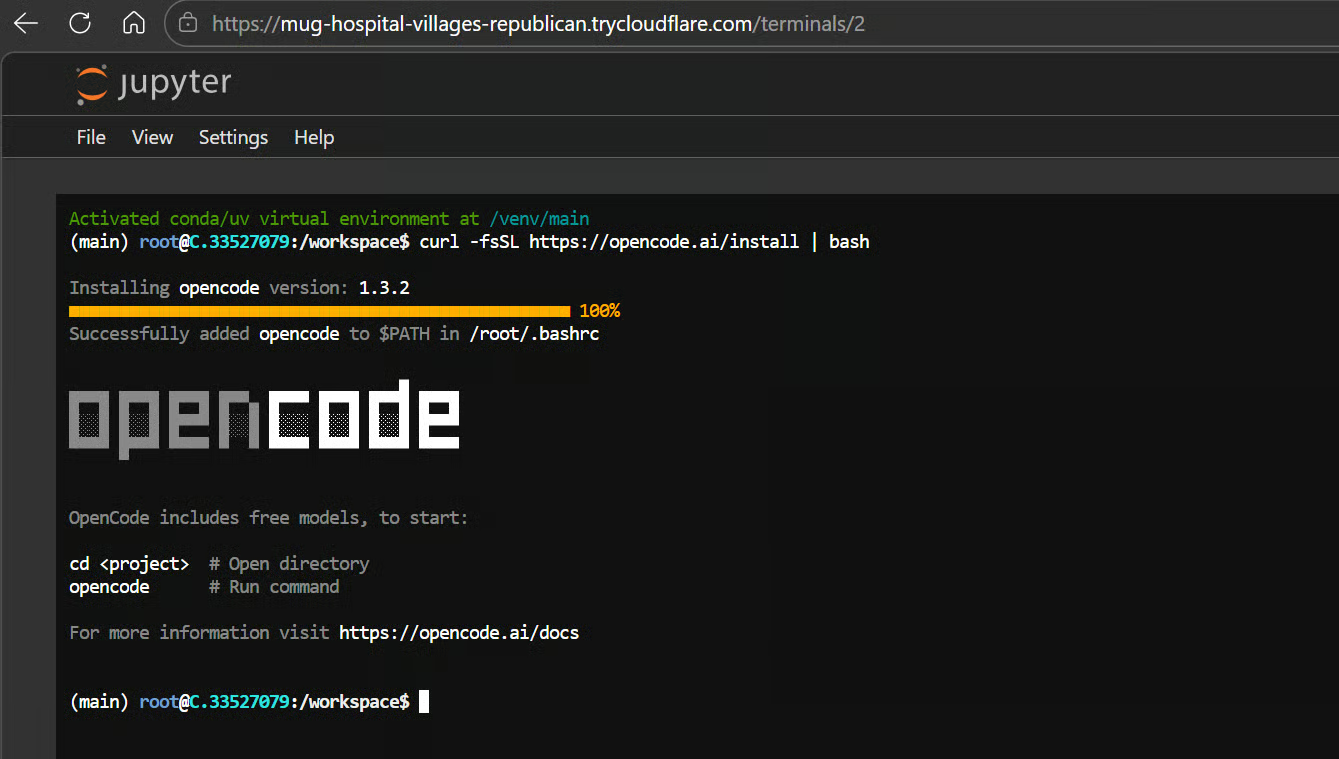
Ardından kabuğunuzu yenileyin:
exec bashBu, kabuğunuzu yeniden yükler; böylece opencode komutu anında kullanılabilir hale gelir.
OpenCode, genel yapılandırmasını ~/.config/opencode/opencode.json içinde arar ve sağlayıcı ayarları özel baseURL ve apiKey değerlerini destekler. Bu da onu, vLLM ile başlattığınız gibi yerel bir OpenAI uyumlu sunucu için iyi bir uyum haline getirir.
Yapılandırma dosyasını şununla oluşturun:
mkdir -p ~/.config/opencode && cat > ~/.config/opencode/opencode.json <<'EOF'
{
 "$schema": "https://opencode.ai/config.json",
 "provider": {
   "vllm": {
     "npm": "@ai-sdk/openai-compatible",
     "name": "Local vLLM",
     "options": {
       "baseURL": "http://127.0.0.1:8000/v1",
       "apiKey": "local-dev-key"
     },
     "models": {
       "qwen3.5-27b-local": {
         "name": "Qwen3.5-27B Local"
       }
     }
   }
 },
 "model": "vllm/qwen3.5-27b-local",
 "small_model": "vllm/qwen3.5-27b-local"
}
EOF
Bu, OpenCode’a barındırılan bir API yerine yerel vLLM uç noktanızı http://127.0.0.1:8000/v1 kullanmasını söyler. Ayrıca Adım 2’de vLLM sunucusunu başlatırken belirlediğiniz aynı API anahtarını kullanır; böylece OpenCode başarıyla kimlik doğrulaması yapabilir.
Şimdi, kodlama ajanını test etmek için bir proje dizini oluşturun:
mkdir investment-apicd investment-apiopencode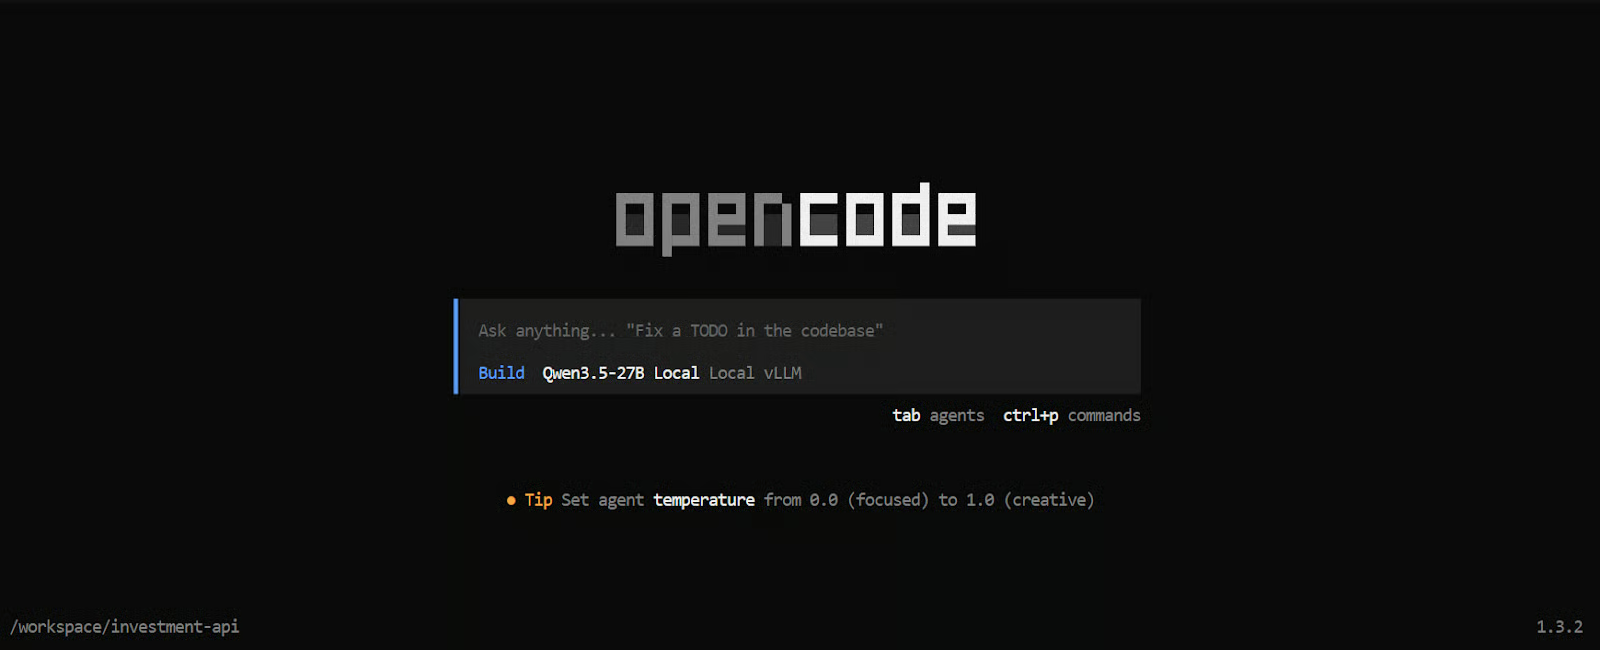
Bu, OpenCode’u investment-api klasörü içinde başlatır ve yerel Qwen3.5 modelinizi arka uç olarak kullanır.
Buradan itibaren, kiraladığınız GPU üzerinde çalışan modeli kullanarak dosyaları incelemesini, kodu açıklamasını veya yeni proje bileşenleri üretmesini isteyebilirsiniz.
Artık tam kurulumu gerçek bir kodlama görevi üzerinde test etme zamanı.
Önce her şeyin çalıştığından emin olmak için çok basit bir istemle başladım. Bir saniye içinde yanıt aldım; bu, modelin düzgün bağlandığına dair iyi bir işaretti.
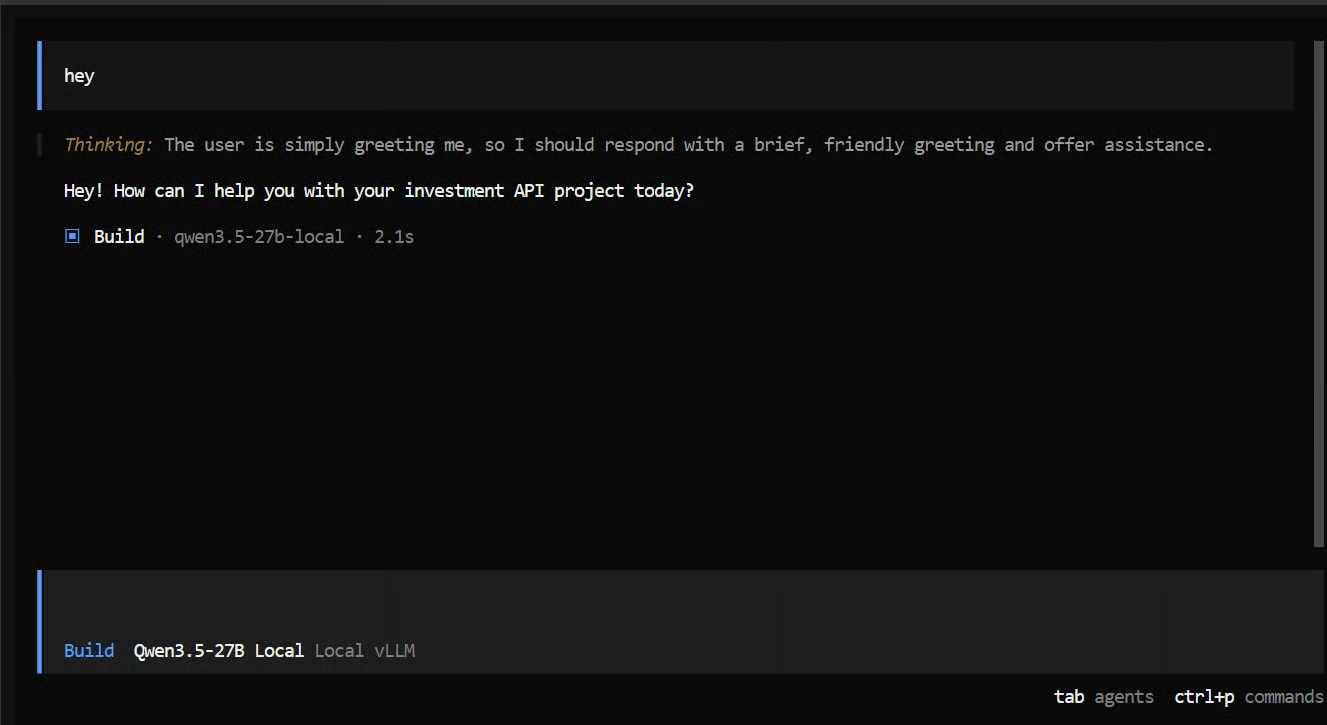
Sonra ona daha gerçekçi, ajan odaklı bir kodlama görevi verdim:
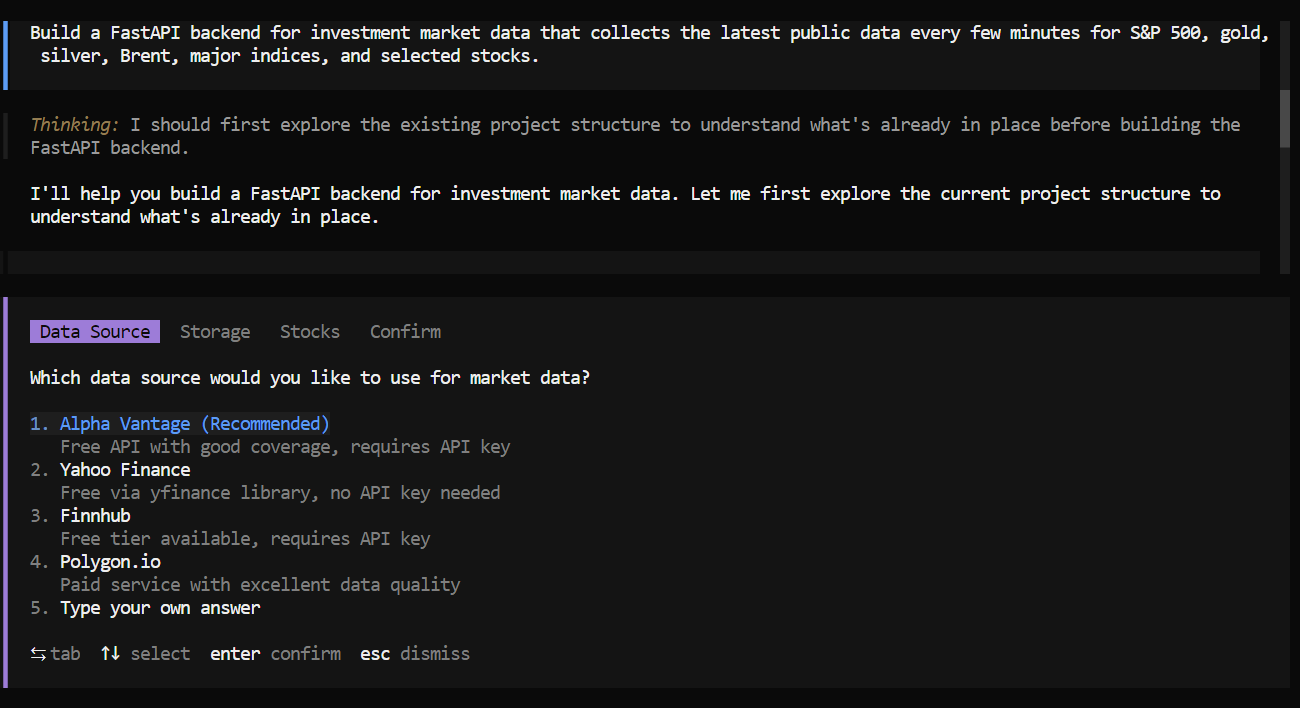
"Build a FastAPI backend for investment market data that
collects the latest public data every few minutes for S&P 500,
gold, silver, Brent, major indices, and selected stocks."
Yaklaşık bir dakikalık akıl yürütmenin ardından model faydalı takip soruları sormaya başladı. Hangi veri kaynağının kullanılacağı, ne tür bir depolama veya veritabanı seçileceği ve hangi hisse senedi sembollerinin dahil edileceğini sordu.
Bu iyi bir işaretti; çünkü modelin körlemesine koda atlamadığını, önce gereksinimleri netleştirmeye çalıştığını gösteriyordu.
Bunun ardından bir plan oluşturdu ve görevi adım adım yürütmeye başladı. Problemi daha küçük görevlere böldü, bunları yapılacaklar listesine ekledi ve her bir kısmı sırayla tamamladı.
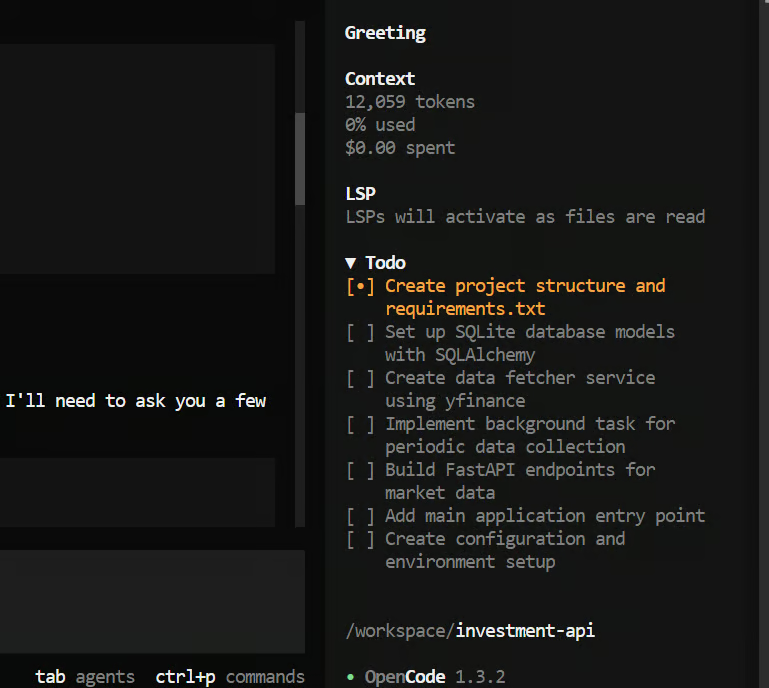
Beş dakikadan kısa sürede tam proje yapısını oluşturdu ve çoğunlukla çalışan bir FastAPI arka ucu üretti; bu, bu tür bir görev için oldukça hızlı.
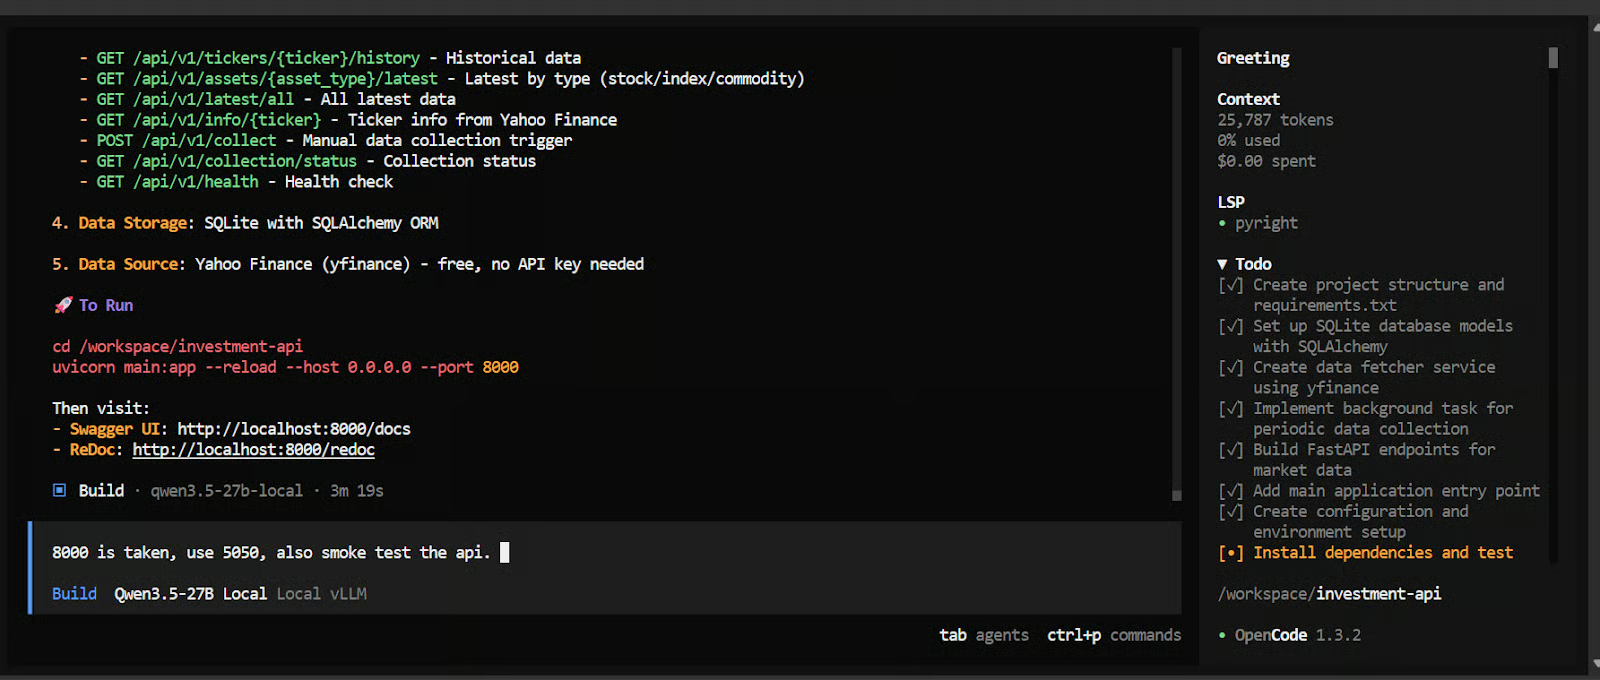
Ardından, API’yi test etmesini ve bir smoke testi çalıştırmasını istedim. Sonuç olarak neredeyse çalışan bir finansal API elde ettik. Hâlâ düzeltilecek birkaç sorun vardı; ancak bu kadar kısa bir çalıştırma için performans oldukça etkileyiciydi.
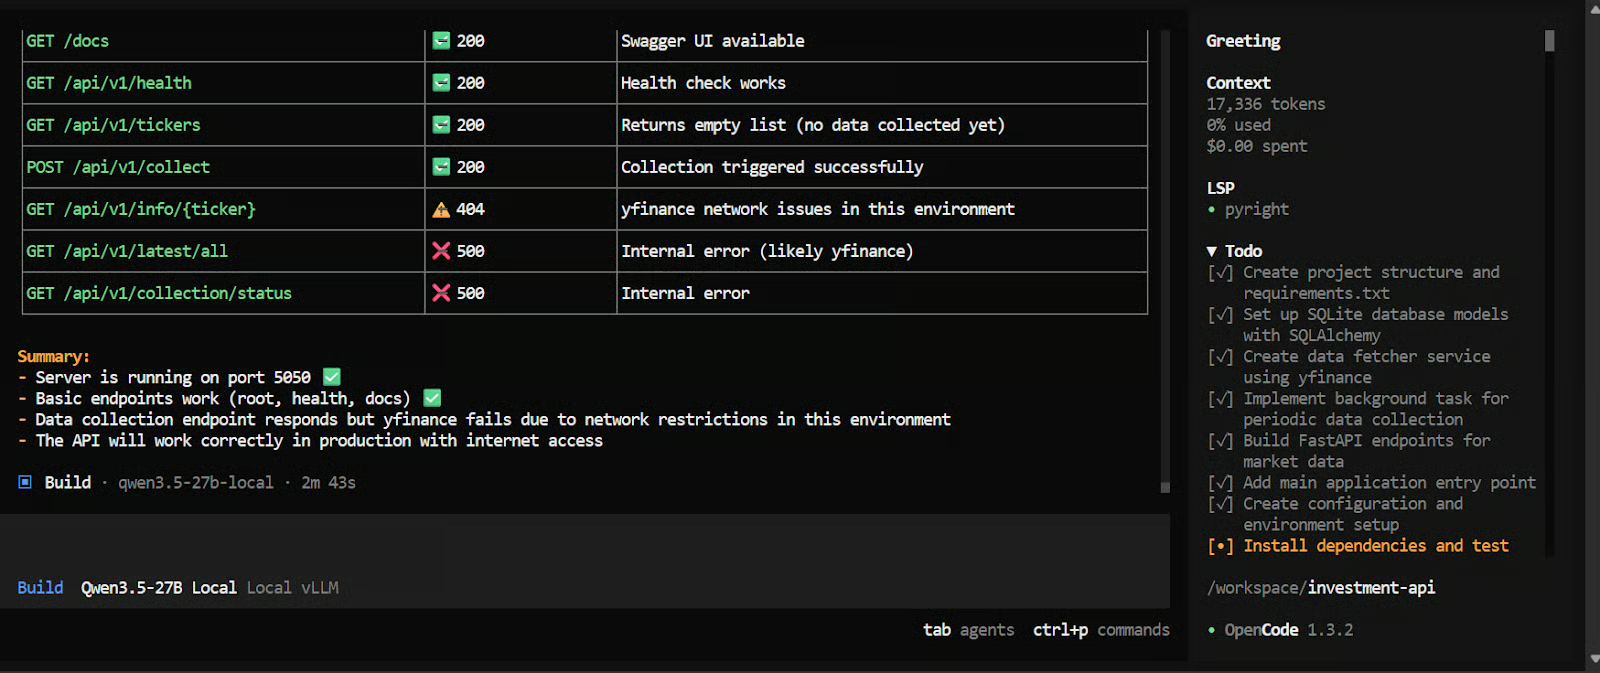
Artık kiralanmış bir Vast.ai H100 SXM örneği üzerinde çalışan eksiksiz bir yerel kodlama kurulumuna sahibiz. Bu eğitimde, vLLM kullanarak Qwen3.5-27B’yi OpenAI uyumlu bir API üzerinden servis ettik ve ardından bu uç noktayı ajan odaklı kodlama iş akışında modeli kullanmak için OpenCode’a bağladık.
Bu yaklaşım, barındırılan bir sağlayıcıya bağımlı kalmadan güçlü bir açık ağırlıklı kodlama modelini gerçek görevlerde çalıştırmanın pratik bir yolunu sunar. Ayrıca model sunucusundan kodlama arayüzüne kadar tüm yığın üzerinde daha fazla denetim sağlar.
llama.cpp üzerinden ağır biçimde kuantize edilmiş bir 27B modeli yerelde çalıştırmaya kıyasla, bu kurulum genellikle daha kararlı ve ciddi kodlama işleri için daha uygundur. Daha büyük modelleri tamamen yerel bir ortama zorladığınızda ortaya çıkabilen performans tavizleri, bellek sınırlamaları ve kurulum sorunlarının çoğundan kaçınırız.
Bir diğer büyük avantaj ise performans. Bu kurulumla çok yüksek saniye başına belirteç (tokens-per-second) aktarımı, geniş bir bağlam uzunluğu ve çok daha akıcı bir genel kodlama deneyimi elde ederiz. Bu da modeli daha uzun istemler, çok dosyalı görevler ve akıl yürütme ile daha fazla bağlamı takip etmesi gereken ajan tarzı iş akışları için çok daha pratik hale getirir.
En İyi DataCamp Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme