
कोर्स
डेवलपर्स के लिए AI-असिस्टेड कोडिंग
1 घंटा 30 मिनट
10.7K
इस ट्यूटोरियल में, आप Vast.ai पर एक रिमोट H100 SXM इंस्टेंस सेट करेंगे, Qwen3.5-27B को vLLM के साथ सर्व करेंगे, उसे OpenCode से जोड़ेंगे, और एक वास्तविक FastAPI प्रोजेक्ट पर इसकी एजेंटिक कोडिंग क्षमता का परीक्षण करेंगे।
हमने जानबूझकर यहाँ नहीं लिया है llama.cpp का उपयोग। भले ही llama.cpp कई लोकल इन्फरेंस सेटअप के लिए बेहतरीन है, लेकिन इसके जरिए एक क्वांटाइज़्ड 27B मॉडल चलाने पर अक्सर समझौते करने पड़ते हैं: आउटपुट गुणवत्ता कम होना, कोडिंग प्रदर्शन में गिरावट, और सेटअप में ज्यादा रुकावटें।
Qwen3.5-27B जैसे बड़े मॉडलों के लिए, क्वांटाइज़ेशन विश्वसनीयता पर ध्यान देने योग्य असर डाल सकता है, और यदि आप स्मूद, प्रोडक्शन-जैसा एजेंट व्यवहार चाहते हैं तो llama.cpp के जरिए लोकल डिप्लॉयमेंट मैनेज करना कठिन हो सकता है।
इसके बजाय, यह ट्यूटोरियल vLLM का उपयोग किराए पर लिए गए H100 SXM GPU पर करता है। इससे आपको अधिक स्थिर OpenAI-कम्पैटिबल एंडपॉइंट, पूरे मॉडल से बेहतर प्रदर्शन, और एजेंटिक कोडिंग वर्कफ़्लो के लिए बहुत साफ-सुथरा सेटअप मिलता है।
आप हमारे अलग गाइड में देख सकते हैं कि Qwen3.5-397B-A17B को लोकली कैसे चलाएँ.
शुरू करने से पहले, सुनिश्चित करें कि आपके पास यह है:
इस सेटअप के लिए H100 SXM एक मजबूत विकल्प है, क्योंकि Qwen3.5-27B को भरपूर मेमोरी और तेज थ्रूपुट की ज़रूरत पड़ती है—खासकर लंबे कॉन्टेक्स्ट विंडोज़ और अधिक स्मूद, कोडिंग-केंद्रित इन्फरेंस के लिए।
हम Vast.ai का उपयोग कर रहे हैं क्योंकि यह एक GPU मार्केटप्लेस है जो आम तौर पर एक पारंपरिक सिंगल-वेंडर क्लाउड की तुलना में कीमत और हार्डवेयर पर आपको कहीं अधिक लचीलापन देता है।
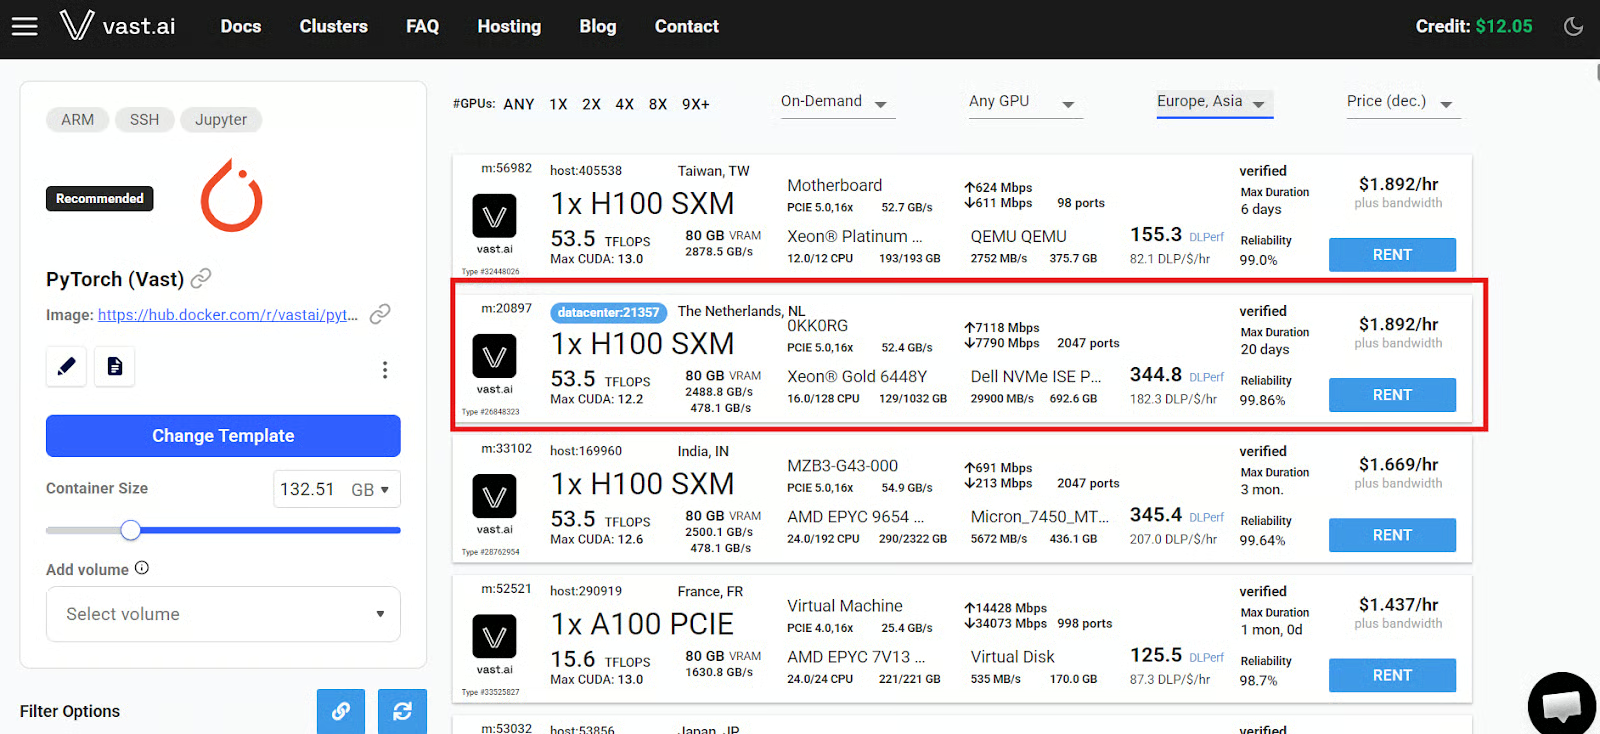
आप कम्युनिटी-होस्टेड मशीनों से लेकर Secure Cloud / डाटासेंटर ऑफ़र तक कुछ भी किराए पर ले सकते हैं, जिन्हें Vast एक नीले डाटासेंटर लेबल से चिह्नित करता है। ऐसे सेटअप के लिए, मैं बेहतर विश्वसनीयता और स्मूद अनुभव हेतु उन्हीं नीले-लेबल वाले डाटासेंटर मशीनों में से एक चुनने की कड़ी सलाह देता हूँ।
शुरू में Vast.ai खाता बनाएँ और अपने सत्र को कवर करने के लिए पर्याप्त क्रेडिट जोड़ें। फिर सर्च पेज खोलें, Jupyter सक्षम वाले PyTorch टेम्पलेट को चुनें, और 1x H100 SXM ऑफ़र खोजें।
Vast.ai पर कीमतें एक लाइव मार्केटप्लेस होने के कारण लगातार बदलती रहती हैं, इसलिए किसी भी प्रति घंटा रेट को फिक्स्ड की बजाय अनुमानित मानें।
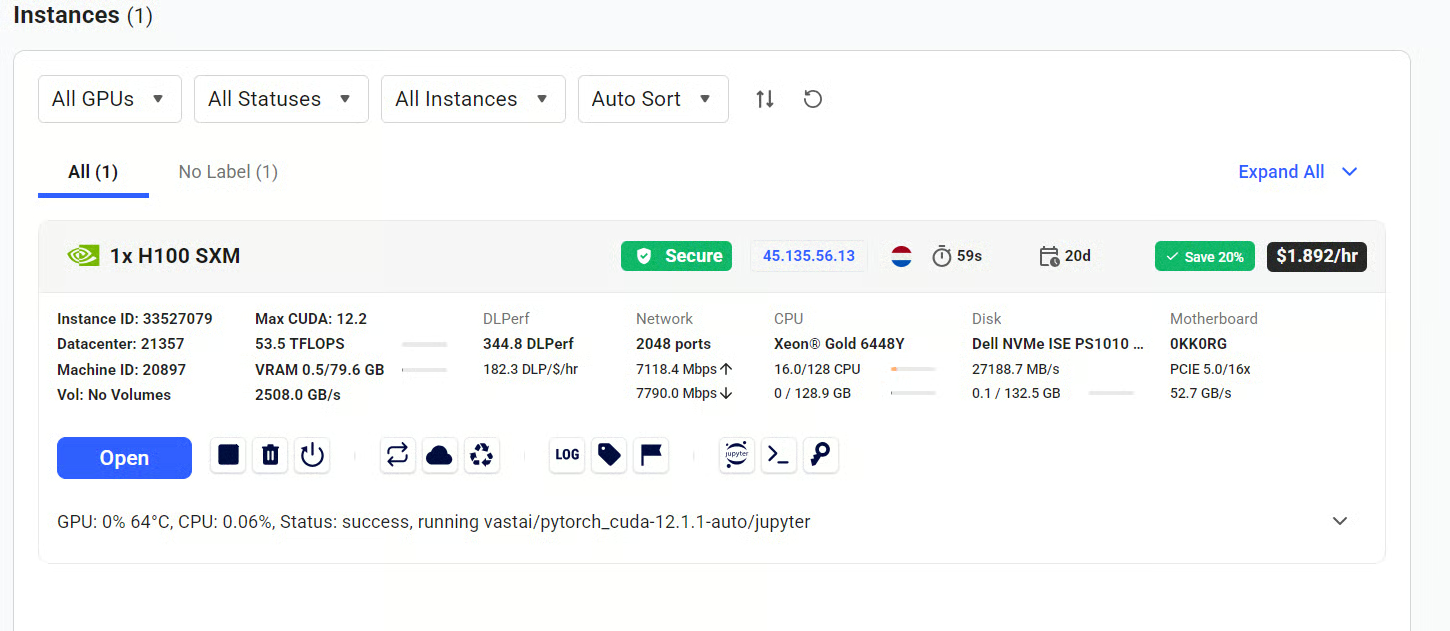
मशीन किराए पर लेने के बाद, Instances टैब पर जाएँ। जब स्टेटस Open में बदल जाए, तो ब्राउज़र में इंस्टेंस पोर्टल खोलने के लिए Open बटन पर क्लिक करें।
यहाँ से आप Jupyter खोल सकते हैं और सीधे रिमोट मशीन पर एक टर्मिनल सत्र शुरू कर सकते हैं।
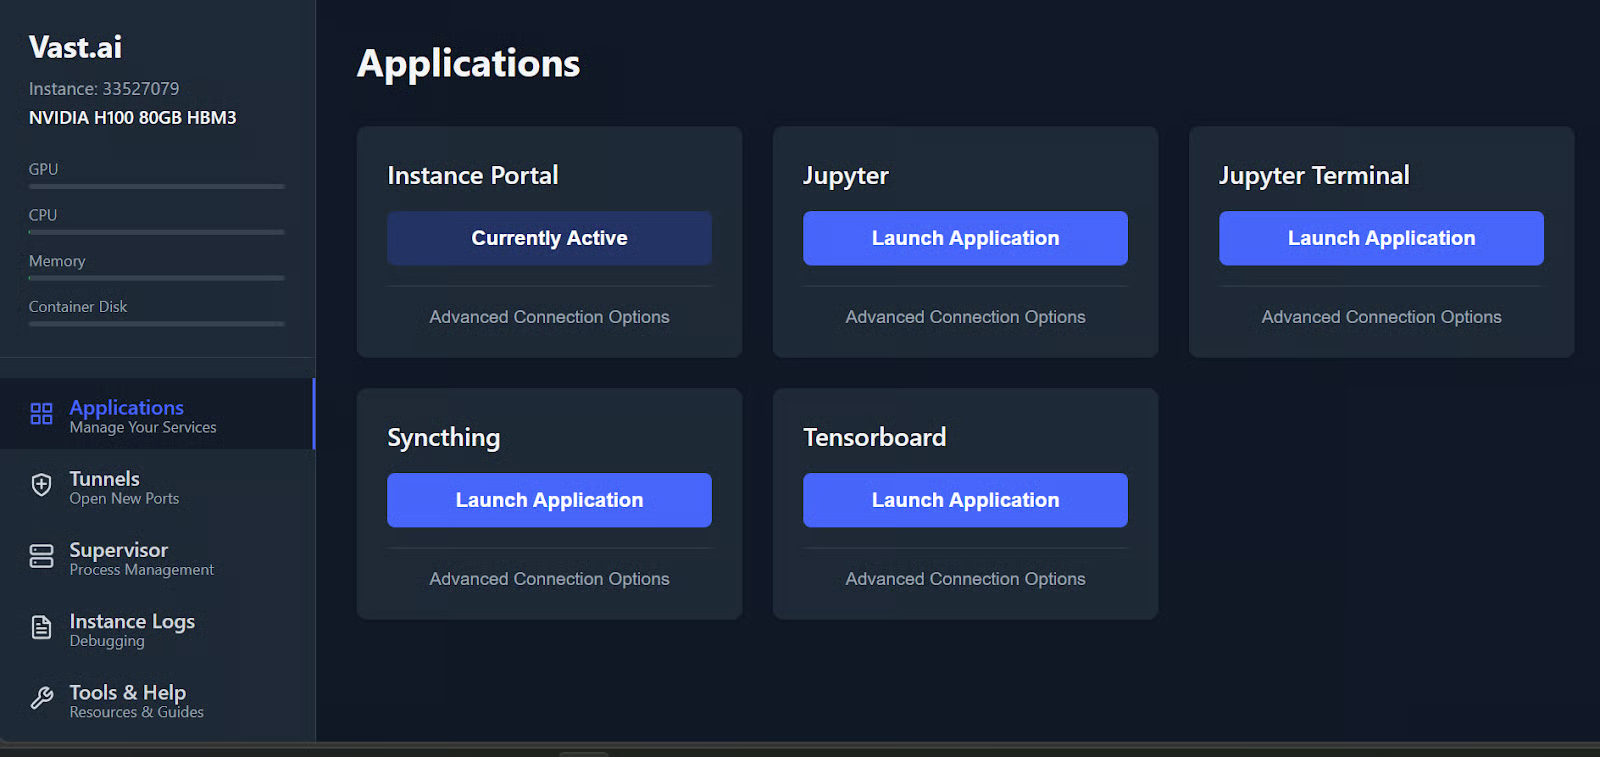
इस ट्यूटोरियल के लिए, दो टर्मिनल खुले रखें:
इन कार्यों को अलग-अलग रखने से, एक बार मॉडल सर्वर चलने पर वर्कफ़्लो मैनेज करना काफी आसान हो जाता है।
इस चरण में, आप एक आइसोलेटेड Python एनवायरनमेंट बनाएँगे, vLLM इंस्टॉल करेंगे, और Qwen3.5-27B को एक OpenAI-कम्पैटिबल API के रूप में लॉन्च करेंगे, जिससे OpenCode संवाद कर सके।
vLLM बड़े भाषा मॉडलों के लिए एक हाई-थ्रूपुट इन्फरेंस इंजन है, जिसे API के माध्यम से मॉडलों को कुशलतापूर्वक सर्व करने के लिए बनाया गया है।
अपने पहले टर्मिनल में, मॉडल सर्वर के लिए एक क्लीन वर्कस्पेस बनाएँ:
mkdir qwen-servercd qwen-server/uv venv --python 3.12source .venv/bin/activateयह आपको समर्पित Python 3.12 एनवायरनमेंट देता है, ताकि मॉडल सर्वर की डिपेंडेंसीज़ मशीन के बाकी हिस्सों से अलग रहें।
अब vLLM इंस्टॉल करें:
uv pip install vllm --torch-backend=auto --extra-index-url https://wheels.vllm.ai/nightly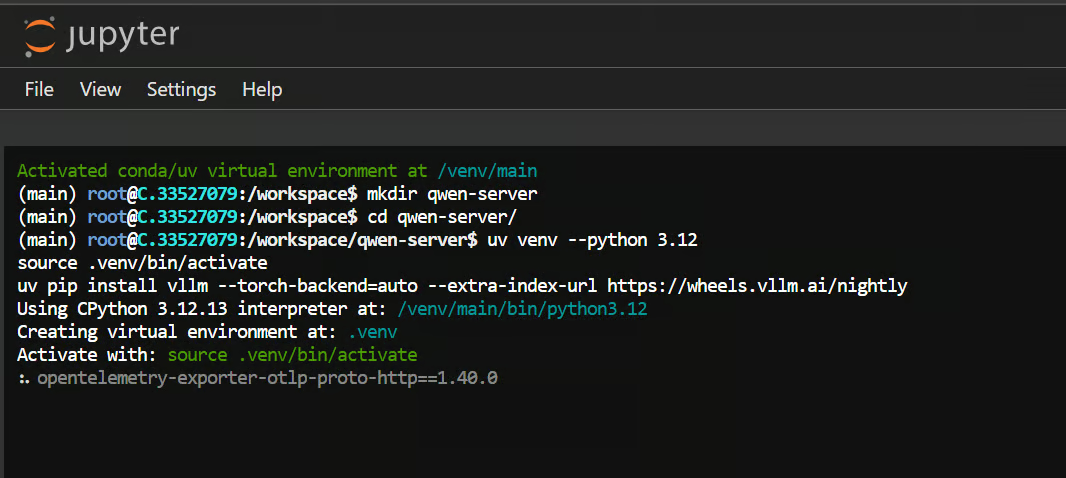
यह वह इन्फरेंस इंजन इंस्टॉल करता है जो Qwen3.5 को OpenAI-कम्पैटिबल API के जरिए एक्सपोज़ करेगा।
नोट: इस सेटअप के लिए आपको नाइटली व्हील्स की ज़रूरत नहीं भी पड़ सकती है, क्योंकि Qwen3.5 के लिए मौजूदा vLLM सपोर्ट अक्सर स्टैंडर्ड इंस्टॉलेशन के साथ भी काम करता है।
vLLM इंस्टॉल हो जाने के बाद, मॉडल सर्वर इस कमांड से शुरू करें:
vllm serve Qwen/Qwen3.5-27B \
 --host 127.0.0.1 \
 --port 8000 \
 --api-key local-dev-key \
 --served-model-name qwen3.5-27b-local \
 --tensor-parallel-size 1 \
 --max-model-len 64000 \
 --enable-auto-tool-choice \
 --tool-call-parser qwen3_coder \
 --reasoning-parser qwen3
पहली बार यह कमांड चलाने पर, vLLM मॉडल और टोकनाइज़र फ़ाइलें डाउनलोड करेगा।
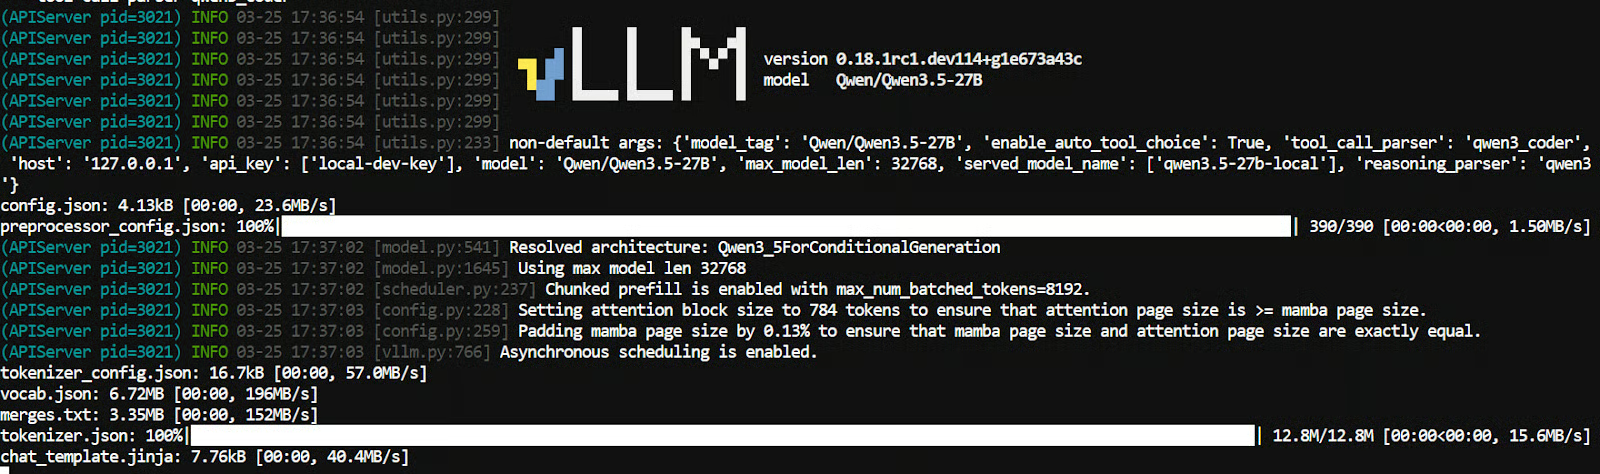
उसके बाद, यह मॉडल को GPU मेमोरी में लोड करेगा। सब तैयार हो जाने पर, आपको सर्वर स्टार्टअप पूरा होने का संदेश दिखेगा।
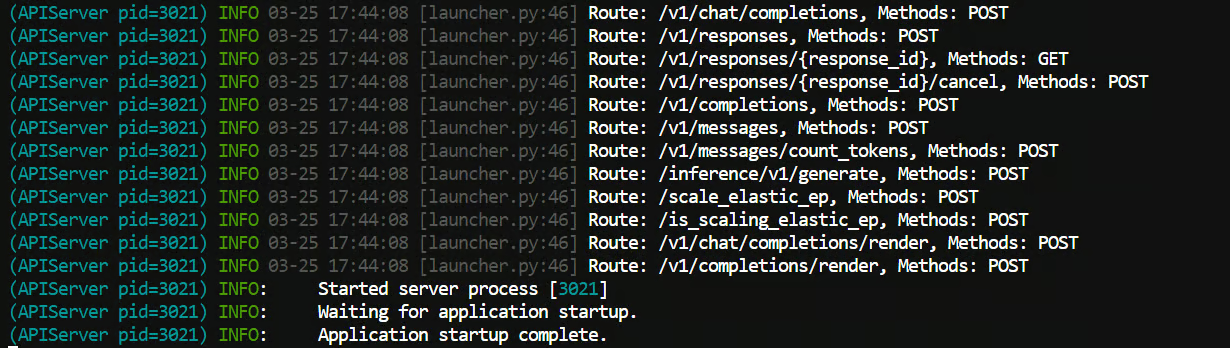
यह Qwen3.5-27B को लोकली पोर्ट 8000 पर लॉन्च करता है और एंडपॉइंट को API key local-dev-key से सुरक्षित करता है।
यहाँ कुछ विवरण अहम हैं:
--served-model-name मॉडल को वह नाम देता है जिसे OpenCode रेफर कर सके--enable-auto-tool-choice एजेंट-स्टाइल व्यवहार को सपोर्ट करता है--tool-call-parser qwen3_coder Qwen की कोडिंग वर्कफ़्लोज़ के लिए उपयुक्त है--reasoning-parser qwen3 Qwen के रीज़निंग आउटपुट को ठीक से संभालने में मदद करता हैसर्वर तैयार होने के बाद यह टर्मिनल चलता रहने दें।
इस चरण में, आप दूसरा टर्मिनल खोलेंगे, OpenCode इंस्टॉल करेंगे, और उसे स्टेप 2 में शुरू किए गए लोकल vLLM एंडपॉइंट से जोड़ेंगे।
OpenCode एक ओपन-सोर्स कोडिंग एजेंट है जो टर्मिनल में चल सकता है और अपने प्रोवाइडर कॉन्फ़िगरेशन के जरिए लोकल मॉडलों से कनेक्ट हो सकता है।
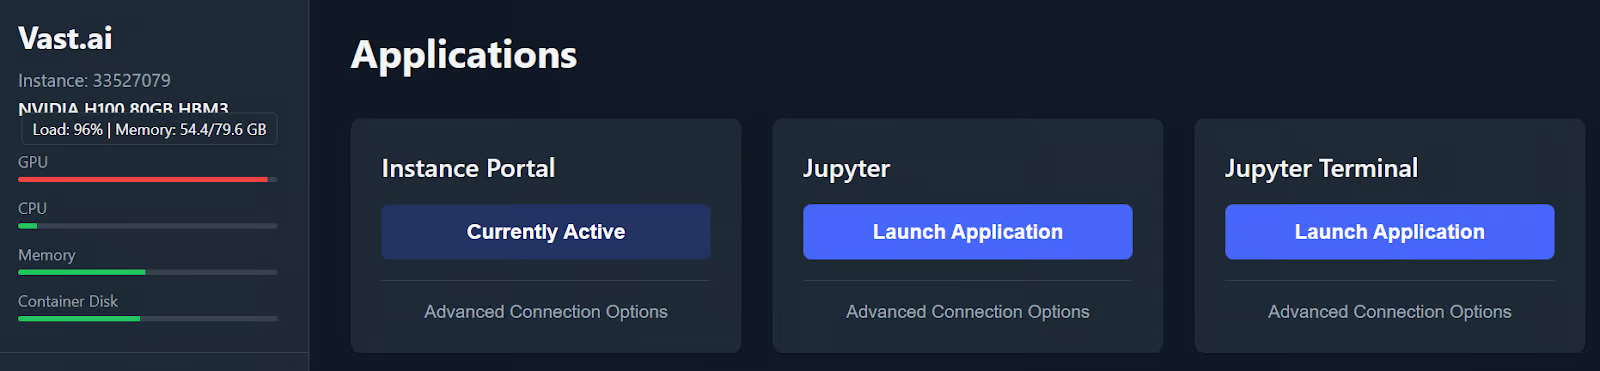
इंस्टेंस पोर्टल पर वापस जाएँ और दूसरा Jupyter टर्मिनल खोलें। अपना पहला टर्मिनल चालू रखें, क्योंकि वही vLLM के जरिए Qwen3.5 को सर्व कर रहा है।
यदि Jupyter Terminal बटन पर क्लिक करने से वही टर्मिनल फिर खुल जाता है, तो आप आम तौर पर टर्मिनल URL के अंत में संख्या बदलकर दूसरा टर्मिनल खोल सकते हैं। उदाहरण के लिए, यदि आपका मौजूदा टर्मिनल /terminals/1 पर समाप्त होता है, तो उसे /terminals/2 कर दें।
यह दूसरा टर्मिनल आपका OpenCode टर्मिनल होगा, जबकि पहला टर्मिनल मॉडल सर्वर चलाता रहेगा।
OpenCode इंस्टॉल करने के लिए निम्न कमांड चलाएँ:
curl -fsSL https://opencode.ai/install | bash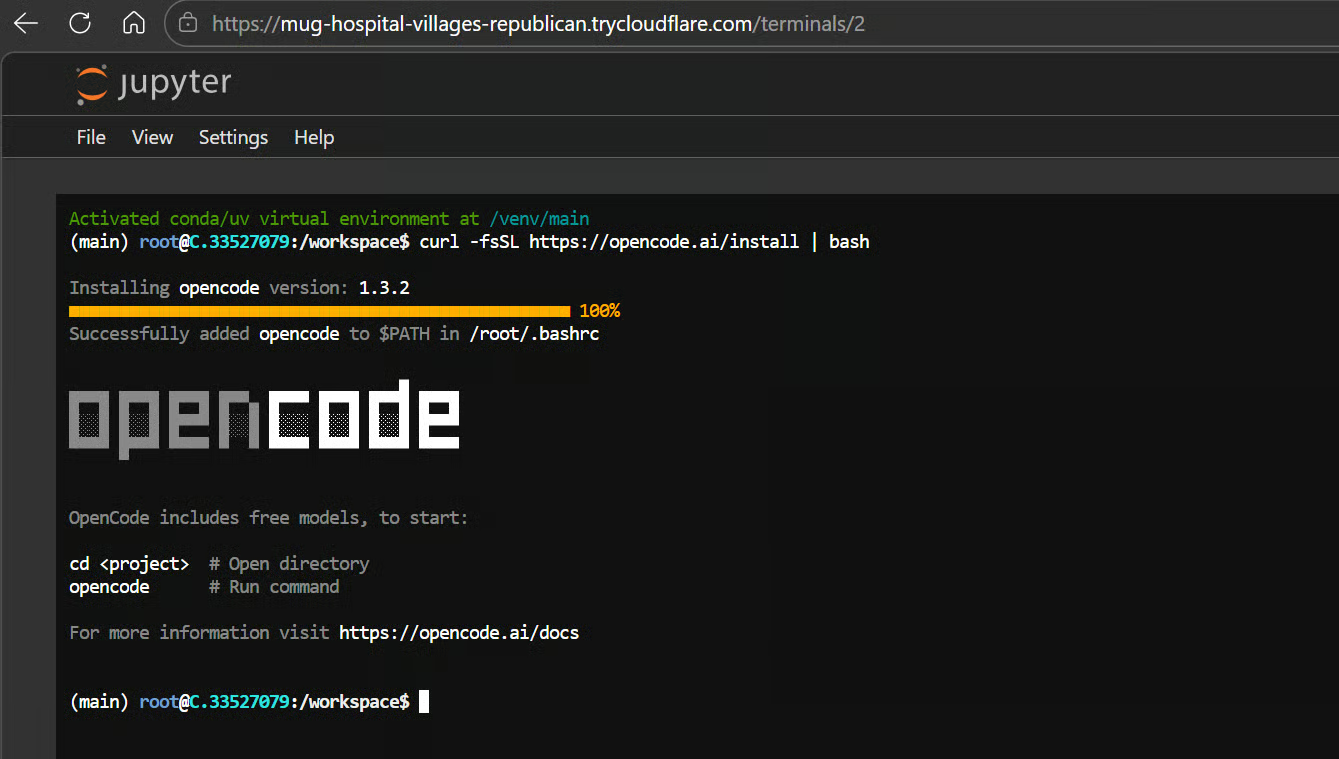
फिर अपना शेल रिफ्रेश करें:
exec bashयह आपका शेल रीलोड कर देता है, ताकि opencode कमांड तुरंत उपलब्ध हो जाए।
OpenCode अपनी ग्लोबल कॉन्फ़िग को ~/.config/opencode/opencode.json में देखता है, और इसके प्रोवाइडर सेटिंग्स कस्टम baseURL और apiKey वैल्यू सपोर्ट करती हैं। इससे यह आपके द्वारा vLLM से लॉन्च किए गए जैसे लोकल OpenAI-कम्पैटिबल सर्वर के लिए उपयुक्त बनता है।
यह कॉन्फ़िग फाइल बनाएँ:
mkdir -p ~/.config/opencode && cat > ~/.config/opencode/opencode.json <<'EOF'
{
 "$schema": "https://opencode.ai/config.json",
 "provider": {
   "vllm": {
     "npm": "@ai-sdk/openai-compatible",
     "name": "Local vLLM",
     "options": {
       "baseURL": "http://127.0.0.1:8000/v1",
       "apiKey": "local-dev-key"
     },
     "models": {
       "qwen3.5-27b-local": {
         "name": "Qwen3.5-27B Local"
       }
     }
   }
 },
 "model": "vllm/qwen3.5-27b-local",
 "small_model": "vllm/qwen3.5-27b-local"
}
EOF
यह OpenCode को आपके लोकल vLLM एंडपॉइंट http://127.0.0.1:8000/v1 का उपयोग करने को कहता है, किसी होस्टेड API के बजाय। यह वही API key उपयोग करता है जो आपने स्टेप 2 में vLLM सर्वर लॉन्च करते समय सेट की थी, ताकि OpenCode सफलतापूर्वक प्रमाणीकृत हो सके।
अब, कोडिंग एजेंट के परीक्षण के लिए एक प्रोजेक्ट डायरेक्टरी बनाएँ:
mkdir investment-apicd investment-apiopencode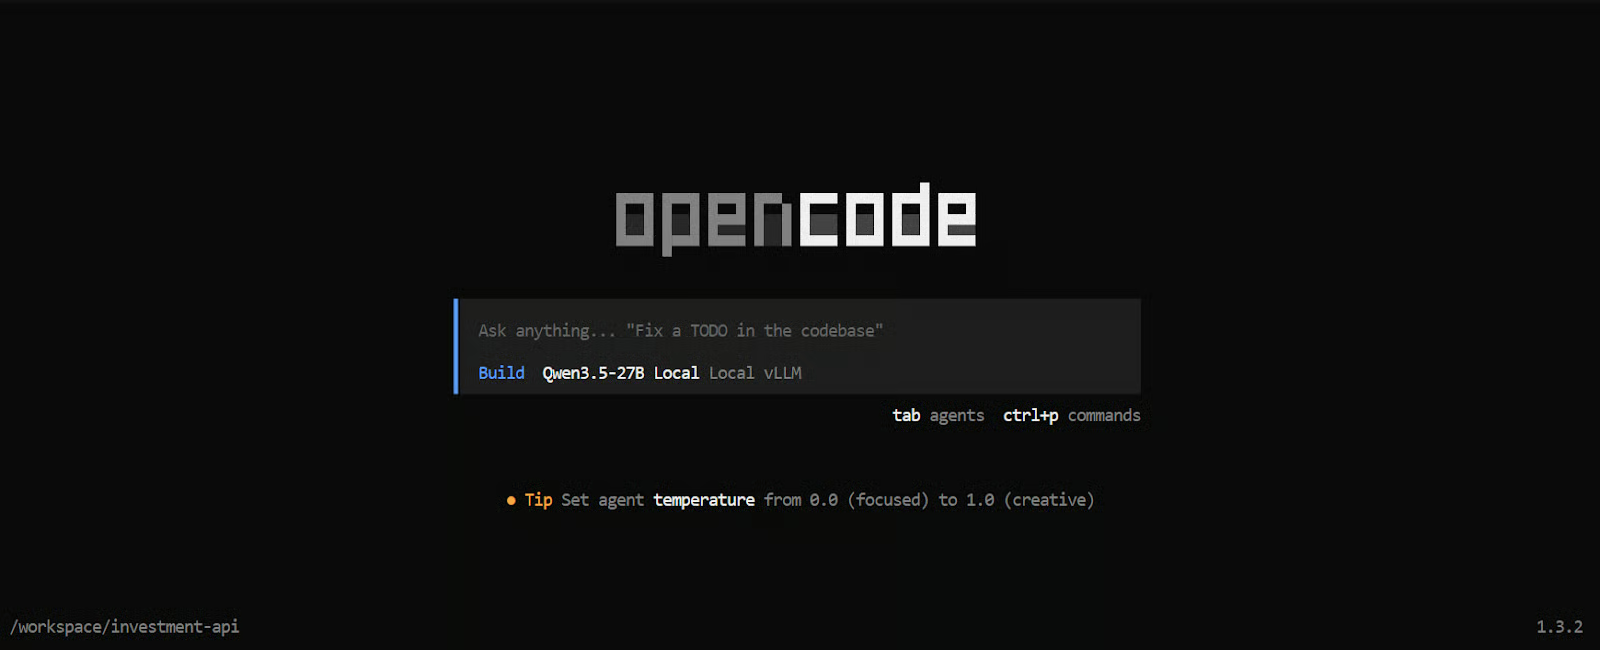
यह investment-api फ़ोल्डर के अंदर OpenCode लॉन्च करता है और आपके लोकल Qwen3.5 मॉडल को इसके बैकएंड के रूप में उपयोग करता है।
यहाँ से, आप इसे फ़ाइलों का निरीक्षण करने, कोड समझाने, या अपने किराए के GPU पर चल रहे मॉडल का उपयोग करके नए प्रोजेक्ट घटक जनरेट करने के लिए कहना शुरू कर सकते हैं।
अब पूरे सेटअप को एक वास्तविक कोडिंग टास्क पर परखने का समय है।
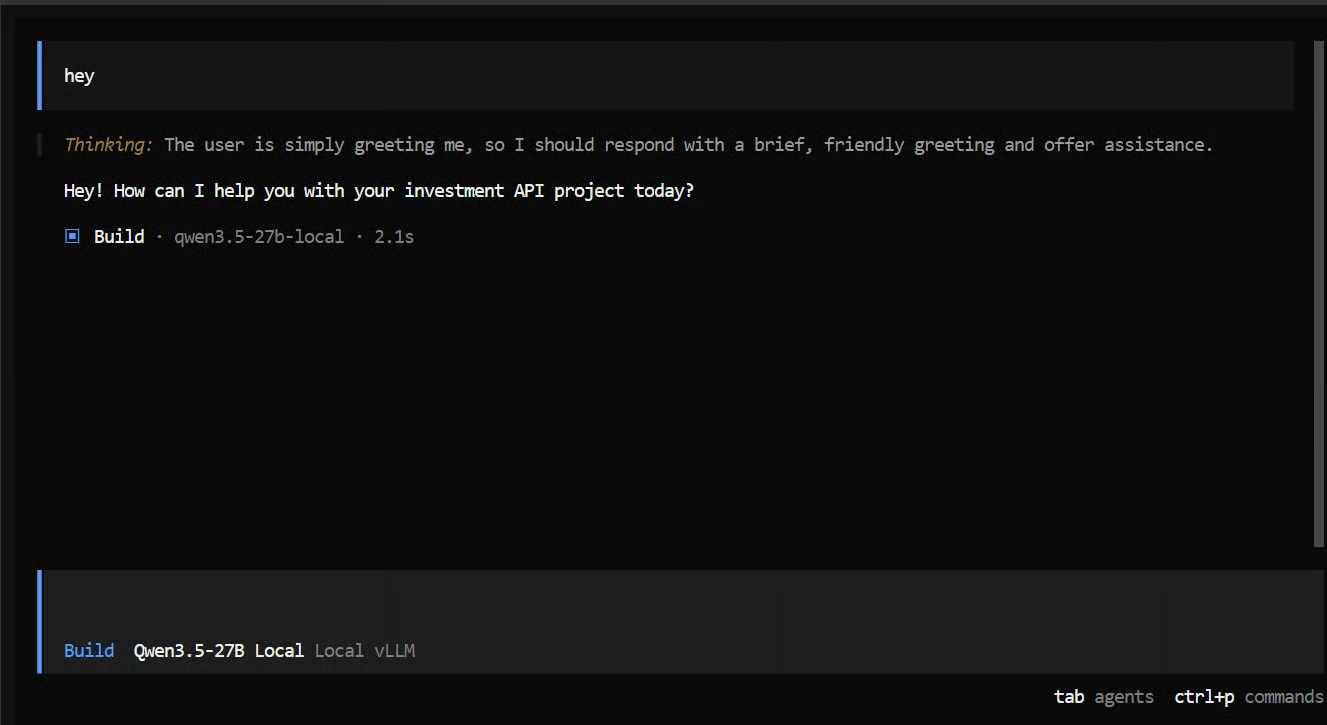
मैंने पहले बहुत साधारण प्रॉम्प्ट से शुरुआत की ताकि यह सुनिश्चित किया जा सके कि सब कुछ काम कर रहा है। एक सेकंड के भीतर जवाब मिल गया—यह अच्छा संकेत था कि मॉडल सही तरह से कनेक्टेड है।
इसके बाद, मैंने इसे एक अधिक यथार्थवादी एजेंटिक कोडिंग टास्क दिया:
"Build a FastAPI backend for investment market data that
collects the latest public data every few minutes for S&P 500,
gold, silver, Brent, major indices, and selected stocks."
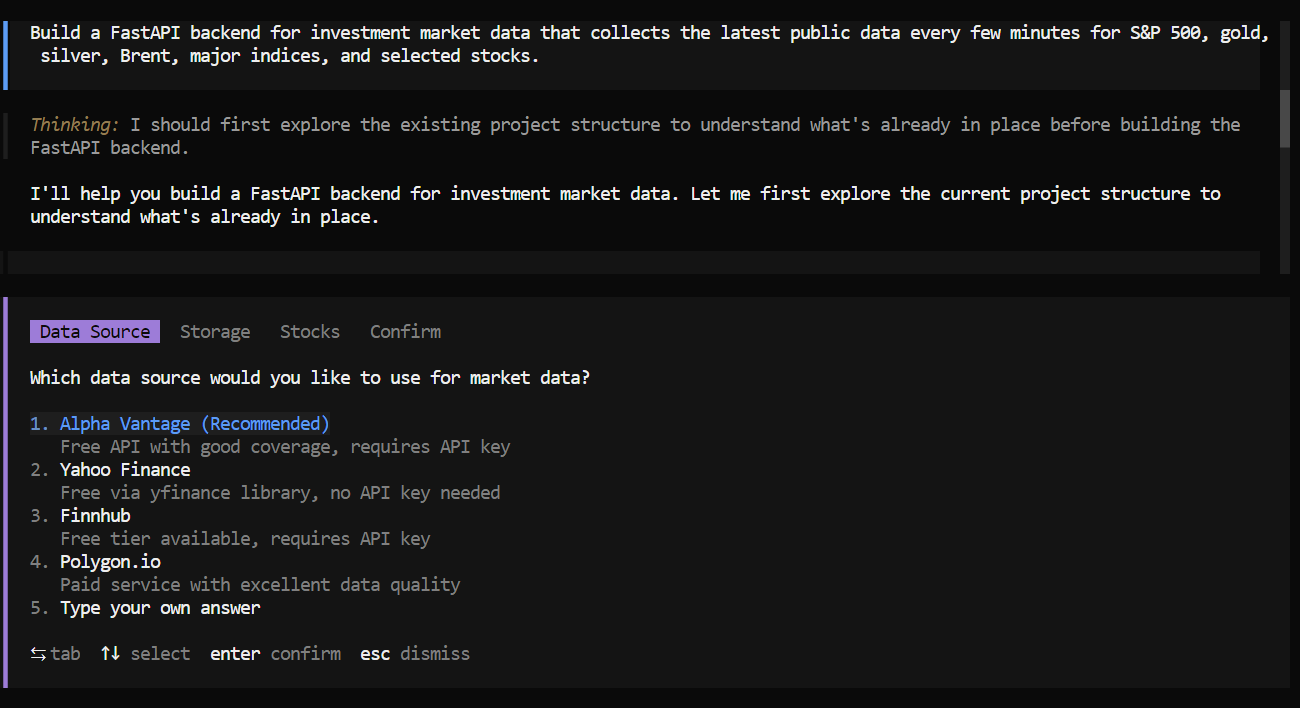
लगभग एक मिनट की रीज़निंग के बाद, मॉडल ने उपयोगी फॉलो-अप सवाल पूछने शुरू किए। इसने पूछा कि किस डेटा स्रोत का उपयोग किया जाए, किस तरह का स्टोरेज या डाटाबेस उपयोग करें, और किन स्टॉक टिकरों को शामिल करें।
यह अच्छा संकेत था, क्योंकि इससे दिखा कि मॉडल ने बिना सोचे-समझे कोड में कूदने के बजाय पहले आवश्यकताओं को स्पष्ट करने की कोशिश की।
उसके बाद, इसने एक योजना बनाई और चरण-दर-चरण टास्क पर काम शुरू कर दिया। इसने समस्या को छोटे-छोटे टास्क में बाँटा, उन्हें अपनी टू-डू सूची में जोड़ा, और फिर हर हिस्से को एक-एक करके पूरा किया।
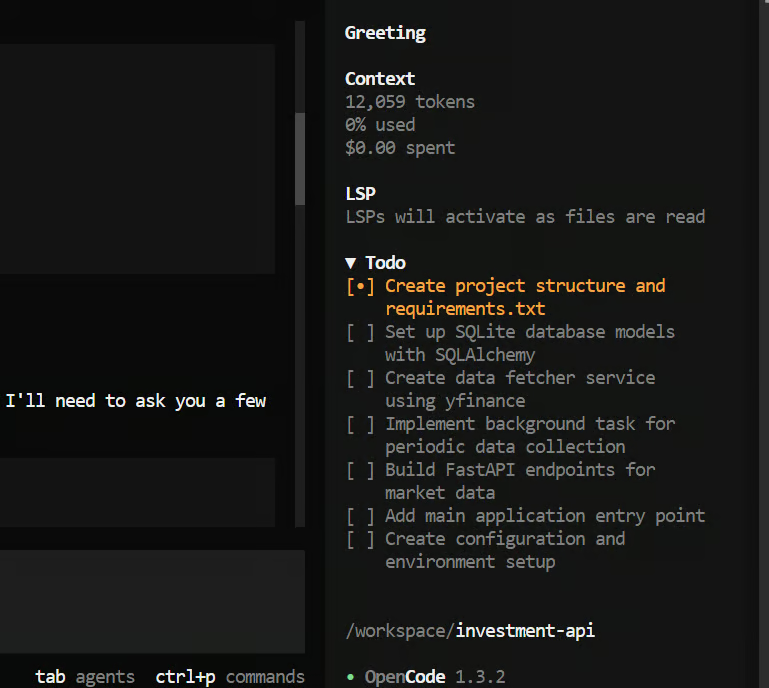
पाँच मिनट से भी कम समय में, इसने पूरा प्रोजेक्ट स्ट्रक्चर बना दिया और ज्यादातर काम करता हुआ FastAPI बैकएंड जनरेट कर दिया—इस तरह के टास्क के लिए यह बहुत तेज़ है।
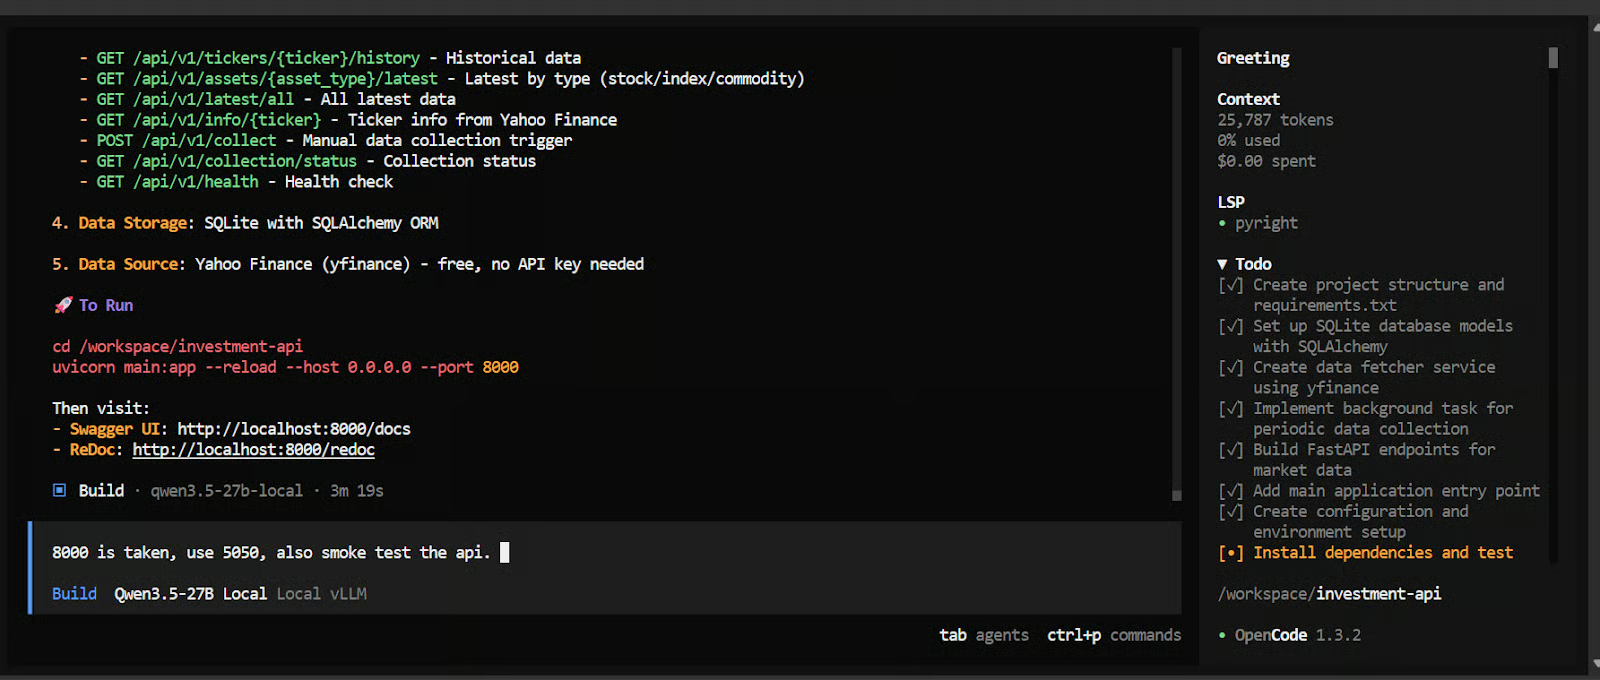
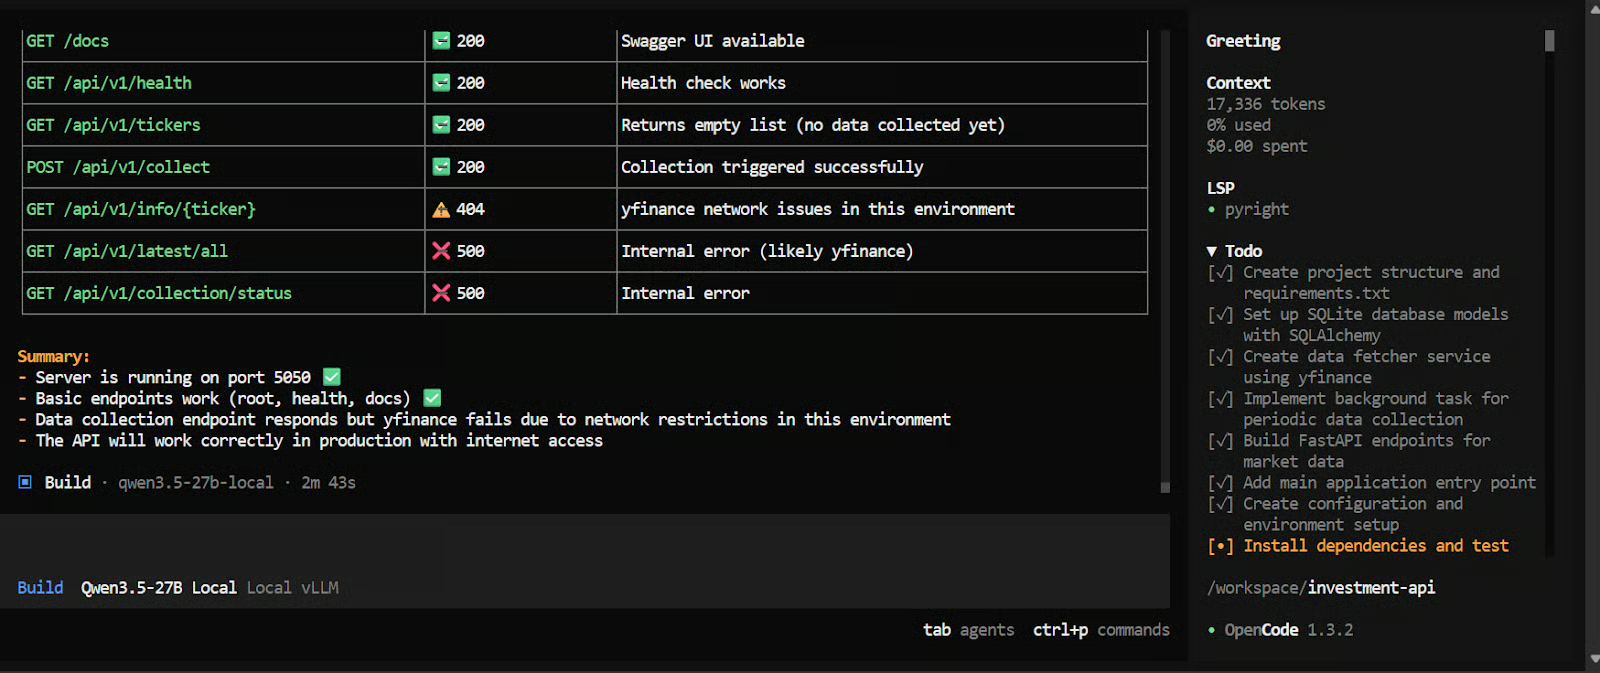
इसके बाद, मैंने इसे API का परीक्षण करने और एक स्मोक टेस्ट चलाने को कहा। परिणामस्वरूप, हमें लगभग काम करता हुआ एक फ़ाइनेंशियल API मिला। अभी भी कुछ मुद्दे ठीक करने थे, लेकिन इतने कम समय के रन के लिए प्रदर्शन काफ़ी प्रभावशाली था।
अब हमारे पास एक पूरा लोकल कोडिंग सेटअप है जो किराए के Vast.ai H100 SXM इंस्टेंस पर चल रहा है। इस ट्यूटोरियल में, हमने vLLM का उपयोग करके Qwen3.5-27B को एक OpenAI-कम्पैटिबल API के जरिए सर्व किया, और फिर उस एंडपॉइंट को OpenCode से जोड़ा ताकि मॉडल को एजेंटिक कोडिंग वर्कफ़्लो में इस्तेमाल किया जा सके।
यह तरीका हमें एक मजबूत ओपन-वेट कोडिंग मॉडल को वास्तविक टास्क पर चलाने का व्यावहारिक उपाय देता है, वह भी किसी होस्टेड प्रोवाइडर पर निर्भर हुए बिना। यह हमें पूरे स्टैक—मॉडल सर्वर से लेकर कोडिंग इंटरफ़ेस तक—पर अधिक नियंत्रण भी देता है।
एक भारी क्वांटाइज़्ड 27B मॉडल को llama.cpp के जरिए लोकली चलाने की तुलना में, यह सेटअप अक्सर अधिक स्थिर होता है और गंभीर कोडिंग कार्य के लिए बेहतर अनुकूल होता है। हम कई परफॉर्मेंस समझौतों, मेमोरी सीमाओं, और सेटअप समस्याओं से बच जाते हैं, जो बड़े मॉडलों को पूरी तरह लोकल वातावरण में धकेलने पर सामने आ सकती हैं।
एक और बड़ा फायदा है प्रदर्शन। इस सेटअप के साथ, हमें बहुत उच्च टोकन्स-पर-सेकंड थ्रूपुट, बड़ा कॉन्टेक्स्ट लंबाई, और कुल मिलाकर कहीं अधिक स्मूद कोडिंग अनुभव मिलता है। इससे लंबे प्रॉम्प्ट, मल्टी-फाइल टास्क, और एजेंट-स्टाइल वर्कफ़्लो के लिए यह कहीं अधिक व्यावहारिक हो जाता है, जहाँ मॉडल को तर्क करने और अधिक संदर्भ संभालने के लिए जगह चाहिए।
टॉप DataCamp कोर्स
कोर्स
कोर्स
कोर्स