

Lo svantaggio è che alcune affermazioni nel write-up finale risultano poco citate o troppo assolute, e la guida sarebbe più forte con link, fonti e assunzioni più chiare (hardware, dimensione del modello, batch size, lunghezza del contesto), dato che i consigli per la produzione dipendono molto dal contesto. Nel complesso, però, ha gestito un prompt complesso e articolato restituendo un playbook netto e subito utilizzabile, dall’aspetto pronto per la produzione.
Creazione e annotazione di dataset
Successivamente ho testato Agent Swarm su un task di costruzione dataset chiedendo a Kimi K2.5 di generare un benchmark di 100 problemi di matematica in linguaggio naturale con soluzioni e livelli di difficoltà. Ho anche richiesto esplicitamente di usare 20 agenti per vedere quanto rispettasse il vincolo sulla dimensione dello swarm mantenendo la qualità.
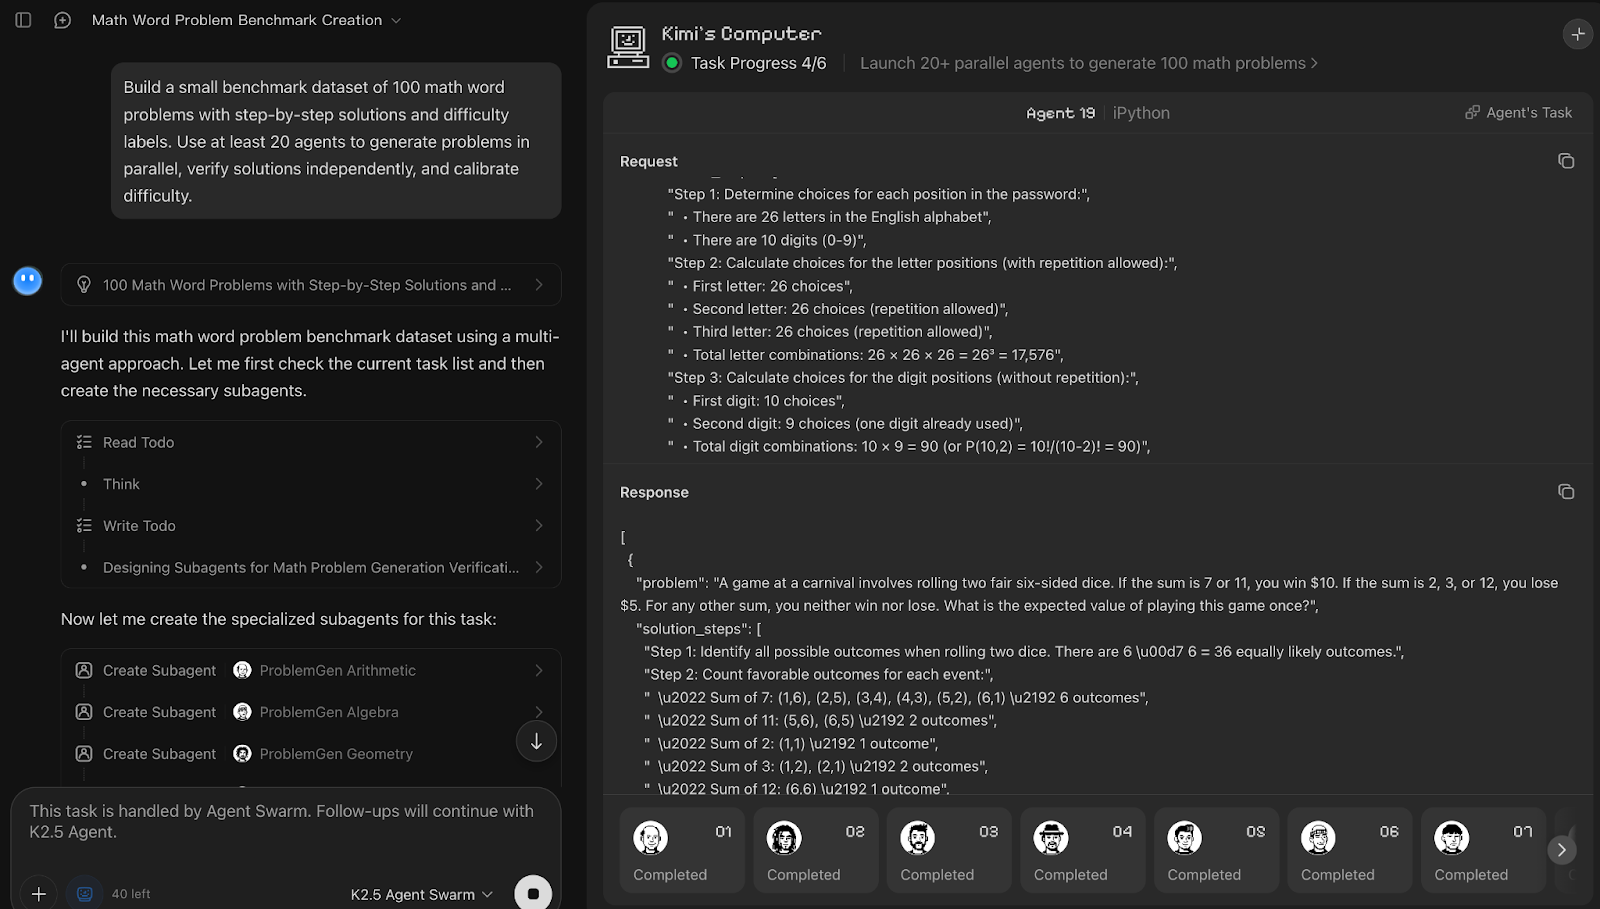
Prompt:
Build a small benchmark dataset of 100 math word problems with step-by-step solutions and difficulty labels. Use at least 20 agents to generate problems in parallel, verify solutions independently, and calibrate difficulty.Kimi K2.5 Agent Swarm ha trattato la creazione del dataset come una pipeline in tre fasi: generazione, verifica e calibrazione. Sebbene il prompt richiedesse almeno 20 agenti, il sistema ha avviato autonomamente 25 sotto-agenti, privilegiando la correttezza rispetto all’aderenza rigida al numero richiesto. È stato interessante osservare che circa cinque agenti lavoravano attivamente alla volta mentre altri erano in coda e riprendevano quando i sotto-task precedenti finivano, il che suggerisce un meccanismo di scheduling interno.
Ogni agente di generazione gestiva un dominio matematico distinto e produceva cinque problemi con soluzioni passo-passo, dopodiché 10 agenti sono stati assegnati alla verifica e un gruppo più piccolo di cinque agenti si è concentrato sulla calibrazione della difficoltà.
Il punto di forza qui è la chiara separazione delle responsabilità e la ridondanza nella verifica, che migliora in modo concreto la qualità del dataset. Il principale svantaggio è la latenza e un collo di bottiglia sequenziale.
L’esecuzione completa ha richiesto circa 20–25 minuti, rendendo questo approccio più adatto alla creazione di benchmark di alta qualità che a iterazioni rapide. Anche con 25 agenti, alcuni hanno dovuto attendere che altri finissero, il che significa che lo swarm è comunque limitato dalla logica degli step.
Detto questo, la capacità di regolare dinamicamente il numero di agenti per ogni sotto-task, riutilizzare quelli inattivi e convergere su un dataset etichettato è una solida dimostrazione di come si comporta Agent Swarm.
QA multimodale su larga scala
Poi ho spinto Kimi K2.5 in un workflow multimodale fornendo più immagini di etichette nutrizionali e chiedendo un confronto strutturato. L’obiettivo era valutare quanto bene sapesse estrarre, normalizzare e verificare dati visivi.
Prompt:
I’m sharing images of nutrition labels from 7 packaged food items. Analyze them and produce a clear comparison specifically:
Extract fields like: calories, protein, total fat, sugar, sodium, from each label.Normalize all values to a per-100g basis so items are comparableDouble-check numeric consistency (e.g. serving size vs totals)Rank the products from healthiest to least healthy, explaining the reasoningReturn a comparison table with normalized values for all items. Also include a summary highlighting, best high-protein option, the lowest sugar option, and items to avoid and why.
Assume the labels may vary in format and serving size. Resolve ambiguities where possible and note any missing or unclear values.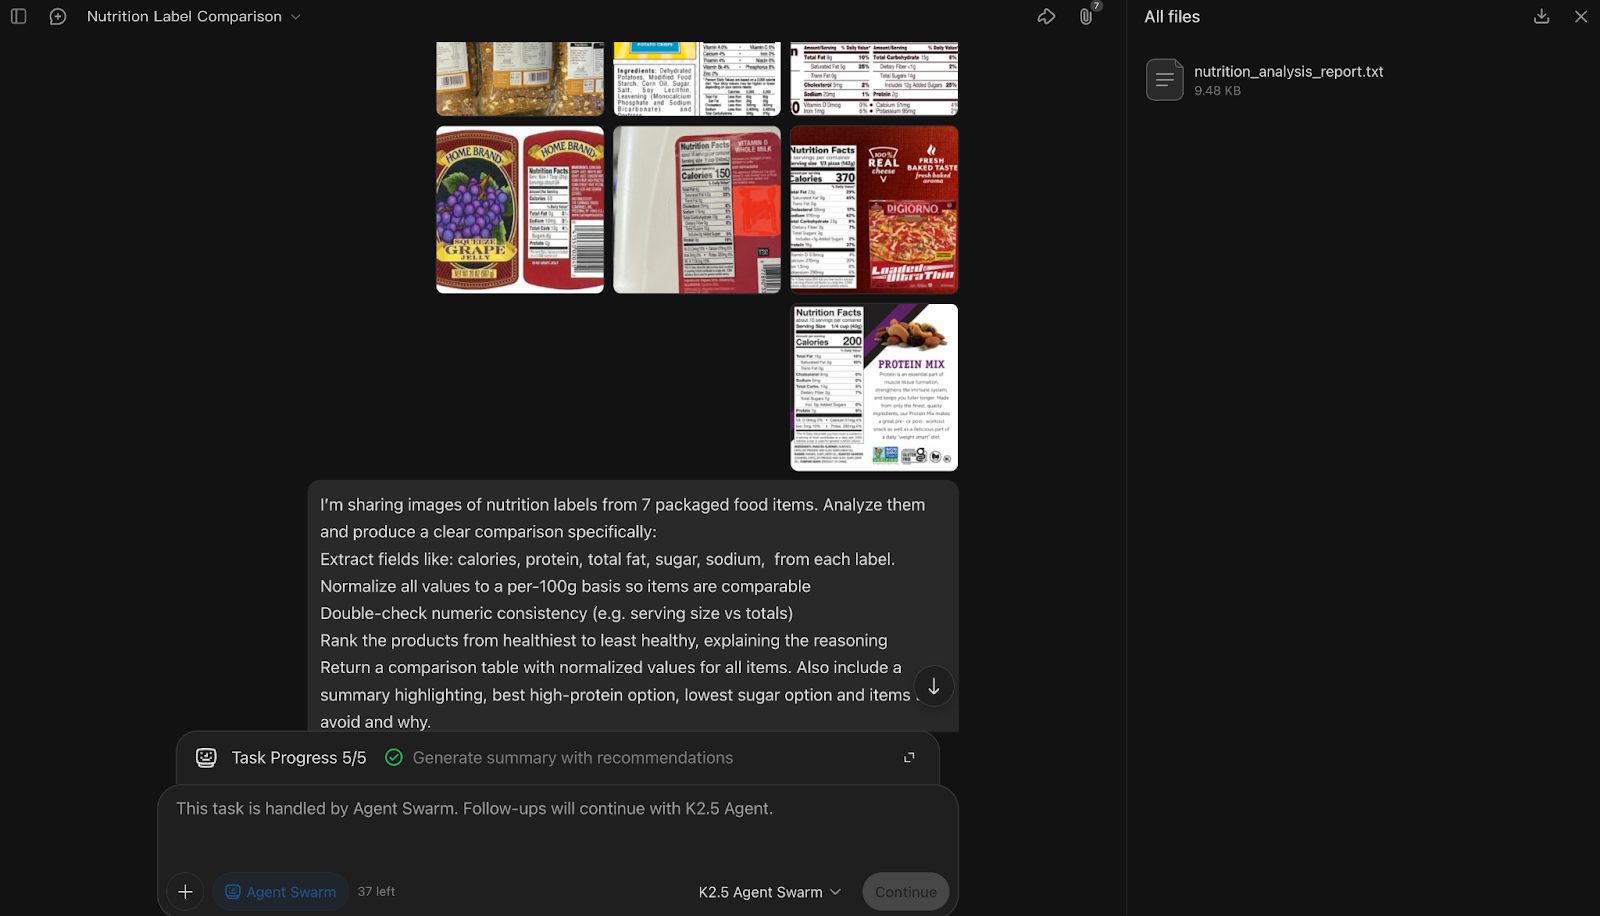
In questo esperimento di QA multimodale, Kimi K2.5 Agent Swarm ha scomposto il compito assegnando una label per sotto-agente, avviando sette sotto-agenti paralleli per estrarre i campi nutrizionali da ciascuna immagine, mentre un agente coordinatore gestiva normalizzazione, cross-check e ranking.
Una cosa interessante di Kimi è che i vincoli specificati nel prompt (estrazione, normalizzazione, verifica, ranking) diventano di fatto il blueprint secondo cui Kimi istanzia e assegna i sotto-agenti.
Ciò che mi ha colpito è il modo in cui lo swarm ha trattato la verifica come uno step importante: dopo l’estrazione, l’orchestrator ha esplicitamente riconciliato le porzioni, normalizzato i valori e segnalato le ambiguità invece di indovinare in silenzio. Il passaggio di sintesi finale, con il ranking dei prodotti e l’individuazione delle opzioni più proteiche e a minor contenuto di zuccheri, ha mostrato una forte logica di aggregazione su input visivi.
Di contro, analizzare 7 immagini ad alta risoluzione con uno swarm è pesante a livello computazionale, rendendolo una funzionalità premium più che uno strumento da chat rapida.
Questo esempio ha anche messo in luce un limite attuale: mentre l’analisi multimodale basata su immagini ha funzionato bene, l’input video diretto non era supportato, quindi un tentativo successivo di generare una ricetta da un video di cucina non è stato eseguibile.
Nel complesso, questa demo evidenzia la forza di Agent Swarm nell’estrazione visiva in parallelo e nella riconciliazione strutturata.
Sviluppare un gioco
Infine, ho testato le capacità di coding di Kimi K2.5 chiedendogli di creare da zero un gioco Bubble Shooter completamente interattivo. Questo esperimento mostra come il modello gestisce la generazione di codice end-to-end e stateful, dove la coerenza conta più del parallelismo.
Prompt:
```markdown
Crea un gioco Bubble Shooter completamente giocabile che giri localmente in un browser web. Il gioco deve supportare mira con mouse e touch, mostrare una guida visiva della mira in tempo reale, sparare bolle colorate dal centro in basso, far rimbalzare i colpi sulle pareti laterali e agganciare le bolle a una griglia in alto alla collisione.
Implementa la logica di gioco principale, inclusi lo scoppio di gruppi di tre o più bolle collegate dello stesso colore, la caduta di cluster disconnessi, il tracciamento e la visualizzazione del punteggio, l’anteprima della prossima bolla e la fine della partita quando le bolle superano una linea di pericolo vicino al fondo.
Mantieni la grafica semplice ma reattiva, includi un pulsante di riavvio e termina con brevi istruzioni su come eseguire e testare il gioco in locale.
```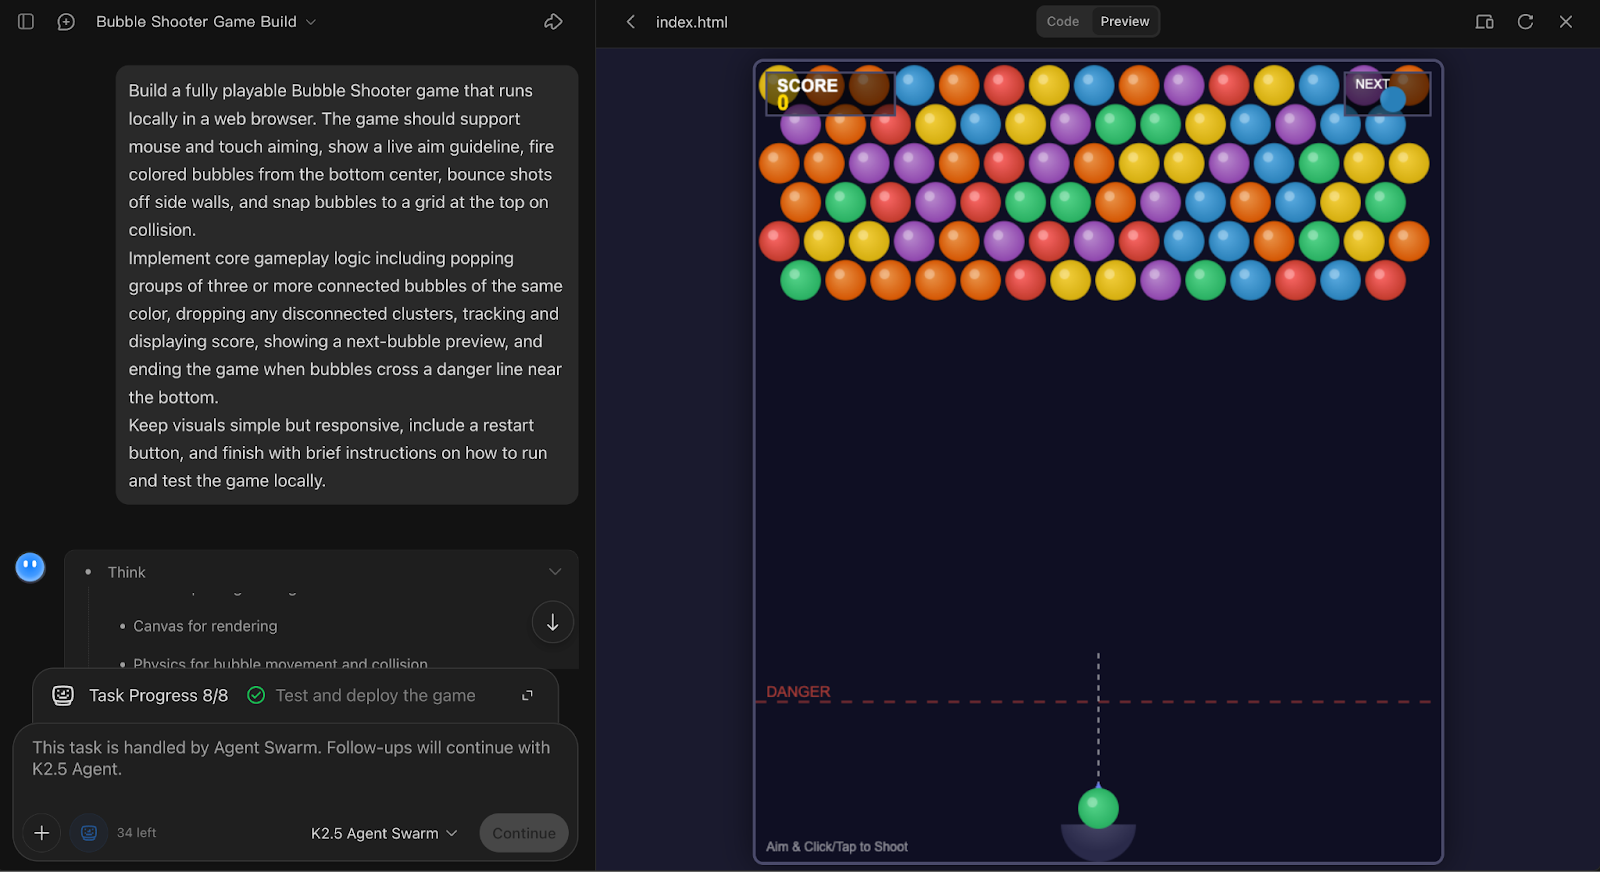
In questo esperimento di sviluppo del gioco, Kimi K2.5 Agent Swarm ha fatto una scelta notevolmente conservativa assegnando un unico sotto-agente all’intero task.
Questa decisione è di per sé interessante perché il sistema ha riconosciuto correttamente che si trattava di un problema di coding strettamente accoppiato e stateful, in cui un forte parallelismo avrebbe aggiunto overhead di coordinamento senza alcun beneficio.
L’agente ha prodotto un’implementazione di Bubble Shooter completa e eseguibile in locale con mira, rimbalzi sulle pareti, aggancio alla griglia, popping match-three, tracciamento del punteggio e logica di riavvio, mostrando sia le meccaniche di gioco che il flusso UI.
Mi è piaciuto in particolare che l’output fosse coerente e integrato; il rovescio della medaglia è che rifinitura e polishing richiederebbero probabilmente prompt iterativi, dato che tutto passa da un singolo agente.
Nel complesso, questo esempio dimostra bene che Agent Swarm in Kimi K2.5 non consiste nel generare sempre più agenti, ma nell’usare il parallelismo solo quando migliora davvero i risultati.
Conclusioni
In questo tutorial, Kimi K2.5 ha dimostrato di saper scomporre compiti complessi, allocare dinamicamente gli agenti e produrre output strutturati e pronti alle decisioni che tradizionalmente richiederebbero un piccolo team, non un singolo modello.
Allo stesso tempo, gli esempi ne chiariscono i confini.
Agent Swarm eccelle in workflow ampi e ricchi di strumenti come ricerca, costruzione di dataset ed estrazione multimodale, ma offre scarso vantaggio per task strettamente accoppiati e stateful come lo sviluppo di giochi interattivi.
Introduce anche trade-off concreti su latenza, costi e velocità di iterazione, soprattutto quando si danno priorità a verifica e riconciliazione rispetto al throughput puro.
Nel complesso, Kimi K2.5 offre un blueprint convincente sulla direzione dei sistemi agentici. Per sviluppatori e ricercatori a loro agio con i workflow basati su agenti, è uno dei modelli più interessanti da esplorare oggi.
Se vuoi approfondire come funziona l’AI agentica, ti consiglio di dare un’occhiata allo skill track AI Agent Fundamentals.
Kimi K2.5 e Agent Swarm: FAQ
Kimi K2.5 è davvero open source e gratuito da usare?
Sì, Moonshot AI ha rilasciato Kimi K2.5 con una licenza MIT modificata e pesi disponibili su Hugging Face. Tuttavia, trattandosi di un enorme modello a 1,04 trilioni di parametri (Mixture-of-Experts), l’esecuzione in locale richiede hardware di livello enterprise (ad esempio, più GPU H100). Per la maggior parte degli utenti, l’API ufficiale o la Web UI sono i punti di accesso più pratici.
Qual è il prezzo dell’API di Kimi K2.5?
Kimi K2.5 offre prezzi API competitivi: $0,60 per 1M token in input (che scendono a $0,10 per input in cache) e $3,00 per 1M token in output.
Qual è la differenza tra Chat standard e Agent Swarm?
La chat standard è lineare e single-threaded. Agent Swarm è un orchestratore parallelo: può scomporre autonomamente un prompt in sotto-task e avviare fino a 100 sotto-agenti specializzati per eseguirli simultaneamente. Lo Swarm è ideale per task "ampi" come ricerca approfondita o estrazione massiva di dati, mentre la Chat è migliore per task sequenziali e stateful come programmare un gioco.
Kimi K2.5 supporta input video?
Sì, il modello è nativamente multimodale e supporta input video fino a risoluzione 2K. Pur eccellendo in benchmark video a lungo contesto (come LongVideoBench), la funzionalità è attualmente sperimentale, quindi talvolta può avere difficoltà a seguire istruzioni complesse in workflow agentici basati su video rispetto a immagini statiche.
Qual è la dimensione della finestra di contesto di Kimi K2.5?
Kimi K2.5 supporta una finestra di contesto da 256.000 token (circa 200.000 parole). Questo contesto ultra-esteso consente al modello di processare interi libri, codebase massivi o lunghi documenti legali in un singolo passaggio senza dover spezzettare i dati, aspetto cruciale per mantenere l’accuratezza in grandi swarm.

Sono una Google Developers Expert in ML (Gen AI), una Kaggle 3x Expert e una Women Techmakers Ambassador con oltre 3 anni di esperienza nel tech. Ho co-fondato una startup health-tech nel 2020 e sto conseguendo un master in informatica al Georgia Tech, con specializzazione in machine learning.



Kimi K2.5 è un modello multimodale open-source di Moonshot AI pensato per workflow agentici, non solo per la chat. Invece di rispondere a prompt isolati, può scomporre compiti complessi, coordinare l’uso di strumenti e produrre output strutturati come tabelle, report, piani e codice, lungo workflow a più step.
Ciò che rende Kimi K2.5 particolarmente interessante è Agent Swarm: una modalità auto-diretta in cui il modello può avviare e orchestrare dinamicamente più sotto-agenti in parallelo per accelerare ricerca, verifica ed esecuzione.
In questo tutorial spiegherò cos’è Kimi K2.5 e dove rende meglio, per poi concentrarmi su quattro esperimenti pratici che mostrano come Agent Swarm si comporta in concreto: cosa fa bene, dove è carente e quando supera effettivamente un’impostazione a singolo agente.
Che cos’è Kimi K2.5?
Kimi K2.5 è il modello nativamente multimodale open-source di Moonshot AI, progettato per gestire testo, immagini, video e documenti in un unico sistema. Estende Kimi K2 con ulteriore pretraining su circa 15T di token misti testuali e visivi, ed è pensato non solo come chatbot, ma come sistema agentico in grado di pianificare, usare strumenti e (in modalità swarm) eseguire task in parallelo.
In pratica, Kimi K2.5 si distingue per tre aspetti:
Fonte: Kimi K2.5
I grafici sopra riassumono le prestazioni di Kimi K2.5 in quattro categorie: Agents, Coding, Image e Video, con Kimi in blu e altri modelli di frontiera in grigio.
Puoi provare Kimi K2.5 in vari modi:
https://platform.moonshot.aiPer benchmark riproducibili, Moonshot consiglia di usare l’API ufficiale o provider verificati tramite Kimi Vendor Verifier.
Che cos’è Agent Swarm in Kimi K2.5?
Oggi molti setup multi-agente sono ancora costruiti a mano: definisci ruoli, colleghi un workflow e speri che l’orchestrazione regga man mano che i task crescono. Kimi K2.5 Agent Swarm ribalta questo modello.
Invece di predefinire agenti e pipeline, K2.5 può auto-dirigere uno swarm, decidendo quando parallelizzare, quanti agenti avviare, quali strumenti usare e come unire i risultati, in base al task stesso.
Può creare e coordinare autonomamente uno swarm di fino a 100 sotto-agenti, eseguendo workflow paralleli con fino a 1.500 chiamate a strumenti, senza ruoli predefiniti.
Come funziona Kimi K2.5 Agent Swarm?
Sotto il cofano, Agent Swarm introduce un orchestrator addestrabile che impara a scomporre il lavoro in sotto-task paralleli e a schedularli in modo efficiente:
Perché PARL (Parallel-Agent Reinforcement Learning) è importante
Il comportamento a swarm di Kimi K2.5 è addestrato con il Parallel-Agent Reinforcement Learning (PARL), un setup di training che rende la parallelizzazione una skill apprendibile. Questo è cruciale perché i sistemi multi-agente ingenui spesso falliscono in due modi:
PARL affronta il problema modellando le ricompense durante il training: incoraggia il parallelismo all’inizio e sposta gradualmente l’ottimizzazione verso la qualità end-to-end del task, prevenendo il falso parallelismo. Per rendere l’ottimizzazione attenta alla latenza, K2.5 valuta le prestazioni usando i Critical Steps, perché aumentare il numero di agenti aiuta solo se accorcia davvero il percorso di esecuzione più lento, invece di gonfiare l’overhead di coordinamento.
Quando il task è ampio e ricco di strumenti, Agent Swarm può ridurre in modo significativo il time-to-output. Moonshot riporta che, rispetto a un setup a singolo agente, K2.5 Swarm può tagliare i tempi di esecuzione di ~3x–4,5x, e valutazioni interne mostrano fino a ~80% di riduzione del runtime end-to-end su workload complessi grazie alla vera parallelizzazione.
Esempi e osservazioni su Kimi K2.5
In questa sezione condivido la mia esperienza diretta testando Kimi K2.5 Agent Swarm in diversi scenari. Ogni esempio mostra come lo swarm scompone i task, assegna gli agenti e dove questo approccio aiuta davvero o, in pratica, non rende al meglio.
Research swarm
Nel primo esperimento ho verificato se Kimi K2.5 Agent Swarm potesse affrontare un compito reale e di alto impatto, come redigere un piano di deployment per LLM open-source.
Prompt:
In questa demo, Kimi K2.5 Agent Swarm ha scomposto subito il prompt in filoni di ricerca paralleli e ha avviato tre sotto-agenti dedicati, ovvero
InferenceStackResearcher,QuantizationHardwareResearchereCostControlResearcher. Pur se ogni nome indica il lavoro assegnato, ha poi distribuito le attività su più worker con diverse “personas”.La cosa che ho apprezzato di più è che l’output finale era una tabella comparativa pulita per gli inference stack, insieme a raccomandazioni concise e note sulla quantizzazione. Puoi anche usare la barra di avanzamento per vedere come ha scomposto il lavoro in partenza e come ha tracciato ogni sotto-task fino al completamento.