

Het nadeel is echter dat sommige claims in de uiteindelijke write-up onderbouwd aanvoelen met te weinig bronnen of te absoluut zijn, en de gids sterker zou zijn met links, bronnen en duidelijkere aannames (hardware, modelgrootte, batchgrootte, contextlengte), aangezien advies voor productie sterk contextafhankelijk is. Al met al ging het goed om met een complexe, meerledige prompt om te gaan en leverde het een scherpe, direct bruikbare playbook op dat production ready oogt.
Datasetcreatie en annotatie
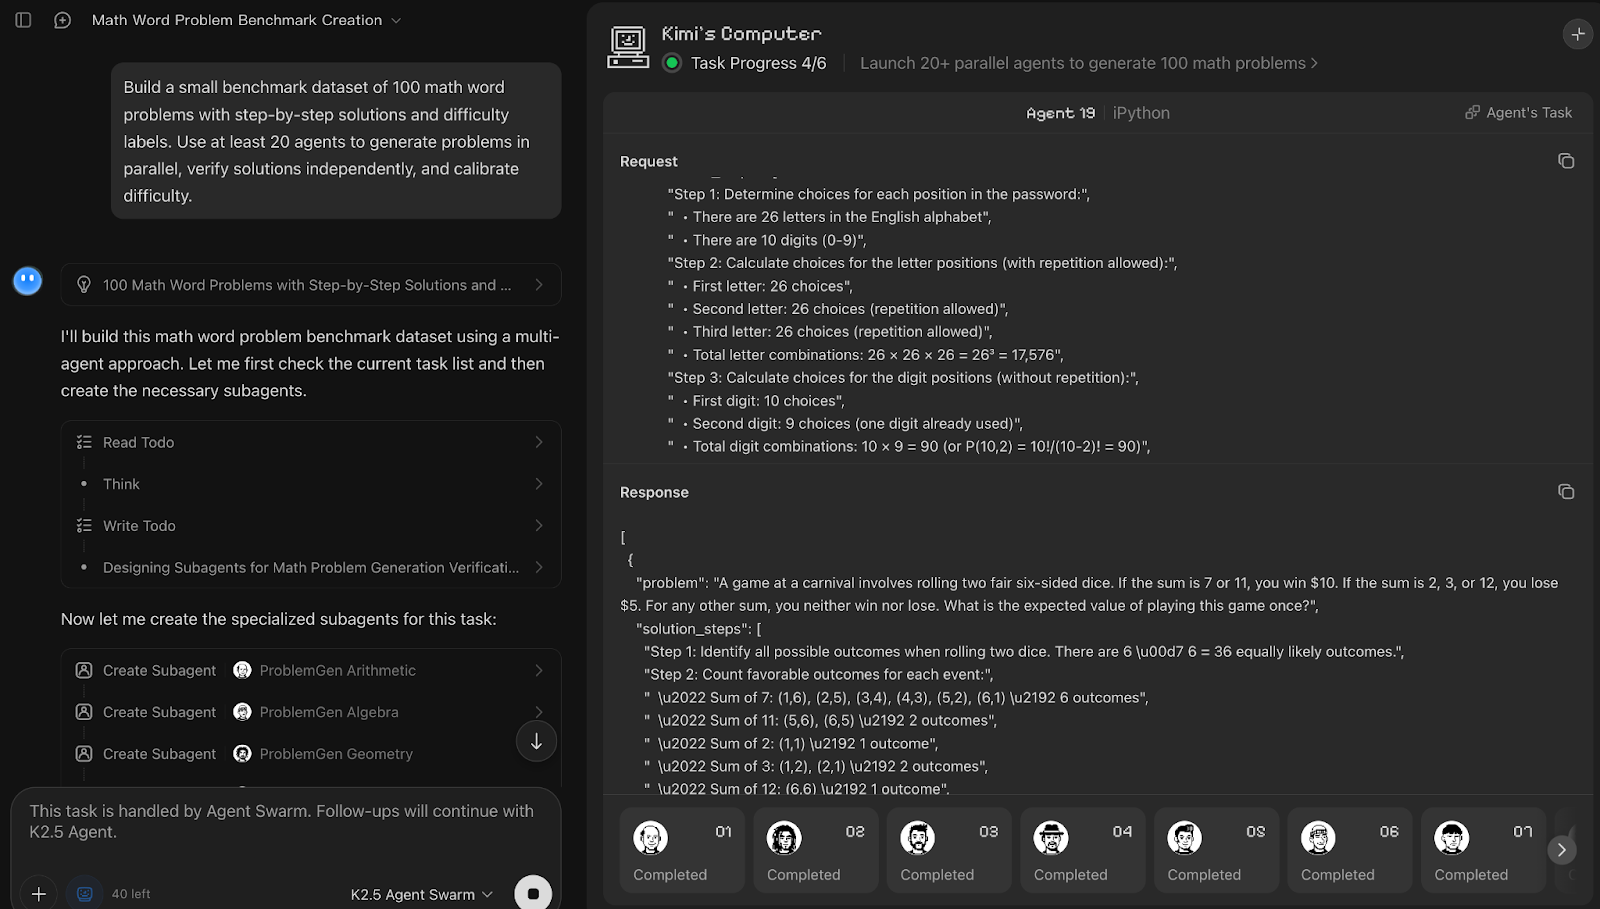
Vervolgens testte ik Agent Swarm op een taak voor het bouwen van een dataset door Kimi K2.5 te vragen een benchmark van 100 tekstsomproblemen voor wiskunde te genereren met oplossingen en moeilijkheidslabels. Ik vroeg ook expliciet om 20 agents te gebruiken om te zien hoe strikt het de swarm-grootte volgt terwijl de kwaliteit behouden blijft.
Prompt:
Build a small benchmark dataset of 100 math word problems with step-by-step solutions and difficulty labels. Use at least 20 agents to generate problems in parallel, verify solutions independently, and calibrate difficulty.Kimi K2.5 Agent Swarm behandelde datasetcreatie als een pijplijn met drie fasen: generatie, verificatie en calibratie. Hoewel de prompt om minimaal 20 agents vroeg, startte het systeem autonoom 25 sub-agents, waarbij het correctheid boven strikte naleving van het gevraagde aantal stelde. Het was interessant om te zien dat ongeveer vijf agents tegelijk actief werkten terwijl anderen in de wachtrij stonden en hervatten zodra eerdere subtaken waren afgerond, wat duidt op een intern planningsmechanisme.
Elke generatieagent beheerde een afzonderlijk wiskundedomein en produceerde vijf problemen met stapsgewijze oplossingen, waarna 10 agents werden toegewezen aan verificatie en een kleinere set van vijf agents zich richtte op moeilijkheidscalibratie.
De opvallende sterkte hier is de duidelijke scheiding van verantwoordelijkheden en redundantie in verificatie, wat de kwaliteit van de dataset wezenlijk verbetert. Het belangrijkste nadeel is latency en een sequentiële bottleneck.
De volledige run duurde ongeveer 20–25 minuten, waardoor deze aanpak geschikter is voor het maken van hoogwaardige benchmarks dan voor snelle iteratie. Zelfs met 25 agents moesten sommige agents wachten tot anderen klaar waren, wat betekent dat de swarm nog steeds wordt beperkt door de logica van de stappen.
Toch is het vermogen om het aantal agents per subtaak dynamisch aan te passen, inactieve agents te hergebruiken en te convergeren naar een gelabelde dataset een sterke demonstratie van hoe Agent Swarm zich gedraagt.
Multimodale QA op schaal
Vervolgens duwde ik Kimi K2.5 een multimodale workflow in door meerdere afbeeldingen van voedingswaardelabels aan te leveren en om een gestructureerde vergelijking te vragen. Het doel was te zien hoe goed het visuele data kan extraheren, normaliseren en verifiëren.
Prompt:
I’m sharing images of nutrition labels from 7 packaged food items. Analyze them and produce a clear comparison specifically:
Extract fields like: calories, protein, total fat, sugar, sodium, from each label.Normalize all values to a per-100g basis so items are comparableDouble-check numeric consistency (e.g. serving size vs totals)Rank the products from healthiest to least healthy, explaining the reasoningReturn a comparison table with normalized values for all items. Also include a summary highlighting, best high-protein option, the lowest sugar option, and items to avoid and why.
Assume the labels may vary in format and serving size. Resolve ambiguities where possible and note any missing or unclear values.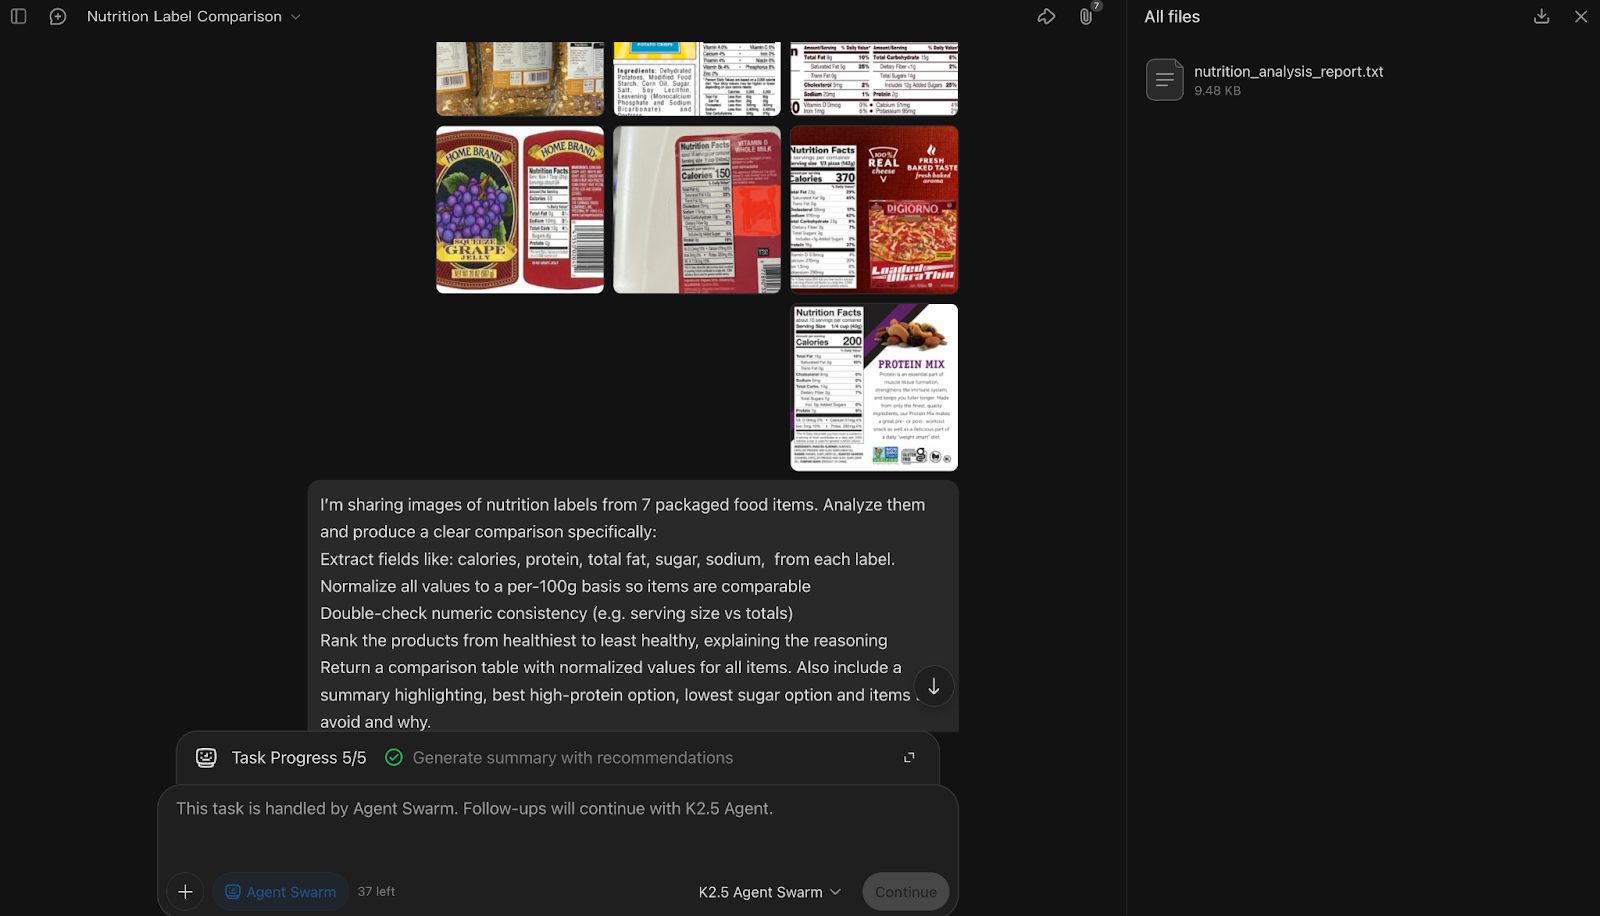
In dit multimodale QA-experiment decomponeerde Kimi K2.5 Agent Swarm de taak volgens één label per sub-agent, waarbij zeven parallelle sub-agents werden opgestart om voedingswaarden uit elke afbeelding te extraheren, terwijl een coördinerende agent de normalisatie, cross-checking en ranking afhandelde.
Een interessant aspect van Kimi is dat de beperkingen die je in de prompt specificeert (extractie, normalisatie, verificatie, ranking) feitelijk het blauwdruk worden voor hoe Kimi sub-agents instantiëert en toewijst.
Wat mij opviel, is hoe de swarm verificatie als een belangrijke stap behandelde; d.w.z. na extractie verzoende de orkestrator expliciet portiegroottes, normaliseerde waarden en markeerde onduidelijkheden in plaats van stilzwijgend te gokken. De laatste synthese-stap, die producten rangschikte en de beste hoog-eiwit- en laag-suikeropties aanwees, liet sterke aggregatielogica over visuele inputs zien.
Een nadeel is dat het analyseren van 7 high-res afbeeldingen met een swarm veel rekenkracht vraagt, waardoor het meer een premiumfunctie is dan een snelle-chattool.
Dit voorbeeld legde ook een huidige beperking bloot; hoewel beeldgebaseerde multimodale analyse goed werkte, werd directe video-input niet ondersteund, waardoor een vervolgpoging om een recept te genereren uit een kookvideo niet kon worden uitgevoerd.
Al met al benadrukt deze demo de kracht van Agent Swarm in parallelle visuele extractie en gestructureerde verzoening.
Een game coderen
Tot slot testte ik Kimi K2.5’s codeercapaciteiten door te vragen om vanaf nul een volledig interactieve Bubble Shooter-game te bouwen. Dit experiment laat zien hoe het model end-to-end, stateful codegeneratie afhandelt, waar samenhang belangrijker is dan parallelisme.
Prompt:
```markdown
Bouw een volledig speelbare Bubble Shooter-game die lokaal in een webbrowser draait. De game moet muis- en touch-aiming ondersteunen, een live richtlijn tonen, gekleurde bubbels afvuren vanaf het midden onderaan, schoten laten stuiteren op zijmuren en bubbels aan de bovenkant op een raster laten vastklikken bij een botsing.
Implementeer kernspeellogica, waaronder het laten knappen van groepen van drie of meer verbonden bubbels van dezelfde kleur, het laten vallen van niet-verbonden clusters, het bijhouden en weergeven van de score, het tonen van een volgende-bubbel-preview en het beëindigen van het spel wanneer bubbels een gevarenzone nabij de onderkant overschrijden.
Houd de visuals simpel maar responsief, voeg een herstartknop toe en sluit af met korte instructies over hoe je de game lokaal kunt draaien en testen.
```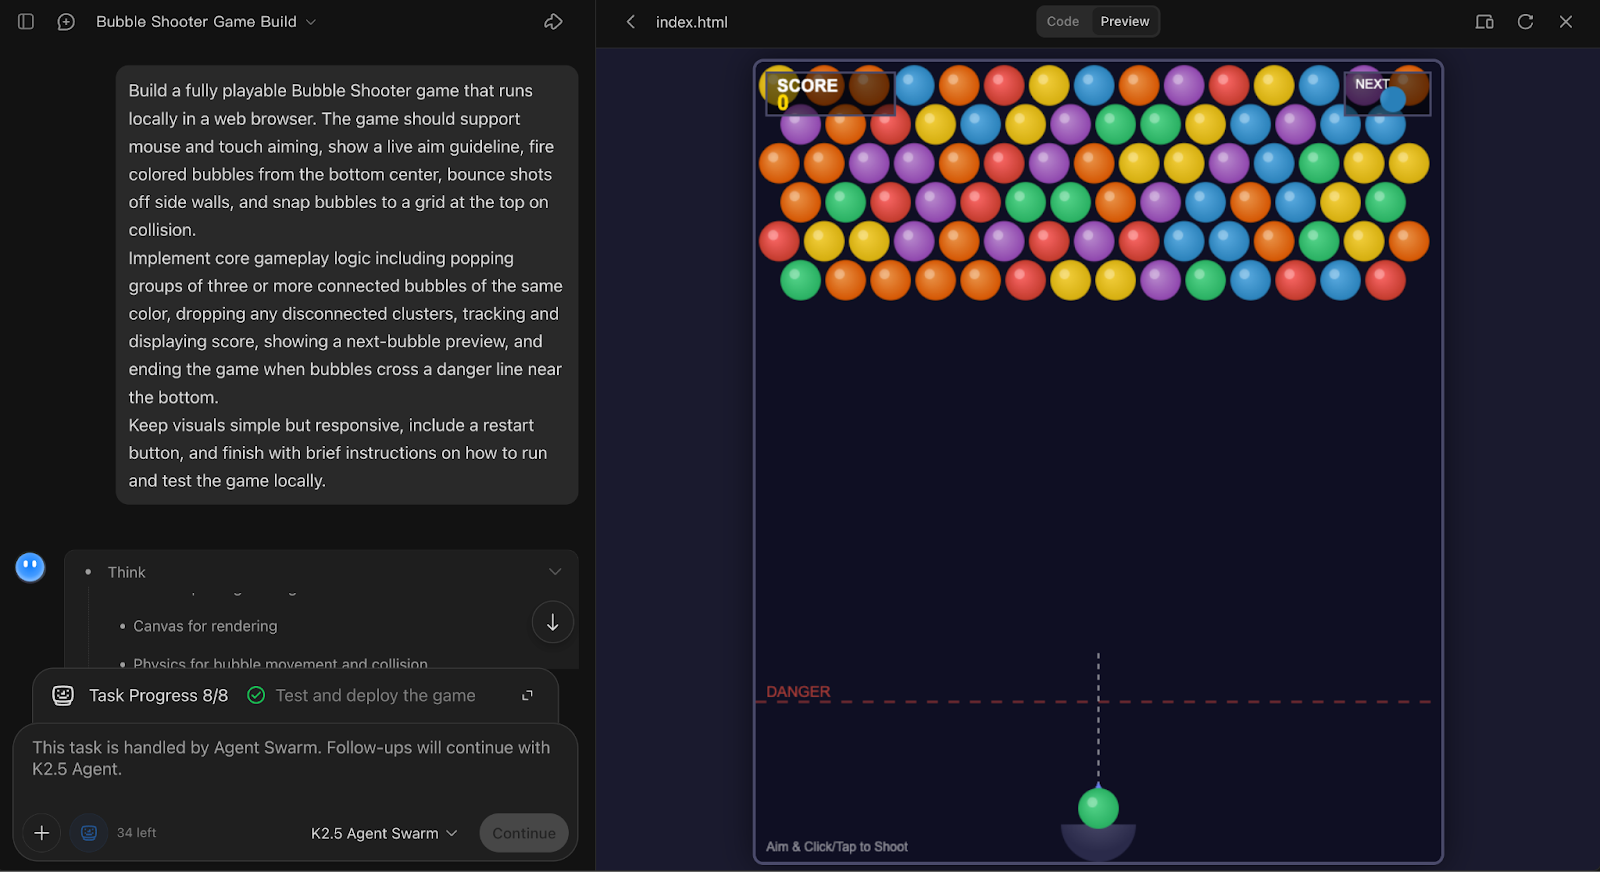
In dit gamebouw-experiment maakte Kimi K2.5 Agent Swarm een opvallend behoudende keuze door slechts één sub-agent toe te wijzen om de volledige taak af te handelen.
Die beslissing is op zich al interessant, omdat het systeem correct herkende dat dit een nauw gekoppeld, stateful codeerprobleem was, waarbij zwaar parallelisme coördinatie-overhead zou toevoegen zonder voordeel.
De agent produceerde een complete, lokaal draaiende Bubble Shooter-implementatie met mikken, muur-stuiters, rastervastklikken, match-three knallen, scorebijhouden en herstartlogica, met zowel spelmechanica als UI-flow.
Wat ik vooral goed vond, is dat de output coherent en geïntegreerd aanvoelde, maar het nadeel is wel dat verfijning en polish waarschijnlijk iteratieve prompting vereisen, aangezien alles via één agent loopt.
Al met al laat dit voorbeeld goed zien dat Agent Swarm in Kimi K2.5 niet draait om altijd meer agents te starten, maar om parallelisme alleen in te zetten wanneer het de uitkomsten daadwerkelijk verbetert.
Conclusie
In deze tutorial liet Kimi K2.5 zien complexe taken te kunnen opsplitsen, agents dynamisch toe te wijzen en gestructureerde, beslissingsklare outputs te produceren die traditioneel een klein team vereisen in plaats van één enkel model.
Tegelijkertijd maken de voorbeelden de grenzen duidelijk.
Agent Swarm blinkt uit bij brede, tool-intensieve workflows zoals research, datasetconstructie en multimodale extractie, maar biedt weinig voordeel voor nauw gekoppelde, stateful taken zoals interactieve gameontwikkeling.
Het introduceert ook echte trade-offs rond latency, kosten en iteratiesnelheid, vooral wanneer verificatie en verzoening prioriteit krijgen boven ruwe doorvoer.
Al met al biedt Kimi K2.5 een overtuigende blauwdruk voor waar agentische systemen naartoe gaan. Voor developers en onderzoekers die graag experimenteren met agentgebaseerde workflows is het een van de interessantste modellen om vandaag te verkennen.
Als je meer wilt leren over hoe agentische AI werkt, raad ik je aan de AI Agent Fundamentals skill track te bekijken.
Kimi K2.5 en Agent Swarm: veelgestelde vragen
Is Kimi K2.5 echt open source en gratis te gebruiken?
Ja, Moonshot AI heeft Kimi K2.5 uitgebracht onder een aangepaste MIT-licentie met weights beschikbaar op Hugging Face. Omdat het echter een enorm model met 1,04 biljoen parameters is (Mixture-of-Experts), is het lokaal draaien ervan enterprise-grade hardware vereist (bijv. meerdere H100 GPU’s). Voor de meeste gebruikers zijn de officiële API of Web UI het meest praktische toegangspunt.
Wat zijn de API-kosten van Kimi K2.5?
Kimi K2.5 biedt competitieve API-prijzen: $0,60 per 1M inputtokens (dalend naar $0,10 voor gecachete inputs) en $3,00 per 1M outputtokens.
Wat is het verschil tussen Standard Chat en Agent Swarm?
Standaard chat is lineair en single-threaded. Agent Swarm is een parallelle orkestrator: het kan autonoom een prompt opsplitsen in subtaken en tot 100 gespecialiseerde sub-agents starten om ze gelijktijdig uit te voeren. Swarm is het beste voor "brede" taken zoals diepgaand onderzoek of bulkdata-extractie, terwijl Chat beter is voor stateful, sequentiële taken zoals het coderen van een game.
Ondersteunt Kimi K2.5 video-input?
Ja, het model is van nature multimodaal en ondersteunt video-input tot 2K-resolutie. Hoewel het excelleert op long-context videobenchmarks (zoals LongVideoBench), is de functie momenteel experimenteel, wat betekent dat het af en toe kan worstelen met complexe instructieopvolging in videogebaseerde agentworkflows vergeleken met statische afbeeldingen.
Wat is de grootte van het contextvenster voor Kimi K2.5?
Kimi K2.5 ondersteunt een contextvenster van 256.000 tokens (ongeveer 200.000 woorden). Deze ultralange context maakt het mogelijk dat het model volledige boeken, enorme codebases of lange juridische documenten in één keer verwerkt zonder data te hoeven chunken, wat cruciaal is voor het behouden van nauwkeurigheid in grote swarms.

Ik ben een Google Developers Expert in ML (Gen AI), een Kaggle 3x Expert en een Women Techmakers Ambassador met meer dan 3 jaar ervaring in tech. In 2020 heb ik een healthtech-startup mee opgericht en ik volg een master computer science aan Georgia Tech, met als specialisatie machine learning.


Kimi K2.5 is een open-source, multimodaal model van Moonshot AI dat is gebouwd voor agent-gedreven workflows, niet alleen chat. In plaats van te reageren op losse prompts kan het complexe taken opdelen, het gebruik van tools coördineren en gestructureerde outputs produceren zoals tabellen, rapporten, plannen en code, over meerstapsworkflows heen.
Wat Kimi K2.5 extra interessant maakt, is Agent Swarm. Een zelfgestuurde modus waarin het model dynamisch meerdere sub-agents parallel kan opstarten en orkestreren om onderzoek, verificatie en uitvoering te versnellen.
In deze tutorial behandel ik wat Kimi K2.5 is en waar het goed presteert, en focus ik vervolgens op vier hands-on experimenten die laten zien hoe Agent Swarm zich in de praktijk gedraagt, inclusief wat het indrukwekkend doet, waar het tekortschiet en wanneer het een single-agentopzet daadwerkelijk verslaat.
Wat is Kimi K2.5?
Kimi K2.5 is Moonshot AI’s open-source, van nature multimodale model, ontworpen om tekst, afbeeldingen, video en documenten in één systeem te verwerken. Het breidt Kimi K2 uit met doorlopende pretraining op ongeveer 15T gemengde tekst- en visuele tokens, en het is ontworpen om niet alleen als chatbot te functioneren, maar als een agentisch systeem dat kan plannen, tools kan gebruiken en (in swarm-modus) taken parallel kan uitvoeren.
In de praktijk valt Kimi K2.5 op door drie dingen:
Bron: Kimi K2.5
De bovenstaande grafieken vatten Kimi K2.5’s prestaties samen in vier categorieën: Agents, Coding, Image en Video, met Kimi in blauw en andere toonaangevende frontier-modellen als grijze balken.
Je kunt Kimi K2.5 op meerdere manieren proberen:
https://platform.moonshot.aiVoor reproduceerbare benchmarks raadt Moonshot aan de officiële API of geverifieerde providers via Kimi Vendor Verifier te gebruiken.
Wat is Agent Swarm in Kimi K2.5?
De meeste multi-agentopstellingen zijn vandaag de dag nog handmatig gebouwd; je definieert rollen, legt een workflow vast en hoopt dat de orkestratie standhoudt naarmate taken groter worden. Kimi K2.5 Agent Swarm draait dat model om.
In plaats van agents en pipelines vooraf te definiëren kan K2.5 zelf een swarm aansturen, beslissen wanneer te paralleliseren, hoeveel agents te starten, welke tools te gebruiken en hoe resultaten te mergen, op basis van de taak zelf.
Het kan autonoom een agent-swarm creëren en coördineren van maximaal 100 sub-agents, parallelle workflows uitvoeren met tot 1.500 tool-calls, zonder vooraf gedefinieerde rollen.
Hoe werkt Kimi K2.5 Agent Swarm?
Onder de motorkap introduceert Agent Swarm een trainbare orkestrator die leert om werk op te delen in parallelle subtaken en ze efficiënt te plannen:
Waarom PARL (Parallel-Agent Reinforcement Learning) ertoe doet
Het swarm-gedrag van Kimi K2.5 is getraind met Parallel-Agent Reinforcement Learning (PARL), een trainingsopzet die parallelisme zelf tot een aan te leren vaardigheid maakt. Dit is belangrijk omdat naïeve multi-agentsystemen vaak op twee manieren falen:
PARL pakt dit aan door tijdens training de beloningen te sturen. Het stimuleert vroeg parallelisme en verschuift de optimalisatie geleidelijk naar de end-to-end taakkwaliteit, waardoor nep-parallelisme wordt voorkomen. Om de optimalisatie latency-bewust te maken, evalueert K2.5 prestaties met Critical Steps, omdat meer agents starten alleen helpt als het daadwerkelijk het traagste pad van uitvoering verkort in plaats van de coördinatie-overhead op te blazen.
Wanneer de taak breed is en zwaar op tools leunt, kan Agent Swarm de time-to-output substantieel verkorten. Moonshot meldt dat K2.5 Swarm, vergeleken met een single-agentopzet, de uitvoeringstijd met ~3x tot 4,5x kan terugbrengen, en interne evaluaties tonen tot ~80% reductie in end-to-end runtimes op complexe workloads door echte parallelisatie.
Kimi K2.5-voorbeelden en observaties
In dit deel deel ik mijn eigen ervaringen met het testen van Kimi K2.5 Agent Swarm in uiteenlopende scenario’s. Elk voorbeeld laat zien hoe de swarm taken opdeelt, agents toewijst en waar deze aanpak in de praktijk echt helpt of tekortschiet.
Research-swarm
Voor mijn eerste experiment testte ik of Kimi K2.5 Agent Swarm een high-stakes, realistische taak aankon, zoals het opstellen van een uitrolplan voor open-source LLM’s.
Prompt:
In deze demo splitste Kimi K2.5 Agent Swarm de prompt meteen op in parallelle onderzoekstrajecten en startte drie toegewijde sub-agents, namelijk
InferenceStackResearcher,QuantizationHardwareResearcherenCostControlResearcher. Hoewel elke subagent-naam verwijst naar het toegewezen werk, waaierde het vervolgens uit over meerdere worker-persona’s.Wat ik het meest waardeerde, was dat de uiteindelijke output een overzichtelijke vergelijkende tabel was voor inference-stacks, samen met bondige aanbevelingen en notities voor kwantisatie. Je kunt ook de voortgangsbalk van de taak gebruiken om te zien hoe het het werk vooraf opdeelde en elke subtaak tot voltooiing volgde.