

Namun, sisi lemahnya adalah beberapa klaim dalam tulisan akhir terasa kurang diberi sitasi atau terlalu absolut, dan panduannya akan lebih kuat dengan tautan, sumber, dan asumsi yang lebih jelas (perangkat keras, ukuran model, ukuran batch, panjang konteks), karena saran untuk produksi sangat bergantung pada konteks. Secara keseluruhan, model ini menangani prompt kompleks multi-bagian dan mengembalikan playbook yang tegas dan siap pakai yang tampak siap produksi.
Pembuatan dan anotasi dataset
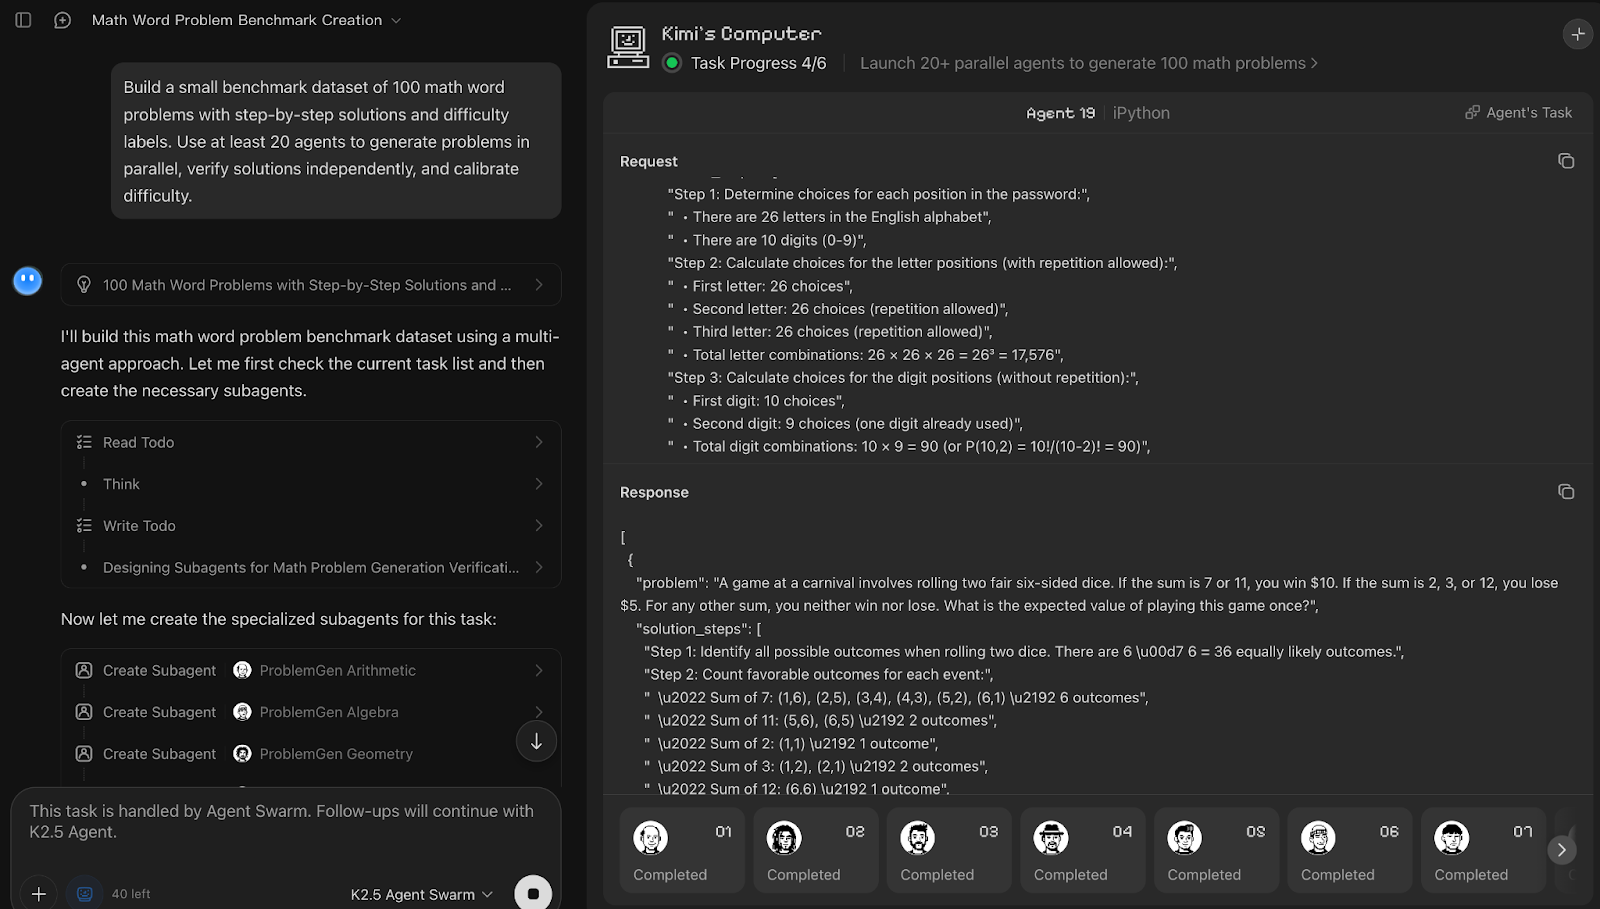
Berikutnya, saya menguji Agent Swarm pada tugas pembuatan dataset dengan meminta Kimi K2.5 menghasilkan tolok ukur 100 soal cerita matematika beserta solusi dan label tingkat kesulitan. Saya juga secara eksplisit meminta menggunakan 20 agen untuk melihat seberapa patuh ia mengikuti batasan ukuran swarm sambil menjaga kualitas.
Prompt:
Build a small benchmark dataset of 100 math word problems with step-by-step solutions and difficulty labels. Use at least 20 agents to generate problems in parallel, verify solutions independently, and calibrate difficulty.Kimi K2.5 Agent Swarm memperlakukan pembuatan dataset sebagai pipeline tiga fase, meliputi pembuatan, verifikasi, dan kalibrasi. Meskipun prompt meminta setidaknya 20 agen, sistem secara otonom memunculkan 25 sub-agen, memprioritaskan kebenaran dibanding ketaatan ketat pada jumlah yang diminta. Menarik untuk diamati bahwa sekitar lima agen bekerja aktif sekaligus sementara yang lain mengantre dan melanjutkan ketika sub-tugas sebelumnya selesai, yang menyiratkan adanya mekanisme penjadwalan internal.
Setiap agen pembuat menangani domain matematika yang berbeda dan menghasilkan lima soal dengan solusi langkah demi langkah, setelah itu 10 agen dialokasikan untuk verifikasi, dan kelompok yang lebih kecil sebanyak lima agen berfokus pada kalibrasi tingkat kesulitan.
Kekuatan yang menonjol di sini adalah pemisahan tanggung jawab yang jelas dan redundansi dalam verifikasi, yang secara nyata meningkatkan kualitas dataset. Kekurangan utamanya adalah latensi dan bottleneck berurutan.
Seluruh proses memakan waktu sekitar 20–25 menit, sehingga pendekatan ini lebih cocok untuk pembuatan tolok ukur berkualitas tinggi daripada iterasi cepat. Bahkan dengan 25 agen, beberapa agen harus menunggu yang lain selesai, yang berarti swarm masih dibatasi oleh logika langkah-langkahnya.
Meski begitu, kemampuan untuk menyesuaikan jumlah agen secara dinamis untuk setiap sub-tugas, menggunakan kembali agen yang menganggur, dan berkonsolidasi pada dataset berlabel merupakan demonstrasi kuat tentang bagaimana Agent Swarm berperilaku.
QA multimodal dalam skala besar
Selanjutnya, saya mendorong Kimi K2.5 ke alur kerja multimodal dengan memberikan beberapa gambar label nutrisi dan meminta perbandingan terstruktur. Tujuannya adalah melihat seberapa baik model mengekstrak, menormalkan, dan memverifikasi data visual.
Prompt:
I’m sharing images of nutrition labels from 7 packaged food items. Analyze them and produce a clear comparison specifically:
Extract fields like: calories, protein, total fat, sugar, sodium, from each label.Normalize all values to a per-100g basis so items are comparableDouble-check numeric consistency (e.g. serving size vs totals)Rank the products from healthiest to least healthy, explaining the reasoningReturn a comparison table with normalized values for all items. Also include a summary highlighting, best high-protein option, the lowest sugar option, and items to avoid and why.
Assume the labels may vary in format and serving size. Resolve ambiguities where possible and note any missing or unclear values.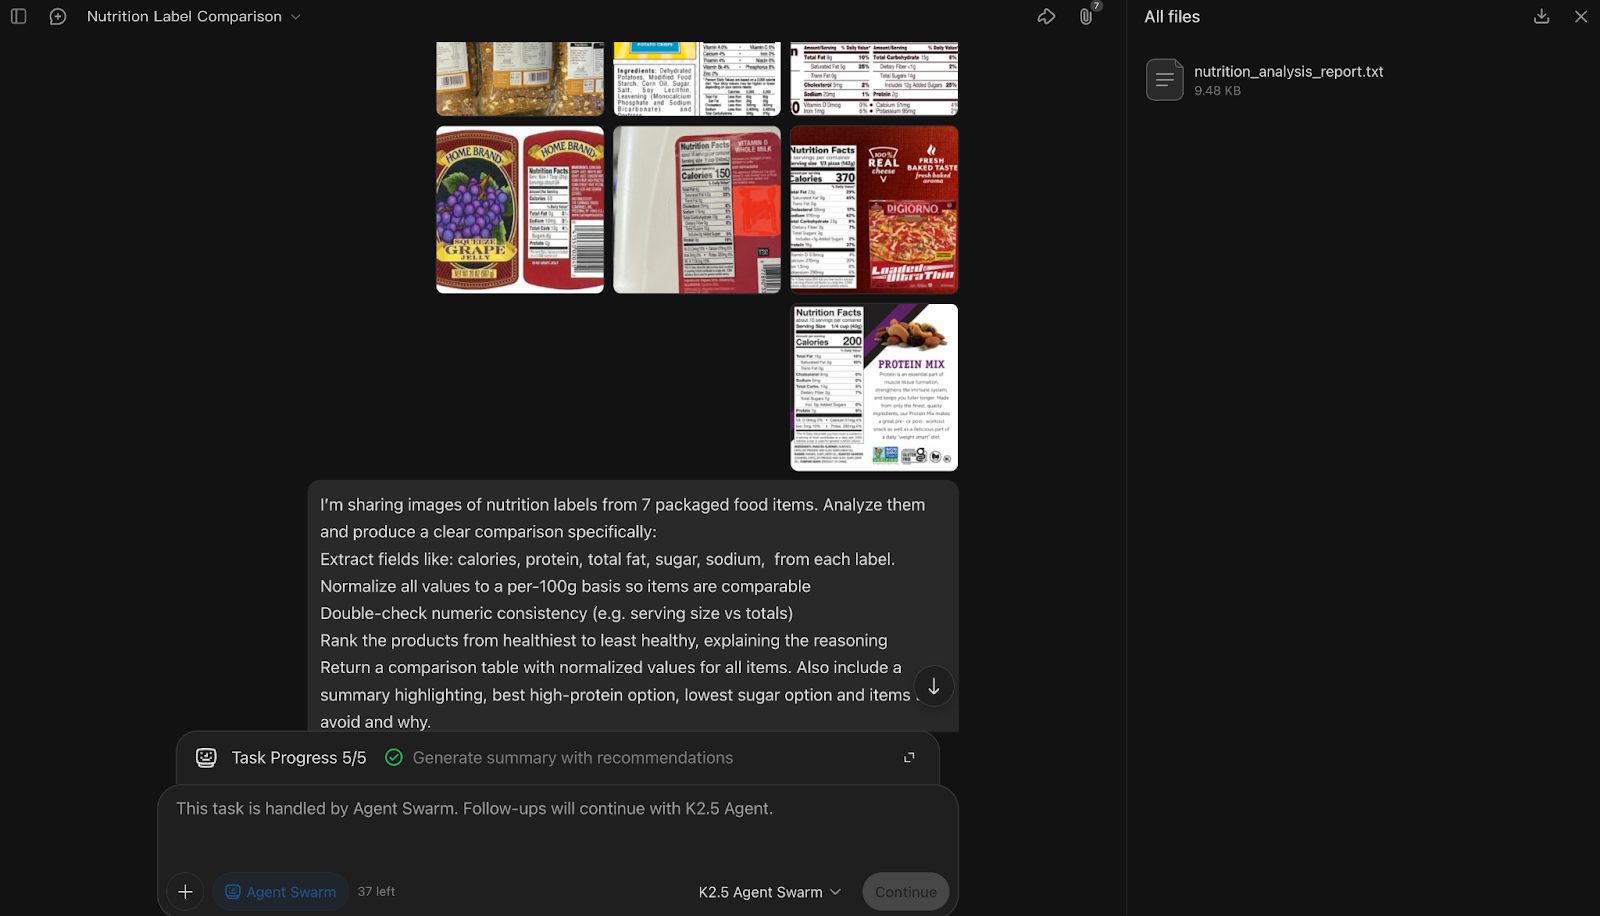
Dalam eksperimen QA multimodal ini, Kimi K2.5 Agent Swarm memecah tugas berdasarkan satu label per sub-agen, memunculkan tujuh sub-agen paralel untuk mengekstrak field nutrisi dari setiap gambar sementara agen koordinator menangani normalisasi, pemeriksaan silang, dan pemeringkatan.
Hal menarik dari Kimi adalah batasan yang Anda tentukan dalam prompt (ekstraksi, normalisasi, verifikasi, pemeringkatan) secara efektif menjadi cetak biru tentang bagaimana Kimi membuat dan menugaskan sub-agen.
Yang menonjol bagi saya adalah bagaimana swarm memperlakukan verifikasi sebagai langkah penting, yakni setelah ekstraksi, orkestrator secara eksplisit menyelaraskan ukuran saji, menormalkan nilai, dan menandai ambiguitas alih-alih menebak secara diam-diam. Langkah sintesis akhir, yang memberi peringkat produk dan menyebutkan opsi tinggi protein terbaik dan rendah gula terbaik, menunjukkan logika agregasi yang kuat di seluruh input visual.
Di sisi lain, menganalisis 7 gambar beresolusi tinggi dengan swarm menguras komputasi, menjadikannya fitur premium alih-alih alat chat cepat.
Contoh ini juga memperlihatkan keterbatasan saat ini; sementara analisis multimodal berbasis gambar berjalan baik, input video langsung belum didukung, sehingga upaya lanjutan untuk menghasilkan resep dari video memasak tidak dapat dijalankan.
Secara keseluruhan, demo ini menyoroti kekuatan Agent Swarm dalam ekstraksi visual paralel dan rekonsiliasi terstruktur.
Membuat kode sebuah gim
Terakhir, saya menguji kemampuan pengkodean Kimi K2.5 dengan memintanya membangun gim Bubble Shooter yang sepenuhnya interaktif dari awal. Eksperimen ini menyoroti bagaimana model menangani pembuatan kode end-to-end yang mempertahankan status, di mana koherensi lebih penting daripada paralelisme.
Prompt:
```markdown
Bangun gim Bubble Shooter yang sepenuhnya dapat dimainkan dan berjalan lokal di browser web. Gim harus mendukung bidikan menggunakan mouse dan sentuhan, menampilkan panduan bidik langsung, menembakkan gelembung berwarna dari tengah bawah, memantulkan tembakan dari dinding samping, dan menjepit gelembung ke kisi di bagian atas saat terjadi tumbukan.
Implementasikan logika permainan inti termasuk meledakkan kelompok tiga atau lebih gelembung terhubung dengan warna yang sama, menjatuhkan kluster yang terputus, melacak dan menampilkan skor, menampilkan pratinjau gelembung berikutnya, dan mengakhiri permainan saat gelembung melintasi garis bahaya dekat bagian bawah.
Jaga visual tetap sederhana namun responsif, sertakan tombol mulai ulang, dan akhiri dengan instruksi singkat tentang cara menjalankan dan menguji gim secara lokal.
```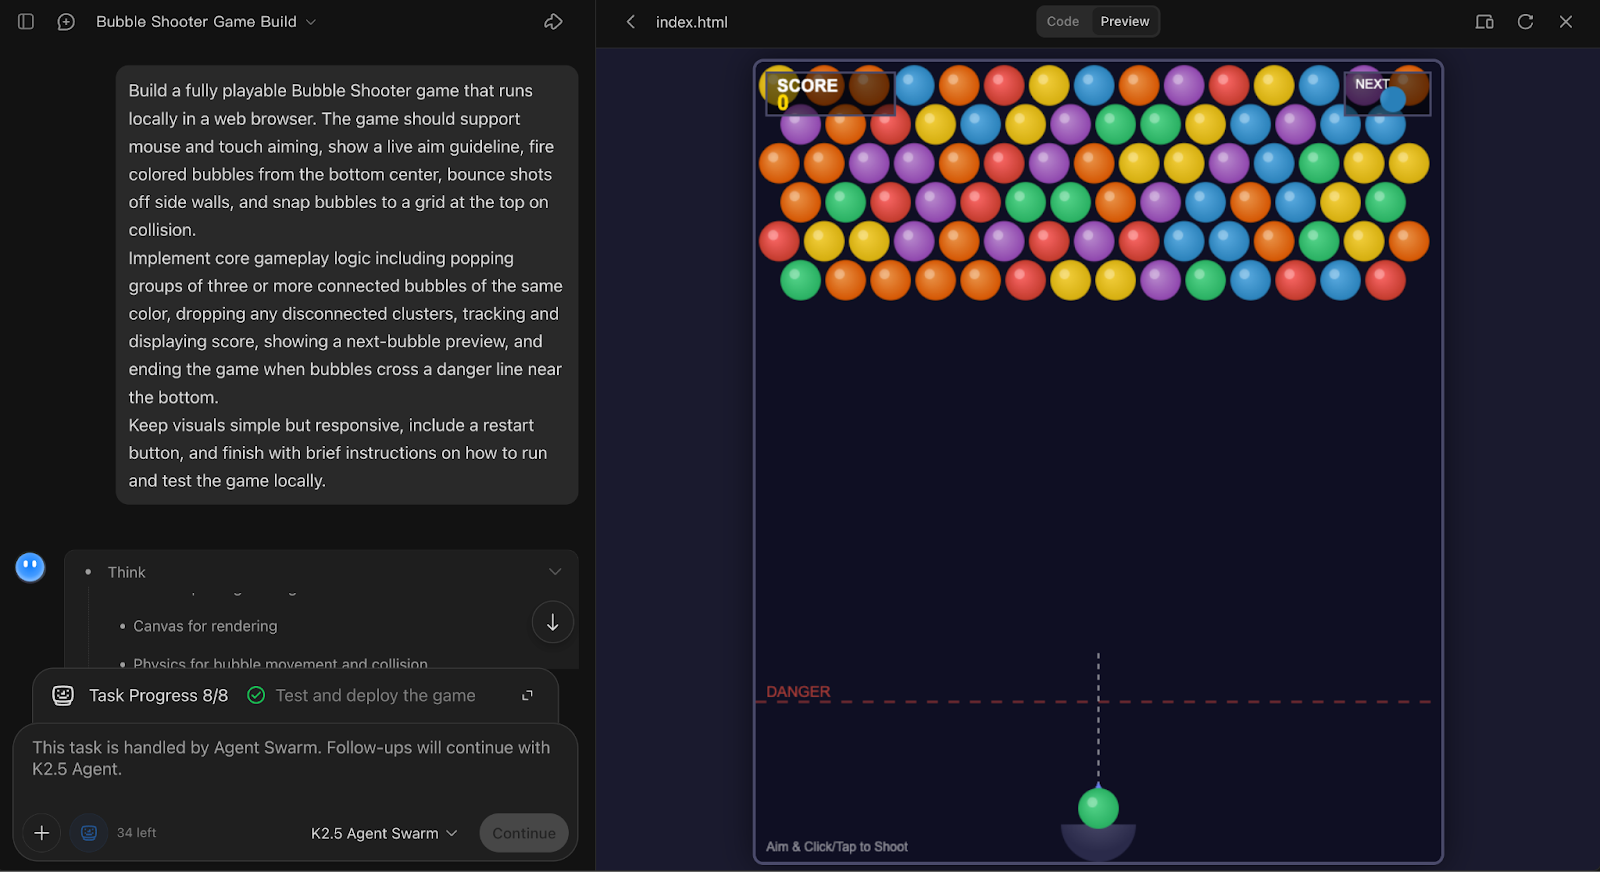
Dalam eksperimen pembuatan gim ini, Kimi K2.5 Agent Swarm membuat pilihan yang cukup konservatif dengan mengalokasikan hanya satu sub-agen untuk menangani seluruh tugas.
Keputusan itu sendiri merupakan observasi menarik karena sistem dengan tepat mengenali bahwa ini adalah masalah pengkodean yang saling terkait erat dan mempertahankan status, di mana paralelisme berat hanya akan menambah overhead koordinasi tanpa manfaat.
Agen tersebut menghasilkan implementasi Bubble Shooter yang lengkap dan dapat dijalankan secara lokal dengan bidikan, pantulan dinding, penjepitan ke kisi, pop tiga-cocok, pelacakan skor, dan logika mulai ulang, menampilkan mekanika permainan dan alur UI.
Yang saya sukai khususnya adalah output terasa koheren dan terintegrasi, namun trade-off-nya adalah penyempurnaan dan pemolesan kemungkinan memerlukan prompting iteratif, karena semuanya dijalankan melalui satu agen.
Secara keseluruhan, contoh ini dengan baik menunjukkan bahwa Agent Swarm di Kimi K2.5 bukan tentang selalu memunculkan lebih banyak agen, melainkan menggunakan paralelisme hanya ketika benar-benar meningkatkan hasil.
Kesimpulan
Dalam tutorial ini, Kimi K2.5 menunjukkan kemampuan untuk memecah tugas kompleks, mengalokasikan agen secara dinamis, dan menghasilkan output terstruktur yang siap diambil keputusan yang secara tradisional memerlukan sebuah tim kecil, bukan satu model saja.
Pada saat yang sama, contoh-contohnya memperjelas batasannya.
Agent Swarm unggul pada alur kerja yang luas dan berat alat seperti riset, konstruksi dataset, dan ekstraksi multimodal, tetapi menawarkan sedikit keunggulan untuk tugas yang saling terkait erat dan mempertahankan status seperti pengembangan gim interaktif.
Ini juga memperkenalkan trade-off nyata terkait latensi, biaya, dan kecepatan iterasi, terutama ketika verifikasi dan rekonsiliasi diprioritaskan daripada throughput mentah.
Secara keseluruhan, Kimi K2.5 menawarkan cetak biru meyakinkan untuk arah pengembangan sistem agen. Bagi pengembang dan peneliti yang nyaman bereksperimen dengan alur kerja berbasis agen, ini adalah salah satu model paling menarik untuk dieksplorasi saat ini.
Jika Anda ingin mempelajari lebih lanjut tentang cara kerja AI berbasis agen, saya sarankan melihat AI Agent Fundamentals skill track.
Kimi K2.5 dan FAQ Agent Swarm
Apakah Kimi K2.5 benar-benar sumber terbuka dan gratis digunakan?
Ya, Moonshot AI telah merilis Kimi K2.5 di bawah Modified MIT License dengan bobot tersedia di Hugging Face. Namun, karena ini adalah model besar dengan 1,04 triliun parameter (Mixture-of-Experts), menjalankannya secara lokal memerlukan perangkat keras kelas enterprise (misalnya, beberapa GPU H100). Bagi sebagian besar pengguna, API resmi atau Web UI adalah titik akses yang paling praktis.
Berapa harga API Kimi K2.5?
Kimi K2.5 menawarkan harga API yang kompetitif: $0,60 per 1M token input (turun menjadi $0,10 untuk input yang di-cache) dan $3,00 per 1M token output.
Apa perbedaan antara Chat Standar dan Agent Swarm?
Chat standar bersifat linear dan single-threaded. Agent Swarm adalah orkestrator paralel: ia dapat secara otonom memecah sebuah prompt menjadi sub-tugas dan memunculkan hingga 100 sub-agen spesialis untuk mengeksekusinya secara simultan. Swarm paling cocok untuk tugas "luas" seperti riset mendalam atau ekstraksi data massal, sedangkan Chat lebih baik untuk tugas berurutan yang mempertahankan status seperti membuat kode gim.
Apakah Kimi K2.5 mendukung input video?
Ya, model ini secara native bersifat multimodal dan mendukung input video hingga resolusi 2K. Meskipun unggul pada tolok ukur video konteks panjang (seperti LongVideoBench), fitur ini saat ini bersifat eksperimental, yang berarti sesekali dapat kesulitan mengikuti instruksi kompleks dalam alur kerja agen berbasis video dibandingkan gambar statis.
Berapa ukuran jendela konteks untuk Kimi K2.5?
Kimi K2.5 mendukung jendela konteks 256.000 token (sekitar 200.000 kata). Konteks yang sangat panjang ini memungkinkan model memproses seluruh buku, basis kode besar, atau dokumen hukum panjang dalam satu kali proses tanpa perlu membagi data, yang krusial untuk menjaga akurasi dalam swarm besar.

Saya adalah Google Developers Expert di ML (Gen AI), Kaggle 3x Expert, dan Women Techmakers Ambassador dengan pengalaman lebih dari 3 tahun di bidang teknologi. Saya ikut mendirikan startup health-tech pada 2020 dan sedang menempuh studi magister ilmu komputer di Georgia Tech dengan spesialisasi machine learning.


Kimi K2.5 adalah model multimodal sumber terbuka dari Moonshot AI yang dibangun untuk alur kerja berbasis agen, bukan sekadar chat. Alih-alih merespons prompt yang terpisah, model ini dapat memecah tugas kompleks, mengoordinasikan penggunaan alat, dan menghasilkan output terstruktur seperti tabel, laporan, rencana, dan kode, di sepanjang alur kerja multi-langkah.
Yang membuat Kimi K2.5 sangat menarik adalah Agent Swarm. Mode swakelola di mana model dapat secara dinamis memunculkan dan mengorkestrasi banyak sub-agen secara paralel untuk mempercepat riset, verifikasi, dan eksekusi.
Dalam tutorial ini, saya akan membahas apa itu Kimi K2.5 dan di mana ia berkinerja baik, lalu berfokus pada empat eksperimen langsung yang menunjukkan bagaimana Agent Swarm berperilaku dalam praktik, termasuk yang mengesankan, di mana kekurangannya, dan kapan model ini benar-benar mengungguli pengaturan agen tunggal.
Apa Itu Kimi K2.5?
Kimi K2.5 adalah model multimodal asli sumber terbuka dari Moonshot AI yang dibangun untuk menangani teks, gambar, video, dan dokumen dalam satu sistem. Model ini memperluas Kimi K2 dengan pretraining lanjutan pada sekitar 15T token campuran teks dan visual, dan dirancang untuk beroperasi bukan hanya sebagai chatbot, tetapi sebagai sistem berbasis agen yang dapat merencanakan, menggunakan alat, dan (dalam mode swarm) mengeksekusi tugas secara paralel.
Dalam praktiknya, Kimi K2.5 menonjol dalam tiga hal:
Sumber: Kimi K2.5
Plot di atas merangkum kinerja Kimi K2.5 di empat kategori: Agents, Coding, Image, dan Video, dengan Kimi ditampilkan dalam warna biru dan model frontier terkemuka lainnya sebagai batang abu-abu.
Anda dapat mencoba Kimi K2.5 dengan beberapa cara:
https://platform.moonshot.aiUntuk tolok ukur yang dapat direproduksi, Moonshot merekomendasikan menggunakan API resmi atau penyedia terverifikasi melalui Kimi Vendor Verifier.
Apa itu Agent Swarm di Kimi K2.5?
Sebagian besar pengaturan multi-agen saat ini masih dibuat secara manual; Anda mendefinisikan peran, menyusun alur kerja, dan berharap orkestrasi tetap andal saat tugas membesar. Kimi K2.5 Agent Swarm membalik model tersebut.
Alih-alih mendefinisikan agen dan pipeline terlebih dahulu, K2.5 dapat mengarahkan swarm secara mandiri, memutuskan kapan melakukan paralelisasi, berapa banyak agen yang dipanggil, alat apa yang digunakan, dan bagaimana menggabungkan hasil, berdasarkan tugas itu sendiri.
Ia dapat secara otonom membuat dan mengoordinasikan swarm hingga 100 sub-agen, mengeksekusi alur kerja paralel hingga 1.500 pemanggilan alat, tanpa peran yang didefinisikan sebelumnya.
Bagaimana cara kerja Kimi K2.5 Agent Swarm?
Di balik layar, Agent Swarm memperkenalkan orkestrator yang dapat dilatih yang belajar memecah pekerjaan menjadi sub-tugas paralel dan menjadwalkannya secara efisien:
Mengapa PARL (Parallel-Agent Reinforcement Learning) penting
Perilaku swarm Kimi K2.5 dilatih menggunakan Parallel-Agent Reinforcement Learning (PARL), sebuah pengaturan pelatihan yang menjadikan paralelisme sebagai keterampilan yang dapat dipelajari. Ini penting karena sistem multi-agen yang naif sering gagal dengan dua cara:
PARL mengatasi hal ini dengan membentuk reward selama pelatihan. Ia mendorong paralelisme di awal dan secara bertahap mengalihkan optimisasi menuju kualitas tugas end-to-end, sehingga mencegah paralelisme semu. Untuk membuat optimisasi sadar latensi, K2.5 mengevaluasi kinerja menggunakan Critical Steps karena memunculkan lebih banyak agen hanya membantu jika benar-benar mempersingkat jalur eksekusi paling lambat alih-alih meningkatkan overhead koordinasi.
Ketika tugasnya luas dan berat penggunaan alat, Agent Swarm dapat secara signifikan mengurangi waktu menuju output. Moonshot melaporkan bahwa, dibandingkan pengaturan agen tunggal, K2.5 Swarm dapat memangkas waktu eksekusi sekitar 3x hingga 4,5x, dan evaluasi internal menunjukkan hingga ~80% pengurangan runtime end-to-end pada beban kerja kompleks melalui paralelisasi yang nyata.
Contoh dan Observasi Kimi K2.5
Di bagian ini, saya akan membagikan pengalaman langsung saya menguji Kimi K2.5 Agent Swarm di berbagai skenario. Setiap contoh menyoroti bagaimana swarm memecah tugas, mengalokasikan agen, serta di mana pendekatan ini benar-benar membantu atau kurang dalam praktik.
Swarm riset
Untuk eksperimen pertama, saya menguji apakah Kimi K2.5 Agent Swarm dapat menangani tugas dunia nyata bernilai tinggi seperti menyusun rencana deployment untuk LLM sumber terbuka.
Prompt:
Dalam demo ini, Kimi K2.5 Agent Swarm segera memecah prompt menjadi jalur riset paralel dan memunculkan tiga sub-agen khusus, yaitu
InferenceStackResearcher,QuantizationHardwareResearcher, danCostControlResearcher. Sementara setiap nama sub-agen merujuk pada pekerjaan yang dialokasikan, selanjutnya pekerjaan disebarkan ke beragam persona pekerja.Hal yang paling saya sukai adalah bagaimana output akhir berupa tabel perbandingan yang rapi untuk inference stack, beserta rekomendasi ringkas dan catatan untuk kuantisasi. Anda juga dapat menggunakan bilah progres tugas untuk melihat bagaimana pekerjaan dipecah sejak awal dan setiap sub-tugas dilacak hingga selesai.