

हालाँकि, कमी यह रही कि अंतिम लेखन में कुछ दावे कम उद्धृत लगे या बहुत निर्णायक थे, और चूँकि प्रोडक्शन सलाह अत्यधिक संदर्भ-निर्भर होती है, इसलिए लिंक, स्रोत और स्पष्ट मान्यताओं (हार्डवेयर, मॉडल आकार, बैच आकार, कॉन्टेक्स्ट लंबाई) के साथ यह गाइड और मज़बूत होता। कुल मिलाकर, इसने एक जटिल, बहु-भाग प्रॉम्प्ट को संभाला और एक सटीक, तुरंत उपयोगी प्लेबुक लौटाई जो प्रोडक्शन-रेडी लगती है।
डेटासेट निर्माण और एनोटेशन
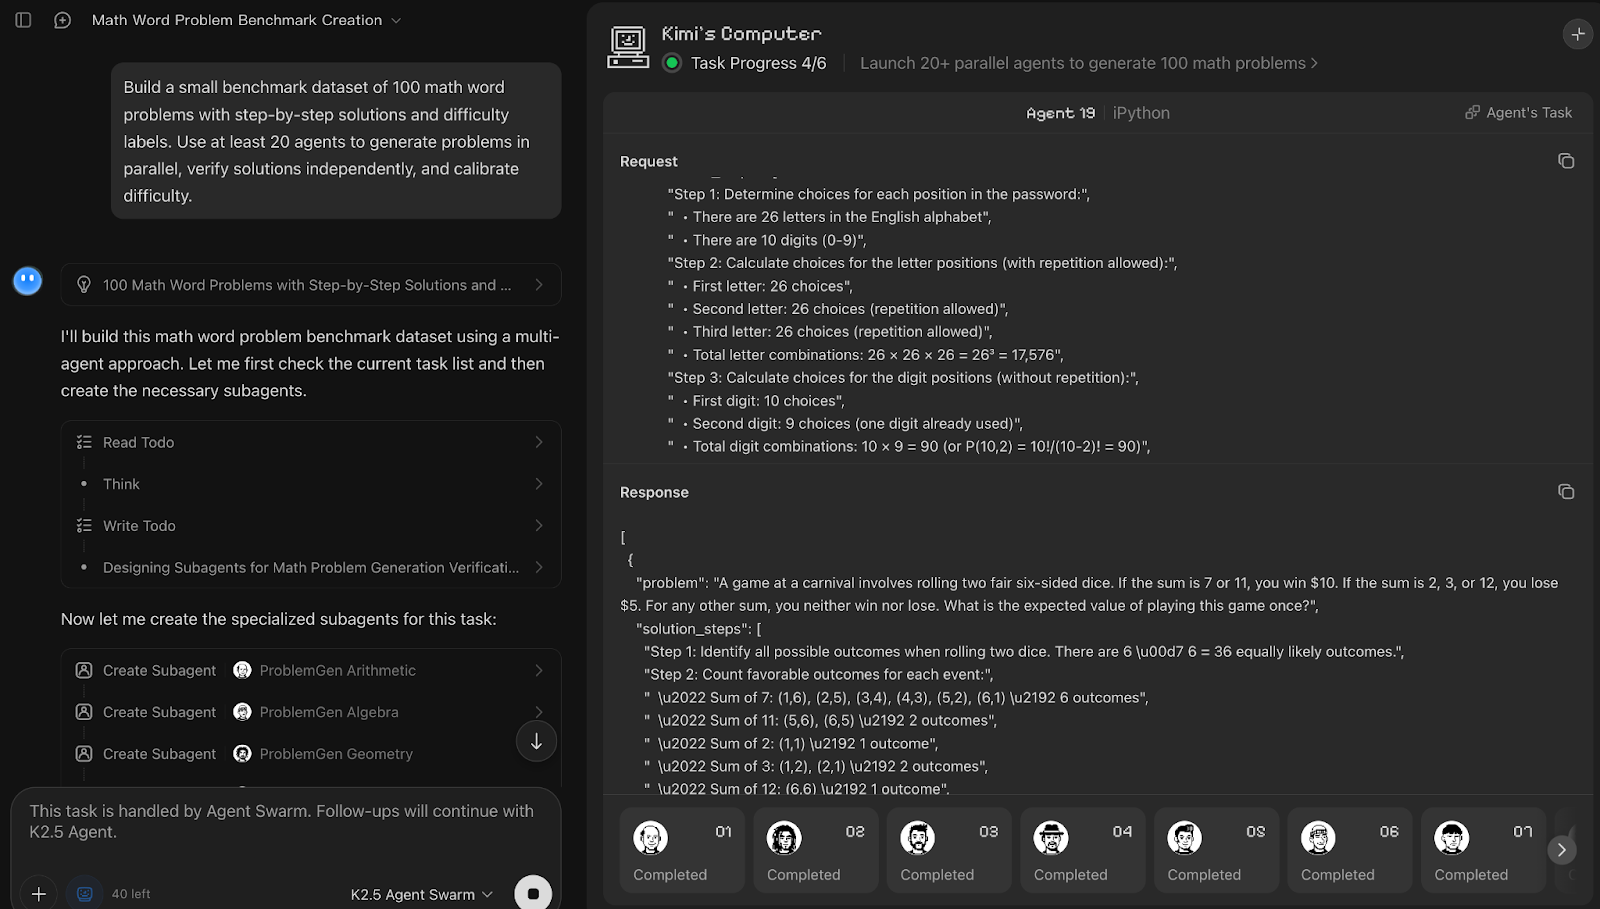
इसके बाद, मैंने Kimi K2.5 से 100-आइटम का गणितीय वर्ड-प्रॉब्लम बेंचमार्क समाधान और कठिनाई लेबल्स सहित जनरेट करवाकर एजेंट स्वॉर्म का डेटासेट-बिल्डिंग कार्य पर परीक्षण किया। मैंने स्पष्ट रूप से 20 एजेंट्स का अनुरोध भी किया ताकि देखा जा सके कि यह स्वॉर्म-आकार बाधा का पालन करते हुए गुणवत्ता कैसे बनाए रखता है।
प्रॉम्प्ट:
Build a small benchmark dataset of 100 math word problems with step-by-step solutions and difficulty labels. Use at least 20 agents to generate problems in parallel, verify solutions independently, and calibrate difficulty.Kimi K2.5 Agent Swarm ने डेटासेट निर्माण को तीन-चरणीय पाइपलाइन—जनरेशन, वेरिफिकेशन और कैलिब्रेशन—के रूप में लिया। यद्यपि प्रॉम्प्ट में कम-से-कम 20 एजेंट्स मांगे गए थे, सिस्टम ने स्वायत्त रूप से 25 उप-एजेंट्स स्पॉन किए, और अनुरोधित संख्या के कड़े पालन के बजाय शुद्धता को प्राथमिकता दी। यह देखना दिलचस्प था कि लगभग पाँच एजेंट एक समय में सक्रिय रूप से काम कर रहे थे जबकि अन्य कतार में थे और पहले के उप-कार्य पूर्ण होते ही फिर शुरू हो जाते थे, जो एक आंतरिक शेड्यूलिंग मैकेनिज़्म का संकेत देता है।
प्रत्येक जनरेशन एजेंट ने एक अलग गणितीय डोमेन संभाला और चरण-दर-चरण समाधानों के साथ पाँच समस्याएँ बनाई, जिसके बाद 10 एजेंट्स वेरिफिकेशन को सौंपे गए, और पाँच एजेंट्स के छोटे सेट ने कठिनाई कैलिब्रेशन पर ध्यान केंद्रित किया।
यहाँ की प्रमुख ताकत चिंताओं का स्पष्ट पृथक्करण और वेरिफिकेशन में रिडंडेंसी है, जो डेटासेट गुणवत्ता को ठोस रूप से सुधारती है। मुख्य कमी विलंबता और एक सीक्वेन्शियल बाधा है।
पूरी रन लगभग 20–25 मिनट लगी, जिससे यह तरीका तेज़ इटरेशन की तुलना में उच्च-गुणवत्ता बेंचमार्क निर्माण के लिए अधिक उपयुक्त है। 25 एजेंट्स होने पर भी, कुछ एजेंट्स को दूसरों के समाप्त होने की प्रतीक्षा करनी पड़ी, यानी स्वॉर्म अभी भी चरणों की तर्क-श्रृंखला से सीमित है।
फिर भी, प्रत्येक उप-कार्य के लिए एजेंट संख्या को गतिशील रूप से समायोजित करना, निष्क्रिय एजेंट्स का पुन: उपयोग, और एक लेबलयुक्त डेटासेट पर अभिसरण करने की क्षमता Agent Swarm के व्यवहार का एक मज़बूत प्रदर्शन है।
स्केल पर मल्टीमोडल QA
अगले चरण में, मैंने कई न्यूट्रिशन-लेबल इमेज देकर और संरचित तुलना माँगकर Kimi K2.5 को एक मल्टीमोडल वर्कफ़्लो में धकेला। लक्ष्य यह देखना था कि यह विज़ुअल डेटा को कितना अच्छी तरह निकाल, सामान्यीकृत और सत्यापित कर सकता है।
प्रॉम्प्ट:
I’m sharing images of nutrition labels from 7 packaged food items. Analyze them and produce a clear comparison specifically:
Extract fields like: calories, protein, total fat, sugar, sodium, from each label.Normalize all values to a per-100g basis so items are comparableDouble-check numeric consistency (e.g. serving size vs totals)Rank the products from healthiest to least healthy, explaining the reasoningReturn a comparison table with normalized values for all items. Also include a summary highlighting, best high-protein option, the lowest sugar option, and items to avoid and why.
Assume the labels may vary in format and serving size. Resolve ambiguities where possible and note any missing or unclear values.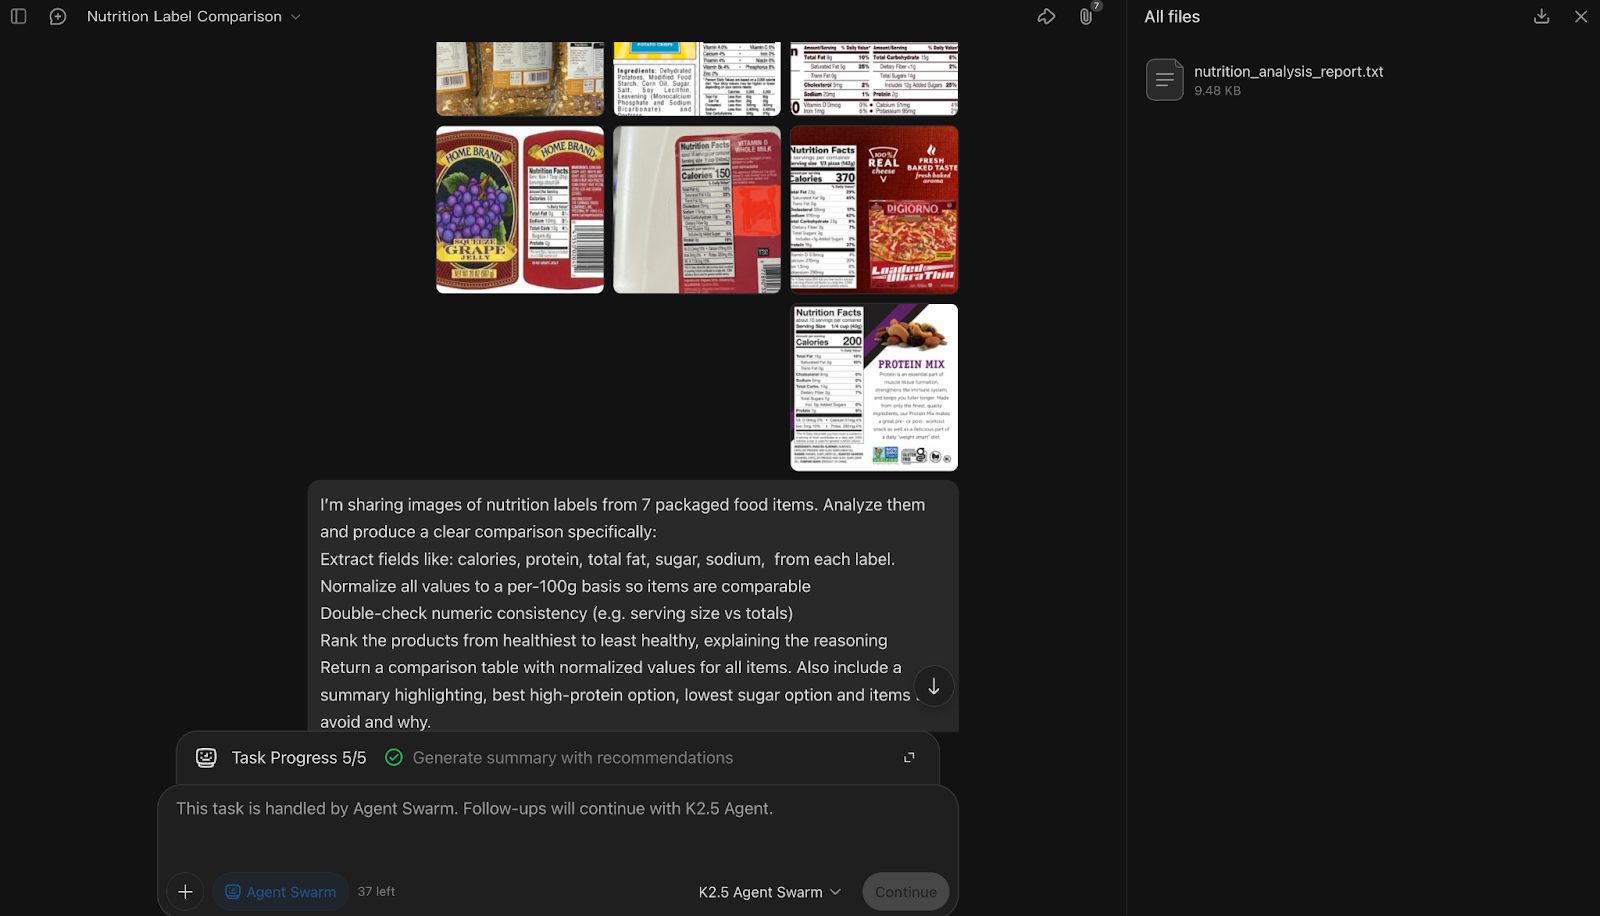
इस मल्टीमोडल QA प्रयोग में, Kimi K2.5 Agent Swarm ने कार्य को एक लेबल प्रति उप-एजेंट के इर्दगिर्द विभाजित किया, सात समानांतर उप-एजेंट्स स्पॉन किए ताकि प्रत्येक इमेज से पोषण-संबंधी फ़ील्ड्स निकाली जाएँ, जबकि एक समन्वयक एजेंट सामान्यीकरण, क्रॉस-चेकिंग और रैंकिंग संभाल रहा था।
Kimi की एक दिलचस्प बात यह है कि आप प्रॉम्प्ट में जिन बाधाओं को निर्दिष्ट करते हैं (एक्सट्रैक्शन, नॉर्मलाइज़ेशन, वेरिफिकेशन, रैंकिंग) वे प्रभावी रूप से इस बात की रूपरेखा बन जाती हैं कि Kimi उप-एजेंट्स को कैसे इंस्टैंशिएट और असाइन करता है।
मेरे लिए जो बात उभर कर आई, वह यह कि स्वॉर्म ने वेरिफिकेशन को एक महत्वपूर्ण चरण माना—अर्थात, एक्सट्रैक्शन के बाद, ऑर्केस्ट्रेटर ने स्पष्ट रूप से सर्विंग साइज का मिलान किया, मूल्यों को सामान्यीकृत किया, और अनिश्चितताओं को चिह्नित किया, बिना चुपचाप अनुमान लगाए। अंतिम सिंथेसिस चरण, जिसने उत्पादों को रैंक किया और सर्वश्रेष्ठ हाई-प्रोटीन तथा लो-शुगर विकल्पों को उजागर किया, ने विज़ुअल इनपुट्स के पार मज़बूत एग्रीगेशन लॉजिक का प्रदर्शन किया।
दूसरी ओर, 7 हाई-रेज़ इमेज का स्वॉर्म के साथ विश्लेषण कम्प्यूट-भारी है, जिससे यह त्वरित-चैट टूल के बजाय एक प्रीमियम फ़ीचर बन जाता है।
इस उदाहरण ने एक वर्तमान सीमा भी उजागर की; जबकि इमेज-आधारित मल्टीमोडल विश्लेषण अच्छी तरह काम किया, प्रत्यक्ष वीडियो इनपुट समर्थित नहीं था, इसलिए कुकिंग वीडियो से रेसिपी जनरेट करने का फ़ॉलो-अप प्रयास निष्पादित नहीं हो सका।
कुल मिलाकर, यह डेमो समानांतर विज़ुअल एक्सट्रैक्शन और संरचित समेटने (reconciliation) में Agent Swarm की ताकत को उजागर करता है।
एक गेम का कोडिंग
अंत में, मैंने Kimi K2.5 की कोडिंग क्षमताओं का परीक्षण इसे शून्य से एक पूरी तरह इंटरैक्टिव Bubble Shooter गेम बनाने को कहकर किया। यह प्रयोग दिखाता है कि मॉडल एंड-टू-एंड, स्टेटफुल कोड जनरेशन को कैसे संभालता है, जहाँ समानांतरता से अधिक सामंजस्य (coherence) मायने रखता है।
प्रॉम्प्ट:
```markdown
एक पूरी तरह खेलने योग्य Bubble Shooter गेम बनाएँ जो स्थानीय रूप से वेब ब्राउज़र में चलता हो। गेम में माउस और टच एमिंग का समर्थन हो, लाइव ऐम गाइडलाइन दिखाए, निचले केंद्र से रंगीन बबल्स दागे, साइड वॉल्स से शॉट्स उछले, और टकराव पर बबल्स ऊपर की ग्रिड में स्नैप हो जाएँ।
कोर गेमप्ले लॉजिक लागू करें, जिसमें एक ही रंग के तीन या अधिक जुड़े बबल्स के समूह पॉप करना, किसी भी डिसकनेक्टेड क्लस्टर को गिराना, स्कोर को ट्रैक और दिखाना, अगली बबल प्रीव्यू दिखाना, और जब बबल्स नीचे के नज़दीक एक डेंजर लाइन को पार करें तो गेम समाप्त करना शामिल हो।
विज़ुअल्स को सरल लेकिन रिस्पॉन्सिव रखें, रीस्टार्ट बटन शामिल करें, और अंत में स्थानीय रूप से गेम कैसे चलाएँ और परीक्षण करें, उस पर संक्षिप्त निर्देश दें।
```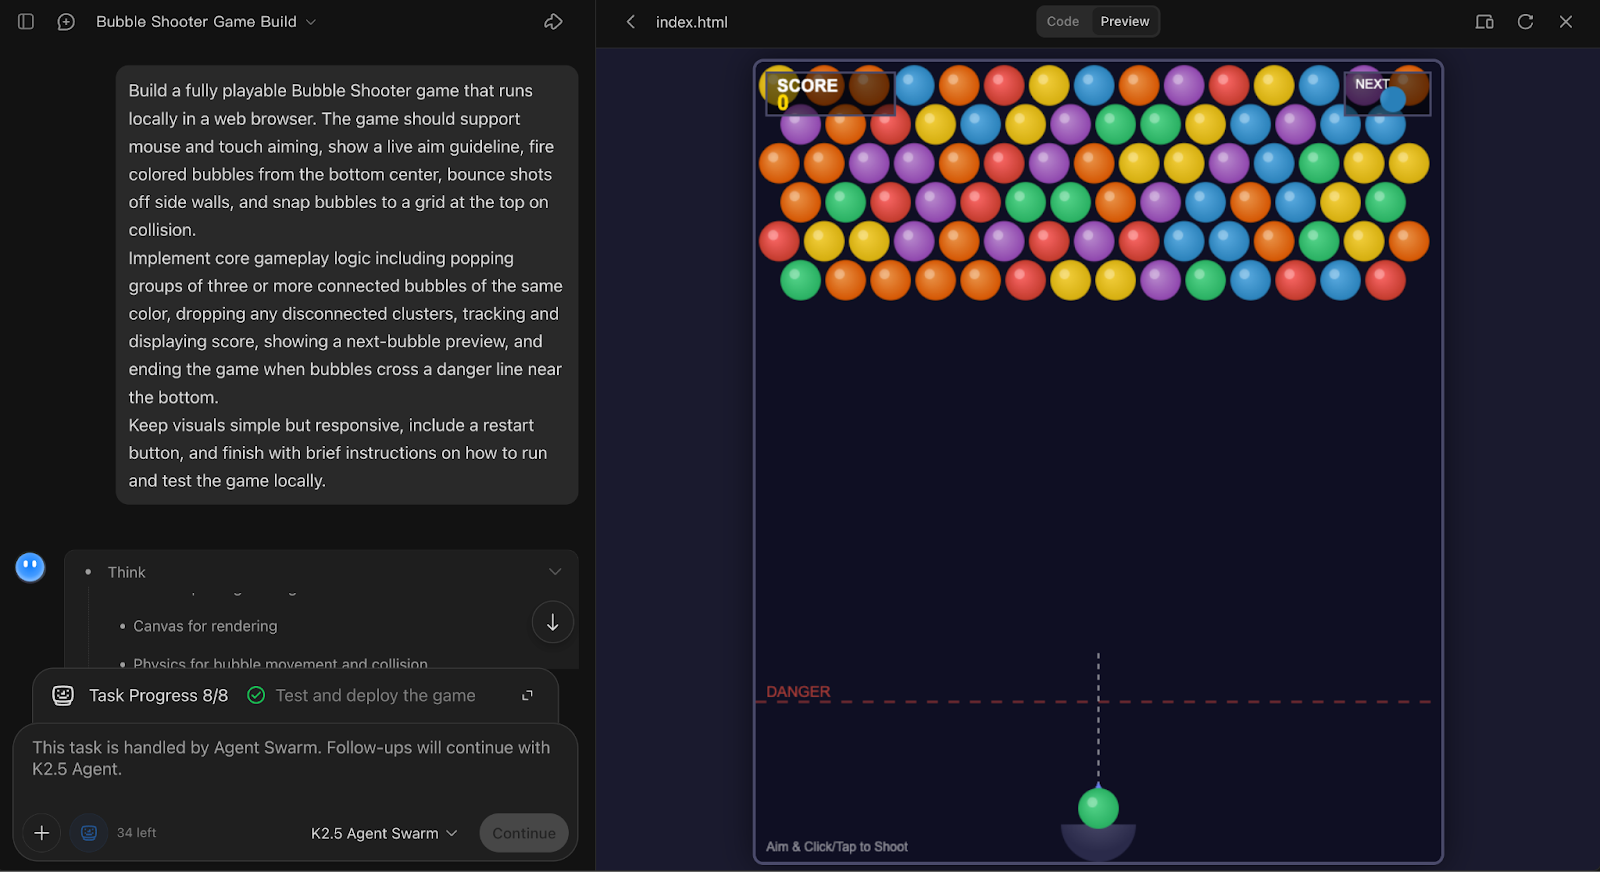
इस गेम-बिल्डिंग प्रयोग में, Kimi K2.5 Agent Swarm ने पूरे कार्य को संभालने के लिए सिर्फ एक उप-एजेंट आवंटित कर एक उल्लेखनीय रूप से रक्षात्मक विकल्प चुना।
स्वयं यह निर्णय एक दिलचस्प अवलोकन है क्योंकि सिस्टम ने सही पहचाना कि यह एक कड़ी तरह से युग्मित, स्टेटफुल कोडिंग समस्या है, जहाँ भारी समानांतरता किसी लाभ के बिना समन्वय ओवरहेड जोड़ देगी।
एजेंट ने एमिंग, वॉल बाउंसेज़, ग्रिड स्नैपिंग, मैच-थ्री पॉपिंग, स्कोर ट्रैकिंग, और रीस्टार्ट लॉजिक सहित एक पूर्ण, लोकली चलने योग्य Bubble Shooter इम्प्लीमेंटेशन बनाया, जो गेमप्ले मैकेनिक्स और UI फ़्लो दोनों दिखाता है।
मुझे विशेष रूप से यह अच्छा लगा कि आउटपुट सुसंगत और इंटीग्रेटेड लगा, लेकिन समझौता यह है कि चूँकि सब कुछ एक ही एजेंट से होकर गुजरता है, इसलिए परिष्कार और पॉलिश के लिए संभवतः आवर्ती प्रॉम्प्टिंग की आवश्यकता होगी।
कुल मिलाकर, यह उदाहरण अच्छी तरह दर्शाता है कि Kimi K2.5 में Agent Swarm हमेशा अधिक एजेंट्स स्पॉन करने के बारे में नहीं है, बल्कि केवल तब समानांतरता का उपयोग करने के बारे में है जब यह वास्तव में परिणामों को बेहतर बनाती है।
निष्कर्ष
इस ट्यूटोरियल में, Kimi K2.5 ने जटिल कार्यों को तोड़ने, एजेंट्स को गतिशील रूप से आवंटित करने, और संरचित, निर्णय-तैयार आउटपुट बनाने की क्षमता प्रदर्शित की—जो पारंपरिक रूप से एक छोटे दल की आवश्यकता होती, न कि एकल मॉडल की।
इसी समय, उदाहरण इसकी सीमाएँ भी स्पष्ट करते हैं।
Agent Swarm शोध, डेटासेट निर्माण और मल्टीमोडल एक्सट्रैक्शन जैसे व्यापक, टूल-प्रधान वर्कफ़्लो पर उत्कृष्ट है, लेकिन इंटरैक्टिव गेम डेवलपमेंट जैसे कड़ी तरह से युग्मित, स्टेटफुल कार्यों के लिए कम लाभ देता है।
यह विलंबता, लागत और इटरेशन गति के इर्दगिर्द वास्तविक समझौते भी पेश करता है, खासकर जब वेरिफिकेशन और रीकन्सिलिएशन को रॉ थ्रूपुट पर प्राथमिकता दी जाती है।
कुल मिलाकर, Kimi K2.5 एजेंटिक सिस्टम्स के भविष्य के लिए एक प्रभावी ब्लूप्रिंट प्रदान करता है। डेवलपर्स और शोधकर्ताओं के लिए जो एजेंट-आधारित वर्कफ़्लो के साथ प्रयोग करने में सहज हैं, यह आज खोजने के लिए सबसे दिलचस्प मॉडलों में से एक है।
यदि आप यह जानने के इच्छुक हैं कि एजेंटिक AI कैसे काम करता है, तो मैं AI Agent Fundamentals स्किल ट्रैक देखने की सलाह देता/देती हूँ।
Kimi K2.5 और Agent Swarm FAQs
क्या Kimi K2.5 वास्तव में ओपन सोर्स और उपयोग के लिए मुफ़्त है?
हाँ, Moonshot AI ने Kimi K2.5 को Modified MIT License के तहत जारी किया है और वेट्स Hugging Face पर उपलब्ध हैं। हालाँकि, यह एक विशाल 1.04 ट्रिलियन पैरामीटर मॉडल (Mixture-of-Experts) है, इसलिए इसे लोकली चलाने के लिए एंटरप्राइज़-ग्रेड हार्डवेयर (जैसे, कई H100 GPUs) की आवश्यकता होती है। अधिकांश उपयोगकर्ताओं के लिए, आधिकारिक API या वेब UI सबसे व्यावहारिक एक्सेस पॉइंट है।
Kimi K2.5 का API प्राइसिंग क्या है?
Kimi K2.5 प्रतिस्पर्धी API प्राइसिंग प्रदान करता है: $0.60 प्रति 1M इनपुट टोकन (कैश्ड इनपुट्स के लिए घटकर $0.10) और $3.00 प्रति 1M आउटपुट टोकन।
स्टैंडर्ड चैट और Agent Swarm में क्या अंतर है?
स्टैंडर्ड चैट रैखिक और सिंगल-थ्रेडेड है। Agent Swarm एक समानांतर ऑर्केस्ट्रेटर है: यह स्वायत्त रूप से किसी प्रॉम्प्ट को उप-कार्यों में तोड़ सकता है और उन्हें एक साथ निष्पादित करने के लिए 100 विशेषीकृत उप-एजेंट्स तक स्पॉन कर सकता है। स्वॉर्म गहन शोध या बल्क डेटा एक्सट्रैक्शन जैसे "विस्तृत" कार्यों के लिए उपयुक्त है, जबकि चैट इंटरैक्टिव गेम कोडिंग जैसे स्टेटफुल, क्रमिक कार्यों के लिए बेहतर है।
क्या Kimi K2.5 वीडियो इनपुट का समर्थन करता है?
हाँ, मॉडल नैटिव रूप से मल्टीमोडल है और 2K रेज़ोल्यूशन तक वीडियो इनपुट का समर्थन करता है। जबकि यह लंबे-कॉन्टेक्स्ट वीडियो बेंचमार्क्स (जैसे LongVideoBench) पर उत्कृष्ट है, यह सुविधा वर्तमान में प्रायोगिक है, यानी वीडियो-आधारित एजेंट वर्कफ़्लो में जटिल निर्देशों का पालन करते समय यह कभी-कभी स्थिर इमेज की तुलना में संघर्ष कर सकता है।
Kimi K2.5 की कॉन्टेक्स्ट विंडो साइज क्या है?
Kimi K2.5 256,000 टोकन कॉन्टेक्स्ट विंडो (लगभग 200,000 शब्द) का समर्थन करता है। यह अल्ट्रा-लॉन्ग कॉन्टेक्स्ट मॉडल को पूरी किताबें, विशाल कोडबेस, या लंबे कानूनी दस्तावेज़ एक ही पास में प्रोसेस करने देता है, बिना डेटा को टुकड़ों में बाँटने की ज़रूरत के—जो बड़े स्वॉर्म्स में सटीकता बनाए रखने के लिए अहम है।

मैं एमएल (Gen AI) में Google Developers Expert, Kaggle 3x Expert, और Women Techmakers एंबेसडर हूँ, तथा तकनीक क्षेत्र में 3+ वर्षों का अनुभव रखती हूँ। मैंने 2020 में एक हेल्थ-टेक स्टार्टअप की सह-स्थापना की और वर्तमान में Georgia Tech से कंप्यूटर विज्ञान में मास्टर कर रही हूँ, जिसमें मेरा विशेषज्ञता क्षेत्र मशीन लर्निंग है।
Kimi K2.5 Moonshot AI का एक मुक्त-स्रोत, मल्टीमोडल मॉडल है, जिसे सिर्फ चैट के बजाय एजेंटिक वर्कफ़्लो के लिए बनाया गया है। अलग-थलग प्रॉम्प्ट्स का जवाब देने के बजाय, यह जटिल कार्यों को तोड़ सकता है, टूल उपयोग का समन्वय कर सकता है, और बहु-चरणीय वर्कफ़्लो में तालिकाओं, रिपोर्टों, योजनाओं और कोड जैसे संरचित आउटपुट बना सकता है।
Kimi K2.5 को विशेष रूप से दिलचस्प बनाता है Agent Swarm—एक स्व-निर्देशित मोड, जहाँ मॉडल शोध, सत्यापन और एक्ज़िक्यूशन को तेज़ करने के लिए समानांतर में कई उप-एजेंट्स को गतिशील रूप से शुरू और ऑर्केस्ट्रेट कर सकता है।
इस ट्यूटोरियल में, मैं बताऊँगा कि Kimi K2.5 क्या है और यह कहाँ अच्छा प्रदर्शन करता है, फिर चार हाथ-से-हाथ प्रयोगों पर ध्यान दूँगा जो दिखाते हैं कि Agent Swarm व्यावहारिक रूप से कैसा व्यवहार करता है—यह क्या प्रभावशाली करता है, कहाँ कम पड़ता है, और कब यह वास्तव में सिंगल-एजेंट सेटअप को मात देता है।
Kimi K2.5 क्या है?
Kimi K2.5 Moonshot AI का मुक्त-स्रोत, नैटिव मल्टीमोडल मॉडल है, जिसे एक ही सिस्टम में टेक्स्ट, इमेज, वीडियो और दस्तावेज़ संभालने के लिए बनाया गया है। यह Kimi K2 को लगभग 15T मिश्रित टेक्स्ट और विजुअल टोकन पर निरंतर प्रीट्रेनिंग से विस्तारित करता है, और इसे सिर्फ चैटबॉट नहीं बल्कि एक एजेंटिक सिस्टम के रूप में डिज़ाइन किया गया है जो योजना बना सकता है, टूल्स का उपयोग कर सकता है, और (स्वॉर्म मोड में) कार्यों को समानांतर में निष्पादित कर सकता है।
व्यवहार में, Kimi K2.5 तीन बातों के लिए अलग दिखता है:
स्रोत: Kimi K2.5
ऊपर दिए प्लॉट्स Kimi K2.5 के प्रदर्शन को चार श्रेणियों—एजेंट्स, कोडिंग, इमेज और वीडियो—में संक्षेपित करते हैं, जहाँ Kimi नीले रंग में और अन्य प्रमुख फ्रंटियर मॉडेल ग्रे बार्स में दिखाए गए हैं।
आप Kimi K2.5 को कई तरीकों से आज़मा सकते हैं:
https://platform.moonshot.aiपुनरुत्पाद्य बेंचमार्क्स के लिए, Moonshot आधिकारिक API या Kimi Vendor Verifier के माध्यम से सत्यापित प्रदाताओं का उपयोग करने की अनुशंसा करता है।
Kimi K2.5 में Agent Swarm क्या है?
आज अधिकांश मल्टी-एजेंट सेटअप अब भी हाथ से बनाए जाते हैं; आप भूमिकाएँ परिभाषित करते हैं, एक वर्कफ़्लो वायर करते हैं, और उम्मीद करते हैं कि जैसे-जैसे कार्य बड़े हों, ऑर्केस्ट्रेशन टिका रहे। Kimi K2.5 Agent Swarm इस मॉडल को पलट देता है।
एजेंट्स और पाइपलाइन्स को पहले से परिभाषित करने के बजाय, K2.5 स्वयं-निर्देशित स्वॉर्म बना सकता है, जो कार्य के आधार पर तय करता है कि कब पैरेललाइज़ करना है, कितने एजेंट स्पॉन करने हैं, कौन से टूल्स उपयोग करने हैं, और परिणामों को कैसे मर्ज करना है।
यह बिना किसी पूर्वपरिभाषित भूमिकाओं के 100 तक उप-एजेंट्स का स्वचालित रूप से निर्माण और समन्वय कर सकता है, 1,500 तक टूल कॉल्स में समानांतर वर्कफ़्लो निष्पादित करते हुए।
Kimi K2.5 Agent Swarm कैसे काम करता है?
अंदरूनी स्तर पर, Agent Swarm एक प्रशिक्षित होने योग्य ऑर्केस्ट्रेटर पेश करता है जो काम को समानांतर उप-कार्यों में विभाजित करना और उन्हें कुशलता से शेड्यूल करना सीखता है:
PARL (Parallel-Agent Reinforcement Learning) क्यों मायने रखता है
Kimi K2.5 का स्वॉर्म व्यवहार Parallel-Agent Reinforcement Learning (PARL) से प्रशिक्षित है—एक प्रशिक्षण सेटअप जो समानांतरता को स्वयं एक सीखने योग्य कौशल बनाता है। यह इसलिए मायने रखता है क्योंकि सरल मल्टी-एजेंट सिस्टम अक्सर दो तरीकों से विफल होते हैं:
PARL इसे प्रशिक्षण के दौरान रिवार्ड्स को आकार देकर संबोधित करता है। यह शुरू में समानांतरता को प्रोत्साहित करता है और धीरे-धीरे अनुकूलन को एंड-टू-एंड कार्य गुणवत्ता की ओर स्थानांतरित करता है, ताकि नकली समानांतरता रोकी जा सके। अनुकूलन को विलंबता-समझदार बनाने के लिए, K2.5 Critical Steps का उपयोग करके प्रदर्शन का मूल्यांकन करता है क्योंकि अधिक एजेंट स्पॉन करना तभी मदद करता है जब वह निष्पादन के सबसे धीमे पथ को वास्तव में छोटा करे, न कि समन्वय ओवरहेड बढ़ाए।
जब कार्य व्यापक और टूल-प्रधान हो, तो Agent Swarm आउटपुट-तक पहुँचने का समय काफ़ी घटा सकता है। Moonshot की रिपोर्ट के अनुसार, सिंगल-एजेंट सेटअप की तुलना में K2.5 Swarm निष्पादन समय को लगभग 3x से 4.5x तक घटा सकता है, और आंतरिक मूल्याँकन वास्तविक समानांतरता के ज़रिए जटिल वर्कलोड्स पर एंड-टू-एंड रनटाइम में ~80% तक कमी दिखाते हैं।
Kimi K2.5 उदाहरण और अवलोकन
इस खंड में, मैं विविध परिदृश्यों में Kimi K2.5 Agent Swarm का परीक्षण करने का अपना प्रत्यक्ष अनुभव साझा करूँगा। प्रत्येक उदाहरण दिखाता है कि स्वॉर्म कार्यों को कैसे तोड़ता है, एजेंट्स कैसे आवंटित करता है, और यह दृष्टिकोण व्यवहार में सचमुच कहाँ मदद करता है या कहाँ कम पड़ता है।
शोध स्वॉर्म
अपने पहले प्रयोग में, मैंने जाँचा कि क्या Kimi K2.5 Agent Swarm ओपन-सोर्स LLMs के लिए डिप्लॉयमेंट प्लान तैयार करने जैसे उच्च-दाँव, वास्तविक-जीवन के कार्य को संभाल सकता है।
प्रॉम्प्ट:
इस डेमो में, Kimi K2.5 Agent Swarm ने तुरंत प्रॉम्प्ट को समानांतर शोध ट्रैक्स में विभाजित किया और तीन समर्पित उप-एजेंट्स स्पॉन किए, अर्थात्
InferenceStackResearcher,QuantizationHardwareResearcher, औरCostControlResearcher। जबकि प्रत्येक उप-एजेंट का नाम उन्हें सौंपे गए काम को दर्शाता है, इसके बाद इसने कार्य को कई वर्कर पर्सोना में फैला दिया।मुझे सबसे अच्छा यह लगा कि अंतिम आउटपुट में इन्फ़ेरेंस स्टैक्स के लिए एक साफ़ तुलना तालिका थी, साथ ही क्वांटाइज़ेशन के लिए संक्षिप्त सिफारिशें और नोट्स थे। आप टास्क प्रोग्रेस बार का उपयोग करके यह भी देख सकते हैं कि इसने शुरू में काम को कैसे विभाजित किया और प्रत्येक उप-कार्य को पूर्णता तक कैसे ट्रैक किया।