

了解 Llama 3
Meta 发布了新一代大型语言模型(LLMs)Llama 3,这是一个包含预训练和指令微调的文本到文本模型系列。
Llama 3 是一种采用优化过的 Transformer 架构的自回归语言模型。预训练和指令微调版本均提供 8B 和 70B 参数规模,支持 8K 上下文长度。
Llama 3 8B 是 Hugging Face 上获赞最多的 LLM。其指令微调版本在多项性能指标上优于 Google 的 Gemma 7B-It 和 Mistral 7B Instruct。70B 指令微调版本在大多数指标上已超过 Gemini Pro 1.5 和 Claude Sonnet:
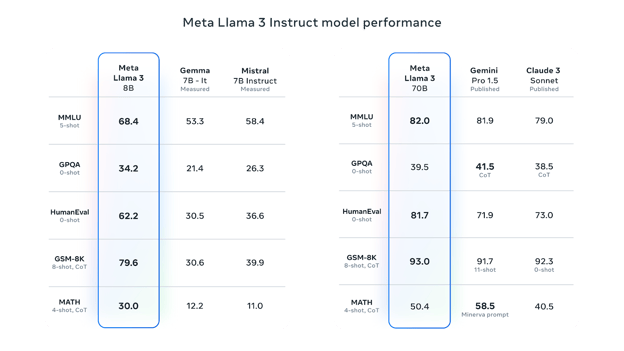
来源:Meta Llama 3
Meta 使用新的公共在线数据混合训练了 Llama 3,总计超过 15 万亿个 token。8B 模型的知识截止时间为 2023 年 3 月,70B 模型的截止时间为 2023 年 12 月。模型采用 Grouped-Query Attention(GQA),以降低内存带宽占用并提升效率。
Llama 3 模型以自定义商业许可发布。要访问模型,您需要填写姓名、单位、邮箱并接受条款和条件。如果您在 Kaggle 和 Hugging Face 等平台使用不同的邮箱,可能需要分别填写表单。
您可以通过这篇文章进一步了解 Llama 3:What is Llama 3?。
1. 微调 Llama 3
在本教程中,我们将使用 ruslanmv/ai-medical-chatbot 数据集微调 Llama 3 8B-Chat 模型。该数据集包含 25 万条病人与医生之间的对话。我们将使用 Kaggle Notebook 来访问该模型和免费的 GPU。
环境准备
在启动 Kaggle Notebook 之前,请使用您的 Kaggle 邮箱填写 Meta 下载表单,然后前往 Kaggle 上的 Llama 3 模型页面并接受协议。审批流程可能需要一到两天。
现在按以下步骤进行:
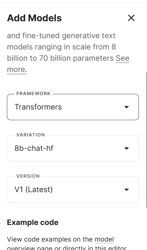
1. 在 Kaggle 上新建 Notebook,通过点击+ Add Input 按钮,选择 Models 选项,并在 Llama 3 模型旁点击加号 + 添加模型。之后选择正确的框架、变体和版本并添加模型。
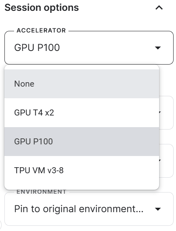
2. 前往 Session options,将加速器选择为 GPU P100。
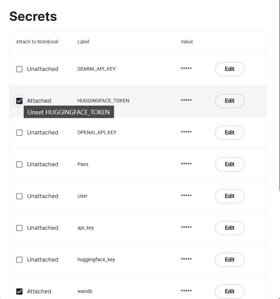
3. 生成 Hugging Face 和 Weights & Biases 的令牌,并创建 Kaggle Secrets。您可以通过 Add-ons > Secrets > Add 新建 secret 并启用。
4. 安装所有必要的 Python 软件包,启动 Kaggle 会话。
%%capture
%pip install -U transformers
%pip install -U datasets
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
%pip install -U bitsandbytes
%pip install -U wandb5. 导入加载数据集、模型与分词器及进行微调所需的 Python 包。
from transformers import (
AutoModelForCausalLM,
AutoTokenizer,
BitsAndBytesConfig,
HfArgumentParser,
TrainingArguments,
pipeline,
logging,
)
from peft import (
LoraConfig,
PeftModel,
prepare_model_for_kbit_training,
get_peft_model,
)
import os, torch, wandb
from datasets import load_dataset
from trl import SFTTrainer, setup_chat_format6. 我们将使用 Weights & Biases 跟踪训练过程,并将微调后的模型保存到 Hugging Face,因此需要使用 API 密钥登录 Hugging Face Hub 和 Weights & Biases。
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(token = hf_token)
wb_token = user_secrets.get_secret("wandb")
wandb.login(key=wb_token)
run = wandb.init(
project='Fine-tune Llama 3 8B on Medical Dataset',
job_type="training",
anonymous="allow"
)7. 设置基础模型、数据集和新模型变量。我们将从 Kaggle 加载基础模型、从 HugginFace Hub 加载数据集,然后保存新模型。
base_model = "/kaggle/input/llama-3/transformers/8b-chat-hf/1"
dataset_name = "ruslanmv/ai-medical-chatbot"
new_model = "llama-3-8b-chat-doctor"8. 设置数据类型和注意力实现。
torch_dtype = torch.float16
attn_implementation = "eager"加载模型与分词器
本部分我们将从 Kaggle 加载模型。但由于内存限制,无法加载完整模型,因此将使用 4 位精度加载。
本项目的目标是降低内存占用并加速微调过程。
# QLoRA config
bnb_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_quant_type="nf4",
bnb_4bit_compute_dtype=torch_dtype,
bnb_4bit_use_double_quant=True,
)
# Load model
model = AutoModelForCausalLM.from_pretrained(
base_model,
quantization_config=bnb_config,
device_map="auto",
attn_implementation=attn_implementation
)加载分词器,然后为对话式 AI 任务设置模型与分词器。默认使用 OpenAI 的 chatml 模板,将输入文本转换为聊天格式。
# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model)
model, tokenizer = setup_chat_format(model, tokenizer)为层添加适配器
微调完整模型会耗费大量时间。为提升训练速度,我们将附加带少量参数的适配器层,使整个过程更快且更省内存。
# LoRA config
peft_config = LoraConfig(
r=16,
lora_alpha=32,
lora_dropout=0.05,
bias="none",
task_type="CAUSAL_LM",
target_modules=['up_proj', 'down_proj', 'gate_proj', 'k_proj', 'q_proj', 'v_proj', 'o_proj']
)
model = get_peft_model(model, peft_config)加载数据集
为了加载并预处理数据集,我们将:
1. 加载 ruslanmv/ai-medical-chatbot 数据集,打乱顺序,并仅选择前 1000 行。这将显著缩短训练时间。
2. 将聊天模板格式化为对话形式。把病人问题和医生回复合并到一个名为 "text" 的列中。
3. 展示 “text” 列中的一个样本(该列使用带特殊标记的聊天格式)。
#Importing the dataset
dataset = load_dataset(dataset_name, split="all")
dataset = dataset.shuffle(seed=65).select(range(1000)) # Only use 1000 samples for quick demo
def format_chat_template(row):
row_json = [{"role": "user", "content": row["Patient"]},
{"role": "assistant", "content": row["Doctor"]}]
row["text"] = tokenizer.apply_chat_template(row_json, tokenize=False)
return row
dataset = dataset.map(
format_chat_template,
num_proc=4,
)
dataset['text'][3]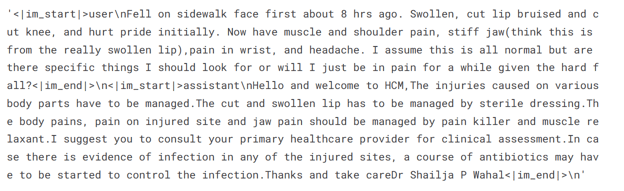
4. 将数据集划分为训练集和验证集。
dataset = dataset.train_test_split(test_size=0.1)编译并训练模型
我们设置模型的超参数以便在 Kaggle 上运行。您可以通过阅读 Fine-Tuning Llama 2 教程了解每个超参数。
我们对模型进行 1 个 epoch 的微调,并使用 Weights and Biases 记录指标。
training_arguments = TrainingArguments(
output_dir=new_model,
per_device_train_batch_size=1,
per_device_eval_batch_size=1,
gradient_accumulation_steps=2,
optim="paged_adamw_32bit",
num_train_epochs=1,
evaluation_strategy="steps",
eval_steps=0.2,
logging_steps=1,
warmup_steps=10,
logging_strategy="steps",
learning_rate=2e-4,
fp16=False,
bf16=False,
group_by_length=True,
report_to="wandb"
)接下来设置监督式微调(SFT)训练器,提供训练与评估数据集、LoRA 配置、训练参数、分词器和模型。我们将 max_seq_length 设为 512,以避免训练时超出 GPU 内存。
trainer = SFTTrainer(
model=model,
train_dataset=dataset["train"],
eval_dataset=dataset["test"],
peft_config=peft_config,
max_seq_length=512,
dataset_text_field="text",
tokenizer=tokenizer,
args=training_arguments,
packing= False,
)运行以下代码开始微调过程。
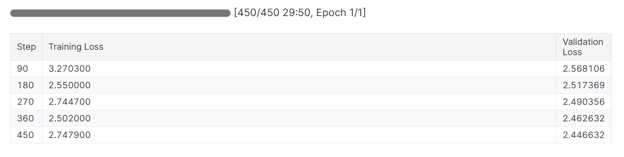
trainer.train()训练损失和验证损失均有所下降。为获得更好效果,可在完整数据集上训练三个 epoch。
模型评估
完成 Weights & Biases 会话后,会生成运行历史和摘要。
wandb.finish()
model.config.use_cache = True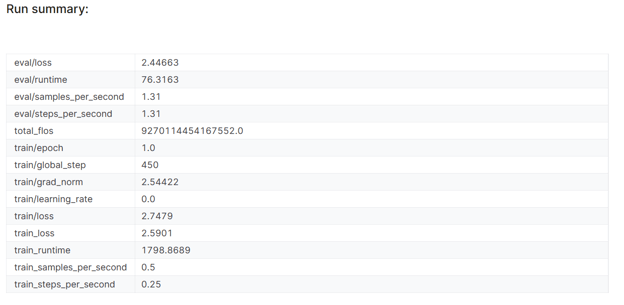
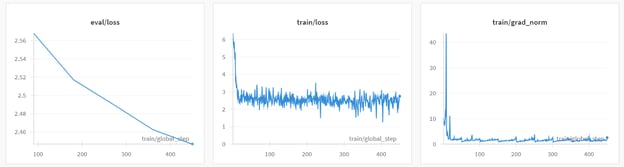
模型的性能指标也会存储在您 Weights & Biases 账户中该项目名下。
让我们在一个示例患者问题上评估模型,检查是否已正确微调。
要生成回复,我们需要将消息转换为聊天格式,通过分词器处理,将结果输入模型,然后解码生成的 token 来显示文本。
messages = [
{
"role": "user",
"content": "Hello doctor, I have bad acne. How do I get rid of it?"
}
]
prompt = tokenizer.apply_chat_template(messages, tokenize=False,
add_generation_prompt=True)
inputs = tokenizer(prompt, return_tensors='pt', padding=True,
truncation=True).to("cuda")
outputs = model.generate(**inputs, max_length=150,
num_return_sequences=1)
text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(text.split("assistant")[1])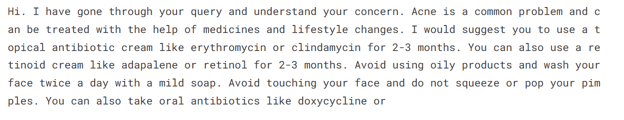
事实证明,即便只训练一个 epoch,我们也能获得中等水平的结果。
保存模型文件
我们现在将保存微调后的适配器并推送到 Hugging Face Hub。Hub API 会自动创建仓库并存储适配器文件。
trainer.model.save_pretrained(new_model)
trainer.model.push_to_hub(new_model, use_temp_dir=False)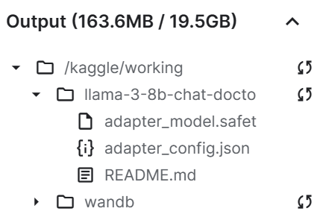
可以看到,我们保存的适配器文件比基础模型小得多。
最后,我们将带有适配器文件的笔记本保存下来,以便在新的笔记本中与基础模型合并。
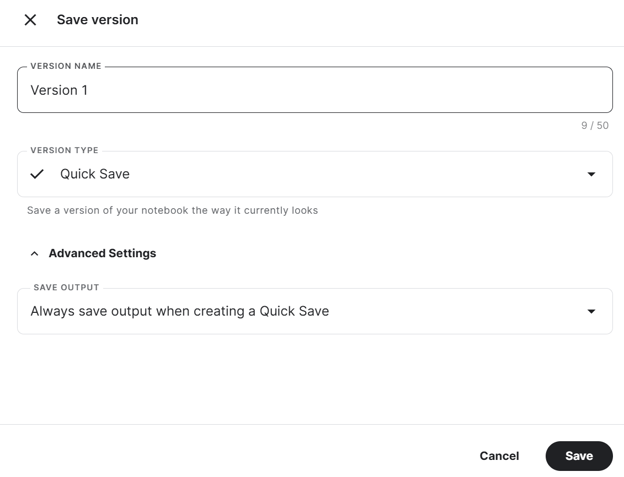
要保存 Kaggle Notebook,请点击右上角的 Save Version 按钮,将版本类型选择为 Quick Save,打开高级设置,勾选 Always save output when creating a Quick Save,然后点击 Save。
如果您在运行代码时遇到问题,请参考这个 Kaggle Notebook:Fine-tune Llama 3 8B on Medical Dataset。
我们已使用 GPU 微调模型。您也可以通过以下教程学习使用 TPU 微调 LLM:Fine-Tune and Run Inference on Google's Gemma Model Using TPUs。
如果您想学习如何微调其他模型,请查看这篇教程:Mistral 7B Tutorial: A Step-by-Step Guide to Using and Fine-Tuning Mistral 7B。
2. 合并 Llama 3
要在本地使用微调后的模型,首先需要将适配器与基础模型合并,然后保存完整模型。
环境准备
请按以下步骤操作:
1. 新建一个 Kaggle Notebook 并安装所有必要的 Python 包。请确保使用 GPU 作为加速器。
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
%pip install -U trl2. 使用 Kaggle Secrets 登录 Hugging Face Hub,以便更轻松地上传完整微调模型。
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
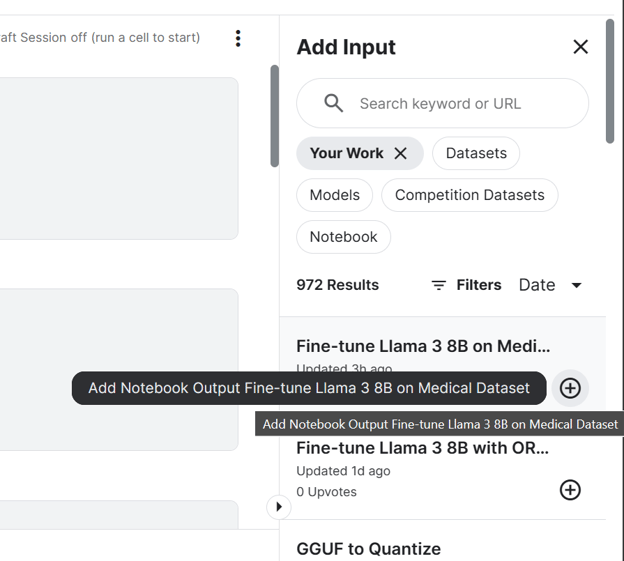
login(token = hf_token)3. 添加 Llama 3 8B Chat 模型和我们刚刚保存的微调 Kaggle Notebook。您可以像添加数据集和模型一样,将 Notebook 加入当前会话。
将 Notebook 添加到 Kaggle 会话后,我们就可以访问其输出文件。在我们的案例中,就是模型适配器文件。
4. 设置基础模型和适配器的位置变量。
base_model = "/kaggle/input/llama-3/transformers/8b-chat-hf/1"
new_model = "/kaggle/input/fine-tune-llama-3-8b-on-medical-dataset/llama-3-8b-chat-doctor/"将基础模型与适配器合并
我们将首先使用 transformers 库加载分词器和基础模型;然后使用 trl 库设置聊天格式;最后用 PEFT 库加载并将适配器合并到基础模型中。
merge_and_unload() 函数可将适配器权重与基础模型合并,并作为独立模型使用。
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
from peft import PeftModel
import torch
from trl import setup_chat_format
# Reload tokenizer and model
tokenizer = AutoTokenizer.from_pretrained(base_model)
base_model_reload = AutoModelForCausalLM.from_pretrained(
base_model,
return_dict=True,
low_cpu_mem_usage=True,
torch_dtype=torch.float16,
device_map="auto",
trust_remote_code=True,
)
base_model_reload, tokenizer = setup_chat_format(base_model_reload, tokenizer)
# Merge adapter with base model
model = PeftModel.from_pretrained(base_model_reload, new_model)
model = model.merge_and_unload()模型推理
为验证模型是否正确合并,我们将使用 transformers 库中的 pipeline 进行一次简单推理。我们先用聊天模板转换消息,然后向 pipeline 提供提示。该 pipeline 使用模型、分词器和任务类型进行初始化。
另外,如果您想使用多块 GPU,可以将 device_map 设为 "auto"。
messages = [{"role": "user", "content": "Hello doctor, I have bad acne. How do I get rid of it?"}]
prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
pipe = pipeline(
"text-generation",
model=model,
tokenizer=tokenizer,
torch_dtype=torch.float16,
device_map="auto",
)
outputs = pipe(prompt, max_new_tokens=120, do_sample=True, temperature=0.7, top_k=50, top_p=0.95)
print(outputs[0]["generated_text"])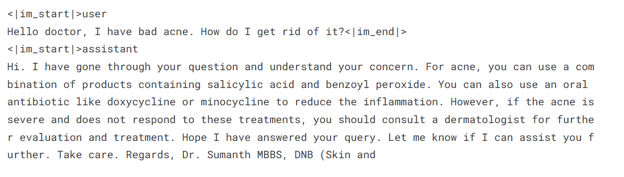
合并后,我们的微调模型运行如预期。
保存并推送合并后的模型
现在使用 save_pretrained() 函数保存分词器和模型。
model.save_pretrained("llama-3-8b-chat-doctor")
tokenizer.save_pretrained("llama-3-8b-chat-doctor")模型文件以 safetensors 格式存储,模型总大小约为 16 GB。
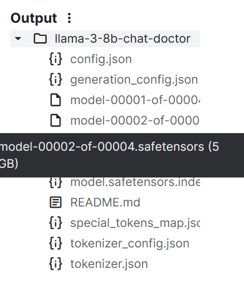
我们可以使用 push_to_hub() 函数将所有文件推送到 Hugging Face Hub。
model.push_to_hub("llama-3-8b-chat-doctor", use_temp_dir=False)
tokenizer.push_to_hub("llama-3-8b-chat-doctor", use_temp_dir=False)最后,可以像之前一样保存 Kaggle Notebook。
使用 Fine Tuned Adapter to fully model 这个 Kaggle Notebook 将有助于解决您在自行运行代码时遇到的任何问题。
3. 将模型转换为 Llama.cpp GGUF
我们无法在本地直接使用 safetensors 文件,因为大多数本地 AI 聊天应用并不支持。相反,我们将其转换为 llama.cpp 的 GGUF 文件格式。
环境准备
启动新的 Kaggle Notebook 会话,并添加 Fine Tuned Adapter to the full model Notebook。
克隆 llama.cpp 仓库,并按如下所示使用 make 命令安装 llama.cpp 框架。
另外说明:以下命令仅适用于 Kaggle Notebook。在其他平台或本地运行时,您可能需要做一些调整。
%cd /kaggle/working
!git clone --depth=1 https://github.com/ggerganov/llama.cpp.git
%cd /kaggle/working/llama.cpp
!sed -i 's|MK_LDFLAGS += -lcuda|MK_LDFLAGS += -L/usr/local/nvidia/lib64 -lcuda|' Makefile
!LLAMA_CUDA=1 conda run -n base make -j > /dev/null将 Safetensors 转换为 GGUF 模型格式
在 Kaggle Notebook 单元中运行以下命令,将模型转换为 GGUF 格式。
convert-hf-to-gguf.py 需要输入模型目录、输出文件目录和输出类型。
!python convert-hf-to-gguf.py /kaggle/input/fine-tuned-adapter-to-full-model/llama-3-8b-chat-doctor/ \
--outfile /kaggle/working/llama-3-8b-chat-doctor.gguf \
--outtype f16几分钟内,模型就会转换完成并保存在本地。随后我们可以保存 Notebook 以保存该文件。
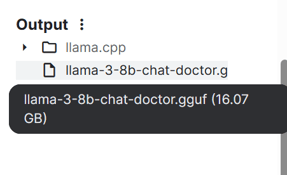
如果您在运行上述代码时遇到问题,请参考 HF LLM to GGUF 这个 Kaggle Notebook。
4. 对 GGUF 模型进行量化
普通笔记本电脑通常没有足够的内存与显存来加载完整模型,因此我们需要对 GGUF 模型进行量化,将 16 GB 的模型缩减到约 4–5 GB。
环境准备
启动新的 Kaggle Notebook 会话,并添加 HF LLM to GGUF Notebook。
然后在 Kaggle Notebook 单元中运行以下命令安装 llama.cpp。
%cd /kaggle/working
!git clone --depth=1 https://github.com/ggerganov/llama.cpp.git
%cd /kaggle/working/llama.cpp
!sed -i 's|MK_LDFLAGS += -lcuda|MK_LDFLAGS += -L/usr/local/nvidia/lib64 -lcuda|' Makefile
!LLAMA_CUDA=1 conda run -n base make -j > /dev/null量化
量化脚本需要提供 GGUF 模型目录、输出文件目录与量化方法。我们将使用 Q4_K_M 方法转换模型。
%cd /kaggle/working/
!./llama.cpp/llama-quantize /kaggle/input/hf-llm-to-gguf/llama-3-8b-chat-doctor.gguf llama-3-8b-chat-doctor-Q4_K_M.gguf Q4_K_M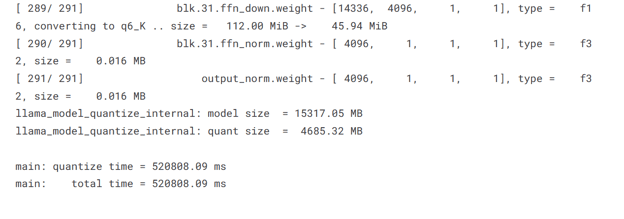
我们的模型大小已从 15317.05 MB 大幅缩减至 4685.32 MB。
将模型文件推送到 Hugging Face
要将单个文件推送到 Hugging Face Hub,我们将:
- 使用 API 密钥登录 Hugging Face Hub。
- 创建 API 对象。
- 提供本地路径、仓库路径、仓库 ID 和仓库类型来上传文件。
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
from huggingface_hub import HfApi
user_secrets = UserSecretsClient()
hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(token = hf_token)
api = HfApi()
api.upload_file(
path_or_fileobj="/kaggle/working/llama-3-8b-chat-doctor-Q4_K_M.gguf",
path_in_repo="llama-3-8b-chat-doctor-Q4_K_M.gguf",
repo_id="kingabzpro/llama-3-8b-chat-doctor",
repo_type="model",
)
如下所示,我们的模型已成功推送到远端服务器。
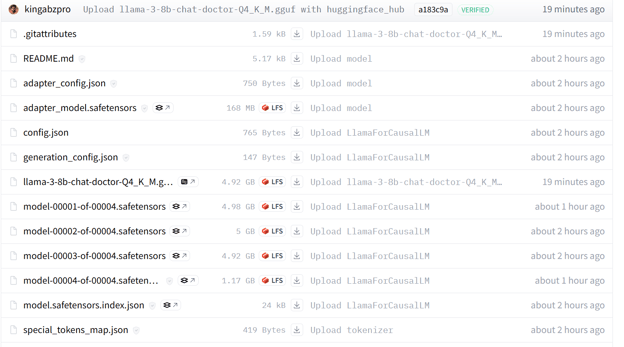
如果您仍有问题,请参考包含全部代码与输出的 GGUF to Quantize Kaggle Notebook。
如果您想要更简便的转换与量化方式,请访问 这个 Hugging Face Space 并提供 Hub 模型 ID。
5. 在本地使用微调模型
要在本地使用 GGUF 模型,您需要下载并将其导入 Jan 应用。
从 Hugging Face 下载模型
要下载模型,请:
1. 访问我们的 Hugging Face 仓库。
2. 点击 Files 选项卡。
3. 点击带有 GGUF 扩展名的量化模型文件。
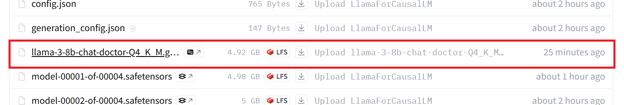
4. 点击 download 按钮。
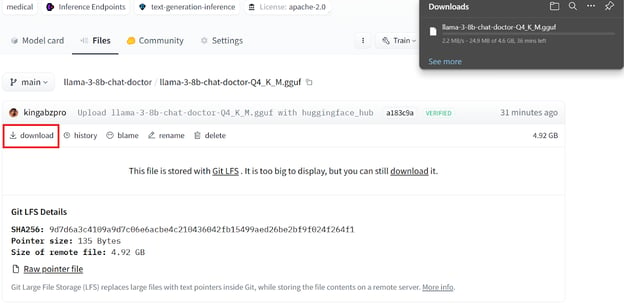
下载到本地需要几分钟时间。
安装 Jan 应用
从 Jan AI 下载并安装 Jan 应用。
启动 Jan Windows 应用后界面如下所示:
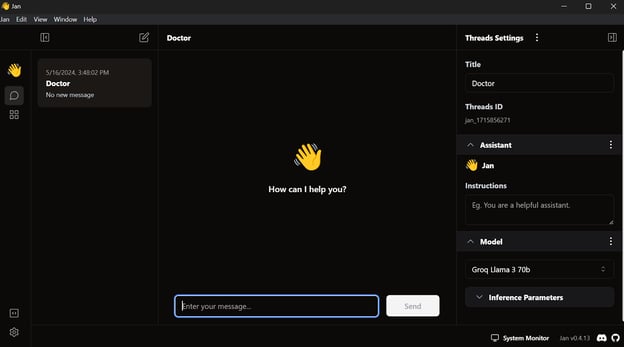
在 Jan 中加载微调模型
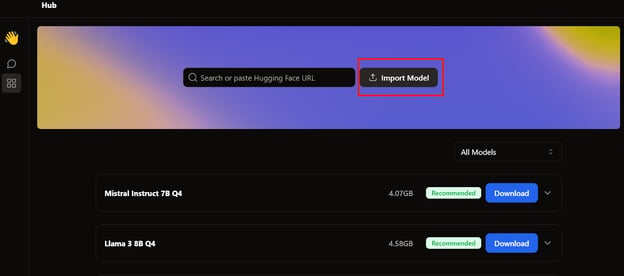
要将模型添加到 Jan 应用,我们需要导入量化后的 GGUF 文件。
进入 Hub 菜单并点击 Import Model,如下所示。提供刚下载文件的位置即可。
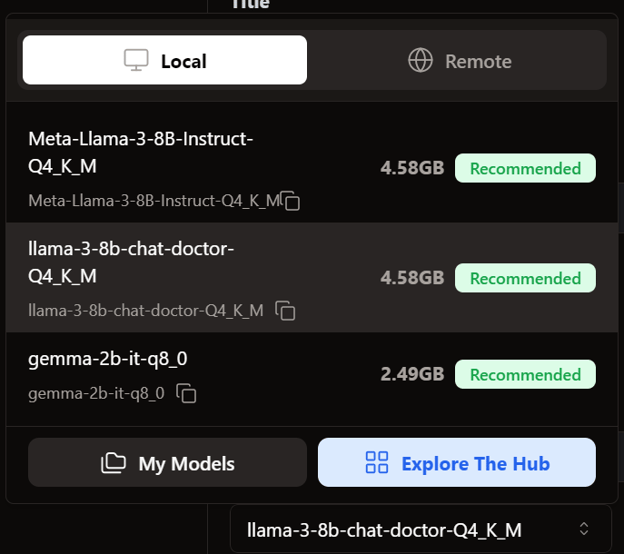
进入 Thread 菜单并选择该微调模型。
在 Jan 中使用微调模型
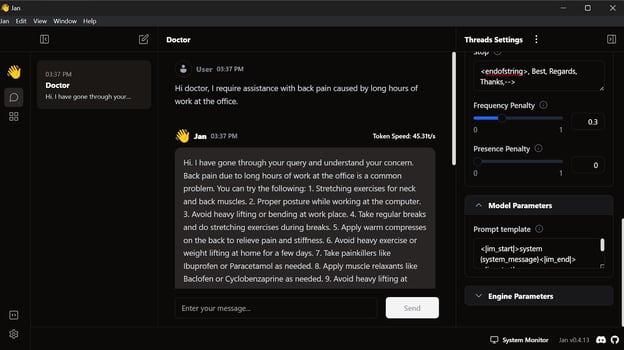
在使用模型前,我们需要对其进行自定义以正确显示回复。首先,在 Model Parameters 部分修改 Prompt 模板。
<|im_start|>system
{system_message}<|im_end|>
<|im_start|>user
{prompt}<|im_end|>
<|im_start|>assistant我们在推理参数中添加 Stop 标记,并将最大 token 更改为 512。
<endofstring>, Best, Regards, Thanks,-->现在开始输入问题,医生将作出相应回复。
我们的微调模型在本地运行良好。
该模型可与 GPT4ALL、Llama.cpp、Ollama 以及许多其他本地 AI 应用协同工作。要了解如何使用各类工具,请查看此教程:how to run LLMs locally。
结语
在自定义数据集上微调 Llama 3 并在本地使用,为构建创新应用带来了更多可能。从私密且定制化的对话式 AI 方案,到特定领域聊天机器人、文本分类、机器翻译、问答、个性化推荐系统,甚至医疗与营销自动化应用,皆可受益。
借助 Ollama 与 Langchain 框架,构建您自己的 AI 应用比以往任何时候都更容易,仅需数行代码即可上手。请参考教程:LlamaIndex: A Data Framework for Large Language Models (LLMs)- based applications。
在本教程中,我们学习了如何在医疗数据集上微调 Llama 3 8B Chat,完成了将适配器与基础模型合并、转换为 GGUF 格式并量化,以便在 Jan 聊天应用中本地使用的全过程。
想要了解更多,请查看这条包含四门课程的技能路径:Developing Large Language Models。

作为一名持证的数据科学家,我热衷于利用前沿技术打造创新的机器学习应用。凭借在语音识别、数据分析与报告、MLOps、对话式人工智能以及自然语言处理方面的扎实背景,我不断打磨构建智能系统的能力,力求带来切实影响。除技术专长外,我也擅长沟通,能够将复杂概念提炼为清晰、简明的表述。因此,我成为数据科学领域备受关注的博主,与不断壮大的数据专业人士社区分享洞见与实践经验。目前,我专注于内容创作与编辑,借助大语言模型打造有力且吸引人的内容,帮助企业与个人更好地发挥数据价值。
在本教程中,我们将学习如何在一个医疗数据集上微调 Llama 3。我们还会将模型转换成可通过 Jan 应用在本地使用的格式。
更具体地说,我们将:
如果您想系统学习人工智能,请查看这条包含六门课程的技能路径:AI Fundamentals。