LlamaIndex 是一个面向大型语言模型(LLM)应用的数据框架。像 GPT-4 这样的 LLM 预先在海量公共数据集上完成训练,开箱即用即可实现出色的自然语言处理能力。然而,如果无法访问您自己的私有数据,它们的实用性会受到限制。
LlamaIndex 通过灵活的数据连接器,让您从 API、数据库、PDF 等多种来源摄取数据。随后,这些数据会被索引为针对 LLM 优化的中间表示。借助查询引擎、聊天界面和由 LLM 驱动的数据代理,LlamaIndex 允许您以自然语言查询并与数据对话。它使您的 LLM 能够在无需用新数据重新训练模型的情况下,大规模访问和解读私有数据。
无论您是想以最简单的方式用自然语言查询数据的初学者,还是需要深度定制的高级用户,LlamaIndex 都能提供相应工具。高级 API 只需五行代码即可上手,而低级 API 则让您能完全控制数据摄取、索引、检索等流程。
LlamaIndex 如何工作?
LlamaIndex 使用将大型语言模型与私有知识库结合的检索增强生成(RAG)系统。它通常由两个阶段构成:索引阶段与查询阶段。
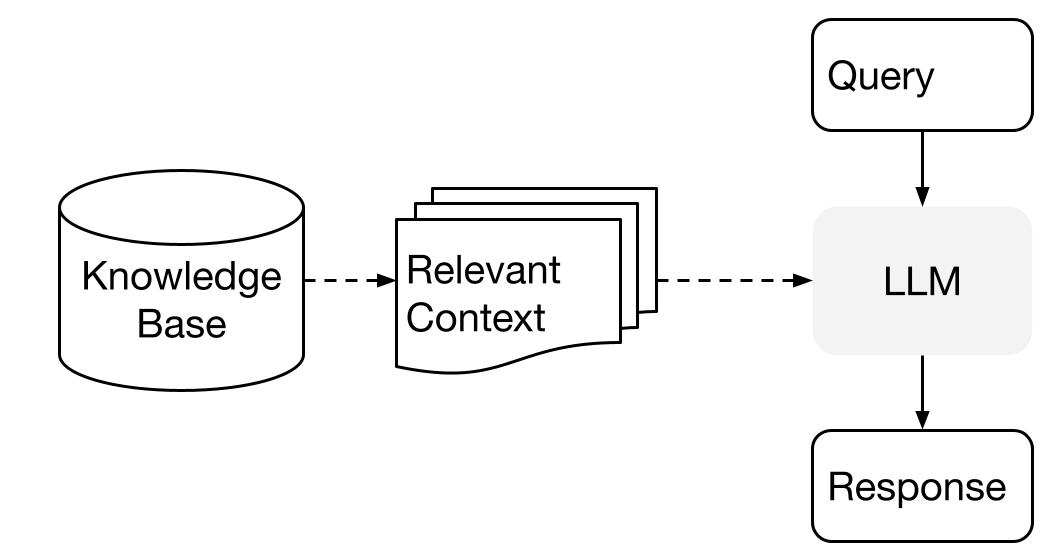
图片来源:High-Level Concepts
索引阶段
在索引阶段,LlamaIndex 会将私有数据高效地索引到向量索引中。此步骤有助于创建针对您领域的可搜索知识库。您可以输入文本文档、数据库记录、知识图谱以及其他数据类型。
本质上,索引会将数据转换为数值向量或嵌入,以捕捉其语义含义。这样便可在内容间快速进行相似度搜索。
查询阶段
在查询阶段,RAG 流水线会根据用户的查询搜索最相关的信息。随后,这些信息会连同查询一起提供给 LLM,以生成准确的响应。
这一过程让 LLM 能够访问其初始训练中可能未包含的最新信息。
此阶段的主要挑战在于如何从可能包含多个知识库的环境中进行检索、组织并进行推理。
在我们的代码演练《使用 PineCone 的检索增强生成》中,了解更多关于 RAG 的内容。
设置 LlamaIndex
在进入 LlamaIndex 教程与项目之前,我们需要先安装 Python 包并完成 API 设置。
我们可以直接使用 pip 安装 LlamaIndex。
pip install llama-index默认情况下,LlamaIndex 使用 OpenAI 的 GPT-3 text-davinci-003 模型。要使用该模型,您必须设置 OPENAI_API_KEY。您可以创建一个免费账户并登录 OpenAI’s new API token 获取 API 密钥。
import os

os.environ["OPENAI_API_KEY"] = "INSERT OPENAI KEY"
另外,请确保您已安装 openai 包。
pip install openai使用 LlamaIndex 向 LLM 添加个人数据
本节将学习如何使用 LlamaIndex 创建一款简历阅读器。您可以前往LinkedIn 个人资料页面,点击“更多”,然后选择“保存为 PDF”下载您的简历。
请注意,我们使用 DataLab 运行 Python 代码。您可以在 LlamaIndex: Adding Personal Data to LLMs 工作簿中访问所有相关代码和输出;您可以轻松创建自己的副本来运行全部代码,而无需在您的计算机上安装任何东西!
在开始运行前,我们需要安装 llama-index、openai 和 pypdf。安装 pypdf 是为了读取并转换 PDF 文件。
%pip install llama-index openai pypdf加载数据并创建索引
我们有一个名为“Private-Data”的目录,其中只包含一个 PDF 文件。我们将使用 SimpleDirectoryReader 读取它,然后使用 TreeIndex 将其转换为索引。
from llama_index import TreeIndex, SimpleDirectoryReader

resume = SimpleDirectoryReader("Private-Data").load_data()
new_index = TreeIndex.from_documents(resume)
运行查询
数据被索引后,您可以使用 as_query_engine() 开始提问。该函数使您能够就文档中的特定信息提出问题,并借助 OpenAI 的 GPT-3 text-davinci-003 模型获得相应回答。
注意:您可以按照教程 在 Python 中通过 OpenAI API 使用 GPT-3.5 和 GPT-4 在 DataLab 中设置 OpenAI API。
如我们所见,LLM 模型对查询做出了准确回应。它检索了索引并找到了相关信息。
query_engine = new_index.as_query_engine()
response = query_engine.query("When did Abid graduated?")
print(response)
Abid graduated in February 2014.我们还可以进一步询问认证情况。看起来 LlamaIndex 已经对候选人形成了完整的理解,这对于寻找特定人才的公司来说非常有利。
response = query_engine.query("What is the name of certification that Abid received?")
print(response)
Data Scientist Professional保存与加载上下文
创建索引是一个耗时的过程。我们可以通过保存上下文来避免重复创建索引。默认情况下,以下命令会将索引存储保存到 ./storage 目录。
new_index.storage_context.persist()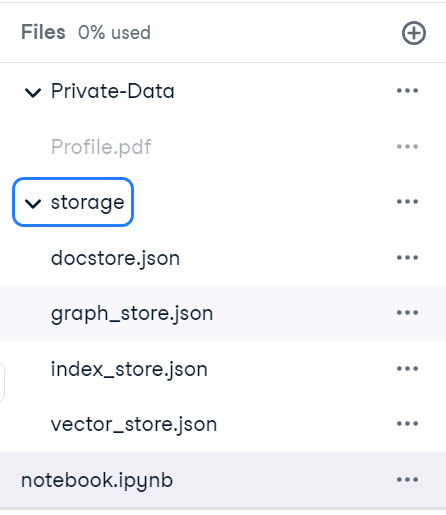
完成后,我们可以快速加载存储上下文并创建索引。
from llama_index import StorageContext, load_index_from_storage

storage_context = StorageContext.from_defaults(persist_dir="./storage")
index = load_index_from_storage(storage_context)
为验证其工作正常,我们将向查询引擎提出来自简历的问题。看起来我们已成功加载上下文。
query_engine = index.as_query_engine()
response = query_engine.query("What is Abid's job title?")
print(response)
Abid's job title is Technical Writer.聊天机器人
除问答外,我们还可以使用 LlamaIndex 创建个人聊天机器人。我们只需使用 as_chat_engine() 函数初始化索引即可。
我们将先问一个简单的问题。
query_engine = index.as_chat_engine()
response = query_engine.chat("What is the job title of Abid in 2021?")
print(response)
Abid's job title in 2021 is Data Science Consultant.接着在不提供额外上下文的情况下,我们将继续追问。
response = query_engine.chat("What else did he do during that time?")
print(response)
In 2021, Abid worked as a Data Science Consultant for Guidepoint, a Writer for Towards Data Science and Towards AI, a Technical Writer for Machine Learning Mastery, an Ambassador for Deepnote, and a Technical Writer for Start It Up.很明显,聊天引擎运行流畅且准确。
在构建好您的语言应用后,下一步建议阅读在云端使用大型语言模型(LLM)与本地运行的优缺点,以帮助您确定更适合自身需求的方案。
用 LlamaIndex 构建维基文本转语音
我们的下一个项目是开发一个应用,从维基百科获取问题的答案并将其转为语音。
代码与更多信息可在此 DataLab 工作簿中获取。
抓取维基百科页面
首先,我们将抓取 Italy - Wikipedia 页面数据,并将其保存为 italy_text.txt 文件到 data 文件夹中。
from pathlib import Path

import requests

response = requests.get(
    "https://en.wikipedia.org/w/api.php",
    params={
        "action": "query",
        "format": "json",
        "titles": "Italy",
        "prop": "extracts",
        # 'exintro': True,
        "explaintext": True,
    },
).json()
page = next(iter(response["query"]["pages"].values()))
italy_text = page["extract"]

data_path = Path("data")

if not data_path.exists():
    Path.mkdir(data_path)

with open("data/italy_text.txt", "w") as fp:
    fp.write(italy_text)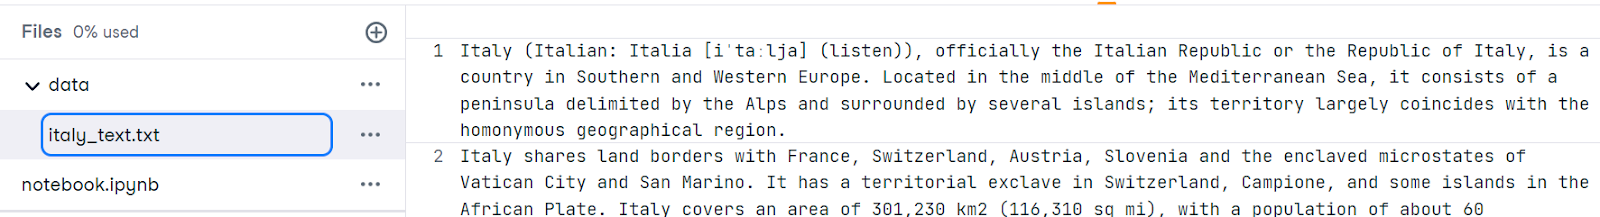
加载数据并构建索引
接下来,我们需要安装必要的包。elevenlabs 包可以让我们通过 API 轻松将文本转换为语音。
%pip install llama-index openai elevenlabs使用 SimpleDirectoryReader 我们将加载数据,并通过 VectorStoreIndex 将 TXT 文件转换为向量存储。
from llama_index import VectorStoreIndex, SimpleDirectoryReader
from IPython.display import Markdown, display
from llama_index.tts import ElevenLabsTTS
from IPython.display import Audio

documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)
查询
我们的计划是就该国家提出一个泛化问题,并从 LLM 的 query_engine 中获得回答。
query = "Tell me an interesting fact about the country?"
query_engine = index.as_query_engine()
response = query_engine.query(query)

display(Markdown(f"<b>{query}</b>"))
display(Markdown(f"<p>{response}</p>"))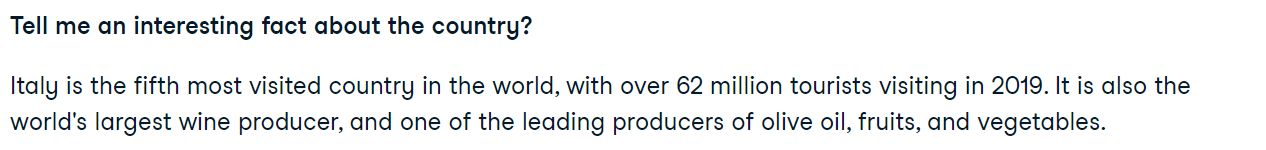
文本转语音
随后,我们将使用 llama_index.tts 模块访问 ElevenLabsTTS API。您需要提供 ElevenLabs 的 API 密钥来启动音频生成功能。可在 ElevenLabs 官网免费获取 API 密钥。
import os

elevenlabs_key = os.environ["ElevenLabs_key"]
tts = ElevenLabsTTS(api_key=elevenlabs_key)
我们会将响应传入 generate_audio 函数以生成自然语音。要播放音频,我们将使用 IPython.display 的 Audio 函数。
audio = tts.generate_audio(str(response))
Audio(audio)
这是一个简单示例。您可以组合多个模块来创建类似 Siri 的助手,它能够基于您私有数据理解问题并作出回答。更多信息请参阅 LlamaIndex 文档。
除了 LlamaIndex,LangChain 也支持构建基于 LLM 的应用。此外,您还可以阅读《面向数据工程与数据应用的 LangChain 入门》,了解 LangChain 能做什么、它解决的问题以及数据用例示例。
LlamaIndex 的使用场景
LlamaIndex 提供了一整套构建语言类应用的工具包。除此之外,您还可以使用 Llama Hub 中的多种数据加载器和代理工具,来开发具备多种功能的复杂应用。
您可以通过一个或多个插件型数据加载器,将自定义数据源连接到您的 LLM。
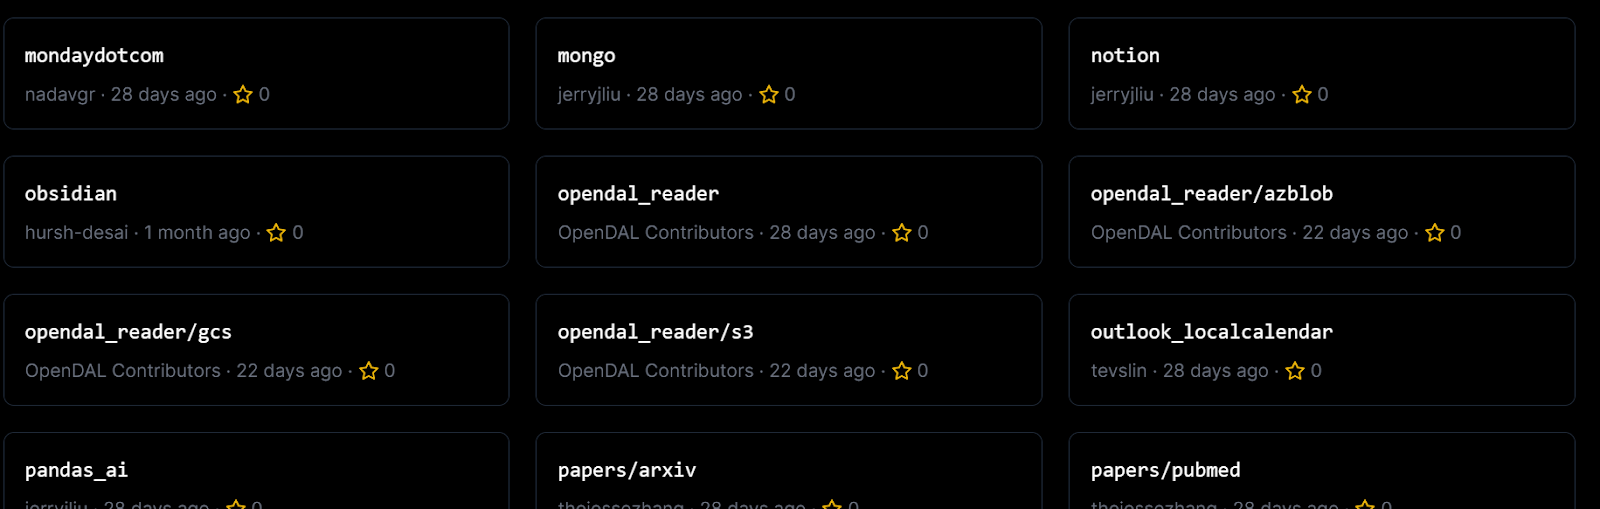
来自 Llama Hub 的数据加载器
您也可以使用代理工具来集成第三方工具与 API。
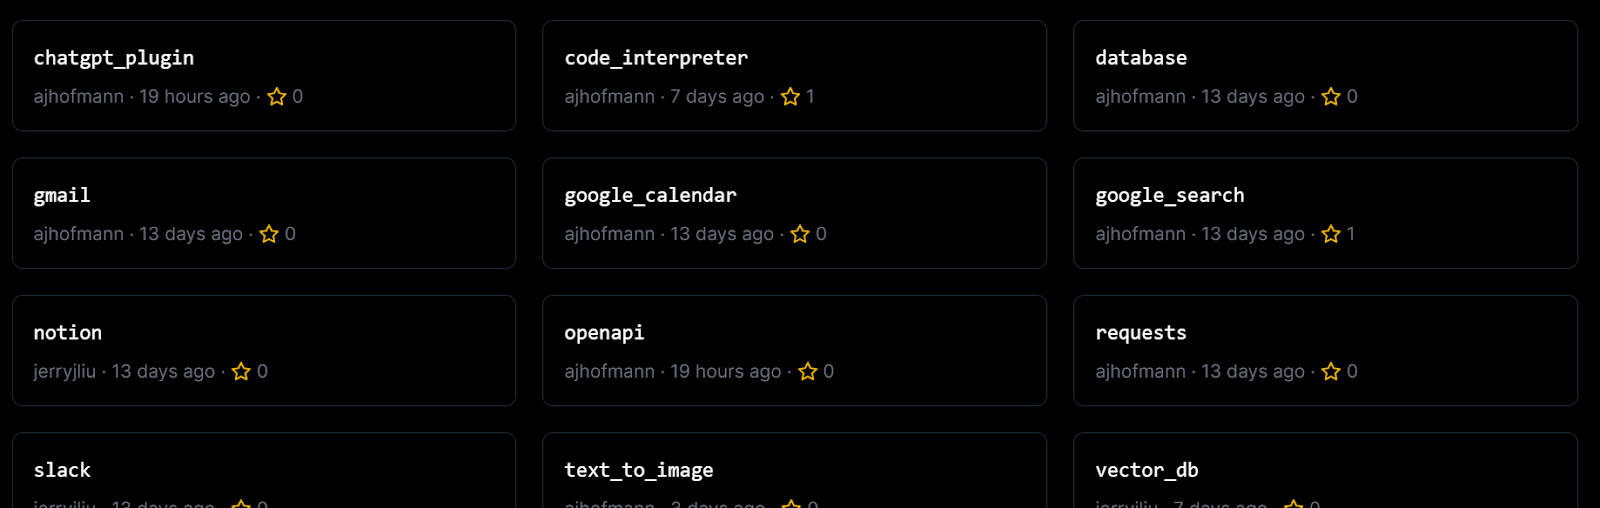
来自 Llama Hub 的代理工具
简而言之,您可以用 LlamaIndex 构建:
- 文档问答
- 聊天机器人
- 代理(Agents)
- 结构化数据应用
- 全栈 Web 应用
- 私有化部署
如需深入了解这些使用场景,请前往 LlamaIndex 的文档。
总结
LlamaIndex 提供了强大的工具包,用于构建检索增强生成系统,将大型语言模型的优势与自定义知识库相结合。它可以创建特定领域数据的索引存储,并在推理时利用这些数据为 LLM 提供相关上下文,从而生成高质量的回答。
在本教程中,我们了解了 LlamaIndex 及其工作原理。此外,我们仅用少量 Python 代码就构建了一个简历阅读器和文本转语音项目。使用 LlamaIndex 创建 LLM 应用十分简单,并且它提供了庞大的插件、数据加载器和代理库。
若要成为 LLM 开发专家,自然的下一步是报名参加《精通大型语言模型概念》课程。该课程将为您全面讲解 LLM,包括其应用、训练方法、伦理考量以及最新研究。
