

Llama 3 को समझना
Meta ने Llama 3 नामक बड़े भाषा मॉडलों (LLMs) की एक नई श्रृंखला जारी की है, जो प्री-ट्रेंड और इंस्ट्रक्शन-ट्यून किए गए टेक्स्ट-टू-टेक्स्ट मॉडलों का संग्रह है।
Llama 3 एक ऑटो-रेग्रेसीव भाषा मॉडल है जो एक ऑप्टिमाइज़्ड ट्रांसफॉर्मर आर्किटेक्चर का उपयोग करता है। प्री-ट्रेंड और इंस्ट्रक्शन-ट्यून किए गए दोनों मॉडलों में 8B और 70B पैरामीटर्स होते हैं, जिनकी कॉन्टेक्स्ट लंबाई 8K टोकन्स है।
Llama 3 8B Hugging Face पर सबसे पसंद किया जाने वाला LLM है। इसका इंस्ट्रक्शन-ट्यून संस्करण कई प्रदर्शन मीट्रिक्स पर Google के Gemma 7B-It और Mistral 7B Instruct से बेहतर है। 70B इंस्ट्रक्शन-ट्यून संस्करण ने अधिकांश प्रदर्शन मीट्रिक्स पर Gemini Pro 1.5 और Claude Sonnet को पीछे छोड़ दिया है:
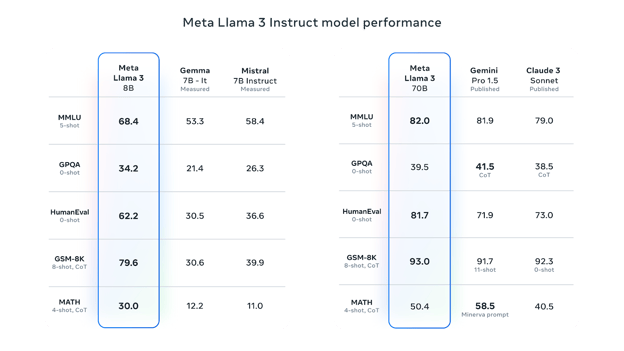
स्रोत: Meta Llama 3
Meta ने Llama 3 को सार्वजनिक रूप से उपलब्ध ऑनलाइन डाटा के नए मिश्रण पर प्रशिक्षित किया है, जिसमें 15 ट्रिलियन से अधिक टोकन्स हैं। 8B मॉडल का नॉलेज कटऑफ मार्च 2023 है, जबकि 70B मॉडल का कटऑफ दिसंबर 2023 है। मॉडल्स Grouped-Query Attention (GQA) का उपयोग करते हैं, जो मेमोरी बैंडविड्थ कम करता है और दक्षता बढ़ाता है।
Llama 3 मॉडल कस्टम कमर्शियल लाइसेंस के तहत जारी किए गए हैं। मॉडल तक पहुंचने के लिए, आपको अपने नाम, संबद्धता और ईमेल के साथ फॉर्म भरना होगा और नियम व शर्तें स्वीकार करनी होंगी। यदि आप Kaggle और Hugging Face जैसे अलग-अलग प्लेटफॉर्म्स के लिए अलग ईमेल पते उपयोग करते हैं, तो आपको फॉर्म कई बार भरना पड़ सकता है।
आप Llama 3 के बारे में और जान सकते हैं: What is Llama 3? लेख से।
1. Llama 3 का फाइन-ट्यूनिंग
इस ट्यूटोरियल के लिए, हम ruslanmv/ai-medical-chatbot डेटासेट का उपयोग करके Llama 3 8B-Chat मॉडल को फाइन-ट्यून करेंगे। इस डेटासेट में मरीज और डॉक्टर के बीच 2.5 लाख संवाद शामिल हैं। हम इस मॉडल और फ्री GPUs तक पहुंचने के लिए Kaggle Notebook का उपयोग करेंगे।
सेटअप
Kaggle Notebook शुरू करने से पहले, अपने Kaggle ईमेल पते के साथ Meta डाउनलोड फॉर्म भरें, फिर Kaggle पर Llama 3 मॉडल पेज पर जाएं और एग्रीमेंट स्वीकार करें। स्वीकृति प्रक्रिया में एक से दो दिन लग सकते हैं।
अब निम्नलिखित चरण लें:
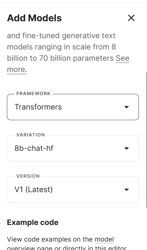
1. Kaggle पर नया Notebook लॉन्च करें, और + Add Input बटन पर क्लिक करके, Models विकल्प चुनकर, और Llama 3 मॉडल के बगल में + बटन पर क्लिक करके Llama 3 मॉडल जोड़ें। इसके बाद, सही फ्रेमवर्क, वेरिएशन और वर्ज़न चुनें और मॉडल जोड़ें।
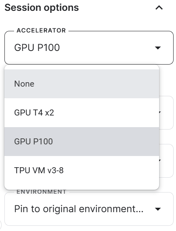
2. Session options पर जाएं और एक्सेलरेटर के रूप में GPU P100 चुनें।
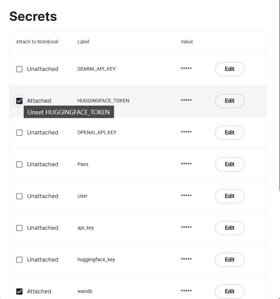
3. Hugging Face और Weights & Biases टोकन जेनरेट करें, और Kaggle Secrets बनाएं। आप Add-ons > Secrets > Add में जाकर Kaggle Secrets बना और सक्रिय कर सकते हैं।
4. आवश्यक सभी Python पैकेज इंस्टॉल करके Kaggle सत्र प्रारंभ करें।
%%capture
%pip install -U transformers
%pip install -U datasets
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
%pip install -U bitsandbytes
%pip install -U wandb5. डेटासेट, मॉडल और टोकनाइज़र लोड करने तथा फाइन-ट्यूनिंग के लिए आवश्यक Python पेजेज इम्पोर्ट करें।
from transformers import (
AutoModelForCausalLM,
AutoTokenizer,
BitsAndBytesConfig,
HfArgumentParser,
TrainingArguments,
pipeline,
logging,
)
from peft import (
LoraConfig,
PeftModel,
prepare_model_for_kbit_training,
get_peft_model,
)
import os, torch, wandb
from datasets import load_dataset
from trl import SFTTrainer, setup_chat_format6. हम Weights & Biases का उपयोग करके प्रशिक्षण प्रक्रिया को ट्रैक करेंगे और फिर फाइन-ट्यून किया गया मॉडल Hugging Face पर सेव करेंगे। इसके लिए हमें API key का उपयोग करके Hugging Face Hub और Weights & Biases दोनों में लॉग इन करना होगा।
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(token = hf_token)
wb_token = user_secrets.get_secret("wandb")
wandb.login(key=wb_token)
run = wandb.init(
project='Fine-tune Llama 3 8B on Medical Dataset',
job_type="training",
anonymous="allow"
)7. बेस मॉडल, डेटासेट और नए मॉडल के वेरिएबल सेट करें। हम बेस मॉडल को Kaggle से और डेटासेट को HugginFace Hub से लोड करेंगे और फिर नए मॉडल को सेव करेंगे।
base_model = "/kaggle/input/llama-3/transformers/8b-chat-hf/1"
dataset_name = "ruslanmv/ai-medical-chatbot"
new_model = "llama-3-8b-chat-doctor"8. डाटा टाइप और अटेंशन इम्प्लीमेंटेशन सेट करें।
torch_dtype = torch.float16
attn_implementation = "eager"मॉडल और टोकनाइज़र लोड करना
इस भाग में, हम Kaggle से मॉडल लोड करेंगे। हालांकि, मेमोरी सीमाओं के कारण हम पूरा मॉडल लोड नहीं कर सकते। इसलिए, हम मॉडल को 4-बिट प्रिसीजन में लोड कर रहे हैं।
इस प्रोजेक्ट में हमारा लक्ष्य मेमोरी उपयोग को कम करना और फाइन-ट्यूनिंग प्रक्रिया को तेज करना है।
# QLoRA config
bnb_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_quant_type="nf4",
bnb_4bit_compute_dtype=torch_dtype,
bnb_4bit_use_double_quant=True,
)
# Load model
model = AutoModelForCausalLM.from_pretrained(
base_model,
quantization_config=bnb_config,
device_map="auto",
attn_implementation=attn_implementation
)टोकनाइज़र लोड करें और फिर वार्तालाप संबंधी कार्यों के लिए मॉडल और टोकनाइज़र सेट करें। डिफ़ॉल्ट रूप से, यह OpenAI के chatml टेम्पलेट का उपयोग करता है, जो इनपुट टेक्स्ट को चैट-जैसे फॉर्मेट में बदल देगा।
# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model)
model, tokenizer = setup_chat_format(model, tokenizer)लेयर में एडॉप्टर जोड़ना
पूरे मॉडल को फाइन-ट्यून करना काफी समय लेगा, इसलिए प्रशिक्षण समय में सुधार के लिए हम कुछ पैरामीटर्स के साथ एडॉप्टर लेयर अटैच करेंगे, जिससे पूरी प्रक्रिया तेज़ और मेमोरी-कुशल बन जाएगी।
# LoRA config
peft_config = LoraConfig(
r=16,
lora_alpha=32,
lora_dropout=0.05,
bias="none",
task_type="CAUSAL_LM",
target_modules=['up_proj', 'down_proj', 'gate_proj', 'k_proj', 'q_proj', 'v_proj', 'o_proj']
)
model = get_peft_model(model, peft_config)डेटासेट लोड करना
अपना डेटासेट लोड और प्री-प्रोसेस करने के लिए, हम:
1. ruslanmv/ai-medical-chatbot डेटासेट लोड करेंगे, उसे शफल करेंगे, और केवल शीर्ष 1000 पंक्तियाँ चुनेंगे। इससे प्रशिक्षण समय में काफी कमी आएगी।
2. चैट टेम्पलेट को वार्तालापपूर्ण बनाने के लिए फॉर्मेट करेंगे। मरीज के प्रश्न और डॉक्टर के उत्तर को मिलाकर एक "text" कॉलम में रखेंगे।
3. टेक्स्ट कॉलम से एक सैंपल प्रदर्शित करेंगे ("text" कॉलम में विशेष टोकन्स के साथ चैट-जैसा फॉर्मेट होता है)।
#Importing the dataset
dataset = load_dataset(dataset_name, split="all")
dataset = dataset.shuffle(seed=65).select(range(1000)) # Only use 1000 samples for quick demo
def format_chat_template(row):
row_json = [{"role": "user", "content": row["Patient"]},
{"role": "assistant", "content": row["Doctor"]}]
row["text"] = tokenizer.apply_chat_template(row_json, tokenize=False)
return row
dataset = dataset.map(
format_chat_template,
num_proc=4,
)
dataset['text'][3]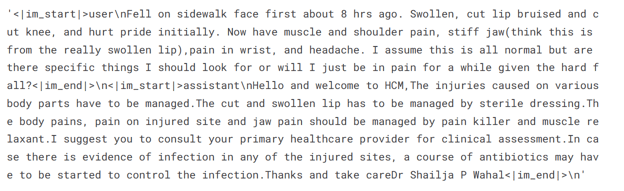
4. डेटासेट को प्रशिक्षण और वैलिडेशन सेट में विभाजित करें।
dataset = dataset.train_test_split(test_size=0.1)मॉडल को कम्पाइल करना और ट्रेन करना
हम मॉडल हाइपरपैरामीटर्स ऐसे सेट कर रहे हैं कि हम इसे Kaggle पर चला सकें। आप प्रत्येक हाइपरपैरामीटर के बारे में Fine-Tuning Llama 2 ट्यूटोरियल पढ़कर जान सकते हैं।
हम मॉडल को एक epoch के लिए फाइन-ट्यून कर रहे हैं और Weights and Biases का उपयोग करके मीट्रिक्स लॉग कर रहे हैं।
training_arguments = TrainingArguments(
output_dir=new_model,
per_device_train_batch_size=1,
per_device_eval_batch_size=1,
gradient_accumulation_steps=2,
optim="paged_adamw_32bit",
num_train_epochs=1,
evaluation_strategy="steps",
eval_steps=0.2,
logging_steps=1,
warmup_steps=10,
logging_strategy="steps",
learning_rate=2e-4,
fp16=False,
bf16=False,
group_by_length=True,
report_to="wandb"
)अब हम supervised fine-tuning (SFT) ट्रेनर सेट करेंगे और ट्रेन व इवैल्यूएशन डेटासेट, LoRA कॉन्फ़िगरेशन, ट्रेनिंग आर्ग्युमेंट्स, टोकनाइज़र और मॉडल प्रदान करेंगे। हम max_seq_length को 512 रख रहे हैं ताकि प्रशिक्षण के दौरान GPU मेमोरी से अधिक न हो।
trainer = SFTTrainer(
model=model,
train_dataset=dataset["train"],
eval_dataset=dataset["test"],
peft_config=peft_config,
max_seq_length=512,
dataset_text_field="text",
tokenizer=tokenizer,
args=training_arguments,
packing= False,
)हम निम्नलिखित कोड चलाकर फाइन-ट्यूनिंग प्रक्रिया शुरू करेंगे।
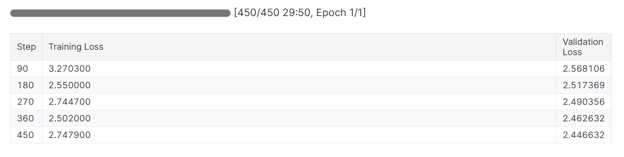
trainer.train()ट्रेनिंग और वैलिडेशन दोनों लॉसेस कम हुए हैं। बेहतर परिणामों के लिए पूरे डेटासेट पर तीन epochs तक ट्रेनिंग पर विचार करें।
मॉडल मूल्यांकन
जब आप Weights & Biases सत्र समाप्त करते हैं, तो यह रन हिस्ट्री और सारांश जेनरेट करेगा।
wandb.finish()
model.config.use_cache = True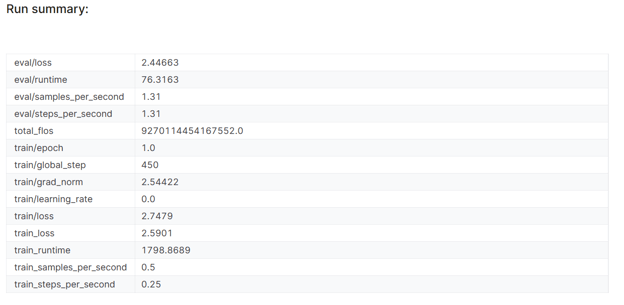
मॉडल प्रदर्शन मीट्रिक्स भी आपके Weights & Biases अकाउंट पर दिए गए प्रोजेक्ट नाम के अंतर्गत सहेजे जाते हैं।
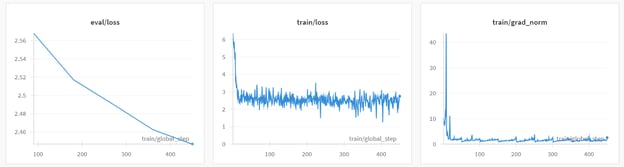
यह जांचने के लिए कि मॉडल ठीक से फाइन-ट्यून हुआ है या नहीं, आइए एक नमूना मरीज क्वेरी पर मॉडल का मूल्यांकन करें।
प्रतिक्रिया जेनरेट करने के लिए, हमें संदेशों को चैट फॉर्मेट में बदलना होगा, उन्हें टोकनाइज़र से पास करना होगा, परिणाम को मॉडल में इनपुट करना होगा, और फिर जेनरेट किए गए टोकन को डिकोड करके टेक्स्ट प्रदर्शित करना होगा।
messages = [
{
"role": "user",
"content": "Hello doctor, I have bad acne. How do I get rid of it?"
}
]
prompt = tokenizer.apply_chat_template(messages, tokenize=False,
add_generation_prompt=True)
inputs = tokenizer(prompt, return_tensors='pt', padding=True,
truncation=True).to("cuda")
outputs = model.generate(**inputs, max_length=150,
num_return_sequences=1)
text = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(text.split("assistant")[1])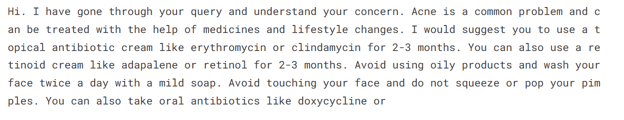
पता चलता है कि केवल एक epoch के साथ भी हम औसत परिणाम प्राप्त कर सकते हैं।
मॉडल फाइल सेव करना
अब हम फाइन-ट्यून किए गए एडॉप्टर को सेव करेंगे और उसे Hugging Face Hub पर पुश करेंगे। Hub API स्वचालित रूप से रिपॉजिटरी बनाएगा और एडॉप्टर फाइल स्टोर करेगा।
trainer.model.save_pretrained(new_model)
trainer.model.push_to_hub(new_model, use_temp_dir=False)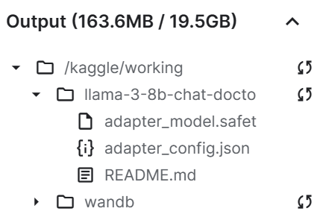
जैसा कि हम देख सकते हैं, हमारी सेव की गई एडॉप्टर फाइल बेस मॉडल से काफी छोटी है।
अंततः, हम एडॉप्टर फाइल वाले नोटबुक को सेव करेंगे ताकि नए नोटबुक में इसे बेस मॉडल के साथ मर्ज किया जा सके।
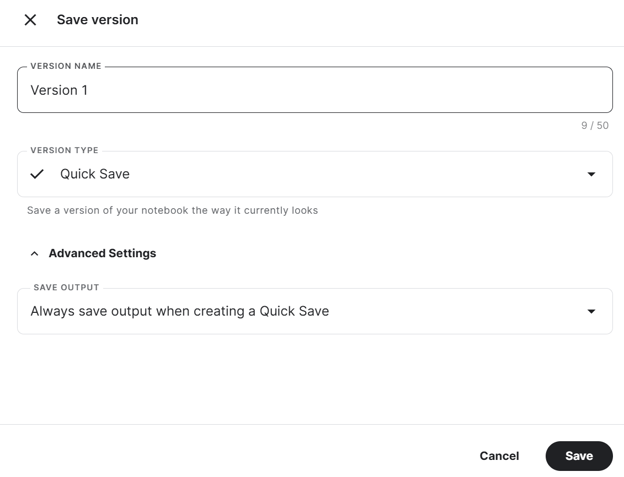
Kaggle Notebook सेव करने के लिए, ऊपर दाईं ओर Save Version बटन पर क्लिक करें, वर्ज़न टाइप के रूप में Quick Save चुनें, एडवांस्ड सेटिंग खोलें, Always save output when creating a Quick Save चुनें, और फिर Save बटन दबाएं।
यदि आपको कोड चलाते समय समस्या आ रही है, तो यह Kaggle Notebook देखें: Fine-tune Llama 3 8B on Medical Dataset।
हमने GPU का उपयोग करके अपना मॉडल फाइन-ट्यून किया है। आप TPUs का उपयोग करके भी LLMs को फाइन-ट्यून करना सीख सकते हैं: Fine-Tune and Run Inference on Google's Gemma Model Using TPUs ट्यूटोरियल का अनुसरण करके।
यदि आप अन्य मॉडलों को फाइन-ट्यून करना सीखना चाहते हैं, तो यह देखें: Mistral 7B Tutorial: A Step-by-Step Guide to Using and Fine-Tuning Mistral 7B।
2. Llama 3 को मर्ज करना
फाइन-ट्यून किए गए मॉडल को लोकल रूप से उपयोग करने के लिए, हमें पहले एडॉप्टर को बेस मॉडल के साथ मर्ज करना होगा और फिर पूरे मॉडल को सेव करना होगा।
सेटअप
आइए निम्नलिखित चरण लें:
1. नया Kaggle Notebook बनाएं और आवश्यक सभी Python पैकेज इंस्टॉल करें। सुनिश्चित करें कि आप एक्सेलरेटर के रूप में GPU का उपयोग कर रहे हैं।
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
%pip install -U trl2. Kaggle Secrets का उपयोग करके Hugging Face Hub में लॉग इन करें। यह हमें पूरे फाइन-ट्यून किए गए मॉडल को आसानी से अपलोड करने में मदद करेगा।
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
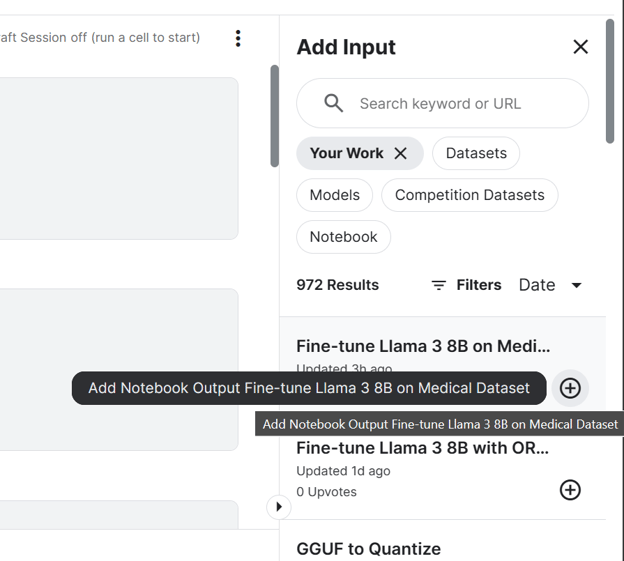
login(token = hf_token)3. Llama 3 8B Chat मॉडल और हाल ही में सेव किया गया फाइन-ट्यून Kaggle Notebook जोड़ें। हम वर्तमान सत्र में Notebooks को उसी तरह जोड़ सकते हैं जैसे आप डेटासेट और मॉडल जोड़ते हैं।
Kaggle सत्र में Notebook जोड़ने से हमें आउटपुट फाइलों तक पहुंचने की अनुमति मिलती है। हमारे मामले में, यह मॉडल एडॉप्टर फाइल है।
4. बेस मॉडल और एडॉप्टर के लोकेशन के साथ वेरिएबल सेट करना।
base_model = "/kaggle/input/llama-3/transformers/8b-chat-hf/1"
new_model = "/kaggle/input/fine-tune-llama-3-8b-on-medical-dataset/llama-3-8b-chat-doctor/"बेस मॉडल को एडॉप्टर के साथ मर्ज करना
हम पहले transformers लाइब्रेरी का उपयोग करके टोकनाइज़र और बेस मॉडल लोड करेंगे। फिर, हम trl लाइब्रेरी का उपयोग करके चैट फॉर्मेट सेट करेंगे। अंत में, हम PEFT लाइब्रेरी का उपयोग करके एडॉप्टर को बेस मॉडल में लोड और मर्ज करेंगे।
merge_and_unload() फंक्शन हमें एडॉप्टर वेट्स को बेस मॉडल के साथ मर्ज करने और उसे एक स्टैंडअलोन मॉडल के रूप में उपयोग करने में मदद करेगा।
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
from peft import PeftModel
import torch
from trl import setup_chat_format
# Reload tokenizer and model
tokenizer = AutoTokenizer.from_pretrained(base_model)
base_model_reload = AutoModelForCausalLM.from_pretrained(
base_model,
return_dict=True,
low_cpu_mem_usage=True,
torch_dtype=torch.float16,
device_map="auto",
trust_remote_code=True,
)
base_model_reload, tokenizer = setup_chat_format(base_model_reload, tokenizer)
# Merge adapter with base model
model = PeftModel.from_pretrained(base_model_reload, new_model)
model = model.merge_and_unload()मॉडल इन्फरेंस
यह सत्यापित करने के लिए कि हमारा मॉडल सही ढंग से मर्ज हो गया है, हम transformers लाइब्रेरी के pipeline का उपयोग करके एक साधारण इन्फरेंस करेंगे। हम संदेश को चैट टेम्पलेट से कन्वर्ट करेंगे और फिर पाइपलाइन को एक प्रॉम्प्ट देंगे। पाइपलाइन को मॉडल, टोकनाइज़र और टास्क टाइप का उपयोग करके इनिशियलाइज़ किया गया था।
एक साइड नोट के रूप में, यदि आप कई GPUs का उपयोग करना चाहते हैं, तो आप device_map को "auto" पर सेट कर सकते हैं।
messages = [{"role": "user", "content": "Hello doctor, I have bad acne. How do I get rid of it?"}]
prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
pipe = pipeline(
"text-generation",
model=model,
tokenizer=tokenizer,
torch_dtype=torch.float16,
device_map="auto",
)
outputs = pipe(prompt, max_new_tokens=120, do_sample=True, temperature=0.7, top_k=50, top_p=0.95)
print(outputs[0]["generated_text"])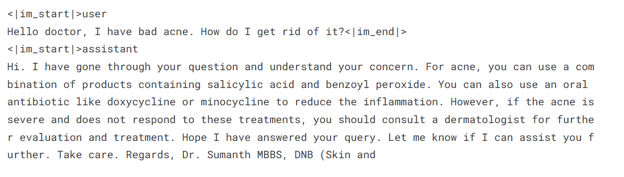
मर्ज होने के बाद हमारा फाइन-ट्यून किया गया मॉडल अपेक्षित रूप से काम कर रहा है।
मर्ज किए गए मॉडल को सेव करना और पुश करना
अब हम save_pretrained() फंक्शन का उपयोग करके टोकनाइज़र और मॉडल को सेव करेंगे।
model.save_pretrained("llama-3-8b-chat-doctor")
tokenizer.save_pretrained("llama-3-8b-chat-doctor")मॉडल फाइलें safetensors फॉर्मेट में स्टोर होती हैं, और मॉडल का कुल आकार लगभग 16 GB है।
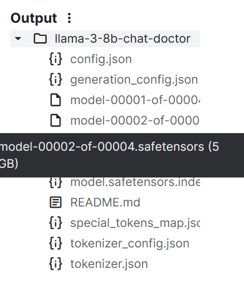
हम push_to_hub() फंक्शन का उपयोग करके सभी फाइलों को Hugging Face Hub पर पुश कर सकते हैं।
model.push_to_hub("llama-3-8b-chat-doctor", use_temp_dir=False)
tokenizer.push_to_hub("llama-3-8b-chat-doctor", use_temp_dir=False)अंत में, हम पहले की तरह Kaggle Notebook को सेव कर सकते हैं।
Fine Tuned Adapter to fully model Kaggle Notebook का उपयोग करना आपके अपने स्तर पर कोड चलाने से जुड़ी किसी भी समस्या को हल करने में मदद करेगा।
3. मॉडल को Llama.cpp GGUF में कन्वर्ट करना
हम safetensors फाइलों को लोकल रूप से उपयोग नहीं कर सकते क्योंकि अधिकांश लोकल AI चैटबॉट्स उन्हें सपोर्ट नहीं करते। इसके बजाय, हम इसे llama.cpp GGUF फाइल फॉर्मेट में कन्वर्ट करेंगे।
सेटअप
नया Kaggle Notebook सत्र शुरू करें और Fine Tuned Adapter to the full model Notebook जोड़ें।
llama.cpp रिपॉजिटरी को क्लोन करें और नीचे दिखाए अनुसार make कमांड का उपयोग करके llama.cpp फ्रेमवर्क इंस्टॉल करें।
एक साइड नोट के रूप में, नीचे दिया गया कमांड केवल Kaggle Notebook के लिए काम करता है। अन्य प्लेटफॉर्म या लोकल रूप से चलाने के लिए आपको कुछ चीजें बदलनी पड़ सकती हैं।
%cd /kaggle/working
!git clone --depth=1 https://github.com/ggerganov/llama.cpp.git
%cd /kaggle/working/llama.cpp
!sed -i 's|MK_LDFLAGS += -lcuda|MK_LDFLAGS += -L/usr/local/nvidia/lib64 -lcuda|' Makefile
!LLAMA_CUDA=1 conda run -n base make -j > /dev/nullSafetensors को GGUF मॉडल फॉर्मेट में कन्वर्ट करना
मॉडल को GGUF फॉर्मेट में कन्वर्ट करने के लिए Kaggle Notebook सेल में निम्नलिखित कमांड चलाएँ।
convert-hf-to-gguf.py को इनपुट मॉडल डायरेक्टरी, आउटपुट फाइल डायरेक्टरी और आउट टाइप की आवश्यकता होती है।
!python convert-hf-to-gguf.py /kaggle/input/fine-tuned-adapter-to-full-model/llama-3-8b-chat-doctor/ \
--outfile /kaggle/working/llama-3-8b-chat-doctor.gguf \
--outtype f16कुछ ही मिनटों में, मॉडल कन्वर्ट होकर लोकली सेव हो जाता है। इसके बाद हम फाइल सेव करने के लिए नोटबुक को सेव कर सकते हैं।
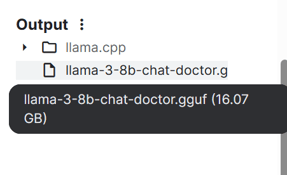
यदि आपको ऊपर दिए गए कोड को चलाने में समस्या आती है, तो HF LLM to GGUF Kaggle Notebook देखें।
4. GGUF मॉडल को क्वांटाइज़ करना
साधारण लैपटॉप्स में पूरे मॉडल को लोड करने के लिए पर्याप्त RAM और GPU मेमोरी नहीं होती, इसलिए हमें GGUF मॉडल को क्वांटाइज़ करना होगा, जिससे 16 GB का मॉडल घटकर लगभग 4-5 GB रह जाएगा।
सेटअप
नया Kaggle Notebook सत्र शुरू करें और HF LLM to GGUF Notebook जोड़ें।
इसके बाद, Kaggle Notebook सेल में निम्नलिखित कमांड चलाकर llama.cpp इंस्टॉल करें।
%cd /kaggle/working
!git clone --depth=1 https://github.com/ggerganov/llama.cpp.git
%cd /kaggle/working/llama.cpp
!sed -i 's|MK_LDFLAGS += -lcuda|MK_LDFLAGS += -L/usr/local/nvidia/lib64 -lcuda|' Makefile
!LLAMA_CUDA=1 conda run -n base make -j > /dev/nullक्वांटाइज़ेशन
क्वांटाइज़ स्क्रिप्ट को GGUF मॉडल डायरेक्टरी, आउटपुट फाइल डायरेक्टरी और क्वांटाइज़ेशन मेथड की आवश्यकता होती है। हम Q4_K_M मेथड का उपयोग करके मॉडल को कन्वर्ट कर रहे हैं।
%cd /kaggle/working/
!./llama.cpp/llama-quantize /kaggle/input/hf-llm-to-gguf/llama-3-8b-chat-doctor.gguf llama-3-8b-chat-doctor-Q4_K_M.gguf Q4_K_M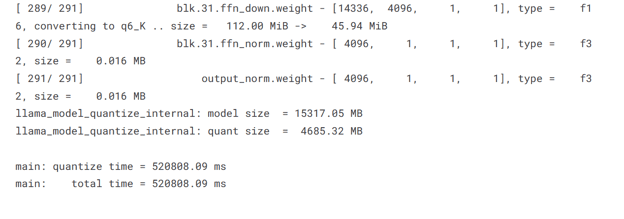
हमारे मॉडल का आकार 15317.05 MB से घटकर 4685.32 MB हो गया है।
मॉडल फाइल को Hugging Face पर पुश करना
एकल फाइल को Hugging Face Hub पर पुश करने के लिए, हम:
- API key का उपयोग करके Hugging Face Hub में लॉग इन करेंगे।
- API ऑब्जेक्ट बनाएंगे।
- लोकल पाथ, रिपो पाथ, रिपो आईडी और रिपो टाइप प्रदान करके फाइल अपलोड करेंगे।
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
from huggingface_hub import HfApi
user_secrets = UserSecretsClient()
hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(token = hf_token)
api = HfApi()
api.upload_file(
path_or_fileobj="/kaggle/working/llama-3-8b-chat-doctor-Q4_K_M.gguf",
path_in_repo="llama-3-8b-chat-doctor-Q4_K_M.gguf",
repo_id="kingabzpro/llama-3-8b-chat-doctor",
repo_type="model",
)
हमारा मॉडल नीचे दिखाए अनुसार सफलतापूर्वक रिमोट सर्वर पर पुश हो गया है।
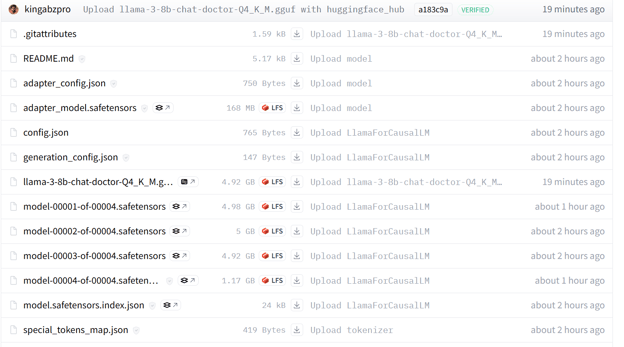
यदि आपको अभी भी समस्याएँ आ रही हैं, तो GGUF to Quantize Kaggle Notebook देखें, जिसमें पूरा कोड और आउटपुट है।
यदि आप अपने मॉडल को कन्वर्ट और क्वांटाइज़ करने का सरल तरीका ढूंढ रहे हैं, तो इस Hugging Face Space पर जाएँ और Hub Model Id प्रदान करें।
5. फाइन-ट्यून किए मॉडल का लोकल उपयोग
GGUF मॉडल को लोकल रूप से उपयोग करने के लिए, आपको इसे डाउनलोड करके Jan एप्लिकेशन में इम्पोर्ट करना होगा।
Hugging Face से मॉडल डाउनलोड करना
मॉडल डाउनलोड करने के लिए, हमें:
1. अपने Hugging Face रिपॉजिटरी पर जाना होगा।
2. Files टैब पर क्लिक करना होगा।
3. GGUF एक्सटेंशन वाली क्वांटाइज़्ड मॉडल फाइल पर क्लिक करना होगा।
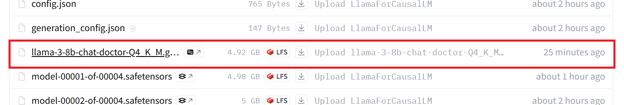
4. download बटन पर क्लिक करें।
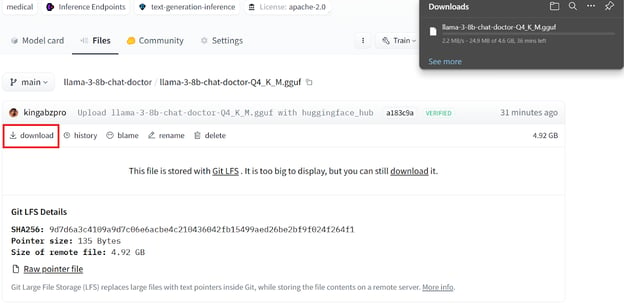
फाइल को लोकल रूप से डाउनलोड होने में कई मिनट लगेंगे।
Jan एप्लिकेशन इंस्टॉल करना
Jan AI से Jan एप्लिकेशन डाउनलोड और इंस्टॉल करें।
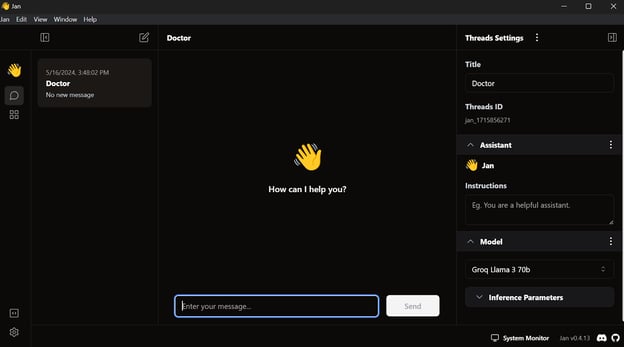
Jan विंडोज़ एप्लिकेशन लॉन्च करने पर यह इस तरह दिखता है:
Jan में फाइन-ट्यून किए मॉडल को लोड करना
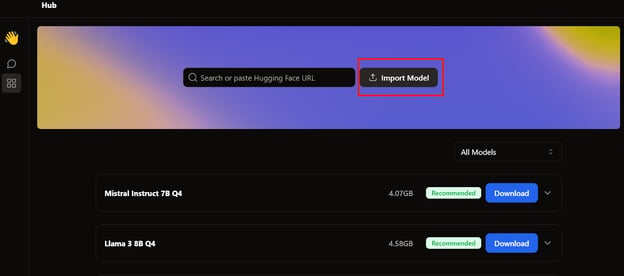
मॉडल को Jan एप्लिकेशन में जोड़ने के लिए, हमें क्वांटाइज़्ड GGUF फाइल इम्पोर्ट करनी होगी।
हमें Hub मेन्यू में जाना है और नीचे दिखाए अनुसार Import Model पर क्लिक करना है। हम हाल ही में डाउनलोड की गई फाइल का लोकेशन देते हैं, और बस हो गया।
हम Thread मेन्यू में जाते हैं और फाइन-ट्यून किए मॉडल का चयन करते हैं।
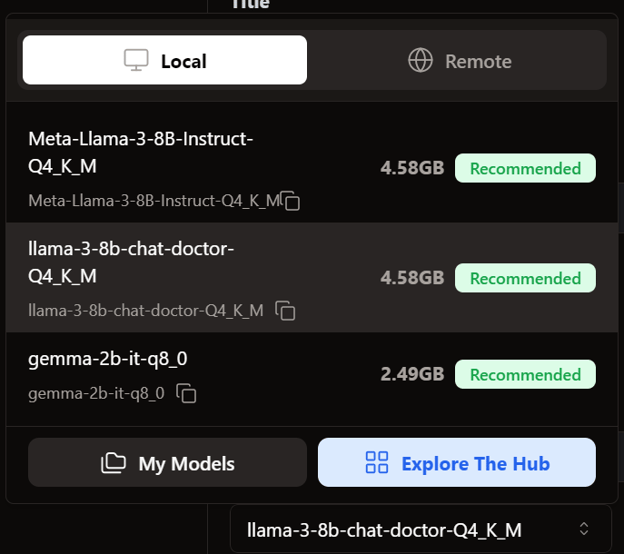
Jan में फाइन-ट्यून किए मॉडल का उपयोग
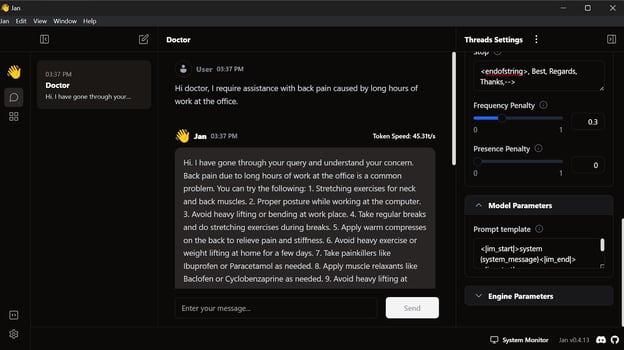
मॉडल का उपयोग करने से पहले, हमें प्रतिक्रिया को सही ढंग से प्रदर्शित करने के लिए इसे कस्टमाइज़ करना होगा। पहले, हम Model Parameters अनुभाग में Prompt टेम्पलेट में बदलाव करते हैं।
<|im_start|>system
{system_message}<|im_end|>
<|im_start|>user
{prompt}<|im_end|>
<|im_start|>assistantहम Stop टोकन जोड़ते हैं और इन्फरेंस पैरामीटर्स में अधिकतम टोकन को 512 में बदलते हैं।
<endofstring>, Best, Regards, Thanks,-->हम क्वेरियाँ लिखना शुरू करते हैं, और डॉक्टर तदनुसार उत्तर देगा।
हमारा फाइन-ट्यून किया मॉडल लोकल रूप से बिल्कुल सही काम कर रहा है।
यह मॉडल GPT4ALL, Llama.cpp, Ollama और कई अन्य लोकल AI एप्लिकेशंस के साथ काम करता है। प्रत्येक का उपयोग करना सीखने के लिए, इस ट्यूटोरियल पर नज़र डालें: how to run LLMs locally।
निष्कर्ष
कस्टम डेटासेट पर Llama 3 मॉडल को फाइन-ट्यून करना और उसे लोकल रूप से उपयोग करना, नवीन एप्लिकेशन बनाने के लिए कई संभावनाएँ खोलता है। संभावित उपयोग मामलों में निजी और कस्टमाइज़्ड वार्तालाप AI समाधान, डोमेन-विशिष्ट चैटबॉट्स, टेक्स्ट क्लासिफिकेशन, भाषा अनुवाद, प्रश्नोत्तर, व्यक्तिगत अनुशंसा प्रणालियाँ, और यहाँ तक कि स्वास्थ्य सेवा और मार्केटिंग ऑटोमेशन एप्लिकेशन शामिल हैं।
Ollama और Langchain फ्रेमवर्क्स के साथ, अपना खुद का AI एप्लिकेशन बनाना अब पहले से कहीं अधिक सुलभ हो गया है, जिसके लिए केवल कुछ पंक्तियों के कोड की आवश्यकता होती है। ऐसा करने के लिए, LlamaIndex: A Data Framework for Large Language Models (LLMs)- based applications ट्यूटोरियल का पालन करें।
इस ट्यूटोरियल में, हमने एक चिकित्सा डेटासेट पर Llama 3 8B Chat को फाइन-ट्यून करना सीखा। हमने एडॉप्टर को बेस मॉडल के साथ मर्ज करने, उसे GGUF फॉर्मेट में कन्वर्ट करने, और Jan चैटबॉट एप्लिकेशन पर लोकल उपयोग के लिए क्वांटाइज़ करने की प्रक्रिया से गुज़रे।
यदि आप और सीखना चाहते हैं, तो Developing Large Language Models पर यह चार-कोर्स स्किल ट्रैक देखें।

एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।
इस ट्यूटोरियल में, हम एक चिकित्सा डेटासेट पर Llama 3 को फाइन-ट्यून करना सीखेंगे। हम मॉडल को Jan एप्लिकेशन के माध्यम से लोकल उपयोग के लिए तैयार फॉर्मेट में भी बदलेंगे।
विशेष रूप से, हम:
यदि आप AI सीखने के लिए एक क्यूरेटेड करिकुलम ढूंढ रहे हैं, तो AI Fundamentals पर यह छह-कोर्स स्किल ट्रैक देखें।