

如何微调 Llama 2:分步指南
本部分我们将了解在 T4 GPU 上微调 70 亿参数的 Llama 2 模型所需的全部步骤。您可以在 Google Colab 或 Kaggle 上使用免费 GPU。代码可在两个平台运行。
Colab 的 T4 GPU 仅有 16 GB 显存。这几乎只够存下 Llama 2–7b 的权重,这意味着无法进行全量微调,我们需要使用如 LoRA 或 QLoRA 这样的参数高效微调技术。
我们将使用 QLoRA 技术,以 4 位精度微调模型并优化显存占用。为此,我们将使用 Hugging Face 的 LLM 库生态:transformers、accelerate、peft、trl 与 bitsandbytes。
1. 开始上手
首先安装所需库。
%%capture
%pip install accelerate peft bitsandbytes transformers trl随后,从这些库中加载必要的模块。
import os
import torch
from datasets import load_dataset
from transformers import (
AutoModelForCausalLM,
AutoTokenizer,
BitsAndBytesConfig,
TrainingArguments,
pipeline,
logging,
)
from peft import LoraConfig
from trl import SFTTrainer2. 模型配置
您可以在 Hugging Face 上申请访问 Meta 官方的 Llama-2 模型,但需要提交请求并等待数日确认。为避免等待,我们将使用 NousResearch 的 Llama-2-7b-chat-hf 作为基础模型。它与原版相同,但更易获取。
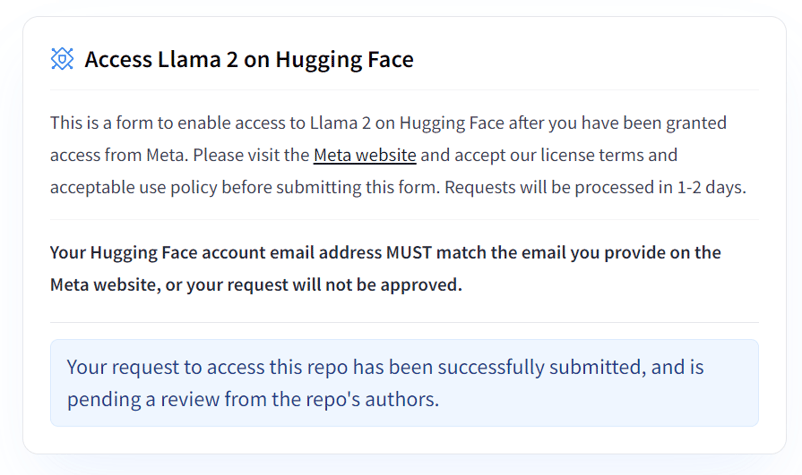
图片来自 Hugging Face
我们将使用一个更小的数据集 mlabonne/guanaco-llama2-1k 来微调基础模型,并为微调后的模型写好名称。
# Model from Hugging Face hub
base_model = "NousResearch/Llama-2-7b-chat-hf"
# New instruction dataset
guanaco_dataset = "mlabonne/guanaco-llama2-1k"
# Fine-tuned model
new_model = "llama-2-7b-chat-guanaco"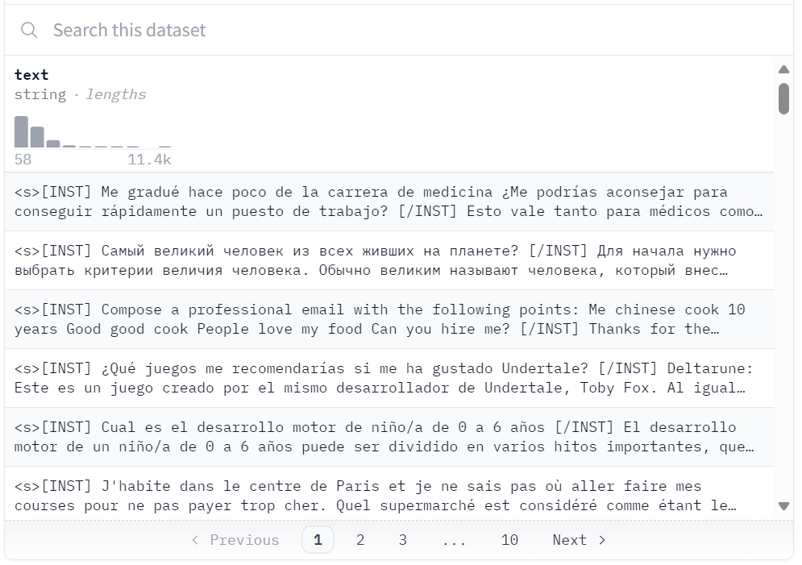
Hugging Face 上的数据集
3. 加载数据集、模型与分词器
我们将从 Hugging Face hub 加载 “guanaco-llama2-1k” 数据集。该数据集包含 1000 个样本,已处理为符合 Llama 2 提示词格式,是优秀数据集 timdettmers/openassistant-guanaco 的子集。
dataset = load_dataset(guanaco_dataset, split="train")Dataset parquet downloaded and prepared to /root/.cache/huggingface/datasets/parquet/mlabonne--guanaco-llama2-1k-f1f1134768f90029/0.0.0/0b6d5799bb726b24ad7fc7be720c170d8e497f575d02d47537de9a5bac074901. Subsequent calls will reuse this data.4. 4 位量化配置
通过 QLoRA 的 4 位量化,可以在消费级硬件上高效微调超大 LLM,同时保持较高性能。这极大提升了模型在真实场景中的可获得性与可用性。
QLoRA 将预训练语言模型量化为 4 位并冻结其参数,然后在模型上添加少量可训练的低秩适配器层。
在微调过程中,梯度会通过冻结的 4 位量化模型反向传播到低秩适配器层。因此,整个预训练模型保持 4 位不变,仅有适配器会更新。同时,4 位量化不会显著损害模型性能。
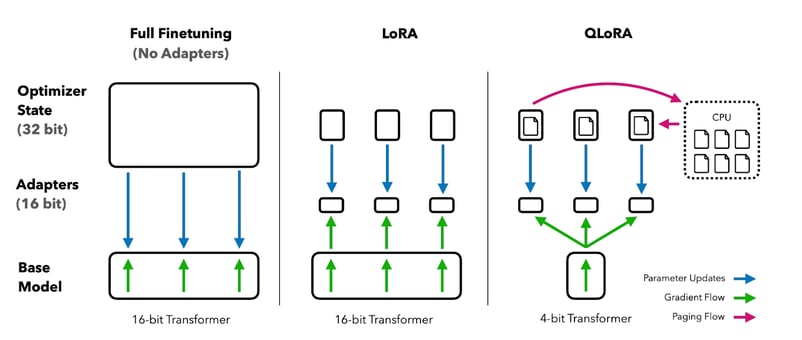
图片来自 QLoRA 论文
您可以阅读该论文以更好地理解。
微调方法对比
| 特性 | 全量微调 | LoRA | QLoRA |
|---|---|---|---|
| 更新的参数 | 全部模型参数 | 小型适配器矩阵(约 0.1–1%) | 小型适配器矩阵(约 0.1–1%) |
| 基础模型精度 | FP16 / BF16 | FP16 / BF16 | 4 位(NF4) |
| 7B 模型显存 | 约 60+ GB | 约 16 GB | 约 6–8 GB |
| 消费级 GPU 兼容 | 否 | 有限 | 是(T4、RTX 3060+) |
| 相对全量微调质量 | 基线 | 约 98–99% | 约 96–98% |
| 训练速度 | 最慢 | 快 | 快 |
在我们的场景中,我们将使用 BitsAndBytes 创建 NF4 类型配置的 4 位量化。
compute_dtype = getattr(torch, "float16")
quant_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_quant_type="nf4",
bnb_4bit_compute_dtype=compute_dtype,
bnb_4bit_use_double_quant=False,
)5. 加载 Llama 2 模型
现在我们将从 Hugging Face 以 4 位精度并使用 "float16" 计算类型加载模型,以加快训练速度。
model = AutoModelForCausalLM.from_pretrained(
base_model,
quantization_config=quant_config,
device_map={"": 0}
)
model.config.use_cache = False
model.config.pretraining_tp = 16. 加载分词器
接下来,我们将从 Hugging Face 加载分词器,并将 padding_side 设为 “right”,以修复 fp16 的相关问题。
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"7. PEFT 参数
传统的预训练语言模型(PLM)微调需要更新全部模型参数,计算开销大且需要海量数据。
参数高效微调(PEFT)仅更新模型中一小部分最具影响力的参数,因而效率更高。通过阅读 PEFT 官方文档了解相关参数。
peft_params = LoraConfig(
lora_alpha=16,
lora_dropout=0.1,
r=64,
bias="none",
task_type="CAUSAL_LM",
)8. 训练参数
以下是可用于优化训练过程的超参数列表:
- output_dir:输出目录,用于存放模型预测与检查点。
- num_train_epochs:训练轮数。
- fp16/bf16:是否禁用 fp16/bf16 训练。
- per_device_train_batch_size:每块 GPU 的训练批大小。
- per_device_eval_batch_size:每块 GPU 的评估批大小。
- gradient_accumulation_steps:更新过程中梯度累积的步数。
- gradient_checkpointing:启用梯度检查点。
- max_grad_norm:梯度裁剪。
- learning_rate:初始学习率。
- weight_decay:对除偏置/LayerNorm 权重外的所有层应用权重衰减。
- Optim:模型优化器(AdamW)。
- lr_scheduler_type:学习率调度策略。
- max_steps:训练步数。
- warmup_ratio:线性预热的步数比例。
- group_by_length:可显著提升性能并加速训练。
- save_steps:每 25 个更新步保存一次检查点。
- logging_steps:每 25 个更新步记录一次日志。
training_params = TrainingArguments(
output_dir="./results",
num_train_epochs=1,
per_device_train_batch_size=4,
gradient_accumulation_steps=1,
optim="paged_adamw_32bit",
save_steps=25,
logging_steps=25,
learning_rate=2e-4,
weight_decay=0.001,
fp16=False,
bf16=False,
max_grad_norm=0.3,
max_steps=-1,
warmup_ratio=0.03,
group_by_length=True,
lr_scheduler_type="constant",
report_to="tensorboard"
)9. 模型微调
监督式微调(SFT)是基于人类反馈的强化学习(RLHF)中的关键步骤。HuggingFace 的 TRL 库提供了易用的 API,只需几行代码即可创建 SFT 模型并在您的数据集上训练。它配套了使用强化学习训练语言模型的工具,流程从监督式微调开始,继而是奖励建模,最后是近端策略优化(PPO)。
我们将为 SFT Trainer 提供模型、数据集、Lora 配置、分词器以及训练参数。
trainer = SFTTrainer(
model=model,
train_dataset=dataset,
peft_config=peft_params,
dataset_text_field="text",
max_seq_length=None,
tokenizer=tokenizer,
args=training_params,
packing=False,
)我们将使用 .train() 在新数据集上微调 Llama 2 模型。模型完成 1 个 epoch 约耗时一个半小时。
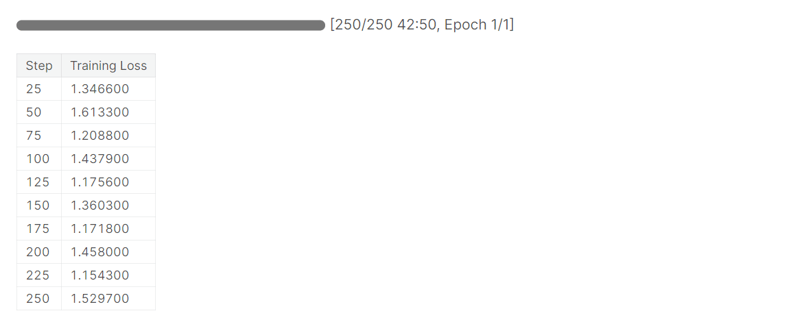
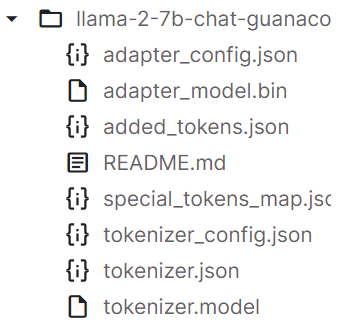
训练完成后,我们将保存模型适配器与分词器。您也可以使用类似的 API 将模型上传至 Hugging Face。
trainer.model.save_pretrained(new_model)
trainer.tokenizer.save_pretrained(new_model)
10. 评估
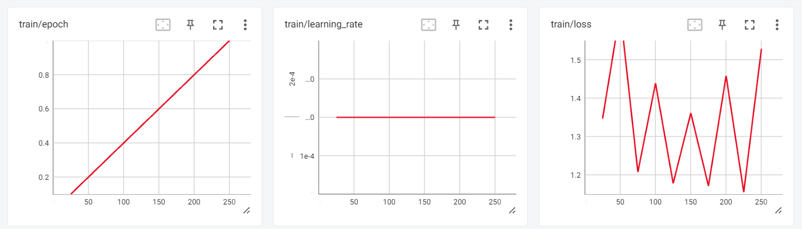
我们现在可以在 Tensorboard 的交互式会话中查看训练结果。
from tensorboard import notebook
log_dir = "results/runs"
notebook.start("--logdir {} --port 4000".format(log_dir))
为了测试我们微调后的模型,我们将使用 transformers 的文本生成管线,并提出类似 “Who is Leonardo Da Vinci?” 这样的问题。
logging.set_verbosity(logging.CRITICAL)
prompt = "Who is Leonardo Da Vinci?"
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])输出:
模型生成了连贯且详尽的回答。
<s>[INST] Who is Leonardo Da Vinci? [/INST] Leonardo da Vinci (1452-1519) was an Italian polymath, artist, inventor, and engineer.
Da Vinci is widely considered one of the greatest painters of all time, and his works include the famous Mona Lisa. He was also an accomplished engineer, inventor, and anatomist, and his designs for machines and flight were centuries ahead of his time.
Da Vinci was born in the town of Vinci, Italy, and he was the illegitimate son of a local notary. Despite his humble origins, he was able to study art and engineering in Florence, and he became a renowned artist and inventor.
Da Vinci's work had a profound impact on the Renaissance, and his legacy continues to inspire artists, engineers, and inventors to this day. He
我们再问一个问题。
prompt = "What is DataCamp Career track?"
result = pipe(f"<s>[INST] {prompt} [/INST]")
print(result[0]['generated_text'])输出:
Guanaco 是一个高质量数据集,过去曾用于微调最先进的 LLM。完整的 Guanaco 数据集可在 Hugging Face 上获取,并有望在多种自然语言任务上取得更高表现。
<s>[INST] What is Datacamp Career track? [/INST] DataCamp Career Track is a program that offers a comprehensive learning experience to help you build your skills and prepare for a career in data science.
The program includes a range of courses, projects, and assessments that are designed to help you build your skills in data science. You will learn how to work with data, create visualizations, and build predictive models.
In addition to the technical skills, you will also learn how to communicate your findings to stakeholders and how to work with a team to solve complex problems.
The program is designed to be flexible, so you can learn at your own pace and on your own schedule. You will also have access to a community of learners and mentors who can provide support and guidance throughout the program.
Overall, DataCamp Career Track is a great way to build your skills and prepare for a career in这里提供了包含代码与输出的 Colab Notebook,助您开启编码之旅。
接下来,您可以使用 LlamaIndex,基于新训练的模型构建自己的 AI 应用,参见教程 LlamaIndex:为 LLM 添加个人数据。您也可参考 5 个可用生成式模型与开源工具构建的项目获取灵感。
自 Llama 2 以来有哪些变化
自 2023 年 7 月 Llama 2 发布以来,Meta 已推出多款升级模型,改进显著。Llama 3(2024 年 4 月)在所有模型规模上引入更大的 128K 词表与分组查询注意力(GQA)。Llama 3.1(2024 年 7 月)将上下文长度扩展至 128K token,并新增 405B 参数变体。Llama 3.2(2024 年 9 月)带来多模态能力,以及针对边缘设备优化的轻量级 1B/3B 模型。
微调生态同样显著演进。诸如 Unsloth 等工具相比标准 Hugging Face PEFT 可实现 2 倍训练速度、60% 内存节省;而 LLaMA-Factory 等图形界面工具让无需写代码也能完成微调。本文涉及的 QLoRA 与 PEFT 核心概念仍是基础——建议继续阅读我们关于微调 Llama 3.1与微调 Llama 3.2的最新实践。
结论
本教程介绍了如何使用 QLoRA、PEFT 与 SFT 等技术,在内存与算力受限的条件下微调 LLaMA 2。借助 transformers、accelerate、peft、trl 与 bitsandbytes 等 Hugging Face 库,我们成功在消费级 GPU 上微调了 7B 参数的 LLaMA 2 模型。
总体而言,本教程展示了近期进展如何推动大型语言模型的民主化与可达性,使得即便是业余爱好者也能在有限资源下构建最前沿的 AI。
若想继续学习,可选修 Fine-Tuning with Llama 3 课程,动手实践更新的模型;或通过 Working with Hugging Face 课程深入理解本教程所用生态。打好基础可从 Introduction to LLMs in Python 或 Large Language Models (LLMs) Concepts 课程开始,并探索 AI Fundamentals 技能路径。
参考资料

作为一名持证的数据科学家,我热衷于利用前沿技术打造创新的机器学习应用。凭借在语音识别、数据分析与报告、MLOps、对话式人工智能以及自然语言处理方面的扎实背景,我不断打磨构建智能系统的能力,力求带来切实影响。除技术专长外,我也擅长沟通,能够将复杂概念提炼为清晰、简明的表述。因此,我成为数据科学领域备受关注的博主,与不断壮大的数据专业人士社区分享洞见与实践经验。目前,我专注于内容创作与编辑,借助大语言模型打造有力且吸引人的内容,帮助企业与个人更好地发挥数据价值。
Llama 2 QLoRA 微调常见问答
什么是 QLoRA?它与 LoRA 有何不同?
QLoRA(量化低秩适配)结合了两种节省内存的技术:以 4 位量化精度加载基础模型,并在其上训练小型低秩适配器层。标准 LoRA 将基础模型保持在 16 位精度(FP16),对 7B 模型大约需要 16 GB 显存。QLoRA 通过将冻结的基础模型量化为 4 位,将需求降至 6–8 GB,从而能在 T4 或 RTX 3060 等消费级 GPU 上完成微调。LoRA 与 QLoRA 在标准基准上的质量差通常低于 2%。
不使用云端 GPU,我能在本地机器上微调 Llama 2 吗?
可以,如果您的机器配备至少 8 GB 显存且支持 CUDA 的 NVIDIA GPU。诸如 RTX 3060(12 GB)、RTX 4060 或 RTX 2080 Ti 等 GPU 与 QLoRA 搭配良好。搭载 M 系列芯片的 Apple Silicon 用户也可使用 Apple 的 MLX 框架进行微调,但训练速度会慢于同等级的 NVIDIA GPU。若本机无合适 GPU,Google Colab(T4 GPU)或 Kaggle 等免费云端选项对 7B 模型也很适用。
微调 Llama 2 7B 需要多长时间?
训练时长取决于您的 GPU、数据集规模与配置。在免费的 Google Colab T4 GPU 上,使用 1,000 条样本、1 个 epoch,预计约需 1–2 小时。RTX 4090 完成同样任务约需 30–45 分钟。对于更大的数据集(10,000+ 样本),训练基本线性扩展——T4 可能需 3–4 小时,而 RTX 4090 约 1.5–2 小时。
Llama 2 微调需要什么样的数据集格式?
Llama 2 期望使用其聊天模板格式的对话数据:<s>[INST] user message [/INST] assistant response </s>。本教程使用的数据集(mlabonne/guanaco-llama2-1k)已按此格式整理。对于自定义数据集,您可以使用 Hugging Face 的 datasets 库从 JSON、CSV 或 parquet 文件加载数据,并在预处理阶段应用 Llama 2 的提示模板。
2026 年微调 Llama 2 还有价值吗?
Llama 2 仍是理解微调概念的良好学习资源,但对于生产场景,更新的模型如 Llama 3.1 和 Llama 3.2 在性能、上下文长度与效率方面都有显著提升。本文介绍的 QLoRA 与 PEFT 技术可直接迁移到新模型。请参阅我们关于微调 Llama 3.1与微调 Llama 3.2的教程,获取最新方法。
在 Meta 推出首个版本的 LLaMA 之后,随之而来的是一场打造更强大大型语言模型(LLM)的新军备竞赛,以期与 GPT-3.5(ChatGPT)等模型一较高下。开源社区快速发布了越来越强的模型。对 AI 爱好者而言,这几乎像是在过圣诞节,新进展频频宣布。
然而,这些进步也带来了问题。大多数开源模型都带有受限许可协议,意味着只能用于研究目的。其次,只有预算充足的大公司或研究机构才负担得起对模型进行微调或训练。最后,部署和维护最先进的大模型成本高昂。
新版本的 LLaMA 模型旨在解决这些问题。它采用商业许可,使更多组织能够使用。此外,新的方法学现在允许在显存有限的消费级 GPU 上进行微调。
这种 AI 的普及化对广泛采用至关重要。通过降低进入门槛,即使是小公司也能构建适合自身需求与预算的定制模型。
在本教程中,我们将探索 Llama-2,并演示如何在 Google Colab 上使用新数据集对其进行微调。此外,我们还将介绍能够降低内存占用并加速训练过程的新方法与微调技术。
图片由作者使用 DALL-E 3 生成
要点速览
transformers、peft、trl、bitsandbytes)微调 Llama 2 7B理解 Llama 2 与模型微调
Llama 2 是 Meta 推出的第二代开源 LLM 系列,配套商业许可。它旨在处理广泛的自然语言处理任务,模型规模从 70 亿到 700 亿参数不等。通过阅读我们的文章《Meta AI 的 LLaMA 简介:赋能 AI 创新》,了解更多 LLaMA 模型信息。
专为对话优化的 Llama-2-Chat 展现出与 ChatGPT、PaLM 等主流闭源模型相近的表现。我们甚至可以通过在高质量对话数据集上微调进一步提升其性能。
在机器学习中,微调是指在新数据上调整预训练模型的权重与参数,以提升其在特定任务上的表现。它涉及在与当前任务相关的新数据集上训练模型,同时更新模型权重以适应新数据。更多微调内容请参考我们的GPT 3.5 微调指南。
在消费级硬件上微调 LLM 颇具挑战,受限于显存与算力。但在本教程中,我们将克服这些内存与计算的限制,使用 Google Colab 免费版 Notebook 来训练我们的模型。