

OpenAI 音频 API
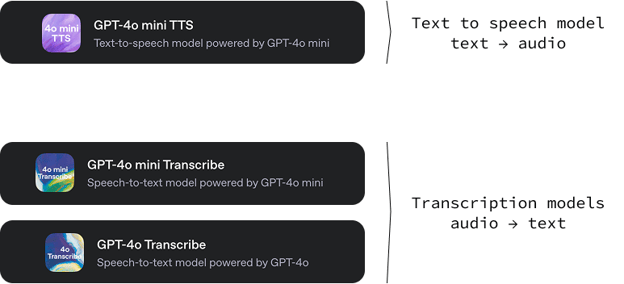
此次 OpenAI 的新版本包含三个模型:
gpt-4o-mini-tts:一种文本转音频模型,能够以多种语气和声音从文本生成音频。该文本转语音模型的一项妙用是,我们可以通过提供特定的文本指令来引导语音的听感。这带来了高度的可定制性,便于打造独特且量身定制的语音体验。您可以在OpenAI.fm上试用。-
gpt-4o-transcribe和gpt-4o-mini-transcribe:两种音频转文本模型,专为将口语转换为书面文本而设计。它们的主要功能是提供高度准确且可靠的音频转写。这些模型具有更低的词错误率(WER),也就是说,相较于以往方案,它们在识别口语词汇时犯错更少。
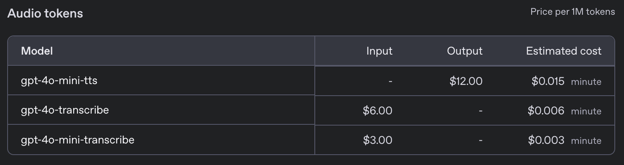
这些新模型的定价如下:
语音助手项目
在本教程中,我将带您在终端中构建一个 AI 语音助手。这个语音助手本质上会模拟流行的文本式 AI 模型,但交互将完全通过口语完成。想象一下,您可以直接对着电脑说话,提出任何问题,并几乎即时收到语音回复。
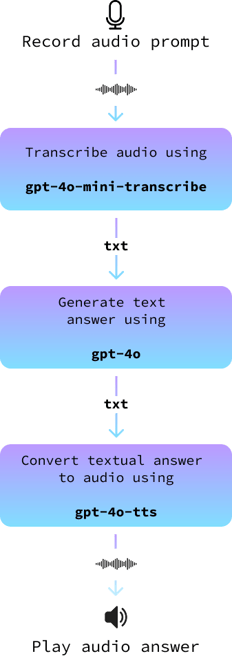
我们的项目将采用一个简单而有效的架构。我们将先用麦克风捕获您的口语提示。录制完成后,我们会借助先进的语音转文本模型将该音频输入转换为文本。
随后将该文本传入大型语言模型以生成合适的回复。最后,我们会把文本回复再转换为音频,让助手把答案“说”给您听。流程中的每一步都旨在确保我们的语音助手既准确又有吸引力。
尽管 OpenAI 提供了专门的Realtime API,可通过简化整个流程来增强交互,但我们将选择另一种方式。Realtime API 虽然令人印象深刻,且非常适合追求快速集成的开发者,但往往成本更高、灵活性更低。
通过为每一步构建独立组件来实现本项目,我们可以对 AI 助手的定制拥有更大的掌控权。这种方式让我们可以自行选择所用模型,从而根据特定需求(无论是准确性、速度,还是回复语气偏好)进行优化。如此一来,我们的语音助手不仅功能强大,而且高度定制,能够契合独特的项目需求。
本文开发的全部代码可在此 GitHub 仓库中获取。
Python 环境配置
首先,我们将创建一个名为 audio-demo 的新 Anaconda 环境。Anaconda 环境可为每个项目创建相互隔离的空间,让我们能无冲突地安装特定版本的包。请在命令行中执行以下命令:
conda create -n audio-demo -y python=3.9
conda activate audio-demo
pip install openai
pip install numpy
pip install dotenv
pip install sounddevice
pip install scipy下面逐条说明每条命令和每个包的作用:
- 创建环境:
conda create -n audio-demo -y python=3.9:创建名为audio-demo的新环境,并使用 Python 3.9。-y参数会自动同意安装,无需确认。
- 激活环境:
conda activate audio-demo:激活刚创建的audio-demo环境,后续操作都在该环境中进行。
- 安装依赖包:
pip install openai:OpenAI 库,便于访问 OpenAI 的模型和 API。pip install numpy:NumPy,进行数值计算的基础库。pip install dotenv:Dotenv 可从.env文件加载环境变量,便于更安全地进行配置管理。pip install sounddevice:Sounddevice 让我们用简单函数录音和播放音频,适合在 Python 中处理音频输入与输出。pip install scipy:SciPy 基于 NumPy,提供更多科研与工程计算功能,如信号处理。在本项目中,我们将用它来保存音频文件。
完成 audio-demo 环境配置后,我们就可以开始开发能处理音频输入的 AI 助手了。这样的结构化设置有助于保持干净的开发空间,确保项目所需依赖齐备。
OpenAI API 密钥配置
要使用 OpenAI API,我们需要一个 API 密钥。前往其 API 密钥页面,点击 "Generate new secret key" 按钮生成密钥。复制该密钥,创建名为 .env 的文件,并按以下格式粘贴进去:
OPENAI_API_KEY=<paste_your_api_key_here>文本转音频示例
下面通过步骤创建一个使用 OpenAI 文本转音频能力的 Python 脚本,将文本转化为带有个性化风格的语音。我们在与 .env 文件同一文件夹下编写名为 text_to_audio.py 的代码。
导入所需库
首先导入构成脚本的必要库:
import asyncio
from openai import AsyncOpenAI
from openai.helpers import LocalAudioPlayer
from dotenv import load_dotenv快速了解这些导入分别做什么:
asyncio:用于编写异步代码,对接流式 API 至关重要。AsyncOpenAI:OpenAI 库的一部分,提供以异步方式与 OpenAI API 交互的工具。LocalAudioPlayer:OpenAI 的辅助工具,用于在本机播放音频。load_dotenv:从.env文件加载环境变量,我们会把 API 密钥等敏感信息存放于此。
加载环境变量
接着,使用 load_dotenv 函数从 .env 文件加载 API 密钥:
load_dotenv()这样即可确保脚本能安全地访问 API 密钥。
初始化 OpenAI
创建 AsyncOpenAI 实例,以开始与 OpenAI API 交互:
openai = AsyncOpenAI()编写主函数
现在定义主函数 text_to_audio(),使用 OpenAI 的文本转音频功能处理输入并播放生成的音频:
async def text_to_audio(text, tone_and_style_instructions):
async with openai.audio.speech.with_streaming_response.create(
model="gpt-4o-mini-tts",
voice="coral",
input=text,
instructions=tone_and_style_instructions,
response_format="pcm",
) as response:
await LocalAudioPlayer().play(response)快速说明上述代码的作用:
- 通过
model和voice参数控制语音合成。使用的model为gpt-4o-mini-tts,选择的声音为 "coral"。 - 将
response_format设为"pcm",便于后续音频处理。 - 随后由
LocalAudioPlayer播放 API 生成的音频回复。
执行函数
用以下代码收尾,确保在执行脚本时会运行 text_to_audio() 函数:
if __name__ == "__main__":
asyncio.run(text_to_audio("Hello world!", "Enthusiastic voice."))该代码块会检查脚本是否作为主模块运行,并使用 asyncio.run() 执行 text_to_audio(),以处理异步逻辑。
至此,脚本即可使用 OpenAI 的文本转音频服务将文本输入转换为语音。这样的设置便于我们尝试不同的输入和风格,让文本通过声音“活起来”。
使用以下命令运行脚本:
python text_to_audio.py完整代码见此处。
从文件进行音频转写
本节我们来了解如何使用 OpenAI 的音频转写工具将音频文件转为文本。我们的脚本将以异步方式处理音频文件,以提高效率和速度。我们会将该脚本实现于名为 audio_to_text.py 的文件中。
导入与初始设置与之前相同,不同之处在于这里无需导入 LocalAudioPlayer。以下是一个用于转写音频文件的函数:
async def transcribe_audio(audio_filename = "audio.wav"):
audio_file = await asyncio.to_thread(open, audio_filename, "rb")
stream = await openai.audio.transcriptions.create(
model="gpt-4o-mini-transcribe",
file=audio_file,
response_format="text",
stream=True,
)
transcript = ""
async for event in stream:
if event.type == "transcript.text.delta":
print(event.delta, end="", flush=True)
transcript += event.delta
print()
audio_file.close()
return transcript下面拆解一下其工作流程:
- 打开音频文件:
audio_file = await asyncio.to_thread(open, audio_filename, "rb"):以二进制只读模式("rb")打开音频文件。通过asyncio.to_thread()将该阻塞操作放到单独线程中,避免阻塞程序其他部分。
- 创建转写流:
stream = await openai.audio.transcriptions. create(...):调用转写 API。- 将
model指定为gpt-4o-mini-transcribe,该模型专为转写任务设计。 file参数为我们打开的音频文件。response_format="text"表示以文本形式返回转写结果。stream=True开启实时流式转写,音频一经处理便立即返回对应片段,从而加快响应。
- 处理转写流:
async for event in stream:启动循环,按事件产生的顺序读取转写流中的事件。if event.type == "transcript.text.delta"::检测事件类型,若为transcript.text.delta(表示有部分转写已就绪),则予以处理。print(event.delta, end="", flush=True):实时打印增量转写结果,确保即时输出。
- 关闭音频文件:
audio_file.close():完成转写后关闭音频文件,释放系统资源。
执行 main() 函数后,我们即可高效地将音频文件转换为文本,并以流式方式处理以获得即时反馈。此设置非常适合需要快速转写或包含长音频的应用。
您可以将音频文件放在与脚本相同的文件夹内,将 audio.wav 替换为您的音频文件名,并运行以下命令进行尝试:
python audio_to_text.py完整代码见此处。
从麦克风进行音频转写
由于我们的目标是创建语音助手,需要先将用户的语音提示录制为音频文件。
我们将创建一个名为 record.py 的新文件,并实现一个名为 record_audio 的函数。该函数从麦克风采集声音并保存为音频文件。其工作原理并非本文重点,这里不做展开:
import sounddevice as sd
import numpy as np
import scipy.io.wavfile as wavfile
SAMPLE_RATE = 44100 # Sample rate in Hz
def record_audio():
print("[INFO: Recording... Press <Enter> to stop]")
audio_data = [] # Initialize a list to store audio frames
def callback(indata, frames, time, status):
audio_data.append(indata.copy())
with sd.InputStream(samplerate=SAMPLE_RATE, channels=1, callback=callback, dtype='int16'):
input() # Wait for the user to press Enter to stop recording
print("[INFO: Recording complete]")
print()
audio_data = np.concatenate(audio_data) # Concatenate the list into a single array
filename = "output.wav"
wavfile.write(filename, SAMPLE_RATE, audio_data)
return audio_data调用该函数后,将开始从用户麦克风录音。程序会等待用户按下 "Enter",随后将音频保存为给定文件名的文件。
为进行测试,我们可以将该函数与上文的转写函数结合,对用户说出的消息进行转写。如下在新文件 record_and_transcribe.py 中实现:
import asyncio
from audio_to_text import transcribe_audio
from audio_recorder import record_audio
async def main():
record_audio("prompt.wav")
await transcribe_audio("prompt.wav")
if __name__ == "__main__":
asyncio.run(main())您可以用命令 python record_and_transcribe.py 运行它。脚本会在您按下 "Enter" 前持续录音,然后转写您说的内容。
构建音频助手
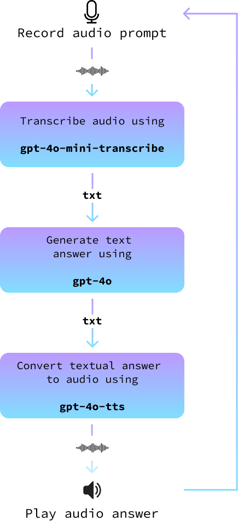
本节我们将把前面的部分整合起来,构建一个音频助手。我们在名为 audio_assistant.py 的新文件中按以下步骤实现:
- 使用
record_audio()函数录制用户语音提示。 - 使用
transcribe_audio()函数将语音提示转换为文本。 - 使用常规文本生成模型(如
gpt-4o)生成答案。 - 最后使用
text_to_audio()函数将文本答案转换为音频。 - 循环上述过程,直至用户退出。
下图对此进行了说明:
建议您先动手尝试构建,再继续往下阅读。
首先,导入我们之前实现的函数并初始化 OpenAI 客户端。
# Import the functions we created
from text_to_audio import text_to_audio
from audio_to_text import transcribe_audio
from audio_recorder import record_audio
# Import other dependencies and initialize OpenAI
import asyncio
from openai import AsyncOpenAI
from dotenv import load_dotenv
load_dotenv()
openai = AsyncOpenAI()然后,我们需要一个生成答案的函数。它使用常规的 OpenAI GPT API,模型可以是 gpt-4o 或任一文本生成模型。如果您对此不熟悉,可以参考这篇GPT-4o API 教程。
以下是该函数的异步实现:
async def get_answer(prompt):
stream = await openai.chat.completions.create(
model="gpt-4o",
messages=[
{"role": "user", "content": prompt}
],
stream=True,
)
answer = ""
async for chunk in stream:
content = chunk.choices[0].delta.content
if content is not None:
answer += content
print(content, end="", flush=True)
print("\n\n")
return answer实现主循环时,按照上述步骤进行:
async def main(tone_and_style_instructions):
await text_to_audio("Hello, how can I help you today?", tone_and_style_instructions)
while True:
record_audio("prompt.wav")
prompt = await transcribe_audio("prompt.wav")
print()
answer = await get_answer(prompt)
await text_to_audio(answer, tone_and_style_instructions)最后,在脚本执行时运行主循环:
if __name__ == "__main__":
tone_and_style_instructions = "Enthusiastic voice."
asyncio.run(main(tone_and_style_instructions))下面是其运行演示:
完整代码见此处。
进一步改进
如果我们用复杂的语气和风格指令来使用助手,可能会注意到词句内容与语气之间有些脱节。例如,以下是来自 OpenAI 网站、用于“Emo Teenager(情绪化青少年)”声音的指令:
tone_and_style_instructions = """
Tone: Sarcastic, disinterested, and melancholic, with a hint of passive-aggressiveness.
Emotion: Apathy mixed with reluctant engagement.
Delivery: Monotone with occasional sighs, drawn-out words, and subtle disdain, evoking a classic emo teenager attitude.
"""音频的语音语调会匹配这种风格,但由 get_answer() 函数生成的文本内容并不会据此调整,可能造成轻微的不一致。示例如下:
为解决这个问题,我们可以在 get_answer() 函数中,将用户消息与系统提示配对,指明生成的文本应遵循语气与风格指令。
为此,我们把 tone_and_style_instructions 作为 get_answer() 函数的第二个参数,并在聊天请求中添加系统消息:
async def get_answer(prompt, tone_and_style_instructions):
stream = await openai.chat.completions.create(
model="gpt-4o",
messages=[
{
"role": "system",
"content":
f"""
The text you generate is being used in a text-to-voice model.
Make sure your answer matches the guidelines {tone_and_style_instructions}
"""
},
{"role": "user", "content": prompt}
],
stream=True,
)
answer = ""
async for chunk in stream:
content = chunk.choices[0].delta.content
if content is not None:
answer += content
print(content, end="", flush=True)
print("\n\n")
return answer现在模型的回答如下所示:
如您所见,生成的文本现已匹配语气指令。完整代码见此处。
使用 Agents API 构建助手
在前一个示例中,我们手动调用了语音转文本和文本转语音模型来构建语音助手。借此我们学会了如何显式使用 OpenAI 语音 API 中的新模型。
然而,如果目标是构建语音助手,使用 Agents API 有更简单的方法。该 API 已更新,能够自动处理我们在此实现的语音→文本→语音流程。
如果您是首次使用 Agents API,建议先查看这篇关于OpenAI Agents SDK的教程。
开始之前,我们需要再安装一个依赖:
pip install 'openai-agents[voice]'准备就绪后,先导入运行带语音管线的 agent 所需的一切:
from dotenv import load_dotenv
load_dotenv()
import asyncio
from agents import Agent
from agents.voice import (
AudioInput,
SingleAgentVoiceWorkflow,
VoicePipeline,
VoicePipelineConfig,
TTSModelSettings,
)
from audio_recorder import record_audio
from audio_player import AudioPlayer其中 AudioPlayer 并非来自某个包,而是从本地文件导入,包含一个简单的类,帮助我们实时播放音频。这是必须的,因为使用 VoicePipeline 时我们会分块获取音频,需要边接收边播放。以下是audio_player.py 文件的内容:
import numpy as np
import sounddevice as sd
class AudioPlayer:
def __enter__(self):
self.stream = sd.OutputStream(samplerate=24000, channels=1, dtype=np.int16)
self.stream.start()
return self
def __exit__(self, tp, val, tb):
self.stream.close()
def add_audio(self, audio_data):
self.stream.write(audio_data)下一步,创建一个 agent:
agent = Agent(
name="Voice Assistant",
instructions="You’re a helpful assistant speaking to a human.",
model="gpt-4o-mini",
)参数说明如下:
name:可随意命名。instructions:定义 agent 的定位,相当于系统提示词。model:用于生成答案的模型。
该 agent 的作用类似我们之前实现的 get_answer() 函数。可将其视为为文本提示提供答案的管线组件。
接下来定义管线,在此处配置所有与语音相关的内容:
pipeline = VoicePipeline(
workflow=SingleAgentVoiceWorkflow(agent),
stt_model="gpt-4o-mini-transcribe",
tts_model="gpt-4o-mini-tts",
config=VoicePipelineConfig(
tts_settings=TTSModelSettings(
voice="coral",
instructions="""
Speak in an enthusiastic voice.
"""
)
)
)部分参数说明如下:
stt_model:用于将语音转换为文本的模型。tts_model:用于将文本转换为语音的模型。config:提供管线配置。此处用于指定tts_model采用的声音和语音指令。
最后,像之前一样运行主循环:
async def main():
while True:
audio_input = AudioInput(buffer=record_audio())
result = await pipeline.run(audio_input)
with AudioPlayer() as player:
async for event in result.stream():
if event.type == "voice_stream_event_audio":
player.add_audio(event.data)
if __name__ == "__main__":
asyncio.run(main())完整实现见此处。
添加工具
请注意,该循环会一直运行,因为我们未指定停止条件。执行时您需要手动终止进程。实现停止的一种方式是为 agent 提供一个工具。
工具是我们提供给 agent 的函数,由其代我们执行。本例中,我们可以提供一个停止脚本的函数。agent 根据函数名和注释来判断是否应调用它。
from agents import function_tool
@function_tool
def stop_conversation():
"""Stop the conversation."""
exit()然后将该工具提供给 agent:
agent = Agent(
…
tools=[stop_conversation], # Add this line when creating the agent
)这样,当我们说“我想结束对话”时,agent 会理解需要调用 stop_conversation()。需要注意的是,由于 stop_conversation() 的实现方式,此实现不会优雅退出。
如需完整脚本,请查看此文件。
使用多个 agent
Agents API 的一个亮点是,我们可以配置多个 agent 协同工作。以下示例摘自OpenAI 文档:
from agents.extensions.handoff_prompt import prompt_with_handoff_instructions
spanish_agent = Agent(
name="Spanish voice assistant",
handoff_description="A spanish speaking agent.",
instructions=prompt_with_handoff_instructions(
"You're speaking to a human, so be polite and concise. Speak in Spanish.",
),
model="gpt-4o-mini",
)
agent = Agent(
name="Voice Assistant",
instructions=prompt_with_handoff_instructions("""
You're speaking to a human, so be polite and concise.
If the user speaks in Spanish, handoff to the spanish agent.
"""),
model="gpt-4o-mini",
)在该示例中,我们定义了第二个以西班牙语交流的 agent,并通过带交接(handoff)的提示对第一个 agent 进行了改造。当交接条件满足时,第二个 agent 将接手并继续对话。
完整脚本见此处。
结语
借助 OpenAI 最新音频模型的先进能力,我们构建了一个能将口语高效转写为文本,并将文本回复生成类人语音的系统。该项目不仅展示了当前技术的潜力,也体现了这些工具对希望打造定制 AI 方案的开发者已变得多么易用。

OpenAI 推出了新一代音频模型,专注于增强语音转文本和文本转语音能力。最新模型在复杂场景(如口音或嘈杂环境)下具有更高的准确性,并提供更可定制的语音交互。
在本教程中,我将逐步讲解如何使用这些新的 OpenAI 音频模型构建一个语音对语音的 AI 助手。我们的目标是开发一个能够理解口语输入并以自然合成语音、针对特定需求进行定制回复的 AI 助手。