

OpenAI Audio API
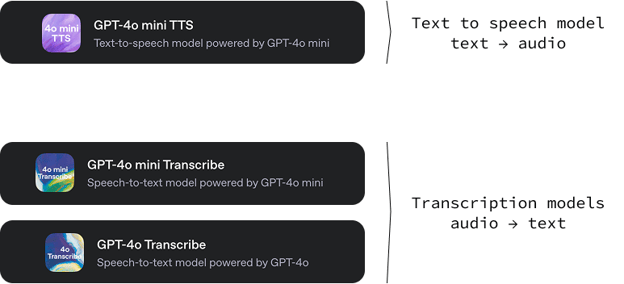
OpenAI'nin bu yeni sürümü üç model içeriyor:
gpt-4o-mini-tts: Farklı tonlar ve seslerle metinden ses üretme yeteneğine sahip bir metinden-sese modelidir. Bu metinden-konuşmaya modelinin güzel bir özelliği, belirli metin talimatları vererek sesin nasıl çıkacağını yönlendirebilmemizdir. Bu, yüksek düzeyde özelleştirme sağlar ve benzersiz, ihtiyaçlara özel ses deneyimleri oluşturmayı mümkün kılar. OpenAI.fm üzerinde deneyebilirsiniz.-
gpt-4o-transcribevegpt-4o-mini-transcribe: Konuşulan dili yazılı metne dönüştürmek için tasarlanmış iki sesten-metine modelidir. Temel işlevleri, sesin yüksek doğrulukta ve güvenilir şekilde yazıya dökümünü sağlamaktır. Bu modeller, daha düşük kelime hata oranı (WER) sergileyerek, önceki çözümlere kıyasla konuşulan kelimeleri tanımada daha az hata yapar.
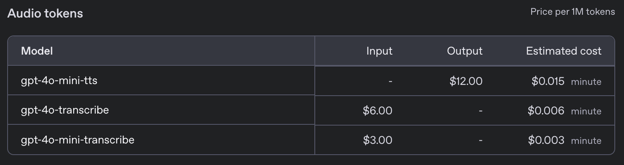
Bu yeni modellerin fiyatlandırması şu şekildedir:
Sesli Asistan Projesi
Bu eğitimde, doğrudan terminalinizde bir yapay zekâ sesli asistanı oluşturma sürecinde size rehberlik edeceğim. Bu sesli asistan, temelde popüler bir metin tabanlı yapay zekâ modelini taklit edecek ancak etkileşimlerin tamamı konuşma üzerinden gerçekleşecek. Bilgisayarınızla doğrudan konuşabildiğinizi, aklınızdaki herhangi bir soruyu sorabildiğinizi ve neredeyse anında sesli bir yanıt alabildiğinizi hayal edin.
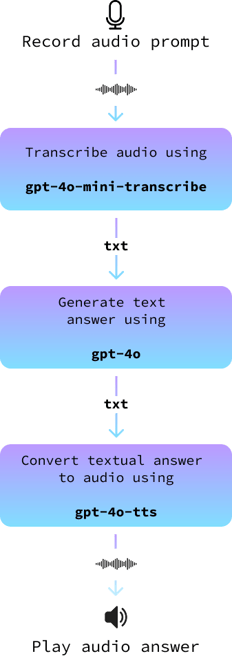
Projemiz, basit ama etkili bir mimari kullanacak. Önce mikrofonunuzu kullanarak konuşulan isteminizi yakalayacağız. Kaydı yaptıktan sonra, bu ses girdisini gelişmiş konuşmadan-metine modellerin yardımıyla metne dönüştüreceğiz.
Ardından bu metni, uygun bir yanıt üretmesi için büyük bir dil modeline vereceğiz. Son olarak, metin yanıtını tekrar sese dönüştüreceğiz; böylece asistan yanıtı size “konuşarak” iletecek. Bu sürecin her adımı, sesli asistanımızın hem doğru hem de ilgi çekici olmasını sağlamak üzere tasarlandı.
OpenAI, tüm süreci kolaylaştırarak etkileşimleri iyileştirebilen özel bir Realtime API sunsa da biz farklı bir yaklaşım tercih edeceğiz. Realtime API etkileyici ve hızlı entegrasyonlar arayan geliştiriciler için ideal olsa da, çoğu zaman daha maliyetli ve daha az esnektir.
Her adım için ayrı bileşenler kullanarak projemizi oluşturmayı seçerek, yapay zekâ asistanımızın özelleştirilmesi üzerinde daha fazla kontrol kazanırız. Bu yaklaşım, kullanmak istediğimiz modelleri seçmemize olanak tanır; böylece doğruluk, hız veya yanıt tonuna yönelik tercihler gibi belirli ihtiyaçlara göre optimize edebiliriz. Bu sayede sesli asistanımız yalnızca güçlü bir araç olmakla kalmaz, aynı zamanda benzersiz proje gereksinimlerine uyum sağlayabilen yüksek derecede kişiselleştirilmiş bir çözüme dönüşür.
Burada geliştirdiğimiz tüm kodlara bu GitHub deposundan ulaşabilirsiniz.
Python Kurulumu
Başlamak için önce audio-demo adlı yeni bir Anaconda ortamı kuracağız. Anaconda ortamları, her proje için paketlerin belirli sürümlerini çakışma olmadan kurabileceğimiz izole alanlar oluşturmamızı sağlar. Aşağıdaki komutları komut satırınızda çalıştırın:
conda create -n audio-demo -y python=3.9
conda activate audio-demo
pip install openai
pip install numpy
pip install dotenv
pip install sounddevice
pip install scipyHer komut ve paketin ne yaptığına kısaca bakalım:
- Ortamı oluşturma:
conda create -n audio-demo -y python=3.9: Bu komut, Python 3.9 sürümüyleaudio-demoadlı yeni bir ortam oluşturur.-ybayrağı, yüklemeleri sormadan otomatik olarak onaylar.
- Ortamı etkinleştirme:
conda activate audio-demo: Yeni oluşturulanaudio-demoortamını etkinleştirir; böylece çalışmalarımızı bunun içinde yürütürüz.
- Paketleri yükleme:
pip install openai: OpenAI kütüphanesi, OpenAI'nin modellerine ve API'lerine kolay erişim sağlar.pip install numpy: NumPy, sayısal hesaplamalar için temel bir kütüphanedir.pip install dotenv: Dotenv, yapılandırma yönetimini daha kolay ve güvenli kılan.envdosyasından ortam değişkenlerini yüklemeye yardımcı olur.pip install sounddevice: Sounddevice, Python'da ses girişi ve çıkışını yönetmek için ideal, basit işlevlerle ses kaydı ve çalma imkânı sağlar.pip install scipy: SciPy, NumPy üzerine inşa edilmiştir ve sinyal işleme gibi bilimsel/teknik hesaplamalara yönelik ek işlevler sunar. Bizim durumda, ses dosyasını kaydetmek için kullanacağız.
audio-demo ortamımızı kurduğumuza göre, ses girdilerini işleyebilen yapay zekâ asistanımız üzerinde çalışmaya başlamaya hazırız. Bu yapılandırılmış kurulum, tüm bağımlılıkların proje için yerinde olmasını sağlayarak temiz bir geliştirme alanı sunar.
OpenAI API Anahtarı Kurulumu
OpenAI API'sini kullanmak için bir API anahtarına ihtiyacımız var. API anahtarı sayfalarına gidin ve "Generate new secret key" düğmesine tıklayarak bir anahtar oluşturun. Anahtarı kopyalayın, .env adlı bir dosya oluşturun ve aşağıdaki biçimde içine yapıştırın:
OPENAI_API_KEY=<paste_your_api_key_here>Metinden Sese Örneği
OpenAI'nin metinden-sese yeteneklerini kullanan ve metni kişiselleştirilmiş bir dokunuşla konuşmaya dönüştüren bir Python betiği oluşturma adımlarını birlikte inceleyelim. Kodumuzu, .env dosyasıyla aynı klasörde text_to_audio.py adlı bir dosyada yazacağız.
Gerekli kütüphaneleri içe aktarın
Önce betiğimizi oluşturacak gerekli kütüphaneleri içe aktarmamız gerekiyor:
import asyncio
from openai import AsyncOpenAI
from openai.helpers import LocalAudioPlayer
from dotenv import load_dotenvBu içe aktarmaların her birinin ne yaptığına kısaca bakalım:
asyncio: Python'da eşzamanlı olmayan (asenkron) kod yazmak için gereklidir; akış (streaming) API'leriyle çalışırken önemlidir.AsyncOpenAI: OpenAI kütüphanesinin bir parçasıdır ve OpenAI'nin API'leriyle asenkron etkileşim kurmayı sağlar.LocalAudioPlayer: OpenAI'nin bu yardımcı sınıfı, makinenizde yerel olarak ses çalmanızı sağlar.load_dotenv: API anahtarlarımız gibi hassas bilgileri sakladığımız.envdosyasından ortam değişkenlerini yükler.
Ortam değişkenlerini yükleyin
Sonra, load_dotenv işlevini kullanarak .env dosyasından API anahtarımızı yüklüyoruz:
load_dotenv()Bu, betiğimizin API anahtarına güvenli şekilde erişmesini sağlar.
OpenAI'yi başlatın
OpenAI API ile etkileşime başlamak için bir AsyncOpenAI örneği oluşturuyoruz:
openai = AsyncOpenAI()Ana işleve yazın
Şimdi, OpenAI'nin metinden-sese özelliğini kullanarak girdiyi işleyip ortaya çıkan sesi çalacak text_to_audio() adlı ana fonksiyonumuzu tanımlıyoruz:
async def text_to_audio(text, tone_and_style_instructions):
async with openai.audio.speech.with_streaming_response.create(
model="gpt-4o-mini-tts",
voice="coral",
input=text,
instructions=tone_and_style_instructions,
response_format="pcm",
) as response:
await LocalAudioPlayer().play(response)Yukarıda yaptıklarımızı kısaca açıklayalım:
- Konuşma sentezini kontrol etmek için
modelvevoiceparametrelerini belirtiyoruz. Kullanılanmodelgpt-4o-mini-tts, seçilen ses ise "coral". response_format"pcm"olarak ayarlanır; bu, ses işleme için uygundur.LocalAudioPlayerdaha sonra API tarafından üretilen ses yanıtını çalar.
İşlevi çalıştırın
Betiği çalıştırdığımızda text_to_audio() işlevinin çalışmasını sağlamak için aşağıdaki satırlarla betiği tamamlıyoruz:
if __name__ == "__main__":
asyncio.run(text_to_audio("Hello world!", "Enthusiastic voice."))Bu kod bloğu, betiğin doğrudan çalıştırılan ana modül olup olmadığını kontrol eder ve eşzamansız mantığı yönetmek için asyncio.run() kullanarak text_to_audio() işlevini yürütür.
Bu adımlarla, betiğimiz OpenAI'nin metinden-sese hizmetini kullanarak metin girdisini konuşmaya dönüştürmeye hazır. Bu kurulum, farklı girdi ve stillerle denemeler yapmamıza olanak tanıyarak metni sesle canlandırır.
Betiği şu komutla çalıştırabiliriz:
python text_to_audio.pyTam kodu burada bulabilirsiniz.
Dosyadan Ses Dökümü (Transkripsiyon)
Bu bölümde, OpenAI’nin ses dökümü aracını kullanarak bir ses dosyasını metne nasıl dönüştüreceğimizi inceleyelim. Betiğimiz, işlemi verimli ve hızlı kılmak için ses dosyalarını eşzamanlı olmayan biçimde ele alacak. Bu betiği audio_to_text.py adlı bir dosyada uygulayacağız.
İçe aktarımlar ve başlangıç kurulumu öncekiyle aynı; yalnızca burada LocalAudioPlayer'ı içe aktarmamız gerekmiyor. İşte ses dosyasını yazıya döken bir işlevi nasıl yazabileceğimiz:
async def transcribe_audio(audio_filename = "audio.wav"):
audio_file = await asyncio.to_thread(open, audio_filename, "rb")
stream = await openai.audio.transcriptions.create(
model="gpt-4o-mini-transcribe",
file=audio_file,
response_format="text",
stream=True,
)
transcript = ""
async for event in stream:
if event.type == "transcript.text.delta":
print(event.delta, end="", flush=True)
transcript += event.delta
print()
audio_file.close()
return transcriptBurada neler olduğuna bakalım:
- Ses dosyasını açma:
audio_file = await asyncio.to_thread(open, audio_filename, "rb"): Bu satır ses dosyasını ikili okuma kipinde ("rb") açar.asyncio.to_thread()yöntemi, dosya açma işlemini ayrı bir iş parçacığında çalıştırarak programın diğer bölümlerinin engellenmesini önler.
- Döküm akışı oluşturma:
stream = await openai.audio.transcriptions. create(...): Bu satır döküm API çağrısını yapar.modelparametresi, döküm görevleri için özel olarak tasarlanmışgpt-4o-mini-transcribeolarak belirtilir.-
fileparametresi, açtığımız ses dosyasını taşır. response_format="text", dökümün metin olarak döndürülmesini söyler.stream=True, dökümün gerçek zamanlı akışla gelmesini sağlar; bu, sesin bir kısmı işlenir işlenmez hemen dönmesini sağlayarak yanıtı hızlandırır.
- Döküm akışını işleme:
async for event in stream: Olaylar oluştukça döküm akışından okumaya başlayan bir döngü başlatır.if event.type == "transcript.text.delta":: Her olay türünü kontrol eder vetranscript.text.deltatüründeyse işler; bu, dökümün bir bölümünün hazır olduğu anlamına gelir.print(event.delta, end="", flush=True): Artımlı dökümü hazır oldukça yazdırır; böylece çıktımız gerçek zamanlı olur.
- Ses dosyasını kapatma:
audio_file.close(): Dökümü tamamladıktan sonra sistem kaynaklarını serbest bırakmak için dosyayı kapatmak iyi bir uygulamadır.
main() işlevini çalıştırarak, bir ses dosyasını verimli şekilde metne dönüştürebilir ve anında geri bildirim almak için akışlı olarak işleyebiliriz. Bu kurulum, hızlı döküm gerektiren veya uzun ses dosyalarını içeren uygulamalar için idealdir.
Bunu denemek için, betikle aynı klasöre bir ses dosyası yerleştirebilir, audio.wav'i ses dosyanızın adıyla değiştirebilir ve şu komutu çalıştırabilirsiniz:
python audio_to_text.pyTam kodu burada bulabilirsiniz.
Mikrofondan Ses Dökümü
Hedefimiz bir sesli asistan oluşturmak olduğundan, kullanıcının sesli istemini bir ses dosyasına kaydetmemiz gerekiyor.
record.py adlı yeni bir dosya oluşturup record_audio adlı bir işlev yazacağız. Bu işlev, mikrofondan sesi yakalayarak bir ses dosyası olarak kaydeder. Bu makalenin ana odağı olmadığı için ayrıntılarına fazla girmeyeceğiz:
import sounddevice as sd
import numpy as np
import scipy.io.wavfile as wavfile
SAMPLE_RATE = 44100 # Sample rate in Hz
def record_audio():
print("[INFO: Recording... Press <Enter> to stop]")
audio_data = [] # Initialize a list to store audio frames
def callback(indata, frames, time, status):
audio_data.append(indata.copy())
with sd.InputStream(samplerate=SAMPLE_RATE, channels=1, callback=callback, dtype='int16'):
input() # Wait for the user to press Enter to stop recording
print("[INFO: Recording complete]")
print()
audio_data = np.concatenate(audio_data) # Concatenate the list into a single array
filename = "output.wav"
wavfile.write(filename, SAMPLE_RATE, audio_data)
return audio_dataBu işlevi çağırdığımızda, kullanıcının mikrofonundan kayda başlayacaktır. Kullanıcı "Enter" tuşuna basana kadar bekler ve ardından sesi verilen dosya adına kaydeder.
Bunu test etmek için, yukarıdaki döküm işleviyle birleştirip kullanıcının söylediği bir mesajı yazıya dökebiliriz. Bunu uygulamak için record_and_transcribe.py adlı yeni bir dosyayı şöyle oluşturabiliriz:
import asyncio
from audio_to_text import transcribe_audio
from audio_recorder import record_audio
async def main():
record_audio("prompt.wav")
await transcribe_audio("prompt.wav")
if __name__ == "__main__":
asyncio.run(main()) python record_and_transcribe.py komutunu kullanarak çalıştırmayı deneyebilirsiniz. Betik, siz "Enter" tuşuna basana kadar söylediklerinizi kaydedecek ve ardından söylediklerinizi yazıya dökecektir.
Bir Sesli Asistan Oluşturma
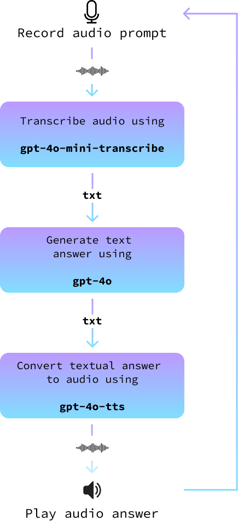
Bu bölümde, her şeyi bir araya getirip bir sesli asistan oluşturuyoruz. Bunu, aşağıdaki adımları izleyerek audio_assistant.py adlı yeni bir dosyada uyguluyoruz:
- Kullanıcının sesli istemini
record_audio()işleviyle kaydedin. - Sesli istemi
transcribe_audio()işleviyle metne dönüştürün. - Yanıtı üretmek için
gpt-4ogibi normal bir metinden-metine model kullanın. - Son olarak, metin yanıtını
text_to_audio()işleviyle sese dönüştürün. - Kullanıcı çıkana kadar bunu tekrarlayın.
Aşağıdaki diyagram bunu göstermektedir:
Devam etmeden önce bunu kendiniz yapmayı denemenizi öneririm.
Önce, daha önce uyguladığımız işlevleri içe aktarıp OpenAI istemcisini başlatıyoruz.
# Import the functions we created
from text_to_audio import text_to_audio
from audio_to_text import transcribe_audio
from audio_recorder import record_audio
# Import other dependencies and initialize OpenAI
import asyncio
from openai import AsyncOpenAI
from dotenv import load_dotenv
load_dotenv()
openai = AsyncOpenAI()Ardından, yanıtı üretecek bir işlev gerekir. Bu, gpt-4o veya başka herhangi bir metinden-metine model gibi normal OpenAI GPT API'sini kullanır. Buna yeniyseniz, GPT-4o API eğitimine göz atmak isteyebilirsiniz.
Bu işlevin eşzamansız bir uygulaması şöyle:
async def get_answer(prompt):
stream = await openai.chat.completions.create(
model="gpt-4o",
messages=[
{"role": "user", "content": prompt}
],
stream=True,
)
answer = ""
async for chunk in stream:
content = chunk.choices[0].delta.content
if content is not None:
answer += content
print(content, end="", flush=True)
print("\n\n")
return answerAna döngüyü uygulamak için yukarıda belirtilen adımları izliyoruz:
async def main(tone_and_style_instructions):
await text_to_audio("Hello, how can I help you today?", tone_and_style_instructions)
while True:
record_audio("prompt.wav")
prompt = await transcribe_audio("prompt.wav")
print()
answer = await get_answer(prompt)
await text_to_audio(answer, tone_and_style_instructions)Son olarak, betik çalıştırıldığında ana döngüyü başlatıyoruz:
if __name__ == "__main__":
tone_and_style_instructions = "Enthusiastic voice."
asyncio.run(main(tone_and_style_instructions))İşte çalışır hâlde bir demosu:
Tam kodu burada bulabilirsiniz.
İleri Düzey İyileştirmeler
Asistanı karmaşık ton ve stil talimatlarıyla kullanmayı denersek, sözcüklerle ton arasında bir kopukluk fark edebiliriz. Örneğin, OpenAI web sitesinden alınan "Emo Teenager" sesine yönelik şu talimatları düşünün:
tone_and_style_instructions = """
Tone: Sarcastic, disinterested, and melancholic, with a hint of passive-aggressiveness.
Emotion: Apathy mixed with reluctant engagement.
Delivery: Monotone with occasional sighs, drawn-out words, and subtle disdain, evoking a classic emo teenager attitude.
"""Sesin tonu bu stile uyacaktır; ancak get_answer() işlevi tarafından üretilen yanıtın metin içeriği bunu dikkate almayabilir ve bu da bir miktar tutarsızlığa yol açabilir. İşte bir örnek:
Bunu aşmak için, get_answer() işlevindeki kullanıcı mesajını, üretilen metnin ton ve stil talimatlarına uyması gerektiğini belirten bir sistem istemiyle eşleştirebiliriz.
Bunun için, tone_and_style_instructions'ı get_answer() işlevinin ikinci argümanı olarak sağlayıp sohbet isteğini bir sistem mesajı ekleyerek değiştiriyoruz:
async def get_answer(prompt, tone_and_style_instructions):
stream = await openai.chat.completions.create(
model="gpt-4o",
messages=[
{
"role": "system",
"content":
f"""
The text you generate is being used in a text-to-voice model.
Make sure your answer matches the guidelines {tone_and_style_instructions}
"""
},
{"role": "user", "content": prompt}
],
stream=True,
)
answer = ""
async for chunk in stream:
content = chunk.choices[0].delta.content
if content is not None:
answer += content
print(content, end="", flush=True)
print("\n\n")
return answerModelin artık nasıl yanıt verdiği şöyle:
Gördüğünüz gibi, artık ürettiği metin ton talimatlarıyla örtüşüyor. Tam kodu burada bulabilirsiniz.
Agents API ile Bir Asistan Oluşturma
Önceki örnekte, bir sesli asistan oluşturmak için sesten-metine ve metinden-sese modellerini elle çağırdık. Böylece OpenAI’nin ses API’sindeki yeni modelleri açıkça nasıl kullanacağımızı öğrendik.
Ancak amaç bir sesli asistan oluşturmaksa, ajan API'sini kullanmanın daha kolay bir yolu var. Bu API, burada uyguladığımız sesten-metine ve metinden-sese iş akışını otomatik olarak yönetebilecek şekilde güncellendi.
Ajan API'sini ilk kez kullanıyorsanız, OpenAI Agents SDK üzerine bu eğitime göz atmak isteyebilirsiniz.
Başlamadan önce bir bağımlılığı daha kurmamız gerekiyor:
pip install 'openai-agents[voice]'Bunu hallettikten sonra, bir ses hattıyla (pipeline) çalışan bir ajanı yürütmek için gereken her şeyi içe aktararak başlıyoruz:
from dotenv import load_dotenv
load_dotenv()
import asyncio
from agents import Agent
from agents.voice import (
AudioInput,
SingleAgentVoiceWorkflow,
VoicePipeline,
VoicePipelineConfig,
TTSModelSettings,
)
from audio_recorder import record_audio
from audio_player import AudioPlayerAudioPlayer herhangi bir pakete ait değildir. Yerel bir dosyadan içe aktarılır ve sesi gerçek zamanlı çalmaya yardımcı olan basit bir sınıf içerir. Bu gereklidir; çünkü VoicePipeline ile sesi parça parça alacağız ve her parçayı aldıkça çalacağız. İşte audio_player.py dosyasının içeriği:
import numpy as np
import sounddevice as sd
class AudioPlayer:
def __enter__(self):
self.stream = sd.OutputStream(samplerate=24000, channels=1, dtype=np.int16)
self.stream.start()
return self
def __exit__(self, tp, val, tb):
self.stream.close()
def add_audio(self, audio_data):
self.stream.write(audio_data)Sıradaki adım bir ajan oluşturmak:
agent = Agent(
name="Voice Assistant",
instructions="You’re a helpful assistant speaking to a human.",
model="gpt-4o-mini",
)Kullandığımız parametrelerin açıklaması şöyle:
name: Dilediğimiz herhangi bir isim olabilir.instructions: Ajanın ne yapması gerektiğini tanımlar; sistem istemi (system prompt) gibi çalışır.model: Yanıt üretmek için kullanılan model.
Ajan, daha önce uyguladığımız get_answer() işlevi gibi çalışır. Bunu, metin istemine yanıt sağlayan hattın bir parçası olarak düşünebilirsiniz.
Sonraki adım hattı (pipeline) tanımlamaktır. Burada sesle ilgili tüm yapılandırmaları belirtiriz:
pipeline = VoicePipeline(
workflow=SingleAgentVoiceWorkflow(agent),
stt_model="gpt-4o-mini-transcribe",
tts_model="gpt-4o-mini-tts",
config=VoicePipelineConfig(
tts_settings=TTSModelSettings(
voice="coral",
instructions="""
Speak in an enthusiastic voice.
"""
)
)
)Bazı parametrelerin dökümü şu şekilde:
stt_model: Konuşmayı metne dönüştürmek için kullanılacak model.tts_model: Metni konuşmaya dönüştürmek için kullanılan model.config: Hat yapılandırmasını sağlar. Buradatts_model'in kullanacağı sesi ve konuşma talimatlarını belirtmek için kullanıyoruz.
Son olarak, daha önce yaptığımıza benzer şekilde ana döngüyü çalıştırıyoruz:
async def main():
while True:
audio_input = AudioInput(buffer=record_audio())
result = await pipeline.run(audio_input)
with AudioPlayer() as player:
async for event in result.stream():
if event.type == "voice_stream_event_audio":
player.add_audio(event.data)
if __name__ == "__main__":
asyncio.run(main())Tam bir uygulamayı burada bulabilirsiniz.
Araçlar ekleme
Bu döngünün sonsuza kadar çalışacağını, çünkü bir durdurma koşulu belirtmediğimizi unutmayın. Çalıştırırken işlemi durdurmak için süreci elle sonlandırmanız gerekir. Bunu durdurmanın yollarından biri, ajana bir araç sağlamaktır.
Araçlar, ajanın bizim için çalıştırabilmesi için sağladığımız işlevlerdir. Bu durumda, betiği durduran bir işlev sağlayabiliriz. Ajan, işlev adını ve açıklamasını kullanarak onu çağırıp çağırmayacağına karar verir.
from agents import function_tool
@function_tool
def stop_conversation():
"""Stop the conversation."""
exit()Sonra aracı ajana sağlarız:
agent = Agent(
…
tools=[stop_conversation], # Add this line when creating the agent
)Bu uygulamayla, “Konuşmayı sonlandırmak istiyorum” dersek, ajan stop_conversation() işlevini çağırması gerektiğini anlayacaktır. Bu uygulamanın, stop_conversation() işlevinin yazılış biçimi nedeniyle düzgün bir şekilde çıkış yapmayacağını unutmayın.
Tam bir betik isterseniz bu dosyaya bakın.
Birden fazla ajan kullanma
Ajan API'nin güzel bir özelliği, birden fazla ajanın birlikte çalışacak şekilde yapılandırılabilmesidir. İşte OpenAI dokümantasyonundan alınmış bir örnek:
from agents.extensions.handoff_prompt import prompt_with_handoff_instructions
spanish_agent = Agent(
name="Spanish voice assistant",
handoff_description="A spanish speaking agent.",
instructions=prompt_with_handoff_instructions(
"You're speaking to a human, so be polite and concise. Speak in Spanish.",
),
model="gpt-4o-mini",
)
agent = Agent(
name="Voice Assistant",
instructions=prompt_with_handoff_instructions("""
You're speaking to a human, so be polite and concise.
If the user speaks in Spanish, handoff to the spanish agent.
"""),
model="gpt-4o-mini",
)Bu örnekte, İspanyolca konuşmak üzere tasarlanmış ikinci bir ajan tanımlıyor ve bir devretme (handoff) istemi sağlayarak ilk ajanda değişiklik yapıyoruz. Devretme talimatları sağlandığında, ikinci ajan devreye girerek konuşmayı sürdürecektir.
Tam betiğe buradan ulaşabilirsiniz.
Sonuç
OpenAI'nin en yeni ses modellerinin gelişmiş yeteneklerini kullanarak, konuşulan dili etkin biçimde metne dökebilen ve metinsel yanıtlardan insan benzeri konuşma üretebilen bir sistem oluşturduk. Bu proje, yalnızca mevcut teknolojinin potansiyelini göstermekle kalmıyor; aynı zamanda özel yapay zekâ çözümleri oluşturmakla ilgilenen geliştiriciler için bu araçların ne kadar erişilebilir hâle geldiğini de ortaya koyuyor.




OpenAI, konuşmadan metne ve metinden konuşmaya yeteneklerini geliştirmeye odaklanan yeni nesil ses modellerini tanıttı. Bu en yeni modeller, özellikle aksanlar veya gürültülü ortamlar gibi karmaşık durumlarda daha yüksek doğruluk sunuyor ve daha özelleştirilebilir sesli etkileşimler sağlıyor.
Bu eğitimde, yeni OpenAI ses modellerini kullanarak bir sesli-asistanı adım adım nasıl oluşturacağınızı açıklayacağım. Amacımız, konuşulan girdiyi anlayıp belirli ihtiyaçlara göre uyarlanmış, doğal bir sentezlenmiş sesle yanıt verebilen bir yapay zekâ asistanı geliştirmek.