
Khóa học
Retrieval Augmented Generation (RAG) với LangChain
3 giờ
21.3K
Bản phát hành mới này của OpenAI bao gồm ba mô hình:
gpt-4o-mini-tts: Mô hình văn bản–thành–âm thanh có khả năng tạo âm thanh từ văn bản với nhiều sắc thái và giọng đọc. Một tính năng hay của mô hình chuyển văn bản thành giọng nói này là chúng ta có thể định hướng âm sắc giọng đọc bằng cách đưa ra hướng dẫn văn bản cụ thể. Điều này mang lại mức độ tùy chỉnh cao, cho phép tạo nên trải nghiệm giọng nói độc đáo và phù hợp. Bạn có thể dùng thử trên OpenAI.fm.gpt-4o-transcribe và gpt-4o-mini-transcribe: Hai mô hình âm thanh–thành–văn bản được thiết kế để chuyển đổi ngôn ngữ nói thành văn bản viết. Chức năng chính của chúng là cung cấp bản chép lời có độ chính xác và độ tin cậy cao. Những mô hình này thể hiện tỷ lệ lỗi từ (WER) thấp hơn, tức là mắc ít lỗi nhận diện từ nói hơn so với các giải pháp trước đây.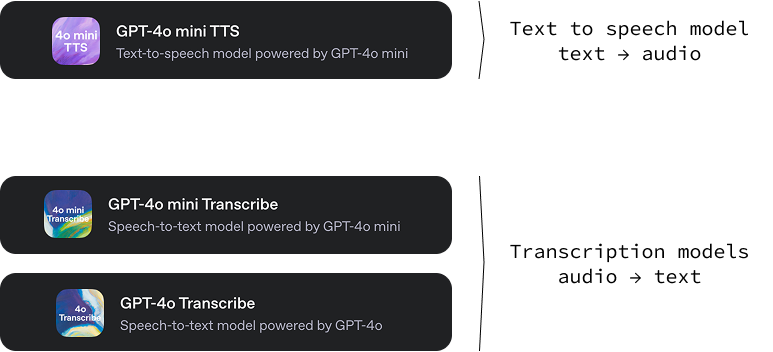
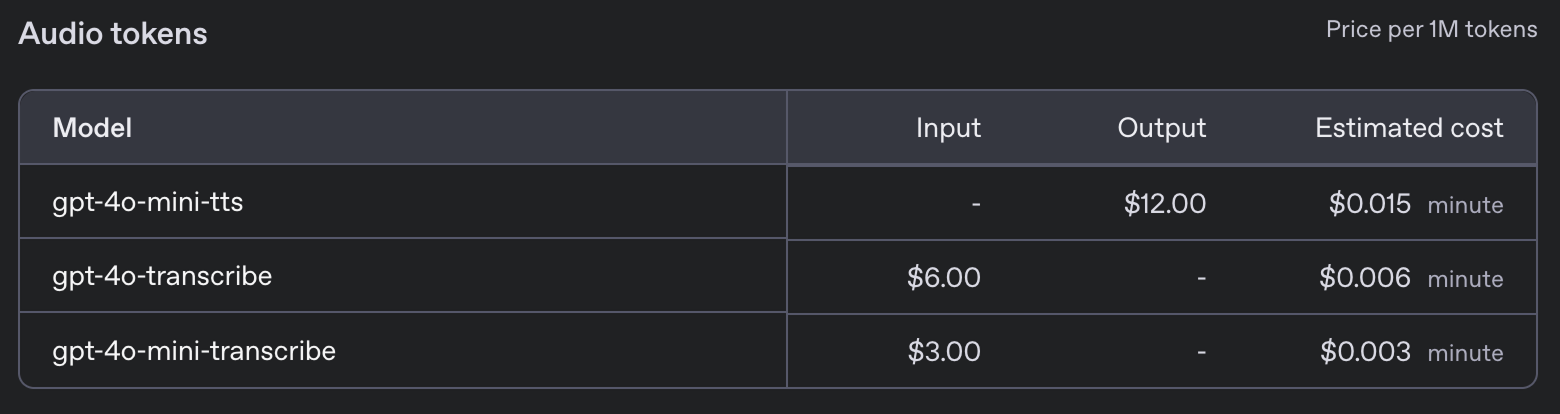
Những mô hình mới này có mức giá như sau:
Trong hướng dẫn này, tôi sẽ dẫn bạn xây dựng một trợ lý giọng nói ngay trong terminal. Trợ lý này về cơ bản sẽ mô phỏng một mô hình AI dạng văn bản phổ biến nhưng tương tác hoàn toàn qua ngôn ngữ nói. Hãy hình dung bạn có thể nói trực tiếp với máy tính, đặt bất kỳ câu hỏi nào và nhận câu trả lời bằng giọng nói gần như ngay lập tức.
Dự án của chúng ta sử dụng một kiến trúc đơn giản mà hiệu quả. Trước tiên, chúng ta sẽ dùng micro của bạn để ghi lại lời nhắc bằng giọng nói. Sau khi ghi, chúng ta sẽ chuyển đổi đầu vào âm thanh này thành văn bản với sự hỗ trợ của các mô hình chuyển giọng nói thành văn bản tiên tiến.
Văn bản này sau đó được đưa vào một mô hình ngôn ngữ lớn để tạo phản hồi phù hợp. Cuối cùng, chúng ta chuyển phản hồi văn bản trở lại thành âm thanh, cho phép trợ lý “nói” câu trả lời cho bạn. Mỗi bước của quy trình được thiết kế để đảm bảo trợ lý giọng nói vừa chính xác vừa cuốn hút.
Mặc dù OpenAI cung cấp một Realtime API chuyên dụng có thể nâng cao tương tác bằng cách tinh gọn toàn bộ quy trình, chúng ta sẽ chọn một hướng khác. Realtime API, dù ấn tượng và lý tưởng cho các nhà phát triển muốn tích hợp nhanh, thường tốn kém hơn và linh hoạt kém hơn.
Bằng cách xây dựng dự án với các thành phần tách biệt cho từng bước, chúng ta có nhiều quyền kiểm soát hơn đối với việc tùy biến trợ lý AI. Cách tiếp cận này cho phép tự chọn mô hình sử dụng, từ đó tối ưu theo nhu cầu cụ thể, dù là độ chính xác, tốc độ hay sở thích về tông giọng phản hồi. Nhờ vậy, trợ lý giọng nói không chỉ mạnh mẽ mà còn được “may đo” cao, phù hợp với yêu cầu dự án riêng biệt.
Toàn bộ mã nguồn chúng ta phát triển ở đây có sẵn trong kho GitHub này.
Để bắt đầu, trước tiên ta tạo một môi trường Anaconda mới tên audio-demo. Các môi trường của Anaconda cho phép tạo không gian cô lập cho từng dự án, nơi ta có thể cài các phiên bản gói cụ thể mà không xung đột. Thực thi các lệnh sau trong giao diện dòng lệnh:
conda create -n audio-demo -y python=3.9
conda activate audio-demo
pip install openai
pip install numpy
pip install dotenv
pip install sounddevice
pip install scipy
Hãy phân tích nhanh từng lệnh và gói:
conda create -n audio-demo -y python=3.9: Tạo môi trường mới tên audio-demo với Python 3.9. Cờ -y tự động đồng ý cài đặt gói mà không hỏi lại.conda activate audio-demo: Kích hoạt môi trường audio-demo vừa tạo để làm việc trong đó.pip install openai: OpenAI là thư viện cung cấp truy cập dễ dàng tới các mô hình và API của OpenAI.pip install numpy: NumPy là thư viện thiết yếu cho tính toán số.pip install dotenv: Dotenv giúp nạp biến môi trường từ tệp .env, giúp quản lý cấu hình dễ và an toàn hơn.pip install sounddevice: Sounddevice cho phép ghi và phát âm thanh bằng các hàm đơn giản, lý tưởng để xử lý I/O âm thanh trong Python.pip install scipy: SciPy xây dựng trên NumPy và cung cấp chức năng bổ sung cho tính toán khoa học/kỹ thuật như xử lý tín hiệu. Trong bài này, ta dùng nó để lưu tệp âm thanh.Với môi trường audio-demo đã sẵn sàng, chúng ta có thể bắt tay vào xây dựng trợ lý AI xử lý đầu vào âm thanh. Thiết lập có cấu trúc này giúp giữ không gian phát triển sạch sẽ, đảm bảo mọi phụ thuộc đều sẵn cho dự án.
Để dùng OpenAI API, chúng ta cần một khóa API. Truy cập trang khóa API của họ và tạo khóa bằng cách nhấn nút "Generate new secret key". Sao chép khóa, tạo tệp .env, và dán vào theo định dạng sau:
OPENAI_API_KEY=<paste_your_api_key_here>Hãy cùng đi qua các bước để tạo một script Python sử dụng khả năng văn bản–thành–âm thanh của OpenAI, biến văn bản thành giọng nói với dấu ấn cá nhân. Chúng ta viết mã trong tệp text_to_audio.py cùng thư mục với tệp .env.
Đầu tiên, cần import các thư viện cần thiết cho script:
import asyncio
from openai import AsyncOpenAI
from openai.helpers import LocalAudioPlayer
from dotenv import load_dotenv
Lướt nhanh qua tác dụng của từng import:
asyncio: Thư viện để viết mã bất đồng bộ trong Python, thiết yếu khi làm việc với API streaming.AsyncOpenAI: Thành phần của thư viện OpenAI, cung cấp công cụ tương tác với API OpenAI theo cách bất đồng bộ.LocalAudioPlayer: Trợ lý từ OpenAI cho phép phát âm thanh cục bộ trên máy.load_dotenv: Nạp biến môi trường từ tệp .env, nơi lưu thông tin nhạy cảm như khóa API.Tiếp theo, nạp khóa API từ tệp .env bằng hàm load_dotenv:
load_dotenv()Điều này đảm bảo script truy cập khóa API một cách an toàn.
Tạo một thể hiện AsyncOpenAI để bắt đầu tương tác với OpenAI API:
openai = AsyncOpenAI()Giờ chúng ta định nghĩa hàm chính text_to_audio(), sử dụng tính năng văn bản–thành–âm thanh của OpenAI để xử lý đầu vào và phát âm thanh kết quả:
async def text_to_audio(text, tone_and_style_instructions):
  async with openai.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=text,
    instructions=tone_and_style_instructions,
    response_format="pcm",
  ) as response:
    await LocalAudioPlayer().play(response)
Giải thích nhanh những gì vừa làm:
model và voice để điều khiển tổng hợp giọng nói. model dùng là gpt-4o-mini-tts và giọng chọn là "coral".response_format đặt là "pcm", phù hợp cho xử lý âm thanh.LocalAudioPlayer sẽ phát phản hồi âm thanh do API tạo ra.Hoàn tất script bằng các dòng sau để đảm bảo hàm text_to_audio() chạy khi thực thi script:
if __name__ == "__main__":
  asyncio.run(text_to_audio("Hello world!", "Enthusiastic voice."))
Khối mã này kiểm tra nếu script là module chính đang chạy thì sẽ thực thi text_to_audio() bằng asyncio.run() để xử lý logic bất đồng bộ.
Với các bước trên, script đã sẵn sàng để chuyển văn bản thành giọng nói bằng dịch vụ văn bản–thành–âm thanh của OpenAI. Thiết lập này cho phép thử nghiệm nhiều đầu vào và phong cách khác nhau, “thổi hồn” cho văn bản qua âm thanh.
Chúng ta có thể chạy script bằng lệnh:
python text_to_audio.pyMã hoàn chỉnh có tại đây.
Trong phần này, hãy khám phá cách chép một tệp âm thanh thành văn bản bằng công cụ chép lời của OpenAI. Script của chúng ta được thiết kế xử lý tệp âm thanh theo cách bất đồng bộ để quá trình hiệu quả và nhanh chóng. Chúng ta sẽ triển khai trong tệp audio_to_text.py.
Phần import và thiết lập ban đầu giống như trước, ngoại trừ việc không cần import LocalAudioPlayer ở đây. Sau đây là cách viết một hàm chép lời tệp âm thanh:
async def transcribe_audio(audio_filename = "audio.wav"):
  audio_file = await asyncio.to_thread(open, audio_filename, "rb")
  stream = await openai.audio.transcriptions.create(
    model="gpt-4o-mini-transcribe",
    file=audio_file,
    response_format="text",
    stream=True,
  )
  transcript = ""
  async for event in stream:
    if event.type == "transcript.text.delta":
      print(event.delta, end="", flush=True)
      transcript += event.delta
  print()
  audio_file.close()
  return transcript
Diễn giải những gì diễn ra ở đây:
audio_file = await asyncio.to_thread(open, audio_filename, "rb"): Dòng này mở tệp âm thanh ở chế độ đọc nhị phân ("rb"). Phương thức asyncio.to_thread() cho phép thao tác mở tệp chạy ở luồng riêng, tránh chặn các phần khác của chương trình.stream = await openai.audio.transcriptions. create(...): Gọi API chép lời. model là gpt-4o-mini-transcribe, được thiết kế riêng cho tác vụ chép lời.file chứa tệp âm thanh đã mở.response_format="text" yêu cầu API trả về bản chép lời ở dạng văn bản.stream=True để stream kết quả chép lời theo thời gian thực, nghĩa là phần nào được xử lý xong sẽ trả về ngay, tăng tốc độ phản hồi.async for event in stream: Bắt đầu vòng lặp đọc sự kiện từ luồng chép lời khi chúng xuất hiện.if event.type == "transcript.text.delta":: Kiểm tra loại sự kiện và xử lý nếu là transcript.text.delta, cho biết một phần chép lời đã sẵn sàng.print(event.delta, end="", flush=True): In phần chép lời gia tăng ngay khi có, đảm bảo đầu ra theo thời gian thực.audio_file.close(): Sau khi hoàn tất chép lời, nên đóng tệp để giải phóng tài nguyên hệ thống.Bằng cách thực thi hàm main(), chúng ta có thể chuyển tệp âm thanh thành văn bản hiệu quả và xử lý theo dạng stream để nhận phản hồi tức thời. Thiết lập này lý tưởng cho ứng dụng cần chép lời nhanh hoặc xử lý tệp âm thanh dài.
Bạn có thể thử bằng cách đặt một tệp âm thanh cùng thư mục với script, thay audio.wav bằng tên tệp của bạn, và chạy lệnh:
python audio_to_text.pyMã hoàn chỉnh có tại đây.
Vì mục tiêu là tạo một trợ lý giọng nói, chúng ta cần ghi lời nhắc của người dùng vào một tệp âm thanh.
Chúng ta sẽ tạo tệp mới tên record.py với hàm record_audio. Hàm này thu âm từ micro và lưu thành tệp âm thanh. Chúng ta sẽ không đi sâu cơ chế hoạt động vì đây không phải trọng tâm bài viết:
import sounddevice as sd
import numpy as np
import scipy.io.wavfile as wavfile

SAMPLE_RATE = 44100  # Sample rate in Hz

def record_audio():
    print("[INFO: Recording... Press <Enter> to stop]")
    audio_data = []  # Initialize a list to store audio frames
    def callback(indata, frames, time, status):
        audio_data.append(indata.copy())
    with sd.InputStream(samplerate=SAMPLE_RATE, channels=1, callback=callback, dtype='int16'):
        input()  # Wait for the user to press Enter to stop recording
    print("[INFO: Recording complete]")
    print()
    audio_data = np.concatenate(audio_data)  # Concatenate the list into a single array
    filename = "output.wav"
    wavfile.write(filename, SAMPLE_RATE, audio_data)
    return audio_data
Khi gọi hàm này, quá trình ghi từ micro của người dùng sẽ bắt đầu. Chương trình chờ đến khi người dùng nhấn "Enter" rồi lưu âm thanh vào tệp với tên đã cho.
Để thử nghiệm, ta có thể kết hợp hàm này với hàm chép lời bên trên để chép một thông điệp do người dùng nói. Sau đây là cách tạo tệp mới record_and_transcribe.py để triển khai:
import asyncio
from audio_to_text import transcribe_audio
from audio_recorder import record_audio

async def main():
  record_audio("prompt.wav")
  await transcribe_audio("prompt.wav")

if __name__ == "__main__":
  asyncio.run(main())
Bạn có thể chạy bằng lệnh python record_and_transcribe.py. Script sẽ ghi lại những gì bạn nói cho đến khi bạn nhấn "Enter", rồi chép lại nội dung bạn đã nói.
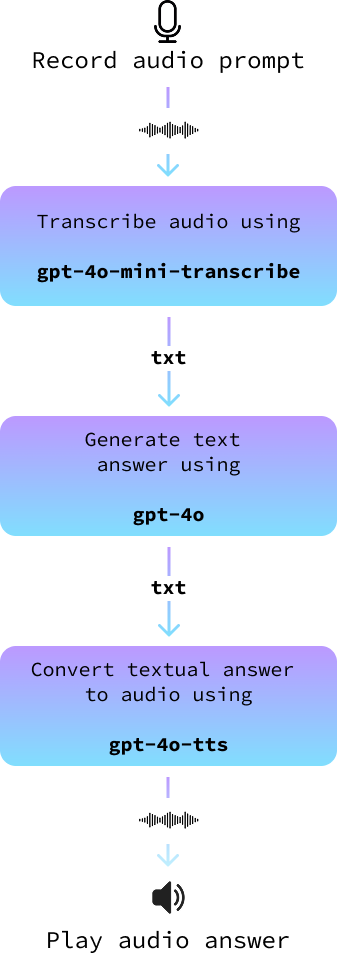
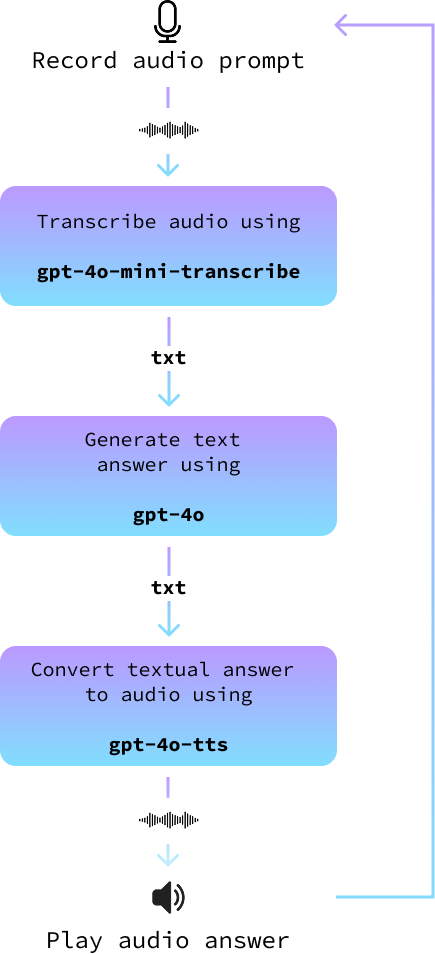
Trong phần này, chúng ta ghép lại tất cả để xây dựng một trợ lý âm thanh. Ta triển khai trong tệp mới audio_assistant.py theo các bước sau:
record_audio().transcribe_audio().gpt-4o để tạo câu trả lời.text_to_audio().Sơ đồ sau minh họa quy trình này:
Khuyến khích bạn thử tự xây dựng trước khi đọc tiếp.
Đầu tiên, import các hàm đã triển khai trước đó và khởi tạo client OpenAI.
# Import the functions we created
from text_to_audio import text_to_audio
from audio_to_text import transcribe_audio
from audio_recorder import record_audio

# Import other dependencies and initialize OpenAI
import asyncio
from openai import AsyncOpenAI
from dotenv import load_dotenv
load_dotenv()
openai = AsyncOpenAI()
Tiếp theo, cần một hàm tạo câu trả lời. Hàm này dùng OpenAI GPT API bình thường với mô hình như gpt-4o hoặc bất kỳ mô hình văn bản–thành–văn bản nào khác. Nếu bạn mới bắt đầu, có thể xem hướng dẫn GPT-4o API này.
Đây là một triển khai bất đồng bộ của hàm:
async def get_answer(prompt):
  stream = await openai.chat.completions.create(
    model="gpt-4o",
    messages=[
      {"role": "user", "content": prompt}
    ],
    stream=True,
  )
  answer = ""
  async for chunk in stream:
    content = chunk.choices[0].delta.content
    if content is not None:
      answer += content
      print(content, end="", flush=True)
  print("\n\n")
  return answer
Để triển khai vòng lặp chính, chúng ta làm theo các bước đã nêu:
async def main(tone_and_style_instructions):
  await text_to_audio("Hello, how can I help you today?", tone_and_style_instructions)
  while True:
    record_audio("prompt.wav")
    prompt = await transcribe_audio("prompt.wav")
    print()
    answer = await get_answer(prompt)
    await text_to_audio(answer, tone_and_style_instructions)
Cuối cùng, chạy vòng lặp chính khi script được thực thi:
if __name__ == "__main__":
  tone_and_style_instructions = "Enthusiastic voice."
  asyncio.run(main(tone_and_style_instructions))
Đây là đoạn demo minh họa hoạt động:
Học AI với các khóa học này!
Khóa học
Khóa học
Lộ trình
blog
Matt Crabtree
10 phút
