
Kursus
Retrieval Augmented Generation (RAG) dengan LangChain
3 jam
20.9K
Rilis baru dari OpenAI ini mencakup tiga model:
gpt-4o-mini-tts: Model text-to-audio yang mampu menghasilkan audio dari teks dengan berbagai nada dan suara. Fitur menarik dari model text-to-speech ini adalah kita dapat mengarahkan seperti apa suara yang dihasilkan dengan memberikan instruksi teks spesifik. Ini menghadirkan tingkat kustomisasi tinggi, memungkinkan pembuatan pengalaman suara yang unik dan tertailor. Anda dapat mencobanya di OpenAI.fm.gpt-4o-transcribe dan gpt-4o-mini-transcribe: Dua model audio-to-text yang dirancang untuk mengonversi bahasa lisan menjadi teks tertulis. Fungsi utamanya adalah memberikan transkripsi audio yang sangat akurat dan andal. Model-model ini menunjukkan tingkat kesalahan kata (WER) yang lebih rendah, artinya mereka membuat lebih sedikit kesalahan dalam mengenali kata yang diucapkan dibandingkan solusi sebelumnya.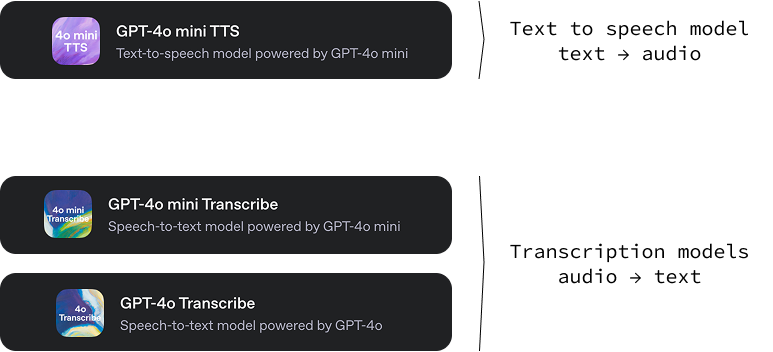
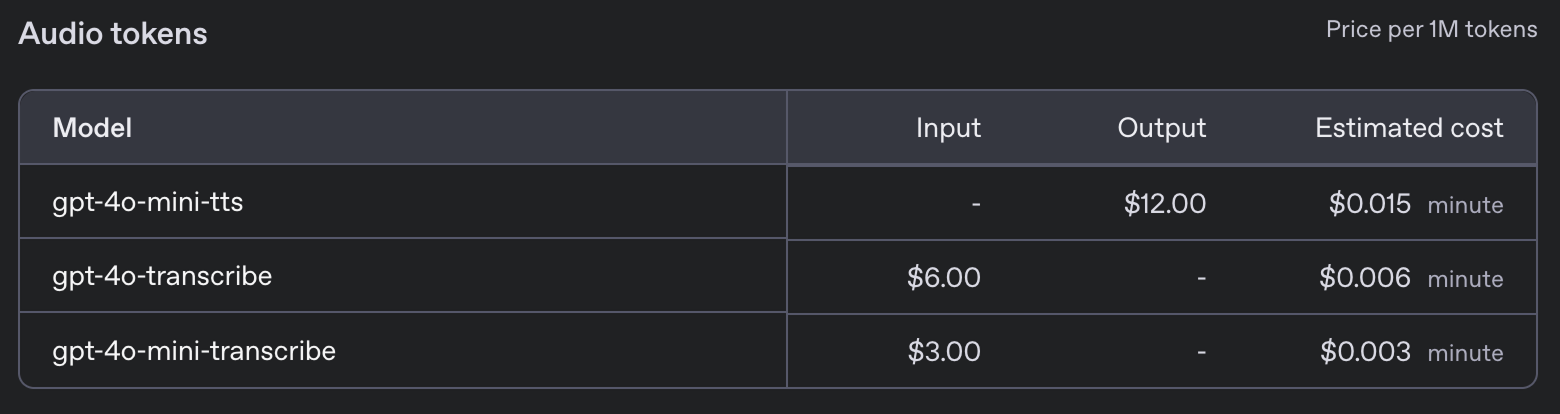
Model-model baru ini hadir dengan harga berikut:
Dalam tutorial ini, saya akan memandu Anda membangun asisten suara AI langsung di terminal Anda. Asisten suara ini pada dasarnya meniru model AI berbasis teks populer namun akan berinteraksi sepenuhnya melalui bahasa lisan. Bayangkan Anda dapat berbicara langsung ke komputer, mengajukan pertanyaan apa pun, dan menerima jawaban suara hampir seketika.
Proyek kita akan menggunakan arsitektur yang sederhana namun efektif. Kita akan mulai dengan menggunakan mikrofon Anda untuk menangkap prompt lisan. Setelah direkam, kita akan mengonversi masukan audio ini menjadi teks dengan bantuan model speech-to-text canggih.
Teks ini kemudian dimasukkan ke model bahasa besar untuk menghasilkan respons yang sesuai. Terakhir, kita akan mengonversi respons teks kembali menjadi audio, memungkinkan asisten untuk “berbicara” memberikan jawaban kepada Anda. Setiap langkah proses ini dirancang agar asisten suara kita akurat sekaligus menarik.
Walaupun OpenAI menawarkan Realtime API khusus yang dapat meningkatkan interaksi dengan menyederhanakan seluruh proses, kita akan memilih pendekatan berbeda. Realtime API, meski mengesankan dan cocok untuk pengembang yang mencari integrasi cepat, sering kali lebih mahal dan kurang fleksibel.
Dengan memilih membangun proyek menggunakan komponen terpisah untuk setiap langkah, kita mendapatkan kendali yang lebih besar atas kustomisasi asisten AI. Pendekatan ini memungkinkan kita menentukan model yang ingin digunakan, sehingga dapat dioptimalkan untuk kebutuhan spesifik—baik akurasi, kecepatan, maupun preferensi nada respons. Dengan begitu, asisten suara kita bukan hanya alat yang kuat, tetapi juga sangat tertailor, mampu menyesuaikan kebutuhan proyek unik.
Seluruh kode yang kita kembangkan di sini tersedia di repositori GitHub ini.
Untuk memulai, pertama-tama kita akan menyiapkan lingkungan Anaconda baru bernama audio-demo. Lingkungan Anaconda memungkinkan kita membuat ruang terisolasi untuk setiap proyek sehingga kita bisa memasang versi paket spesifik tanpa konflik. Jalankan perintah berikut di antarmuka baris perintah Anda:
conda create -n audio-demo -y python=3.9
conda activate audio-demo
pip install openai
pip install numpy
pip install dotenv
pip install sounddevice
pip install scipy
Mari kita uraikan fungsi setiap perintah dan paket:
conda create -n audio-demo -y python=3.9: Perintah ini membuat lingkungan baru bernama audio-demo dengan Python versi 3.9. Flag -y otomatis menyetujui instalasi paket tanpa konfirmasi.conda activate audio-demo: Mengaktifkan lingkungan audio-demo yang baru dibuat, sehingga kita dapat bekerja di dalamnya.pip install openai: OpenAI adalah pustaka yang menyediakan akses mudah ke model dan API OpenAI.pip install numpy: NumPy adalah pustaka penting untuk komputasi numerik.pip install dotenv: Dotenv membantu memuat variabel lingkungan dari berkas .env, sehingga manajemen konfigurasi lebih mudah dan aman.pip install sounddevice: Sounddevice memungkinkan kita merekam dan memutar suara dengan fungsi sederhana, ideal untuk menangani input dan output audio di Python.pip install scipy: SciPy dibangun di atas NumPy dan menyediakan fungsionalitas tambahan untuk komputasi ilmiah dan teknis, seperti pemrosesan sinyal. Dalam kasus kita, ini digunakan untuk menyimpan berkas audio.Dengan lingkungan audio-demo siap, kita bisa mulai mengerjakan asisten AI yang dapat memproses input audio. Penyiapan terstruktur ini membantu menjaga ruang pengembangan tetap bersih, memastikan semua dependensi tersedia untuk proyek kita.
Untuk menggunakan OpenAI API, kita memerlukan kunci API. Kunjungi halaman kunci API mereka dan buat kunci API dengan mengeklik tombol "Generate new secret key". Salin kuncinya, buat berkas bernama .env, dan tempelkan di sana dengan format berikut:
OPENAI_API_KEY=<paste_your_api_key_here>Mari kita telusuri langkah-langkah membuat skrip Python yang menggunakan kemampuan text-to-audio OpenAI, mengubah teks menjadi ucapan dengan sentuhan personal. Kita menulis kode dalam berkas bernama text_to_audio.py di folder yang sama dengan berkas .env.
Pertama, kita perlu mengimpor pustaka yang diperlukan untuk menyusun skrip:
import asyncio
from openai import AsyncOpenAI
from openai.helpers import LocalAudioPlayer
from dotenv import load_dotenv
Mari kita ulas singkat fungsi masing-masing impor ini:
asyncio: Pustaka ini diperlukan untuk menulis kode asinkron di Python, yang penting saat bekerja dengan API streaming.AsyncOpenAI: Bagian dari pustaka OpenAI yang menyediakan alat untuk berinteraksi dengan API OpenAI secara asinkron.LocalAudioPlayer: Pembantu dari OpenAI yang memungkinkan kita memutar audio secara lokal di mesin kita.load_dotenv: Memuat variabel lingkungan dari berkas .env, tempat kita menyimpan informasi sensitif seperti kunci API.Selanjutnya, kita memuat kunci API dari berkas .env menggunakan fungsi load_dotenv:
load_dotenv()Ini memastikan skrip memiliki akses yang aman ke kunci API.
Kita membuat instance AsyncOpenAI untuk mulai berinteraksi dengan OpenAI API:
openai = AsyncOpenAI()Sekarang kita mendefinisikan fungsi utama, text_to_audio(), yang akan menggunakan fitur text-to-audio OpenAI untuk memproses input dan memutar audio yang dihasilkan:
async def text_to_audio(text, tone_and_style_instructions):
  async with openai.audio.speech.with_streaming_response.create(
    model="gpt-4o-mini-tts",
    voice="coral",
    input=text,
    instructions=tone_and_style_instructions,
    response_format="pcm",
  ) as response:
    await LocalAudioPlayer().play(response)
Mari kita jelaskan secara singkat apa yang kita lakukan di atas:
model dan voice untuk mengendalikan sintesis ucapan. model yang digunakan adalah gpt-4o-mini-tts dan suara yang dipilih adalah "coral".response_format disetel ke "pcm", cocok untuk pemrosesan audio.LocalAudioPlayer kemudian memutar respons audio yang dihasilkan oleh API.Kita melengkapi skrip dengan baris berikut untuk memastikan fungsi text_to_audio() berjalan saat skrip dieksekusi:
if __name__ == "__main__":
  asyncio.run(text_to_audio("Hello world!", "Enthusiastic voice."))
Blok kode ini memeriksa apakah skrip adalah modul utama yang dijalankan dan mengeksekusi fungsi text_to_audio() menggunakan asyncio.run() untuk menangani logika asinkron.
Dengan langkah-langkah ini, skrip kita siap mengonversi input teks menjadi ucapan menggunakan layanan text-to-audio OpenAI. Penyiapan ini memungkinkan kita bereksperimen dengan berbagai input dan gaya, menghidupkan teks melalui suara.
Kita dapat menjalankan skrip dengan perintah:
python text_to_audio.pyKode lengkapnya dapat ditemukan di sini.
Di bagian ini, mari kita jelajahi cara mentranskripsi berkas audio menjadi teks menggunakan alat transkripsi audio OpenAI. Skrip kita dirancang untuk menangani berkas audio secara asinkron agar prosesnya efisien dan cepat. Kita akan mengimplementasikan skrip ini dalam berkas bernama audio_to_text.py.
Impor dan penyiapan awal sama seperti sebelumnya, kecuali kita tidak perlu mengimpor LocalAudioPlayer di sini. Berikut cara menulis fungsi yang mentranskripsi berkas audio:
async def transcribe_audio(audio_filename = "audio.wav"):
  audio_file = await asyncio.to_thread(open, audio_filename, "rb")
  stream = await openai.audio.transcriptions.create(
    model="gpt-4o-mini-transcribe",
    file=audio_file,
    response_format="text",
    stream=True,
  )
  transcript = ""
  async for event in stream:
    if event.type == "transcript.text.delta":
      print(event.delta, end="", flush=True)
      transcript += event.delta
  print()
  audio_file.close()
  return transcript
Mari kita uraikan apa yang terjadi di sini:
audio_file = await asyncio.to_thread(open, audio_filename, "rb"): Baris ini membuka berkas audio dalam mode baca biner ("rb"). Metode asyncio.to_thread() memungkinkan operasi pembukaan berkas berjalan di thread terpisah, mencegahnya memblokir bagian program lain.stream = await openai.audio.transcriptions. create(...): Baris ini memanggil API transkripsi. model sebagai gpt-4o-mini-transcribe, yang dirancang khusus untuk tugas transkripsi.file memuat berkas audio yang kita buka.response_format="text" memberi tahu API agar mengembalikan transkripsi sebagai teks.stream=True digunakan untuk melakukan streaming transkripsi secara real time, artinya begitu sebagian audio diproses, hasilnya segera dikembalikan, mempercepat respons.async for event in stream: Memulai loop untuk membaca event dari stream transkripsi saat terjadi.if event.type == "transcript.text.delta":: Memeriksa setiap jenis event dan memprosesnya jika berjenis transcript.text.delta, yang menandakan sebagian transkripsi sudah siap.print(event.delta, end="", flush=True): Mencetak transkripsi bertahap saat tersedia, memastikan keluaran real time.audio_file.close(): Setelah transkripsi selesai, praktik yang baik adalah menutup berkas audio untuk membebaskan sumber daya sistem.Dengan mengeksekusi fungsi main(), kita dapat mengonversi berkas audio menjadi teks secara efisien dan memprosesnya dalam bentuk stream untuk mendapatkan umpan balik segera. Penyiapan ini ideal untuk aplikasi yang memerlukan transkripsi cepat atau melibatkan berkas audio panjang.
Anda dapat mencobanya dengan menempatkan berkas audio di folder yang sama dengan skrip, mengganti audio.wav dengan nama berkas audio Anda, lalu menjalankan perintah:
python audio_to_text.pyKode lengkapnya dapat ditemukan di sini.
Karena tujuan kita adalah membuat asisten suara, kita perlu merekam prompt audio pengguna ke dalam berkas audio.
Kita akan membuat berkas baru bernama record.py dengan fungsi bernama record_audio. Fungsi ini menangkap suara dari mikrofon dan menyimpannya sebagai berkas audio. Kita tidak akan membahas rinci cara kerjanya karena bukan fokus utama artikel ini:
import sounddevice as sd
import numpy as np
import scipy.io.wavfile as wavfile

SAMPLE_RATE = 44100  # Sample rate in Hz

def record_audio():
    print("[INFO: Recording... Press <Enter> to stop]")
    audio_data = []  # Initialize a list to store audio frames
    def callback(indata, frames, time, status):
        audio_data.append(indata.copy())
    with sd.InputStream(samplerate=SAMPLE_RATE, channels=1, callback=callback, dtype='int16'):
        input()  # Wait for the user to press Enter to stop recording
    print("[INFO: Recording complete]")
    print()
    audio_data = np.concatenate(audio_data)  # Concatenate the list into a single array
    filename = "output.wav"
    wavfile.write(filename, SAMPLE_RATE, audio_data)
    return audio_data
Saat fungsi ini dipanggil, perekaman dari mikrofon pengguna akan dimulai. Fungsi akan menunggu hingga pengguna menekan "Enter" lalu menyimpan audio ke dalam berkas dengan nama yang diberikan.
Untuk mengujinya, kita dapat menggabungkan fungsi ini dengan fungsi transkripsi di atas untuk mentranskripsi pesan yang diucapkan pengguna. Berikut cara membuat berkas baru bernama record_and_transcribe.py untuk mengimplementasikannya:
import asyncio
from audio_to_text import transcribe_audio
from audio_recorder import record_audio

async def main():
  record_audio("prompt.wav")
  await transcribe_audio("prompt.wav")

if __name__ == "__main__":
  asyncio.run(main())
Anda dapat mencoba menjalankannya dengan perintah python record_and_transcribe.py. Skrip akan merekam ucapan Anda hingga Anda menekan "Enter" lalu mentranskripsikan yang Anda ucapkan.
Di bagian ini, kita merangkai semuanya untuk membangun asisten audio. Kita mengimplementasikannya dalam berkas baru bernama audio_assistant.py dengan langkah-langkah berikut:
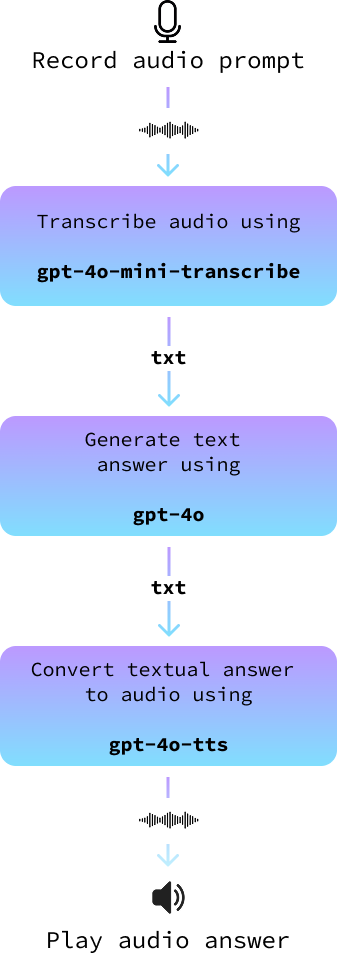
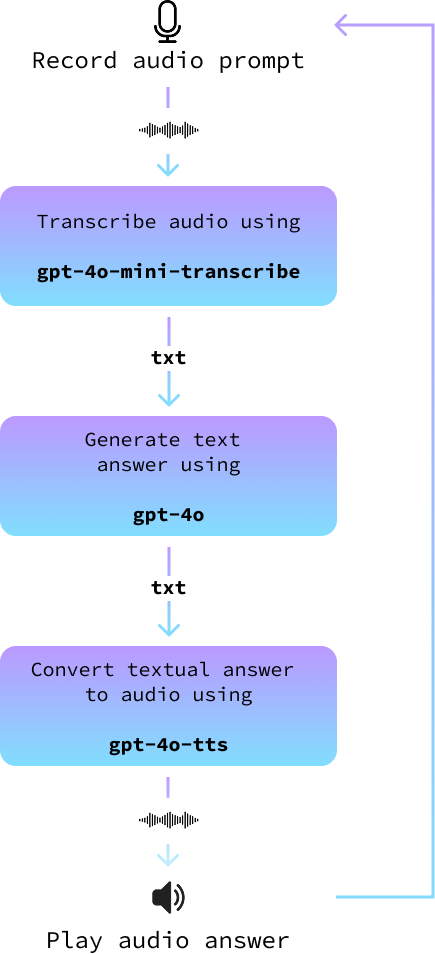
record_audio().transcribe_audio().gpt-4o untuk menghasilkan jawaban.text_to_audio().Diagram berikut mengilustrasikan hal ini:
Saya mendorong Anda untuk mencoba membangunnya sendiri sebelum melanjutkan membaca.
Pertama, kita mengimpor fungsi yang telah diimplementasikan sebelumnya dan menginisialisasi klien OpenAI.
# Import the functions we created
from text_to_audio import text_to_audio
from audio_to_text import transcribe_audio
from audio_recorder import record_audio

# Import other dependencies and initialize OpenAI
import asyncio
from openai import AsyncOpenAI
from dotenv import load_dotenv
load_dotenv()
openai = AsyncOpenAI()
Lalu, kita membutuhkan fungsi untuk menghasilkan jawaban. Ini menggunakan OpenAI GPT API biasa dengan model seperti gpt-4o atau model text-to-text lainnya. Jika Anda baru dengan ini, Anda bisa melihat tutorial API GPT-4o ini.
Berikut implementasi async dari fungsi ini:
async def get_answer(prompt):
  stream = await openai.chat.completions.create(
    model="gpt-4o",
    messages=[
      {"role": "user", "content": prompt}
    ],
    stream=True,
  )
  answer = ""
  async for chunk in stream:
    content = chunk.choices[0].delta.content
    if content is not None:
      answer += content
      print(content, end="", flush=True)
  print("\n\n")
  return answer
Untuk mengimplementasikan loop utama, kita mengikuti langkah-langkah yang diuraikan di atas:
async def main(tone_and_style_instructions):
  await text_to_audio("Hello, how can I help you today?", tone_and_style_instructions)
  while True:
    record_audio("prompt.wav")
    prompt = await transcribe_audio("prompt.wav")
    print()
    answer = await get_answer(prompt)
    await text_to_audio(answer, tone_and_style_instructions)
Terakhir, kita jalankan loop utama saat skrip dieksekusi:
if __name__ == "__main__":
  tone_and_style_instructions = "Enthusiastic voice."
  asyncio.run(main(tone_and_style_instructions))
Berikut demo saat dijalankan:
Pelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



