
课程
使用 pandas 进行数据处理
4 小时
567.5K
实践并学习路径你的进步。
使用 Google 继续Netflix 最近发布了一些用户评分数据。我想提出一个直接的问题:Netflix 订阅用户更偏爱老电影还是新电影?
直观来看,您会希望将数据集按年份拆分成若干组,然后计算一个汇总统计量,例如均值或中位数,接着观察这个统计量是否随着年份上升(之后,您可能还会进行统计检验)。
好消息是,针对这种做法与思考方式,有一个概念性的框架,并且在 Python 和 R 中都有实现。这个框架被称为“split-apply-combine”(拆分-应用-合并),因为我们会……
这就是当前分析的概念框架。在本文中,您将学习如何使用 Python 包 pandas 来回答上面的 Netflix 评分问题。使用 R 也可以完成同样的工作,例如使用 dplyr 包。我还会必要地深入讲解 groupby 对象,因为它们并不是最直观的对象。使用 groupby 对象进行拆分-应用-合并的过程,是我们都会直觉性执行的一种模式,正如我们将看到的,但直到 2011 年 Hadley Wickham 在其论文 The Split-Apply-Combine Strategy for Data Analysis 中才将这一过程形式化。
如果您觉得这项技术有用,欢迎前往我们的课程使用 pandas 操作 DataFrame了解更多并进行练习(以及学习更多其他内容)。
这里您将使用 pandas、groupby 对象以及拆分-应用-合并原则,来查看 Netflix 电影评分如何随上映年份变化。我最初是在 data.world 上这里发现这些数据的。如果您想复现本文内容,所有代码都可以在这里找到。
首先导入必要的包与数据,并查看前五行:
# Import packages and set visualization style
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
sns.set()
%matplotlib inline
# Import data and check out head of DataFrame
df = pd.read_csv('data/chasewillden-netflix-shows/data/netflix.csv')
df.head()
| title | rating | ratinglevel | ratingdescription | release_year | user_rating_score | user_rating_size | |
|---|---|---|---|---|---|---|---|
| 0 | White Chicks | PG-13 | crude and sexual humor, language and some drug... | 80 | 2004 | 82.0 | 80 |
| 1 | Lucky Number Slevin | R | strong violence, sexual content and adult lang... | 100 | 2006 | NaN | 82 |
| 2 | Grey's Anatomy | TV-14 | Parents strongly cautioned. May be unsuitable ... | 90 | 2016 | 98.0 | 80 |
| 3 | Prison Break | TV-14 | Parents strongly cautioned. May be unsuitable ... | 90 | 2008 | 98.0 | 80 |
| 4 | How I Met Your Mother | TV-PG | Parental guidance suggested. May not be suitab... | 70 | 2014 | 94.0 | 80 |
看起来很不错:您有标题、分级、上映年份和用户评分等多列。在进行 groupby 与拆分-应用-合并流程之前,先更仔细地查看数据,以确认其与我们的预期一致,并处理缺失值。请注意,第 2 行(行索引为 1)的 user_rating_score 中有一个缺失值 NaN。
pandas DataFrame 的 .info() 方法非常有用。下面应用该方法显示,我们有 1000 行、7 列的数据,但感兴趣的列 user_rating_score 只有 605 个非空值。这意味着有 395 个缺失值:
# Check out info of DataFrame
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 1000 entries, 0 to 999
Data columns (total 7 columns):
title                1000 non-null object
rating               1000 non-null object
ratinglevel          941 non-null object
ratingdescription    1000 non-null int64
release_year         1000 non-null int64
user_rating_score    605 non-null float64
user_rating_size     1000 non-null int64
dtypes: float64(1), int64(3), object(3)
memory usage: 54.8+ KB
您可以删除含有任意缺失值的行,移除重复行,并使用 seaborn 构建 DataFrame 的 pairplot,以便对数据有一个可视化直观认识。我们会用“rating”列来着色。看看这些图,看看能从中获得什么信息。
# Drop rows with missing values and drop duplicate
df.dropna(inplace=True)
df.drop_duplicates(inplace=True)

# Visualize pairplot of df
sns.pairplot(df, hue='rating');

例如,查看 user_rating_score 随 release_year 的变化。没有明显的可视化趋势,但也许进一步的数据分析会揭示趋势。如果您想查看 DataFrame 的若干汇总统计量,也可以使用 .describe() 方法:
# Get summary stats of df
df.describe()
| ratingdescription | release_year | user_rating_score | user_rating_size | |
|---|---|---|---|---|
| count | 246.000000 | 246.000000 | 246.000000 | 246.0 |
| mean | 73.556911 | 2010.272358 | 81.390244 | 80.0 |
| std | 26.616145 | 8.887219 | 12.677883 | 0.0 |
| min | 10.000000 | 1940.000000 | 55.000000 | 80.0 |
| 25% | 60.000000 | 2007.000000 | 71.000000 | 80.0 |
| 50% | 80.000000 | 2015.000000 | 83.500000 | 80.0 |
| 75% | 90.000000 | 2016.000000 | 92.750000 | 80.0 |
| max | 124.000000 | 2017.000000 | 99.000000 | 80.0 |
既然您已经查看了数据,现在到了有趣的部分。首先使用 groupby 方法将数据拆分为若干组,其中每一组都是某一年上映的电影集合。这就是拆分-应用-合并中的 拆分:
# Group by year
df_by_year = df.groupby('release_year')
这会创建一个 groupby 对象:
# Check type of GroupBy object
type(df_by_year)
pandas.core.groupby.DataFrameGroupBy这样的 groupby 对象非常有用。还记得 DataFrame 的 .describe() 方法会返回数值列的汇总统计吗?对于 DataFrameGroupBy 对象,.describe() 会对每个数值列计算汇总统计,但分别针对拆分后的每个组。在您的案例中,就是针对每个 release_year。这就是拆分-应用-合并中的 应用:您在 groupby 的每个组上应用 .describe() 方法。执行并打印结果的前 5 行:
# Summary stats over years
df_by_year.describe().head()
| ratingdescription | user_rating_score | user_rating_size | |||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| count | mean | std | min | 25% | 50% | 75% | max | count | mean | ... | 75% | max | count | mean | std | min | 25% | 50% | 75% | max | |
| release_year | |||||||||||||||||||||
| 1940 | 1.0 | 35.0 | NaN | 35.0 | 35.0 | 35.0 | 35.0 | 35.0 | 1.0 | 61.0 | ... | 61.0 | 61.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1978 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 86.0 | ... | 86.0 | 86.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1982 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 68.0 | ... | 68.0 | 68.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1986 | 1.0 | 35.0 | NaN | 35.0 | 35.0 | 35.0 | 35.0 | 35.0 | 1.0 | 67.0 | ... | 67.0 | 67.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1987 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 58.0 | ... | 58.0 | 58.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
5 rows × 24 columns
如果您想看看分组后的样子,可以将 groupby 对象传给 list() 函数:
# Cast grouping as a list and check out one year
list(df_by_year)[10]
(1995,             title rating                                ratinglevel  \
 766         Balto      G  General Audiences. Suitable for all ages.
 967  Heavyweights     PG              some rude language and pranks

      ratingdescription  release_year  user_rating_score  user_rating_size
 766                 35          1995               64.0                80
967 60 1995 74.0 80 )假设您想要每一年的 user_rating_score 的均值或中位数。那么可以分别对 groupby 对象应用 .mean() 或 .median() 方法,并将这些结果“合并”为一个新的 DataFrame。
# Get median values by year and print first 5 rows
df_med_by_year = df_by_year.median()
df_med_by_year.head()| ratingdescription | user_rating_score | user_rating_size | |
|---|---|---|---|
| release_year | |||
| 1940 | 35.0 | 61.0 | 80.0 |
| 1978 | 60.0 | 86.0 | 80.0 |
| 1982 | 60.0 | 68.0 | 80.0 |
| 1986 | 35.0 | 67.0 | 80.0 |
| 1987 | 60.0 | 58.0 | 80.0 |
关于 DataFrame df_med_by_year 的索引,有一个重要的细节。回想一下,DataFrame 的索引由行标签组成。先看看原始 DataFrame df 的索引:
# Print index of df
print(df.index)
Int64Index([  0,   2,   3,   4,   5,   6,   7,   8,   9,  10,
            ...
            908, 911, 917, 931, 962, 966, 967, 972, 973, 979],
           dtype='int64', length=246)
这个索引由原始的行号(整数)组成。由于之前删除了部分行,“1”缺失。df_med_by_year 的索引由您进行分组时所用原始列中的取值组成,也就是 release_year 中的年份:
# Print index
print(df_med_by_year.index)
Int64Index([1940, 1978, 1982, 1986, 1987, 1989, 1990, 1992, 1993, 1994, 1995,
            1997, 1998, 1999, 2000, 2001, 2002, 2003, 2004, 2005, 2006, 2007,
            2008, 2009, 2010, 2011, 2012, 2013, 2014, 2015, 2016, 2017],
           dtype='int64', name='release_year')
我们关注的是 user_rating_score 列,它包含每一年的评分中位数。您可以切片取出 df_med_by_year 的 user_rating_score 列,并按年份(由 DataFrame df_rat_by_year 的索引给出)进行绘图:
# Slice out user rating and plot
df_rat_by_year = df_med_by_year['user_rating_score']
plt.scatter(df_rat_by_year.index, df_rat_by_year)
plt.xlabel('year of release')
plt.ylabel('median rating');
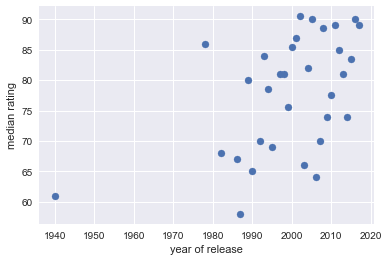
从图中可以看到,中位数评分确实随时间上升。要让我对总体趋势信服,还需要使用更复杂的统计方法,但这正是探索性数据分析作为进一步研究起点的一个好例子。
Groupby 对象并不直观。然而,它对应于一个很自然的动作:根据数据集的一列(或多列,但我们将把多列分组和分级索引留到另一篇文章)来拆分数据集。
拆分-应用-合并原则不仅优雅、实用,也是数据科学家日常使用的工具,就像上面的示例。想更深入了解其用法,请查看 Hadley Wickham 的原始论文 The Split-Apply-Combine Strategy for Data Analysis。如果您有任何想法、反馈或随想,欢迎在 Twitter 上与我联系:@hugobowne。
看看 DataCamp 其他实用的 pandas 教程,包括:
pandas 课程
课程
课程
实践并学习路径你的进步。
使用 Google 继续