Kurs
Datenbearbeitung mit pandas
4 Std.
563.9K
Netflix hat kürzlich Nutzungsbewertungen veröffentlicht. Ich wollte eine einfache Frage stellen: Mögen Netflix-Abonnentinnen und -Abonnenten eher ältere oder neuere Filme?
Aus dem Bauch heraus würdest du den Datensatz nach Jahren aufteilen, pro Jahr eine Gruppe bilden, dann eine Kenngröße wie den Mittelwert oder Median berechnen und anschließend prüfen, ob diese Kennzahl im Laufe der Jahre steigt (danach könntest du einen statistischen Test durchführen).
Praktisch ist, dass es dafür ein klares Konzept gibt – inklusive Implementierungen in Python und R. Das Konzept heißt „Split-Apply-Combine“, weil wir ...
Das ist der gedankliche Rahmen für die Analyse. In diesem Beitrag lernst du, wie du damit die obige Netflix-Frage in Python mit pandas beantwortest. Dasselbe ließe sich in R zum Beispiel mit dem Paket dplyr umsetzen. Außerdem schauen wir uns groupby-Objekte genauer an, die nicht gerade selbsterklärend sind. Das Muster Split-Apply-Combine mit groupby-Objekten wenden wir zwar oft intuitiv an, doch Hadley Wickham hat es 2011 in seinem Paper The Split-Apply-Combine Strategy for Data Analysis erstmals formal beschrieben.
Wenn dir diese Technik gefällt, kannst du sie (und vieles mehr) in unserem Kurs Manipulating DataFrames with pandas vertiefen und üben.
Hier nutzt du pandas, groupby-Objekte und die Prinzipien von Split-Apply-Combine, um zu untersuchen, wie sich Netflix-Bewertungen je nach Erscheinungsjahr unterscheiden. Ich bin ursprünglich hier auf data.world über die Daten gestolpert. Den kompletten Code zu diesem Beitrag findest du hier, falls du alles reproduzieren möchtest.
Zuerst importierst du die nötigen Pakete und die Daten und schaust dir die ersten fünf Zeilen an:
# Import packages and set visualization style
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
sns.set()
%matplotlib inline
# Import data and check out head of DataFrame
df = pd.read_csv('data/chasewillden-netflix-shows/data/netflix.csv')
df.head()
| title | rating | ratinglevel | ratingdescription | release_year | user_rating_score | user_rating_size | |
|---|---|---|---|---|---|---|---|
| 0 | White Chicks | PG-13 | crude and sexual humor, language and some drug... | 80 | 2004 | 82.0 | 80 |
| 1 | Lucky Number Slevin | R | strong violence, sexual content and adult lang... | 100 | 2006 | NaN | 82 |
| 2 | Grey's Anatomy | TV-14 | Parents strongly cautioned. May be unsuitable ... | 90 | 2016 | 98.0 | 80 |
| 3 | Prison Break | TV-14 | Parents strongly cautioned. May be unsuitable ... | 90 | 2008 | 98.0 | 80 |
| 4 | How I Met Your Mother | TV-PG | Parental guidance suggested. May not be suitab... | 70 | 2014 | 94.0 | 80 |
Sieht vielversprechend aus: Du hast Titel, Altersfreigaben, Erscheinungsjahr und Nutzerbewertung, neben einigen weiteren Spalten. Bevor wir mit groupby und Split-Apply-Combine loslegen, werfen wir einen genaueren Blick auf die Daten, um Annahmen zu prüfen und fehlende Werte zu behandeln. Beachte zum Beispiel den fehlenden Wert NaN in user_rating_score der zweiten Zeile (Zeile 1).
Die pandas-Methode .info() ist Gold wert. Hier zeigt sie, dass 1000 Zeilen und 7 Spalten vorliegen, aber die für uns relevante Spalte user_rating_score nur 605 Nicht-Null-Werte enthält. Das heißt, es fehlen 395 Werte:
# Check out info of DataFrame
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 1000 entries, 0 to 999
Data columns (total 7 columns):
title                1000 non-null object
rating               1000 non-null object
ratinglevel          941 non-null object
ratingdescription    1000 non-null int64
release_year         1000 non-null int64
user_rating_score    605 non-null float64
user_rating_size     1000 non-null int64
dtypes: float64(1), int64(3), object(3)
memory usage: 54.8+ KB
Du kannst Zeilen mit fehlenden Werten entfernen, Dubletten löschen und mit seaborn ein pairplot erstellen, um ein visuelles Gefühl für die Daten zu bekommen. Wir färben nach der Spalte 'rating'. Schau dir die Plots an und überlege, welche Hinweise sie liefern.
# Drop rows with missing values and drop duplicate
df.dropna(inplace=True)
df.drop_duplicates(inplace=True)

# Visualize pairplot of df
sns.pairplot(df, hue='rating');

Betrachte zum Beispiel user_rating_score in Abhängigkeit vom release_year. Es ist kein klarer Trend erkennbar, aber vielleicht bringt eine Analyse mehr ans Licht. Mehrere Kenngrößen lässt du dir mit .describe() ausgeben:
# Get summary stats of df
df.describe()
| ratingdescription | release_year | user_rating_score | user_rating_size | |
|---|---|---|---|---|
| count | 246.000000 | 246.000000 | 246.000000 | 246.0 |
| mean | 73.556911 | 2010.272358 | 81.390244 | 80.0 |
| std | 26.616145 | 8.887219 | 12.677883 | 0.0 |
| min | 10.000000 | 1940.000000 | 55.000000 | 80.0 |
| 25% | 60.000000 | 2007.000000 | 71.000000 | 80.0 |
| 50% | 80.000000 | 2015.000000 | 83.500000 | 80.0 |
| 75% | 90.000000 | 2016.000000 | 92.750000 | 80.0 |
| max | 124.000000 | 2017.000000 | 99.000000 | 80.0 |
Nachdem du die Daten geprüft hast, kommt jetzt der spannende Teil. Zuerst teilst du sie per groupby in Gruppen auf, wobei jede Gruppe die in einem bestimmten Jahr veröffentlichten Filme enthält. Das ist der Split in Split-Apply-Combine:
# Group by year
df_by_year = df.groupby('release_year')
Das erzeugt ein groupby-Objekt:
# Check type of GroupBy object
type(df_by_year)
pandas.core.groupby.DataFrameGroupBySolche groupby-Objekte sind äußerst nützlich. Erinnerst du dich, dass .describe() für einen DataFrame Kenngrößen für numerische Spalten liefert? Für DataFrameGroupBy-Objekte gibt .describe() dieselben Statistiken je Gruppe aus. In unserem Fall also je release_year. Das ist ein Beispiel für Apply in Split-Apply-Combine: Du anwendest .describe() auf jede Gruppe. Führe das aus und gib die ersten 5 Zeilen aus:
# Summary stats over years
df_by_year.describe().head()
| ratingdescription | user_rating_score | user_rating_size | |||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| count | mean | std | min | 25% | 50% | 75% | max | count | mean | ... | 75% | max | count | mean | std | min | 25% | 50% | 75% | max | |
| release_year | |||||||||||||||||||||
| 1940 | 1.0 | 35.0 | NaN | 35.0 | 35.0 | 35.0 | 35.0 | 35.0 | 1.0 | 61.0 | ... | 61.0 | 61.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1978 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 86.0 | ... | 86.0 | 86.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1982 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 68.0 | ... | 68.0 | 68.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1986 | 1.0 | 35.0 | NaN | 35.0 | 35.0 | 35.0 | 35.0 | 35.0 | 1.0 | 67.0 | ... | 67.0 | 67.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1987 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 58.0 | ... | 58.0 | 58.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
5 rows × 24 columns
Wenn du sehen willst, wie die Gruppierung konkret aussieht, kannst du das groupby-Objekt an list() übergeben:
# Cast grouping as a list and check out one year
list(df_by_year)[10]
(1995,             title rating                                ratinglevel  \
 766         Balto      G  General Audiences. Suitable for all ages.
 967  Heavyweights     PG              some rude language and pranks

      ratingdescription  release_year  user_rating_score  user_rating_size
 766                 35          1995               64.0                80
967 60 1995 74.0 80 )Angenommen, du möchtest den mittleren oder Median-user_rating_score je Jahr. Dann kannst du .mean() oder .median() auf das groupby-Objekt anwenden und die Ergebnisse zu einem neuen DataFrame „kombinieren“.
# Get median values by year and print first 5 rows
df_med_by_year = df_by_year.median()
df_med_by_year.head()| ratingdescription | user_rating_score | user_rating_size | |
|---|---|---|---|
| release_year | |||
| 1940 | 35.0 | 61.0 | 80.0 |
| 1978 | 60.0 | 86.0 | 80.0 |
| 1982 | 60.0 | 68.0 | 80.0 |
| 1986 | 35.0 | 67.0 | 80.0 |
| 1987 | 60.0 | 58.0 | 80.0 |
Wichtig ist hier ein Detail zum Index des DataFrames df_med_by_year. Der Index eines DataFrames besteht aus den Zeilenlabels. Schau dir den Index des ursprünglichen DataFrames df an:
# Print index of df
print(df.index)
Int64Index([  0,   2,   3,   4,   5,   6,   7,   8,   9,  10,
            ...
            908, 911, 917, 931, 962, 966, 967, 972, 973, 979],
           dtype='int64', length=246)
Dieser Index sind die ursprünglichen Zeilennummern, also ganze Zahlen. Die '1' fehlt, weil du oben Zeilen entfernt hast. Der Index von df_med_by_year besteht dagegen aus den Werten der Spalte, nach der du gruppiert hast – den Jahren aus release_year:
# Print index
print(df_med_by_year.index)
Int64Index([1940, 1978, 1982, 1986, 1987, 1989, 1990, 1992, 1993, 1994, 1995,
            1997, 1998, 1999, 2000, 2001, 2002, 2003, 2004, 2005, 2006, 2007,
            2008, 2009, 2010, 2011, 2012, 2013, 2014, 2015, 2016, 2017],
           dtype='int64', name='release_year')
Uns interessiert die Spalte user_rating_score, also der Median je Jahr. Du kannst die Spalte aus df_med_by_year herausgreifen und als Funktion des Jahres (gegeben durch den Index von df_rat_by_year) plotten:
# Slice out user rating and plot
df_rat_by_year = df_med_by_year['user_rating_score']
plt.scatter(df_rat_by_year.index, df_rat_by_year)
plt.xlabel('year of release')
plt.ylabel('median rating');
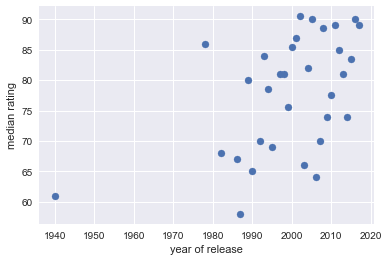
Der Median scheint im Zeitverlauf tatsächlich zu steigen. Um den Trend allgemein zu belegen, bräuchte es belastbarere Statistik, aber als Explorative Datenanalyse ist das ein solider Ausgangspunkt für weitere Untersuchungen.
Groupby-Objekte sind nicht intuitiv. Sie entsprechen aber einem natürlichen Vorgehen: einen Datensatz entlang einer Spalte aufzuteilen (oder auch mehreren, doch das heben wir uns für einen Beitrag zu Mehrfach-Gruppierungen und hierarchischen Indizes auf).
Das Split-Apply-Combine-Prinzip ist nicht nur elegant und praktisch, es gehört für Data Scientists zum Tagesgeschäft – so wie im obigen Beispiel. Wenn du mehr Anwendungen sehen möchtest, wirf einen Blick in Hadley Wickhams ursprüngliches Paper The Split-Apply-Combine Strategy for Data Analysis. Wenn du Gedanken, Fragen oder Anmerkungen hast, schreib mir gern auf Twitter: @hugobowne.
Sieh dir auch diese praktischen pandas-Tutorials von DataCamp an:
pandas-Kurse
Kurs
Kurs
Kurs