Curso
Manipulación de datos con pandas
4 h
563.9K
Netflix publicó recientemente algunos datos de valoraciones de usuarios. Yo quería responder a una pregunta sencilla: ¿los suscriptores de Netflix prefieren las películas antiguas o las nuevas?
De forma intuitiva, querrás dividir el conjunto de datos en grupos, uno por cada año, calcular una estadística resumen, como la media o la mediana, y comprobar si esa estadística aumenta con los años (después, quizá quieras hacer una prueba estadística).
Lo mejor es que existe un marco conceptual para hacer y pensar en esto, con implementaciones tanto en Python como en R. El enfoque se conoce como "split-apply-combine" porque...
Este es el marco conceptual para el análisis que nos ocupa. En este post aprenderás a hacerlo para responder a la pregunta sobre las valoraciones de Netflix usando el paquete de Python pandas. Podrías hacer lo mismo en R usando, por ejemplo, el paquete dplyr. También voy a profundizar necesariamente en los objetos groupby, que no son los más intuitivos. El proceso split-apply-combine con objetos groupby es un patrón que todos aplicamos de forma intuitiva, como veremos, pero fue Hadley Wickham quien formalizó el procedimiento en 2011 con su artículo The Split-Apply-Combine Strategy for Data Analysis.
Si te resulta útil esta técnica, puedes aprender más (entre muchas otras cosas) y practicarla en nuestro curso Manipulating DataFrames with pandas.
Aquí usarás pandas, objetos groupby y los principios de split-apply-combine para ver cómo varían las valoraciones de películas de Netflix en función del año de estreno. Encontré los datos originalmente en data.world aquí. Puedes encontrar todo el código de este post aquí si quieres reproducirlo.
Primero importarás los paquetes necesarios y los datos, y echarás un vistazo a las cinco primeras filas:
# Import packages and set visualization style
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
sns.set()
%matplotlib inline
# Import data and check out head of DataFrame
df = pd.read_csv('data/chasewillden-netflix-shows/data/netflix.csv')
df.head()
| title | rating | ratinglevel | ratingdescription | release_year | user_rating_score | user_rating_size | |
|---|---|---|---|---|---|---|---|
| 0 | White Chicks | PG-13 | crude and sexual humor, language and some drug... | 80 | 2004 | 82.0 | 80 |
| 1 | Lucky Number Slevin | R | strong violence, sexual content and adult lang... | 100 | 2006 | NaN | 82 |
| 2 | Grey's Anatomy | TV-14 | Parents strongly cautioned. May be unsuitable ... | 90 | 2016 | 98.0 | 80 |
| 3 | Prison Break | TV-14 | Parents strongly cautioned. May be unsuitable ... | 90 | 2008 | 98.0 | 80 |
| 4 | How I Met Your Mother | TV-PG | Parental guidance suggested. May not be suitab... | 70 | 2014 | 94.0 | 80 |
Tiene buena pinta: tienes títulos, clasificación por edades, año de estreno y la puntuación de usuarios, entre otras columnas. Antes de hacer el groupby y aplicar split-apply-combine, vamos a mirar los datos con más detalle para asegurarnos de que son lo que creemos y para tratar los valores ausentes. Observa que hay un valor ausente NaN en user_rating_score de la segunda fila (fila 1).
El método .info() de un DataFrame de pandas es oro puro. Aplicarlo a continuación muestra que tienes 1000 filas y 7 columnas, pero también que la columna de interés, user_rating_score, solo tiene 605 valores no nulos. Esto significa que hay 395 valores ausentes:
# Check out info of DataFrame
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 1000 entries, 0 to 999
Data columns (total 7 columns):
title                1000 non-null object
rating               1000 non-null object
ratinglevel          941 non-null object
ratingdescription    1000 non-null int64
release_year         1000 non-null int64
user_rating_score    605 non-null float64
user_rating_size     1000 non-null int64
dtypes: float64(1), int64(3), object(3)
memory usage: 54.8+ KB
Puedes eliminar las filas con valores ausentes, quitar duplicados y crear un pairplot del DataFrame con seaborn para hacerte una idea visual de los datos. Colorearemos por la columna 'rating'. Revisa los gráficos y piensa qué información puedes extraer.
# Drop rows with missing values and drop duplicate
df.dropna(inplace=True)
df.drop_duplicates(inplace=True)

# Visualize pairplot of df
sns.pairplot(df, hue='rating');

Fíjate, por ejemplo, en user_rating_score en función de release_year. No hay una tendencia evidente a simple vista, pero quizá un poco de análisis de datos nos ayude a sacarla. Si quieres consultar varias estadísticas resumen del DataFrame, también puedes hacerlo con el método .describe():
# Get summary stats of df
df.describe()
| ratingdescription | release_year | user_rating_score | user_rating_size | |
|---|---|---|---|---|
| count | 246.000000 | 246.000000 | 246.000000 | 246.0 |
| mean | 73.556911 | 2010.272358 | 81.390244 | 80.0 |
| std | 26.616145 | 8.887219 | 12.677883 | 0.0 |
| min | 10.000000 | 1940.000000 | 55.000000 | 80.0 |
| 25% | 60.000000 | 2007.000000 | 71.000000 | 80.0 |
| 50% | 80.000000 | 2015.000000 | 83.500000 | 80.0 |
| 75% | 90.000000 | 2016.000000 | 92.750000 | 80.0 |
| max | 124.000000 | 2017.000000 | 99.000000 | 80.0 |
Ahora que ya has revisado los datos, vamos a la parte entretenida. Primero usarás un método groupby para dividir los datos en grupos, donde cada grupo es el conjunto de películas estrenadas en un año dado. Este es el split de split-apply-combine:
# Group by year
df_by_year = df.groupby('release_year')
Esto crea un objeto groupby:
# Check type of GroupBy object
type(df_by_year)
pandas.core.groupby.DataFrameGroupByEstos objetos groupby son muy útiles. ¿Recuerdas que el método .describe() para un DataFrame devuelve estadísticas resumen de las columnas numéricas? Pues bien, el método .describe() para objetos DataFrameGroupBy devuelve estadísticas resumen para cada columna numérica, pero calculadas para cada grupo del split. En tu caso, para cada release_year. Este es un ejemplo del apply en split-apply-combine: estás aplicando el método .describe() a cada grupo del groupby. Hazlo e imprime las 5 primeras filas del resultado:
# Summary stats over years
df_by_year.describe().head()
| ratingdescription | user_rating_score | user_rating_size | |||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| count | mean | std | min | 25% | 50% | 75% | max | count | mean | ... | 75% | max | count | mean | std | min | 25% | 50% | 75% | max | |
| release_year | |||||||||||||||||||||
| 1940 | 1.0 | 35.0 | NaN | 35.0 | 35.0 | 35.0 | 35.0 | 35.0 | 1.0 | 61.0 | ... | 61.0 | 61.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1978 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 86.0 | ... | 86.0 | 86.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1982 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 68.0 | ... | 68.0 | 68.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1986 | 1.0 | 35.0 | NaN | 35.0 | 35.0 | 35.0 | 35.0 | 35.0 | 1.0 | 67.0 | ... | 67.0 | 67.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1987 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 58.0 | ... | 58.0 | 58.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
5 rows × 24 columns
Si quieres ver cómo queda la agrupación, puedes pasar el objeto groupby a la función list():
# Cast grouping as a list and check out one year
list(df_by_year)[10]
(1995,             title rating                                ratinglevel  \
 766         Balto      G  General Audiences. Suitable for all ages.
 967  Heavyweights     PG              some rude language and pranks

      ratingdescription  release_year  user_rating_score  user_rating_size
 766                 35          1995               64.0                80
967 60 1995 74.0 80 )Imagina que quieres la media o la mediana de user_rating_score para cada año. Entonces puedes aplicar los métodos .mean() o .median(), respectivamente, al objeto groupby y "combinar" estos resultados en un nuevo DataFrame.
# Get median values by year and print first 5 rows
df_med_by_year = df_by_year.median()
df_med_by_year.head()| ratingdescription | user_rating_score | user_rating_size | |
|---|---|---|---|
| release_year | |||
| 1940 | 35.0 | 61.0 | 80.0 |
| 1978 | 60.0 | 86.0 | 80.0 |
| 1982 | 60.0 | 68.0 | 80.0 |
| 1986 | 35.0 | 67.0 | 80.0 |
| 1987 | 60.0 | 58.0 | 80.0 |
Hay un matiz importante respecto al índice del DataFrame df_med_by_year. Recuerda que el índice de un DataFrame son las etiquetas de fila. Fíjate en el índice del DataFrame original df:
# Print index of df
print(df.index)
Int64Index([  0,   2,   3,   4,   5,   6,   7,   8,   9,  10,
            ...
            908, 911, 917, 931, 962, 966, 967, 972, 973, 979],
           dtype='int64', length=246)
Este índice son los números de fila originales, etiquetados con enteros. Falta el '1' porque eliminaste algunas filas antes. El índice de df_med_by_year son los valores de la columna original por la que agrupaste, los años de release_year:
# Print index
print(df_med_by_year.index)
Int64Index([1940, 1978, 1982, 1986, 1987, 1989, 1990, 1992, 1993, 1994, 1995,
            1997, 1998, 1999, 2000, 2001, 2002, 2003, 2004, 2005, 2006, 2007,
            2008, 2009, 2010, 2011, 2012, 2013, 2014, 2015, 2016, 2017],
           dtype='int64', name='release_year')
Te interesa la columna user_rating_score, que contiene la mediana de la valoración de cada año. Puedes extraer la columna user_rating_score de df_med_by_year y representarla en función del año (dado por el índice del DataFrame df_rat_by_year):
# Slice out user rating and plot
df_rat_by_year = df_med_by_year['user_rating_score']
plt.scatter(df_rat_by_year.index, df_rat_by_year)
plt.xlabel('year of release')
plt.ylabel('median rating');
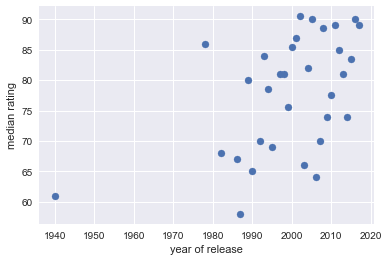
Al mirar la figura, la mediana de la valoración aumenta claramente con el tiempo. Harían falta estadísticas más sofisticadas para convencerme de la tendencia en general, pero este es un buen ejemplo de cómo el análisis exploratorio es un gran punto de partida para seguir investigando.
Los objetos groupby no son intuitivos. Sin embargo, reflejan un acto natural: dividir un conjunto de datos con respecto a una de sus columnas (o a más de una, pero dejemos eso para otro post sobre agrupación por múltiples columnas e índices jerárquicos).
El principio split-apply-combine no solo es elegante y práctico, es algo que los Data Scientists usan a diario, como en el ejemplo anterior. Para apreciar más usos, echa un vistazo al artículo original de Hadley Wickham, The Split-Apply-Combine Strategy for Data Analysis. Si tienes ideas, comentarios o reflexiones, escríbeme en Twitter: @hugobowne.
Echa un vistazo a otros tutoriales prácticos de pandas en DataCamp, como:
Cursos de pandas
Curso
Curso
Curso
Tutorial
DataCamp Team
13 min
Tutorial
Karlijn Willems
15 min
Tutorial
DataCamp Team
7 min
Tutorial
Vidhi Chugh
15 min
Tutorial
Kevin Babitz
8 min
Tutorial
Moez Ali
14 min





