Corso
Manipolazione dei dati con pandas
4 ore
565.8K
Netflix ha pubblicato di recente alcuni dati sulle valutazioni degli utenti. Volevo pormi una domanda semplice: gli abbonati Netflix preferiscono i film più vecchi o quelli più recenti?
In modo intuitivo, verrebbe da suddividere il dataset in gruppi, uno per ogni anno, calcolare poi una statistica riassuntiva, come la media o la mediana, e quindi verificare se questa statistica aumenta nel corso degli anni (dopodiché potresti voler eseguire un test statistico).
La cosa interessante è che esiste un modello concettuale per fare e pensare tutto questo, con implementazioni sia in Python che in R. Il modello è noto come "split-apply-combine" perché...
Questo è il quadro concettuale per l'analisi in questione. In questo post imparerai come farlo per rispondere alla domanda sulle valutazioni Netflix qui sopra usando il pacchetto Python pandas. Potresti fare lo stesso in R usando, per esempio, il pacchetto dplyr. Tratterò anche necessariamente gli oggetti groupby, che non sono i più intuitivi. Il processo split-apply-combine con gli oggetti groupby è uno schema che tutti noi applichiamo in modo intuitivo, come vedremo, ma ci è voluto Hadley Wickham per formalizzare la procedura nel 2011 con il suo articolo The Split-Apply-Combine Strategy for Data Analysis.
Se trovi utile questa tecnica, puoi approfondirla (tra molte altre cose) ed esercitarti nel nostro corso Manipulating DataFrames with pandas.
Qui userai pandas, gli oggetti groupby e i principi di split-apply-combine per verificare come variano le valutazioni dei film su Netflix in funzione dell'anno di uscita. Ho trovato originariamente i dati su data.world qui. Puoi trovare tutto il codice di questo post qui se vuoi riprodurlo.
Per prima cosa importerai i pacchetti necessari e i dati e darai un'occhiata alle prime cinque righe:
# Import packages and set visualization style
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
sns.set()
%matplotlib inline
# Import data and check out head of DataFrame
df = pd.read_csv('data/chasewillden-netflix-shows/data/netflix.csv')
df.head()
| title | rating | ratinglevel | ratingdescription | release_year | user_rating_score | user_rating_size | |
|---|---|---|---|---|---|---|---|
| 0 | White Chicks | PG-13 | crude and sexual humor, language and some drug... | 80 | 2004 | 82.0 | 80 |
| 1 | Lucky Number Slevin | R | strong violence, sexual content and adult lang... | 100 | 2006 | NaN | 82 |
| 2 | Grey's Anatomy | TV-14 | Parents strongly cautioned. May be unsuitable ... | 90 | 2016 | 98.0 | 80 |
| 3 | Prison Break | TV-14 | Parents strongly cautioned. May be unsuitable ... | 90 | 2008 | 98.0 | 80 |
| 4 | How I Met Your Mother | TV-PG | Parental guidance suggested. May not be suitab... | 70 | 2014 | 94.0 | 80 |
A me sembra piuttosto interessante: hai titoli, classificazioni, anno di uscita e punteggio delle valutazioni degli utenti, tra diverse altre colonne. Prima di eseguire la procedura groupby e split-apply-combine, guardiamo un po' più da vicino i dati per assicurarci che siano quello che pensiamo e per gestire i valori mancanti. Nota che c'è un valore mancante NaN nel campo user_rating_score della seconda riga (riga 1).
Il metodo .info() di un DataFrame pandas è preziosissimo. Applicandolo qui sotto si vede che hai 1000 righe e 7 colonne di dati, ma anche che la colonna di interesse, user_rating_score, ha solo 605 valori non nulli. Questo significa che ci sono 395 valori mancanti:
# Check out info of DataFrame
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 1000 entries, 0 to 999
Data columns (total 7 columns):
title                1000 non-null object
rating               1000 non-null object
ratinglevel          941 non-null object
ratingdescription    1000 non-null int64
release_year         1000 non-null int64
user_rating_score    605 non-null float64
user_rating_size     1000 non-null int64
dtypes: float64(1), int64(3), object(3)
memory usage: 54.8+ KB
Puoi eliminare le righe che hanno valori mancanti, rimuovere eventuali duplicati e creare un pairplot del DataFrame usando seaborn per farti un'idea visiva dei dati. Colorerai i dati in base alla colonna 'rating'. Dai un'occhiata ai grafici e vedi quali informazioni ne ricavi.
# Drop rows with missing values and drop duplicate
df.dropna(inplace=True)
df.drop_duplicates(inplace=True)

# Visualize pairplot of df
sns.pairplot(df, hue='rating');

Osserva, per esempio, user_rating_score in funzione di release_year. Non c'è una tendenza identificabile a occhio, ma forse un'analisi dei dati metterà in evidenza eventuali trend. Se vuoi consultare diverse statistiche riassuntive del DataFrame, puoi farlo anche con il metodo .describe():
# Get summary stats of df
df.describe()
| ratingdescription | release_year | user_rating_score | user_rating_size | |
|---|---|---|---|---|
| count | 246.000000 | 246.000000 | 246.000000 | 246.0 |
| mean | 73.556911 | 2010.272358 | 81.390244 | 80.0 |
| std | 26.616145 | 8.887219 | 12.677883 | 0.0 |
| min | 10.000000 | 1940.000000 | 55.000000 | 80.0 |
| 25% | 60.000000 | 2007.000000 | 71.000000 | 80.0 |
| 50% | 80.000000 | 2015.000000 | 83.500000 | 80.0 |
| 75% | 90.000000 | 2016.000000 | 92.750000 | 80.0 |
| max | 124.000000 | 2017.000000 | 99.000000 | 80.0 |
Ora che hai esaminato i dati, è il momento della parte divertente. Per prima cosa userai un metodo groupby per suddividere i dati in gruppi, dove ogni gruppo è l'insieme dei film usciti in un dato anno. Questo è lo split in split-apply-combine:
# Group by year
df_by_year = df.groupby('release_year')
Questo crea un oggetto groupby:
# Check type of GroupBy object
type(df_by_year)
pandas.core.groupby.DataFrameGroupByQuesti oggetti groupby sono molto utili. Ricordi che il metodo .describe() per un DataFrame restituisce statistiche riassuntive per le colonne numeriche? Ecco, il metodo .describe() per gli oggetti DataFrameGroupBy restituisce statistiche riassuntive per ogni colonna numerica, ma calcolate per ciascun gruppo nella suddivisione. Nel tuo caso, è per ogni release_year. Questo è un esempio di apply in split-apply-combine: stai applicando il metodo .describe() a ogni gruppo nel groupby. Fallo e stampa le prime 5 righe del risultato:
# Summary stats over years
df_by_year.describe().head()
| ratingdescription | user_rating_score | user_rating_size | |||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| count | mean | std | min | 25% | 50% | 75% | max | count | mean | ... | 75% | max | count | mean | std | min | 25% | 50% | 75% | max | |
| release_year | |||||||||||||||||||||
| 1940 | 1.0 | 35.0 | NaN | 35.0 | 35.0 | 35.0 | 35.0 | 35.0 | 1.0 | 61.0 | ... | 61.0 | 61.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1978 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 86.0 | ... | 86.0 | 86.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1982 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 68.0 | ... | 68.0 | 68.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1986 | 1.0 | 35.0 | NaN | 35.0 | 35.0 | 35.0 | 35.0 | 35.0 | 1.0 | 67.0 | ... | 67.0 | 67.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1987 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 58.0 | ... | 58.0 | 58.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
5 rows × 24 columns
Se vuoi vedere come appare il raggruppamento, puoi passare l'oggetto groupby alla funzione list():
# Cast grouping as a list and check out one year
list(df_by_year)[10]
(1995,             title rating                                ratinglevel  \
 766         Balto      G  General Audiences. Suitable for all ages.
 967  Heavyweights     PG              some rude language and pranks

      ratingdescription  release_year  user_rating_score  user_rating_size
 766                 35          1995               64.0                80
967 60 1995 74.0 80 )Mettiamo che tu voglia la media o la mediana di user_rating_score per ogni anno. Allora puoi applicare rispettivamente i metodi .mean() o .median() all'oggetto groupby e "combinare" questi risultati in un nuovo DataFrame.
# Get median values by year and print first 5 rows
df_med_by_year = df_by_year.median()
df_med_by_year.head()| ratingdescription | user_rating_score | user_rating_size | |
|---|---|---|---|
| release_year | |||
| 1940 | 35.0 | 61.0 | 80.0 |
| 1978 | 60.0 | 86.0 | 80.0 |
| 1982 | 60.0 | 68.0 | 80.0 |
| 1986 | 35.0 | 67.0 | 80.0 |
| 1987 | 60.0 | 58.0 | 80.0 |
C'è una sottigliezza importante che riguarda l'indice del DataFrame df_med_by_year. Ricorda che l'indice di un DataFrame è costituito dalle etichette delle righe. Guarda l'indice del DataFrame originale df:
# Print index of df
print(df.index)
Int64Index([  0,   2,   3,   4,   5,   6,   7,   8,   9,  10,
            ...
            908, 911, 917, 931, 962, 966, 967, 972, 973, 979],
           dtype='int64', length=246)
Questo indice è costituito dai numeri di riga originali, etichettati con interi. Il '1' manca perché hai eliminato alcune righe in precedenza. L'indice di df_med_by_year è costituito dai valori nella colonna originale su cui hai eseguito il raggruppamento, gli anni di release_year:
# Print index
print(df_med_by_year.index)
Int64Index([1940, 1978, 1982, 1986, 1987, 1989, 1990, 1992, 1993, 1994, 1995,
            1997, 1998, 1999, 2000, 2001, 2002, 2003, 2004, 2005, 2006, 2007,
            2008, 2009, 2010, 2011, 2012, 2013, 2014, 2015, 2016, 2017],
           dtype='int64', name='release_year')
Ti interessa la colonna user_rating_score, che contiene la valutazione mediana per ogni anno. Puoi estrarre la colonna user_rating_score di df_med_by_year e tracciarla in funzione dell'anno (dato dall'indice del DataFrame df_rat_by_year):
# Slice out user rating and plot
df_rat_by_year = df_med_by_year['user_rating_score']
plt.scatter(df_rat_by_year.index, df_rat_by_year)
plt.xlabel('year of release')
plt.ylabel('median rating');
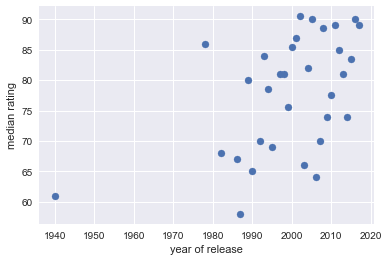
Guardando il grafico, la valutazione mediana aumenta decisamente nel tempo. Servirebbero statistiche più sofisticate per convincermi della tendenza in generale, ma questo è un esempio di Exploratory Data Analysis come ottimo punto di partenza per ulteriori approfondimenti.
Gli oggetti groupby non sono intuitivi. Corrispondono però all'azione naturale di suddividere un dataset rispetto a una sua colonna (o più di una, ma lasciamo questo a un altro post su come raggruppare per più colonne e sugli indici gerarchici).
Il principio split-apply-combine non è solo elegante e pratico, è qualcosa che i Data Scientist usano ogni giorno, come nell'esempio sopra. Per apprezzarne meglio gli utilizzi, dai un'occhiata all'articolo originale di Hadley Wickham paper The Split-Apply-Combine Strategy for Data Analysis. Se hai pensieri, risposte e/o riflessioni, sentiti libero di contattarmi su Twitter: @hugobowne.
Dai un'occhiata anche agli altri pratici tutorial su pandas di DataCamp, tra cui:
Corsi su pandas
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



