Curso
Manipulação de dados com pandas
4 h
563.9K
A Netflix divulgou recentemente alguns dados de avaliações de usuários. Eu quis responder a uma pergunta direta: os assinantes da Netflix preferem filmes mais antigos ou mais novos?
De forma intuitiva, você quer dividir o conjunto de dados em grupos, um para cada ano, calcular uma estatística de resumo, como média ou mediana, e então ver se essa estatística aumenta ao longo dos anos (depois disso, talvez você queira fazer um teste estatístico).
O melhor é que existe um arcabouço conceitual para fazer e pensar sobre isso, com implementações tanto em Python quanto em R. Esse arcabouço é conhecido como "split-apply-combine" porque nós...
Esse é o arcabouço conceitual para a análise que temos em mãos. Neste post, você vai aprender como fazer isso para responder à pergunta sobre as avaliações da Netflix usando o pacote pandas em Python. Você poderia fazer o mesmo em R usando, por exemplo, o pacote dplyr. Também vou entrar necessariamente nos objetos groupby, que não são os mais intuitivos. O processo de split-apply-combine com objetos groupby é um padrão que todos nós executamos de forma intuitiva, como veremos, mas foi Hadley Wickham quem formalizou o procedimento em 2011 com seu artigo The Split-Apply-Combine Strategy for Data Analysis.
Se você achar essa técnica útil, pode aprender mais sobre ela (entre muitas outras coisas) e praticá-la no nosso curso Manipulating DataFrames with pandas.
Aqui você vai usar pandas, objetos groupby e os princípios de split-apply-combine para investigar como as avaliações de filmes da Netflix variam em função do ano de lançamento. Eu encontrei os dados originalmente no data.world neste link. Você encontra todo o código deste post aqui caso queira reproduzir.
Primeiro, importe os pacotes necessários e os dados e visualize as cinco primeiras linhas:
# Import packages and set visualization style
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
sns.set()
%matplotlib inline
# Import data and check out head of DataFrame
df = pd.read_csv('data/chasewillden-netflix-shows/data/netflix.csv')
df.head()
| title | rating | ratinglevel | ratingdescription | release_year | user_rating_score | user_rating_size | |
|---|---|---|---|---|---|---|---|
| 0 | White Chicks | PG-13 | crude and sexual humor, language and some drug... | 80 | 2004 | 82.0 | 80 |
| 1 | Lucky Number Slevin | R | strong violence, sexual content and adult lang... | 100 | 2006 | NaN | 82 |
| 2 | Grey's Anatomy | TV-14 | Parents strongly cautioned. May be unsuitable ... | 90 | 2016 | 98.0 | 80 |
| 3 | Prison Break | TV-14 | Parents strongly cautioned. May be unsuitable ... | 90 | 2008 | 98.0 | 80 |
| 4 | How I Met Your Mother | TV-PG | Parental guidance suggested. May not be suitab... | 70 | 2014 | 94.0 | 80 |
Parece bem legal: você tem títulos, classificação indicativa, ano de lançamento e a nota dos usuários, entre várias outras colunas. Antes de executar o groupby e o procedimento split-apply-combine, vamos olhar os dados com um pouco mais de atenção para garantir que são o que pensamos e para tratar valores ausentes. Note que há um valor ausente NaN em user_rating_score da segunda linha (linha 1).
O método .info() do DataFrame do pandas é valioso. Aplicando-o abaixo, vemos que há 1000 linhas e 7 colunas, mas também que a coluna de interesse, user_rating_score, tem apenas 605 valores não nulos. Isso quer dizer que existem 395 valores ausentes:
# Check out info of DataFrame
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 1000 entries, 0 to 999
Data columns (total 7 columns):
title                1000 non-null object
rating               1000 non-null object
ratinglevel          941 non-null object
ratingdescription    1000 non-null int64
release_year         1000 non-null int64
user_rating_score    605 non-null float64
user_rating_size     1000 non-null int64
dtypes: float64(1), int64(3), object(3)
memory usage: 54.8+ KB
Você pode remover as linhas que tenham qualquer valor ausente, eliminar linhas duplicadas e construir um pairplot do DataFrame usando o seaborn para ter uma visão geral visual dos dados. Vamos colorir pelos valores da coluna 'rating'. Confira os gráficos e veja que insights consegue tirar.
# Drop rows with missing values and drop duplicate
df.dropna(inplace=True)
df.drop_duplicates(inplace=True)

# Visualize pairplot of df
sns.pairplot(df, hue='rating');

Observe, por exemplo, user_rating_score em função de release_year. Não há uma tendência visual clara, mas talvez uma análise mais aprofundada revele algum padrão. Se quiser ver várias estatísticas descritivas do DataFrame, use o método .describe():
# Get summary stats of df
df.describe()
| ratingdescription | release_year | user_rating_score | user_rating_size | |
|---|---|---|---|---|
| count | 246.000000 | 246.000000 | 246.000000 | 246.0 |
| mean | 73.556911 | 2010.272358 | 81.390244 | 80.0 |
| std | 26.616145 | 8.887219 | 12.677883 | 0.0 |
| min | 10.000000 | 1940.000000 | 55.000000 | 80.0 |
| 25% | 60.000000 | 2007.000000 | 71.000000 | 80.0 |
| 50% | 80.000000 | 2015.000000 | 83.500000 | 80.0 |
| 75% | 90.000000 | 2016.000000 | 92.750000 | 80.0 |
| max | 124.000000 | 2017.000000 | 99.000000 | 80.0 |
Agora que você já deu uma olhada nos dados, é hora da parte divertida. Primeiro, vamos usar groupby para dividir os dados em grupos, em que cada grupo é o conjunto de filmes lançados em um determinado ano. Esse é o split do split-apply-combine:
# Group by year
df_by_year = df.groupby('release_year')
Isso cria um objeto groupby:
# Check type of GroupBy object
type(df_by_year)
pandas.core.groupby.DataFrameGroupByObjetos groupby são muito úteis. Lembra que o método .describe() de um DataFrame retorna estatísticas descritivas para colunas numéricas? Pois bem, o .describe() em objetos DataFrameGroupBy retorna estatísticas para cada coluna numérica, mas calculadas para cada grupo do split. No seu caso, para cada release_year. Esse é um exemplo do apply no split-apply-combine: você está aplicando o .describe() a cada grupo do groupby. Faça isso e imprima as 5 primeiras linhas do resultado:
# Summary stats over years
df_by_year.describe().head()
| ratingdescription | user_rating_score | user_rating_size | |||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| count | mean | std | min | 25% | 50% | 75% | max | count | mean | ... | 75% | max | count | mean | std | min | 25% | 50% | 75% | max | |
| release_year | |||||||||||||||||||||
| 1940 | 1.0 | 35.0 | NaN | 35.0 | 35.0 | 35.0 | 35.0 | 35.0 | 1.0 | 61.0 | ... | 61.0 | 61.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1978 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 86.0 | ... | 86.0 | 86.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1982 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 68.0 | ... | 68.0 | 68.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1986 | 1.0 | 35.0 | NaN | 35.0 | 35.0 | 35.0 | 35.0 | 35.0 | 1.0 | 67.0 | ... | 67.0 | 67.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1987 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 58.0 | ... | 58.0 | 58.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
5 rows × 24 columns
Se quiser ver como ficou o agrupamento, você pode passar o objeto groupby para a função list():
# Cast grouping as a list and check out one year
list(df_by_year)[10]
(1995,             title rating                                ratinglevel  \
 766         Balto      G  General Audiences. Suitable for all ages.
 967  Heavyweights     PG              some rude language and pranks

      ratingdescription  release_year  user_rating_score  user_rating_size
 766                 35          1995               64.0                80
967 60 1995 74.0 80 )Digamos que você queira a média ou a mediana de user_rating_score para cada ano. Você pode aplicar os métodos .mean() ou .median(), respectivamente, ao objeto groupby e "combinar" tudo em um novo DataFrame.
# Get median values by year and print first 5 rows
df_med_by_year = df_by_year.median()
df_med_by_year.head()| ratingdescription | user_rating_score | user_rating_size | |
|---|---|---|---|
| release_year | |||
| 1940 | 35.0 | 61.0 | 80.0 |
| 1978 | 60.0 | 86.0 | 80.0 |
| 1982 | 60.0 | 68.0 | 80.0 |
| 1986 | 35.0 | 67.0 | 80.0 |
| 1987 | 60.0 | 58.0 | 80.0 |
Há uma sutileza importante sobre o índice do DataFrame df_med_by_year. Lembre que o índice de um DataFrame consiste nos rótulos das linhas. Veja o índice do DataFrame original df:
# Print index of df
print(df.index)
Int64Index([  0,   2,   3,   4,   5,   6,   7,   8,   9,  10,
            ...
            908, 911, 917, 931, 962, 966, 967, 972, 973, 979],
           dtype='int64', length=246)
Esse índice é composto pelos números das linhas originais, rotulados por inteiros. O '1' está faltando porque você removeu algumas linhas acima. Já o índice de df_med_by_year é composto pelos valores da coluna original pela qual você agrupou, os anos de release_year:
# Print index
print(df_med_by_year.index)
Int64Index([1940, 1978, 1982, 1986, 1987, 1989, 1990, 1992, 1993, 1994, 1995,
            1997, 1998, 1999, 2000, 2001, 2002, 2003, 2004, 2005, 2006, 2007,
            2008, 2009, 2010, 2011, 2012, 2013, 2014, 2015, 2016, 2017],
           dtype='int64', name='release_year')
O seu interesse é a coluna user_rating_score, que contém a mediana das notas por ano. Você pode fatiar a coluna user_rating_score de df_med_by_year e plotá-la em função do ano (dado pelo índice do DataFrame df_rat_by_year):
# Slice out user rating and plot
df_rat_by_year = df_med_by_year['user_rating_score']
plt.scatter(df_rat_by_year.index, df_rat_by_year)
plt.xlabel('year of release')
plt.ylabel('median rating');
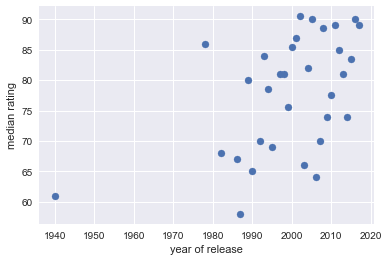
Olhando o gráfico, a mediana das notas claramente aumenta ao longo do tempo. Seria preciso aplicar estatísticas mais robustas para me convencer da tendência de forma geral, mas este é um exemplo de como a análise exploratória de dados é um ótimo ponto de partida para pesquisas mais profundas.
Objetos groupby não são intuitivos. Eles, no entanto, correspondem ao ato natural de dividir um conjunto de dados com respeito a uma de suas colunas (ou mais de uma, mas vamos deixar isso para outro post sobre agrupamento por múltiplas colunas e índices hierárquicos).
O princípio split-apply-combine não é apenas elegante e prático: é algo que cientistas de dados usam diariamente, como no exemplo acima. Para conhecer mais aplicações, confira o artigo original do Hadley Wickham aqui, The Split-Apply-Combine Strategy for Data Analysis. Se quiser trocar ideias, respostas e/ou reflexões, fale comigo no Twitter: @hugobowne.
Confira também outros tutoriais úteis de pandas no DataCamp, incluindo:
Cursos de pandas
Curso
Curso
Curso
Tutorial
DataCamp Team
13 min
Tutorial
Karlijn Willems
15 min
Tutorial
Vidhi Chugh
15 min
Tutorial
DataCamp Team
7 min
Tutorial
Allan Ouko
11 min
Tutorial
Kevin Babitz
8 min






