Cours
Manipulation de données avec pandas
4 h
564K
Netflix a récemment publié des données d'évaluation des utilisateurs. Je me suis posé une question simple : les abonnés Netflix préfèrent-ils les films anciens ou récents ?
Intuitivement, vous voulez scinder le jeu de données en groupes, un par année, puis calculer une statistique synthétique, comme la moyenne ou la médiane, et observer si cette statistique augmente au fil des années (vous pourrez ensuite réaliser un test statistique).
La bonne nouvelle, c'est qu'il existe un cadre conceptuel pour faire et penser cela, avec des implémentations en Python comme en R. Ce cadre est connu sous le nom de « split-apply-combine » (scinder–appliquer–combiner) car nous…
Voici donc le cadre conceptuel pour l'analyse qui nous intéresse. Dans cet article, vous apprendrez à l'appliquer pour répondre à la question des notes Netflix ci-dessus à l'aide du paquet Python pandas. Vous pourriez faire la même chose en R avec, par exemple, le paquet dplyr. J'aborderai aussi les objets groupby, qui ne sont pas les plus intuitifs. Le processus split-apply-combine avec des objets groupby correspond à un schéma que nous suivons tous instinctivement, comme nous le verrons, mais il a fallu Hadley Wickham pour formaliser la procédure en 2011 dans son article The Split-Apply-Combine Strategy for Data Analysis.
Si vous trouvez cette technique utile, vous pouvez en apprendre davantage (entre autres) et vous entraîner dans notre cours Manipulating DataFrames with pandas.
Ici, vous utiliserez pandas, les objets groupby et les principes du split-apply-combine pour analyser l'évolution des notes des films Netflix en fonction de leur année de sortie. J'ai initialement trouvé les données sur data.world ici. Vous pouvez retrouver tout le code de ce billet ici si vous souhaitez le reproduire.
Commencez par importer les packages nécessaires et les données, puis affichez les cinq premières lignes :
# Import packages and set visualization style
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
sns.set()
%matplotlib inline
# Import data and check out head of DataFrame
df = pd.read_csv('data/chasewillden-netflix-shows/data/netflix.csv')
df.head()
| title | rating | ratinglevel | ratingdescription | release_year | user_rating_score | user_rating_size | |
|---|---|---|---|---|---|---|---|
| 0 | White Chicks | PG-13 | crude and sexual humor, language and some drug... | 80 | 2004 | 82.0 | 80 |
| 1 | Lucky Number Slevin | R | strong violence, sexual content and adult lang... | 100 | 2006 | NaN | 82 |
| 2 | Grey's Anatomy | TV-14 | Parents strongly cautioned. May be unsuitable ... | 90 | 2016 | 98.0 | 80 |
| 3 | Prison Break | TV-14 | Parents strongly cautioned. May be unsuitable ... | 90 | 2008 | 98.0 | 80 |
| 4 | How I Met Your Mother | TV-PG | Parental guidance suggested. May not be suitab... | 70 | 2014 | 94.0 | 80 |
Plutôt prometteur : vous avez les titres, les classifications, l'année de sortie et la note des utilisateurs, entre autres colonnes. Avant d'exécuter notre groupby et le split-apply-combine, examinons un peu plus finement les données pour valider nos hypothèses et traiter les valeurs manquantes. Notez qu'il y a une valeur manquante (NaN) dans user_rating_score de la deuxième ligne (ligne 1).
La méthode .info() d'un DataFrame pandas est précieuse. Son application ci-dessous montre que vous avez 1000 lignes et 7 colonnes, mais aussi que la colonne qui nous intéresse, user_rating_score, ne compte que 605 valeurs non nulles. Autrement dit, 395 valeurs manquent :
# Check out info of DataFrame
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 1000 entries, 0 to 999
Data columns (total 7 columns):
title                1000 non-null object
rating               1000 non-null object
ratinglevel          941 non-null object
ratingdescription    1000 non-null int64
release_year         1000 non-null int64
user_rating_score    605 non-null float64
user_rating_size     1000 non-null int64
dtypes: float64(1), int64(3), object(3)
memory usage: 54.8+ KB
Vous pouvez supprimer les lignes comportant des valeurs manquantes, retirer les doublons et tracer un pairplot du DataFrame avec seaborn pour avoir un aperçu visuel. Nous colorerons les points selon la colonne « rating ». Consultez les graphiques et voyez quelles informations vous en tirez.
# Drop rows with missing values and drop duplicate
df.dropna(inplace=True)
df.drop_duplicates(inplace=True)

# Visualize pairplot of df
sns.pairplot(df, hue='rating');

Regardez, par exemple, user_rating_score en fonction de release_year. On n'observe pas de tendance flagrante à l'œil nu, mais une analyse plus poussée mettra peut-être en évidence un signal. Pour consulter plusieurs statistiques descriptives du DataFrame, utilisez aussi la méthode .describe() :
# Get summary stats of df
df.describe()
| ratingdescription | release_year | user_rating_score | user_rating_size | |
|---|---|---|---|---|
| count | 246.000000 | 246.000000 | 246.000000 | 246.0 |
| mean | 73.556911 | 2010.272358 | 81.390244 | 80.0 |
| std | 26.616145 | 8.887219 | 12.677883 | 0.0 |
| min | 10.000000 | 1940.000000 | 55.000000 | 80.0 |
| 25% | 60.000000 | 2007.000000 | 71.000000 | 80.0 |
| 50% | 80.000000 | 2015.000000 | 83.500000 | 80.0 |
| 75% | 90.000000 | 2016.000000 | 92.750000 | 80.0 |
| max | 124.000000 | 2017.000000 | 99.000000 | 80.0 |
Maintenant que vous avez exploré les données, passons au concret. Vous allez d'abord utiliser groupby pour scinder les données en groupes, chaque groupe étant l'ensemble des films sortis une année donnée. C'est la partie split de split-apply-combine :
# Group by year
df_by_year = df.groupby('release_year')
Vous obtenez ainsi un objet groupby :
# Check type of GroupBy object
type(df_by_year)
pandas.core.groupby.DataFrameGroupByCes objets groupby sont très utiles. Rappelez-vous que la méthode .describe() d'un DataFrame renvoie des statistiques descriptives pour les colonnes numériques ? Eh bien, la méthode .describe() appliquée à un objet DataFrameGroupBy renvoie ces mêmes statistiques pour chaque groupe après la scission. Dans votre cas, c'est pour chaque release_year. C'est un exemple de la partie apply : vous appliquez la méthode .describe() à chaque groupe du groupby. Faites-le et affichez les 5 premières lignes du résultat :
# Summary stats over years
df_by_year.describe().head()
| ratingdescription | user_rating_score | user_rating_size | |||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| count | mean | std | min | 25% | 50% | 75% | max | count | mean | ... | 75% | max | count | mean | std | min | 25% | 50% | 75% | max | |
| release_year | |||||||||||||||||||||
| 1940 | 1.0 | 35.0 | NaN | 35.0 | 35.0 | 35.0 | 35.0 | 35.0 | 1.0 | 61.0 | ... | 61.0 | 61.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1978 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 86.0 | ... | 86.0 | 86.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1982 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 68.0 | ... | 68.0 | 68.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1986 | 1.0 | 35.0 | NaN | 35.0 | 35.0 | 35.0 | 35.0 | 35.0 | 1.0 | 67.0 | ... | 67.0 | 67.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
| 1987 | 1.0 | 60.0 | NaN | 60.0 | 60.0 | 60.0 | 60.0 | 60.0 | 1.0 | 58.0 | ... | 58.0 | 58.0 | 1.0 | 80.0 | NaN | 80.0 | 80.0 | 80.0 | 80.0 | 80.0 |
5 rows × 24 columns
Si vous souhaitez visualiser la structure du regroupement, vous pouvez passer l'objet groupby à la fonction list() :
# Cast grouping as a list and check out one year
list(df_by_year)[10]
(1995,             title rating                                ratinglevel  \
 766         Balto      G  General Audiences. Suitable for all ages.
 967  Heavyweights     PG              some rude language and pranks

      ratingdescription  release_year  user_rating_score  user_rating_size
 766                 35          1995               64.0                80
967 60 1995 74.0 80 )Supposons que vous vouliez la moyenne ou la médiane de user_rating_score pour chaque année. Vous pouvez alors appliquer respectivement les méthodes .mean() ou .median() à l'objet groupby et « combiner » ces résultats dans un nouveau DataFrame.
# Get median values by year and print first 5 rows
df_med_by_year = df_by_year.median()
df_med_by_year.head()| ratingdescription | user_rating_score | user_rating_size | |
|---|---|---|---|
| release_year | |||
| 1940 | 35.0 | 61.0 | 80.0 |
| 1978 | 60.0 | 86.0 | 80.0 |
| 1982 | 60.0 | 68.0 | 80.0 |
| 1986 | 35.0 | 67.0 | 80.0 |
| 1987 | 60.0 | 58.0 | 80.0 |
Il y a une subtilité importante concernant l'index du DataFrame df_med_by_year. Rappelez-vous que l'index d'un DataFrame correspond aux étiquettes de lignes. Regardez l'index du DataFrame d'origine df :
# Print index of df
print(df.index)
Int64Index([  0,   2,   3,   4,   5,   6,   7,   8,   9,  10,
            ...
            908, 911, 917, 931, 962, 966, 967, 972, 973, 979],
           dtype='int64', length=246)
Cet index correspond aux numéros de lignes d'origine, étiquetés par des entiers. Le « 1 » manque car vous avez supprimé des lignes plus haut. L'index de df_med_by_year, lui, correspond aux valeurs de la colonne d'origine utilisée pour le regroupement, c'est-à-dire les années de release_year :
# Print index
print(df_med_by_year.index)
Int64Index([1940, 1978, 1982, 1986, 1987, 1989, 1990, 1992, 1993, 1994, 1995,
            1997, 1998, 1999, 2000, 2001, 2002, 2003, 2004, 2005, 2006, 2007,
            2008, 2009, 2010, 2011, 2012, 2013, 2014, 2015, 2016, 2017],
           dtype='int64', name='release_year')
Vous vous intéressez à la colonne user_rating_score, qui contient la médiane des notes pour chaque année. Vous pouvez extraire cette colonne de df_med_by_year et la représenter en fonction de l'année (donnée par l'index du DataFrame df_rat_by_year) :
# Slice out user rating and plot
df_rat_by_year = df_med_by_year['user_rating_score']
plt.scatter(df_rat_by_year.index, df_rat_by_year)
plt.xlabel('year of release')
plt.ylabel('median rating');
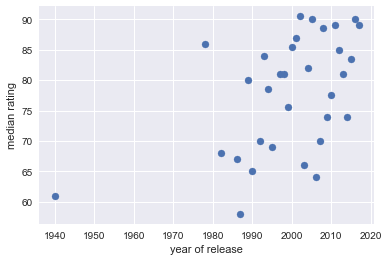
À la lecture du graphique, la médiane des notes augmente clairement avec le temps. Il faudrait des méthodes statistiques plus poussées pour démontrer la tendance de façon générale, mais c'est un bel exemple où l'analyse exploratoire sert de tremplin à des investigations plus approfondies.
Les objets groupby ne sont pas intuitifs. Ils reflètent toutefois un geste naturel : scinder un jeu de données selon l'une de ses colonnes (ou plusieurs, mais gardons cela pour un autre article sur le regroupement par plusieurs colonnes et les index hiérarchiques).
Le principe split-apply-combine est à la fois élégant et pratique, et il fait partie du quotidien des Data Scientists, comme dans l'exemple ci-dessus. Pour en apprécier toutes les facettes, consultez l'article original de Hadley Wickham ici, The Split-Apply-Combine Strategy for Data Analysis. Si vous avez des idées, réactions et/ou réflexions, n'hésitez pas à me contacter sur Twitter : @hugobowne.
Découvrez d'autres tutoriels pratiques sur pandas de DataCamp, notamment :
Cours pandas
Cours
Cours
Cours