

要在本教程中轻松运行所有示例代码,您可以免费创建一个 DataLab 工作簿,其中已预装 R,并包含所有代码示例。若想进一步练习如何将数据导入 R,请查看这个 DataCamp 动手练习。
开始在 R 中导入数据
R 是一款多功能的统计工具。与 Microsoft Excel 等其他软件相比,R 提供更快的数据加载、自动化的数据清洗,以及深入的统计与预测分析。这一切都依赖开源的 R 包来完成,我们将学习如何使用它们导入各种类型的数据集。
我们将使用 DataLab 运行代码示例。它预装了所需的包和 R 环境,您无需任何配置即可在数秒内开始编码。它是免费服务,并提供大量数据集可供使用。
如果您更喜欢本地工作,请参阅我们的指南:如何在 Windows、Mac 和 Ubuntu 上安装 R。
安装必要的包
加载 DataLab 工作簿后,您需要安装一些不算常见但用于加载 SAS、SPSS、Stata 和 Matlab 文件所必需的包。
Tidyverse 包集包含多个用于读取平面文件、清洗数据、进行数据处理与可视化等工作的包。
我们可以使用 install.packages() 函数逐个安装包。
install.packages('tidyverse',dependency=T)也可以在 c() 函数中写入多个包名一次性安装。安装完成后,使用 library() 将它们加载到本地环境。在此示例中,我用 suppressPackageStartupMessages() 包裹 library(),以获得更简短的输出。
install.packages(c('quantmod','ff','foreign','R.matlab'),dependency=T)suppressPackageStartupMessages(library(tidyverse))您会注意到,我在 install.packages() 函数中通过 dependency=T 参数确保安装依赖项。
要点速览
-
CSV 用
readr::read_csv(),Excel 用readxl::read_excel();二者都属于 tidyverse -
rjson::fromJSON()处理 JSON,RSQLite与DBI连接 SQL 数据库 -
haven可读取 SAS(.sas7bdat)、SPSS(.sav)和 Stata(.dta)文件 -
xml2与rvest用于解析 XML 和抓取网页中的 HTML 表格 -
对于大型文件(1 GB+),
data.table::fread()是最快的选择
从常用数据类型在 R 中导入数据
本教程涵盖在 R 中常用的 CSV、TXT、Excel、JSON、数据库以及 XML/HTML 数据文件。同时也将介绍较少使用的 SAS、SPSS、Stata、Matlab 和二进制文件格式,以及如何从网页抓取 HTML 表格与 XML 数据。
速查表:按文件类型对应的导入函数
| 文件类型 | 包 | 函数 | 输出 |
|---|---|---|---|
| CSV | readr | read_csv() | tibble |
| CSV | base R | read.csv() | data.frame |
| CSV(大文件) | data.table | fread() | data.table |
| TXT | base R | read.delim() | data.frame |
| Excel | readxl | read_excel() | tibble |
| JSON | rjson | fromJSON() | list |
| SQL | DBI + RSQLite | dbGetQuery() | data.frame |
| XML | xml2 | read_xml() | xml_document |
| HTML 表格 | rvest | html_table() | tibble |
| SAS | haven | read_sas() | tibble |
| SPSS | haven | read_sav() | tibble |
| Stata | haven | read_dta() | tibble |
| Matlab | R.matlab | readMat() | list |
| Parquet | arrow | read_parquet() | tibble |
| 二进制 | base R | readBin() | vector |
从 CSV 和 TXT 文件导入数据到 R
我们先从两种最常见的数据格式开始:CSV 和 TXT。
在 R 中导入 CSV 文件
本节我们将通过加载 Hotel Booking Demand 的 CSV 文件来读取 R 中的数据。该数据集包含一家城市酒店和一家度假酒店的预订数据。导入 CSV 文件时,我们将使用 readr 包的 read_csv() 函数。与 Pandas 类似,您需要提供文件的位置以处理文件并将其加载为数据框。
您也可以使用 utils 包中的 read.csv() 或 read.delim() 函数来加载 CSV 文件。
data1 <- read_csv('data/hotel_bookings_clean.csv',show_col_types = FALSE)
head(data1, 5)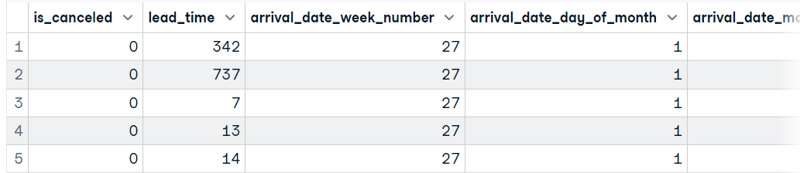
与 read_csv() 类似,您也可以使用 read.table() 函数加载文件。请确保添加逗号作为分隔符,并设置 header = 1。这会将第一行设为列名,而不是 V1、V2 ……
data2 <- read.table('data/hotel_bookings_clean.csv', sep=",", header = 1)
head(data2, 5)在 R 中导入 TXT 文件
本部分我们将使用 Drake Lyrics 数据集来加载一个文本文件。该文件包含歌手 Drake 的歌词。我们可以用 readLines() 加载简单文本文件,但还需要额外步骤将其转换为数据框。
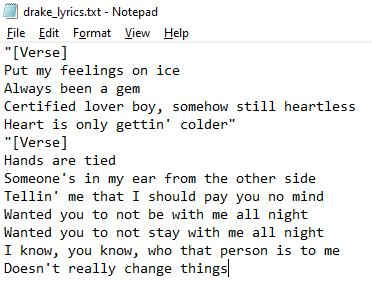
作者供图 | 文本文件
我们将使用 read.table 的替代函数 read.delim(),把文本文件加载为 R 数据框。其他替代函数包括 read.csv、read.csv2 和 read.delim2。
注意:默认以制表符分隔(sep = "\t")
该文本文件由歌词组成,没有表头行。若要将所有歌词显示在一行中,需要设置 header = F。
您还可以使用其他参数自定义数据框,例如 fill 参数,用于在行长不一致时填充空白字段。
阅读 文档以了解 read.table 系列替代函数中的各个参数。
data3 <- read.delim('data/drake_lyrics.txt',header = F)
head(data3, 5)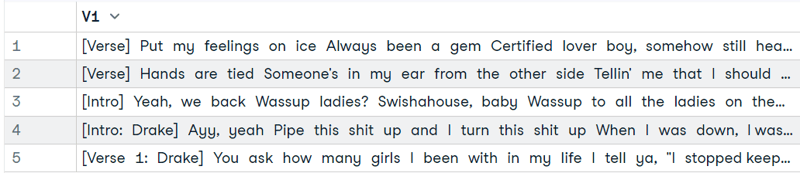
从 Excel 导入数据到 R
本节我们将使用 Kaggle 上的 Tesla Deaths 数据集来演示如何从 Excel 导入 R。该数据集记录了特斯拉车辆导致驾驶员、乘客、骑行者或行人死亡的不幸事故。
数据集包含一个 CSV 文件,我们将使用 MS Excel 将其转换为 Excel 文件,如下所示。
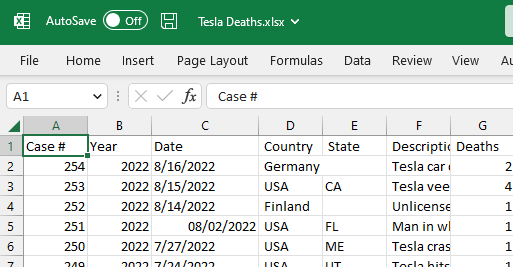
作者供图
我们将使用 readxl 包的 read_excel() 函数读取 Excel 文件中的单个工作表。该包属于 tidyverse,但并非其核心部分,因此使用函数前需要先加载包。
该函数需要数据位置与工作表编号。还可以通过阅读 read_excel 的文档来调整数据框的读取方式。
library(readxl)
data4 <- read_excel("data/Tesla Deaths.xlsx", sheet = 1)
head(data4, 5)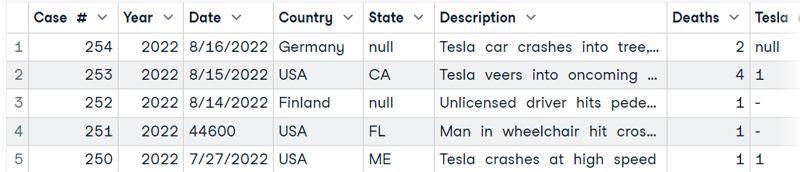
从 JSON 文件导入数据
本部分我们将使用 Drake Lyrics 数据集中的一个文件,将 JSON 加载到 R。它包含歌词、歌曲标题、专辑标题、URL 以及歌曲的浏览量。
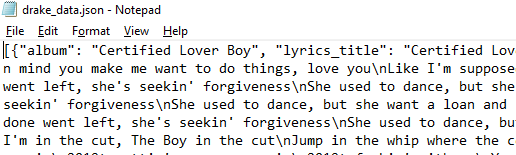
作者供图
要加载 JSON 文件,我们将加载 rjson 包,并使用 fromJSON() 来解析 JSON 文件。
library(rjson)
JsonData <- fromJSON(file = 'data/drake_data.json')
print(JsonData[1])输出:
[[1]]
[[1]]$album
[1] "Certified Lover Boy"
[[1]]$lyrics_title
[1] "Certified Lover Boy* Lyrics"
[[1]]$lyrics_url
[1] "https://genius.com/Drake-certified-lover-boy-lyrics"
[[1]]$lyrics
[1] "Lyrics from CLB Merch\n\n[Verse]\nPut my feelings on ice\nAlways been a gem\nCertified lover boy, somehow still heartless\nHeart is only gettin' colder"
[[1]]$track_views
[1] "8.7K"要将 JSON 数据转换为 R 数据框,我们将使用 base R 的 as.data.frame() 函数。
data5 = as.data.frame(JsonData[1])
data5
在 R 中使用 SQL 从数据库导入数据
本部分我们将使用 Kaggle 的 Mental Health in the Tech Industry 数据集,来通过 R 加载 SQLite 数据库。为了用 SQL 查询从数据库提取数据,我们将使用 DBI 包和 SQLite 函数创建连接。您也可以用类似语法从其他 SQL 服务器加载数据。
我们将加载 RSQLite 包,并使用 dbConnect 函数加载数据库。
注意:您可以使用 dbConnect 来加载来自 MySQL、PostgreSQL 等常见 SQL 服务器的数据。
加载数据库后,我们将显示表名。
library(RSQLite)
conn <- dbConnect(RSQLite::SQLite(), "data/mental_health.sqlite")
dbListTables(conn) # 'Answer''Question''Survey'要运行查询并显示结果,我们将使用 dbGetQuery() 函数。只需添加 SQLite 连接对象和 SQL 查询字符串即可。
dbGetQuery(conn, "SELECT * FROM Survey")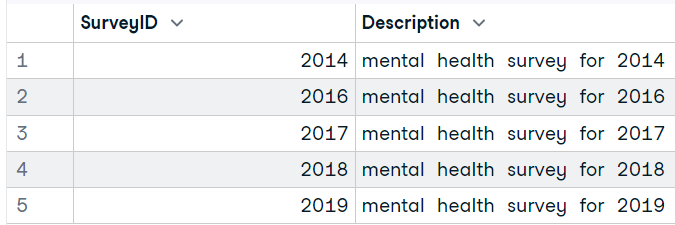
在 R 中使用 SQL 可以让您对数据摄取与分析拥有更强的控制力。
(data6 = dbGetQuery(conn, "SELECT * FROM Question LIMIT 3"))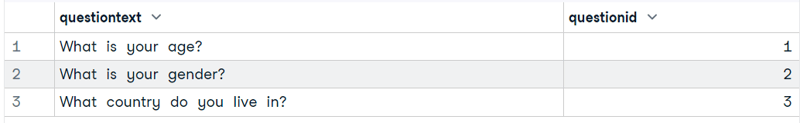
要进一步了解如何在 R 中运行 SQL 查询,请参阅教程《How to Execute SQL Queries in Python and R》。您将学会如何加载数据库,并将 SQL 与 dplyr、ggplot 结合使用。
从 XML 和 HTML 文件导入数据
接下来,我们看看如何从两种最常见的标记语言 XML 和 HTML 导入数据。
将 XML 导入 R
本节我们将使用 xml2 包,从 w3schools 加载 plant_catalog XML 数据。
注意:您也可以使用 XML 包的 xmlTreeParse() 函数加载数据。
就像 read_csv() 一样,我们可以通过提供 XML 站点的 URL 来加载 XML 数据。它会加载页面并解析 XML 数据。
library(xml2)
plant_xml <- read_xml('https://www.w3schools.com/xml/plant_catalog.xml')
plant_xml_parse <- xmlParse(plant_xml)随后,您可以使用 xmlToDataFrame() 函数将 XML 数据转换为 R 数据框。
1. 从 XML 数据中提取节点集合。
-
第一个参数 doc 是
XMLInternalDocument类的对象。 -
第二个参数 path 是要评估的 XPath 表达式字符串。
2. 将 plant_node 传入 xmlToDataFrame() 函数,并显示 R 数据框的前五行。
plant_nodes= getNodeSet(plant_xml_parse, "//PLANT")
data9 <- xmlToDataFrame(nodes=plant_nodes)
head(data9,5)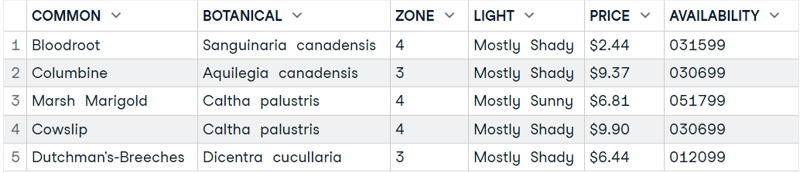
将 HTML 表格导入 R
本节会更有趣:我们将爬取维基百科 阿根廷国家足球队页面,提取 HTML 表格,并用几行代码将其转换为数据框。
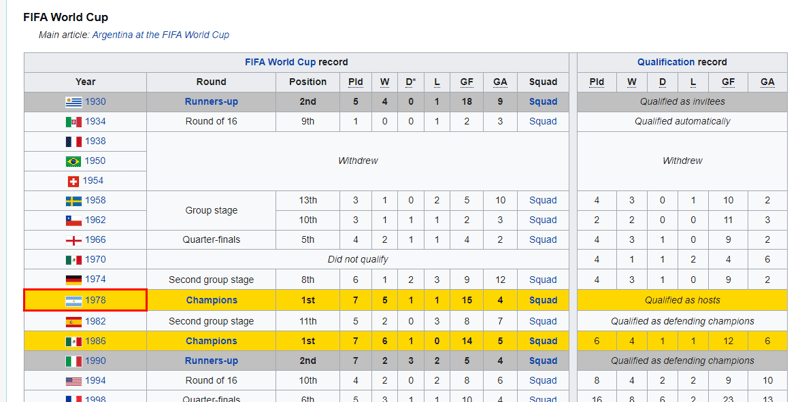
图片来自 Wikipedia
要加载 HTML 表格,我们将使用 XML 和 RCurl 包。我们会将维基百科 URL 提供给 getURL() 函数,然后将返回对象传给 readHTMLTable() 函数,如下所示。
该函数将从网页中提取所有 HTML 表格,我们可以逐个查看,选择需要的那个。
library(XML)
library(RCurl)
url <- getURL("https://en.wikipedia.org/wiki/Brazil_national_football_team")
tables <- readHTMLTable(url)
data7 <- tables[31]
data7$`NULL`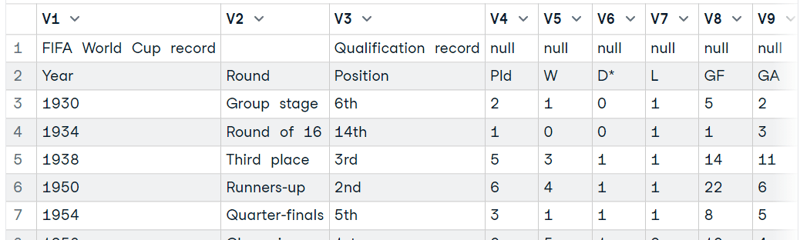
此外,您还可以使用 rvest 包,通过 URL 读取 HTML,提取所有表格,并以数据框形式展示。
-
read_html(URL):从网站提取 HTML 数据。 -
html_nodes(file, "table"):从 HTML 数据中提取表格。 -
html_table(tables[25]):将 HTML 表格转换为数据框。
library(rvest)
url <- "https://en.wikipedia.org/wiki/Argentina_national_football_team"
file <- read_html(url)
tables <- html_nodes(file, "table")
data8 <- html_table(tables[25])
View(data8)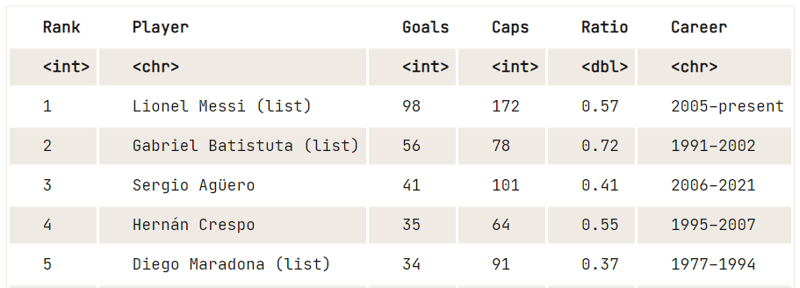
如果您在跟随教程时遇到问题,随时可以查看这份包含本教程全部代码的 DataLab 工作簿。只需复制一份即可开始练习。
从其他数据类型在 R 中导入数据
其他虽然不太常见但同样重要的数据类型包括统计软件、Matlab 和二进制数据。
从 SAS 文件导入数据
本节我们将使用 haven 包导入 SAS 文件。您可以从 GeeksforGeeks 博客下载数据。haven 包可用极少的代码将 SAS、SPSS 和 Stata 文件加载到 R 中。
将文件目录提供给 read_sas() 函数,即可将 .sas7bdat 文件加载为数据框。想了解更多请阅读函数文档。
library(haven)
data10 <- read_sas('data/lond_small.sas7bdat')
# display data
head(data10,5)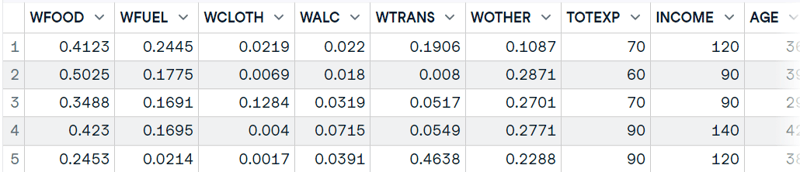
从 SPSS 文件导入数据
如前所述,我们也可以使用 haven 包将 SPSS 文件加载到 R。您可以从 GeeksforGeeks 博客下载数据,并使用 read_sav() 函数加载 SPSS sav 文件。
它需要文件目录字符串,您还可以通过其他参数(如 encoding、col_select、compress)来调整数据框。
library(haven)
data11 <- read_sav("data/airline_passengers.sav")
head(data11,5)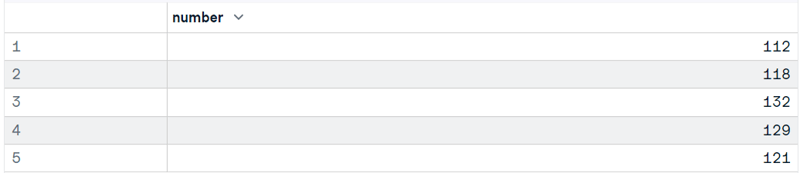
您也可以使用 foreign 包,通过 read.spss() 函数将 .sav 文件加载为数据框。该函数仅需两个参数 file 与 to.data.frame。更多参数请见函数文档。
注意:foreign 包还支持加载 Minitab、S、SAS、SPSS、Stata、Systat、Weka 和 Octave 等文件格式。
library("foreign")
data12 <- read.spss("data/airline_passengers.sav", to.data.frame = TRUE)
head(data12,5)
将 Stata 文件导入 R
本部分我们将使用 foreign 包,从 ucla.edu 加载 Stata 文件。
read.dta 函数可读取 Stata 5 至 12 版本的二进制文件,并将其转换为 R 数据框。
注意:对于 Stata 13 及更高版本,请使用 haven::read_dta()。haven 包支持所有 Stata 版本,并返回 tibble。
library("foreign")
data13 <- read.dta("data/friendly.dta")
head(data13,5)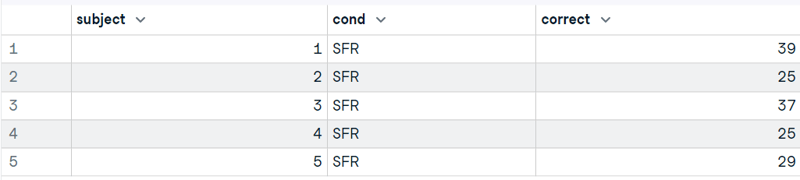
导入 Matlab 文件到 R
MATLAB 在学生与研究人员中非常流行。R.matlab 包允许我们加载 .mat 文件,从而在 R 中进行数据分析与运行模拟。
从 Kaggle 下载 MATLAB 文件自行尝试。
library(R.matlab)
data14 <- readMat("data/cross_dsads.mat")
head(data14$data.dsads)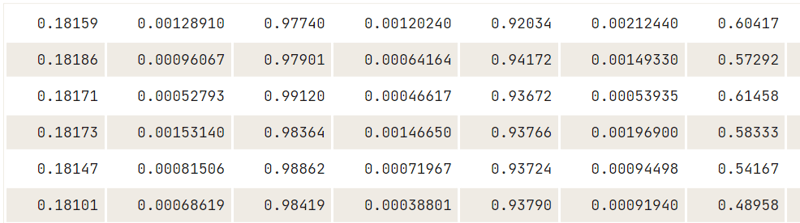
在 R 中导入二进制文件
本部分我们将先创建一个二进制文件,然后使用 readBin() 函数读取该文件。
注意:以下代码示例改编自博文《Working with Binary Files in R Programming》。
首先,我们需要创建一个包含四列四行的数据框。
df = data.frame(
"ID" = c(1, 2, 3, 4),
"Name" = c("Abid", "Matt", "Sara", "Dean"),
"Age" = c(34, 25, 27, 50),
"Pin" = c(234512, 765345, 345678, 098567)
)接着,使用 file() 函数创建一个连接对象。
con = file("data/binary_data.dat", "wb")使用 writeBin() 将列名写入文件。
writeBin(colnames(df), con)将每一列的值写入文件。
writeBin(c(df$ID, df$Name, df$Age, df$Pin), con)写入数据后关闭连接。
close(con)若要读取二进制文件,我们需要先创建与该文件的连接,然后使用 readBin() 以整数形式显示数据。
函数参数说明:
-
conn:连接对象。 -
what:其模式决定所读取向量模式的对象。 -
n:要读取的记录数。
con = file("data/binary_data.dat", "rb")
data15_1 = readBin(con, integer(), n = 25)
print(data15_1)输出:
[1] 1308640329 6647137 6645569 7235920 3276849 3407923
[7] 1684628031 1952533760 1632829556 1140875634 7233893 838874163
[13] 926023733 3159296 892613426 922759729 875771190 875757621
[19] 943142453 892877056您也可以将二进制数据转换为字符串,只需在 what 参数中将 integer() 替换为 character()。
更多内容请阅读 readBin() 的文档。
con = file("data/binary_data.dat", "rb")
data15_2 = readBin(con, character(), n = 25)
print(data15_2)输出:
[1] "ID" "Name" "Age" "Pin" "1" "2" "3" "4"
[9] "Abid" "Matt" "Sara" "Dean" "34" "25" "27" "50"
[17] "234512" "765345" "345678" "98567" 想要学习如何导入平面文件、统计软件文件、数据库数据或直接从网络导入数据,请参加我们的课程Intermediate Importing Data in R。
使用 QuantMod 将数据导入 R
Quantmod 是 R 的金融建模与交易框架。我们将用它来下载并以数据框形式加载最新交易数据。
我们将使用 quantmod 的 getSymbols() 函数,通过提供“from”“to”日期与“frequency”,加载谷歌股票的历史数据。想了解 quantmod 包的更多信息,请阅读其文档。
library(quantmod)
getSymbols("GOOGL",
from = "2022/12/1",
to = "2023/1/15",
periodicity = "daily")
# 'GOOGL'数据被加载到 GOOGL 对象中,我们可以用 head() 函数查看前五行。
head(GOOGL,5)输出:
GOOGL.Open GOOGL.High GOOGL.Low GOOGL.Close GOOGL.Volume
2022-12-01 101.02 102.25 100.25 100.99 28687100
2022-12-02 99.05 100.77 98.90 100.44 21480700
2022-12-05 99.40 101.38 99.00 99.48 24405100
2022-12-06 99.30 99.78 96.42 96.98 24910700
2022-12-07 96.41 96.88 94.72 94.94 31045400
GOOGL.Adjusted
2022-12-01 100.99
2022-12-02 100.44
2022-12-05 99.48
2022-12-06 96.98
2022-12-07 94.94将大型数据集导入 R
导入大型文件颇具挑战。您需要确保所用函数在内存利用与访问速度方面都足够高效。
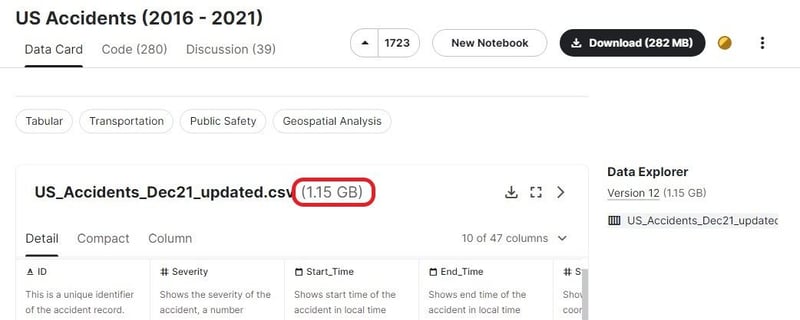
本节我们将查看用于加载 1 GB 以上 CSV 文件的常用函数。我们使用来自 Kaggle 的 US Accidents(2016 - 2021) 数据集,该数据集约 1.15GB,包含 2,845,342 条记录。
使用 read.table() 导入大型数据集
我们可以使用 utils 的 read.table() 函数配合 unz,直接从 zip 文件中读取。这能省去先解压再加载 CSV 的时间。
-
为
unz提供 zip 文件路径和其中的 CSV 文件名。 -
然后将
unz对象传入read.table()。 -
为更快加载,我们将
nrows限制为 10,000。 -
默认以空格分隔,请务必通过
sep参数提供逗号作为分隔符。
file <- unz("data/US Accidents.zip", "US_Accidents_Dec21_updated.csv")
(data16 <- read.table(file, header=T, sep=",",nrow=10000))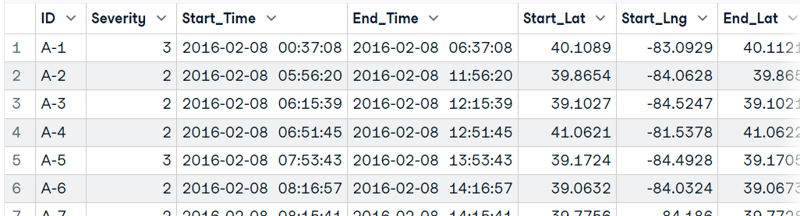
使用 read.csv() 导入大型数据集
与 read.table() 类似,我们可以使用 readr 的 read_csv() 加载 CSV 文件。不同的是,这里用 n_max 来限制读取的记录数。
在我们的示例中,我们不做限制,允许函数加载全部数据。
注意:加载完整数据大约耗时一分钟。您可以通过调整线程数来缩短加载时间。更多内容请参见函数文档。
(data17 <- read_csv('data/US_Accidents_Dec21_updated.csv'))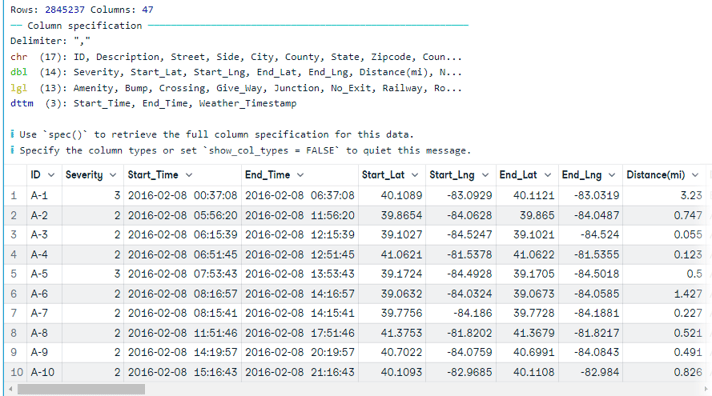
使用 ff 包导入大型数据集
我们也可以使用 ff 包优化加载时间与存储。read.table.ffdf() 函数按块加载数据,从而缩短加载时间。
我们将先解压文件,然后使用 read.table.ffdf() 读取数据。
unzip('data/US Accidents.zip',exdir='data')
library(ff)
data18 <- read.table.ffdf(file="data/US_Accidents_Dec21_updated.csv",
nrows=10000,
header = TRUE,
sep = ',')
data18[1:5,1:25]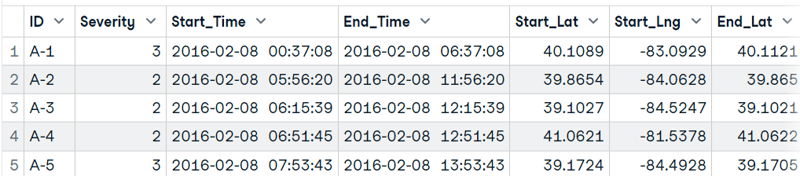
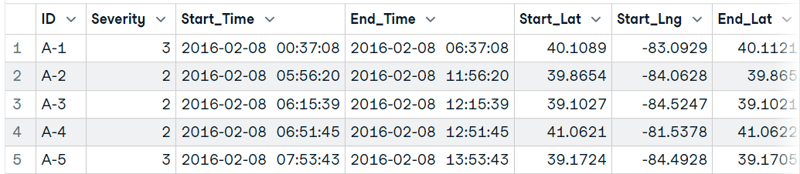
最后,我们来看最常用的 data.table 包中的 fread() 函数,读取前 10,000 行。该函数通常能自动识别文件格式,但在少数情况下需要提供 sep 参数。
若想深入了解 data.table 的语法与操作,请查看我们的data.table R 教程。
library(data.table)
(data19 <- fread("data/US_Accidents_Dec21_updated.csv",
sep=',',
nrows = 10000,
na.strings = c("NA","N/A",""),
stringsAsFactors=FALSE
))
使用 Arrow 导入 Parquet 文件
Parquet 是一种越来越常用于大型分析数据集的列式存储格式。arrow 包可高性能、低内存地将 Parquet 文件读取到 R 中。
library(arrow)
parquet_data <- read_parquet("data/example.parquet")
head(parquet_data, 5)Arrow 还支持从 S3 与 Google Cloud Storage 读取。对于无法全部装入内存的数据集,可使用 open_dataset() 按块处理文件,而无需一次性全部加载。
数据集参考
如果您想自己动手试验示例代码,以下是本教程使用的所有数据集列表。
- CSV:Hotel Booking Demand
- TXT:Drake Lyrics
- Excel:Tesla Deaths
- JSON:Drake Lyrics
- SQL 数据库:Mental Health in the Tech Industry
- XML:w3schools
- HTML:Argentina national football team
- SAS:SAS Files - GeeksforGeeks
- SPSS:SPSS Files - GeeksforGeeks
- Stata:Applied Regression Analysis by Fox Data Files
- Matlab:Cross-position activity recognition | Kaggle
- 大型数据集:US Accidents (2016 - 2021)
结语
R 原生支持广泛的数据格式,从 CSV、Excel 到 SQL 数据库与统计软件文件皆可处理。数据加载完成后,您可以继续参加 Cleaning Data in R 课程进行数据清洗,然后开展探索性分析与可视化。
在本教程中,我们学习了如何使用流行的 R 包以更优的存储与性能来加载各种数据集。如果您想用 R 开启数据科学职业道路,不妨看看我们的 Data Scientist with R 职业路径。它包含 24 门交互式课程,涵盖 R 编程、统计分析、数据处理与预测分析。完成该路径后,您还可以参加认证考试。
另外,别错过这份Import Data Into R DataLab 工作簿,其中包含源码、输出和数据仓库。复制一份,立即开始自学。
在 R 中导入数据的常见问题
常见问题:R 中 read.csv() 与 read_csv() 有何区别?
R 中 read.csv() 与 read_csv() 的主要差异如下:
- 来源:
read.csv()是 base R 函数。read_csv()来自tidyverse中的readr包。
- 性能:
read.csv()对大型数据集较慢、优化较少。read_csv()更快,专为高效读取数据而设计。
- 输出:
read.csv()返回 base R 的数据框(data frame)。read_csv()返回 tibble,与tidyverse工作流更契合。
二者在字符串处理、错误报告与分隔符支持上也存在一些细微但重要的差异。
如何将 Google 表格导入 R?
使用 googlesheets4 包。对于公开表格,先调用 gs4_deauth() 跳过认证,再使用 read_sheet() 并提供 Google 表格的 URL 或表格 ID。对于私有表格,gs4_auth() 将提示您用 Google 帐号登录。通过 install.packages("googlesheets4") 安装该包。
在 R 中读取大型 CSV 的最快方式是什么?
data.table::fread() 是在 R 中读取大型 CSV 文件最快的选项。它会自动检测列分隔符、处理表头,并利用多线程读取。对于 1 GB 以上的文件,fread() 往往比 read.csv() 或 read_csv() 快数倍。若文件为 Parquet 格式,arrow::read_parquet() 在列式数据上更快。
如何将 REST API 的数据导入 R?
使用 httr2 包发起 HTTP 请求,并用 jsonlite::fromJSON() 解析 JSON 响应。典型流程为:resp <- request("https://api.example.com/data") |> req_perform(),然后 data <- resp |> resp_body_json()。对于较旧的 API,也可使用 httr 包的 GET() 与 content(),用法相似。
我可以将 Parquet 文件导入 R 吗?
可以。安装 arrow 包(install.packages("arrow")),并使用 arrow::read_parquet("file.parquet") 加载 Parquet 文件。Arrow 也支持从云存储(S3、GCS)读取,并可通过 open_dataset() 处理超出内存大小的数据集。
将数据加载到 R 中有时会让人挫败。几乎每一种您想导入 R 的文件类型都需要各自的函数,即便如此,您也可能被函数的参数搞糊涂。简言之,无论您是新手还是进阶用户,偶尔出错都很正常。
为满足这些需求,我们整理了一份全面但易上手的 R 数据导入教程,从简单的文本文件到更高级的 SPSS 和 SAS 文件一应俱全。继续阅读,了解如何轻松将您的文件导入 R!