

什么是关系代数?
关系代数是一种过程化查询语言。它告诉数据库如何检索数据,而不仅仅是要什么。
这与 SQL 的声明式特性是关键区别。编写 SQL 查询时,您描述想要的结果;关系代数则描述达到结果的确切操作序列。
它作用于关系(relation)——表的形式化称谓。输入一张或多张关系,应用某个操作,输出仍是一张关系。
最后这一点称为闭包性质。无论应用何种操作——筛选行、选择列、合并表——结果总是另一张关系。这很重要,因为它意味着可以将操作串联起来:一个操作的输出可作为下一个操作的输入,您可以按需层层叠加。
您可以把关系代数理解为“积木”。每个积木取一张(或两张)表,做一件事,然后再给您一张表。数据库引擎在内部使用这些积木来分解并执行您的 SQL 查询。
关系代数的基础概念
在使用关系代数算子之前,您需要了解术语。好消息是只需记住五个。
-
Relation(关系)就是表。它有行和列,表示关于某个实体(如员工或部门)的一组数据。在关系代数中,每个操作都以一张或多张关系为输入,并产出一张关系作为输出。
-
Tuple(元组)是一行。如果
Employees表有 10 行,它就有 10 个元组。每个元组代表一条记录——在此为一名员工。 -
Attribute(属性)是列。
Employees表可能有employee_id、name与department_id等属性。属性定义了每个元组包含的数据类型。 -
Degree(度)是一张关系中的属性数量。若
Employees有五列,则其度为 5。在合并关系时,这一点很重要——某些操作需要度匹配。 -
Cardinality(基数)是一张关系中的元组数量。若
Employees表有 200 行,其基数为 200。基数会随着行的增删而变化;度只在增减列时变化。
这些术语与您已知概念的对应关系如下:
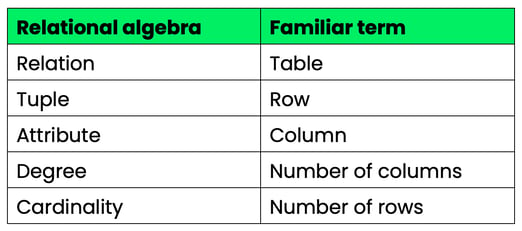
关系代数与常见术语对照
先把这些概念吃透,接下来算子就会一目了然。
DBMS 中的基本关系代数操作
关系代数有五个基本算子。其他所有操作——连接、交、除法——都构建在它们之上。
为保持示例一致,本节将始终使用两张表:
Employees
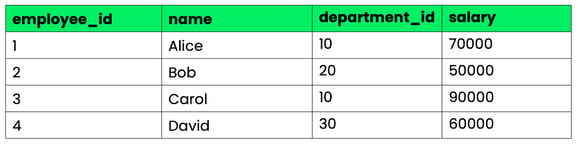
Employees 表
Departments
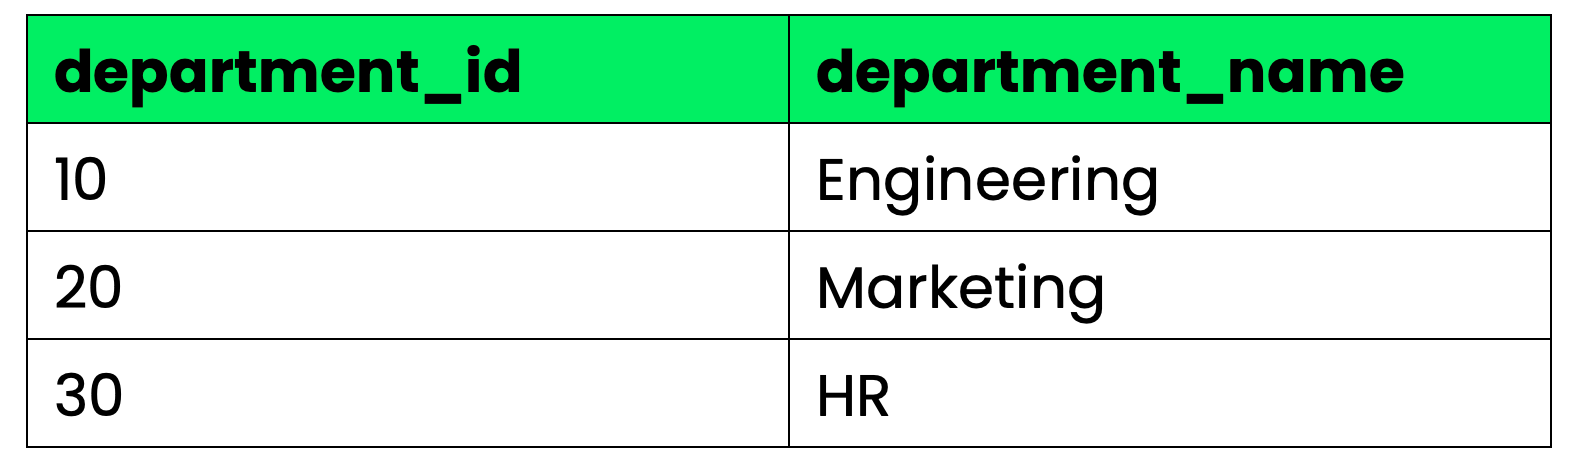
Departments 表
选择(σ)
选择基于条件过滤行。它相当于关系代数中的 WHERE 子句。
记法如下:
σ condition (Relation)例如,您想要所有薪资高于 60,000 的员工:
σ salary > 60000 (Employees)结果是一张仅包含匹配行(如 Alice 和 Carol)的新关系。表结构保持不变,只是移除了不满足条件的行。
对应的 SQL:
SELECT * FROM Employees
WHERE salary > 60000;投影(π)
投影从关系中选择特定列并丢弃其余列。这是将表裁剪为仅保留您关心的属性的方法。
π attribute1, attribute2 (Relation)仅获取所有员工的姓名和薪资:
π name, salary (Employees)需要注意的是,投影会移除结果中的重复行。如果在去掉多余列后两条元组完全相同,输出中只保留一条。
对应的 SQL:
SELECT DISTINCT name, salary
FROM Employees;并(∪)
并将两个关系合并为一个,合并其所有元组,并自动去重。
记法:
Relation1 ∪ Relation2前提是两张关系必须并兼容(union-compatible):属性数量相同且对应属性的数据类型一致。您不能把员工表与部门表做并运算,因为模式不匹配。
假设有一张与 Employees 结构相同的 Contractors 表。并操作会给出两表中所有人,且不含重复:
Employees ∪ Contractors对应的 SQL:
SELECT * FROM Employees
UNION
SELECT * FROM Contractors;差(−)
差返回存在于第一张关系而不在第二张关系中的元组。可理解为“相减”:
Relation1 − Relation2同并操作一样,两张关系必须并兼容。
若要获取所有“不是合同工”的员工,语法如下:
Employees − Contractors结果仅包含 Employees 中在 Contractors 中无对应项的行。
对应的 SQL:
SELECT * FROM Employees
EXCEPT
SELECT * FROM Contractors;笛卡尔积(×)
笛卡尔积将第一张关系的每个元组与第二张关系的每个元组组合。若 Employees 有 4 行、Departments 有 3 行,结果将有 4 × 3 = 12 行。
Employees × Departments单独使用时,结果很少有用——您会得到员工与部门的所有可能组合,包括彼此无关的组合。但笛卡尔积是连接的基础。将其与选择配合,只保留有意义的关联行。
对应的 SQL:
SELECT * FROM Employees, Departments;以上五个算子是地基。关系代数中的其他内容,都是它们组合的简写。
关系代数中的连接操作
连接是关系代数中使用最频繁的操作——而且并不神秘。
每种连接本质上都是“笛卡尔积 + 选择”。先组合两张关系的所有元组,再过滤掉不满足条件的行。之所以有连接这种简写,是因为先做完整笛卡尔积代价高昂;连接在组合过程中就应用条件,缩小了中间结果的规模。
自然连接(⋈)
自然连接会自动在所有同名属性上连接两张关系,并在结果中仅保留这些共享列的一份拷贝:
Employees ⋈ Departments由于两表都包含 department_id,自然连接会在该值相等时匹配并合并行。Alice(department_id = 10)与 Engineering 匹配,Bob 与 Marketing 匹配,依此类推。
无需写条件——连接可由模式推断。这很方便,但也意味着重命名列可能会破坏查询。
对应的 SQL:
SELECT * FROM Employees
NATURAL JOIN Departments;θ 连接(⋈θ)
θ 连接根据您指定的任意条件连接两张关系——条件可使用任意比较运算符:=、≠、<、>、≤、≥。
Employees ⋈ salary > 60000 AND department_id = department_id Departments这给了您对连接条件的完全控制。大多数实际编写的连接在本质上都是 θ 连接。
对应的 SQL:
SELECT * FROM Employees, Departments
WHERE Employees.salary > 60000
AND Employees.department_id = Departments.department_id;等值连接(Equi join)
等值连接是仅使用等号(=)条件的 θ 连接,也是最常见的一类。
Employees ⋈ Employees.department_id = Departments.department_id Departments结果包含两表的所有列,这意味着 department_id 会出现两次。这与自然连接的主要区别在于:等值连接不会移除重复列。
对应的 SQL:
SELECT * FROM Employees
INNER JOIN Departments
ON Employees.department_id = Departments.department_id;外连接
上述连接仅返回两张关系中均有匹配的行。外连接也会保留不匹配的行,并用 NULL 填充缺失值。
共有三种变体:
-
左外连接(⟕)保留左侧关系的所有行。若
Employees中某行没有匹配的部门,它仍会出现在结果中,部门列以NULL填充。 -
右外连接(⟖)保留右侧关系的所有行。没有员工的部门也会出现,员工列以
NULL填充。 -
全外连接(⟗)保留两侧关系的所有行。任一侧的不匹配行都会出现,缺失值以
NULL填充。
对应的 SQL:
-- Left outer join
SELECT * FROM Employees
LEFT JOIN Departments
ON Employees.department_id = Departments.department_id;
-- Right outer join
SELECT * FROM Employees
RIGHT JOIN Departments
ON Employees.department_id = Departments.department_id;
-- Full outer join
SELECT * FROM Employees
FULL OUTER JOIN Departments
ON Employees.department_id = Departments.department_id;当您不能丢失那些“没有匹配项”的行时使用外连接——例如需要完整的员工清单,而不管其部门是否存在于系统中。
关系代数的派生算子
派生算子是由前述五个基本算子组合得到的快捷形式。
交(∩)
交仅返回同时出现在两张关系中的元组。与并与差一样,两张关系必须并兼容。
Employees ∩ Contractors若某人既是员工又是合同工,他会出现在结果中;其他人会被剔除。
在底层,交可以用两次差来表示:
Employees ∩ Contractors = Employees − (Employees − Contractors)对应的 SQL:
SELECT * FROM Employees
INTERSECT
SELECT * FROM Contractors;除法(÷)
除法常让许多 CS 学生与初学者犯难——但概念比看起来简单。
除法回答的问题是:“关系 A 中哪些元组与关系 B 中的所有元组都有关联?”
假设有一张跟踪学生选课的 CourseEnrollments 表,以及一张列出所有必修课的 RequiredCourses 表。除法会给出选修了每一门必修课的学生。
CourseEnrollments ÷ RequiredCourses之所以被认为棘手,是因为 SQL 中没有直接等价物。要在 SQL 中复现除法,需要“双重否定”: “找出不存在‘他未修的必修课’的学生”:
SELECT DISTINCT student_id FROM CourseEnrollments ce1
WHERE NOT EXISTS (
SELECT course_id FROM RequiredCourses rc
WHERE NOT EXISTS (
SELECT * FROM CourseEnrollments ce2
WHERE ce2.student_id = ce1.student_id
AND ce2.course_id = rc.course_id
)
);这个双重 NOT EXISTS 是在 SQL 中表达除法的标准方式。若在面试中遇到“找出与每个 Y 都相关的所有 X”之类问题,除法就是要用的算子。
重命名(ρ)
重命名允许您为关系或其属性赋予新名称。它不改变数据,只改变称谓。
ρ NewName (Relation)或同时重命名关系与其属性:
ρ NewName(attr1, attr2, ...) (Relation)当需要自连接一张表时,重命名非常有用——否则属性名会冲突,操作将失去意义。在串联操作时,它也能让中间结果更具可读性。
对应的 SQL:
SELECT * FROM Employees AS E1;
-- or renaming columns:
SELECT employee_id AS id, name AS employee_name FROM Employees;这三个算子需要记忆。交与重命名相对简单,除法则值得在任何数据库面试前多加练习。
关系代数与 SQL
SQL 与关系代数并不相同——但若无后者,前者也不会存在。
核心区别在于二者对查询的思考方式。关系代数是过程化的——您指定获取结果的确切操作序列。SQL 是声明式的——您描述想要的结果,数据库引擎负责找出实现路径。
看一个简单示例。在关系代数中,获取工程部员工如下所示:
π name, salary (σ department_id = 10 (Employees))您在明确告诉数据库要做什么:先过滤行,再选择列。操作顺序是显式的。
在 SQL 中,您会写:
SELECT name, salary
FROM Employees
WHERE department_id = 10;您在描述想要的结果。数据库引擎会把它翻译为一段操作序列——而这些内部操作正是构建在关系代数之上的。
二者关系即如此:SQL 是面向用户的语言;关系代数是其理论模型。数据库引擎接收 SQL 查询后,会将其解析为基于关系代数的内部表示,进行优化,然后执行。
SQL 也远超关系代数的定义范围。关系代数不涉及:
-
聚合 -
SUM()、COUNT()、AVG() -
分组 -
GROUP BY -
排序 -
ORDER BY -
重复处理 - 关系代数处理集合(无重复);SQL 默认处理多重集(允许重复)
这些功能之所以被加入 SQL,是因为实际查询需要。但它们仍然建立在关系代数的基础之上。
归根结底,理解关系代数能告诉您 SQL 查询在内部是如何构造与转换的。它不会改变您日常写 SQL 的方式,但会改变您对查询实际在做什么的思考方式。
常见错误与困惑
与关系代数相关的大多数困惑,归结为几个反复出现的误解。下面逐一说明。
-
把 SQL 与关系代数当成同一件事。 它们并不相同。SQL 受关系代数启发,但两者不可互换。SQL 是声明式的,并包含聚合与排序等关系代数未定义的功能。关系代数是形式化模型;SQL 是建立其上的实用语言。
-
忽视模式兼容性要求。 并、交与差都要求并兼容的关系——相同的属性数量,且相同顺序上的数据类型一致。将这些算子用于模式不同的表行不通。这点易与无此要求的连接操作混淆。
-
不理解除法算子。 除法没有直接的 SQL 等价,这就是它常让人犯难的原因。若看到“找出与每个 Y 都相关的所有 X”之类查询,那就是除法。SQL 翻译需要使用双重
NOT EXISTS模式——并不直观,因此值得在考试或面试前练习。 -
认为连接是独立的基本算子。 它们不是原语。每个连接都是笛卡尔积与选择的组合。自然连接、θ 连接、等值连接——都是这一组合的简写。理解这一点有助于在结果出乎意料时更易推断其行为。
结语
关系代数是每个关系型数据库系统的理论支柱。您写的每条 SQL 查询,在数据库引擎接触到任何一行数据之前,都会被翻译为一系列关系代数操作。
选择、投影、并、差、笛卡尔积及其派生算子,构成了这种翻译的基石。理解它们如何工作并如何链式组合,您就不再把 SQL 视作黑盒,而能看到其下的结构。
学习关系代数的真正价值在于:理解您的查询实际在做什么,而非用形式化记号去书写它们。

关系代数常见问答
DBMS 中的关系代数是什么?
关系代数是一种形式化查询语言,用于定义在关系型数据库中数据如何被检索与操作。它以关系(表)为操作对象,并在每次操作后产生一个新的关系作为输出。数据库引擎在内部使用它来分解并执行 SQL 查询。
关系代数的基本算子有哪些?
五个基本算子是选择(σ)、投影(π)、并(∪)、差(−)与笛卡尔积(×)。选择用于筛行,投影用于选列,并用于合并两张兼容关系,差用于“减去”元组,笛卡尔积用于组合两张关系的所有元组。其他算子——连接、交、除法——都由这五个算子派生而来。
关系代数与 SQL 有何区别?
关系代数是过程化的——指定检索数据的确切操作序列。SQL 是声明式的——您描述想要的结果,由数据库引擎决定如何实现。SQL 基于关系代数的概念,但也包含聚合、分组、排序等关系代数未定义的功能。
关系代数中的除法算子是什么?
除法回答“关系 A 中哪些元组与关系 B 中的所有元组都有关联?”当需要找出与另一张关系中每一条记录都匹配的记录时使用,例如选修了所有必修课的学生。它没有直接的 SQL 等价,可用双重 NOT EXISTS 模式来复现。
关系代数中的自然连接与等值连接有何区别?
两种连接都使用相等条件匹配行,但对重复列的处理不同。自然连接会自动在所有共享属性名上连接,并从结果中移除重复列。等值连接需要显式条件,并在输出中保留两份连接列。
每当您写下一条
SELECT语句,数据库引擎都会将其翻译为一系列形式化操作。这一翻译过程建立在关系代数之上——它是定义数据如何被查询与操作的数学基础。数据库引擎用它来优化您的查询,面试官也常借此考察您是否具备超越基础的数据库理解。关系代数为您提供了更深层次理解查询工作方式的心智模型。一旦掌握它,SQL 将开始变得“顺理成章”,您也会写出更优化的查询。
本文将带您理解核心概念、基本算子、连接操作,以及关系代数如何映射到您日常编写的 SQL。