
{count, plural, one {Cursus} other {Cursussen}}
Introductie tot relationele databases in SQL
{hours} uur
200.7K
Relationele algebra is een procedurele querytaal. Het vertelt de database hoe je data ophaalt, niet alleen wat je wilt.
Dat is het belangrijkste verschil met SQL, dat declaratief is. Wanneer je een SQL-query schrijft, beschrijf je het resultaat dat je wilt. Relationele algebra beschrijft de exacte reeks operaties om daar te komen.
Het werkt op relaties – de formele term voor tabellen. Je voert één of meer relaties in, past een operatie toe en krijgt een relatie terug als output.
Dat laatste is de sluitingseigenschap. Welke operatie je ook toepast – rijen filteren, kolommen kiezen, tabellen combineren – het resultaat is altijd weer een relatie. Dit is belangrijk omdat je zo operaties kunt ketenen. De output van de ene operatie wordt de input van de volgende, en je kunt ze zo diep stapelen als nodig is.
Je kunt relationele algebra zien als bouwstenen. Elk blok neemt een tabel (of twee), doet er iets mee en geeft je een tabel terug. Database-engines gebruiken deze blokken intern om je SQL-queries op te knippen en uit te voeren.
Voordat je met operatoren van relationele algebra aan de slag gaat, moet je de woordenschat kennen. Het goede nieuws: er zijn maar vijf termen om te onthouden.
Relatie is gewoon een tabel. Die heeft rijen en kolommen en vertegenwoordigt een set gegevens over een specifieke entiteit – zoals medewerkers of afdelingen. In relationele algebra neemt elke operatie één of meer relaties als input en produceert een relatie als output.
Tupel is één rij in die tabel. Als je tabel Employees 10 rijen heeft, heeft die 10 tupels. Elk tupel vertegenwoordigt één record – in dit geval één medewerker.
Attribuut is een kolom. De tabel Employees kan attributen hebben zoals employee_id, name en department_id. Attributen bepalen welk soort data elk tupel bevat.
Graad is het aantal attributen in een relatie. Als Employees vijf kolommen heeft, is de graad 5. Dit speelt een rol bij het combineren van relaties – sommige operaties vereisen overeenkomende graden.
Cardinaliteit is het aantal tupels in een relatie. Als je tabel Employees 200 rijen heeft, is de cardinaliteit 200. Cardinaliteit verandert wanneer je rijen toevoegt of verwijdert; graad verandert alleen wanneer je kolommen toevoegt of verwijdert.
Zo vertalen deze termen zich naar wat je al kent:
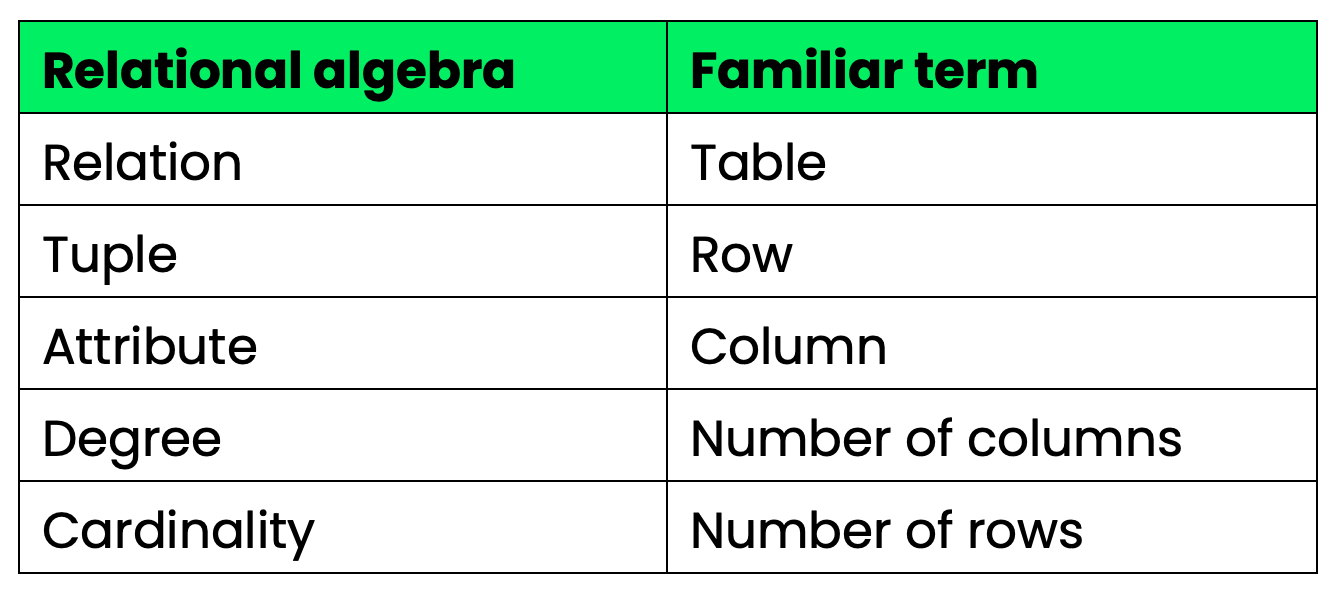
Relationele algebra versus gangbare termen
Zorg dat deze klikken, dan vallen de operatoren vanzelf op hun plek.
Er zijn vijf fundamentele operatoren in relationele algebra. Alle andere operaties – joins, doorsnede, deling – zijn hierop gebouwd.
Om de voorbeelden consistent te houden, gebruik ik in deze sectie twee tabellen:
Employees
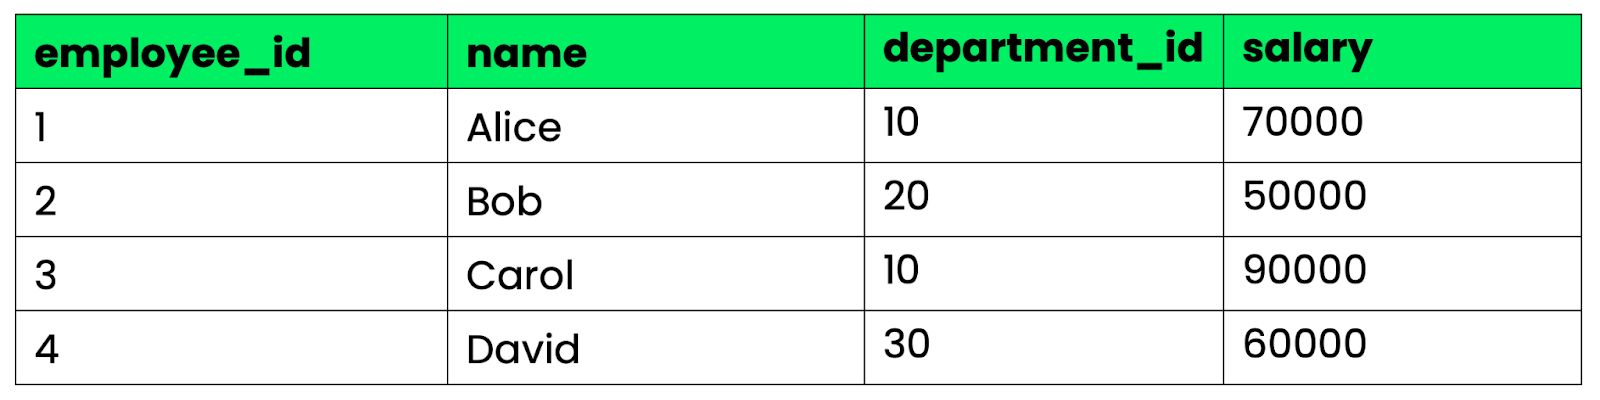
Tabel Employees
Departments
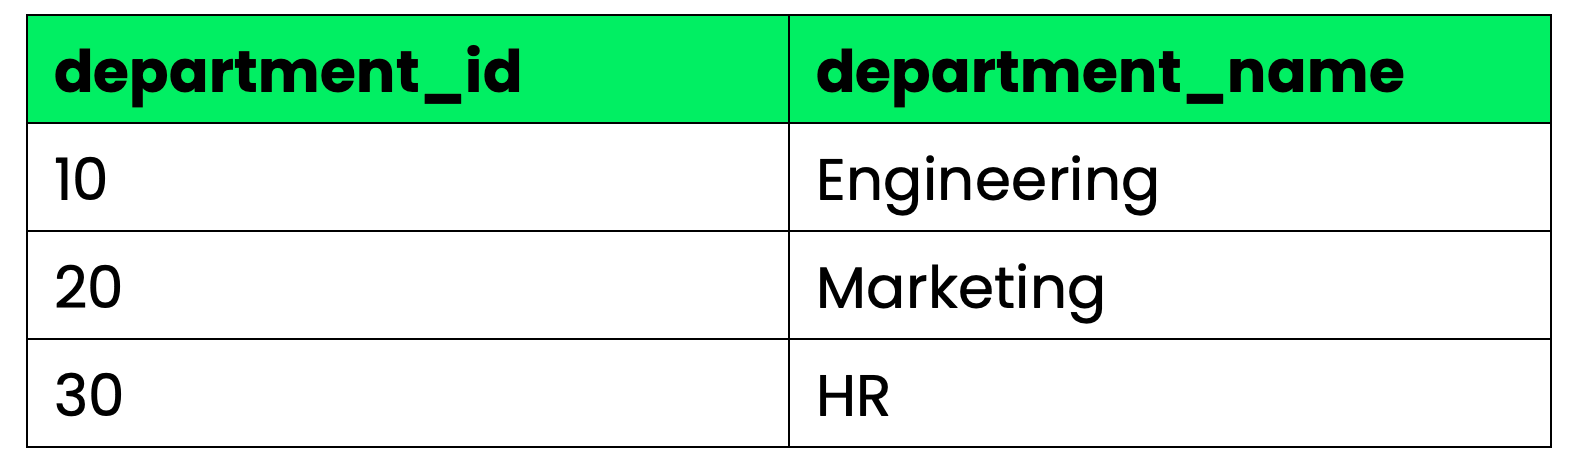
Tabel Departments
Selectie filtert rijen op basis van een conditie. Het is het equivalent van een WHERE-clausule in relationele algebra.
De notatie ziet er zo uit:
σ condition (Relation)Stel dat je alle medewerkers wilt met een salaris boven 60.000:
σ salary > 60000 (Employees)Het resultaat is een nieuwe relatie met alleen de rijen die voldoen – Alice en Carol. De structuur van de tabel blijft gelijk, je verwijdert alleen rijen die niet aan de conditie voldoen.
Dit is het SQL-equivalent:
SELECT * FROM Employees
WHERE salary > 60000;
Projectie selecteert specifieke kolommen uit een relatie en laat de rest weg. Zo snoei je een tabel terug tot alleen de attributen die je nodig hebt.
π attribute1, attribute2 (Relation)Om alleen de namen en salarissen van alle medewerkers te krijgen:
π name, salary (Employees)Let erop dat projectie dubbele rijen uit de output verwijdert. Als twee tupels identiek zijn nadat je extra kolommen hebt laten vallen, komt er maar één kopie in het resultaat.
Dit is het SQL-equivalent:
SELECT DISTINCT name, salary
FROM Employees;
Unie combineert twee relaties tot één en voegt al hun tupels samen. Dubbele rijen worden automatisch verwijderd.
De notatie:
Relation1 ∪ Relation2De voorwaarde is dat beide relaties union-compatibel zijn. Dat betekent dat ze hetzelfde aantal attributen moeten hebben en dat de corresponderende attributen dezelfde datatypen hebben. Je kunt geen employee-tabel met een departments-tabel uniëren, omdat de schema’s niet overeenkomen.
Stel dat je een tabel Contractors hebt met dezelfde structuur als Employees. Unie geeft je iedereen uit beide tabellen, zonder duplicaten:
Employees ∪ ContractorsDit is het SQL-equivalent:
SELECT * FROM Employees
UNION
SELECT * FROM Contractors;Setverschil retourneert de tupels die in de eerste relatie bestaan maar niet in de tweede. Zie het als aftrekken:
Relation1 − Relation2Net als bij unie moeten beide relaties union-compatibel zijn.
Als je alle medewerkers wilt die geen contractors zijn, zou dit de syntax zijn:
Employees − ContractorsHet resultaat bevat alleen de rijen uit Employees die geen match hebben in Contractors.
SQL-equivalent:
SELECT * FROM Employees
EXCEPT
SELECT * FROM Contractors;Een cartesisch product combineert elk tupel uit de eerste relatie met elk tupel uit de tweede. Als Employees 4 rijen heeft en Departments 3 rijen, heeft het resultaat 4 × 3 = 12 rijen.
Employees × DepartmentsOp zichzelf is het resultaat zelden nuttig – je krijgt elke mogelijke combinatie van medewerkers en afdelingen, inclusief combinaties die niets met elkaar te maken hebben. Maar het cartesisch product is de basis van joins. Je koppelt het aan een selectie om alleen de rijen te behouden waar de relatie logisch is.
SQL-equivalent:
SELECT * FROM Employees, Departments;Deze vijf operatoren vormen de basis. Al het andere in relationele algebra is een verkorte notatie voor combinaties hiervan.
Joins zijn de meest gebruikte operaties in relationele algebra – en ze zijn minder mysterieus dan ze lijken.
Elke join is gewoon een cartesisch product gevolgd door een selectie. Je combineert alle tupels van twee relaties en filtert dan de combinaties die niet aan een conditie voldoen. Joins bestaan als verkorte notatie omdat eerst een volledig cartesisch product duur is. Een join past de conditie tijdens het combineren toe, wat de grootte van tussentijdse resultaten beperkt.
Een natuurlijke join voegt twee relaties automatisch samen op alle attributen met dezelfde naam en houdt slechts één kopie van die gedeelde kolommen in het resultaat over:
Employees ⋈ DepartmentsOmdat beide tabellen department_id delen, matcht de natuurlijke join rijen waar die waarde gelijk is en voegt ze samen. Alice (department_id = 10) wordt gekoppeld aan Engineering, Bob aan Marketing, enzovoort.
Je hoeft geen conditie te schrijven – de join leidt die af uit het schema. Dat is handig, maar betekent ook dat het hernoemen van een kolom je query kan breken.
Dit is het SQL-equivalent:
SELECT * FROM Employees
NATURAL JOIN Departments;Een theta-join voegt twee relaties samen op basis van elke conditie die je opgeeft – de conditie kan elke vergelijkingsoperator gebruiken: =, ≠, <, >, ≤, ≥.
Employees ⋈ salary > 60000 AND department_id = department_id DepartmentsDit geeft je volledige controle over de join-conditie. De meeste joins die je in de praktijk schrijft zijn onder de motorkap theta-joins.
Dit is het SQL-equivalent:
SELECT * FROM Employees, Departments
WHERE Employees.salary > 60000
AND Employees.department_id = Departments.department_id;Een equi-join is een theta-join waarbij de conditie alleen gelijkheid (=) gebruikt. Dit is het meest voorkomende type.
Employees ⋈ Employees.department_id = Departments.department_id DepartmentsHet resultaat bevat alle kolommen uit beide tabellen, wat betekent dat department_id twee keer voorkomt. Dat is het belangrijkste verschil met een natuurlijke join – een equi-join verwijdert dubbele kolommen niet.
Dit is het SQL-equivalent:
SELECT * FROM Employees
INNER JOIN Departments
ON Employees.department_id = Departments.department_id;De joins hierboven geven alleen rijen terug waarvoor een match in beide relaties bestaat. Een outer join behoudt ook niet-gematchte rijen en vult NULL in voor ontbrekende waarden.
Er zijn drie varianten:
Left outer join (⟕) behoudt alle rijen uit de linker relatie. Als een rij in Employees geen bijpassende afdeling heeft, verschijnt die nog steeds in het resultaat met NULL in de kolommen van de afdeling.
Right outer join (⟖) behoudt alle rijen uit de rechter relatie. Afdelingen zonder medewerkers verschijnen alsnog, met NULL in de medewerkerskolommen.
Full outer join (⟗) behoudt alle rijen uit beide relaties. Niet-gematchte rijen van beide kanten verschijnen met NULL voor de ontbrekende waarden.
Dit zijn de SQL-equivalenten:
-- Left outer join
SELECT * FROM Employees
LEFT JOIN Departments
ON Employees.department_id = Departments.department_id;

-- Right outer join
SELECT * FROM Employees
RIGHT JOIN Departments
ON Employees.department_id = Departments.department_id;

-- Full outer join
SELECT * FROM Employees
FULL OUTER JOIN Departments
ON Employees.department_id = Departments.department_id;
Gebruik outer joins wanneer je geen rijen wilt verliezen die geen match hebben – bijvoorbeeld als je een volledige lijst met medewerkers nodig hebt, ongeacht of hun afdeling in het systeem bestaat.
Afgeleide operatoren zijn snelkoppelingen die zijn opgebouwd uit de vijf basisoperatoren die we eerder bespraken.
Doorsnede retourneert alleen de tupels die in beide relaties voorkomen. Net als unie en setverschil moeten beide relaties union-compatibel zijn.
Employees ∩ ContractorsAls een medewerker ook contractor is, verschijnt die in het resultaat. Iedereen anders valt af.
Onder de motorkap is doorsnede gewoon twee keer setverschil toepassen:
Employees ∩ Contractors = Employees − (Employees − Contractors)Dit is het SQL-equivalent:
SELECT * FROM Employees
INTERSECT
SELECT * FROM Contractors;
Deling is de operator waar de meeste CS-studenten en juniors over struikelen – maar het concept is eenvoudiger dan het lijkt.
Deling beantwoordt de vraag: "welke tupels in relatie A zijn gekoppeld aan alle tupels in relatie B?"
Stel, je hebt een tabel CourseEnrollments die bijhoudt welke studenten in welke vakken zijn ingeschreven, en een tabel RequiredCourses met alle vakken die een student moet afronden. Deling geeft je de studenten die in alle vereiste vakken zijn ingeschreven.
CourseEnrollments ÷ RequiredCoursesDit wordt als lastig gezien omdat er geen direct SQL-equivalent is. Om deling in SQL te reproduceren, heb je een dubbele negatie nodig – "vind studenten voor wie er geen vereist vak is dat ze niet gevolgd hebben":
SELECT DISTINCT student_id FROM CourseEnrollments ce1
WHERE NOT EXISTS (
    SELECT course_id FROM RequiredCourses rc
    WHERE NOT EXISTS (
        SELECT * FROM CourseEnrollments ce2
        WHERE ce2.student_id = ce1.student_id
        AND ce2.course_id = rc.course_id
    )
);
Dat dubbele NOT EXISTS-patroon is de standaardmanier om deling in SQL uit te drukken. Als je in een interview de vraag ziet "vind alle X die met elke Y gerelateerd zijn", is deling de operator waar je naar grijpt.
Met hernoemen geef je een relatie of zijn attributen een nieuwe naam. De data verandert niet, alleen de benaming.
ρ NewName (Relation)Of om zowel de relatie als de attributen te hernoemen:
ρ NewName(attr1, attr2, ...) (Relation)Hernoemen is handig wanneer je een tabel met zichzelf moet joinen – zonder hernoemen zouden de attributennamen botsen en is de operatie niet logisch. Het is ook nuttig wanneer je operaties ketent en je wilt dat tussentijdse resultaten betekenisvolle namen hebben.
Dit is het SQL-equivalent:
SELECT * FROM Employees AS E1;
-- of kolommen hernoemen:
SELECT employee_id AS id, name AS employee_name FROM Employees;
Deze drie operatoren moet je gewoon kennen. Doorsnede en hernoemen zijn eenvoudig; deling is degene die het waard is om te oefenen vóór een database-interview.
SQL en relationele algebra zijn niet hetzelfde – maar SQL zou zonder dit fundament niet bestaan.
Het kernverschil komt neer op hoe elk naar queries kijkt. Relationele algebra is procedureel – je specificeert de exacte reeks operaties om je resultaat te krijgen. SQL is declaratief – je beschrijft welk resultaat je wilt, en de database-engine bepaalt hoe dat te halen.
Neem een eenvoudig voorbeeld. In relationele algebra ziet het ophalen van medewerkers van Engineering er zo uit:
π name, salary (σ department_id = 10 (Employees))Je vertelt de database precies wat te doen: eerst de rijen filteren, dan de kolommen kiezen. De volgorde van operaties is expliciet.
In SQL schrijf je:
SELECT name, salary
FROM Employees
WHERE department_id = 10;
Je beschrijft het gewenste resultaat. De database-engine vertaalt dat naar een reeks operaties – en die interne operaties zijn gebouwd op relationele algebra.
Dat is de relatie tussen de twee. SQL is de taal voor de gebruiker; relationele algebra is het theoretische model eronder. Wanneer een database-engine een SQL-query ontvangt, parseert die hem naar een interne representatie gebaseerd op relationele algebra, optimaliseert die en voert hem vervolgens uit.
SQL gaat ook veel verder dan wat relationele algebra definieert. Relationele algebra kent geen concepten als:
Aggregatie – SUM(), COUNT(), AVG()
Groeperen – GROUP BY
Sorteren – ORDER BY
Omgang met duplicaten – relationele algebra werkt met verzamelingen (geen duplicaten); SQL werkt met multisets (duplicaten standaard toegestaan)
Deze features zijn aan SQL toegevoegd omdat je ze in de praktijk nodig hebt. Maar ze rusten op het fundament van relationele algebra.
De bottomline: door relationele algebra te begrijpen, zie je hoe je SQL-queries intern worden opgebouwd en getransformeerd. Het verandert niet hoe je dagelijks SQL schrijft, maar wel hoe je redeneert over wat je queries daadwerkelijk doen.
De meeste verwarringen rond relationele algebra komen neer op een paar terugkerende misverstanden. Ik loop ze even langs.
SQL en relationele algebra als hetzelfde zien. Dat zijn ze niet. SQL is geïnspireerd op relationele algebra, maar de twee zijn niet uitwisselbaar. SQL is declaratief en bevat functies zoals aggregatie en sortering die relationele algebra niet definieert. Relationele algebra is een formeel model; SQL is een praktische taal erbovenop.
Vereisten voor schema-compatibiliteit vergeten. Unie, doorsnede en setverschil vereisen union-compatibele relaties – hetzelfde aantal attributen, dezelfde datatypen in dezelfde volgorde. Deze operatoren toepassen op tabellen met verschillende schema’s werkt niet. Dat is verwarrend omdat joins zo’n eis niet hebben.
De delingsoperator niet begrijpen. Deling is de ene operator zonder direct SQL-equivalent, daarom struikelen mensen erover. Als je een query ziet die vraagt "vind alle X die met elke Y geassocieerd zijn", is dat deling. De SQL-vertaling vereist een dubbel NOT EXISTS-patroon – niet vanzelfsprekend, dus het loont om te oefenen voor een tentamen of interview.
Denken dat joins op zichzelf staande operatoren zijn. Het zijn geen primitieven. Elke join is een cartesisch product gecombineerd met een selectie. Natuurlijke join, theta-join, equi-join – allemaal verkortingen van die combinatie. Dit begrijpen maakt het gedrag van joins voorspelbaarder wanneer resultaten onverwacht lijken.
Relationele algebra is de theoretische ruggengraat van elk relationeel databasesysteem. Elke query die je in SQL schrijft, wordt vertaald naar een reeks operaties uit de relationele algebra voordat de database-engine een enkele rij aanraakt.
De operatoren – selectie, projectie, unie, setverschil, cartesisch product en hun afgeleiden – zijn de bouwstenen van die vertaling. Zodra je begrijpt hoe ze werken en hoe ze aan elkaar geschakeld worden, zie je SQL niet langer als een black box maar als de structuur eronder.
Dat is de echte waarde van relationele algebra leren: begrijpen wat je queries daadwerkelijk doen, niet ze in formele notatie kunnen schrijven.
Leren met DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

