
Corso
Introduzione ai database relazionali in SQL
4 ore
200.4K
L’algebra relazionale è un linguaggio di interrogazione procedurale. Dice al database come recuperare i dati, non solo quali vuoi ottenere.
Questa è la differenza chiave rispetto a SQL, che è dichiarativo. Quando scrivi una query SQL, descrivi il risultato che vuoi. L’algebra relazionale descrive l’esatta sequenza di operazioni per arrivarci.
Opera su relazioni, il termine formale per tabelle. Le fornisci una o più relazioni in input, applichi un’operazione e ottieni una relazione in output.
Quest’ultimo aspetto è la proprietà di chiusura. Indipendentemente dall’operazione applicata — filtrare righe, scegliere colonne, combinare tabelle — il risultato è sempre un’altra relazione. Questo conta perché significa che puoi concatenare le operazioni. L’output di una diventa l’input della successiva e puoi continuare a impilarle quanto ti serve.
Puoi pensare all’algebra relazionale come a dei mattoncini. Ogni blocco prende una tabella (o due), le fa qualcosa e ti restituisce una tabella. I motori di database usano internamente questi blocchi per scomporre ed eseguire le tue query SQL.
Prima di lavorare con gli operatori dell’algebra relazionale, ti serve conoscere il vocabolario. La buona notizia è che ci sono solo cinque termini da ricordare.
Relazione è semplicemente una tabella. Ha righe e colonne e rappresenta un insieme di dati su una specifica entità — come dipendenti o reparti. Nell’algebra relazionale, ogni operazione prende una o più relazioni in input e produce una relazione in output.
Tupla è una singola riga di quella tabella. Se la tua tabella Employees ha 10 righe, ha 10 tuple. Ogni tupla rappresenta un record — in questo caso, un dipendente.
Attributo è una colonna. La tabella Employees potrebbe avere attributi come employee_id, name e department_id. Gli attributi definiscono che tipo di dati contiene ogni tupla.
Grado è il numero di attributi in una relazione. Se Employees ha cinque colonne, il suo grado è 5. Questo conta quando combini relazioni: alcune operazioni richiedono gradi corrispondenti.
Cardinalità è il numero di tuple in una relazione. Se la tua tabella Employees ha 200 righe, la sua cardinalità è 200. La cardinalità cambia quando aggiungi o rimuovi righe; il grado cambia solo quando aggiungi o rimuovi colonne.
Ecco come questi termini si mappano su ciò che già conosci:
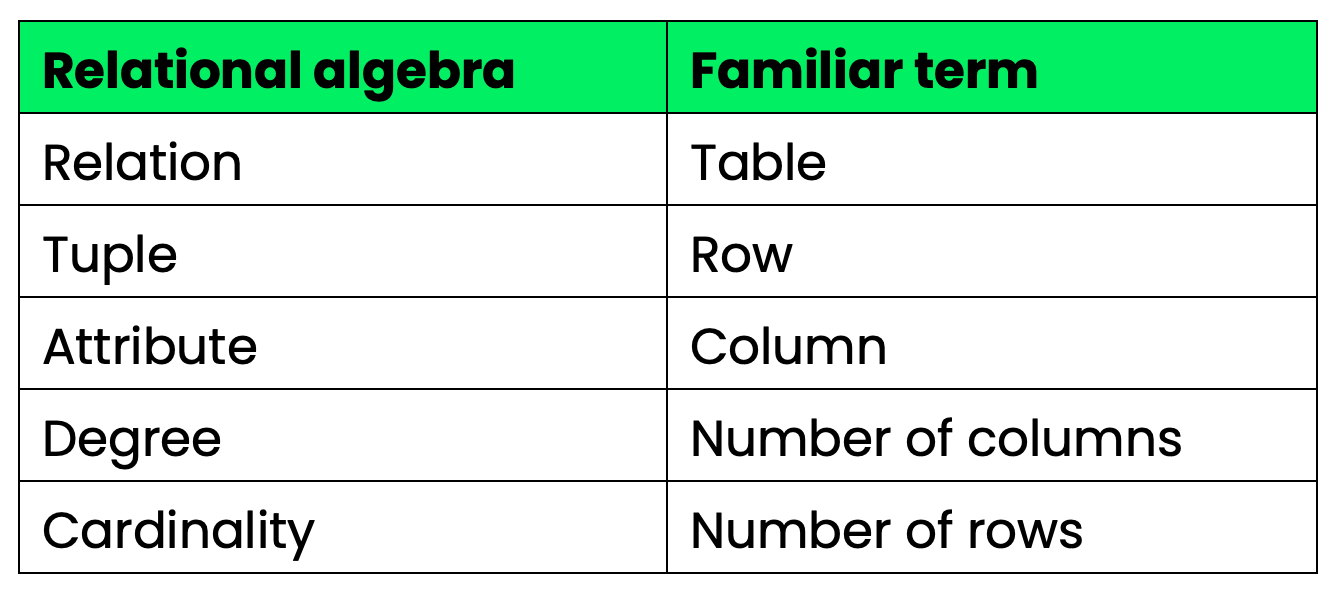
Algebra relazionale rispetto ai termini comuni
Assicurati che questi concetti ti siano chiari, poi gli operatori avranno senso immediatamente.
Ci sono cinque operatori fondamentali nell’algebra relazionale. Ogni altra operazione — join, intersezione, divisione — si basa su questi.
Per mantenere coerenti gli esempi, userò due tabelle in tutta questa sezione:
Employees
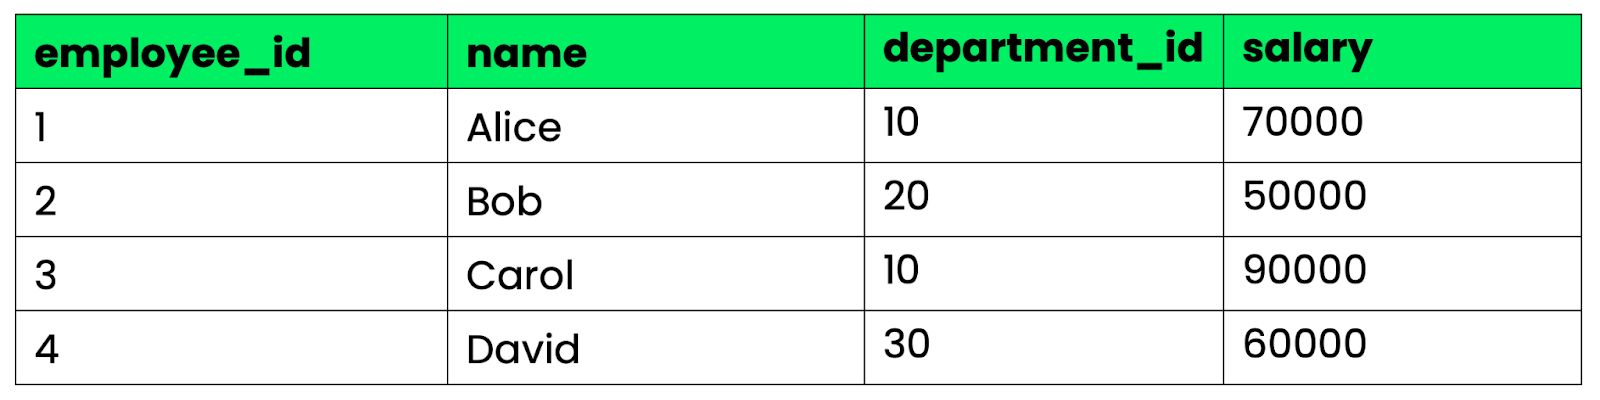
Tabella Employees
Departments
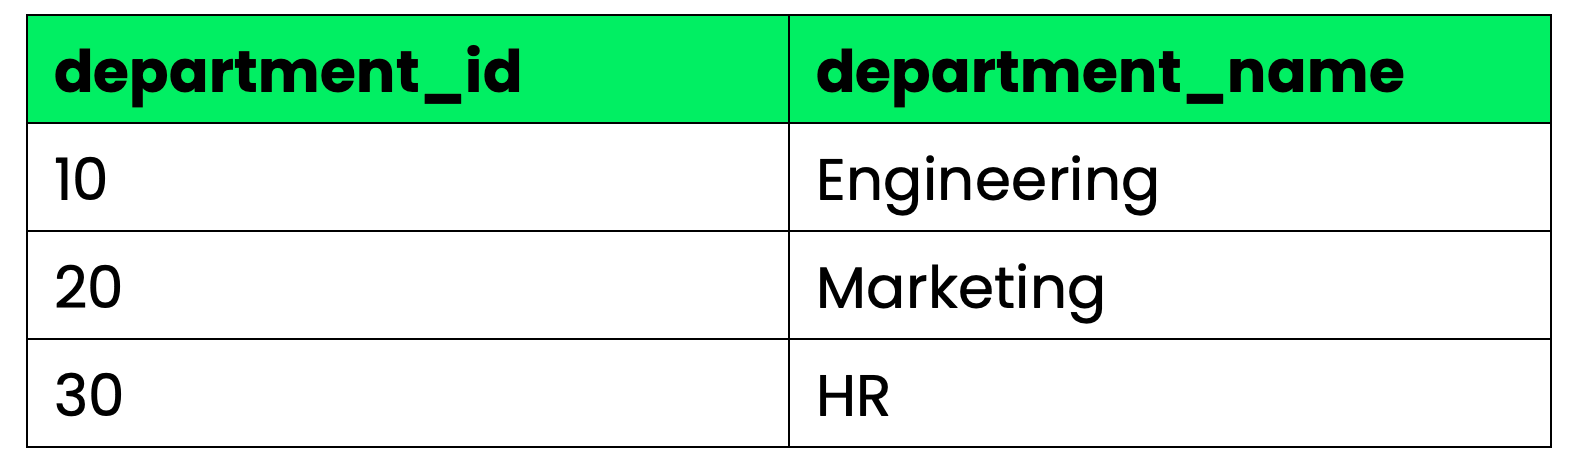
Tabella Departments
La selezione filtra le righe in base a una condizione. È l’equivalente, nell’algebra relazionale, della clausola WHERE.
La notazione è questa:
σ condition (Relation)Mettiamo che tu voglia tutti i dipendenti con stipendio superiore a 60.000:
σ salary > 60000 (Employees)Il risultato è una nuova relazione con solo le righe corrispondenti — Alice e Carol. La struttura della tabella resta la stessa, quindi stai solo rimuovendo le righe che non soddisfano la condizione.
Ecco l’equivalente SQL:
SELECT * FROM Employees
WHERE salary > 60000;La proiezione seleziona colonne specifiche da una relazione ed elimina le altre. È il modo per ridurre una tabella solo agli attributi che ti interessano.
π attribute1, attribute2 (Relation)Per ottenere solo nomi e stipendi di tutti i dipendenti:
π name, salary (Employees)Attenzione: la proiezione rimuove le righe duplicate dal risultato. Se due tuple sono identiche dopo aver eliminato le colonne extra, solo una copia finisce in output.
Equivalente SQL:
SELECT DISTINCT name, salary
FROM Employees;L’unione combina due relazioni in una, unendo tutte le loro tuple. Le righe duplicate vengono rimosse automaticamente.
La notazione:
Relation1 ∪ Relation2La condizione è che entrambe le relazioni siano unione-compatibili. Significa che devono avere lo stesso numero di attributi e gli attributi corrispondenti devono avere gli stessi tipi di dato. Non puoi unire una tabella dipendenti con una tabella reparti se gli schemi non corrispondono.
Supponiamo che tu abbia una tabella Contractors con la stessa struttura di Employees. L’unione ti restituisce tutte le persone di entrambe le tabelle, senza duplicati:
Employees ∪ ContractorsEquivalente SQL:
SELECT * FROM Employees
UNION
SELECT * FROM Contractors;La differenza insiemistica restituisce le tuple che esistono nella prima relazione ma non nella seconda. Pensala come una sottrazione:
Relation1 − Relation2Come per l’unione, entrambe le relazioni devono essere unione-compatibili.
Se vuoi tutti i dipendenti che non sono contractor, la sintassi è questa:
Employees − ContractorsIl risultato contiene solo le righe di Employees che non hanno corrispondenza in Contractors.
Equivalente SQL:
SELECT * FROM Employees
EXCEPT
SELECT * FROM Contractors;Un prodotto cartesiano combina ogni tupla della prima relazione con ogni tupla della seconda. Se Employees ha 4 righe e Departments ne ha 3, il risultato ha 4 × 3 = 12 righe.
Employees × DepartmentsDa solo, il risultato è raramente utile: ottieni ogni possibile combinazione di dipendenti e reparti, incluse quelle che non hanno nulla a che vedere tra loro. Ma il prodotto cartesiano è il fondamento dei join. Lo abbini a una selezione per mantenere solo le righe in cui la relazione ha senso.
Equivalente SQL:
SELECT * FROM Employees, Departments;Questi cinque operatori sono il fondamento. Tutto il resto nell’algebra relazionale è una scorciatoia per combinarli.
I join sono le operazioni più utilizzate nell’algebra relazionale — e non sono così misteriose come sembrano.
Ogni join è solo un prodotto cartesiano seguito da una selezione. Combini tutte le tuple di due relazioni, poi filtri quelle che non soddisfano una condizione. I join esistono come scorciatoia perché fare prima un prodotto cartesiano completo è costoso. Un join applica la condizione durante la combinazione, riducendo la dimensione dei risultati intermedi.
Il natural join unisce automaticamente due relazioni su tutti gli attributi con lo stesso nome e mantiene una sola copia di quelle colonne condivise nel risultato:
Employees ⋈ DepartmentsDato che entrambe le tabelle condividono department_id, il natural join abbina le righe in cui quel valore è uguale e le unisce. Alice (department_id = 10) viene associata a Engineering, Bob a Marketing e così via.
Non c’è una condizione da scrivere: il join la ricava dallo schema. È comodo, ma significa anche che rinominare una colonna può rompere la query.
Equivalente SQL:
SELECT * FROM Employees
NATURAL JOIN Departments;Il theta join unisce due relazioni in base a qualsiasi condizione tu specifichi — la condizione può usare qualunque operatore di confronto: =, ≠, <, >, ≤, ≥.
Employees ⋈ salary > 60000 AND department_id = department_id DepartmentsQuesto ti dà il pieno controllo sulla condizione di join. La maggior parte dei join che scrivi in pratica sono, sotto il cofano, theta join.
Equivalente SQL:
SELECT * FROM Employees, Departments
WHERE Employees.salary > 60000
AND Employees.department_id = Departments.department_id;L’equi join è un theta join in cui la condizione usa solo l’uguaglianza (=). È il tipo più comune.
Employees ⋈ Employees.department_id = Departments.department_id DepartmentsIl risultato include tutte le colonne di entrambe le tabelle, il che significa che department_id compare due volte. Questa è la differenza principale rispetto al natural join: l’equi join non rimuove le colonne duplicate.
Equivalente SQL:
SELECT * FROM Employees
INNER JOIN Departments
ON Employees.department_id = Departments.department_id;I join sopra restituiscono solo le righe in cui esiste una corrispondenza in entrambe le relazioni. L’outer join mantiene anche le righe senza corrispondenza, riempiendo con NULL i valori mancanti.
Esistono tre varianti:
Left outer join (⟕) mantiene tutte le righe della relazione di sinistra. Se una riga in Employees non ha un reparto corrispondente, appare comunque nel risultato con NULL nelle colonne del reparto.
Right outer join (⟖) mantiene tutte le righe della relazione di destra. I reparti senza dipendenti compaiono comunque, con NULL nelle colonne dei dipendenti.
Full outer join (⟗) mantiene tutte le righe di entrambe le relazioni. Le righe senza corrispondenza da uno dei due lati compaiono con NULL nei valori mancanti.
Ecco gli equivalenti SQL:
-- Left outer join
SELECT * FROM Employees
LEFT JOIN Departments
ON Employees.department_id = Departments.department_id;

-- Right outer join
SELECT * FROM Employees
RIGHT JOIN Departments
ON Employees.department_id = Departments.department_id;

-- Full outer join
SELECT * FROM Employees
FULL OUTER JOIN Departments
ON Employees.department_id = Departments.department_id;
Usa gli outer join quando non puoi permetterti di perdere righe senza corrispondenza — per esempio quando ti serve un elenco completo dei dipendenti a prescindere dal fatto che il loro reparto esista nel sistema.
Gli operatori derivati sono scorciatoie costruite a partire dai cinque operatori base visti prima.
L’intersezione restituisce solo le tuple che compaiono in entrambe le relazioni. Come unione e differenza, entrambe le relazioni devono essere unione-compatibili.
Employees ∩ ContractorsSe un dipendente è anche contractor, comparirà nel risultato. Tutti gli altri vengono esclusi.
Sotto il cofano, l’intersezione è semplicemente la differenza applicata due volte:
Employees ∩ Contractors = Employees − (Employees − Contractors)Equivalente SQL:
SELECT * FROM Employees
INTERSECT
SELECT * FROM Contractors;La divisione è l’operatore che mette in difficoltà molti studenti di informatica e junior — ma il concetto è più semplice di quanto sembri.
La divisione risponde alla domanda: «quali tuple nella relazione A sono associate a tutte le tuple nella relazione B?»
Mettiamo che tu abbia una tabella CourseEnrollments che traccia quali studenti sono iscritti a quali corsi, e una tabella RequiredCourses che elenca ogni corso che uno studente deve completare. La divisione ti restituisce gli studenti iscritti a tutti i corsi obbligatori.
CourseEnrollments ÷ RequiredCoursesEcco perché è considerata difficile: non esiste un equivalente SQL diretto. Per replicare la divisione in SQL, serve una doppia negazione — «trova gli studenti per i quali non esiste alcun corso obbligatorio che non abbiano seguito»:
SELECT DISTINCT student_id FROM CourseEnrollments ce1
WHERE NOT EXISTS (
    SELECT course_id FROM RequiredCourses rc
    WHERE NOT EXISTS (
        SELECT * FROM CourseEnrollments ce2
        WHERE ce2.student_id = ce1.student_id
        AND ce2.course_id = rc.course_id
    )
);
Quella doppia struttura NOT EXISTS è il modo standard per esprimere la divisione in SQL. Se in un colloquio vedi una domanda del tipo «trova tutti gli X che si relazionano a ogni Y», la divisione è l’operatore a cui ricorrere.
La rinomina ti permette di dare un nuovo nome a una relazione o ai suoi attributi. Non cambia i dati, solo come si chiamano le cose.
ρ NewName (Relation)Oppure per rinominare sia la relazione che i suoi attributi:
ρ NewName(attr1, attr2, ...) (Relation)La rinomina è utile quando devi fare un join di una tabella con se stessa — senza di essa, i nomi degli attributi andrebbero in conflitto e l’operazione non avrebbe senso. È utile anche quando concateni operazioni e vuoi che i risultati intermedi abbiano nomi significativi.
Equivalente SQL:
SELECT * FROM Employees AS E1;
-- o rinominando le colonne:
SELECT employee_id AS id, name AS employee_name FROM Employees;
Questi tre operatori vanno memorizzati. Intersezione e rinomina sono semplici, e la divisione è quella su cui vale la pena esercitarsi prima di qualsiasi colloquio sui database.
SQL e algebra relazionale non sono la stessa cosa — ma SQL non esisterebbe senza di essa.
La differenza centrale riguarda il modo in cui ciascuna pensa alle query. L’algebra relazionale è procedurale — specifichi l’esatta sequenza di operazioni per ottenere il risultato. SQL è dichiarativo — descrivi il risultato che vuoi, e il motore del database decide come ottenerlo.
Prendiamo un esempio semplice. In algebra relazionale, recuperare i dipendenti di Engineering è così:
π name, salary (σ department_id = 10 (Employees))Stai dicendo al database esattamente cosa fare: prima filtra le righe, poi scegli le colonne. L’ordine delle operazioni è esplicito.
In SQL, scrivi:
SELECT name, salary
FROM Employees
WHERE department_id = 10;
Stai descrivendo il risultato che vuoi. Il motore del database lo traduce in una sequenza di operazioni — e quelle operazioni interne si basano sull’algebra relazionale.
Questo è il rapporto tra i due. SQL è il linguaggio rivolto all’utente; l’algebra relazionale è il modello teorico sottostante. Quando un motore di database riceve una query SQL, la analizza in una rappresentazione interna basata sull’algebra relazionale, la ottimizza e poi la esegue.
SQL va anche ben oltre ciò che definisce l’algebra relazionale. L’algebra relazionale non ha concetti di:
Aggregazione - SUM(), COUNT(), AVG()
Raggruppamento - GROUP BY
Ordinamento - ORDER BY
Gestione dei duplicati - l’algebra relazionale lavora con insiemi (niente duplicati); SQL lavora con multinsiemi (duplicati consentiti di default)
Queste funzionalità sono state aggiunte a SQL perché nel mondo reale servono. Ma poggiano sul fondamento dell’algebra relazionale.
In sintesi, capire l’algebra relazionale ti dice come le tue query SQL sono strutturate e trasformate internamente. Non cambierà il tuo modo di scrivere SQL ogni giorno, ma cambierà il modo in cui ragioni su ciò che le tue query stanno realmente facendo.
La maggior parte delle confusioni con l’algebra relazionale si riduce a un paio di fraintendimenti ricorrenti. Vediamoli.
Trattare SQL e algebra relazionale come la stessa cosa. Non lo sono. SQL è ispirato all’algebra relazionale, ma non sono intercambiabili. SQL è dichiarativo e include funzionalità come aggregazione e ordinamento che l’algebra relazionale non definisce. L’algebra relazionale è un modello formale; SQL è un linguaggio pratico costruito sopra di esso.
Dimenticare i requisiti di compatibilità degli schemi. Unione, intersezione e differenza insiemistica richiedono relazioni unione-compatibili — stesso numero di attributi, stessi tipi di dato nello stesso ordine. Cercare di applicare questi operatori a tabelle con schemi diversi non funziona. Questo crea confusione perché i join non hanno tale requisito.
Non capire l’operatore di divisione. La divisione è l’unico operatore senza equivalente diretto in SQL, motivo per cui mette in difficoltà. Se vedi una query che chiede «trova tutti gli X associati a ogni Y», quello è divisione. La traduzione SQL richiede la doppia struttura NOT EXISTS — non è ovvia, quindi vale la pena esercitarsi prima di un esame o di un colloquio.
Pensare che i join siano operatori autonomi. Non sono primitivi. Ogni join è un prodotto cartesiano combinato con una selezione. Natural join, theta join, equi join — sono tutti scorciatoie per quella combinazione. Capirlo rende molto più facile prevedere il comportamento dei join quando i risultati sembrano inattesi.
L’algebra relazionale è l’ossatura teorica di ogni sistema di database relazionale. Ogni query che scrivi in SQL viene tradotta in una sequenza di operazioni di algebra relazionale prima che il motore tocchi una sola riga.
Gli operatori — selezione, proiezione, unione, differenza insiemistica, prodotto cartesiano e i loro derivati — sono i mattoni di questa traduzione. Una volta che capisci come funzionano e come si concatenano, smetti di vedere SQL come una scatola nera e inizi a vederne la struttura sottostante.
Questo è il vero valore dell’imparare l’algebra relazionale: capire cosa fanno realmente le tue query, senza necessariamente scriverle in notazione formale.
Impara con DataCamp
Corso
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



