

Cours
Introduction aux bases de données relationnelles en SQL
4 h
201.1K
S'entraîner et cursus vos progrès.
Continuer Avec GoogleL’algèbre relationnelle est un langage de requête procédural. Elle indique à la base de données comment récupérer les données, pas seulement ce que vous voulez obtenir.
C’est la différence clé avec SQL, qui est déclaratif. Quand vous écrivez une requête SQL, vous décrivez le résultat souhaité. L’algèbre relationnelle décrit la séquence exacte d’opérations pour y parvenir.
Elle opère sur des relations – le terme formel pour désigner les tables. Vous lui fournissez une ou plusieurs relations en entrée, appliquez une opération, et obtenez une relation en sortie.
Ce dernier point correspond à la propriété de clôture. Quelle que soit l’opération appliquée – filtrer des lignes, sélectionner des colonnes, combiner des tables – le résultat est toujours une autre relation. Cela compte, car vous pouvez enchaîner les opérations. La sortie de l’une devient l’entrée de la suivante, et vous pouvez empiler aussi profondément que nécessaire.
Pensez à l’algèbre relationnelle comme à des briques élémentaires. Chaque brique prend une table (ou deux), lui applique une transformation, et vous renvoie une table. Les moteurs de base de données utilisent ces briques en interne pour décomposer et exécuter vos requêtes SQL.
Avant d’utiliser les opérateurs d’algèbre relationnelle, il faut maîtriser le vocabulaire. La bonne nouvelle : il n’y a que cinq termes à retenir.
Relation : c’est simplement une table. Elle comporte des lignes et des colonnes et représente un ensemble de données sur une entité donnée – comme des employés ou des services. En algèbre relationnelle, chaque opération prend une ou plusieurs relations en entrée et produit une relation en sortie.
Tuple : une ligne de cette table. Si votre table Employees compte 10 lignes, elle contient 10 tuples. Chaque tuple représente un enregistrement – ici, un employé.
Attribut : une colonne. La table Employees peut comporter des attributs comme employee_id, name et department_id. Les attributs définissent la nature des données contenues dans chaque tuple.
Degré : le nombre d’attributs d’une relation. Si Employees possède cinq colonnes, son degré est 5. C’est important lors de combinaisons de relations – certaines opérations exigent des degrés correspondants.
Cardinalité : le nombre de tuples d’une relation. Si votre table Employees a 200 lignes, sa cardinalité est 200. La cardinalité varie lorsque vous ajoutez ou supprimez des lignes ; le degré ne change que lorsque vous ajoutez ou retirez des colonnes.
Voici la correspondance avec les termes que vous connaissez déjà :
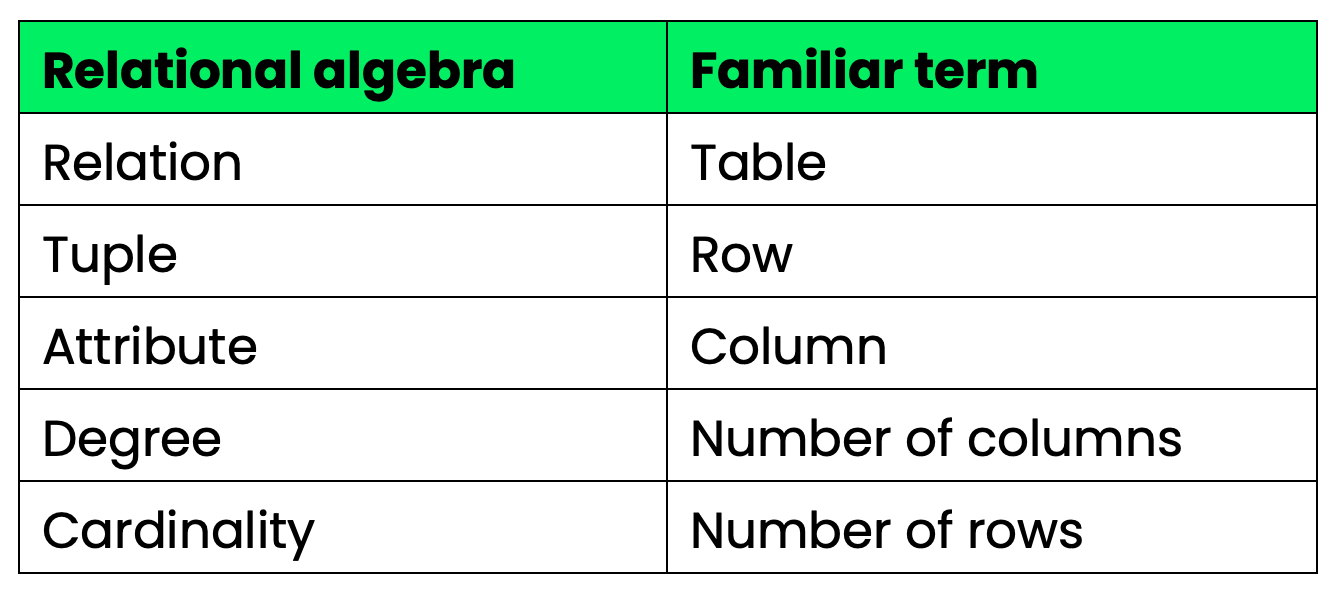
Algèbre relationnelle versus termes courants
Une fois ces notions bien assimilées, les opérateurs deviennent limpides.
Il existe cinq opérateurs fondamentaux en algèbre relationnelle. Toutes les autres opérations – jointures, intersection, division – s’appuient sur ceux-ci.
Pour garder la cohérence des exemples, j’utiliserai deux tables tout au long de cette section :
Employees
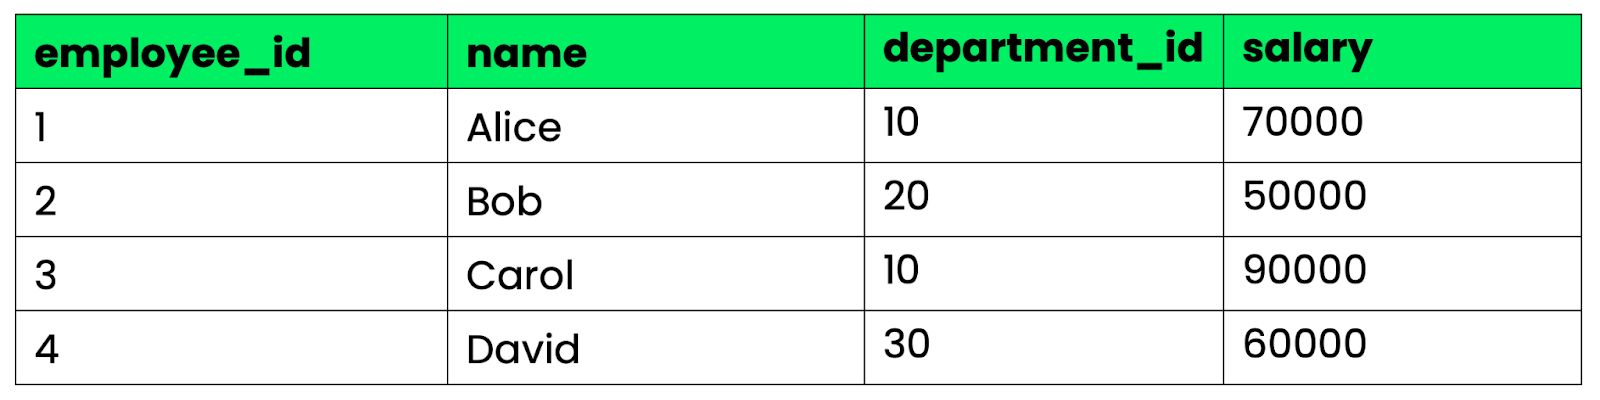
Table Employees
Departments
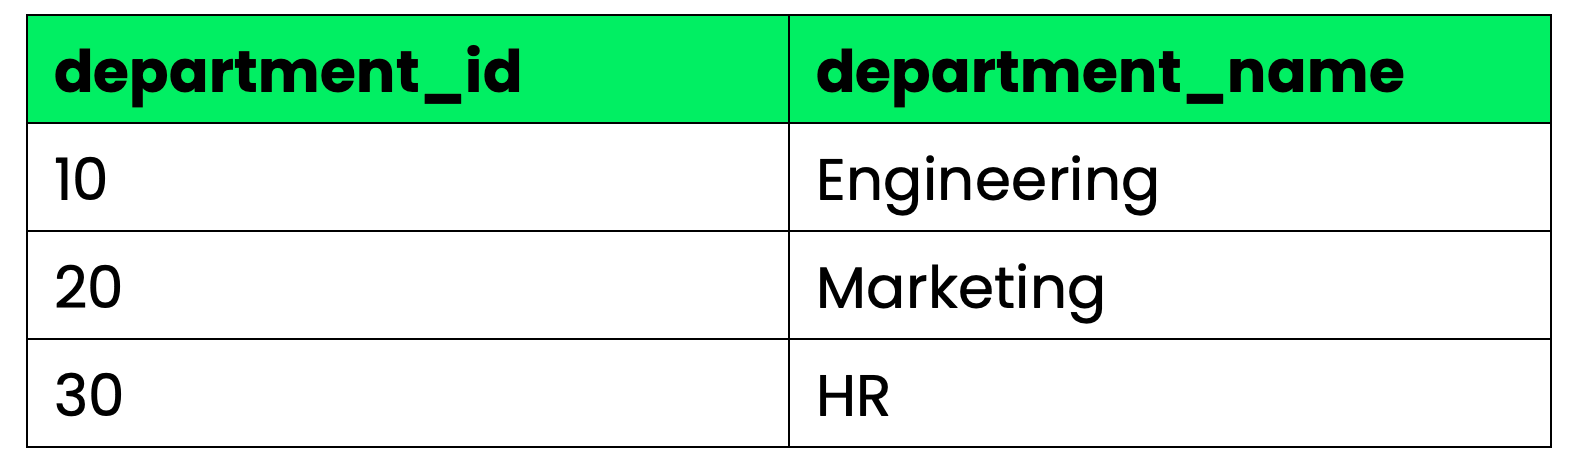
Table Departments
La sélection filtre les lignes selon une condition. C’est l’équivalent en algèbre relationnelle d’une clause WHERE.
La notation ressemble à ceci :
σ condition (Relation)Par exemple, pour obtenir tous les employés ayant un salaire supérieur à 60 000 :
σ salary > 60000 (Employees)Le résultat est une nouvelle relation ne contenant que les lignes correspondantes – Alice et Carol. La structure de la table reste identique, vous ne faites que retirer les lignes qui ne satisfont pas la condition.
Équivalent SQL :
SELECT * FROM Employees
WHERE salary > 60000;La projection sélectionne des colonnes spécifiques d’une relation et ignore les autres. C’est ainsi que vous réduisez une table aux seuls attributs utiles.
π attribute1, attribute2 (Relation)Pour récupérer uniquement les noms et salaires de tous les employés :
π name, salary (Employees)Attention : la projection supprime les doublons dans le résultat. Si deux tuples deviennent identiques après avoir supprimé des colonnes, une seule occurrence est conservée en sortie.
Équivalent SQL :
SELECT DISTINCT name, salary
FROM Employees;L’union combine deux relations en une seule, en fusionnant tous leurs tuples. Les doublons sont supprimés automatiquement.
Notation :
Relation1 ∪ Relation2La contrainte : les deux relations doivent être compatibles pour l’union. Elles doivent avoir le même nombre d’attributs, et les attributs correspondants doivent être du même type. Vous ne pouvez pas faire l’union d’une table d’employés avec une table de services si leurs schémas ne correspondent pas.
Supposons que vous ayez une table Contractors avec la même structure que Employees. L’union renvoie toutes les personnes présentes dans les deux tables, sans doublons :
Employees ∪ ContractorsÉquivalent SQL :
SELECT * FROM Employees
UNION
SELECT * FROM Contractors;La différence d’ensembles renvoie les tuples présents dans la première relation mais absents de la seconde. Pensez-y comme à une soustraction :
Relation1 − Relation2Comme pour l’union, les deux relations doivent être compatibles pour l’union.
Pour lister tous les employés qui ne sont pas des prestataires :
Employees − ContractorsLe résultat contient uniquement les lignes de Employees qui n’ont pas d’équivalent dans Contractors.
Équivalent SQL :
SELECT * FROM Employees
EXCEPT
SELECT * FROM Contractors;Un produit cartésien combine chaque tuple de la première relation avec chaque tuple de la seconde. Si Employees comporte 4 lignes et Departments en a 3, le résultat contient 4 × 3 = 12 lignes.
Employees × DepartmentsPris isolément, le résultat est rarement utile – vous obtenez toutes les combinaisons possibles d’employés et de services, y compris celles qui n’ont aucun sens métier. Mais le produit cartésien est la base des jointures. On l’associe à une sélection pour ne conserver que les lignes où la relation est pertinente.
Équivalent SQL :
SELECT * FROM Employees, Departments;Ces cinq opérateurs constituent le socle. Tout le reste en algèbre relationnelle n’est qu’un raccourci pour les combiner.
Les jointures sont les opérations les plus utilisées en algèbre relationnelle – et elles sont moins mystérieuses qu’elles n’y paraissent.
Chaque jointure n’est qu’un produit cartésien suivi d’une sélection. Vous combinez tous les tuples de deux relations, puis vous filtrez ceux qui ne satisfont pas une condition. Les jointures existent comme raccourci, car effectuer d’abord un produit cartésien complet est coûteux. Une jointure applique la condition pendant la combinaison, ce qui réduit la taille des résultats intermédiaires.
La jointure naturelle associe automatiquement deux relations sur tous les attributs portant le même nom, et ne conserve qu’une seule copie de ces colonnes partagées dans le résultat :
Employees ⋈ DepartmentsComme les deux tables partagent department_id, la jointure naturelle apparie les lignes où la valeur est égale et les fusionne. Alice (department_id = 10) est associée à Engineering, Bob à Marketing, etc.
Il n’y a pas de condition à écrire – la jointure l’infère depuis le schéma. C’est pratique, mais renommer une colonne peut casser la requête.
Équivalent SQL :
SELECT * FROM Employees
NATURAL JOIN Departments;La jointure thêta relie deux relations selon n’importe quelle condition que vous définissez – la condition peut utiliser tout opérateur de comparaison : =, ≠, <, >, ≤, ≥.
Employees ⋈ salary > 60000 AND department_id = department_id DepartmentsVous contrôlez totalement la condition de jointure. La plupart des jointures que vous écrivez en pratique sont, en coulisse, des jointures thêta.
Équivalent SQL :
SELECT * FROM Employees, Departments
WHERE Employees.salary > 60000
AND Employees.department_id = Departments.department_id;La jointure d’égalité est une jointure thêta dont la condition n’utilise que l’égalité (=). C’est la plus courante.
Employees ⋈ Employees.department_id = Departments.department_id DepartmentsLe résultat inclut toutes les colonnes des deux tables, ce qui signifie que department_id apparaît deux fois. C’est la principale différence avec la jointure naturelle – l’equi join ne supprime pas les colonnes en double.
Équivalent SQL :
SELECT * FROM Employees
INNER JOIN Departments
ON Employees.department_id = Departments.department_id;Les jointures ci-dessus ne renvoient que les lignes ayant une correspondance dans les deux relations. La jointure externe conserve aussi les lignes non appariées, en remplissant les valeurs manquantes avec NULL.
Il en existe trois variantes :
Jointure externe gauche (⟕) : conserve toutes les lignes de la relation de gauche. Si une ligne d’Employees n’a pas de service correspondant, elle apparaît quand même avec des NULL dans les colonnes du service.
Jointure externe droite (⟖) : conserve toutes les lignes de la relation de droite. Les services sans employés apparaissent quand même, avec des NULL dans les colonnes employé.
Jointure externe complète (⟗) : conserve toutes les lignes des deux relations. Les lignes non appariées de chaque côté apparaissent avec des NULL pour les valeurs manquantes.
Équivalents SQL :
-- Jointure externe gauche
SELECT * FROM Employees
LEFT JOIN Departments
ON Employees.department_id = Departments.department_id;

-- Jointure externe droite
SELECT * FROM Employees
RIGHT JOIN Departments
ON Employees.department_id = Departments.department_id;

-- Jointure externe complète
SELECT * FROM Employees
FULL OUTER JOIN Departments
ON Employees.department_id = Departments.department_id;
Utilisez des jointures externes lorsque vous ne pouvez pas vous permettre de perdre des lignes sans correspondance – par exemple pour obtenir la liste complète des employés, que leur service existe ou non dans le système.
Les opérateurs dérivés sont des raccourcis construits à partir des cinq opérateurs de base présentés plus haut.
L’intersection renvoie uniquement les tuples présents dans les deux relations. Comme pour l’union et la différence, les relations doivent être compatibles pour l’union.
Employees ∩ ContractorsSi une personne est à la fois employée et prestataire, elle apparaît dans le résultat. Les autres sont exclues.
Sous le capot, l’intersection revient à appliquer deux fois la différence d’ensembles :
Employees ∩ Contractors = Employees − (Employees − Contractors)Équivalent SQL :
SELECT * FROM Employees
INTERSECT
SELECT * FROM Contractors;La division est l’opérateur qui déroute le plus les étudiants en informatique et les juniors – mais le concept est plus simple qu’il n’en a l’air.
La division répond à la question : « quels tuples de la relation A sont associés à tous les tuples de la relation B ? »
Supposons une table CourseEnrollments qui suit l’inscription des étudiants aux cours, et une table RequiredCourses listant tous les cours obligatoires. La division vous donne les étudiants inscrits à tous les cours requis.
CourseEnrollments ÷ RequiredCoursesVoici pourquoi c’est jugé délicat : il n’y a pas d’équivalent SQL direct. Pour reproduire la division en SQL, il faut une double négation – « trouver les étudiants pour lesquels il n’existe pas de cours requis qu’ils n’ont pas suivi » :
SELECT DISTINCT student_id FROM CourseEnrollments ce1
WHERE NOT EXISTS (
    SELECT course_id FROM RequiredCourses rc
    WHERE NOT EXISTS (
        SELECT * FROM CourseEnrollments ce2
        WHERE ce2.student_id = ce1.student_id
        AND ce2.course_id = rc.course_id
    )
);
Ce double motif NOT EXISTS est la façon standard d’exprimer la division en SQL. Si, en entretien, on vous demande « trouver tous les X liés à chaque Y », pensez à l’opérateur de division.
Le renommage vous permet d’attribuer un nouveau nom à une relation ou à ses attributs. Il ne change pas les données, uniquement l’appellation.
ρ NewName (Relation)Ou pour renommer à la fois la relation et ses attributs :
ρ NewName(attr1, attr2, ...) (Relation)Le renommage est utile lorsque vous devez joindre une table avec elle-même – sans cela, les noms d’attributs entreraient en collision et l’opération perdrait son sens. C’est aussi pratique quand vous enchaînez des opérations et souhaitez donner des noms parlants aux résultats intermédiaires.
Équivalent SQL :
SELECT * FROM Employees AS E1;
-- ou renommer des colonnes :
SELECT employee_id AS id, name AS employee_name FROM Employees;
Ces trois opérateurs sont à mémoriser. L’intersection et le renommage sont simples, et la division est celle qu’il vaut la peine de pratiquer avant tout entretien sur les bases de données.
SQL et l’algèbre relationnelle ne sont pas la même chose – mais SQL n’existerait pas sans elle.
La différence essentielle tient à la façon d’aborder les requêtes. L’algèbre relationnelle est procédurale – vous spécifiez la séquence exacte d’opérations pour obtenir votre résultat. SQL est déclaratif – vous décrivez le résultat voulu, et le moteur détermine comment l’obtenir.
Prenons un exemple simple. En algèbre relationnelle, récupérer les employés d’Engineering ressemble à ceci :
π name, salary (σ department_id = 10 (Employees))Vous indiquez précisément quoi faire : filtrer d’abord les lignes, puis sélectionner les colonnes. L’ordre des opérations est explicite.
En SQL, vous écrivez :
SELECT name, salary
FROM Employees
WHERE department_id = 10;
Vous décrivez le résultat souhaité. Le moteur traduit cela en une séquence d’opérations – et ces opérations internes reposent sur l’algèbre relationnelle.
Voilà le lien entre les deux. SQL est le langage orienté utilisateur ; l’algèbre relationnelle est le modèle théorique sous-jacent. Lorsqu’un moteur reçoit une requête SQL, il la parse en une représentation interne fondée sur l’algèbre relationnelle, l’optimise, puis l’exécute.
SQL va également bien au-delà de ce que définit l’algèbre relationnelle. Cette dernière n’a pas de notion de :
Aggregation – SUM(), COUNT(), AVG()
Regroupement – GROUP BY
Tri – ORDER BY
Gestion des doublons – l’algèbre relationnelle travaille sur des ensembles (sans doublons) ; SQL fonctionne sur des multi-ensembles (doublons autorisés par défaut)
Ces fonctionnalités ont été ajoutées à SQL car les besoins réels les imposent. Mais elles reposent sur les fondations de l’algèbre relationnelle.
En bref, comprendre l’algèbre relationnelle vous montre comment vos requêtes SQL sont structurées et transformées en interne. Cela ne change pas votre écriture de SQL au quotidien, mais cela change votre manière de raisonner sur ce que font réellement vos requêtes.
La plupart des confusions autour de l’algèbre relationnelle tiennent à quelques malentendus récurrents. Passons-les en revue.
Assimiler SQL et algèbre relationnelle. Ce ne sont pas des équivalents. SQL s’inspire de l’algèbre relationnelle, mais elles ne sont pas interchangeables. SQL est déclaratif et inclut des fonctionnalités comme l’agrégation et le tri que l’algèbre relationnelle ne définit pas. L’algèbre relationnelle est un modèle formel ; SQL est un langage pratique bâti dessus.
Oublier les exigences de compatibilité de schéma. L’union, l’intersection et la différence d’ensembles exigent des relations compatibles pour l’union – même nombre d’attributs, mêmes types et même ordre. Tenter d’appliquer ces opérateurs à des tables de schémas différents ne fonctionne pas. Cela prête à confusion parce que les jointures n’ont pas cette contrainte.
Ne pas comprendre l’opérateur de division. C’est le seul opérateur sans équivalent SQL direct, d’où les difficultés. Si une requête demande « trouver tous les X associés à chaque Y », c’est de la division. La traduction SQL requiert un double NOT EXISTS – ce n’est pas intuitif, donc à pratiquer avant un examen ou un entretien.
Croire que les jointures sont des opérateurs autonomes. Ce ne sont pas des primitives. Chaque jointure est un produit cartésien combiné à une sélection. Jointure naturelle, thêta, d’égalité – ce sont toutes des raccourcis de cette combinaison. Le comprendre facilite l’anticipation du comportement des jointures lorsque les résultats surprennent.
L’algèbre relationnelle est l’ossature théorique de tout système de base de données relationnelle. Chaque requête que vous écrivez en SQL est traduite en une séquence d’opérations d’algèbre relationnelle avant que le moteur ne touche une seule ligne.
Les opérateurs – sélection, projection, union, différence d’ensembles, produit cartésien, et leurs dérivés – sont les briques de cette traduction. Une fois que vous comprenez leur fonctionnement et leur enchaînement, SQL cesse d’être une boîte noire pour laisser apparaître sa structure sous-jacente.
C’est là tout l’intérêt d’apprendre l’algèbre relationnelle : comprendre ce que font réellement vos requêtes, sans forcément les écrire en notation formelle.
Apprenez avec DataCamp
Cours
Cours
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
Kurtis Pykes
15 min
Tutoriel
Josef Waples
3 min
Tutoriel
Laiba Siddiqui
14 min
Tutoriel
Josef Waples
8 min
Tutoriel
Sejal Jaiswal
24 min
Tutoriel
Mark Pedigo
10 min




