Kurs
Einführung in relationale Datenbanken in SQL
4 Std.
201.1K
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleRelationale Algebra ist eine prozedurale Abfragesprache. Sie sagt der Datenbank, wie Daten geholt werden sollen – nicht nur, was du haben willst.
Das ist der entscheidende Unterschied zu SQL, das deklarativ ist. In SQL beschreibst du das gewünschte Ergebnis. Die relationale Algebra beschreibt die genaue Abfolge von Operationen dorthin.
Sie arbeitet auf Relationen – dem formalen Begriff für Tabellen. Du gibst eine oder mehrere Relationen als Input, wendest eine Operation an und erhältst als Output wieder eine Relation.
Dieser letzte Punkt ist die Abschlusseigenschaft (Closure). Egal, welche Operation du anwendest – Zeilen filtern, Spalten auswählen, Tabellen kombinieren – das Ergebnis ist immer wieder eine Relation. Das ist wichtig, weil du so Operationen verketten kannst: Der Output einer Operation wird zum Input der nächsten – so tief, wie du es brauchst.
Denk an relationale Algebra wie an Bausteine. Jeder Block nimmt eine Tabelle (oder zwei), macht etwas damit und gibt dir wieder eine Tabelle zurück. Datenbank-Engines nutzen diese Blöcke intern, um deine SQL-Abfragen zu zerlegen und auszuführen.
Bevor du mit Operatoren arbeitest, brauchst du das Vokabular. Die gute Nachricht: Es sind nur fünf Begriffe.
Relation ist einfach eine Tabelle. Sie hat Zeilen und Spalten und repräsentiert eine Datenmenge zu einer bestimmten Entität – z. B. Mitarbeitende oder Abteilungen. In der relationalen Algebra nehmen alle Operationen eine oder mehrere Relationen als Input und erzeugen eine Relation als Output.
Tupel ist eine einzelne Zeile in dieser Tabelle. Hat deine Tabelle Employees zehn Zeilen, hat sie zehn Tupel. Jedes Tupel entspricht einem Datensatz – hier also einer Person.
Attribut ist eine Spalte. Die Tabelle Employees könnte Attribute wie employee_id, name und department_id haben. Attribute definieren, welche Art Daten jedes Tupel enthält.
Grad (Degree) ist die Anzahl der Attribute einer Relation. Hat Employees fünf Spalten, beträgt der Grad 5. Das ist relevant beim Kombinieren von Relationen – manche Operationen erfordern übereinstimmende Grade.
Kardinalität ist die Anzahl der Tupel einer Relation. Hat deine Tabelle Employees 200 Zeilen, beträgt die Kardinalität 200. Die Kardinalität ändert sich, wenn du Zeilen hinzufügst oder löschst; der Grad nur, wenn du Spalten hinzufügst oder entfernst.
So ordnen sich die Begriffe dem bereits Bekannten zu:
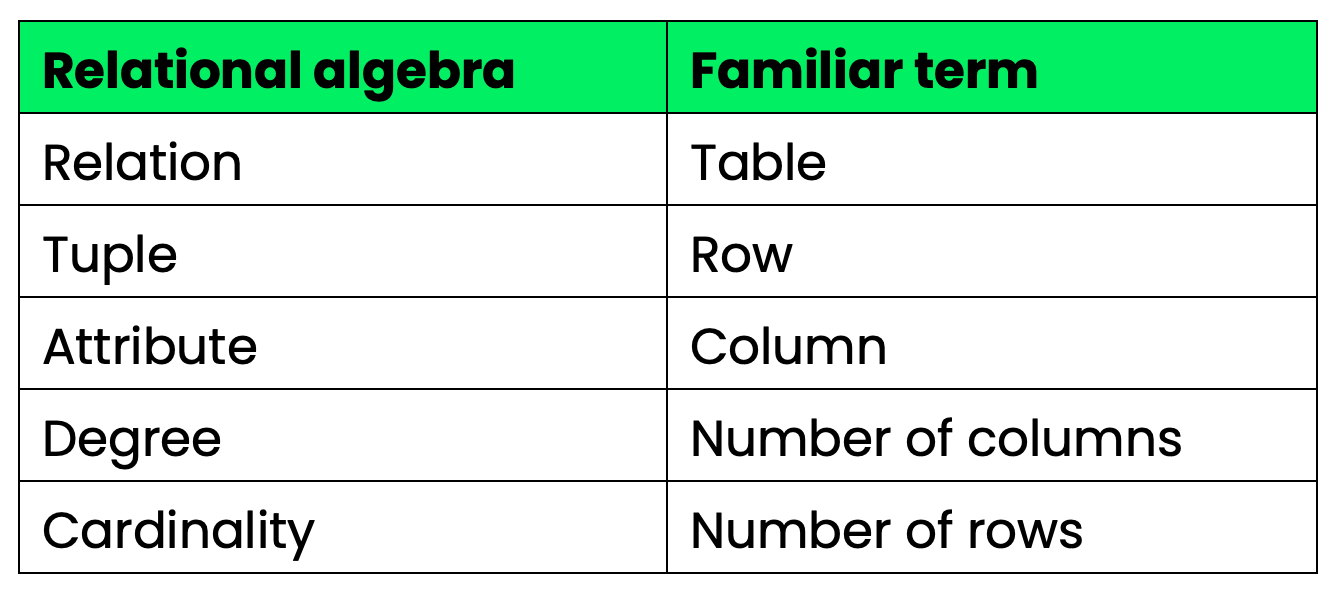
Relationale Algebra versus gängige Begriffe
Wenn das sitzt, sind die Operatoren schnell verinnerlicht.
Es gibt fünf fundamentale Operatoren. Alle anderen – Joins, Schnittmenge, Division – bauen darauf auf.
Für konsistente Beispiele verwende ich durchgängig zwei Tabellen:
Employees
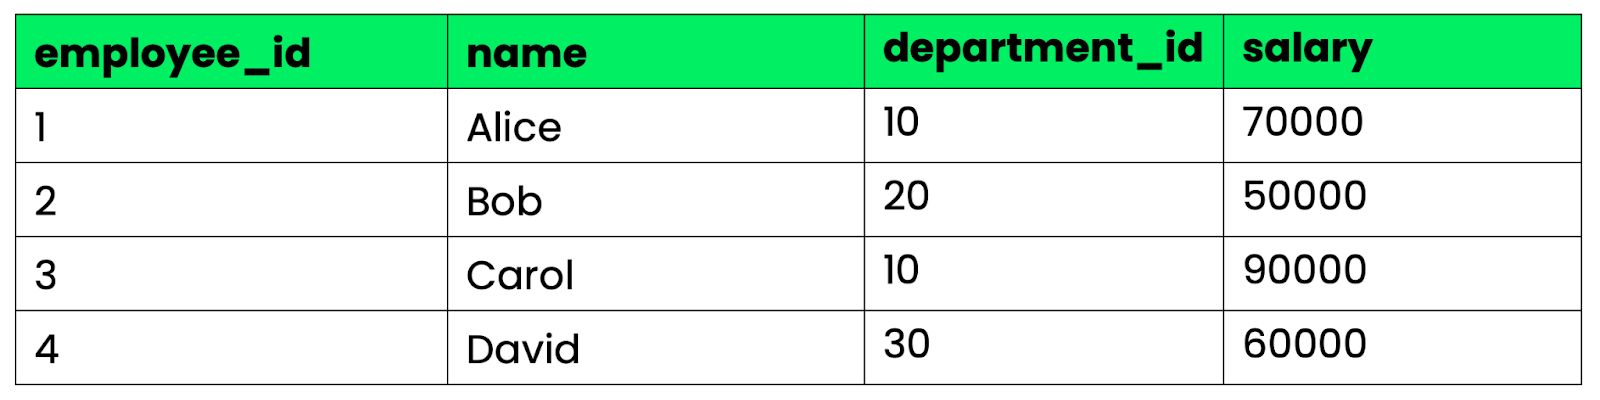
Tabelle Employees
Departments
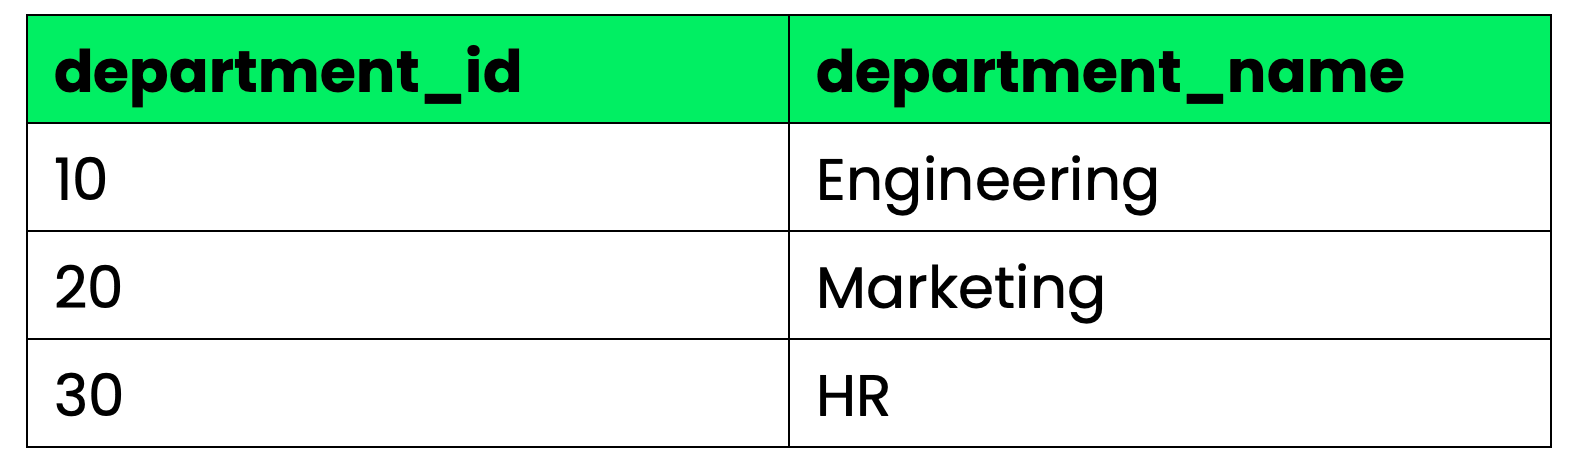
Tabelle Departments
Selektion filtert Zeilen anhand einer Bedingung. Das entspricht der WHERE-Klausel in SQL.
Die Notation sieht so aus:
σ condition (Relation)Angenommen, du willst alle Mitarbeitenden mit einem Gehalt über 60.000:
σ salary > 60000 (Employees)Das Ergebnis ist eine neue Relation nur mit den passenden Zeilen – Alice und Carol. Die Struktur bleibt gleich, du entfernst lediglich nicht passende Zeilen.
Das SQL-Pendant:
SELECT * FROM Employees
WHERE salary > 60000;
Projektion wählt bestimmte Spalten einer Relation aus und lässt den Rest weg. So reduzierst du eine Tabelle auf die Attribute, die dich interessieren.
π attribute1, attribute2 (Relation)Um nur Namen und Gehälter aller Mitarbeitenden zu erhalten:
π name, salary (Employees)Wichtig: Projektion entfernt doppelte Zeilen im Ergebnis. Wenn nach dem Weglassen von Spalten zwei Tupel identisch sind, bleibt nur eines übrig.
Das SQL-Pendant:
SELECT DISTINCT name, salary
FROM Employees;
Vereinigung führt zwei Relationen zusammen und vereint alle Tupel. Doppelte Zeilen werden automatisch entfernt.
Die Notation:
Relation1 ∪ Relation2Voraussetzung ist Vereinigungsverträglichkeit: gleiche Anzahl Attribute und passende Datentypen in derselben Reihenfolge. Du kannst also keine Mitarbeitendentabelle mit einer Abteilungstabelle vereinigen, wenn die Schemata nicht übereinstimmen.
Angenommen, es gibt eine Tabelle Contractors mit derselben Struktur wie Employees. Die Vereinigung liefert alle Personen aus beiden Tabellen ohne Duplikate:
Employees ∪ ContractorsDas SQL-Pendant:
SELECT * FROM Employees
UNION
SELECT * FROM Contractors;Die Mengendifferenz liefert die Tupel, die in der ersten Relation vorkommen, aber nicht in der zweiten. Denk an Subtraktion:
Relation1 − Relation2Wie bei der Vereinigung müssen beide Relationen vereinigungsverträglich sein.
Wenn du alle Mitarbeitenden willst, die keine Contractors sind, lautet die Syntax:
Employees − ContractorsDas Ergebnis enthält nur Zeilen aus Employees ohne Entsprechung in Contractors.
SQL-Pendant:
SELECT * FROM Employees
EXCEPT
SELECT * FROM Contractors;Ein kartesisches Produkt kombiniert jedes Tupel der ersten Relation mit jedem Tupel der zweiten. Hat Employees 4 Zeilen und Departments 3 Zeilen, hat das Ergebnis 4 × 3 = 12 Zeilen.
Employees × DepartmentsFür sich genommen ist das selten sinnvoll – du erhältst jede mögliche Kombination von Mitarbeitenden und Abteilungen, auch ohne Bezug. Aber das kartesische Produkt ist die Basis für Joins: Du kombinierst es mit einer Selektion, um nur sinnvolle Zeilen zu behalten.
SQL-Pendant:
SELECT * FROM Employees, Departments;Diese fünf Operatoren sind das Fundament. Alles andere in der relationalen Algebra ist Kurzschreibweise für ihre Kombination.
Joins sind die am häufigsten genutzten Operationen – und viel weniger mysteriös, als sie aussehen.
Jeder Join ist nur ein kartesisches Produkt gefolgt von einer Selektion. Du kombinierst alle Tupel zweier Relationen und filterst dann anhand einer Bedingung. Joins existieren als Abkürzung, weil ein vollständiges kartesisches Produkt teuer ist. Ein Join wendet die Bedingung bereits beim Kombinieren an und verkleinert so Zwischenresultate.
Der natürliche Join verbindet automatisch alle Attribute gleichen Namens und behält im Ergebnis nur eine Kopie dieser gemeinsamen Spalten:
Employees ⋈ DepartmentsDa beide Tabellen department_id teilen, werden Zeilen mit gleichem Wert gematcht und zusammengeführt. Alice (department_id = 10) landet bei Engineering, Bob bei Marketing usw.
Du musst keine Bedingung schreiben – der Join leitet sie aus dem Schema ab. Das ist bequem, kann aber bei Spaltenumbenennungen deine Abfrage brechen.
Das SQL-Pendant:
SELECT * FROM Employees
NATURAL JOIN Departments;Der Theta-Join verbindet zwei Relationen anhand einer beliebigen von dir definierten Bedingung – zulässig sind Operatoren wie =, ≠, <, >, ≤, ≥.
Employees ⋈ salary > 60000 AND department_id = department_id DepartmentsDamit hast du volle Kontrolle über die Join-Bedingung. Die meisten praktischen Joins sind unter der Haube Theta-Joins.
Das SQL-Pendant:
SELECT * FROM Employees, Departments
WHERE Employees.salary > 60000
AND Employees.department_id = Departments.department_id;Der Equi-Join ist ein Theta-Join, bei dem nur Gleichheit (=) verwendet wird – der häufigste Typ.
Employees ⋈ Employees.department_id = Departments.department_id DepartmentsDas Ergebnis enthält alle Spalten beider Tabellen, department_id erscheint also doppelt. Das ist der Hauptunterschied zum natürlichen Join – Equi-Join entfernt keine doppelten Spalten.
Das SQL-Pendant:
SELECT * FROM Employees
INNER JOIN Departments
ON Employees.department_id = Departments.department_id;Die oben genannten Joins liefern nur Zeilen mit Überschneidung. Outer Joins behalten auch nicht passende Zeilen und füllen fehlende Werte mit NULL.
Es gibt drei Varianten:
Left Outer Join (⟕) behält alle Zeilen aus der linken Relation. Hat ein Eintrag in Employees keine passende Abteilung, erscheint er trotzdem – mit NULL in den Abteilungsspalten.
Right Outer Join (⟖) behält alle Zeilen aus der rechten Relation. Abteilungen ohne Mitarbeitende erscheinen mit NULL in den Mitarbeitendenspalten.
Full Outer Join (⟗) behält alle Zeilen beider Relationen. Nicht überlappende Zeilen erscheinen jeweils mit NULL für fehlende Werte.
Die SQL-Pendants:
-- Left outer join
SELECT * FROM Employees
LEFT JOIN Departments
ON Employees.department_id = Departments.department_id;

-- Right outer join
SELECT * FROM Employees
RIGHT JOIN Departments
ON Employees.department_id = Departments.department_id;

-- Full outer join
SELECT * FROM Employees
FULL OUTER JOIN Departments
ON Employees.department_id = Departments.department_id;
Nutze Outer Joins, wenn du keine Zeilen verlieren darfst, die keine Entsprechung haben – etwa wenn du eine vollständige Liste aller Mitarbeitenden brauchst, unabhängig davon, ob ihre Abteilung im System existiert.
Abgeleitete Operatoren sind Abkürzungen, die aus den fünf Basisoperatoren aufgebaut sind.
Die Schnittmenge liefert nur Tupel, die in beiden Relationen vorkommen. Wie bei Vereinigung und Differenz gilt: vereinigungsverträglich.
Employees ∩ ContractorsIst jemand sowohl Mitarbeiter als auch Contractor, erscheint die Person im Ergebnis. Alle anderen fallen heraus.
Unter der Haube ist die Schnittmenge nur zweimalige Mengendifferenz:
Employees ∩ Contractors = Employees − (Employees − Contractors)Das SQL-Pendant:
SELECT * FROM Employees
INTERSECT
SELECT * FROM Contractors;Die Division bringt viele Studierende ins Stolpern – das Konzept ist aber einfacher, als es wirkt.
Division beantwortet: "Welche Tupel in Relation A sind mit allen Tupeln in Relation B verknüpft?"
Angenommen, du hast eine Tabelle CourseEnrollments, die abbildet, welche Studierenden in welchen Kursen eingeschrieben sind, und eine Tabelle RequiredCourses mit allen Pflichtkursen. Die Division liefert die Studierenden, die in allen Pflichtkursen eingeschrieben sind.
CourseEnrollments ÷ RequiredCoursesKnifflig ist, dass es kein direktes SQL-Pendant gibt. In SQL nutzt man eine doppelte Verneinung – "Finde Studierende, für die es keinen Pflichtkurs gibt, den sie nicht belegt haben":
SELECT DISTINCT student_id FROM CourseEnrollments ce1
WHERE NOT EXISTS (
    SELECT course_id FROM RequiredCourses rc
    WHERE NOT EXISTS (
        SELECT * FROM CourseEnrollments ce2
        WHERE ce2.student_id = ce1.student_id
        AND ce2.course_id = rc.course_id
    )
);
Dieses doppelte NOT EXISTS ist der Standard, um Division in SQL auszudrücken. Wenn im Interview gefragt wird "Finde alle X, die mit jedem Y verknüpft sind", ist Division der gesuchte Operator.
Umbenennen gibt einer Relation oder ihren Attributen einen neuen Namen. Die Daten bleiben unverändert – nur die Bezeichnungen ändern sich.
ρ NewName (Relation)Oder um sowohl Relation als auch Attribute umzubenennen:
ρ NewName(attr1, attr2, ...) (Relation)Umbenennen ist praktisch beim Selbst-Join – ohne wären die Attributnamen kollidierend und die Operation nicht eindeutig. Auch beim Verketten von Operationen sorgt es für aussagekräftige Zwischenresultate.
Das SQL-Pendant:
SELECT * FROM Employees AS E1;
-- oder Spalten umbenennen:
SELECT employee_id AS id, name AS employee_name FROM Employees;
Diese drei Operatoren solltest du auswendig können. Schnittmenge und Umbenennen sind simpel, die Division lohnt sich für die Interview-Vorbereitung.
SQL und relationale Algebra sind nicht dasselbe – aber ohne sie gäbe es SQL nicht.
Der Kernunterschied liegt im Denkmodell: Relationale Algebra ist prozedural – du gibst die genaue Operationsabfolge an. SQL ist deklarativ – du beschreibst das gewünschte Ergebnis, und die Engine findet den Weg.
Ein einfaches Beispiel. In relationaler Algebra sieht das Holen der Engineering-Mitarbeitenden so aus:
π name, salary (σ department_id = 10 (Employees))Du sagst der Datenbank genau, was zu tun ist: erst filtern, dann Spalten auswählen. Die Reihenfolge ist explizit.
In SQL schreibst du:
SELECT name, salary
FROM Employees
WHERE department_id = 10;
Du beschreibst das Ergebnis. Die Engine übersetzt das in eine Abfolge von Operationen – und diese basieren auf relationaler Algebra.
Das ist die Beziehung zwischen beiden: SQL ist die benutzerorientierte Sprache; die relationale Algebra das theoretische Modell darunter. Eine Datenbank-Engine parst eine SQL-Abfrage in eine interne, auf relationaler Algebra basierende Darstellung, optimiert sie und führt sie aus.
SQL geht auch über das hinaus, was die relationale Algebra definiert. Letztere kennt keine:
Aggregation – SUM(), COUNT(), AVG()
Gruppierung – GROUP BY
Sortierung – ORDER BY
Duplikatbehandlung – relationale Algebra arbeitet mit Mengen (ohne Duplikate); SQL mit Multimengen (Duplikate standardmäßig erlaubt)
Diese Features sind in SQL, weil sie im Alltag gebraucht werden – sie bauen aber auf dem Fundament der relationalen Algebra auf.
Unterm Strich hilft dir die relationale Algebra zu verstehen, wie deine SQL-Abfragen intern strukturiert und transformiert werden. Sie ändert nicht, wie du täglich SQL schreibst, aber wie du über die Wirkung deiner Abfragen nachdenkst.
Die meisten Stolpersteine bei relationaler Algebra drehen sich um einige wiederkehrende Missverständnisse. Hier sind sie.
SQL und relationale Algebra gleichsetzen. Sind sie nicht. SQL ist inspiriert von der relationalen Algebra, aber nicht austauschbar. SQL ist deklarativ und umfasst Features wie Aggregation und Sortierung, die die relationale Algebra nicht definiert. Relationale Algebra ist ein formales Modell; SQL eine praxisnahe Sprache darauf aufbauend.
Kompatibilitätsanforderungen ignorieren. Vereinigung, Schnittmenge und Differenz erfordern vereinigungsverträgliche Relationen – gleiche Attributanzahl, gleiche Typen in gleicher Reihenfolge. Mit unterschiedlichen Schemata funktionieren diese Operatoren nicht. Das verwirrt, weil Joins diese Anforderung nicht haben.
Die Divisions-Operation nicht verstehen. Division hat kein direktes SQL-Pendant und verwirrt daher oft. Wenn eine Aufgabe lautet "Finde alle X, die mit jedem Y verknüpft sind", geht es um Division. Die SQL-Übersetzung nutzt die doppelte NOT EXISTS-Struktur – nicht offensichtlich, also üben vor Prüfungen oder Interviews.
Denken, Joins seien eigenständige Primitive. Sind sie nicht. Jeder Join ist ein kartesisches Produkt plus Selektion. Natürlicher Join, Theta-Join, Equi-Join – alles Kurzformen. Wer das versteht, kann Join-Ergebnisse besser vorhersagen, wenn sie überraschend wirken.
Relationale Algebra ist das theoretische Rückgrat jedes relationalen Datenbanksystems. Jede SQL-Abfrage wird in eine Abfolge relationaler Operationen übersetzt, bevor die Engine eine einzige Zeile anfasst.
Die Operatoren – Selektion, Projektion, Vereinigung, Mengendifferenz, kartesisches Produkt und ihre abgeleiteten Gegenstücke – sind die Bausteine dieser Übersetzung. Wenn du verstehst, wie sie funktionieren und sich verketten, siehst du unter die SQL-Haube und erkennst die Struktur dahinter.
Das ist der eigentliche Wert: zu verstehen, was deine Abfragen wirklich tun – nicht, sie in formaler Notation zu schreiben.
Lerne mit DataCamp
Kurs
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleTutorial
Josef Waples
8 Min.
Tutorial
Josef Waples
3 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Allan Ouko
11 Min.