
Kurs
SQL ile İlişkisel Veritabanlarına Giriş
4 sa
200.3K
İlişkisel cebir, yordamlı (procedural) bir sorgulama dilidir. Veritabanına yalnızca ne istediğinizi değil, veriyi nasıl getireceğini söyler.
Bu, bildirime dayalı (declarative) olan SQL’den temel farkıdır. SQL sorgusu yazdığınızda, istediğiniz sonucu tarif edersiniz. İlişkisel cebir ise oraya ulaşmak için uygulanacak işlemlerin tam sırasını tanımlar.
Şu ilişkiler üzerinde çalışır — tablolar için kullanılan biçimsel terimdir. Girdi olarak bir veya daha fazla ilişki verirsiniz, bir işlem uygularsınız ve çıktı olarak yine bir ilişki elde edersiniz.
Son kısım, kapalılık özelliğidir. Hangi işlemi uygularsanız uygulayın — satırları filtreleyin, sütunları seçin, tabloları birleştirin — sonuç her zaman başka bir ilişkidir. Bu, işlemleri birbirine zincirleyebileceğiniz anlamına geldiği için önemlidir. Bir işlemin çıktısı bir sonrakinin girdisi olur ve ihtiyacınız olduğu kadar derinlemesine istifleyebilirsiniz.
İlişkisel cebiri yapı taşları olarak düşünebilirsiniz. Her blok bir tabloyu (ya da iki tabloyu) alır, üzerinde bir şey yapar ve size yine bir tablo verir. Veritabanı motorları bu blokları, SQL sorgularınızı parçalamak ve çalıştırmak için dahili olarak kullanır.
Operatörlerle çalışmadan önce söz dağarcığını bilmeniz gerekir. İyi haber şu ki hatırlanması gereken sadece beş terim var.
İlişki (Relation) basitçe bir tablodur. Satırlara ve sütunlara sahiptir ve çalışanlar ya da departmanlar gibi belirli bir varlıkla ilgili bir veri kümesini temsil eder. İlişkisel cebirde her işlem, girdi olarak bir veya daha fazla ilişki alır ve çıktı olarak bir ilişki üretir.
Kayıt (Tuple) tablodaki tek bir satırdır. Employees tablonuzda 10 satır varsa, 10 kayıt (tuple) vardır. Her kayıt bir kaydı — bu örnekte bir çalışanı — temsil eder.
Özellik (Attribute) bir sütundur. Employees tablosu employee_id, name ve department_id gibi özelliklere sahip olabilir. Özellikler, her kaydın hangi tür veriyi tuttuğunu tanımlar.
Derece (Degree) bir ilişkideki özellik sayısıdır. Employees beş sütuna sahipse, derecesi 5’tir. Bu, ilişkileri birleştirirken önemlidir — bazı işlemler eşleşen dereceler gerektirir.
Kardinalite (Cardinality) bir ilişkideki kayıt (tuple) sayısıdır. Employees tablonuzda 200 satır varsa, kardinalitesi 200’dür. Kardinalite satır eklediğiniz veya sildiğinizde değişir; derece ise yalnızca sütun eklediğinizde veya kaldırdığınızda değişir.
Bu terimlerin, zaten bildiklerinizle eşleşmesi şöyle:
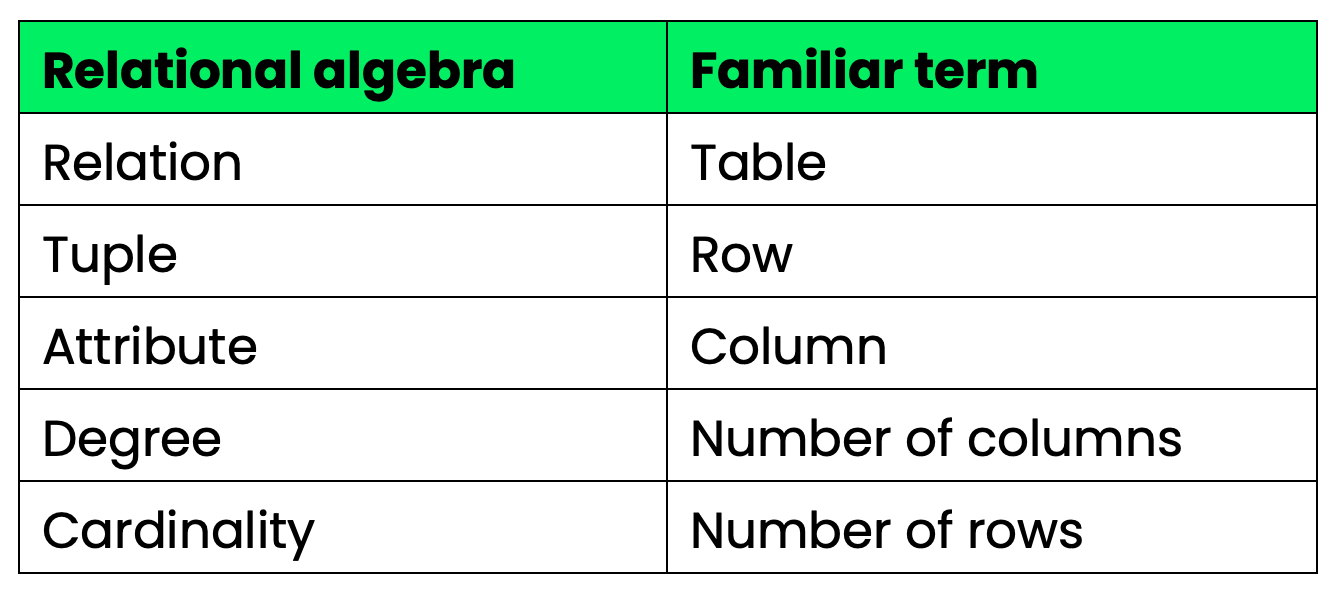
İlişkisel cebir ve yaygın terimler
Bunlar yerine oturduğunda, operatörler tamamen anlamlı hale gelir.
İlişkisel cebirde beş temel operatör vardır. Diğer tüm işlemler — join’ler, kesişim, bölüm — bunların üzerine kuruludur.
Örnekleri tutarlı tutmak için bu bölüm boyunca iki tablo kullanacağım:
Employees
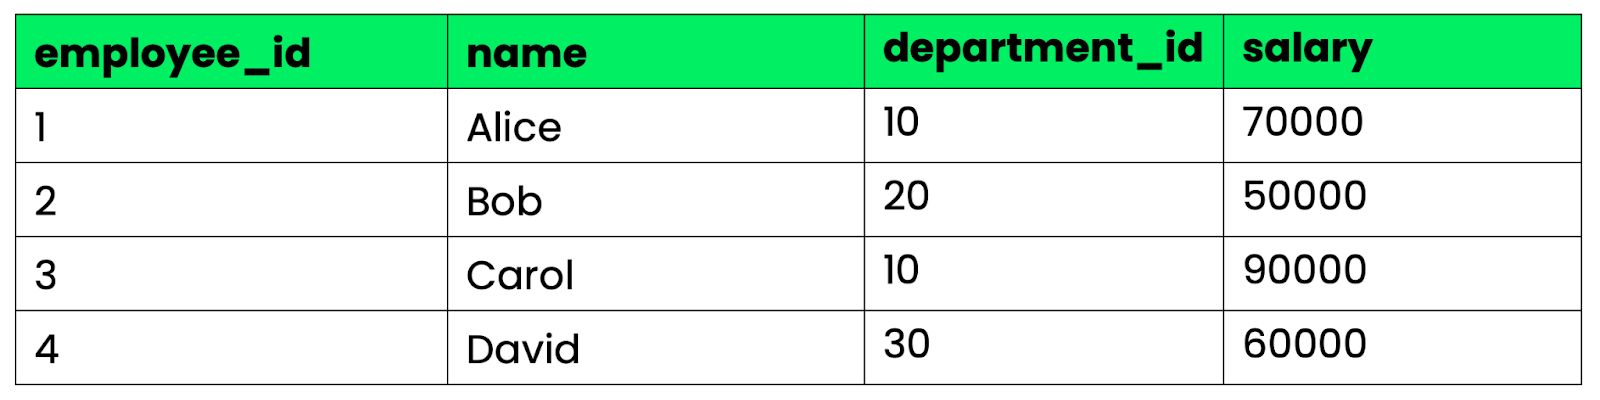
Employees tablosu
Departments
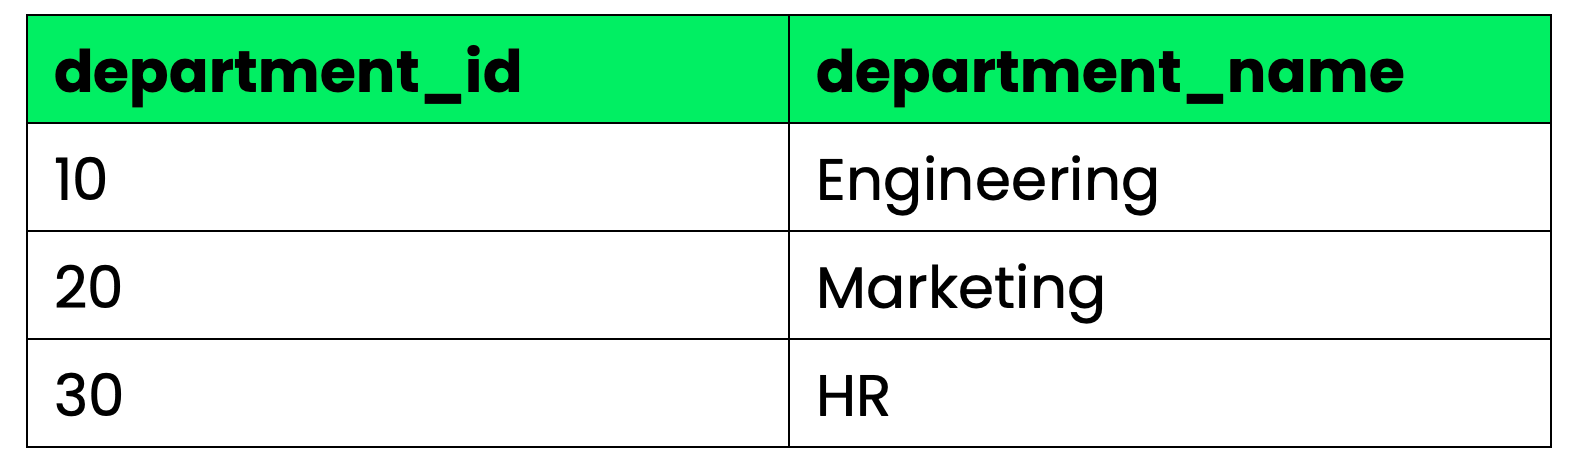
Departments tablosu
Seçim, bir koşula göre satırları filtreler. Bu, ilişkisel cebirde WHERE koşuluna denktir.
Gösterim şu şekildedir:
σ condition (Relation)Maaşı 60.000’in üzerinde olan tüm çalışanları istediğinizi varsayalım:
σ salary > 60000 (Employees)Sonuç, yalnızca koşulu sağlayan satırların yer aldığı yeni bir ilişkidir — Alice ve Carol. Tablonun yapısı aynı kalır, yani koşulu karşılamayan satırları kaldırmış olursunuz.
Bunun SQL karşılığı şöyledir:
SELECT * FROM Employees
WHERE salary > 60000;Projeksiyon, bir ilişkiden belirli sütunları seçer ve kalanları atar. Yalnızca ilgilendiğiniz özelliklere indirgeme yoludur.
π attribute1, attribute2 (Relation)Tüm çalışanların sadece adlarını ve maaşlarını almak için:
π name, salary (Employees)Dikkat edilmesi gereken bir nokta, projeksiyonun sonuçtaki mükerrer satırları kaldırmasıdır. Ek sütunları attıktan sonra iki kayıt özdeşse, çıktıdaki yalnızca bir kopya tutulur.
Bunun SQL karşılığı şöyledir:
SELECT DISTINCT name, salary
FROM Employees;Birleşim, iki ilişkiyi tek bir ilişkide birleştirir ve tüm kayıtları bir araya getirir. Yinelenen satırlar otomatik olarak kaldırılır.
Gösterim:
Relation1 ∪ Relation2Ancak her iki ilişkinin de birleşime uygun olması gerekir. Yani aynı sayıda özelliğe sahip olmalı ve karşılık gelen özelliklerin veri tipleri aynı olmalıdır. Şemalar eşleşmediği için bir çalışan tablosu ile bir departman tablosunu birleştiremezsiniz.
Contractors adlı, Employees ile aynı yapıda bir tablonuz olduğunu varsayın. Union, her iki tablodaki tüm kişileri, tekrarlar olmadan verir:
Employees ∪ ContractorsBunun SQL karşılığı şöyledir:
SELECT * FROM Employees
UNION
SELECT * FROM Contractors;
Küme farkı, ilk ilişkide olup ikinci ilişkide bulunmayan kayıtları döndürür. Çıkarmaya benzetebilirsiniz:
Relation1 − Relation2Birleşimde olduğu gibi, her iki ilişkinin de birleşime uygun olması gerekir.
Yalnızca yüklenici (contractor) olmayan çalışanları istiyorsanız, sözdizimi şöyle olurdu:
Employees − ContractorsSonuç, Employees’ta olup Contractors’ta eşleşmesi olmayan satırlardan oluşur.
SQL karşılığı:
SELECT * FROM Employees
EXCEPT
SELECT * FROM Contractors;
Kartezyen çarpım, ilk ilişkideki her kaydı ikinci ilişkideki her kayıtla birleştirir. Employees 4 satıra ve Departments 3 satıra sahipse, sonuç 4 × 3 = 12 satır olur.
Employees × DepartmentsTek başına pek kullanışlı değildir — çalışanlar ve departmanların birbiriyle ilgisi olmayan tüm olası kombinasyonlarını elde edersiniz. Ancak kartezyen çarpım, join’lerin temelidir. Mantıklı ilişkiye sahip satırları tutmak için bunu bir seçim işlemiyle eşlersiniz.
SQL karşılığı:
SELECT * FROM Employees, Departments;Bu beş operatör temel zemindir. İlişkisel cebirde diğer her şey, bunların birleşimi için bir kısaltmadır.
Join’ler ilişkisel cebirde en çok kullanılan işlemlerdir — ve göründükleri kadar gizemli değillerdir.
Her join, bir kartezyen çarpımın ardından bir seçimden ibarettir. İki ilişkideki tüm kayıtları birleştirir, sonra koşulu sağlamayanları elersiniz. Join’ler, önce tam bir kartezyen çarpım yapmak maliyetli olduğu için kısaltma olarak vardır. Join, koşulu birleşim sırasında uygular ve ara sonuçların boyutunu azaltır.
Doğal birleşim, adaş olan tüm özellikler üzerinden iki ilişkiyi otomatik olarak birleştirir ve sonuçta bu ortak sütunların yalnızca bir kopyasını tutar:
Employees ⋈ DepartmentsHer iki tablo da department_id’yi paylaştığı için, doğal birleşim bu değerin eşit olduğu satırları eşleştirir ve birleştirir. Alice (department_id = 10) Mühendislikle, Bob Pazarlamayla vb. eşleşir.
Yazılacak bir koşul yoktur — join bunu şemadan çıkarır. Bu kullanışlıdır ama aynı zamanda bir sütunu yeniden adlandırmanın sorgunuzu bozabileceği anlamına gelir.
Bunun SQL karşılığı şöyledir:
SELECT * FROM Employees
NATURAL JOIN Departments;
Teta birleşim, belirttiğiniz herhangi bir koşula göre iki ilişkiyi birleştirir — koşul, =, ≠, <, >, ≤, ≥ gibi herhangi bir karşılaştırma operatörünü kullanabilir.
Employees ⋈ salary > 60000 AND department_id = department_id DepartmentsBu, join koşulu üzerinde tam denetim sağlar. Pratikte yazdığınız çoğu join, perde arkasında bir teta birleşimidir.
Bunun SQL karşılığı şöyledir:
SELECT * FROM Employees, Departments
WHERE Employees.salary > 60000
AND Employees.department_id = Departments.department_id;
Eşitlik birleşimi, koşulun yalnızca eşitlik (=) kullandığı bir teta birleşimidir. En yaygın türdür.
Employees ⋈ Employees.department_id = Departments.department_id DepartmentsSonuç, her iki tablodan tüm sütunları içerir; bu da department_id’nin iki kez göründüğü anlamına gelir. Doğal birleşimden temel farkı budur — eşitlik birleşimi mükerrer sütunları kaldırmaz.
Bunun SQL karşılığı şöyledir:
SELECT * FROM Employees
INNER JOIN Departments
ON Employees.department_id = Departments.department_id;Yukarıdaki join’ler yalnızca her iki ilişkide de eşleşen satırları döndürür. Dış birleşim, eşleşmeyen satırları da tutar ve eksik değerler için NULL doldurur.
Üç varyant vardır:
Sol dış birleşim (⟕) sol ilişkideki tüm satırları tutar. Employees’taki bir satırın eşleşen departmanı yoksa bile, sonuçta departman sütunlarında NULL ile görünür.
Sağ dış birleşim (⟖) sağ ilişkideki tüm satırları tutar. Çalışanı olmayan departmanlar yine de görünür; çalışan sütunları NULL olur.
Tam dış birleşim (⟗) her iki ilişkiden de tüm satırları tutar. Her iki taraftan da eşleşmeyen satırlar, eksik değerler için NULL ile görünür.
Bunların SQL karşılıkları şöyledir:
-- Left outer join
SELECT * FROM Employees
LEFT JOIN Departments
ON Employees.department_id = Departments.department_id;

-- Right outer join
SELECT * FROM Employees
RIGHT JOIN Departments
ON Employees.department_id = Departments.department_id;

-- Full outer join
SELECT * FROM Employees
FULL OUTER JOIN Departments
ON Employees.department_id = Departments.department_id;
Eşleşmesi olmayan satırları kaybetmeyi göze alamadığınızda — örneğin, sistemde departmanı bulunsun ya da bulunmasın tüm çalışanların tam listesini gerektiğinde — dış birleşimleri kullanın.
Türetilmiş operatörler, önceki beş temel operatörden oluşturulmuş kısaltmalardır.
Kesişim, yalnızca her iki ilişkide de bulunan kayıtları döndürür. Birleşim ve küme farkında olduğu gibi, her iki ilişkinin de birleşime uygun olması gerekir.
Employees ∩ ContractorsBir çalışan aynı zamanda yükleniciyse, sonuçta görünür. Diğer herkes elenir.
Perde arkasında kesişim, iki kez uygulanan küme farkından ibarettir:
Employees ∩ Contractors = Employees − (Employees − Contractors)Bunun SQL karşılığı şöyledir:
SELECT * FROM Employees
INTERSECT
SELECT * FROM Contractors;
Bölüm operatörü, çoğu bilgisayar bilimi öğrencisi ve yeni başlayanları zorlar — ancak kavram göründüğünden daha basittir.
Bölüm şu soruyu yanıtlar: "A ilişkisindeki hangi kayıtlar, B ilişkisindeki tüm kayıtlarla ilişkilidir?"
CourseEnrollments tablosunun öğrencilerin hangi derslere kayıtlı olduğunu izlediğini ve RequiredCourses tablosunun öğrencinin tamamlaması gereken tüm dersleri listelediğini varsayın. Bölüm, tüm zorunlu derslere kayıtlı öğrencileri verir.
CourseEnrollments ÷ RequiredCoursesZor sayılmasının nedeni şu: Doğrudan bir SQL karşılığı yoktur. Bölümü SQL’de yinelemek için çift olumsuzlama gerekir — "aldığı zorunlu ders olmayan hiçbir ders kalmayacak öğrencileri bul":
SELECT DISTINCT student_id FROM CourseEnrollments ce1
WHERE NOT EXISTS (
    SELECT course_id FROM RequiredCourses rc
    WHERE NOT EXISTS (
        SELECT * FROM CourseEnrollments ce2
        WHERE ce2.student_id = ce1.student_id
        AND ce2.course_id = rc.course_id
    )
);
Bu çift NOT EXISTS kalıbı, bölümün SQL’deki standart ifadesidir. Bir mülakatta "her Y ile ilişkili tüm X’leri bul" diyen bir soru görürseniz, başvurmanız gereken operatör bölümdür.
Yeniden adlandırma, bir ilişkiye veya onun özelliklerine yeni bir ad vermenize olanak tanır. Veriyi değil, yalnızca adlandırmayı değiştirir.
ρ NewName (Relation)Ya da hem ilişkiyi hem de özelliklerini yeniden adlandırmak için:
ρ NewName(attr1, attr2, ...) (Relation)Yeniden adlandırma, bir tabloyu kendisiyle birleştirmeniz gerektiğinde kullanışlıdır — aksi halde özellik adları çakışır ve işlem anlamsızlaşır. Ayrıca işlemleri zincirlerken ara sonuçlara anlamlı adlar vermek istediğinizde de faydalıdır.
Bunun SQL karşılığı şöyledir:
SELECT * FROM Employees AS E1;
-- veya sütunları yeniden adlandırma:
SELECT employee_id AS id, name AS employee_name FROM Employees;
Bu üç operatörü ezberlemek gerekir. Kesişim ve yeniden adlandırma kolaydır; bölüm ise herhangi bir veritabanı mülakatından önce pratik yapmaya değer olandır.
SQL ve ilişkisel cebir aynı şey değildir — ancak SQL onsuz var olamazdı.
Temel fark, her birinin sorguları nasıl ele aldığına dayanır. İlişkisel cebir yordamlıdır — sonucu elde etmek için işlemlerin tam sırasını belirtirsiniz. SQL bildirimseldir — istediğiniz sonucu tarif eder, veritabanı motoru da oraya nasıl ulaşacağını bulur.
Basit bir örnek ele alalım. İlişkisel cebirde Mühendislik (Engineering) çalışanlarını getirmek şöyle görünür:
π name, salary (σ department_id = 10 (Employees))Veritabanına tam olarak ne yapacağını söylersiniz: önce satırları filtrele, sonra sütunları seç. İşlem sırası açıktır.
SQL’de ise şöyle yazarsınız:
SELECT name, salary
FROM Employees
WHERE department_id = 10;
İstediğiniz sonucu tarif edersiniz. Veritabanı motoru bunu bir işlem dizisine çevirir — ve bu dahili işlemler ilişkisel cebir üzerine kuruludur.
İkisi arasındaki ilişki budur. SQL kullanıcıya dönük dildir; ilişkisel cebir ise onun altındaki kuramsal modeldir. Veritabanı motoru bir SQL sorgusu aldığında, bunu ilişkisel cebire dayalı bir iç temsile ayrıştırır, optimize eder ve ardından yürütür.
SQL ayrıca ilişkisel cebirin tanımladığının ötesine geçer. İlişkisel cebirde şu kavramlar yoktur:
Toplama (Aggregation) - SUM(), COUNT(), AVG()
Gruplama - GROUP BY
Sıralama - ORDER BY
Çoğaltma işleme - ilişkisel cebir kümelerle (tekrar yok) çalışır; SQL ise çok-kümelerle (varsayılan olarak tekrarlar serbest) çalışır
Bu özellikler, gerçek dünya sorgulama ihtiyaçları nedeniyle SQL’e eklenmiştir. Ancak hepsi ilişkisel cebir temelinin üzerine oturur.
Özetle, ilişkisel cebiri anlamak SQL sorgularınızın içeride nasıl yapılandığını ve dönüştürüldüğünü gösterir. Günlük SQL yazma biçiminizi değiştirmeyebilir, ancak sorgularınızın gerçekte ne yaptığını kavrayışınızı değiştirir.
İlişkisel cebirle ilgili karışıklıkların çoğu, birkaç yinelenen yanlış anlamaya dayanır. Bunları tek tek ele alayım.
SQL ile ilişkisel cebiri aynı şey sanmak. Aynı değiller. SQL, ilişkisel cebirden esinlenmiştir ama birbirlerinin yerine geçmezler. SQL bildirimseldir ve ilişkisel cebirin tanımlamadığı toplama ve sıralama gibi özellikler içerir. İlişkisel cebir biçimsel bir modeldir; SQL ise onun üzerine inşa edilmiş pratik bir dildir.
Şema uyumluluğu gereksinimlerini unutmak. Birleşim (union), kesişim ve küme farkı, birleşime uygun ilişkiler gerektirir — aynı sayıda özellik, aynı sırada aynı veri tipleri. Şemaları farklı tablolar üzerinde bu operatörleri uygulamaya çalışmak işe yaramaz. Bu, join’lerde böyle bir gereksinim olmadığı için kafa karıştırır.
Bölüm operatörünü anlamamak. Bölümün doğrudan bir SQL karşılığı yoktur; bu yüzden insanları zorlar. "Her Y ile ilişkili tüm X’leri bul" diyen bir sorgu görürseniz, bu bölümdür. SQL çevirisi çift NOT EXISTS kalıbı gerektirir — bariz değildir, bu nedenle sınavdan veya mülakattan önce pratik yapmakta fayda var.
Join’leri bağımsız operatörler sanmak. Temel (primitif) değillerdir. Her join, bir kartezyen çarpım ile bir seçimin birleşimidir. Doğal, teta, eşitlik join — hepsi bu birleşimin kısaltmasıdır. Bunu anlamak, sonuçlar beklenmedik göründüğünde join davranışını öngörmeyi kolaylaştırır.
İlişkisel cebir, her ilişkisel veritabanı sisteminin kuramsal bel kemiğidir. SQL’de yazdığınız her sorgu, veritabanı motoru tek bir satıra dokunmadan önce bir dizi ilişkisel cebir işlemine çevrilir.
Operatörler — seçim, projeksiyon, birleşim, küme farkı, kartezyen çarpım ve bunların türevleri — bu çevirinin yapı taşlarıdır. Nasıl çalıştıklarını ve nasıl zincirlendiklerini anladığınızda, SQL’i bir kara kutu olarak görmekten vazgeçer, altındaki yapıyı görmeye başlarsınız.
İlişkisel cebiri öğrenmenin gerçek değeri de budur: Sorgularınızın gerçekte ne yaptığını anlamak — onları biçimsel gösterimde yazmak değil.
DataCamp ile Öğrenin
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



