Curso
Introducción a las bases de datos relacionales en SQL
4 h
199.9K
El álgebra relacional es un lenguaje de consultas procedimental. Le dice a la base de datos cómo recuperar los datos, no solo qué quieres.
Esa es la gran diferencia con SQL, que es declarativo. Cuando escribes una consulta SQL, describes el resultado que quieres. El álgebra relacional describe la secuencia exacta de operaciones para llegar a él.
Opera sobre relaciones (el término formal para tablas). Le pasas una o varias relaciones como entrada, aplicas una operación y obtienes otra relación como salida.
Esto último es la propiedad de clausura. Da igual qué operación apliques —filtrar filas, elegir columnas, combinar tablas—, el resultado siempre es otra relación. Esto importa porque te permite encadenar operaciones. La salida de una se convierte en la entrada de la siguiente, y puedes seguir apilándolas tanto como necesites.
Puedes pensar en el álgebra relacional como piezas de construcción. Cada pieza toma una tabla (o dos), le hace algo y te devuelve otra tabla. Los motores de bases de datos usan estas piezas internamente para descomponer y ejecutar tus consultas SQL.
Antes de trabajar con los operadores del álgebra relacional, necesitas conocer el vocabulario. La buena noticia es que solo hay cinco términos que recordar.
Relación es simplemente una tabla. Tiene filas y columnas, y representa un conjunto de datos sobre una entidad concreta, como empleados o departamentos. En álgebra relacional, cada operación recibe una o más relaciones como entrada y produce una relación como salida.
Tupla es una sola fila de esa tabla. Si tu tabla Employees tiene 10 filas, tiene 10 tuplas. Cada tupla representa un registro: un empleado, en este caso.
Atributo es una columna. La tabla Employees puede tener atributos como employee_id, name y department_id. Los atributos definen qué tipo de datos contiene cada tupla.
Grado es el número de atributos de una relación. Si Employees tiene cinco columnas, su grado es 5. Importa al combinar relaciones: algunas operaciones requieren grados coincidentes.
Cardinalidad es el número de tuplas de una relación. Si tu tabla Employees tiene 200 filas, su cardinalidad es 200. La cardinalidad cambia cuando añades o eliminas filas; el grado solo cambia cuando añades o eliminas columnas.
Así se corresponden estos términos con lo que ya conoces:
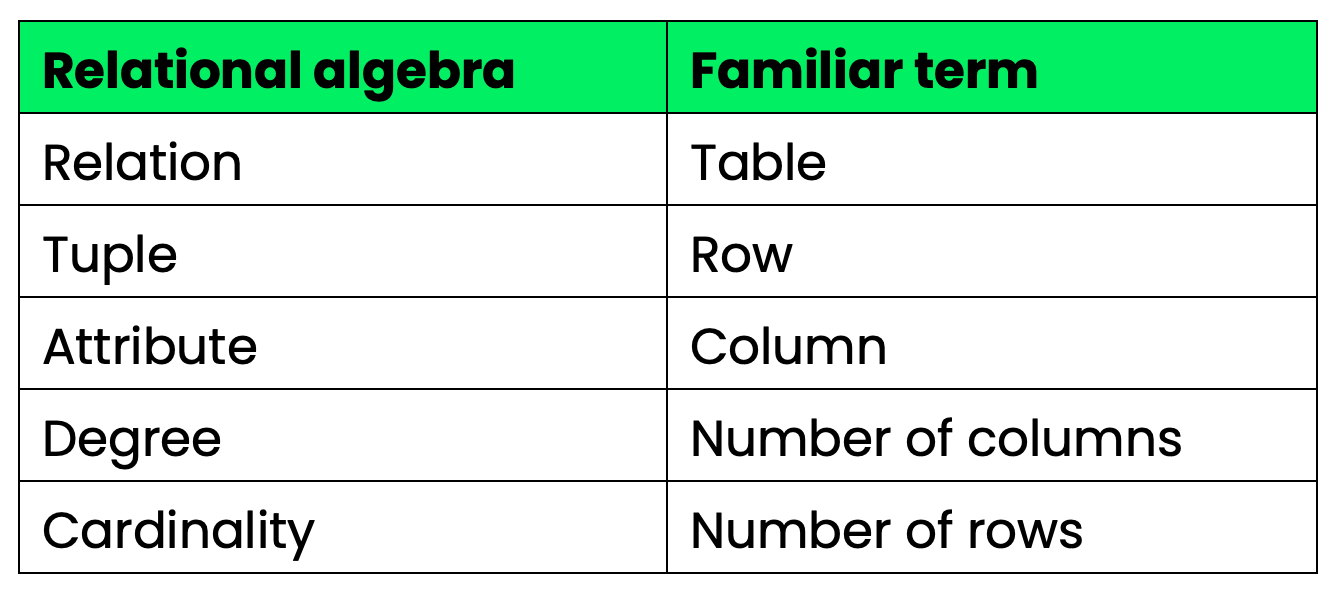
Álgebra relacional frente a términos comunes
Asegúrate de asimilar esto y verás que los operadores encajan de forma natural.
Hay cinco operadores fundamentales en álgebra relacional. Todo lo demás —joins, intersección, división— se construye sobre ellos.
Para mantener los ejemplos consistentes, usaré dos tablas en toda esta sección:
Employees
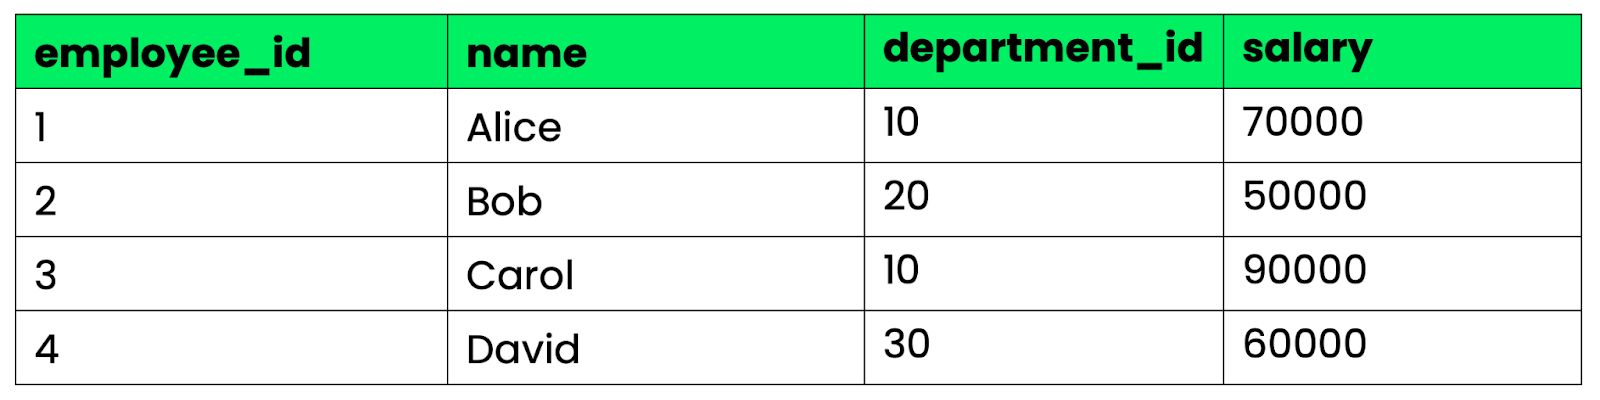
Tabla Employees
Departments
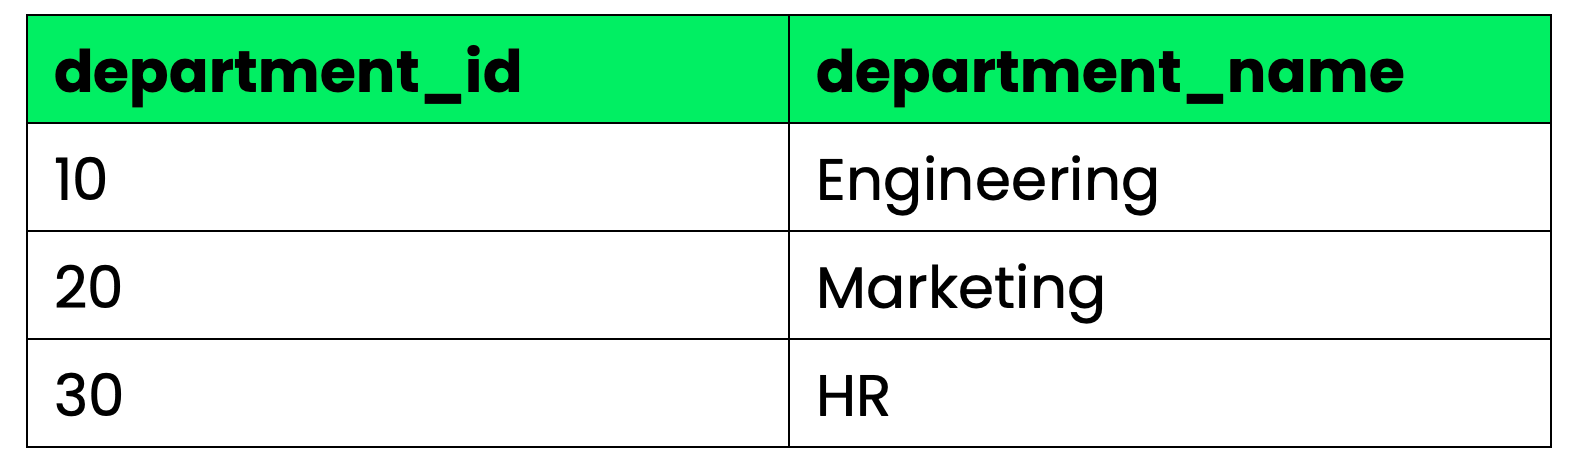
Tabla Departments
La selección filtra filas en función de una condición. Es el equivalente en álgebra relacional de una cláusula WHERE.
La notación es así:
σ condition (Relation)Imagina que quieres todas las personas empleadas con salario superior a 60.000:
σ salary > 60000 (Employees)El resultado es una nueva relación solo con las filas que cumplen la condición: Alice y Carol. La estructura de la tabla no cambia; simplemente eliminas las filas que no la cumplen.
Equivalente en SQL:
SELECT * FROM Employees
WHERE salary > 60000;La proyección selecciona columnas concretas de una relación y descarta el resto. Sirve para reducir una tabla a solo los atributos que te interesan.
π attribute1, attribute2 (Relation)Para obtener solo los nombres y salarios de todas las personas empleadas:
π name, salary (Employees)Ojo: la proyección elimina filas duplicadas del resultado. Si dos tuplas quedan idénticas tras quitar columnas, solo una aparecerá en la salida.
Equivalente en SQL:
SELECT DISTINCT name, salary
FROM Employees;La unión combina dos relaciones en una, uniendo todas sus tuplas. Las filas duplicadas se eliminan automáticamente.
Notación:
Relation1 ∪ Relation2La condición es que ambas relaciones deben ser unión-compatibles: mismo número de atributos y tipos de datos correspondientes. No puedes unir una tabla de empleados con una de departamentos si los esquemas no coinciden.
Supón que tienes una tabla Contractors con la misma estructura que Employees. La unión te devuelve todas las personas de ambas tablas, sin duplicados:
Employees ∪ ContractorsEquivalente en SQL:
SELECT * FROM Employees
UNION
SELECT * FROM Contractors;La diferencia devuelve las tuplas que existen en la primera relación pero no en la segunda. Piensa en ello como una resta:
Relation1 − Relation2Como en la unión, ambas relaciones deben ser unión-compatibles.
Si quieres todas las personas empleadas que no son contratistas, la sintaxis sería:
Employees − ContractorsEl resultado contiene solo las filas de Employees que no tienen correspondencia en Contractors.
Equivalente en SQL:
SELECT * FROM Employees
EXCEPT
SELECT * FROM Contractors;Un producto cartesiano combina cada tupla de la primera relación con cada tupla de la segunda. Si Employees tiene 4 filas y Departments tiene 3, el resultado tiene 4 × 3 = 12 filas.
Employees × DepartmentsPor sí solo, el resultado rara vez es útil: obtienes todas las combinaciones posibles de empleados y departamentos, incluidas las que no tienen relación. Pero el producto cartesiano es la base de los joins. Lo combinas con una selección para quedarte solo con las filas donde la relación tiene sentido.
Equivalente en SQL:
SELECT * FROM Employees, Departments;Estos cinco operadores son la base. Todo lo demás en álgebra relacional es una abreviatura de combinarlos.
Los joins son las operaciones más usadas en álgebra relacional, y no son tan misteriosos como parecen.
Todo join es solo un producto cartesiano seguido de una selección. Combinas todas las tuplas de dos relaciones y después filtras las que no cumplen una condición. Los joins existen como atajo porque hacer primero un producto cartesiano completo es costoso. Un join aplica la condición durante la combinación, lo que reduce el tamaño de los resultados intermedios.
El join natural une automáticamente dos relaciones por todos los atributos que tienen el mismo nombre, y mantiene una sola copia de esas columnas compartidas en el resultado:
Employees ⋈ DepartmentsComo ambas tablas comparten department_id, el join natural empareja filas donde ese valor es igual y las fusiona. Alice (department_id = 10) se une con Engineering, Bob con Marketing, etc.
No hay que escribir ninguna condición: el join la deduce del esquema. Es cómodo, pero también implica que renombrar una columna puede romper tu consulta.
Equivalente en SQL:
SELECT * FROM Employees
NATURAL JOIN Departments;El theta join une dos relaciones en base a cualquier condición que especifiques: puede usar operadores de comparación como =, ≠, <, >, ≤, ≥.
Employees ⋈ salary > 60000 AND department_id = department_id DepartmentsTe da control total sobre la condición del join. La mayoría de joins que escribes en la práctica son theta joins por debajo.
Equivalente en SQL:
SELECT * FROM Employees, Departments
WHERE Employees.salary > 60000
AND Employees.department_id = Departments.department_id;El equi join es un theta join cuya condición usa solo igualdad (=). Es el más común.
Employees ⋈ Employees.department_id = Departments.department_id DepartmentsEl resultado incluye todas las columnas de ambas tablas, por lo que department_id aparece dos veces. Esa es la principal diferencia con el join natural: el equi join no elimina columnas duplicadas.
Equivalente en SQL:
SELECT * FROM Employees
INNER JOIN Departments
ON Employees.department_id = Departments.department_id;Los joins anteriores solo devuelven filas cuando hay coincidencia en ambas relaciones. El outer join conserva también las filas sin correspondencia, rellenando con NULL los valores que faltan.
Hay tres variantes:
Left outer join (⟕) mantiene todas las filas de la relación izquierda. Si una fila en Employees no tiene departamento coincidente, sigue apareciendo con NULL en las columnas del departamento.
Right outer join (⟖) mantiene todas las filas de la relación derecha. Los departamentos sin empleados también aparecen, con NULL en las columnas de empleados.
Full outer join (⟗) mantiene todas las filas de ambas relaciones. Las filas sin correspondencia de cualquiera de los lados aparecen con NULL en los valores que faltan.
Equivalentes en SQL:
-- Left outer join
SELECT * FROM Employees
LEFT JOIN Departments
ON Employees.department_id = Departments.department_id;

-- Right outer join
SELECT * FROM Employees
RIGHT JOIN Departments
ON Employees.department_id = Departments.department_id;

-- Full outer join
SELECT * FROM Employees
FULL OUTER JOIN Departments
ON Employees.department_id = Departments.department_id;
Usa outer joins cuando no te puedes permitir perder filas sin correspondencia, por ejemplo si necesitas la lista completa de personas empleadas aunque su departamento no exista en el sistema.
Los operadores derivados son atajos construidos a partir de los cinco básicos que hemos visto.
La intersección devuelve solo las tuplas que aparecen en ambas relaciones. Como en la unión y la diferencia, ambas deben ser unión-compatibles.
Employees ∩ ContractorsSi una persona empleada también es contratista, aparecerá en el resultado. Las demás se descartan.
Internamente, la intersección es solo una diferencia aplicada dos veces:
Employees ∩ Contractors = Employees − (Employees − Contractors)Equivalente en SQL:
SELECT * FROM Employees
INTERSECT
SELECT * FROM Contractors;La división es el operador que más confunde a estudiantes y perfiles junior, pero el concepto es más simple de lo que parece.
La división responde a la pregunta: «¿qué tuplas de la relación A están asociadas con todas las tuplas de la relación B?»
Imagina una tabla CourseEnrollments que registra en qué cursos está matriculado cada estudiante, y una tabla RequiredCourses con todos los cursos obligatorios. La división te devuelve los estudiantes matriculados en todos los cursos obligatorios.
CourseEnrollments ÷ RequiredCoursesPor qué se considera complicada: no hay un equivalente directo en SQL. Para replicar la división en SQL, necesitas una doble negación: «encuentra estudiantes para los que no exista ningún curso obligatorio que no hayan hecho»:
SELECT DISTINCT student_id FROM CourseEnrollments ce1
WHERE NOT EXISTS (
    SELECT course_id FROM RequiredCourses rc
    WHERE NOT EXISTS (
        SELECT * FROM CourseEnrollments ce2
        WHERE ce2.student_id = ce1.student_id
        AND ce2.course_id = rc.course_id
    )
);
Ese patrón doble con NOT EXISTS es la forma estándar de expresar la división en SQL. Si en una entrevista ves «encuentra todas las X relacionadas con todas las Y», piensa en división.
El renombrado te permite dar un nombre nuevo a una relación o a sus atributos. No cambia los datos, solo cómo los llamas.
ρ NewName (Relation)O para renombrar la relación y sus atributos:
ρ NewName(attr1, attr2, ...) (Relation)El renombrado es útil cuando necesitas unir una tabla consigo misma: sin él, los nombres de los atributos colisionarían y la operación no tendría sentido. También ayuda al encadenar operaciones si quieres dar nombres significativos a los resultados intermedios.
Equivalente en SQL:
SELECT * FROM Employees AS E1;
-- o renombrando columnas:
SELECT employee_id AS id, name AS employee_name FROM Employees;
Estos tres operadores hay que memorizarlos. Intersección y renombrado son sencillos; la división merece práctica antes de cualquier entrevista sobre bases de datos.
SQL y álgebra relacional no son lo mismo, pero SQL no existiría sin ella.
La diferencia clave está en cómo conciben las consultas. El álgebra relacional es procedimental: especificas la secuencia exacta de operaciones para obtener el resultado. SQL es declarativo: describes qué resultado quieres y el motor decide cómo conseguirlo.
Un ejemplo sencillo. En álgebra relacional, recuperar las personas de Engineering sería así:
π name, salary (σ department_id = 10 (Employees))Le estás diciendo a la base de datos exactamente qué hacer: primero filtra filas, luego escoge columnas. El orden de las operaciones es explícito.
En SQL escribirías:
SELECT name, salary
FROM Employees
WHERE department_id = 10;
Estás describiendo el resultado que quieres. El motor lo traduce a una secuencia de operaciones, y esas operaciones internas se basan en álgebra relacional.
Esa es la relación entre ambas. SQL es el lenguaje de cara al usuario; el álgebra relacional es el modelo teórico que hay debajo. Cuando un motor recibe una consulta SQL, la analiza a una representación interna basada en álgebra relacional, la optimiza y la ejecuta.
SQL también va mucho más allá de lo que define el álgebra relacional. El álgebra relacional no contempla:
Agregación - SUM(), COUNT(), AVG()
Agrupación - GROUP BY
Ordenación - ORDER BY
Gestión de duplicados - el álgebra relacional trabaja con conjuntos (sin duplicados); SQL trabaja con multisets (duplicados permitidos por defecto)
Estas funcionalidades se añadieron a SQL porque en el mundo real hacen falta. Pero se apoyan en la base del álgebra relacional.
En resumen, entender el álgebra relacional te explica cómo se estructuran y transforman internamente tus consultas SQL. No cambiará cómo escribes SQL en el día a día, pero sí cómo razonas sobre lo que hacen realmente tus consultas.
La mayoría de confusiones con el álgebra relacional se reducen a unos pocos malentendidos recurrentes. Vamos a verlos.
Tratar SQL y álgebra relacional como lo mismo. No lo son. SQL se inspira en el álgebra relacional, pero no son intercambiables. SQL es declarativo e incluye funciones como agregación y ordenación que el álgebra relacional no define. El álgebra relacional es un modelo formal; SQL es un lenguaje práctico construido sobre él.
Olvidar los requisitos de compatibilidad de esquema. Unión, intersección y diferencia de conjuntos requieren relaciones unión-compatibles: mismo número de atributos y tipos en el mismo orden. Intentar aplicarlas a tablas con esquemas distintos no funciona. Esto confunde porque los joins no tienen ese requisito.
No entender el operador de división. La división es el único operador sin equivalente directo en SQL, por eso cuesta. Si ves una consulta del tipo «encuentra todas las X asociadas a todas las Y», es división. La traducción a SQL requiere el patrón doble con NOT EXISTS: no es obvio, así que conviene practicarlo antes de un examen o entrevista.
Pensar que los joins son operadores primitivos. No lo son. Todo join es un producto cartesiano combinado con una selección. Join natural, theta join, equi join: todos son atajos de esa combinación. Entenderlo hace más fácil predecir su comportamiento cuando los resultados sorprenden.
El álgebra relacional es la columna vertebral teórica de todo sistema de bases de datos relacionales. Cada consulta que escribes en SQL se traduce a una secuencia de operaciones de álgebra relacional antes de que el motor toque una sola fila.
Los operadores —selección, proyección, unión, diferencia de conjuntos, producto cartesiano y sus derivados— son las piezas básicas de esa traducción. Cuando entiendes cómo funcionan y cómo se encadenan, dejas de ver SQL como una caja negra y empiezas a ver la estructura que hay debajo.
Ese es el verdadero valor de aprender álgebra relacional: entender lo que hacen tus consultas, no escribirlas en notación formal.
Aprende con DataCamp
Curso
Curso
Programa
blog
Elena Kosourova
15 min
blog
Javier Canales Luna
15 min
Tutorial
Sejal Jaiswal
15 min
Tutorial
Allan Ouko
9 min
Tutorial
Oluseye Jeremiah
13 min
Tutorial
Abid Ali Awan
13 min