
Last chance! 50% off DataCamp Premium
Sale ends in
रिलेशनल एल्ज़ब्रा एक प्रक्रियात्मक क्वेरी भाषा है। यह डेटाबेस को बताती है कि डेटा कैसे प्राप्त करना है, केवल यह नहीं कि क्या चाहिए।
यही SQL से मुख्य अंतर है, जो घोषणात्मक है। जब आप SQL क्वेरी लिखते हैं, तो आप मनचाहा परिणाम बताते हैं। रिलेशनल एल्ज़ब्रा वहां तक पहुँचने के लिए कार्यों के सटीक क्रम का वर्णन करती है।
यह रिलेशन पर काम करती है — टेबल के लिए औपचारिक शब्द। आप इसमें एक या अधिक रिलेशन इनपुट के रूप में देते हैं, कोई ऑपरेशन लागू करते हैं, और आउटपुट में एक रिलेशन ही प्राप्त होता है।
आखिरी हिस्सा क्लोज़र प्रॉपर्टी है। आप कोई भी ऑपरेशन लागू करें — पंक्तियाँ फिल्टर करना, कॉलम चुनना, टेबल मिलाना — परिणाम हमेशा एक और रिलेशन ही होता है। यह इसलिए महत्वपूर्ण है क्योंकि आप ऑपरेशनों को चेन कर सकते हैं। एक ऑपरेशन का आउटपुट अगले का इनपुट बनता है, और आप ज़रूरत के मुताबिक उन्हें परत-दर-परत जोड़ते जा सकते हैं।
रिलेशनल एल्ज़ब्रा को बिल्डिंग ब्लॉक्स की तरह समझें। हर ब्लॉक एक टेबल (या दो) लेता है, उस पर कुछ करता है, और आपको वापस एक टेबल देता है। डेटाबेस इंजन इन्हीं ब्लॉक्स का अंदरूनी तौर पर उपयोग करके आपकी SQL क्वेरियों को तोड़ते और चलाते हैं।
रिलेशनल एल्ज़ब्रा ऑपरेटरों के साथ काम करने से पहले, शब्दावली जानना आवश्यक है। अच्छी बात यह है कि याद रखने के लिए केवल पाँच शब्द हैं।
Relation बस एक टेबल है। इसमें पंक्तियाँ और कॉलम होते हैं, और यह किसी विशिष्ट इकाई — जैसे कर्मचारी या विभाग — के बारे में डेटा समुच्चय का निरूपण करती है। रिलेशनल एल्ज़ब्रा में हर ऑपरेशन एक या अधिक रिलेशन को इनपुट के रूप में लेता है और आउटपुट में एक रिलेशन देता है।
Tuple उस टेबल की एक एकल पंक्ति है। यदि आपकी Employees टेबल में 10 पंक्तियाँ हैं, तो उसमें 10 ट्यूपल हैं। प्रत्येक ट्यूपल एक रिकॉर्ड का प्रतिनिधित्व करता है — इस मामले में, एक कर्मचारी।
Attribute एक कॉलम है। Employees टेबल में employee_id, name और department_id जैसे एट्रिब्यूट हो सकते हैं। एट्रिब्यूट परिभाषित करते हैं कि हर ट्यूपल में किस प्रकार का डेटा होगा।
Degree किसी रिलेशन में एट्रिब्यूट्स की संख्या है। यदि Employees में पाँच कॉलम हैं, तो इसका डिग्री 5 है। यह तब महत्वपूर्ण होता है जब आप रिलेशनों को मिलाते हैं — कुछ ऑपरेशनों में डिग्री का मेल होना आवश्यक है।
Cardinality किसी रिलेशन में ट्यूपल्स की संख्या है। यदि आपकी Employees टेबल में 200 पंक्तियाँ हैं, तो उसकी कार्डिनैलिटी 200 है। कार्डिनैलिटी पंक्तियाँ जोड़ने/हटाने से बदलती है; डिग्री केवल कॉलम जोड़ने/हटाने पर बदलती है।
ये शब्द उन चीज़ों से इस प्रकार मेल खाते हैं जिन्हें आप पहले से जानते हैं:
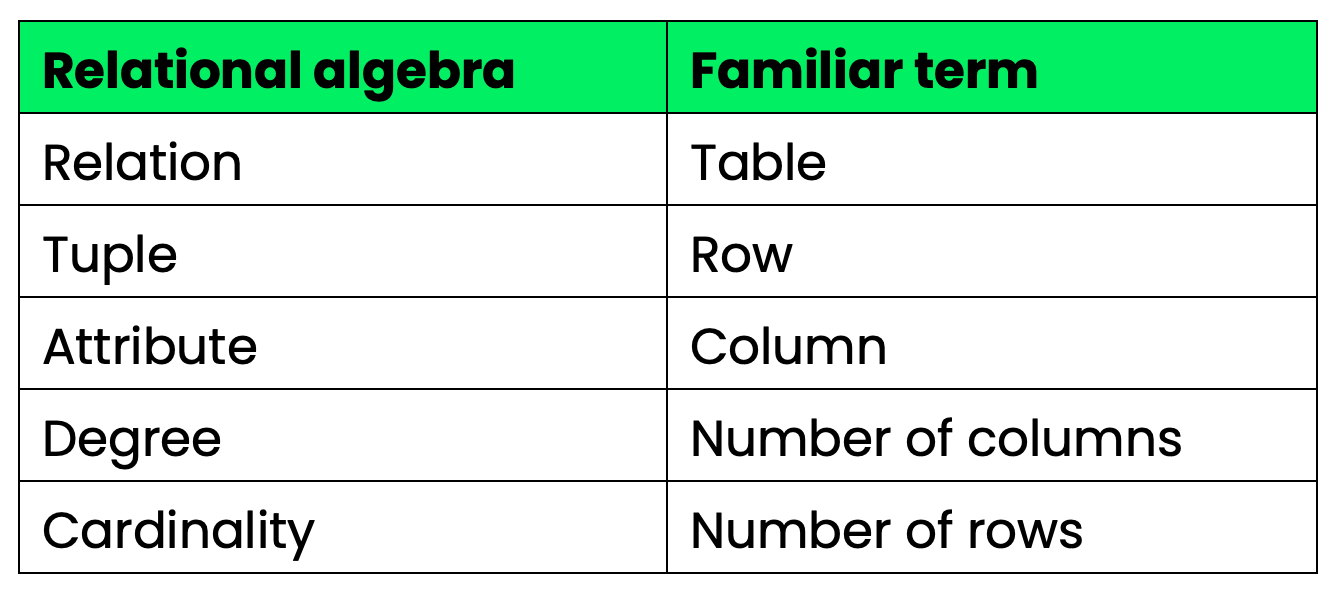
रिलेशनल एल्ज़ब्रा बनाम आम शब्द
पहले इन्हें अच्छे से समझ लें, फिर ऑपरेटर बिल्कुल स्पष्ट लगेंगे।
रिलेशनल एल्ज़ब्रा में पाँच मौलिक ऑपरेटर होते हैं। बाकी हर ऑपरेशन — joins, intersection, division — इन्हीं पर आधारित है।
उदाहरणों में निरंतरता बनाए रखने के लिए, इस खंड में मैं दो टेबलों का उपयोग करूँगा:
Employees
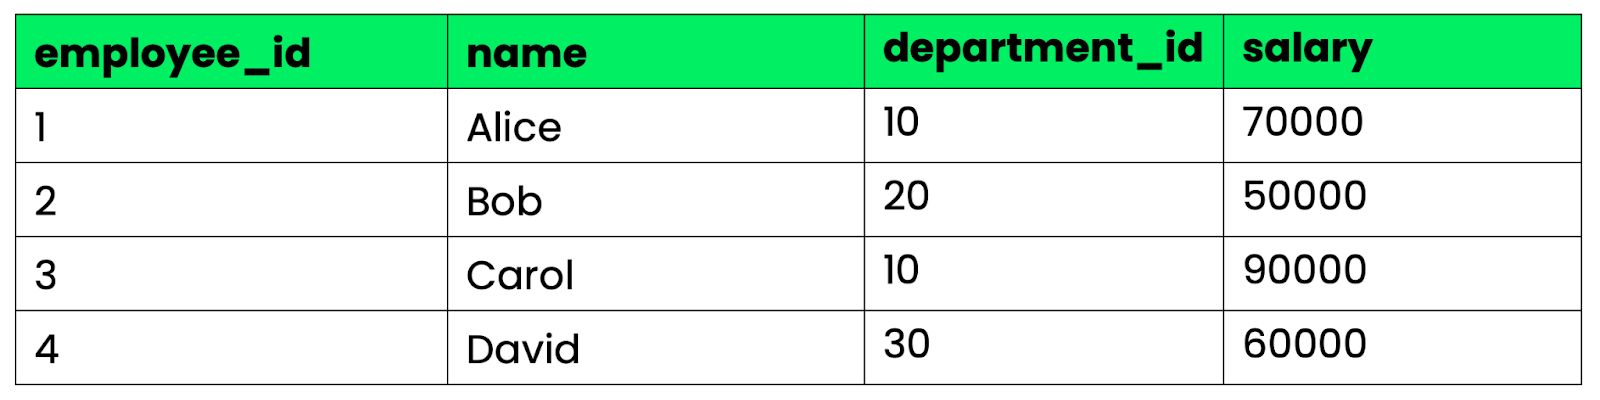
Employees टेबल
Departments
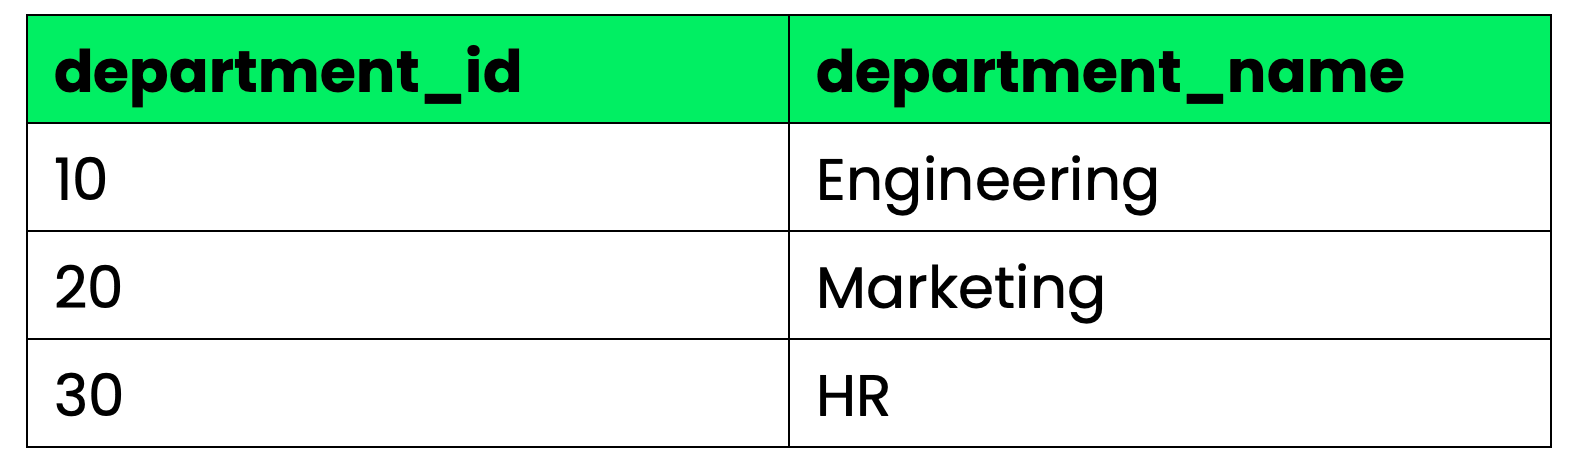
Departments टेबल
Selection किसी शर्त के आधार पर पंक्तियों को फिल्टर करती है। यह रिलेशनल एल्ज़ब्रा में WHERE क्लॉज़ के समकक्ष है।
नोटेशन इस तरह दिखता है:
σ condition (Relation)मान लें आप उन सभी कर्मचारियों को चाहते हैं जिनका वेतन 60,000 से अधिक है:
σ salary > 60000 (Employees)परिणाम एक नया रिलेशन है जिसमें केवल वही पंक्तियाँ होंगी जो मेल खाती हैं — Alice और Carol। टेबल की संरचना वही रहती है, यानी आप केवल वे पंक्तियाँ हटा रहे हैं जो शर्त पूरी नहीं करतीं।
यह SQL में इस प्रकार है:
SELECT * FROM Employees
WHERE salary > 60000;
Projection किसी रिलेशन से विशिष्ट कॉलम चुनती है और बाकी को हटा देती है। इससे आप टेबल को केवल उन एट्रिब्यूट्स तक सीमित करते हैं जिनकी आपको परवाह है।
π attribute1, attribute2 (Relation)सिर्फ सभी कर्मचारियों के नाम और वेतन पाने के लिए:
π name, salary (Employees)एक बात ध्यान रखने की है कि projection परिणाम से डुप्लिकेट पंक्तियाँ हटा देती है। यदि अतिरिक्त कॉलम हटाने के बाद दो ट्यूपल समान हो जाते हैं, तो आउटपुट में केवल एक ही कॉपी आती है।
यह SQL में इस प्रकार है:
SELECT DISTINCT name, salary
FROM Employees;
Union दो रिलेशनों को एक में मिलाकर उनके सभी ट्यूपल्स को जोड़ देती है। डुप्लिकेट पंक्तियाँ अपने-आप हट जाती हैं।
नोटेशन:
Relation1 ∪ Relation2शर्त यह है कि दोनों रिलेशन union-compatible होने चाहिए। यानी, एट्रिब्यूट्स की संख्या समान हो और संबंधित एट्रिब्यूट्स के डेटा प्रकार भी समान हों। आप कर्मचारी टेबल को विभाग टेबल से union नहीं कर सकते क्योंकि उनकी स्कीमा मेल नहीं खाती।
मान लें आपके पास Contractors नाम की टेबल है जिसकी संरचना Employees जैसी ही है। Union आपको दोनों टेबलों में मौजूद हर व्यक्ति देगा, बिना डुप्लिकेट्स के:
Employees ∪ Contractorsयह SQL में इस प्रकार है:
SELECT * FROM Employees
UNION
SELECT * FROM Contractors;
Set difference वे ट्यूपल लौटाती है जो पहले रिलेशन में तो हैं, लेकिन दूसरे में नहीं। इसे घटाव की तरह समझें:
Relation1 − Relation2Union की तरह, दोनों रिलेशन union-compatible होने चाहिए।
यदि आप वे सभी कर्मचारी चाहते हैं जो कॉन्ट्रैक्टर नहीं हैं, तो सिंटैक्स इस प्रकार होगा:
Employees − Contractorsपरिणाम में केवल वे पंक्तियाँ होंगी जो Employees में हैं और जिनका Contractors में कोई मेल नहीं है।
SQL समकक्ष:
SELECT * FROM Employees
EXCEPT
SELECT * FROM Contractors;
Cartesian product पहले रिलेशन के हर ट्यूपल को दूसरे रिलेशन के हर ट्यूपल के साथ जोड़ता है। यदि Employees में 4 पंक्तियाँ हैं और Departments में 3 पंक्तियाँ, तो परिणाम में 4 × 3 = 12 पंक्तियाँ होंगी।
Employees × Departmentsअपने आप में, परिणाम शायद ही उपयोगी होता है — आपको कर्मचारियों और विभागों के हर संभव संयोजन मिलते हैं, जिनमें वे भी शामिल हैं जिनका आपस में कोई संबंध नहीं। लेकिन Cartesian product ही joins की नींव है। आप इसे selection के साथ जोड़ते हैं ताकि केवल वे पंक्तियाँ रहें जहाँ संबंध अर्थपूर्ण हो।
SQL समकक्ष:
SELECT * FROM Employees, Departments;ये पाँच ऑपरेटर बुनियाद हैं। रिलेशनल एल्ज़ब्रा में बाकी सब इन्हें मिलाकर लिखे गए शॉर्टहैंड हैं।
Joins रिलेशनल एल्ज़ब्रा में सबसे ज़्यादा उपयोग होने वाले ऑपरेशन हैं — और वे दिखने में जितने पेचीदा लगते हैं, उतने हैं नहीं।
हर join बस एक Cartesian product के बाद selection है। आप दो रिलेशनों के सभी ट्यूपल्स को मिलाते हैं, फिर जो शर्त नहीं पूरी करते उन्हें फ़िल्टर कर देते हैं। joins शॉर्टहैंड के रूप में इसलिए हैं क्योंकि पहले पूरा Cartesian product बनाना महंगा होता है। join संयोजन के दौरान ही शर्त लागू कर देता है, जिससे मध्यवर्ती परिणामों का आकार घटता है।
Natural join अपने-आप उन सभी एट्रिब्यूट्स पर दो रिलेशनों को जोड़ता है जिनके नाम समान हैं, और परिणाम में उन साझा कॉलमों की केवल एक प्रति रखता है:
Employees ⋈ Departmentsक्योंकि दोनों टेबल में department_id साझा है, natural join उन पंक्तियों का मिलान करता है जहाँ वह मान बराबर है और उन्हें मिला देता है। Alice (department_id = 10) Engineering से मेल खाती है, Bob Marketing से, आदि।
यहाँ कोई शर्त लिखनी नहीं पड़ती — join स्कीमा से खुद पता लगा लेता है। यह सुविधाजनक है, लेकिन इसका मतलब यह भी है कि किसी कॉलम का नाम बदलना आपकी क्वेरी तोड़ सकता है।
SQL समकक्ष:
SELECT * FROM Employees
NATURAL JOIN Departments;
Theta join दो रिलेशनों को किसी भी शर्त के आधार पर जोड़ता है जिसे आप निर्दिष्ट करें — शर्त में कोई भी तुलना ऑपरेटर हो सकता है: =, ≠, <, >, ≤, ≥.
Employees ⋈ salary > 60000 AND department_id = department_id Departmentsयह आपको join की शर्त पर पूरा नियंत्रण देता है। व्यवहार में आप जो अधिकांश joins लिखते हैं, वे भीतर से theta joins ही होते हैं।
SQL समकक्ष:
SELECT * FROM Employees, Departments
WHERE Employees.salary > 60000
AND Employees.department_id = Departments.department_id;
Equi join एक theta join है जिसमें शर्त केवल समानता (=) का उपयोग करती है। यह सबसे सामान्य प्रकार है।
Employees ⋈ Employees.department_id = Departments.department_id Departmentsपरिणाम में दोनों टेबलों के सभी कॉलम शामिल होते हैं, जिसका मतलब है कि department_id दो बार आता है। यही natural join से मुख्य अंतर है — equi join डुप्लिकेट कॉलम नहीं हटाता।
SQL समकक्ष:
SELECT * FROM Employees
INNER JOIN Departments
ON Employees.department_id = Departments.department_id;ऊपर दिए गए joins केवल वही पंक्तियाँ लौटाते हैं जहाँ दोनों रिलेशनों में मेल मौजूद हो। Outer join बिना मेल वाली पंक्तियाँ भी रखता है, और अनुपस्थित मानों के लिए NULL भरता है।
इसके तीन प्रकार हैं:
Left outer join (⟕) बाएँ रिलेशन की सभी पंक्तियाँ रखता है। यदि Employees में कोई पंक्ति ऐसे विभाग से नहीं मिलती, तो भी वह परिणाम में आती है और विभाग के कॉलम में NULL होता है।
Right outer join (⟖) दाएँ रिलेशन की सभी पंक्तियाँ रखता है। जिन विभागों में कोई कर्मचारी नहीं है, वे फिर भी दिखते हैं, और कर्मचारी के कॉलम में NULL होता है।
Full outer join (⟗) दोनों रिलेशनों की सभी पंक्तियाँ रखता है। किसी भी ओर से बिना मेल वाली पंक्तियाँ अनुपस्थित मानों के लिए NULL के साथ दिखाई देती हैं।
इनके SQL समकक्ष:
-- Left outer join
SELECT * FROM Employees
LEFT JOIN Departments
ON Employees.department_id = Departments.department_id;

-- Right outer join
SELECT * FROM Employees
RIGHT JOIN Departments
ON Employees.department_id = Departments.department_id;

-- Full outer join
SELECT * FROM Employees
FULL OUTER JOIN Departments
ON Employees.department_id = Departments.department_id;
Outer joins तब उपयोग करें जब आप बिना मेल वाली पंक्तियाँ खो नहीं सकते — जैसे जब आपको कर्मचारियों की पूरी सूची चाहिए, चाहे उनका विभाग सिस्टम में मौजूद हो या नहीं।
Derived ऑपरेटर वे शॉर्टकट हैं जो पहले कवर किए गए पाँच बुनियादी ऑपरेटरों से बने हैं।
Intersection केवल वे ट्यूपल लौटाती है जो दोनों रिलेशनों में मौजूद हों। Union और set difference की तरह, दोनों रिलेशन union-compatible होने चाहिए।
Employees ∩ Contractorsयदि कोई कर्मचारी कॉन्ट्रैक्टर भी है, तो वह परिणाम में दिखेगा। बाकी सभी हट जाते हैं।
अंदरूनी रूप से, intersection बस set difference को दो बार लागू करना है:
Employees ∩ Contractors = Employees − (Employees − Contractors)यह SQL में इस प्रकार है:
SELECT * FROM Employees
INTERSECT
SELECT * FROM Contractors;
Division वह ऑपरेटर है जो अधिकांश CS छात्रों और जूनियर्स को उलझा देता है — लेकिन अवधारणा उतनी जटिल नहीं है।
Division यह प्रश्न का उत्तर देती है: "रिलेशन A में कौन से ट्यूपल्स रिलेशन B के सभी ट्यूपल्स से संबंधित हैं?"
मान लें आपके पास CourseEnrollments टेबल है जो ट्रैक करती है कि कौन से छात्र किन पाठ्यक्रमों में नामांकित हैं, और RequiredCourses टेबल है जिसमें वे सभी पाठ्यक्रम सूचीबद्ध हैं जिन्हें किसी छात्र को पूरा करना है। Division आपको वे छात्र देती है जो हर आवश्यक पाठ्यक्रम में नामांकित हैं।
CourseEnrollments ÷ RequiredCoursesइसे पेचीदा इसलिए माना जाता है: इसका कोई सीधा SQL समकक्ष नहीं है। SQL में division दोहरी नकारात्मकता से व्यक्त करनी पड़ती है — "वे छात्र खोजें जिनके लिए ऐसा कोई आवश्यक पाठ्यक्रम नहीं है जिसे उन्होंने नहीं लिया है":
SELECT DISTINCT student_id FROM CourseEnrollments ce1
WHERE NOT EXISTS (
    SELECT course_id FROM RequiredCourses rc
    WHERE NOT EXISTS (
        SELECT * FROM CourseEnrollments ce2
        WHERE ce2.student_id = ce1.student_id
        AND ce2.course_id = rc.course_id
    )
);
वह दोहरा NOT EXISTS पैटर्न SQL में division व्यक्त करने का मानक तरीका है। यदि किसी इंटरव्यू में पूछा जाए "सभी Y से संबंधित सभी X खोजें," तो division वही ऑपरेटर है जिसे चुनना चाहिए।
Rename आपको किसी रिलेशन या उसके एट्रिब्यूट्स को नया नाम देने देता है। यह डेटा नहीं बदलता, सिर्फ नाम बदलता है।
ρ NewName (Relation)या रिलेशन और उसके एट्रिब्यूट्स दोनों का नाम बदलने के लिए:
ρ NewName(attr1, attr2, ...) (Relation)Rename तब उपयोगी है जब आपको किसी टेबल को खुद से जोड़ना हो — इसके बिना, एट्रिब्यूट नाम टकराएँगे और ऑपरेशन अर्थहीन हो जाएगा। यह तब भी काम आता है जब आप ऑपरेशनों को चेन कर रहे हों और चाहते हों कि मध्यवर्ती परिणामों के अर्थपूर्ण नाम हों।
SQL समकक्ष:
SELECT * FROM Employees AS E1;
-- या कॉलम का नाम बदलते हुए:
SELECT employee_id AS id, name AS employee_name FROM Employees;
इन तीन ऑपरेटरों को याद रखना ज़रूरी है। Intersection और renaming आसान हैं, और division वही है जिसे किसी भी डेटाबेस इंटरव्यू से पहले अभ्यास करना चाहिए।
SQL और रिलेशनल एल्ज़ब्रा एक जैसी चीज़ नहीं हैं — लेकिन SQL इनके बिना संभव नहीं होती।
मुख्य अंतर इस बात में है कि दोनों क्वेरियों के बारे में कैसे सोचते हैं। रिलेशनल एल्ज़ब्रा प्रक्रियात्मक है — आप परिणाम पाने के लिए कार्यों का सटीक क्रम बताते हैं। SQL घोषणात्मक है — आप बताते हैं कि आपको कौन सा परिणाम चाहिए, और डेटाबेस इंजन तय करता है कि वहाँ तक कैसे पहुँचना है।
एक सरल उदाहरण लें। रिलेशनल एल्ज़ब्रा में, Engineering के कर्मचारियों को प्राप्त करना इस तरह दिखता है:
π name, salary (σ department_id = 10 (Employees))आप डेटाबेस को बिल्कुल बता रहे हैं कि क्या करना है: पहले पंक्तियाँ फिल्टर करो, फिर कॉलम चुनो। ऑपरेशनों का क्रम स्पष्ट है।
SQL में, आप लिखते हैं:
SELECT name, salary
FROM Employees
WHERE department_id = 10;
आप वह परिणाम वर्णित कर रहे हैं जो चाहिए। डेटाबेस इंजन उसे ऑपरेशनों के क्रम में अनुवादित करता है — और वे अंदरूनी ऑपरेशन रिलेशनल एल्ज़ब्रा पर आधारित होते हैं।
दोनों के बीच संबंध यही है। SQL उपयोगकर्ता-उन्मुख भाषा है; रिलेशनल एल्ज़ब्रा इसका सैद्धांतिक आधार है। जब डेटाबेस इंजन कोई SQL क्वेरी प्राप्त करता है, तो वह उसे रिलेशनल एल्ज़ब्रा पर आधारित आंतरिक प्रतिनिधित्व में पार्स करता है, उसे अनुकूलित करता है, और फिर निष्पादित करता है।
SQL वहीँ से आगे भी जाता है जहाँ रिलेशनल एल्ज़ब्रा की परिभाषा समाप्त होती है। रिलेशनल एल्ज़ब्रा में इन अवधारणाओं का कोई स्थान नहीं है:
Aggregation - SUM(), COUNT(), AVG()
Grouping - GROUP BY
Ordering - ORDER BY
Duplicate handling - relational algebra works with sets (no duplicates); SQL works with multisets (duplicates allowed by default)
These features were added to SQL because real-world querying needs them. But they sit on top of the relational algebra foundation.
The bottom line is that understanding relational algebra tells you how your SQL queries are structured and transformed internally. It won't change how you write SQL day to day, but it will change how you reason about what your queries are actually doing.
Most confusions with relational algebra come down to a couple of recurring misunderstandings. Let me go through them.
Treating SQL and relational algebra as the same thing. They're not. SQL is inspired by relational algebra, but the two aren't interchangeable. SQL is declarative and includes features like aggregation and ordering that relational algebra doesn't define. Relational algebra is a formal model; SQL is a practical language built on top of it.
Forgetting schema compatibility requirements. Union, intersection, and set difference all require union-compatible relations - same number of attributes, same data types in the same order. Trying to apply these operators to tables with different schemas won't work. This confuses people because joins have no such requirement.
Not understanding the division operator. Division is the one operator with no direct SQL equivalent, which is why it trips people up. If you see a query that asks "find all X associated with every Y," that's division. The SQL translation requires a double NOT EXISTS pattern - it's not obvious, so it's worth practicing before an exam or interview.
Thinking joins are standalone operators. They're not primitives. Every join is a cartesian product combined with a selection. Natural join, theta join, equi join - all of them are shorthand for that combination. Understanding this makes join behavior much easier to predict when results look unexpected.
Relational algebra is the theoretical backbone of every relational database system. Every query you write in SQL gets translated into a sequence of relational algebra operations before the database engine touches a single row.
The operators - selection, projection, union, set difference, cartesian product, and their derived counterparts - are the building blocks of that translation. Once you understand how they work and how they chain together, you stop seeing SQL as a black box and start seeing the structure underneath it.
That's the real value of learning relational algebra: understanding what your queries are actually doing, and not writing them in formal notation.
DataCamp के साथ सीखें
कोर्स
कोर्स
लर्निंग पाथ
