Python'da Veri Tipleri
BasicSkill Level
4 sa
89.1K learners
Bu eğitimdeki kodu çevrimiçi olarak çalıştırın ve düzenleyin
Kodu çalıştır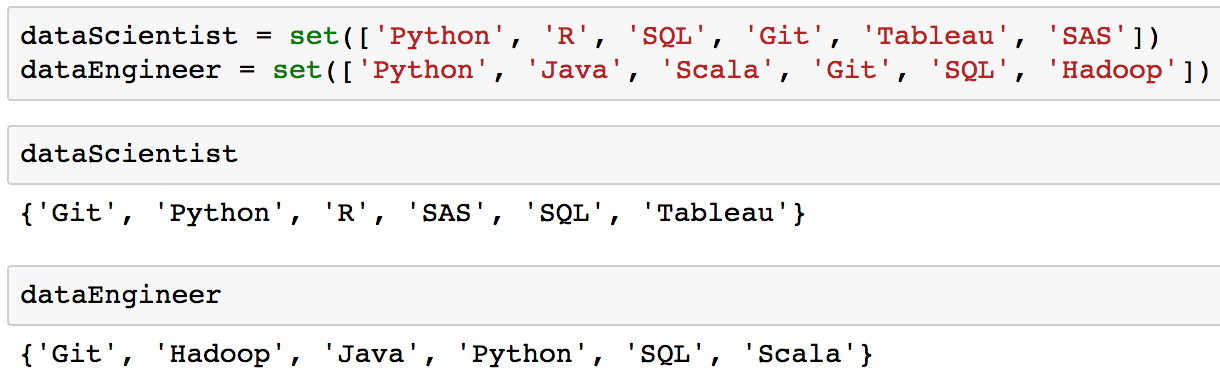
Yukarıdaki dataScientist ve dataEngineer değişkenlerinin çıktısına bakarsanız, kümedeki değerlerin eklenme sırasına göre olmadığını fark edersiniz. Bunun nedeni kümelerin sırasız olmasıdır.
Değer içeren kümeler süslü parantezler kullanılarak da başlatılabilir.
dataScientist = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
dataEngineer = {'Python', 'Java', 'Scala', 'Git', 'SQL', 'Hadoop'}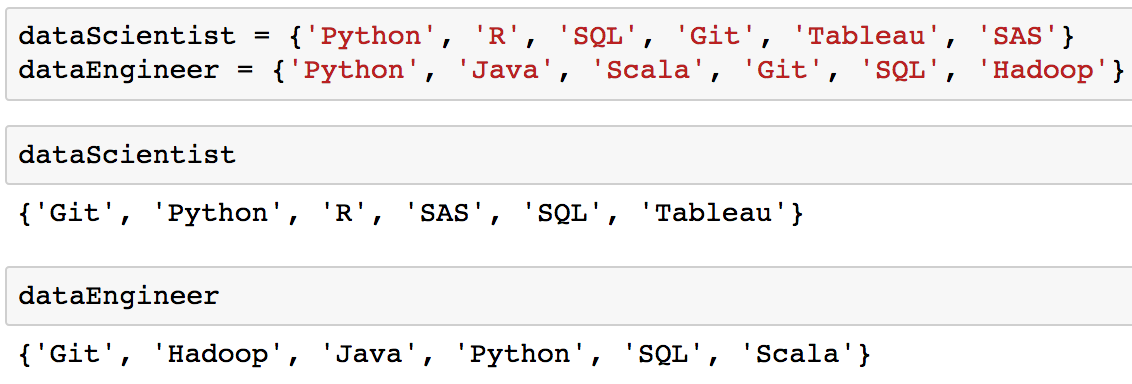
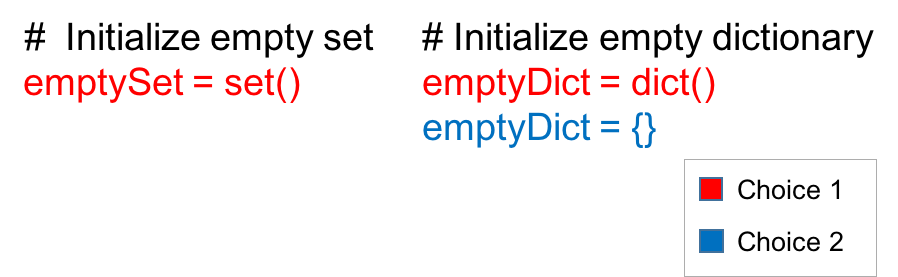
Süslü parantezlerin yalnızca değer içeren bir kümeyi başlatmak için kullanılabileceğini unutmayın. Aşağıdaki görsel, değer olmadan süslü parantez kullanmanın bir kümeyi değil, sözlüğü başlatmanın yollarından biri olduğunu gösterir.
Bir kümeye değer eklemek veya bir değeri kaldırmak için önce bir kümeyi başlatmanız gerekir.
# Değerlerle küme başlat
graphicDesigner = {'InDesign', 'Photoshop', 'Acrobat', 'Premiere', 'Bridge'}Bir kümeye değer eklemek için add yöntemini kullanabilirsiniz.
graphicDesigner.add('Illustrator')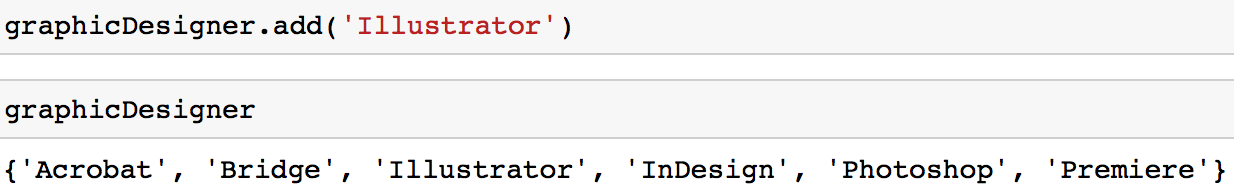
Yalnızca değiştirilemez (string veya demet gibi) bir değeri kümeye ekleyebileceğinizi unutmamak önemlidir. Örneğin, bir listeyi kümeye eklemeye çalışırsanız TypeError alırsınız.
graphicDesigner.add(['Powerpoint', 'Blender'])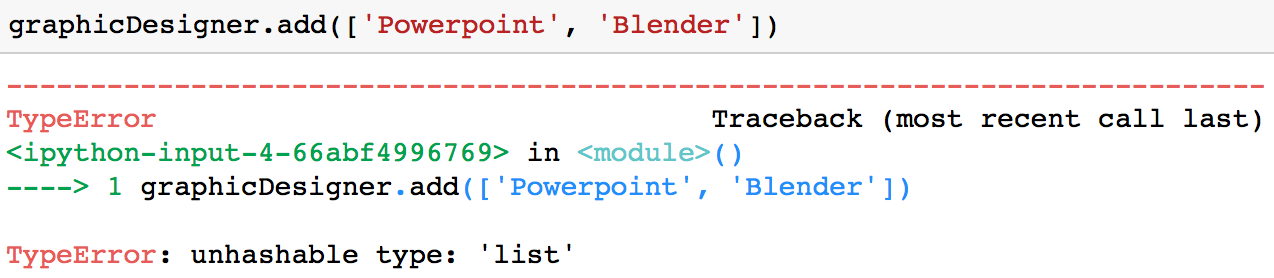
Bir kümeden bir değeri kaldırmanın birkaç yolu vardır.
Seçenek 1: Bir değeri kümeden kaldırmak için remove yöntemini kullanabilirsiniz.
graphicDesigner.remove('Illustrator')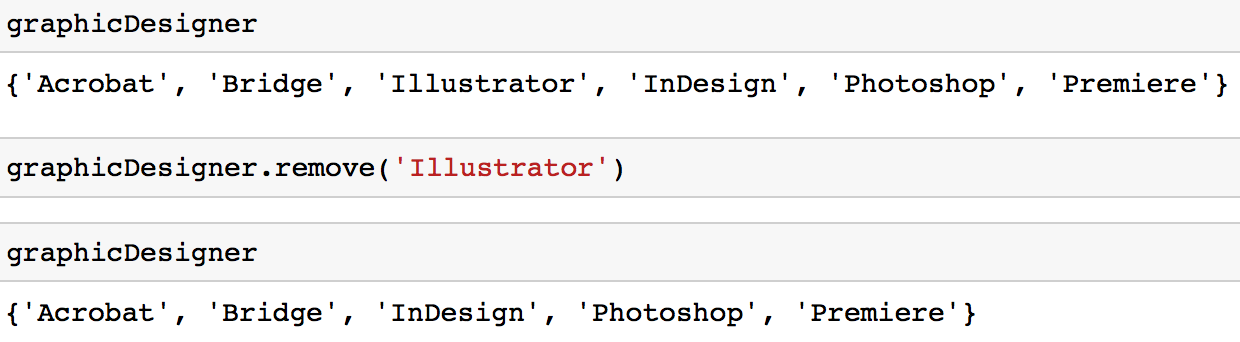
Bu yöntemin dezavantajı, kümenizde olmayan bir değeri kaldırmaya çalışırsanız KeyError hatası almanızdır.
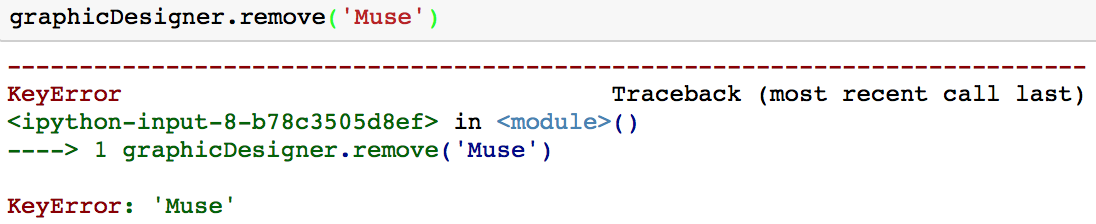
Seçenek 2: Bir değeri kümeden kaldırmak için discard yöntemini kullanabilirsiniz.
graphicDesigner.discard('Premiere')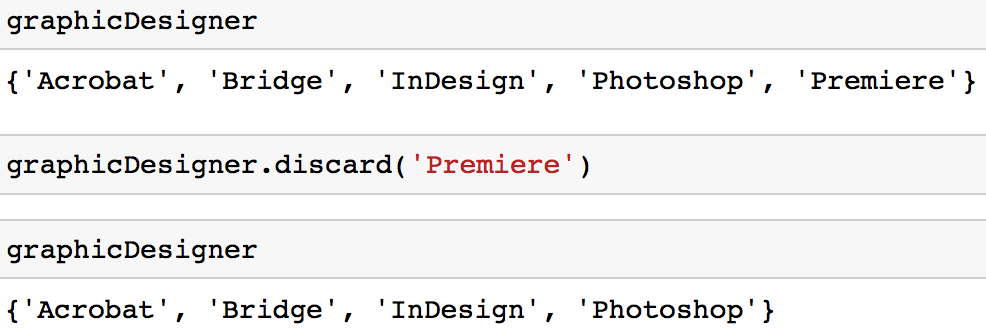
Bu yaklaşımın remove yöntemine göre avantajı, kümenin parçası olmayan bir değeri kaldırmaya çalışsanız bile KeyError almamanızdır. Sözlüklere aşinaysanız, bunun sözlüklerdeki get yöntemine benzer şekilde çalıştığını görebilirsiniz.
Seçenek 3: Ayrıca bir kümeden rastgele bir değeri kaldırmak ve döndürmek için pop yöntemini kullanabilirsiniz.
graphicDesigner.pop()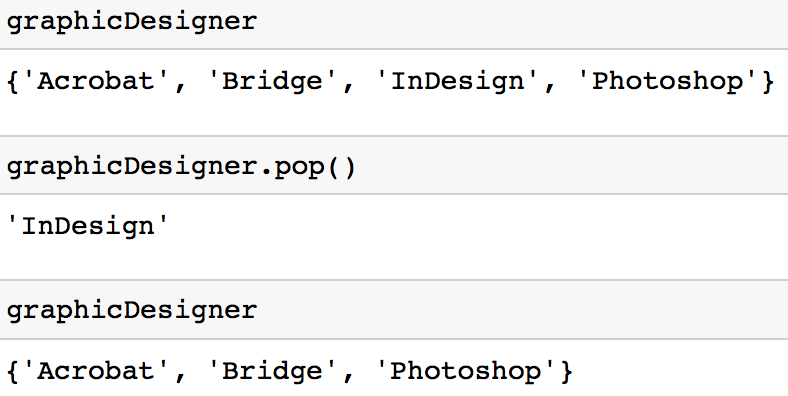
Bu yöntemin, küme boşsa KeyError yükselttiğini unutmamak önemlidir.
Bir kümedeki tüm değerleri kaldırmak için clear yöntemini kullanabilirsiniz.
graphicDesigner.clear()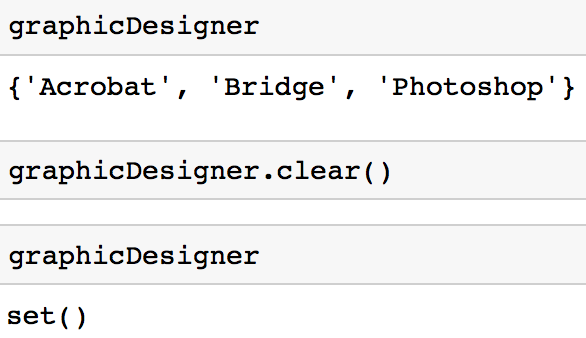
update yöntemi, bir kümenin elemanlarını başka bir kümeye ekler. Argüman olarak bir küme, liste, demet veya sözlük alabilir. .update() yöntemi diğer veri türlerini otomatik olarak kümeye dönüştürür ve kümeye ekler.
Örnekte üç küme başlattık ve set2'den set1'e, ardından set3'ten set1'e elemanları eklemek için update fonksiyonunu kullandık.
# 3 küme başlat
set1 = set([7, 10, 11, 13])
set2 = set([11, 8, 9, 12, 14, 15])
set3 = {'d', 'f', 'h'}
# set1'i set2 ile güncelle
set1.update(set2)
print(set1)
# set1'i set3 ile güncelle
set1.update(set3)
print(set1)
Birçok standart Python veri türünde olduğu gibi, bir küme üzerinde de döngü kurmak mümkündür.
# Bir küme başlat
dataScientist = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
for skill in dataScientist:
print(skill)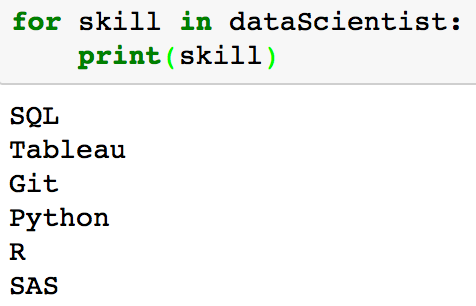
dataScientist içindeki her değeri yazdırma çıktısına bakarsanız, değerlerin eklenme sırasına göre yazdırılmadığını fark edersiniz. Bunun nedeni kümelerin sırasız olmasıdır.
Bu eğitimde kümelerin sırasız olduğu vurgulandı. Kümenizden değerleri sıralı biçimde elde etmeniz gerekiyorsa, sıralı bir liste döndüren sorted fonksiyonunu kullanabilirsiniz.
type(sorted(dataScientist))
Aşağıdaki kod, dataScientist kümesindeki değerleri azalan alfabetik düzende (bu durumda Z-A) çıktı verir.
sorted(dataScientist, reverse = True)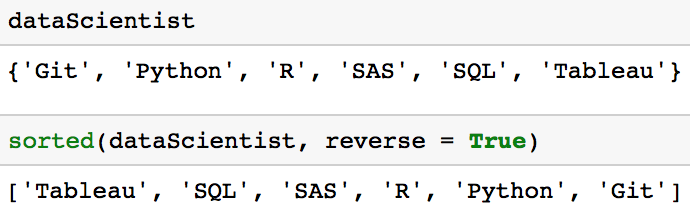
Bu bölümün bir kısmı daha önce En Yaygın 18 Python Liste Sorusu eğitiminde ele alınmıştı; ancak, yinelenenleri bir listeden kaldırmanın en hızlı yolunun kümeler olduğunu vurgulamak önemlidir. Bunu göstermek için iki yaklaşım arasındaki performans farkını inceleyelim.
Yaklaşım 1: Bir listeden yinelenenleri kaldırmak için bir küme kullanın.
print(list(set([1, 2, 3, 1, 7])))Yaklaşım 2: Bir listeden yinelenenleri kaldırmak için bir liste üreteci (list comprehension) kullanın ( liste üreteçlerine yeniden bakmak isterseniz bu eğitimi inceleyin).
def remove_duplicates(original):
unique = []
[unique.append(n) for n in original if n not in unique]
return(unique)
print(remove_duplicates([1, 2, 3, 1, 7]))Performans farkı, Python kodunuzu zamanlamanıza olanak tanıyan timeit kitaplığı kullanılarak ölçülebilir. Aşağıdaki kod her yaklaşımın kodunu 10000 kez çalıştırır ve saniye cinsinden toplam süreyi verir.
import timeit
# Yaklaşım 1: Çalışma süresi
print(timeit.timeit('list(set([1, 2, 3, 1, 7]))', number=10000))
# Yaklaşım 2: Çalışma süresi
print(timeit.timeit('remove_duplicates([1, 2, 3, 1, 7])', globals=globals(), number=10000))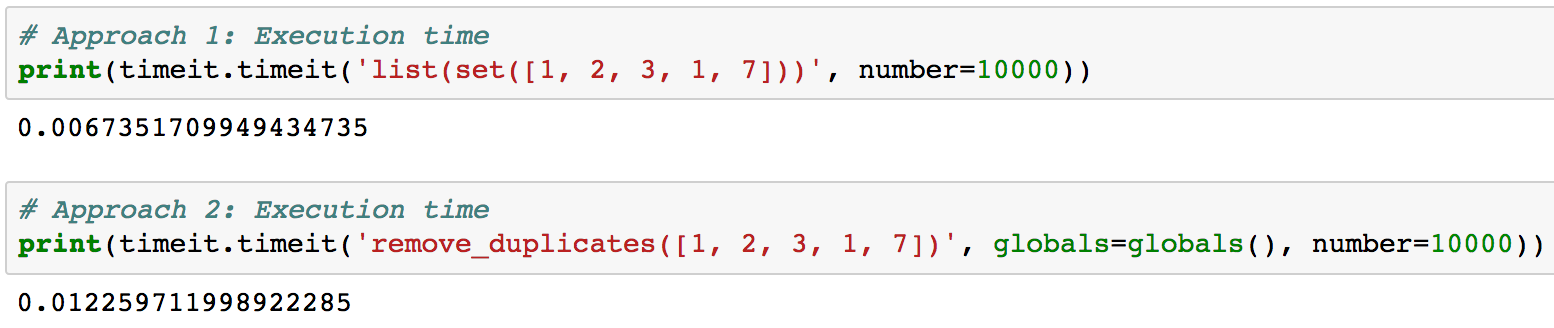
Bu iki yaklaşımı karşılaştırmak, yinelenenleri kaldırmak için kümelerin kullanılmasının daha verimli olduğunu gösterir. Zaman farkı küçük görünse de çok büyük listeleriniz olduğunda size ciddi zaman kazandırabilir.
Python'da kümelerin yaygın bir kullanım alanı, birleşim, kesişim, fark ve simetrik fark gibi standart matematiksel işlemleri hesaplamaktır. Aşağıdaki görsel, A ve B iki kümesi üzerinde birkaç standart matematik işlemini gösterir. Her Venn diyagramındaki kırmızı kısım, verilen küme işleminin sonucunda elde edilen kümeyi temsil eder.
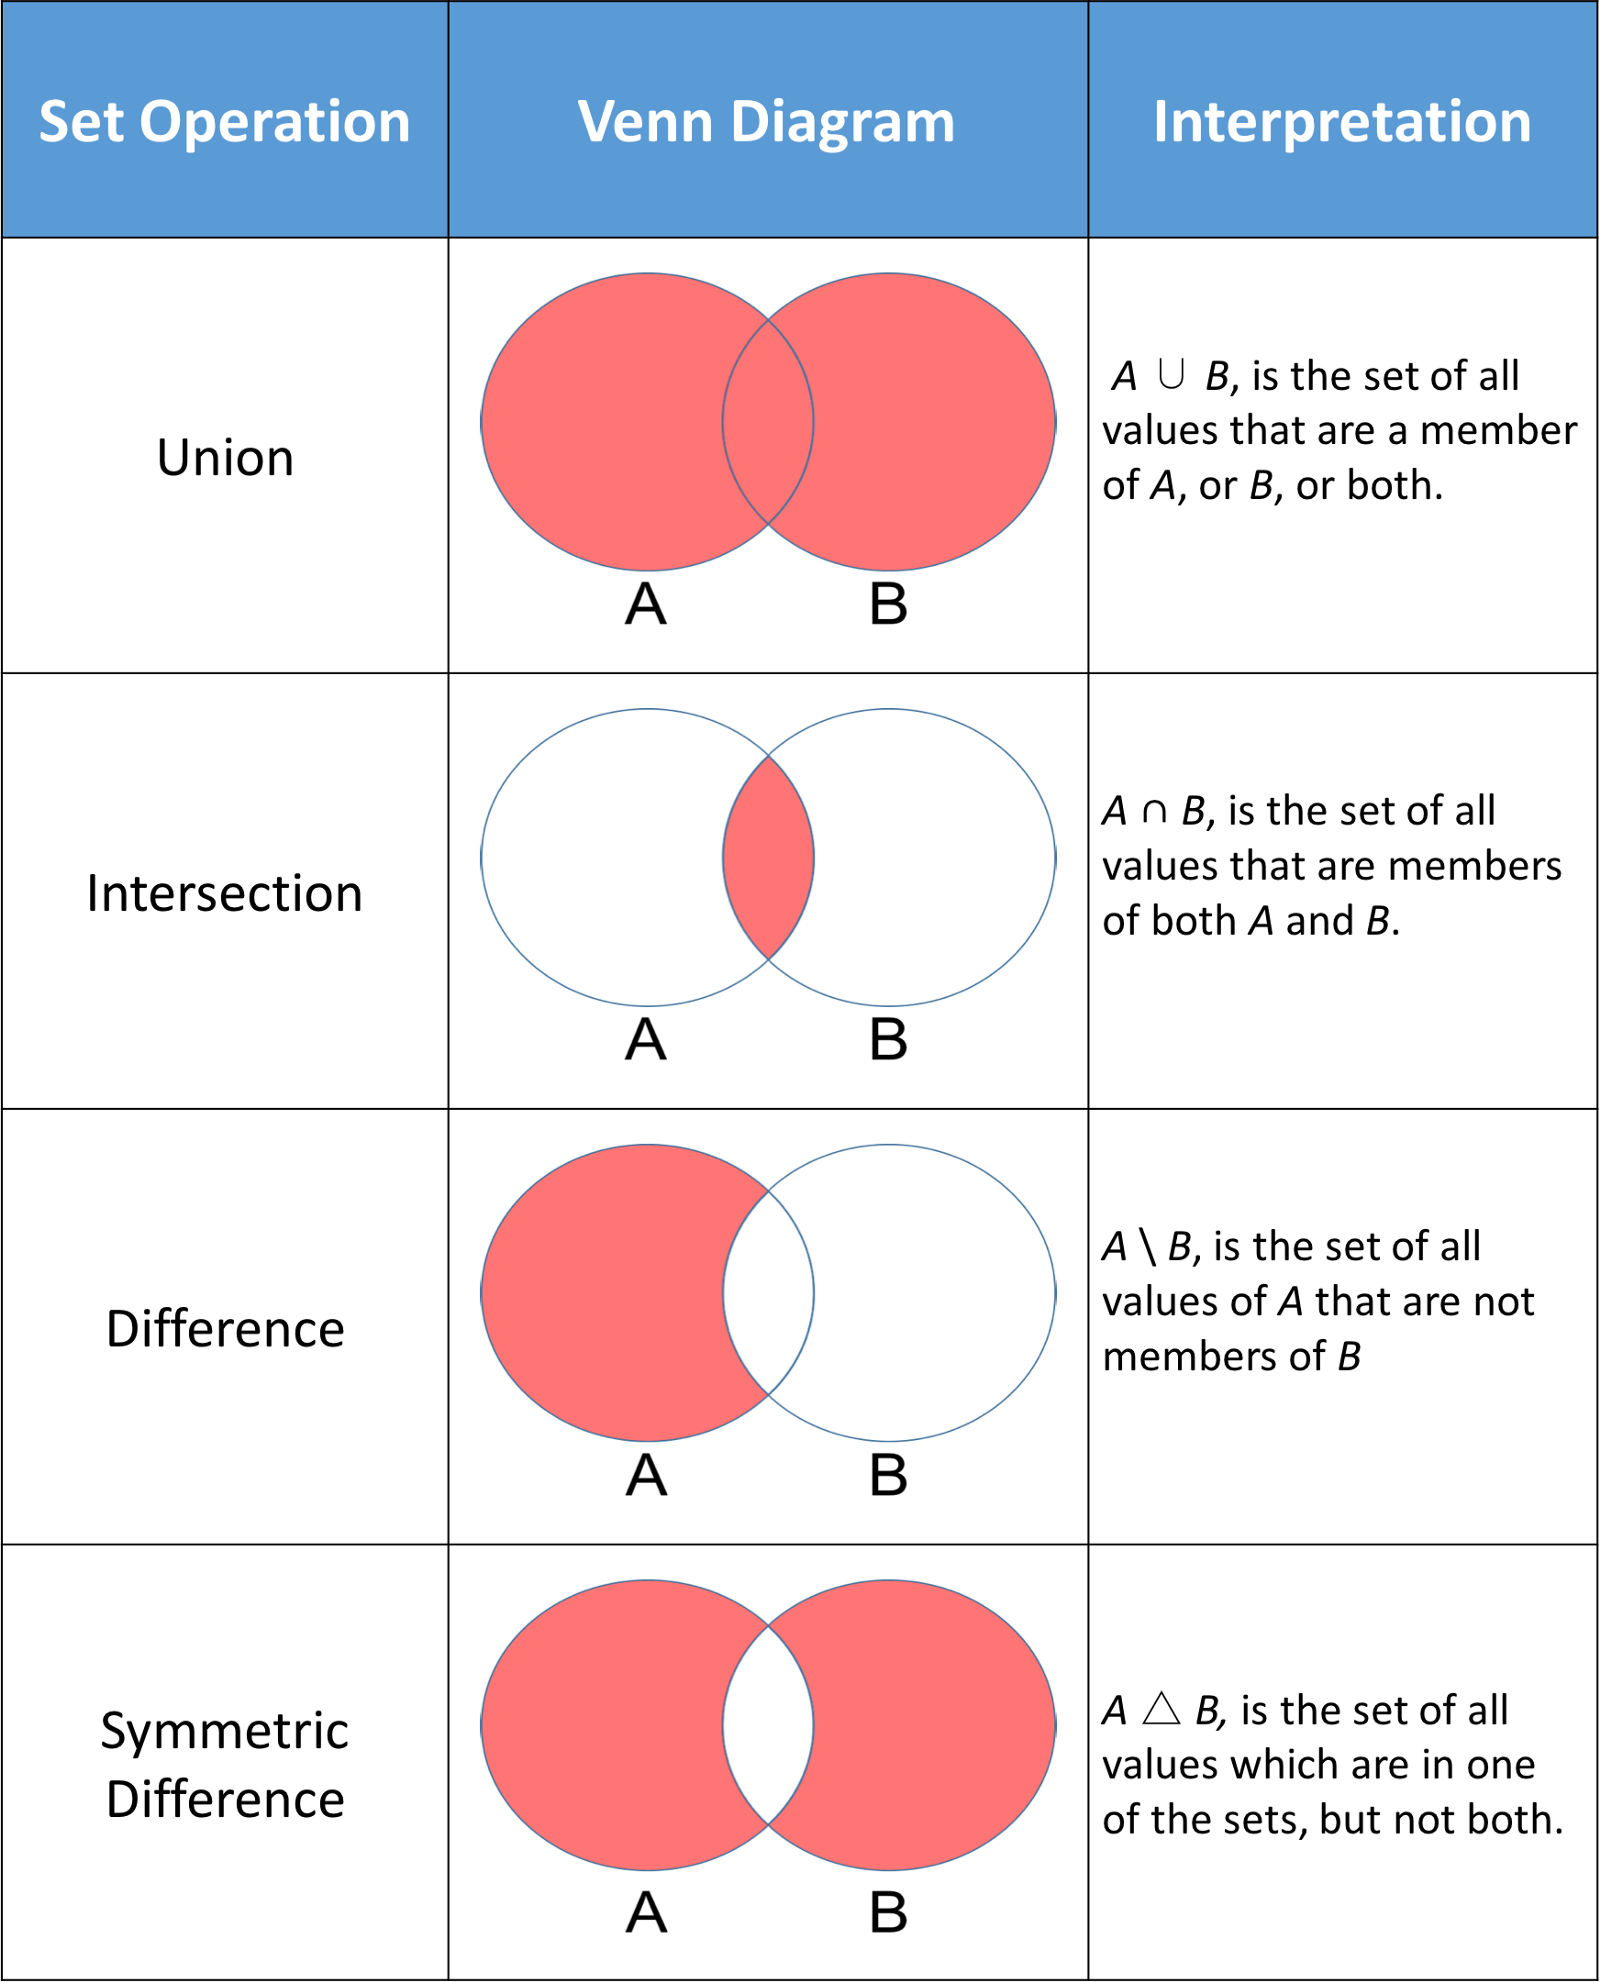
Python kümeleri, bu matematiksel işlemleri gerçekleştirmenizi sağlayan yöntemlere ve eşdeğer sonuçlar veren operatörlere sahiptir.
Bu yöntemleri incelemeden önce, dataScientist ve dataEngineer olmak üzere iki kümeyi başlatarak başlayalım.
dataScientist = set(['Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'])
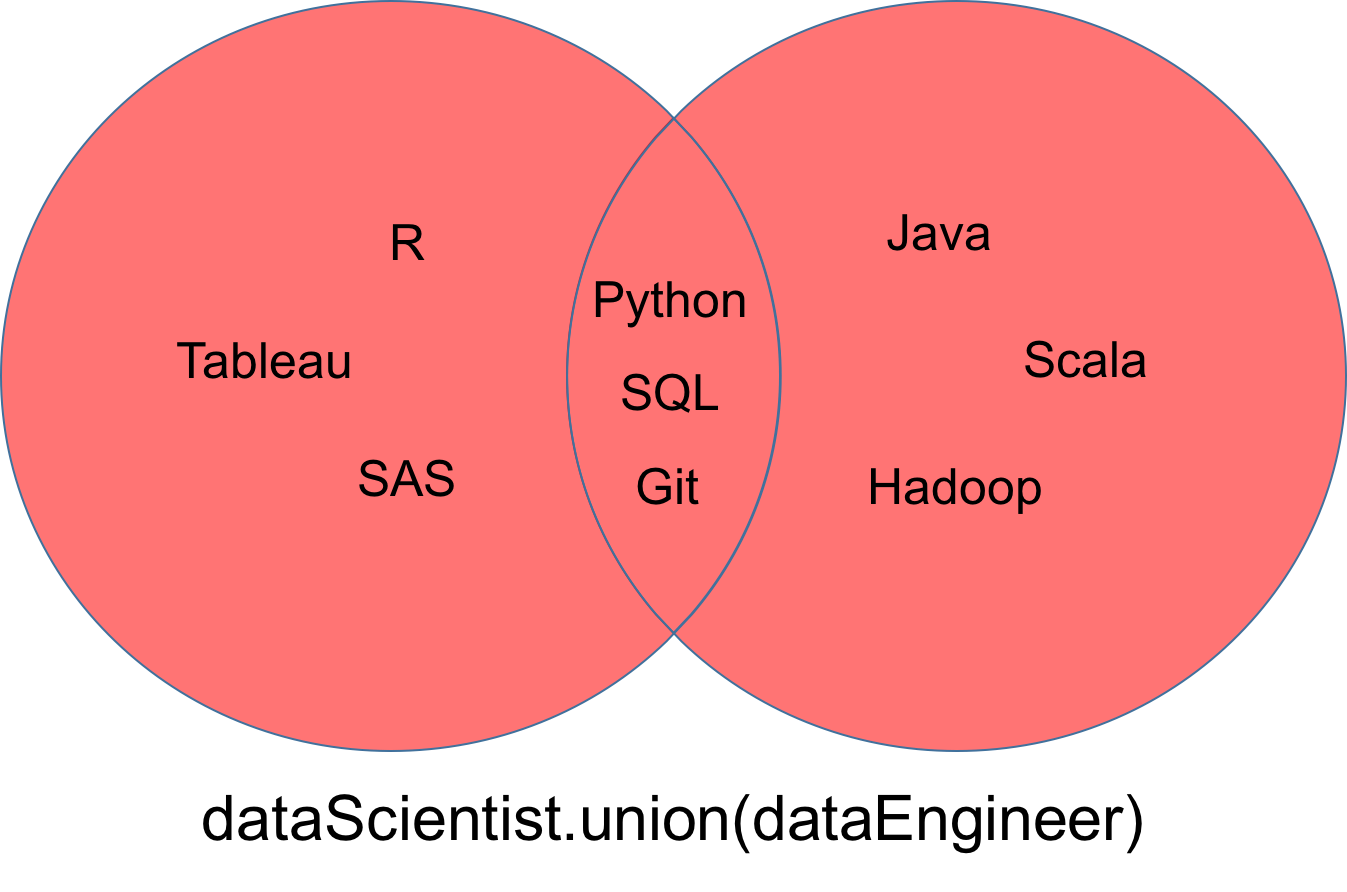
dataEngineer = set(['Python', 'Java', 'Scala', 'Git', 'SQL', 'Hadoop'])Birleşim, dataScientist ∪ dataEngineer ile gösterilir; dataScientist'in, dataEngineer'ın ya da her ikisinin de değeri olan tüm değerlerin kümesidir. İki kümedeki tüm benzersiz değerleri bulmak için union yöntemini kullanabilirsiniz.
# set yerleşik fonksiyonu union
dataScientist.union(dataEngineer)

# Eşdeğer Sonuç
dataScientist | dataEngineer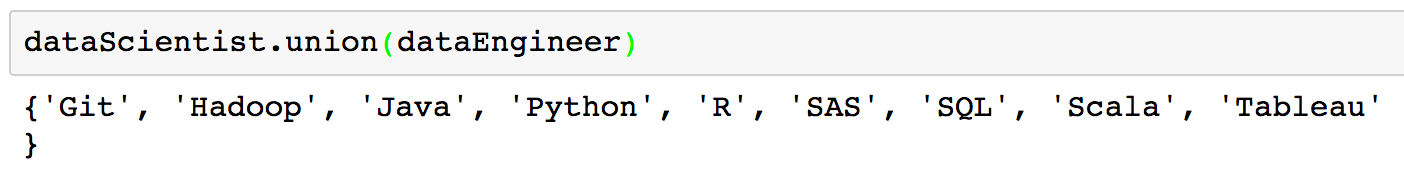
Birleşimden dönen küme aşağıdaki Venn diyagramındaki kırmızı kısım olarak görselleştirilebilir.
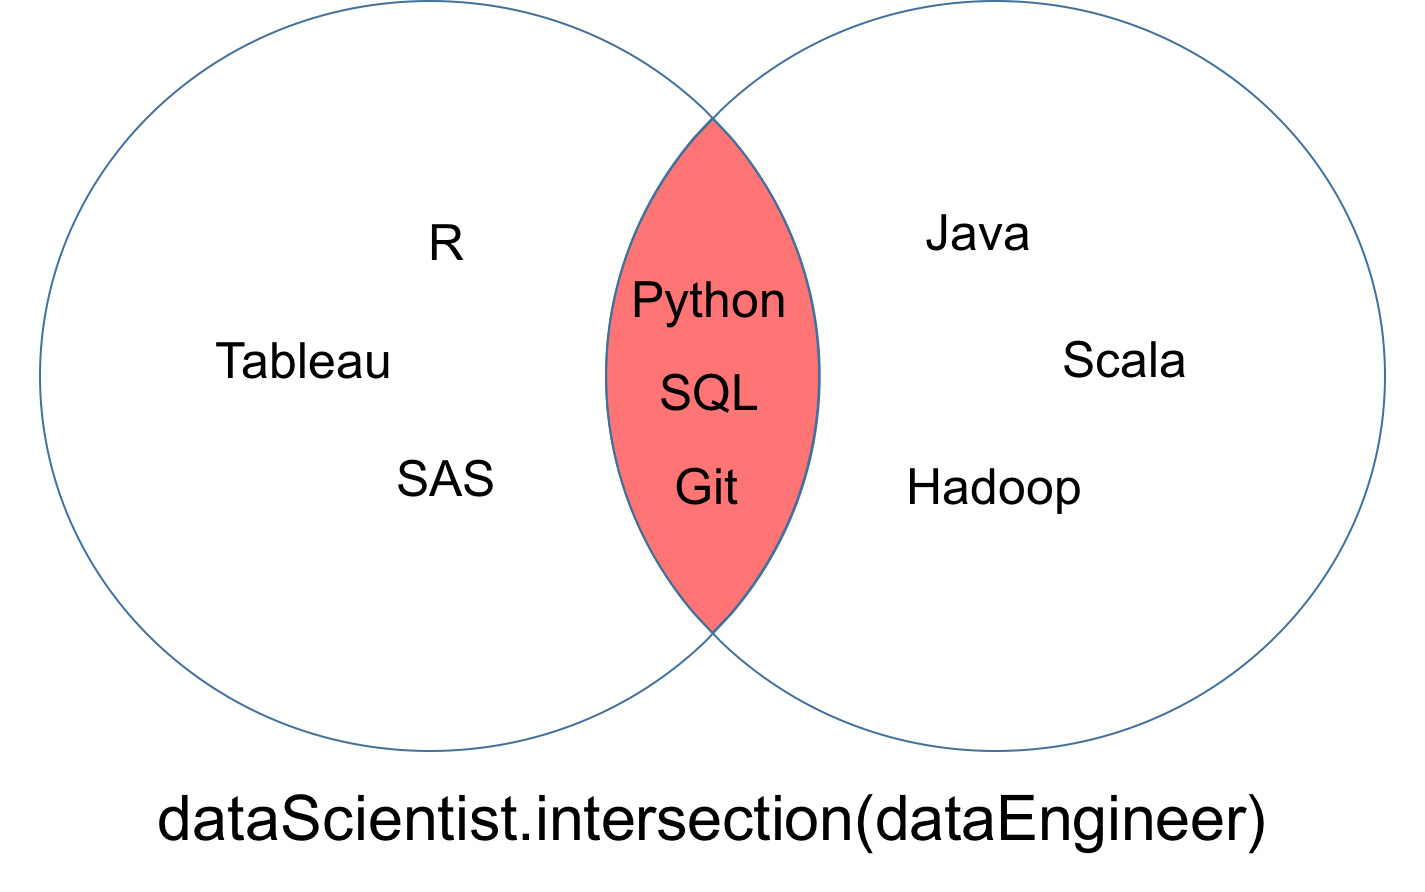
dataScientist ve dataEngineer iki kümesinin kesişimi, dataScientist ∩ dataEngineer ile gösterilir; her ikisinin de değeri olan tüm değerlerin kümesidir.
# Kesişim işlemi
dataScientist.intersection(dataEngineer)

# Eşdeğer Sonuç
dataScientist & dataEngineer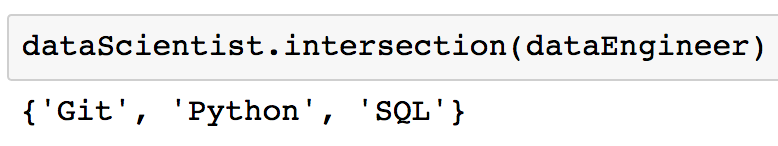
Kesişimden dönen küme aşağıdaki Venn diyagramındaki kırmızı kısım olarak görselleştirilebilir.
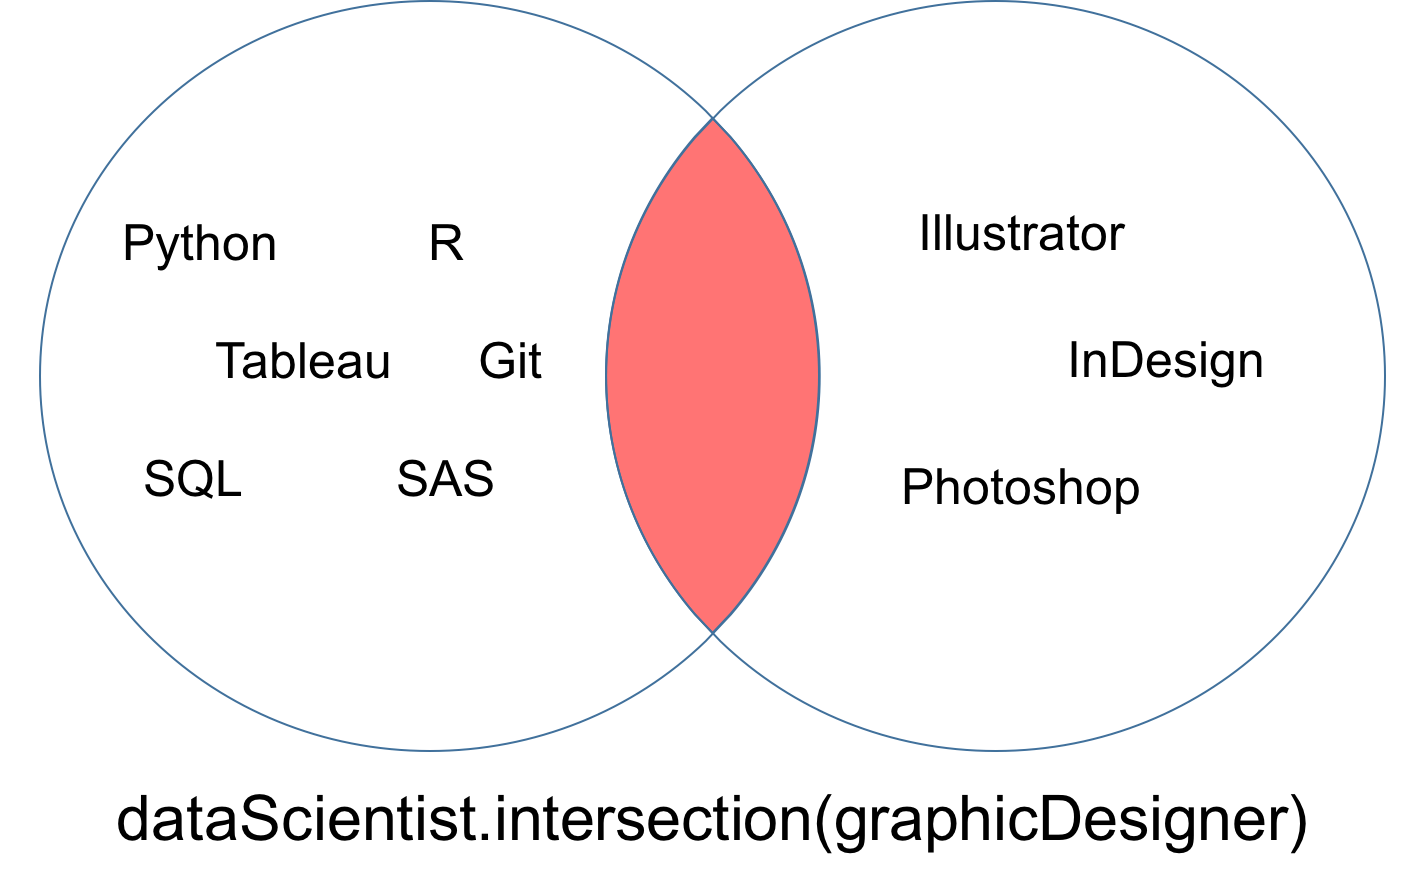
İki kümenin ortak hiçbir değeri olmadığından emin olmak istediğiniz bir durumla karşılaşabilirsiniz. Başka bir deyişle, kesişimleri boş olan iki küme istersiniz. Bu iki kümeye ayrık (disjoint) kümeler denir. Ayrık kümeleri isdisjoint yöntemiyle test edebilirsiniz.
# Bir küme başlat
graphicDesigner = {'Illustrator', 'InDesign', 'Photoshop'}

# Bu kümelerin ortak elemanları olduğundan False döner
dataScientist.isdisjoint(dataEngineer)

# Bu kümelerin ortak elemanı olmadığından True döner
dataScientist.isdisjoint(graphicDesigner)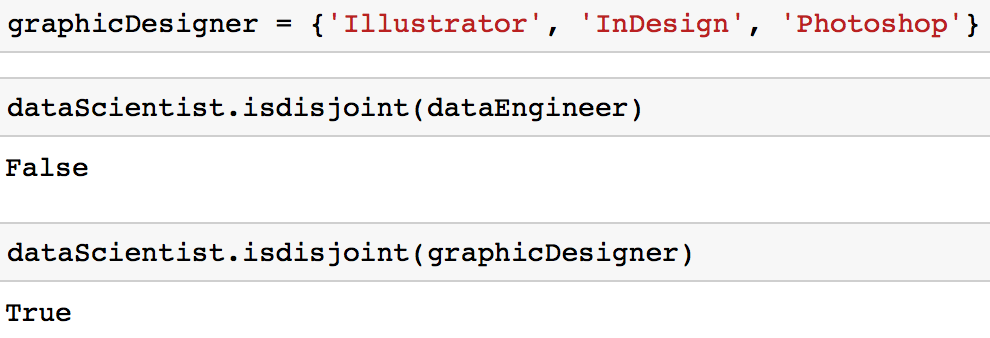
Aşağıdaki Venn diyagramında gösterilen kesişimde, ayrık kümeler olan dataScientist ve graphicDesigner'ın ortak değerleri olmadığını görebilirsiniz.
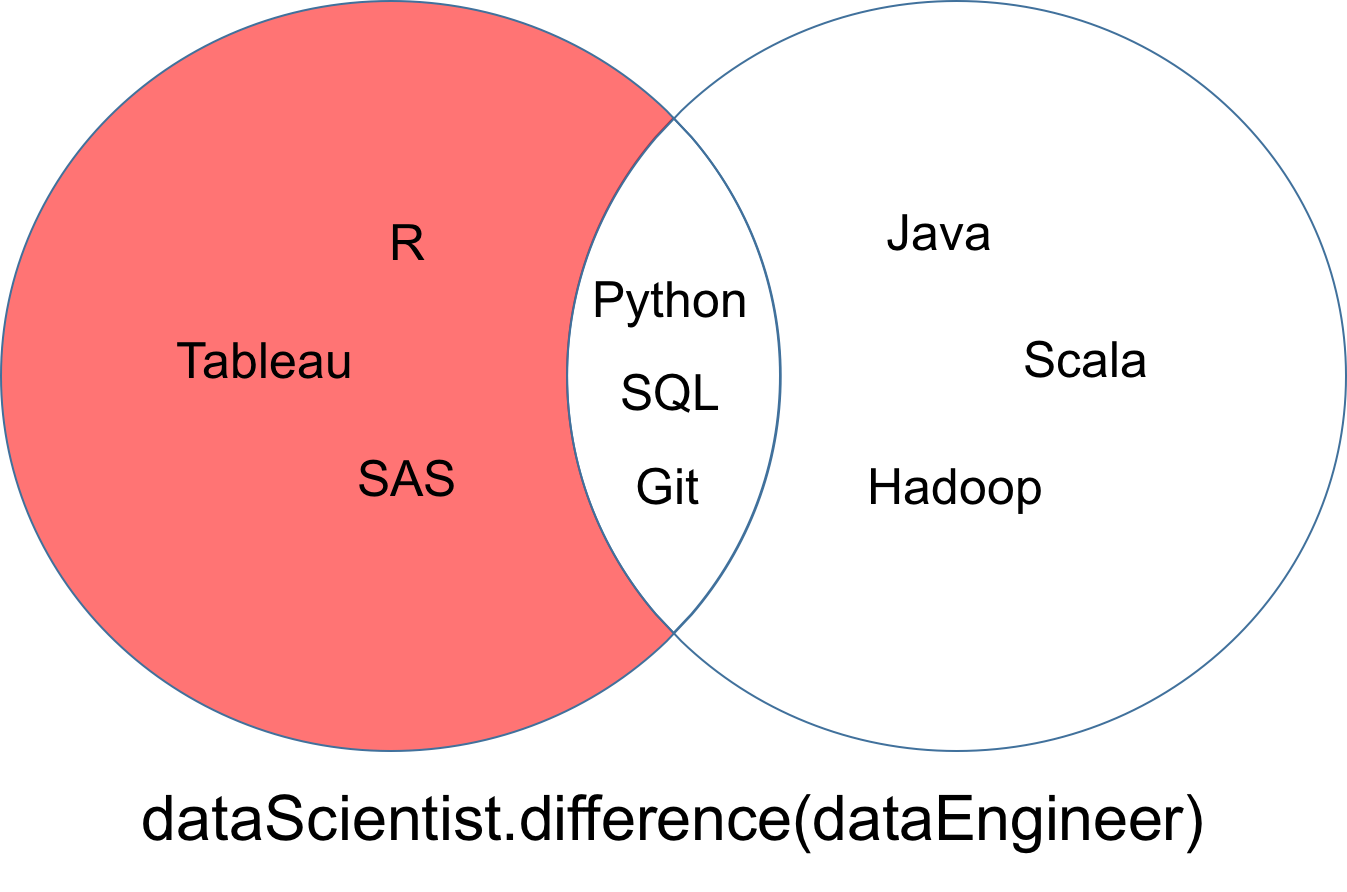
dataScientist ve dataEngineer iki kümesinin farkı, dataScientist \ dataEngineer ile gösterilir; dataScientist'in olup da dataEngineer'ın olmadığı tüm değerlerin kümesidir.
# Fark işlemi
dataScientist.difference(dataEngineer)

# Eşdeğer Sonuç
dataScientist - dataEngineer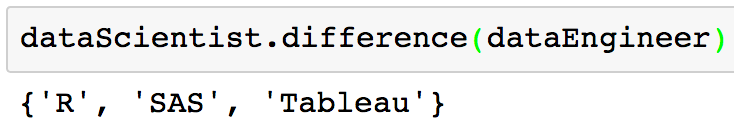
Farktan dönen küme aşağıdaki Venn diyagramındaki kırmızı kısım olarak görselleştirilebilir.
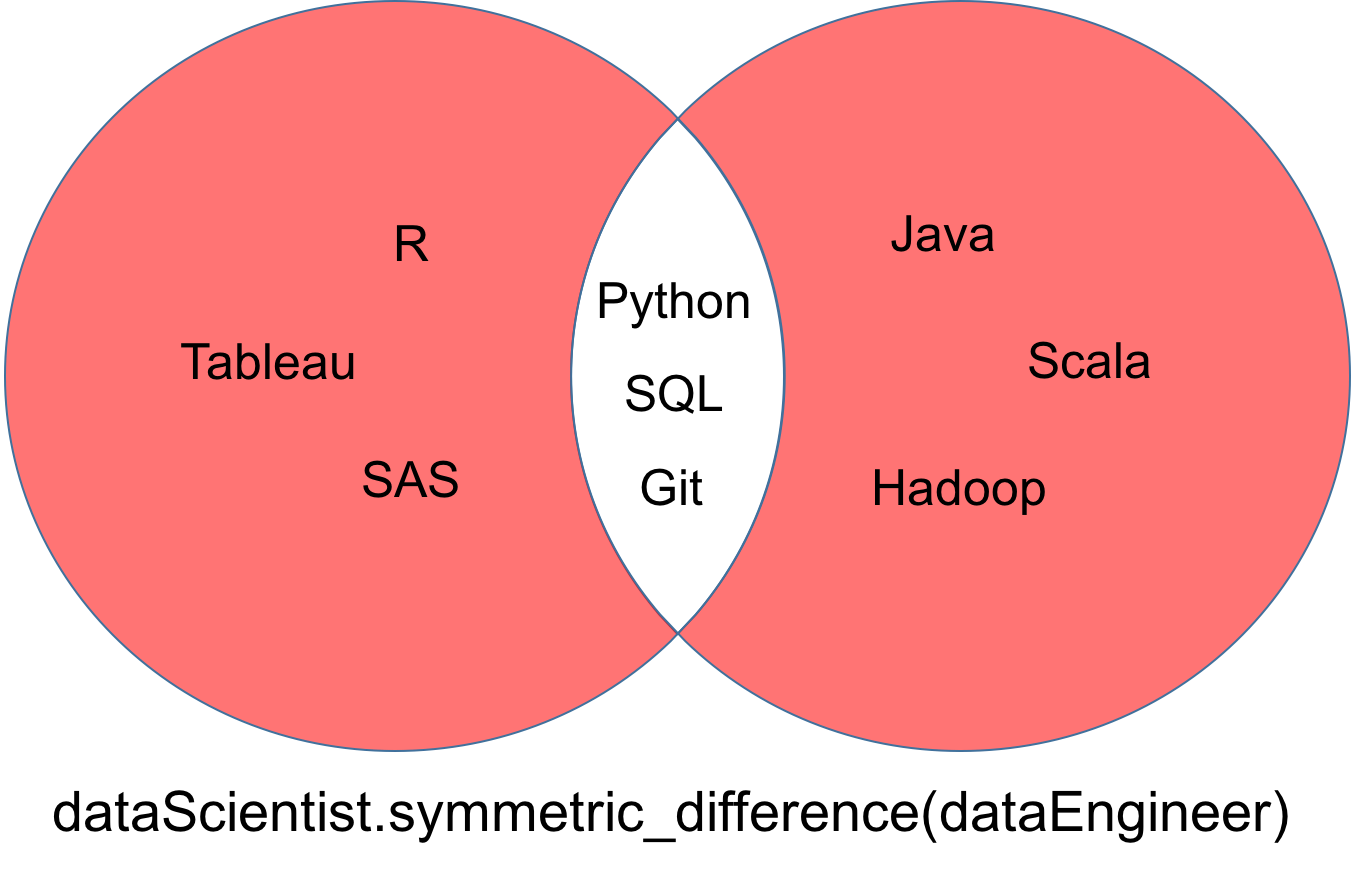
dataScientist ve dataEngineer iki kümesinin simetrik farkı, dataScientist △ dataEngineer ile gösterilir; iki kümeden tam olarak birinin değeri olan, ancak her ikisinin birden olmayan tüm değerlerin kümesidir.
# Simetrik Fark işlemi
dataScientist.symmetric_difference(dataEngineer)

# Eşdeğer Sonuç
dataScientist ^ dataEngineer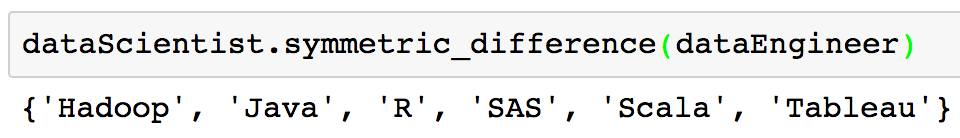
Simetrik farktan dönen küme aşağıdaki Venn diyagramındaki kırmızı kısım olarak görselleştirilebilir.
Daha önce liste üreteçleri, sözlük üreteçleri ve üreteç ifadeleri hakkında öğrenmiş olabilirsiniz. Python'da küme üreteçleri de vardır. Küme üreteçleri bunlara çok benzer. Python'da küme üreteçleri şu şekilde oluşturulabilir:
{skill for skill in ['SQL', 'SQL', 'PYTHON', 'PYTHON']}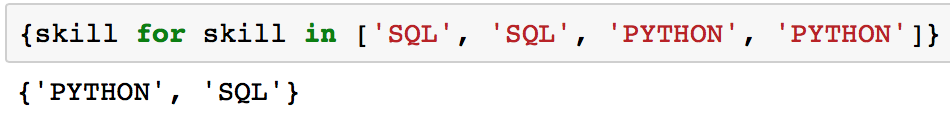
Yukarıdaki çıktı 2 değerden oluşan bir kümedir; çünkü kümelerde aynı öğe birden fazla kez bulunamaz.
Küme üreteçlerinin ardındaki fikir, kodu el ile matematik yapar gibi yazmanızı ve düşünmenizi sağlamaktır.
{skill for skill in ['GIT', 'PYTHON', 'SQL'] if skill not in {'GIT', 'PYTHON', 'JAVA'}}Yukarıdaki kod, daha önce öğrendiğiniz küme farkına benzer. Sadece görünümü biraz farklıdır.
Üyelik testleri, bir dizide (string, liste, demet veya küme gibi) belirli bir öğenin bulunup bulunmadığını kontrol eder. Python'da kümeleri kullanmanın başlıca avantajlarından biri, üyelik testleri için yüksek ölçüde optimize edilmiş olmalarıdır. Örneğin, kümeler üyelik testlerini listelere kıyasla çok daha verimli yapar. Bilgisayar bilimi geçmişiniz varsa, bunun nedeni kümelerde üyelik testlerinin ortalama zaman karmaşıklığının O(1), listelerde ise O(n) olmasıdır.
Aşağıdaki kod bir liste kullanarak üyelik testini gösterir.
# Bir liste başlat
possibleList = ['Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS', 'Java', 'Spark', 'Scala']

# Üyelik testi
'Python' in possibleList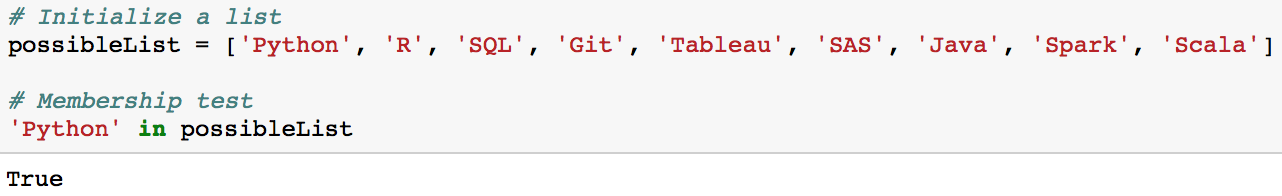
Kümeler için de benzeri yapılabilir. Kümeler sadece daha verimlidir.
# Bir küme başlat
possibleSet = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS', 'Java', 'Spark', 'Scala'}

# Üyelik testi
'Python' in possibleSet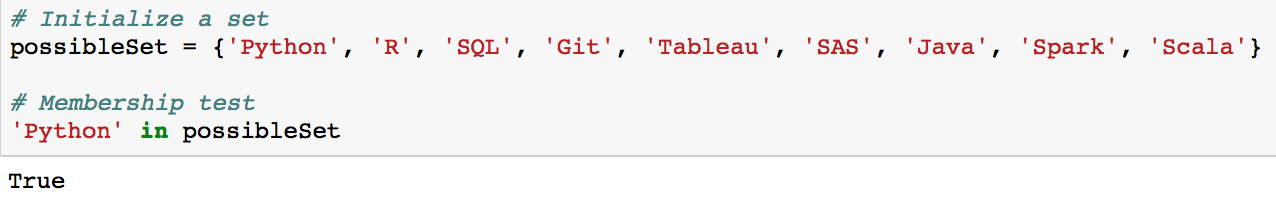
possibleSet bir küme olduğundan ve 'Python' değeri possibleSet'in bir değeri olduğundan, bu durum 'Python' ∈ possibleSet şeklinde gösterilebilir.
Eğer kümenin parçası olmayan bir değeriniz olsaydı, örneğin 'Fortran', bu da 'Fortran' ∉ possibleSet şeklinde gösterilirdi.
Üyeliği anlamanın pratik bir uygulaması alt kümelerdir.
Önce iki küme başlatalım.
possibleSkills = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
mySkills = {'Python', 'R'}
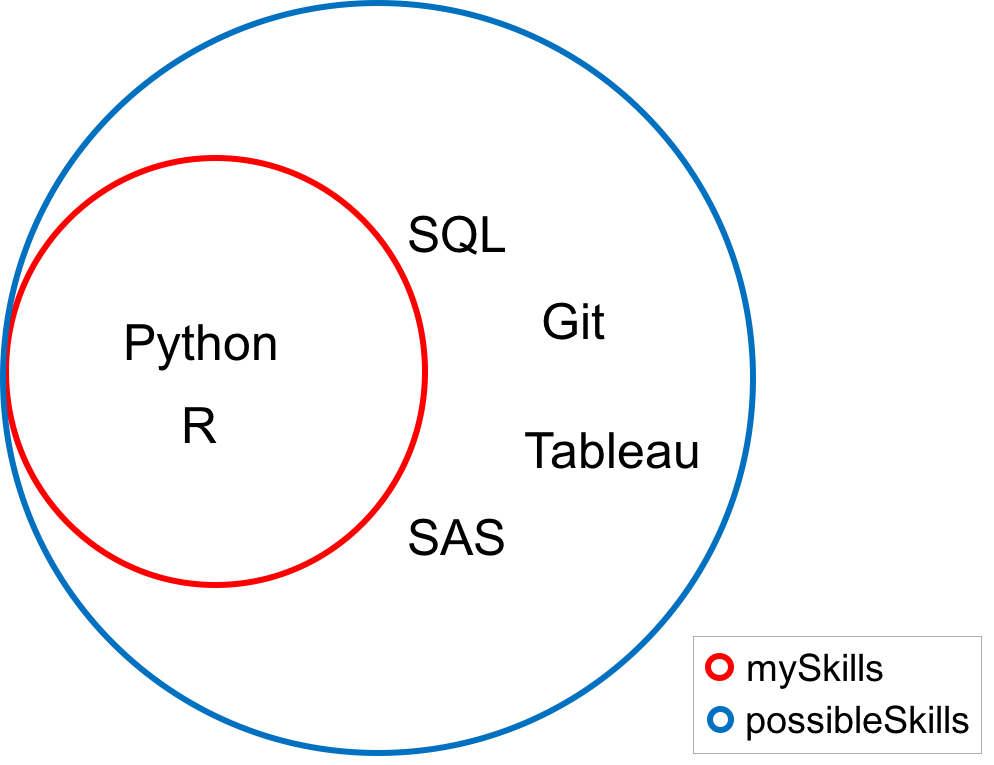
Eğer mySkills kümesinin her değeri possibleSkills kümesinin de bir değeri ise, mySkills kümesi possibleSkills'in bir alt kümesi olarak adlandırılır; matematiksel olarak mySkills ⊆ possibleSkills şeklinde yazılır.
Bir kümenin başka bir kümenin alt kümesi olup olmadığını issubset yöntemiyle kontrol edebilirsiniz.
mySkills.issubset(possibleSkills)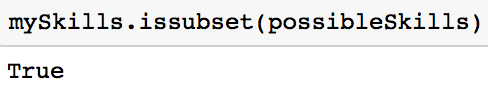
Bu örnekte yöntem True döndürdüğü için alt kümedir. Aşağıdaki Venn diyagramında, mySkills kümesinin her değerinin possibleSkills kümesinin de bir değeri olduğunu fark edeceksiniz.
İç içe listeler ve demetlerle karşılaşmış olabilirsiniz.
# İç içe Listeler ve Demetler
nestedLists = [['the', 12], ['to', 11], ['of', 9], ['and', 7], ['that', 6]]
nestedTuples = (('the', 12), ('to', 11), ('of', 9), ('and', 7), ('that', 6))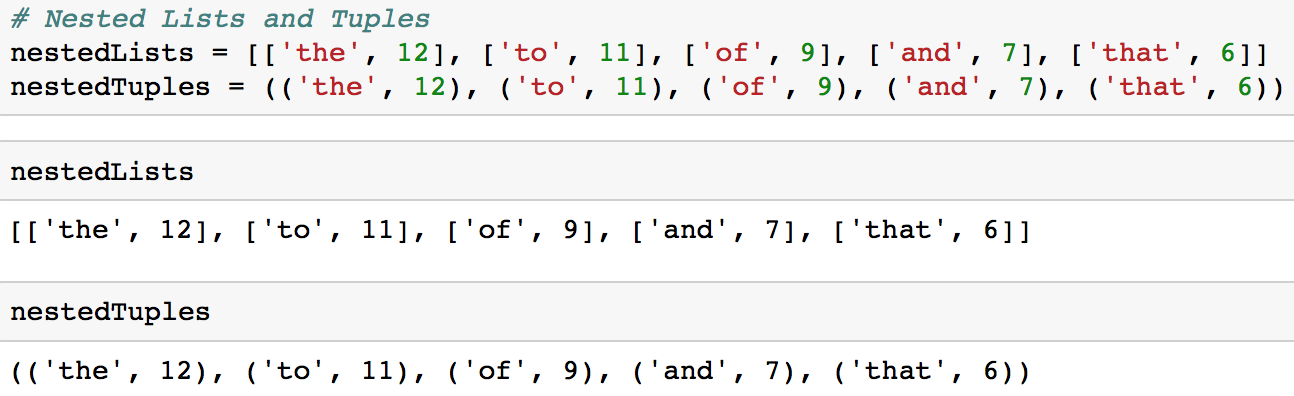
İç içe kümelerdeki sorun, kümelerin değiştirilebilir değerleri (kümeler dahil) içerememesi nedeniyle normalde iç içe Python kümelerine sahip olamamanızdır.
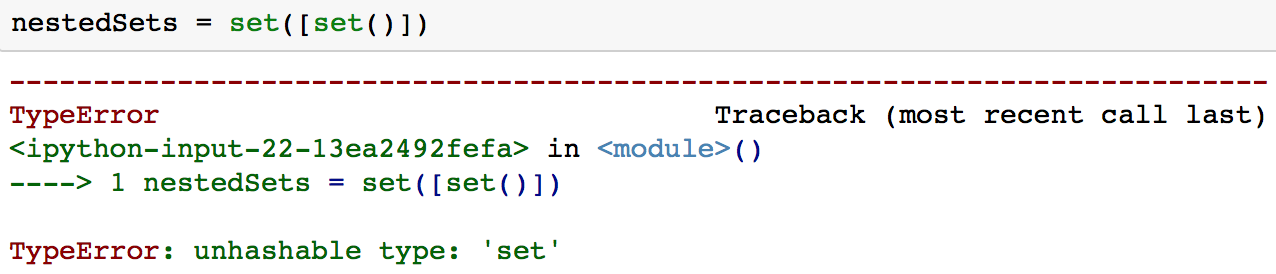
Bu, frozenset kullanmak isteyebileceğiniz bir durumdur. Frozenset, kümeye çok benzer; tek farkı frozenset'in değiştirilemez (immutable) olmasıdır.
Bir frozenset'i frozenset() kullanarak oluşturursunuz.
# Bir frozenset başlat
immutableSet = frozenset()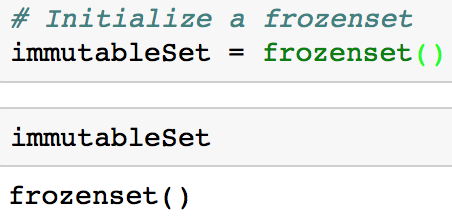
Aşağıdaki koda benzer şekilde bir frozenset kullanarak iç içe bir küme oluşturabilirsiniz.
nestedSets = set([frozenset()])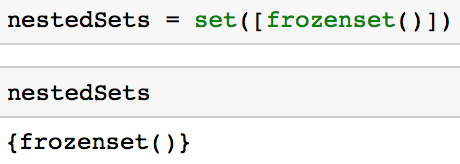
Frozenset'in başlıca dezavantajının, değiştirilemez olmaları nedeniyle değer ekleyip kaldıramamanız olduğunu aklınızda bulundurun.
Python kümeleri, bir liste gibi koleksiyonlardan yinelenen değerleri verimli bir şekilde kaldırmak ve birleşim ile kesişim gibi yaygın matematik işlemlerini gerçekleştirmek için son derece kullanışlıdır. İnsanların sıklıkla karşılaştığı zorluklardan biri, farklı veri türlerini ne zaman kullanacaklarını bilmektir. Örneğin, bir sözlüğü ne zaman, bir kümeyi ne zaman kullanmanın daha avantajlı olduğundan emin değilseniz, DataCamp'in günlük pratik moduna göz atmanızı öneririm. Eğitimle ilgili herhangi bir soru veya düşünceniz varsa, aşağıdaki yorumlardan ya da Twitter üzerinden bana ulaşabilirsiniz.
Python Kursları
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




