

Esegui e modifica il codice da questo tutorial online
Esegui codice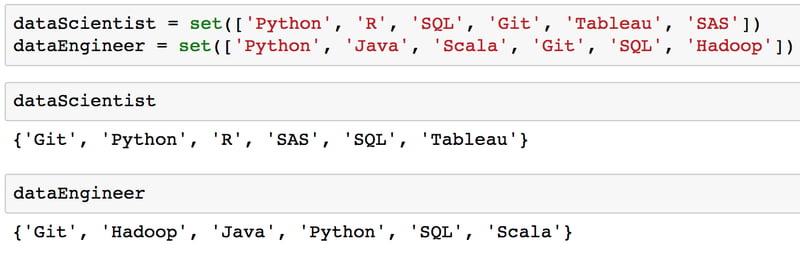
Se guardi l'output delle variabili dataScientist e dataEngineer sopra, noterai che i valori nel set non sono nell'ordine in cui sono stati aggiunti. Questo perché i set non sono ordinati.
I set contenenti valori possono anche essere inizializzati usando le parentesi graffe.
dataScientist = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
dataEngineer = {'Python', 'Java', 'Scala', 'Git', 'SQL', 'Hadoop'}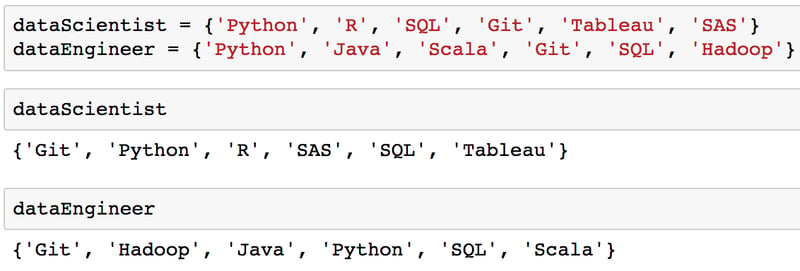
Ricorda che le parentesi graffe possono essere usate solo per inizializzare un set che contiene valori. L'immagine qui sotto mostra che usare le parentesi graffe senza valori è uno dei modi per inizializzare un dizionario e non un set.
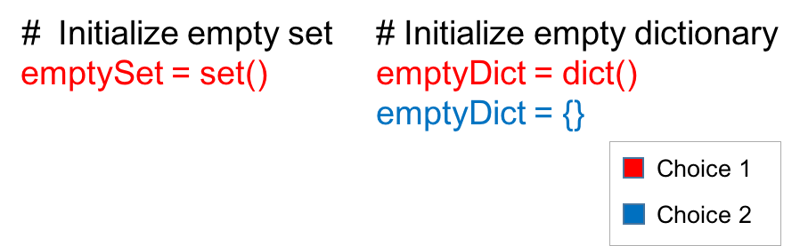
Aggiungere e rimuovere valori dai set in Python
Per aggiungere o rimuovere valori da un set, devi prima inizializzare un set.
# Initialize set with values
graphicDesigner = {'InDesign', 'Photoshop', 'Acrobat', 'Premiere', 'Bridge'}Aggiungere valori a un set in Python
Puoi usare il metodo add per aggiungere un valore a un set.
graphicDesigner.add('Illustrator')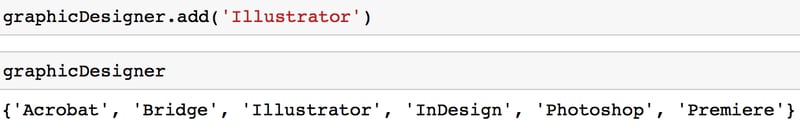
È importante notare che puoi aggiungere a un set solo un valore immutabile (come una stringa o una tupla). Per esempio, otterresti un TypeError se provi ad aggiungere una lista a un set.
graphicDesigner.add(['Powerpoint', 'Blender'])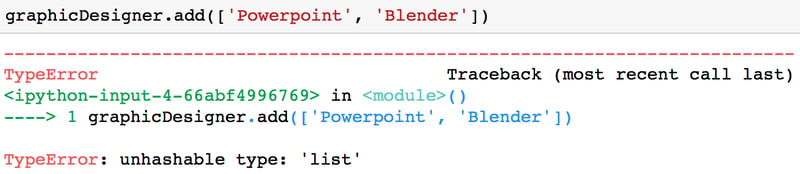
Rimuovere valori dai set in Python
Ci sono un paio di modi per rimuovere un valore da un set.
Opzione 1: Puoi usare il metodo remove per rimuovere un valore da un set.
graphicDesigner.remove('Illustrator')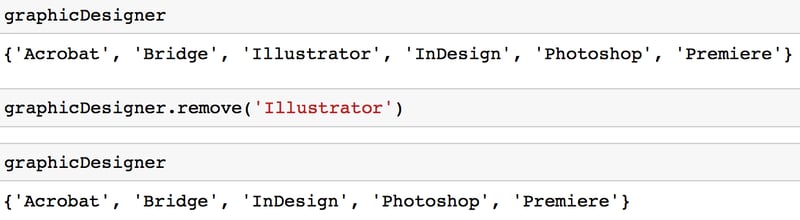
Lo svantaggio di questo metodo è che, se provi a rimuovere un valore che non è nel tuo set, otterrai un KeyError.
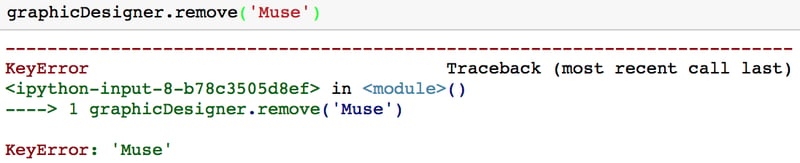
Opzione 2: Puoi usare il metodo discard per rimuovere un valore da un set.
graphicDesigner.discard('Premiere')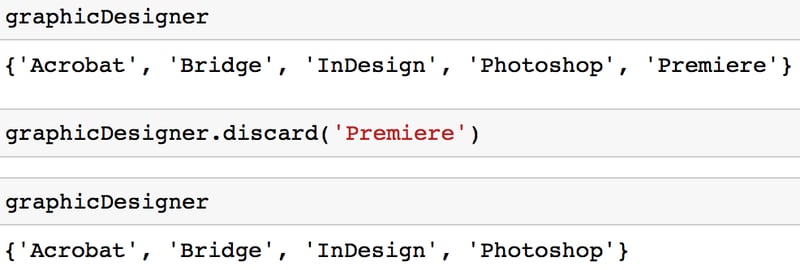
Il vantaggio di questo approccio rispetto al metodo remove è che, se provi a rimuovere un valore che non fa parte del set, non otterrai un KeyError. Se hai familiarità con i dizionari, potresti notare che funziona in modo simile al metodo get dei dizionari.
Opzione 3: Puoi anche usare il metodo pop per rimuovere e restituire un valore arbitrario da un set.
graphicDesigner.pop()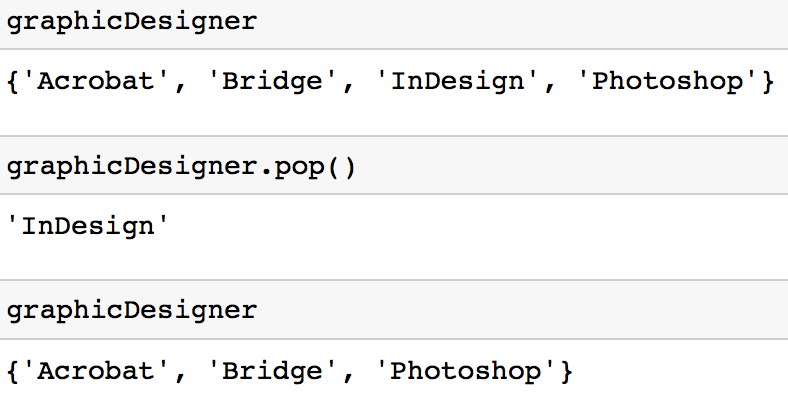
È importante notare che il metodo solleva un KeyError se il set è vuoto.
Rimuovere tutti i valori da un set in Python
Puoi usare il metodo clear per rimuovere tutti i valori da un set.
graphicDesigner.clear()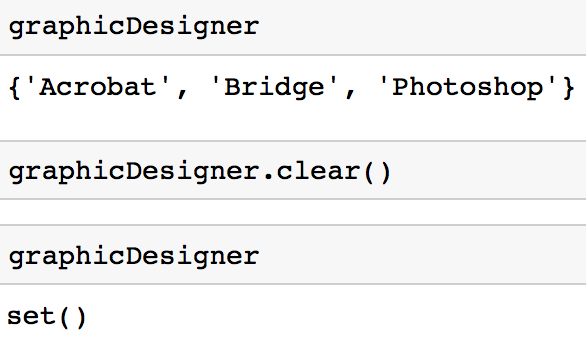
Aggiornare i valori di un set in Python
Il metodo update aggiunge gli elementi da un set a un set. Richiede un singolo argomento che può essere un set, una lista, delle tuple o un dizionario. Il metodo .update() converte automaticamente gli altri tipi di dato in set e li aggiunge al set.
Nell'esempio, abbiamo inizializzato tre set e usato una funzione update per aggiungere gli elementi di set2 a set1 e poi quelli di set3 a set1.
# Initialize 3 sets
set1 = set([7, 10, 11, 13])
set2 = set([11, 8, 9, 12, 14, 15])
set3 = {'d', 'f', 'h'}
# Update set1 with set2
set1.update(set2)
print(set1)
# Update set1 with set3
set1.update(set3)
print(set1)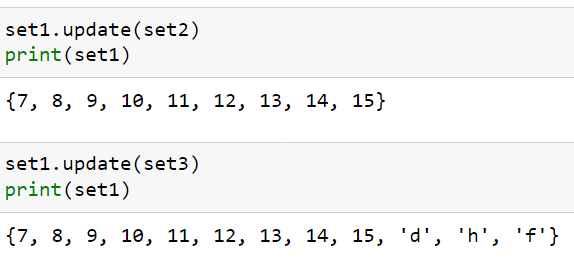
Iterare su un set in Python
Come molti tipi di dato standard di Python, è possibile iterare su un set.
# Initialize a set
dataScientist = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
for skill in dataScientist:
print(skill)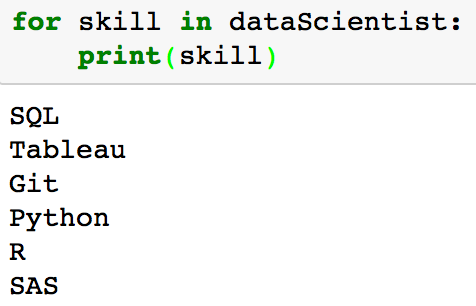
Se guardi l'output della stampa di ciascun valore in dataScientist, noterai che i valori stampati nel set non sono nell'ordine in cui sono stati aggiunti. Questo perché i set non sono ordinati.
Trasformare un set in Python in valori ordinati
Questo tutorial ha sottolineato che i set sono non ordinati. Se ti serve ottenere i valori del tuo set in forma ordinata, puoi usare la funzione sorted, che restituisce una lista ordinata.
type(sorted(dataScientist))
Il codice sotto restituisce i valori nel set dataScientist in ordine alfabetico decrescente (Z-A in questo caso).
sorted(dataScientist, reverse = True)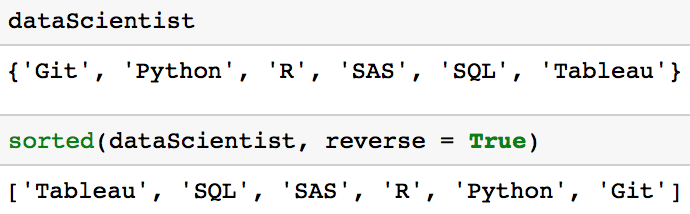
Rimuovere duplicati da una lista in Python
Parte dei contenuti in questa sezione è stata già trattata nel tutorial 18 domande più comuni sulle liste in Python, ma è importante sottolineare che i set sono il modo più veloce per rimuovere duplicati da una lista. Per mostrarlo, studiamo la differenza di prestazioni tra due approcci.
Approccio 1: Usa un set per rimuovere i duplicati da una lista.
print(list(set([1, 2, 3, 1, 7])))Approccio 2: Usa una list comprehension per rimuovere i duplicati da una lista (se vuoi un ripasso sulle list comprehension, guarda questo tutorial).
def remove_duplicates(original):
unique = []
[unique.append(n) for n in original if n not in unique]
return(unique)
print(remove_duplicates([1, 2, 3, 1, 7]))La differenza di prestazioni può essere misurata usando la libreria timeit che consente di cronometrare il tuo codice Python. Il codice sotto esegue il codice per ciascun approccio 10000 volte e restituisce il tempo complessivo impiegato in secondi.
import timeit
# Approach 1: Execution time
print(timeit.timeit('list(set([1, 2, 3, 1, 7]))', number=10000))
# Approach 2: Execution time
print(timeit.timeit('remove_duplicates([1, 2, 3, 1, 7])', globals=globals(), number=10000))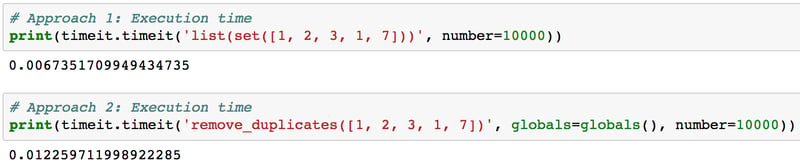
Confrontando questi due approcci si vede che usare i set per rimuovere i duplicati è più efficiente. Anche se può sembrare una piccola differenza di tempo, può farti risparmiare molto se hai liste molto grandi.
Operazioni sui set in Python
Un uso comune dei set in Python è il calcolo di operazioni matematiche standard come unione, intersezione, differenza e differenza simmetrica. L'immagine qui sotto mostra alcune operazioni matematiche standard su due set A e B. La parte rossa di ogni diagramma di Venn è il set risultante da una data operazione sui set.
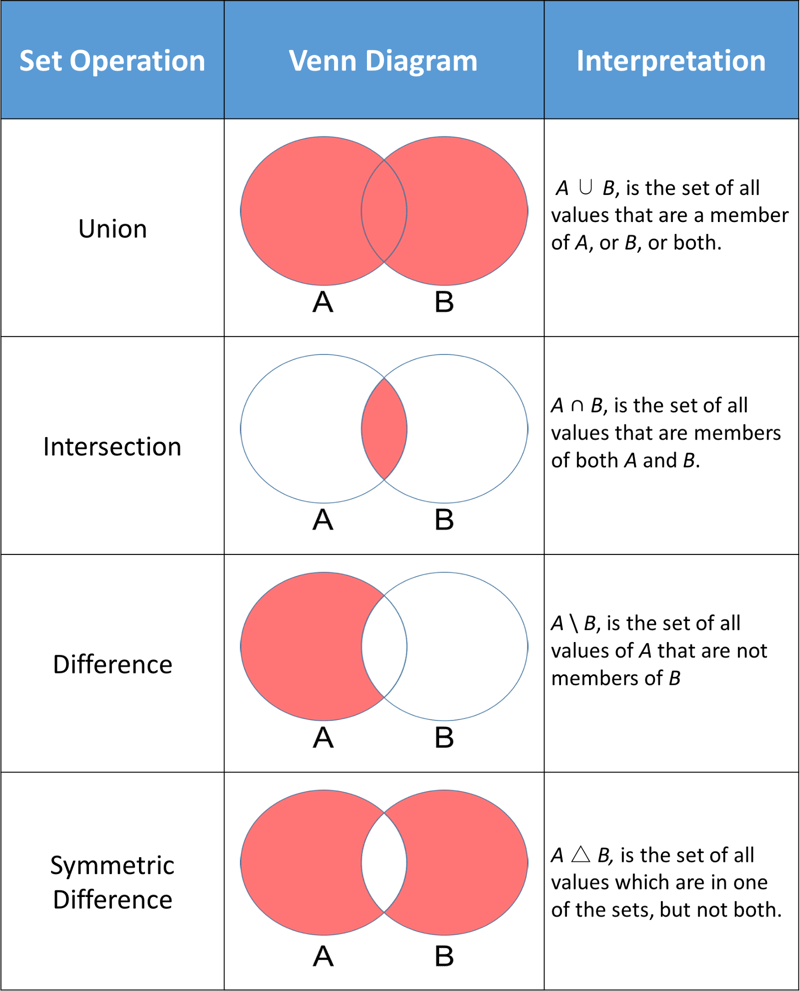
I set in Python hanno metodi che permettono di eseguire queste operazioni matematiche, nonché operatori che danno risultati equivalenti.
Prima di esplorare questi metodi, iniziamo inizializzando due set, dataScientist e dataEngineer.
dataScientist = set(['Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'])
dataEngineer = set(['Python', 'Java', 'Scala', 'Git', 'SQL', 'Hadoop'])union
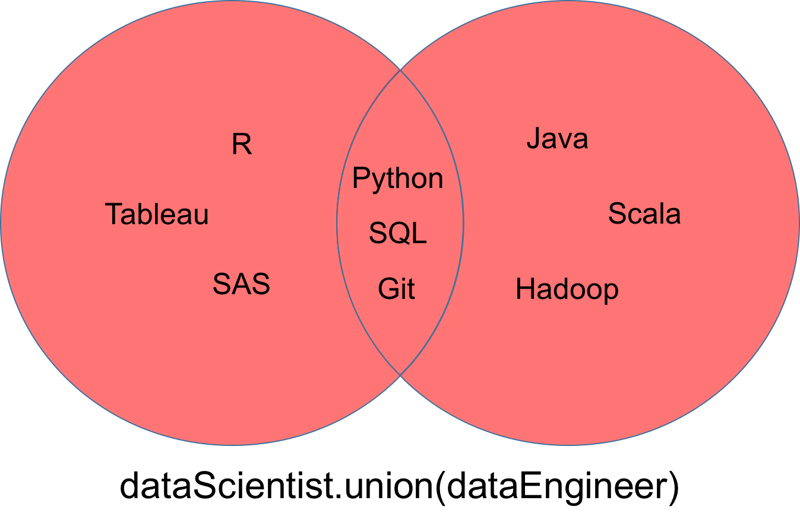
Un'unione, indicata come dataScientist ∪ dataEngineer, è il set di tutti i valori che sono valori di dataScientist, o di dataEngineer, o di entrambi. Puoi usare il metodo union per trovare tutti i valori unici in due set.
# set built-in function union
dataScientist.union(dataEngineer)
# Equivalent Result
dataScientist | dataEngineer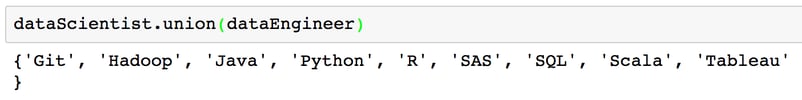
Il set restituito dall'unione può essere visualizzato come la parte rossa del diagramma di Venn qui sotto.
intersection
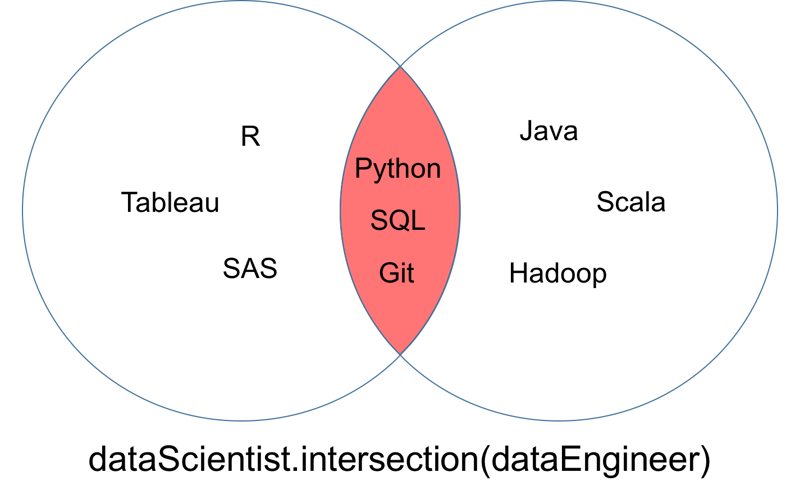
Un'intersezione di due set, dataScientist e dataEngineer, indicata come dataScientist ∩ dataEngineer, è il set di tutti i valori che sono valori di entrambi dataScientist e dataEngineer.
# Intersection operation
dataScientist.intersection(dataEngineer)
# Equivalent Result
dataScientist & dataEngineer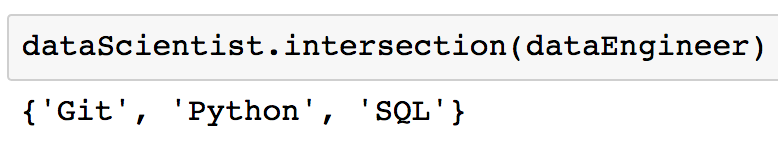
Il set restituito dall'intersezione può essere visualizzato come la parte rossa del diagramma di Venn qui sotto.
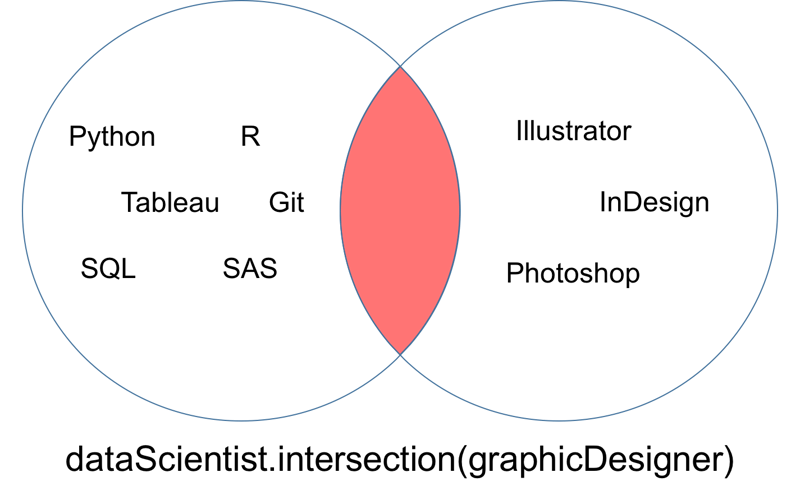
Potresti imbatterti in un caso in cui vuoi assicurarti che due set non abbiano alcun valore in comune. In altre parole, vuoi due set la cui intersezione è vuota. Questi due set sono chiamati set disgiunti. Puoi testare i set disgiunti usando il metodo isdisjoint.
# Initialize a set
graphicDesigner = {'Illustrator', 'InDesign', 'Photoshop'}
# These sets have elements in common so it would return False
dataScientist.isdisjoint(dataEngineer)
# These sets have no elements in common so it would return True
dataScientist.isdisjoint(graphicDesigner)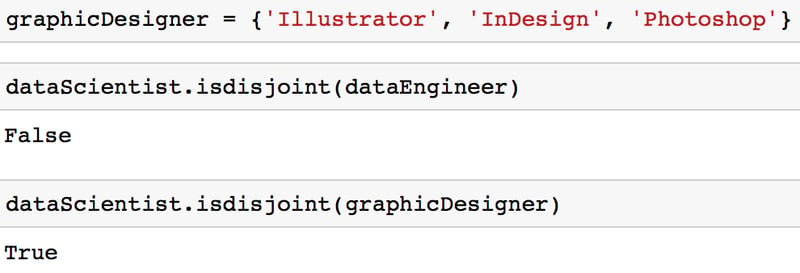
Puoi notare nell'intersezione mostrata nel diagramma di Venn qui sotto che i set disgiunti dataScientist e graphicDesigner non hanno valori in comune.
Differenza
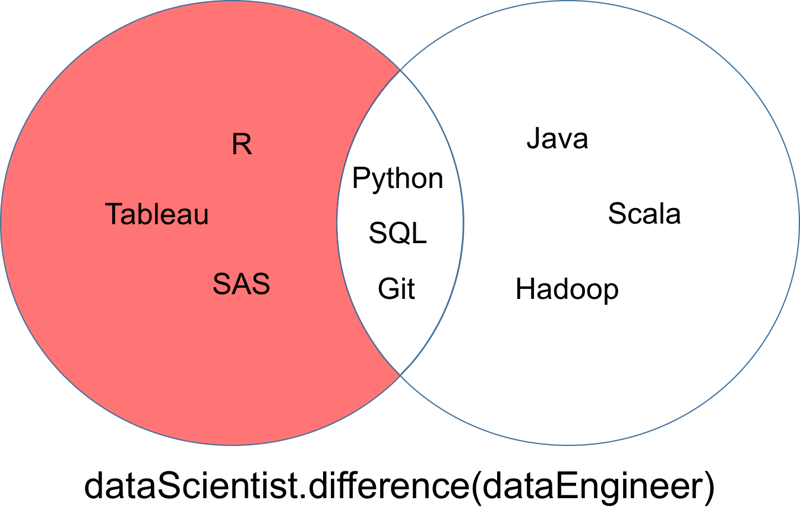
Una differenza di due set, dataScientist e dataEngineer, indicata come dataScientist \ dataEngineer, è il set di tutti i valori di dataScientist che non sono valori di dataEngineer.
# Difference Operation
dataScientist.difference(dataEngineer)
# Equivalent Result
dataScientist - dataEngineer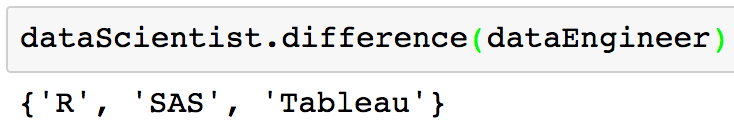
Il set restituito dalla differenza può essere visualizzato come la parte rossa del diagramma di Venn qui sotto.
Differenza simmetrica
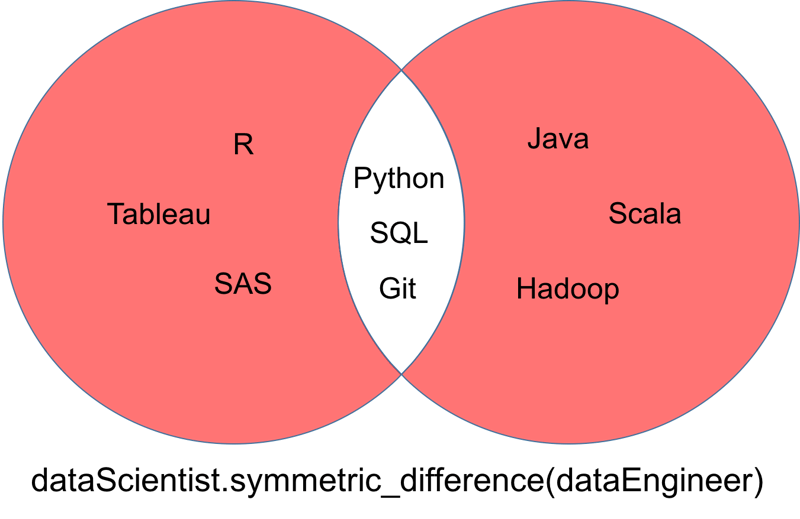
Una differenza simmetrica di due set, dataScientist e dataEngineer, indicata come dataScientist △ dataEngineer, è il set di tutti i valori che appartengono esattamente a uno dei due set, ma non a entrambi.
# Symmetric Difference Operation
dataScientist.symmetric_difference(dataEngineer)
# Equivalent Result
dataScientist ^ dataEngineer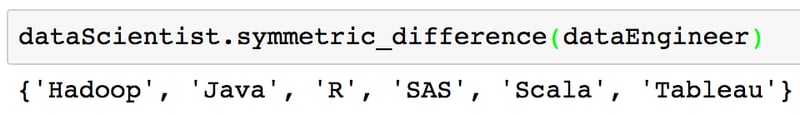
Il set restituito dalla differenza simmetrica può essere visualizzato come la parte rossa del diagramma di Venn qui sotto.
Set comprehension
Potresti aver già imparato le list comprehension, le dictionary comprehension e le generator comprehension. Esistono anche le set comprehension in Python. Le set comprehension sono molto simili. In Python possono essere costruite così:
{skill for skill in ['SQL', 'SQL', 'PYTHON', 'PYTHON']}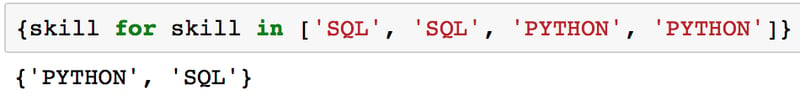
L'output sopra è un set di 2 valori perché i set non possono avere più occorrenze dello stesso elemento.
L'idea dietro l'uso delle set comprehension è permetterti di scrivere e ragionare nel codice allo stesso modo in cui faresti matematica a mano.
{skill for skill in ['GIT', 'PYTHON', 'SQL'] if skill not in {'GIT', 'PYTHON', 'JAVA'}}Il codice sopra è simile a una differenza tra set che hai visto prima. Semplicemente sembra un po' diverso.
Test di appartenenza
I test di appartenenza verificano se un elemento specifico è contenuto in una sequenza, come stringhe, liste, tuple o set. Uno dei principali vantaggi dell'uso dei set in Python è che sono altamente ottimizzati per i test di appartenenza. Per esempio, i set eseguono i test di appartenenza molto più efficientemente delle liste. Se hai un background in informatica, questo perché la complessità temporale media dei test di appartenenza nei set è O(1) contro O(n) per le liste.
Il codice sotto mostra un test di appartenenza usando una lista.
# Initialize a list
possibleList = ['Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS', 'Java', 'Spark', 'Scala']
# Membership test
'Python' in possibleList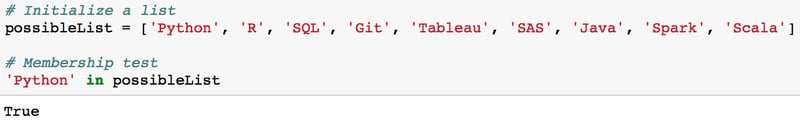
Si può fare qualcosa di simile con i set. I set sono semplicemente più efficienti.
# Initialize a set
possibleSet = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS', 'Java', 'Spark', 'Scala'}
# Membership test
'Python' in possibleSet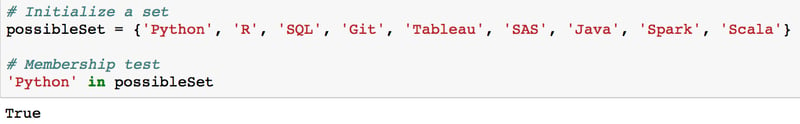
Dato che possibleSet è un set e il valore 'Python' è un valore di possibleSet, questo può essere indicato come 'Python' ∈ possibleSet.
Se avessi un valore che non fa parte del set, come 'Fortran', sarebbe indicato come 'Fortran' ∉ possibleSet.
Sottoinsieme
Un'applicazione pratica della comprensione dell'appartenenza è quella dei sottoinsiemi.
Per prima cosa inizializziamo due set.
possibleSkills = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
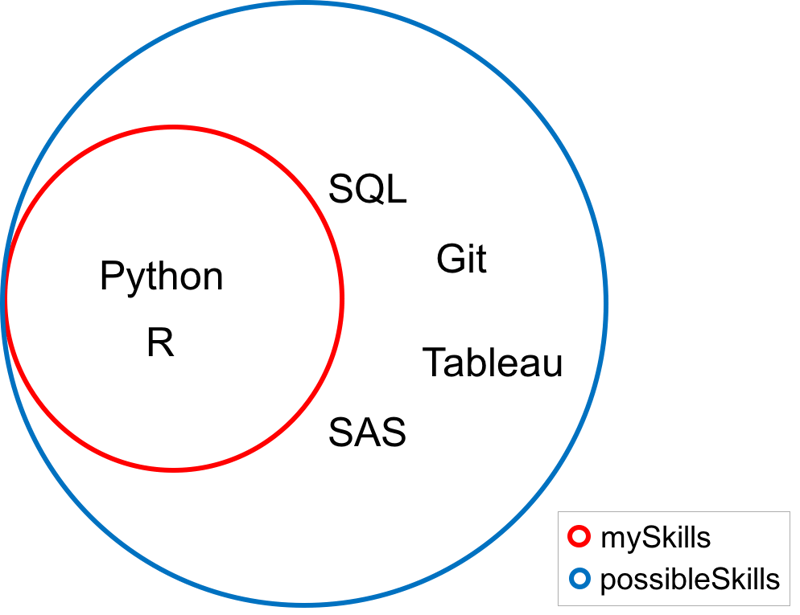
mySkills = {'Python', 'R'}Se ogni valore del set mySkills è anche un valore del set possibleSkills, allora mySkills è detto sottoinsieme di possibleSkills, scritto matematicamente mySkills ⊆ possibleSkills.
Puoi verificare se un set è sottoinsieme di un altro usando il metodo issubset.
mySkills.issubset(possibleSkills)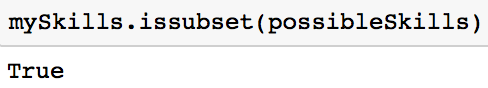
Poiché in questo caso il metodo restituisce True, si tratta di un sottoinsieme. Nel diagramma di Venn qui sotto, nota che ogni valore del set mySkills è anche un valore del set possibleSkills.
Frozenset
Ti sarà capitato di incontrare liste e tuple annidate.
# Nested Lists and Tuples
nestedLists = [['the', 12], ['to', 11], ['of', 9], ['and', 7], ['that', 6]]
nestedTuples = (('the', 12), ('to', 11), ('of', 9), ('and', 7), ('that', 6))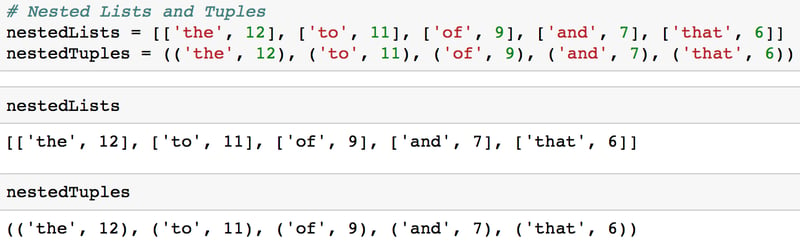
Il problema con i set annidati è che normalmente non puoi avere set Python annidati, dato che i set non possono contenere valori mutabili, inclusi i set stessi.
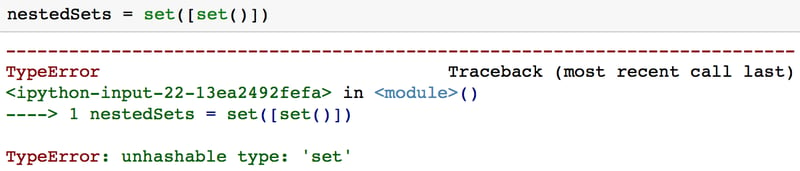
Questa è una delle situazioni in cui potresti voler usare un frozenset. Un frozenset è molto simile a un set, tranne per il fatto che è immutabile.
Crei un frozenset usando frozenset().
# Initialize a frozenset
immutableSet = frozenset()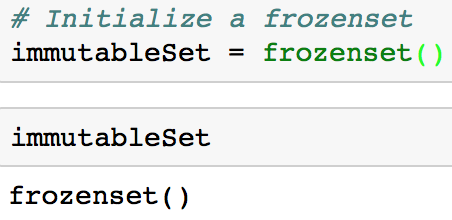
Puoi creare un set annidato se utilizzi un frozenset, come nel codice seguente.
nestedSets = set([frozenset()])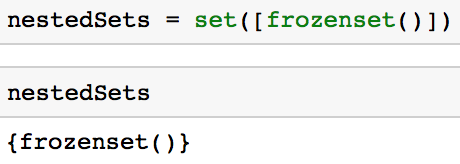
È importante tenere a mente che un grande svantaggio di un frozenset è che, essendo immutabile, non puoi aggiungere o rimuovere valori.
Conclusione
I set in Python sono molto utili per rimuovere in modo efficiente i valori duplicati da una collezione come una lista e per eseguire comuni operazioni matematiche come unioni e intersezioni. Una delle difficoltà che spesso si incontra è capire quando usare i vari tipi di dato. Per esempio, se non ti è chiaro quando convenga usare un dizionario invece di un set, ti invito a provare la modalità di pratica quotidiana di DataCamp. Se hai domande o pensieri sul tutorial, sentiti libero di scrivere nei commenti qui sotto o su Twitter.




Set, liste e tuple in Python
Le liste e le tuple sono tipi di dato standard di Python che archiviano valori in sequenza. I set sono un altro tipo di dato standard di Python che memorizza valori. La differenza principale è che i set, a differenza di liste o tuple, non possono contenere più occorrenze dello stesso elemento e memorizzano valori non ordinati.
Vantaggi di un set in Python
Poiché i set non possono avere più occorrenze dello stesso elemento, sono molto utili per rimuovere in modo efficiente i valori duplicati da una lista o tupla e per eseguire comuni operazioni matematiche come unioni e intersezioni.
Se vuoi affinare le tue abilità in Python, o sei appena agli inizi, dai un'occhiata al nostro percorso di carriera Python Programmer su DataCamp.
Detto questo, iniziamo.
Come creare un set in Python
I set sono una collezione mutabile di valori distinti (unici) e immutabili, non ordinati.
Puoi inizializzare un set vuoto usando set().
Per inizializzare un set con dei valori, puoi passare una lista a set().