Datatypen in Python
BasicSkill Level
4 uur
89.1K learners
Voer de code van deze tutorial online uit en bewerk deze
Code uitvoeren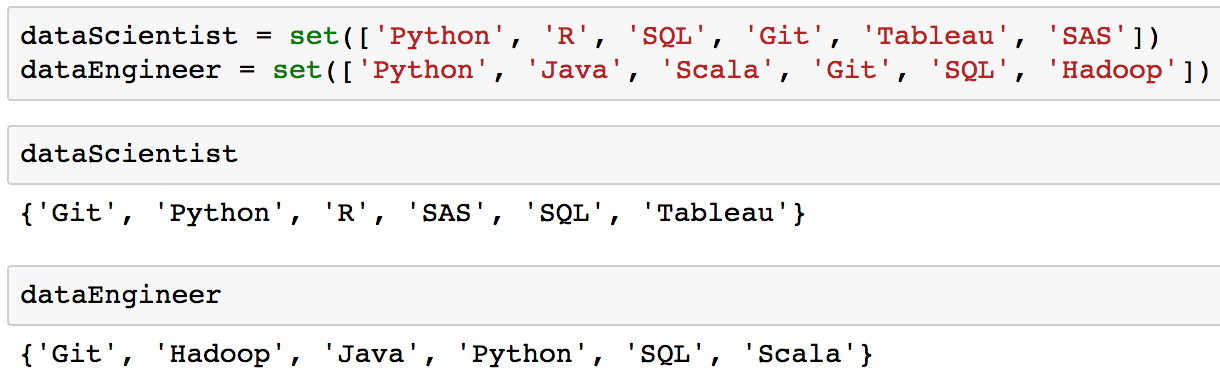
Als je naar de output van de variabelen dataScientist en dataEngineer hierboven kijkt, zie je dat de waarden in de set niet in de volgorde staan waarin ze zijn toegevoegd. Dit komt omdat sets ongeordend zijn.
Sets met waarden kunnen ook worden geïnitialiseerd met accolades.
dataScientist = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
dataEngineer = {'Python', 'Java', 'Scala', 'Git', 'SQL', 'Hadoop'}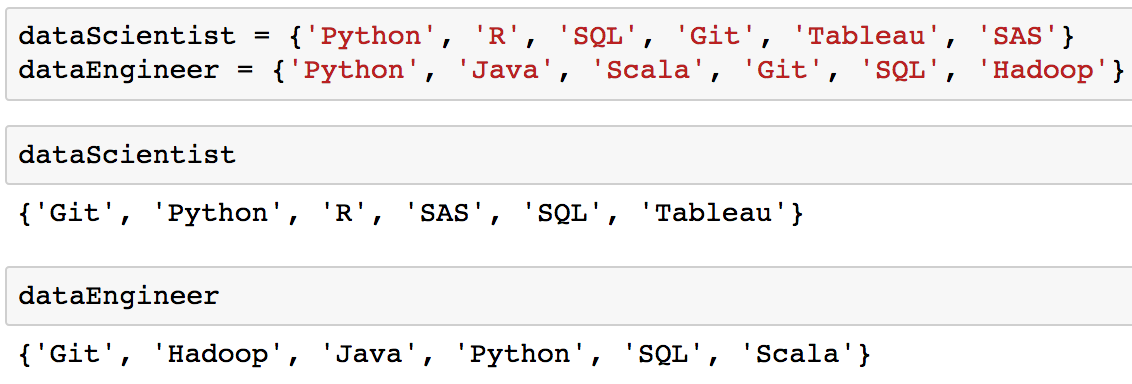
Houd er rekening mee dat accolades alleen gebruikt kunnen worden om een set met waarden te initialiseren. De afbeelding hieronder laat zien dat accolades zonder waarden een van de manieren is om een dictionary te initialiseren en niet een set.
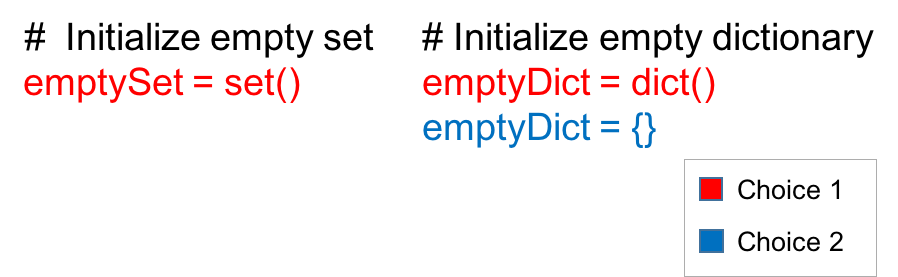
Om waarden toe te voegen aan of te verwijderen uit een set, moet je eerst een set initialiseren.
# Initialize set with values
graphicDesigner = {'InDesign', 'Photoshop', 'Acrobat', 'Premiere', 'Bridge'}Je kunt de methode add gebruiken om een waarde aan een set toe te voegen.
graphicDesigner.add('Illustrator')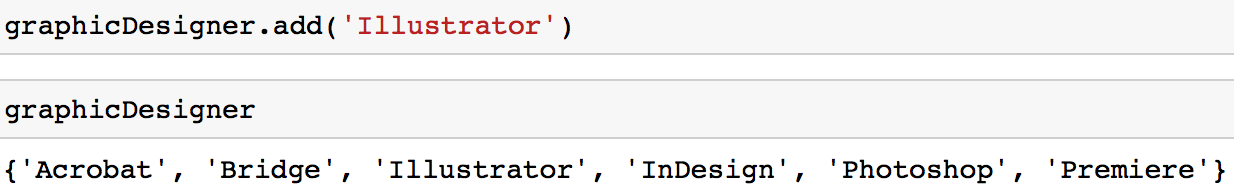
Belangrijk om te weten: je kunt alleen een onveranderlijke waarde (zoals een string of een tuple) aan een set toevoegen. Als je bijvoorbeeld probeert een list aan een set toe te voegen, krijg je een TypeError.
graphicDesigner.add(['Powerpoint', 'Blender'])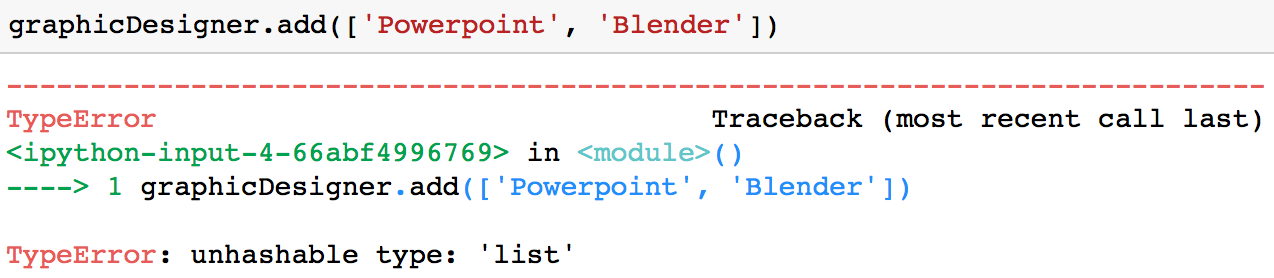
Er zijn een paar manieren om een waarde uit een set te verwijderen.
Optie 1: Je kunt de methode remove gebruiken om een waarde uit een set te verwijderen.
graphicDesigner.remove('Illustrator')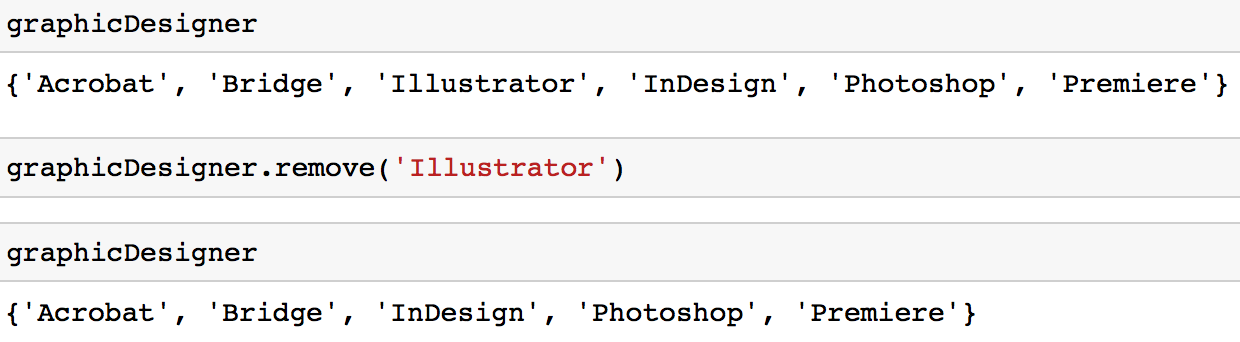
Het nadeel van deze methode is dat je een KeyError krijgt als je probeert een waarde te verwijderen die niet in je set staat.
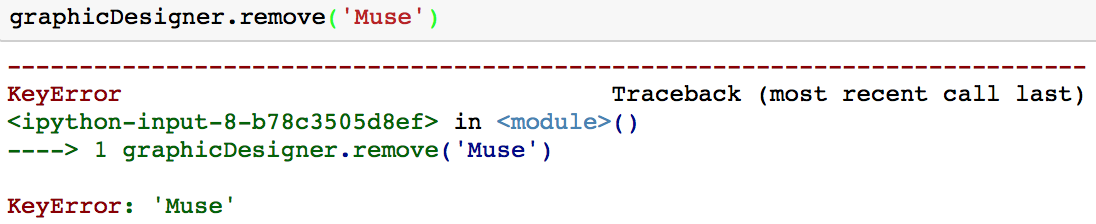
Optie 2: Je kunt de methode discard gebruiken om een waarde uit een set te verwijderen.
graphicDesigner.discard('Premiere')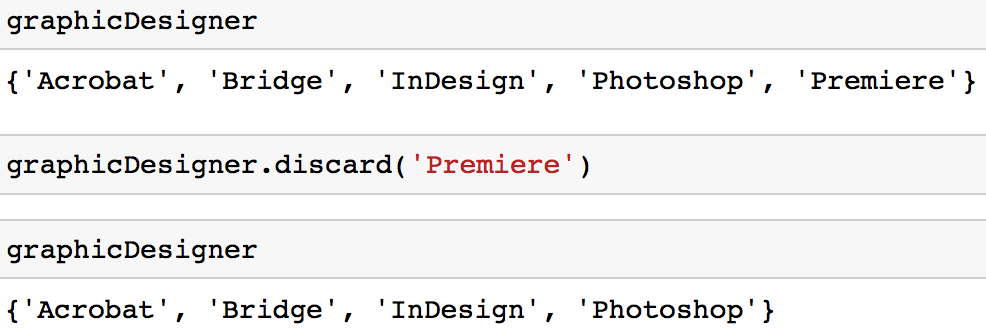
Het voordeel van deze aanpak ten opzichte van de methode remove is dat je geen KeyError krijgt als je probeert een waarde te verwijderen die geen deel uitmaakt van de set. Als je bekend bent met dictionaries, dan merk je dat dit vergelijkbaar werkt met de dictionarymethode get.
Optie 3: Je kunt ook de methode pop gebruiken om een willekeurige waarde uit een set te verwijderen en terug te geven.
graphicDesigner.pop()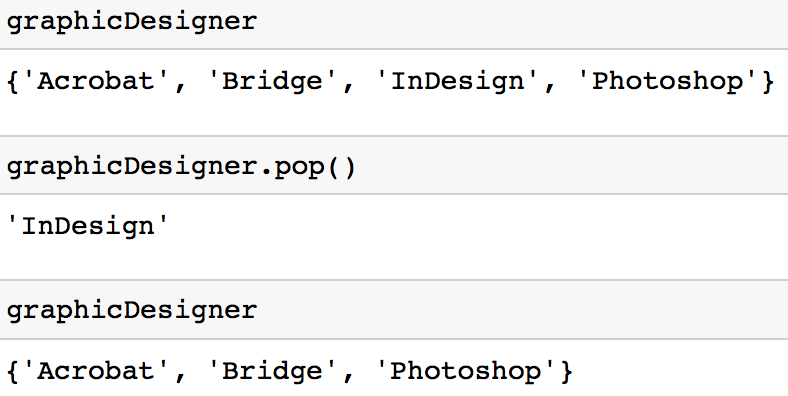
Belangrijk: deze methode geeft een KeyError als de set leeg is.
Je kunt de methode clear gebruiken om alle waarden uit een set te verwijderen.
graphicDesigner.clear()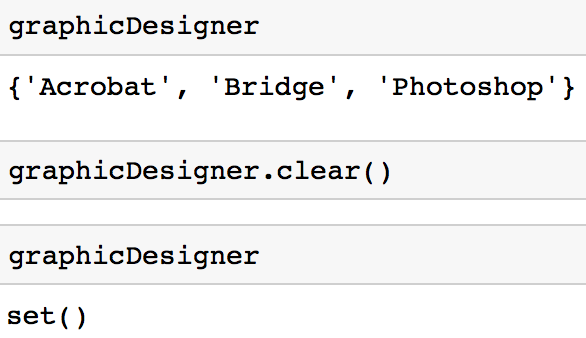
De update-methode voegt de elementen van een set toe aan een set. De methode vereist één argument dat een set, list, tuples of dictionary kan zijn. De .update()-methode zet andere datatypes automatisch om naar sets en voegt ze toe aan de set.
In het voorbeeld hebben we drie sets geïnitialiseerd en een updatefunctie gebruikt om eerst elementen van set2 aan set1 toe te voegen en daarna van set3 aan set1.
# Initialize 3 sets
set1 = set([7, 10, 11, 13])
set2 = set([11, 8, 9, 12, 14, 15])
set3 = {'d', 'f', 'h'}
# Update set1 with set2
set1.update(set2)
print(set1)
# Update set1 with set3
set1.update(set3)
print(set1)
Zoals bij veel standaard Python-datatypes is het mogelijk om over een set te itereren.
# Initialize a set
dataScientist = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
for skill in dataScientist:
print(skill)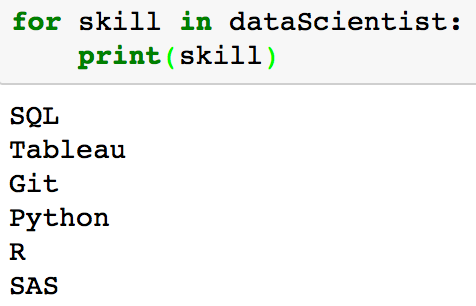
Als je naar de output kijkt van het printen van elke waarde in dataScientist, zie je dat de waarden in de set niet in de volgorde worden geprint waarin ze zijn toegevoegd. Dit komt omdat sets ongeordend zijn.
Deze tutorial heeft benadrukt dat sets ongeordend zijn. Als je de waarden uit je set in een geordende vorm nodig hebt, kun je de functie sorted gebruiken, die een geordende list als output geeft.
type(sorted(dataScientist))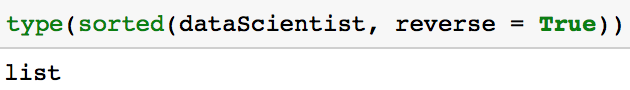
De code hieronder geeft de waarden in de set dataScientist in aflopende alfabetische volgorde (Z-A in dit geval).
sorted(dataScientist, reverse = True)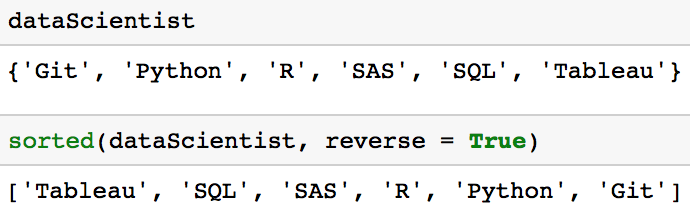
Een deel van de inhoud in deze sectie is eerder behandeld in de tutorial 18 Most Common Python List Questions, maar het is belangrijk om te benadrukken dat sets de snelste manier zijn om duplicaten uit een list te verwijderen. Om dit te laten zien, bekijken we het prestatiedverschil tussen twee aanpakken.
Aanpak 1: Gebruik een set om duplicaten uit een list te verwijderen.
print(list(set([1, 2, 3, 1, 7])))Aanpak 2: Gebruik een list comprehension om duplicaten uit een list te verwijderen (Wil je een opfrisser over list comprehensions, bekijk dan deze tutorial).
def remove_duplicates(original):
unique = []
[unique.append(n) for n in original if n not in unique]
return(unique)
print(remove_duplicates([1, 2, 3, 1, 7]))Het prestatiedverschil kan worden gemeten met de bibliotheek timeit, waarmee je je Python-code kunt timen. De code hieronder voert de code voor elke aanpak 10000 keer uit en geeft de totale tijd in seconden terug.
import timeit
# Approach 1: Execution time
print(timeit.timeit('list(set([1, 2, 3, 1, 7]))', number=10000))
# Approach 2: Execution time
print(timeit.timeit('remove_duplicates([1, 2, 3, 1, 7])', globals=globals(), number=10000))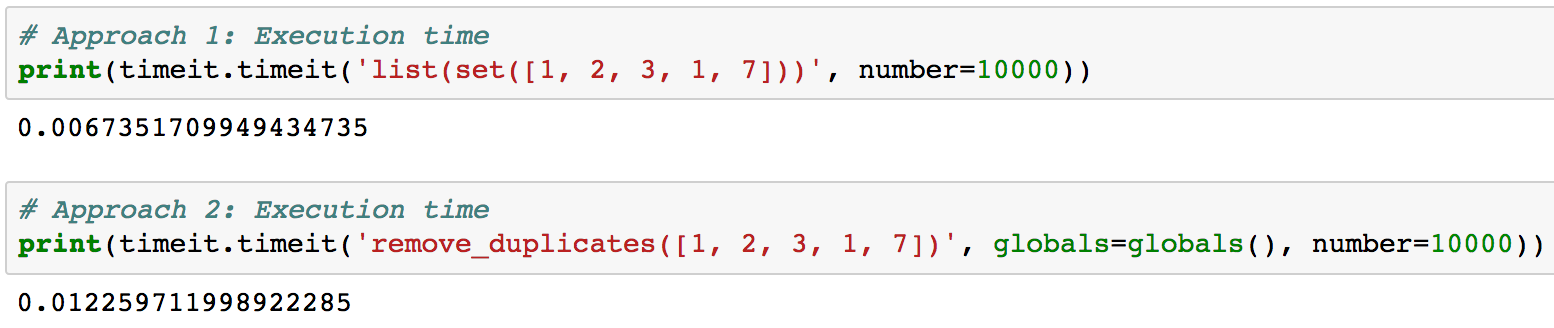
De vergelijking van deze twee aanpakken laat zien dat sets gebruiken om duplicaten te verwijderen efficiënter is. Het lijkt misschien een klein tijdsverschil, maar bij zeer grote lists kan het je veel tijd besparen.
Een veelvoorkomend gebruik van sets in Python is het berekenen van standaard wiskundige bewerkingen zoals unie, doorsnede, verschil en symmetrisch verschil. De afbeelding hieronder laat een paar standaard wiskundige bewerkingen zien op twee sets A en B. Het rode deel van elk Venn-diagram is de resulterende set van een gegeven setbewerking.
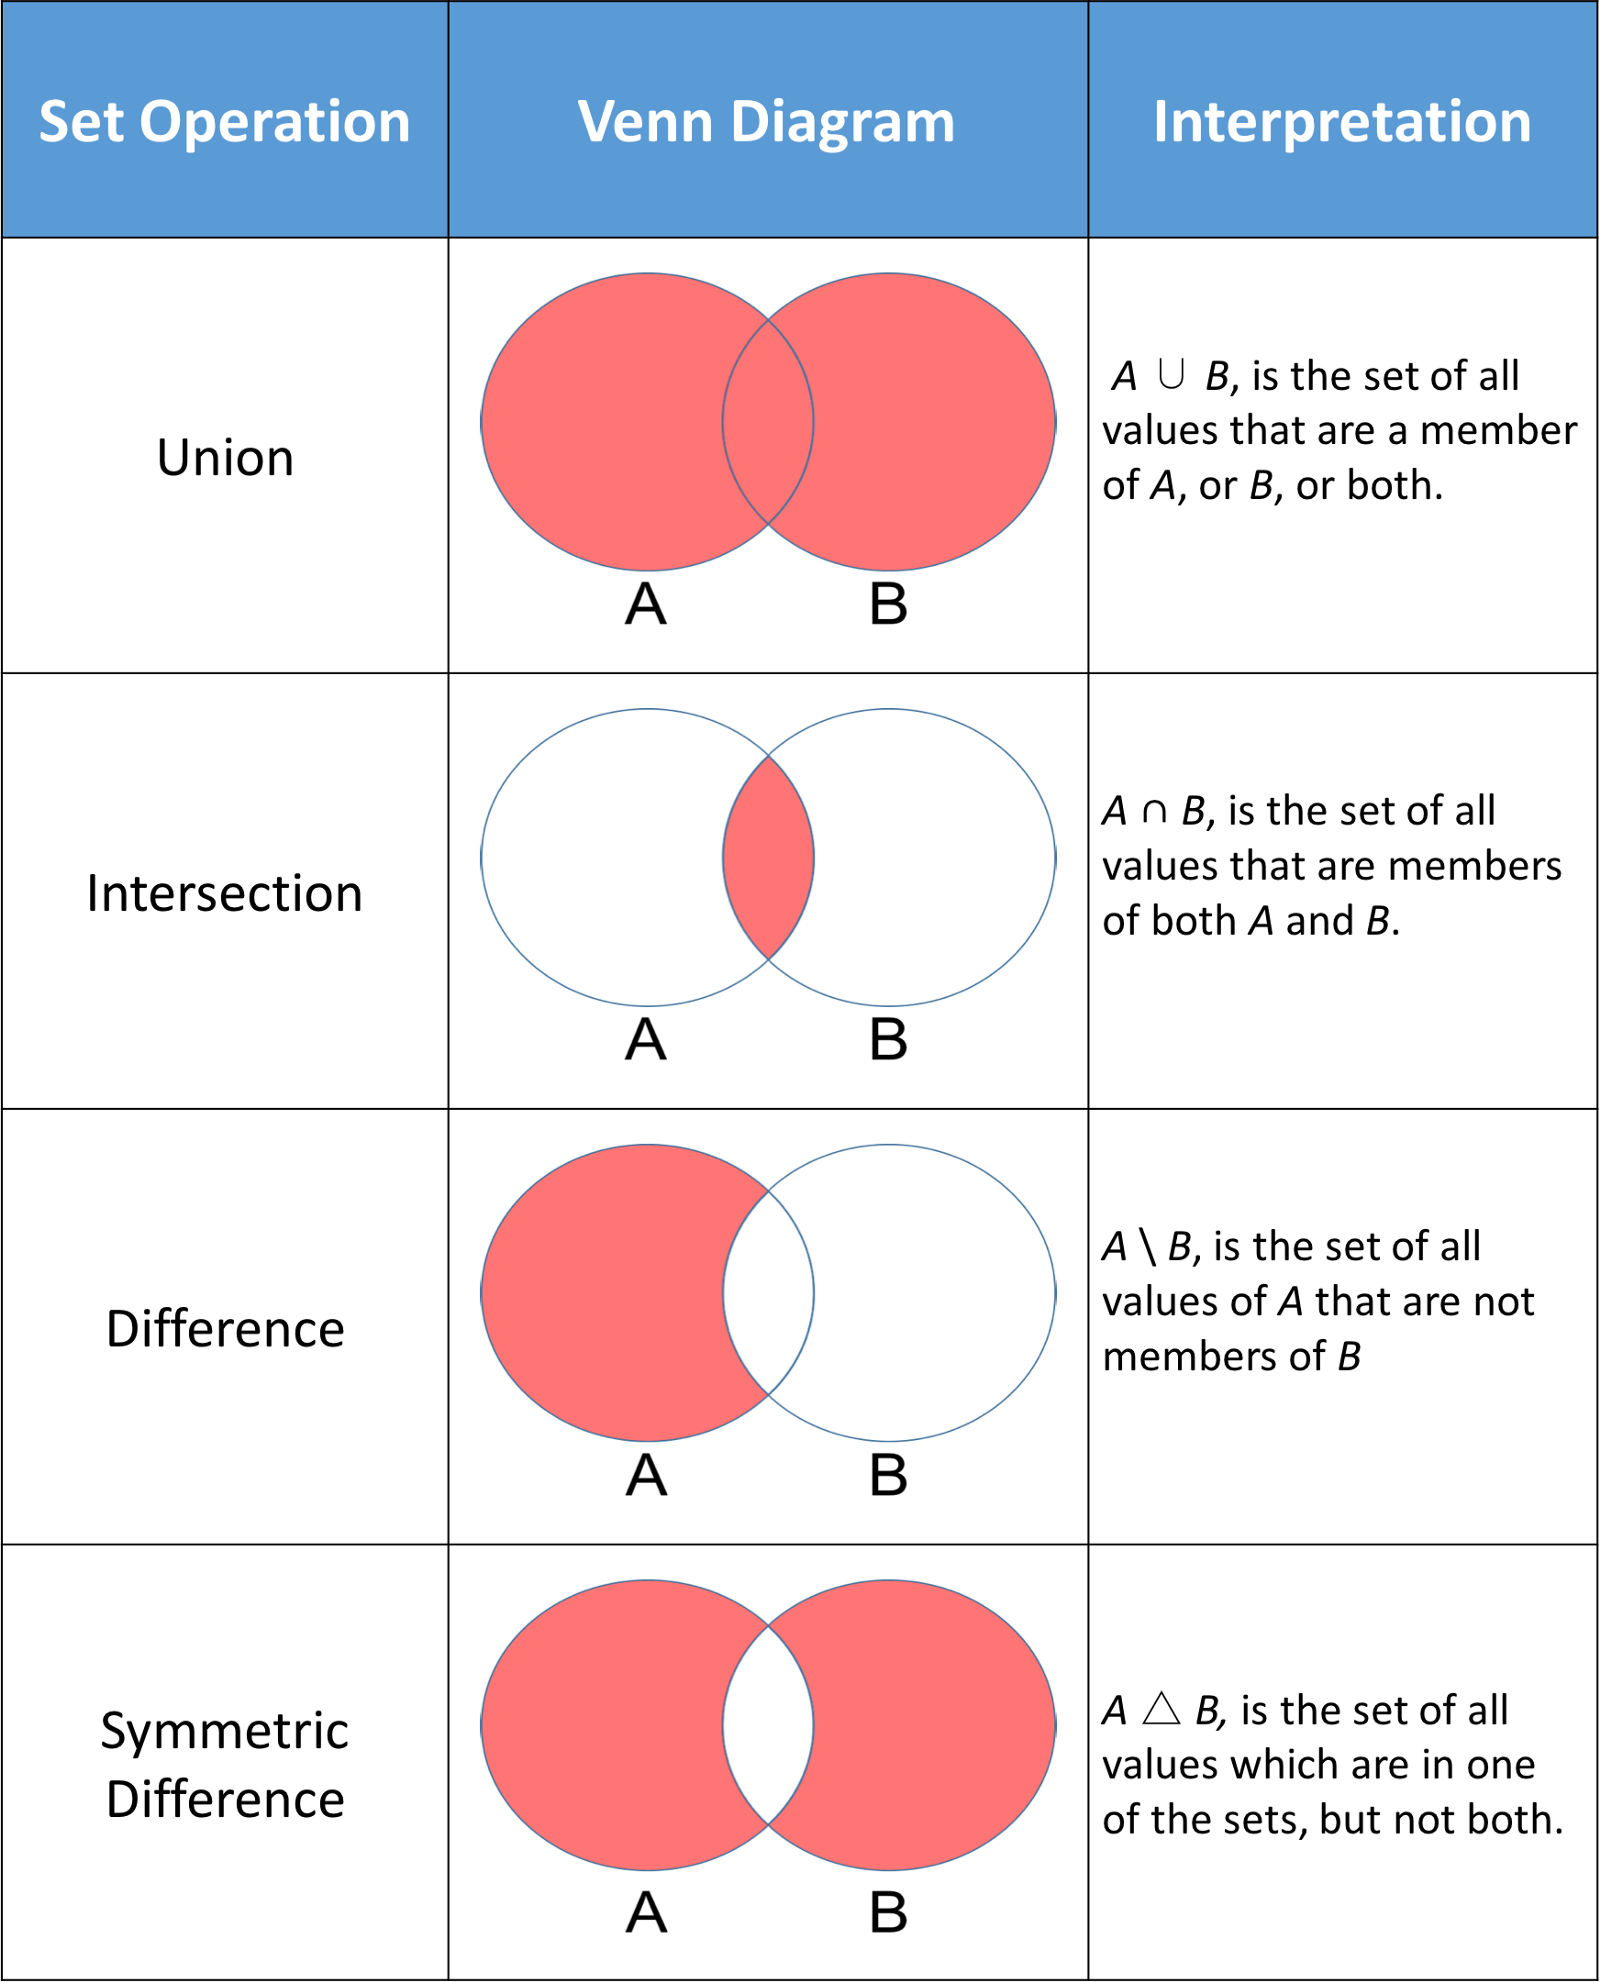
Python-sets hebben methoden waarmee je deze wiskundige bewerkingen kunt uitvoeren, evenals operatoren die equivalente resultaten geven.
Voordat we deze methoden verkennen, beginnen we met het initialiseren van twee sets, dataScientist en dataEngineer.
dataScientist = set(['Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'])
dataEngineer = set(['Python', 'Java', 'Scala', 'Git', 'SQL', 'Hadoop'])Een unie, genoteerd als dataScientist ∪ dataEngineer, is de set van alle waarden die waarden zijn van dataScientist, of dataEngineer, of beide. Je kunt de methode union gebruiken om alle unieke waarden in twee sets te vinden.
# set built-in function union
dataScientist.union(dataEngineer)

# Equivalent Result
dataScientist | dataEngineer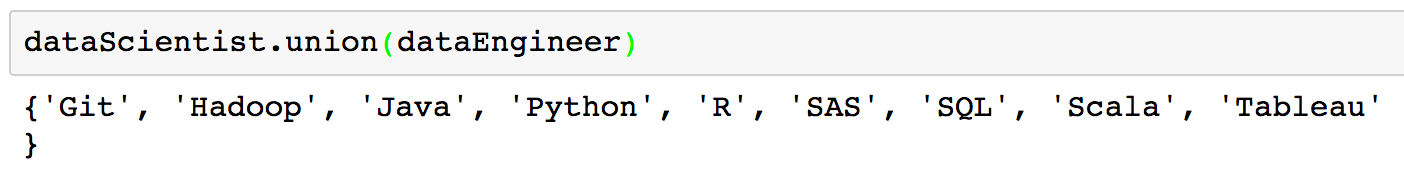
De set die uit de unie wordt teruggegeven, kun je visualiseren als het rode deel van het onderstaande Venn-diagram.
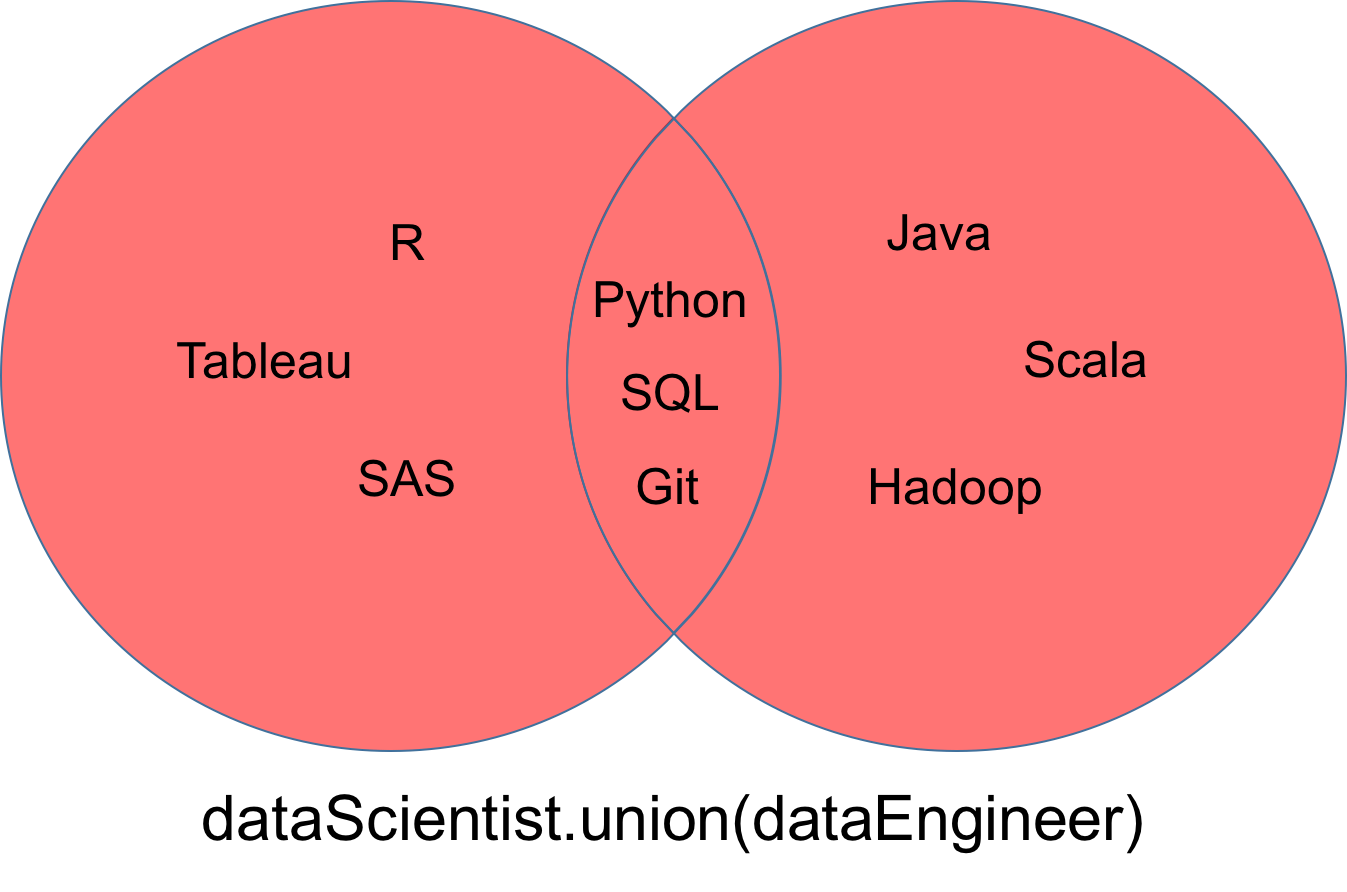
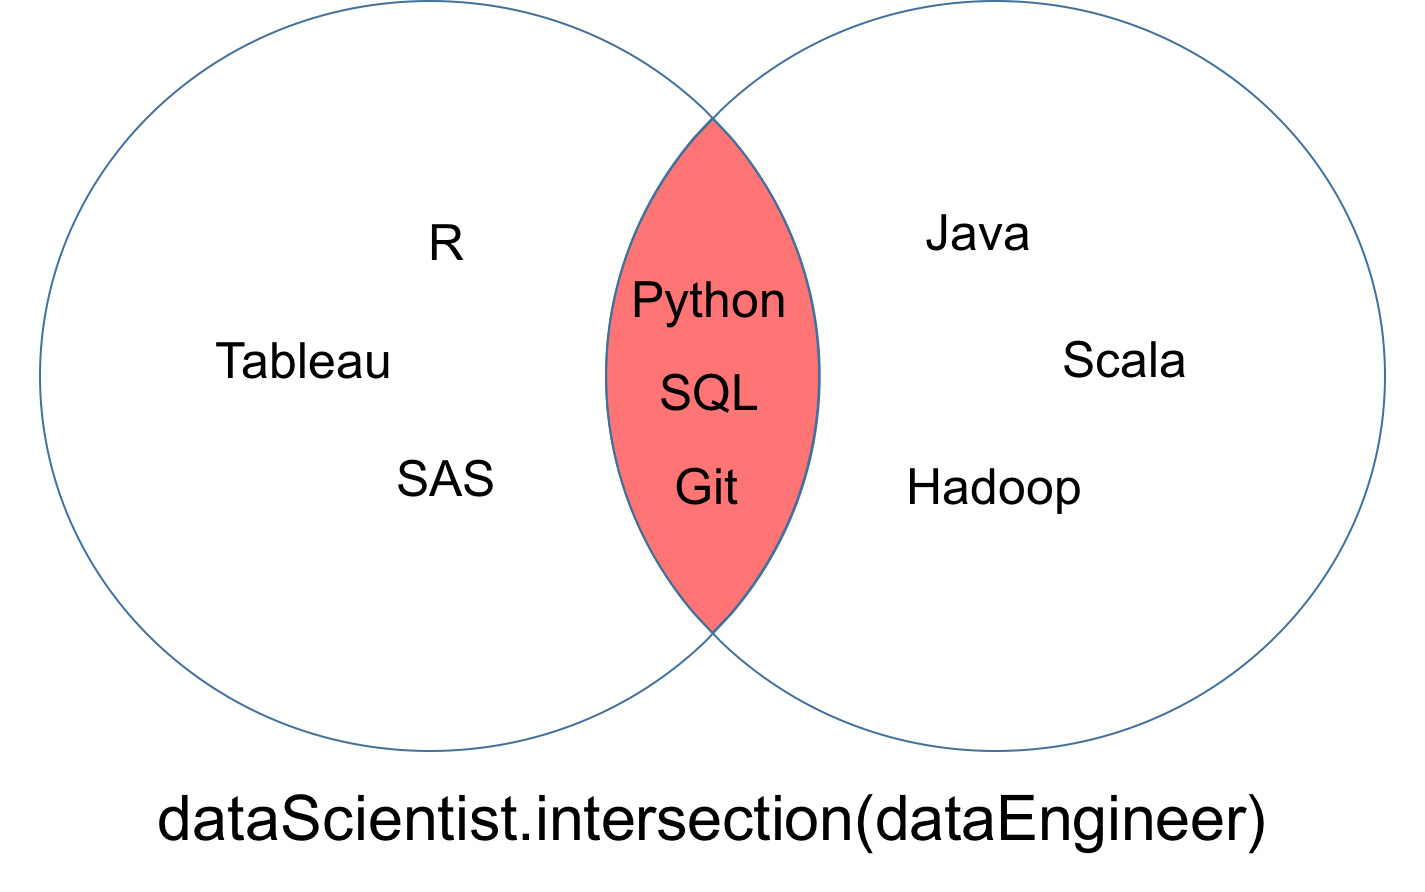
Een doorsnede van twee sets dataScientist en dataEngineer, genoteerd als dataScientist ∩ dataEngineer, is de set van alle waarden die waarden zijn van zowel dataScientist als dataEngineer.
# Intersection operation
dataScientist.intersection(dataEngineer)

# Equivalent Result
dataScientist & dataEngineer
De set die uit de doorsnede wordt teruggegeven, kun je visualiseren als het rode deel van het onderstaande Venn-diagram.
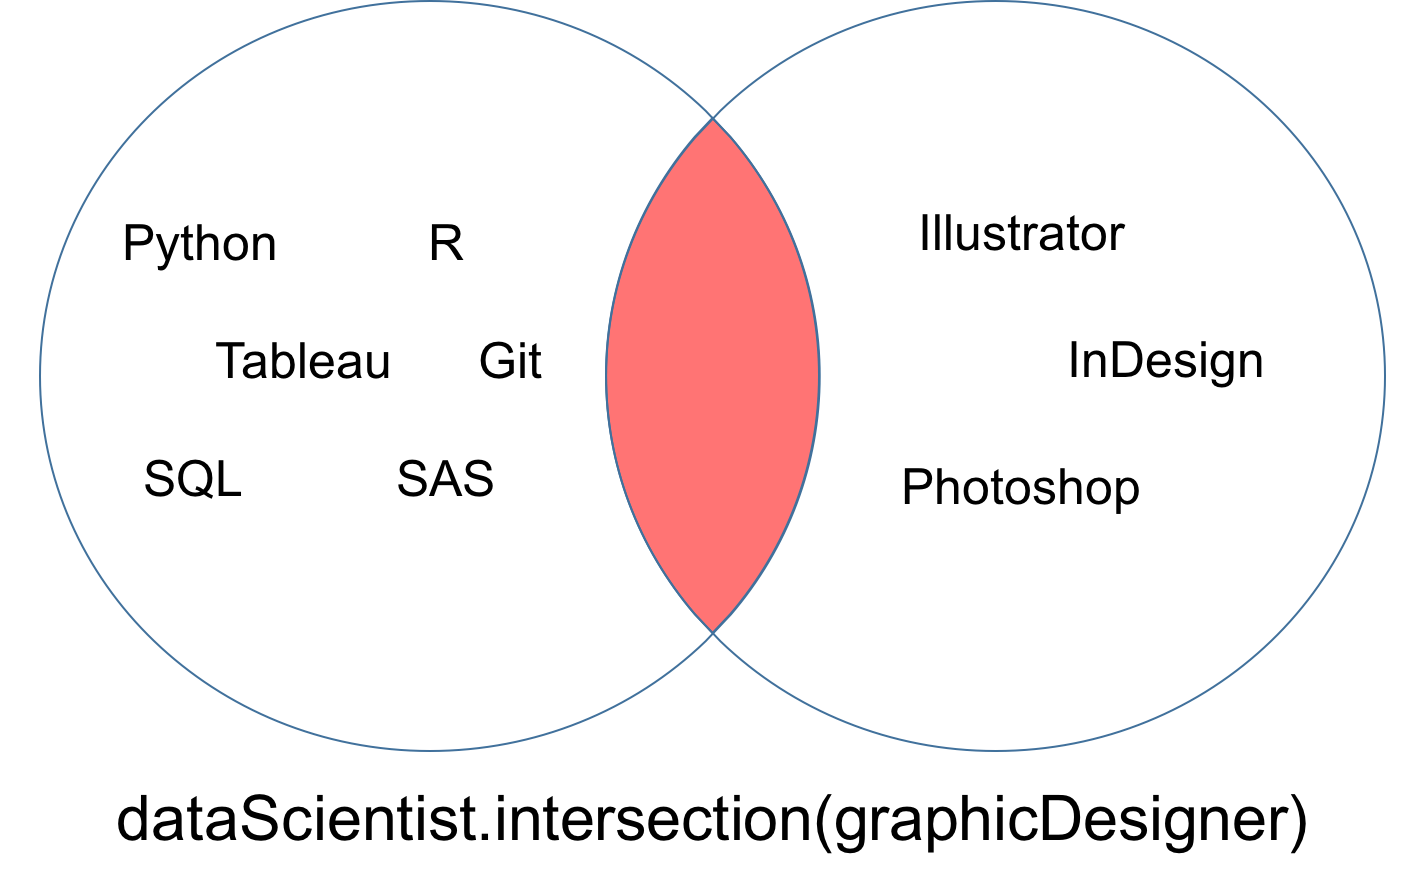
Je komt mogelijk een geval tegen waarin je zeker wilt weten dat twee sets geen enkele waarde gemeen hebben. Met andere woorden: je wilt twee sets met een lege doorsnede. Deze twee sets heten disjuncte sets. Je kunt op disjuncte sets testen met de methode isdisjoint.
# Initialize a set
graphicDesigner = {'Illustrator', 'InDesign', 'Photoshop'}

# These sets have elements in common so it would return False
dataScientist.isdisjoint(dataEngineer)

# These sets have no elements in common so it would return True
dataScientist.isdisjoint(graphicDesigner)
In de doorsnede die in het onderstaande Venn-diagram wordt getoond, zie je dat de disjuncte sets dataScientist en graphicDesigner geen waarden gemeen hebben.
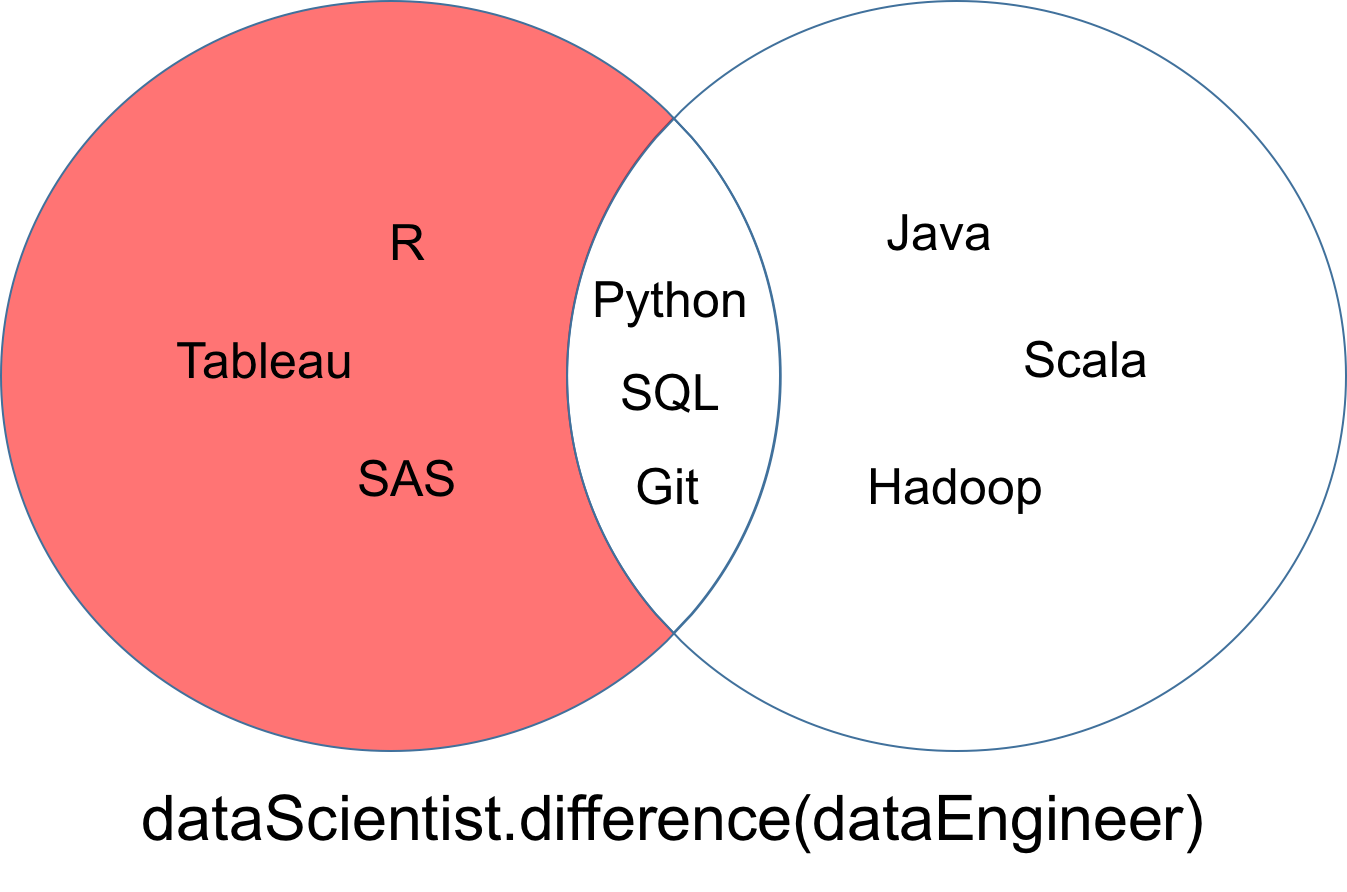
Een verschil van twee sets dataScientist en dataEngineer, genoteerd als dataScientist \ dataEngineer, is de set van alle waarden van dataScientist die geen waarden van dataEngineer zijn.
# Difference Operation
dataScientist.difference(dataEngineer)

# Equivalent Result
dataScientist - dataEngineer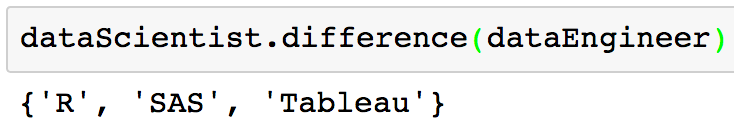
De set die uit het verschil wordt teruggegeven, kun je visualiseren als het rode deel van het onderstaande Venn-diagram.
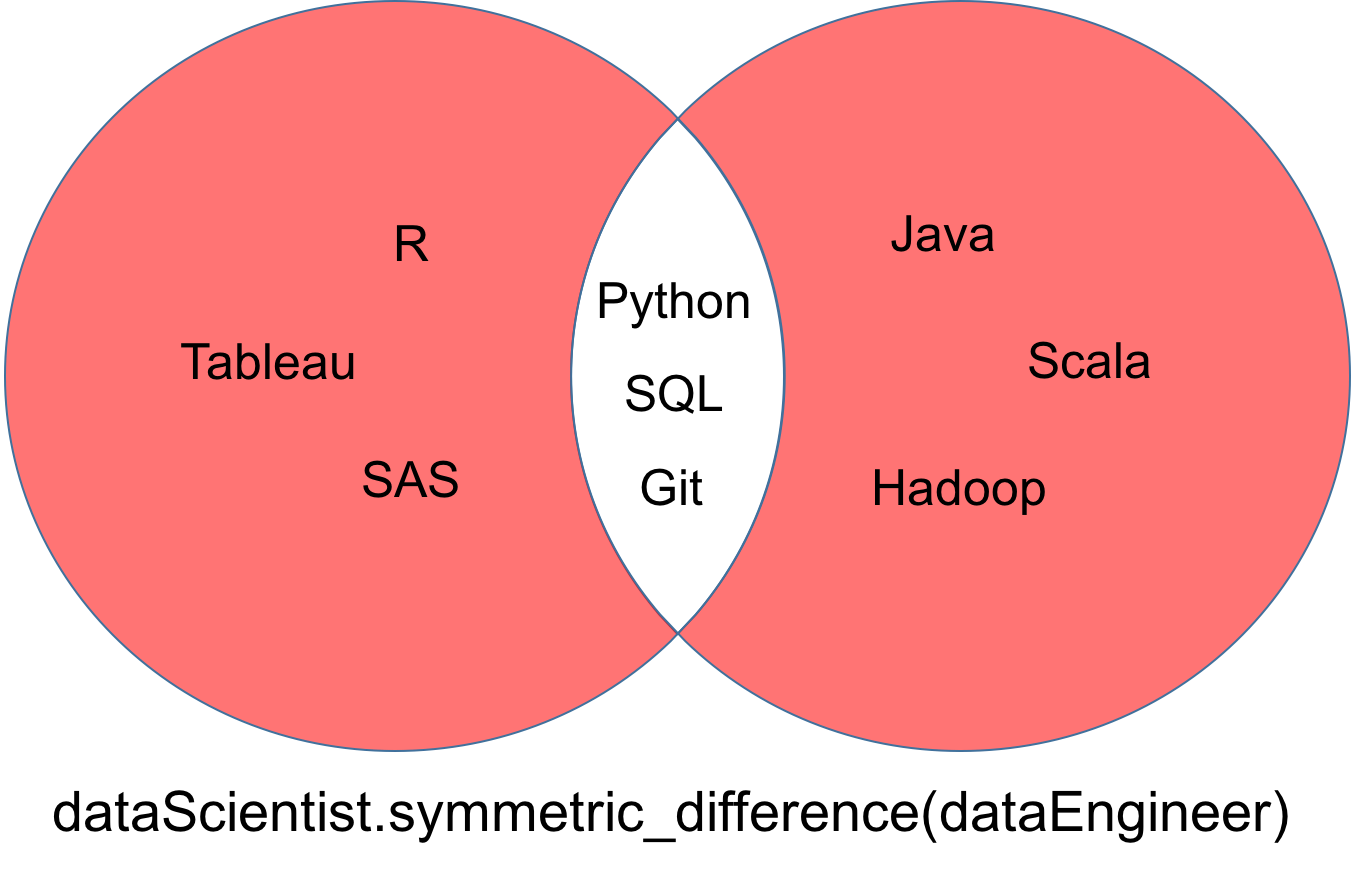
Een symmetrisch verschil van twee sets dataScientist en dataEngineer, genoteerd als dataScientist △ dataEngineer, is de set van alle waarden die waarden zijn van precies één van de twee sets, maar niet beide.
# Symmetric Difference Operation
dataScientist.symmetric_difference(dataEngineer)

# Equivalent Result
dataScientist ^ dataEngineer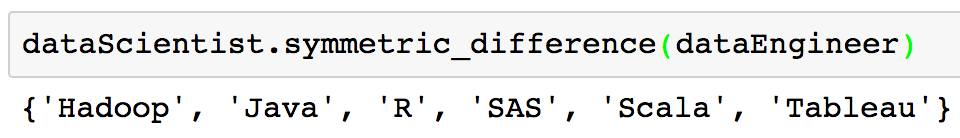
De set die uit het symmetrisch verschil wordt teruggegeven, kun je visualiseren als het rode deel van het onderstaande Venn-diagram.
Misschien heb je eerder geleerd over list comprehensions, dictionary comprehensions en generator comprehensions. Er zijn ook Python set comprehensions. Set comprehensions zijn erg vergelijkbaar. Set comprehensions in Python kunnen als volgt worden geconstrueerd:
{skill for skill in ['SQL', 'SQL', 'PYTHON', 'PYTHON']}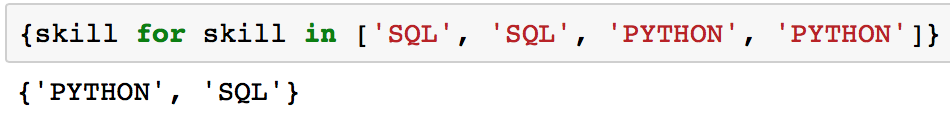
De output hierboven is een set van 2 waarden, omdat sets geen meerdere voorkomens van hetzelfde element kunnen hebben.
Het idee achter set comprehensions is dat je in code kunt schrijven en redeneren op dezelfde manier als je wiskunde met de hand zou doen.
{skill for skill in ['GIT', 'PYTHON', 'SQL'] if skill not in {'GIT', 'PYTHON', 'JAVA'}}De code hierboven is vergelijkbaar met een setverschil waar je eerder over hebt geleerd. Het ziet er alleen net iets anders uit.
Lidmaatschapstests controleren of een specifiek element is opgenomen in een sequentie, zoals strings, lists, tuples of sets. Een van de belangrijkste voordelen van sets in Python is dat ze sterk geoptimaliseerd zijn voor lidmaatschapstests. Zo voeren sets lidmaatschapstests veel efficiënter uit dan lists. Als je een achtergrond in computer science hebt: dit komt doordat de gemiddelde tijdscomplexiteit van lidmaatschapstests in sets O(1) is, tegenover O(n) voor lists.
De code hieronder toont een lidmaatschapstest met een list.
# Initialize a list
possibleList = ['Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS', 'Java', 'Spark', 'Scala']

# Membership test
'Python' in possibleList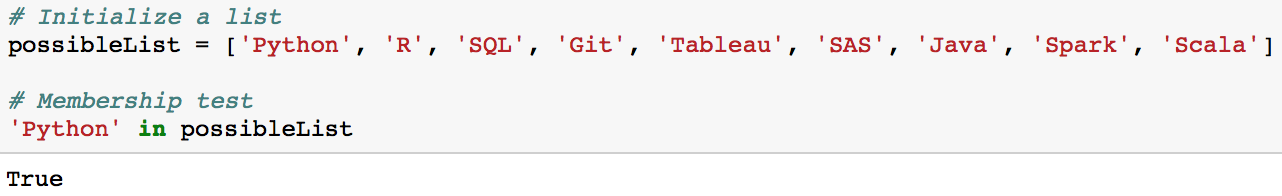
Iets vergelijkbaars kan met sets worden gedaan. Sets zijn gewoon efficiënter.
# Initialize a set
possibleSet = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS', 'Java', 'Spark', 'Scala'}

# Membership test
'Python' in possibleSet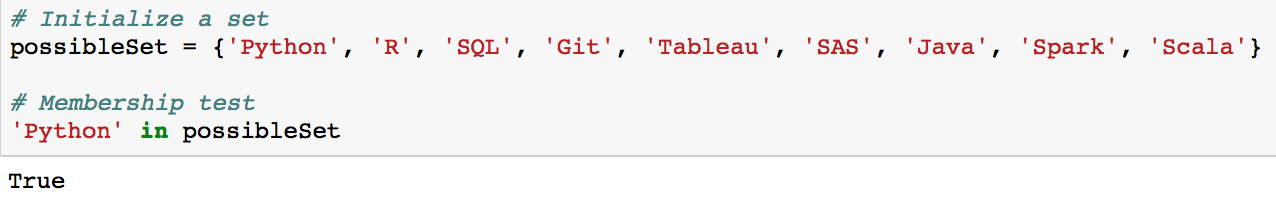
Aangezien possibleSet een set is en de waarde 'Python' een waarde is van possibleSet, kan dit worden genoteerd als 'Python' ∈ possibleSet.
Als je een waarde had die geen deel uitmaakte van de set, zoals 'Fortran', zou dat worden genoteerd als 'Fortran' ∉ possibleSet.
Een praktische toepassing van begrip van lidmaatschap is subsets.
Laten we eerst twee sets initialiseren.
possibleSkills = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
mySkills = {'Python', 'R'}
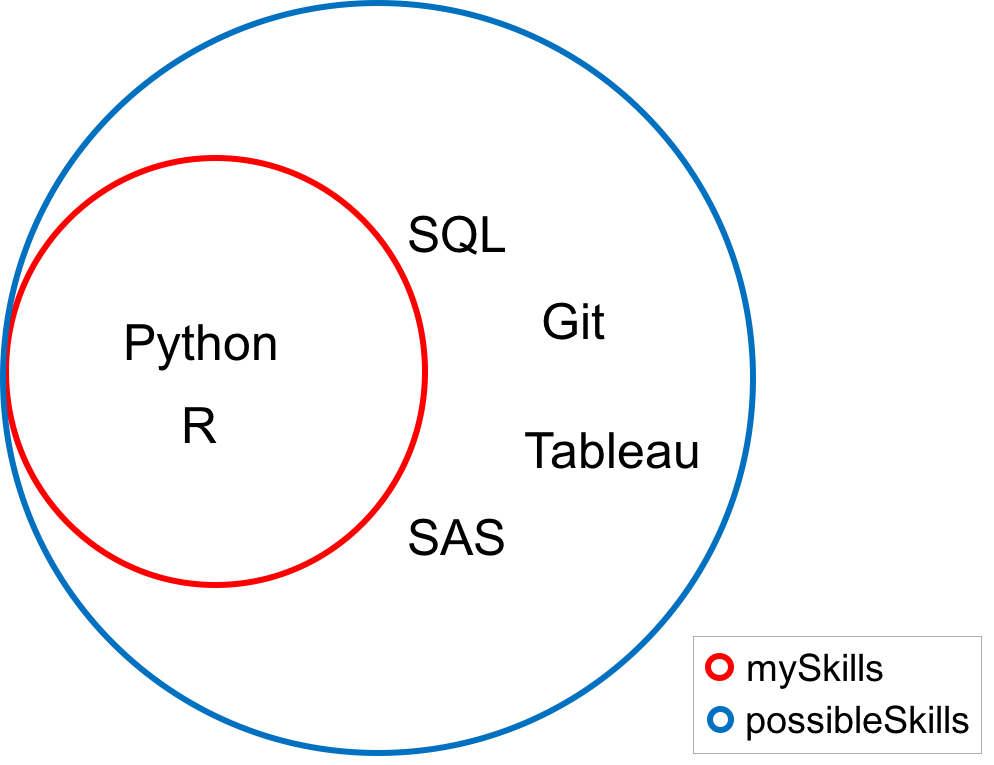
Als elke waarde van de set mySkills ook een waarde is van de set possibleSkills, dan is mySkills een subset van possibleSkills, wiskundig geschreven als mySkills ⊆ possibleSkills.
Je kunt controleren of de ene set een subset is van de andere met de methode issubset.
mySkills.issubset(possibleSkills)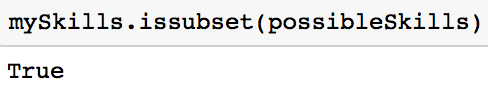
Aangezien de methode hier True teruggeeft, is het een subset. In het onderstaande Venn-diagram zie je dat elke waarde van de set mySkills ook een waarde is van de set possibleSkills.
Je bent misschien nested lists en tuples tegengekomen.
# Nested Lists and Tuples
nestedLists = [['the', 12], ['to', 11], ['of', 9], ['and', 7], ['that', 6]]
nestedTuples = (('the', 12), ('to', 11), ('of', 9), ('and', 7), ('that', 6))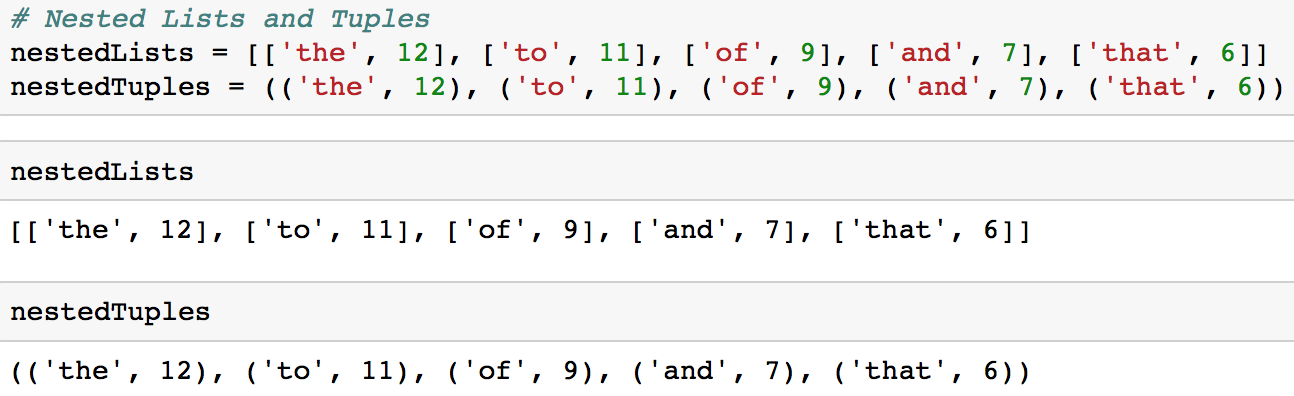
Het probleem met geneste sets is dat je normaal gesproken geen geneste Python-sets kunt hebben, omdat sets geen muteerbare waarden kunnen bevatten, waaronder sets.
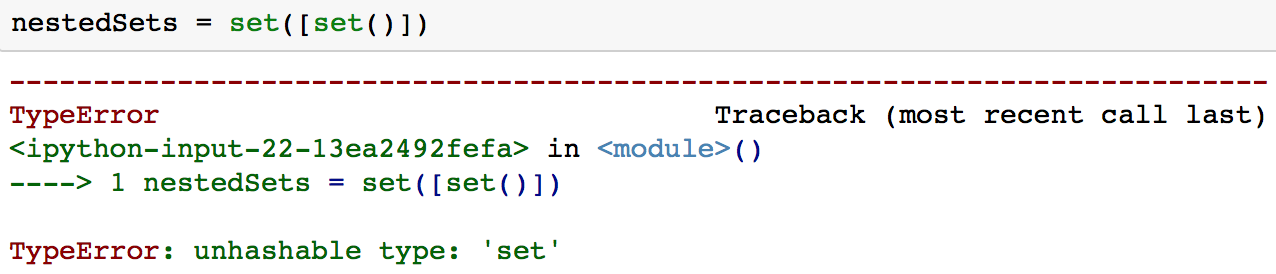
Dit is een situatie waarin je mogelijk een frozenset wilt gebruiken. Een frozenset lijkt sterk op een set, behalve dat een frozenset onveranderlijk is.
Je maakt een frozenset met frozenset().
# Initialize a frozenset
immutableSet = frozenset()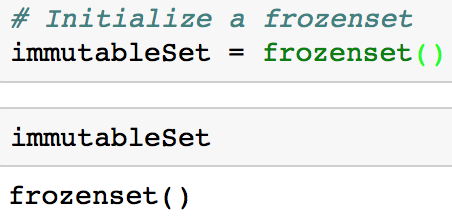
Je kunt een geneste set maken als je een frozenset gebruikt, zoals in de onderstaande code.
nestedSets = set([frozenset()])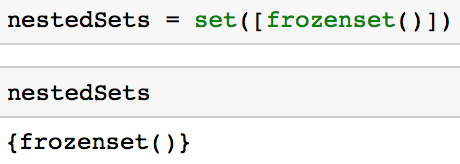
Belangrijk om te onthouden: een groot nadeel van een frozenset is dat je, omdat ze onveranderlijk zijn, geen waarden kunt toevoegen of verwijderen.
Python-sets zijn erg handig om efficiënt dubbele waarden uit een collectie zoals een list te verwijderen en om veelvoorkomende wiskundige bewerkingen zoals unies en doorsneden uit te voeren. Een van de uitdagingen waar mensen vaak tegenaan lopen, is wanneer je de verschillende datatypes gebruikt. Als je bijvoorbeeld denkt dat je niet zeker weet wanneer het voordelig is om een dictionary te gebruiken in plaats van een set, raad ik je aan om de dagelijkse oefenmodus van DataCamp te bekijken. Als je vragen of gedachten hebt over de tutorial, laat dan gerust een reactie achter hieronder of neem contact op via Twitter.
Python-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

