

什么是 LAG() 函数?
LAG() 是 SQL 的窗口函数之一,允许您创建一个新列,用于从另一列的前一行获取值。其名称来源于这样一个事实:您创建的新列中的每一行都会“滞后”到您指定的另一列的前一行去取值。
让我们看看基本语法的实际效果。假设我们有一个包含每日股价的两列表,如下所示:
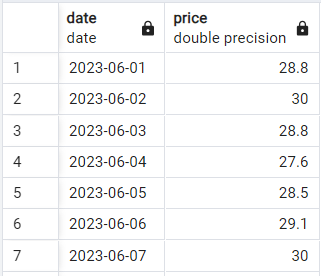
示例股价数据。作者制图。
我们可以使用以下查询,在每一行中创建一个新列以获取前一日的价格:
SELECT date,
price,
LAG(price) OVER(ORDER BY date) AS one_day_before
FROM stock_price;结果如下:
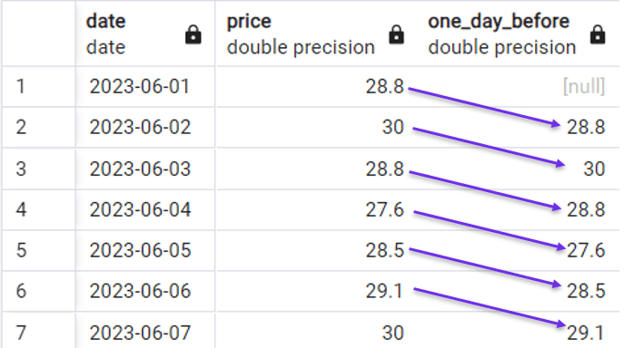
LAG() 的快速示例。作者制图。
请注意,因为第一行没有前一日的值,所以我们引入了一个 [null] 值。
LAG() 函数的基本语法
LAG() 函数写在 SELECT 子句中。在最基本的语法中,函数可写为:
LAG(column1) OVER(ORDER BY column2)下面是在独立查询中应用相同 LAG() 函数的示例:
SELECT
column1,
column2,
LAG(column1) OVER (ORDER BY column2) AS previous_value
FROM
table_name;如您所见,基本语法由几个部分组成。让我们逐一拆解:
- column1:这是要取较早一行的值的列。
- OVER():
OVER()是每个窗口函数的必备关键字。该子句定义窗口函数运行的范围。在上例中,窗口函数将在按column2排序后的数据上运行。 - ORDER BY:
ORDER BY并非强制,但在配合LAG()使用时强烈建议加上;通常没有排序,函数也就失去了意义。 - column2:该列决定
LAG()函数所遵循的顺序。可以使用多个列来作为排序依据。
为何使用 LAG() 函数
您可能会问,LAG() 有何妙处?答案是:这个滞后列可以用来比较来自不同行的值。
这也是 LAG() 常用于时间序列数据的原因。例如,在我们的演示数据集中,我们可以用以下查询轻松计算股价的每日变化:
SELECT date,
price,
LAG(price) OVER(ORDER BY date) AS one_day_before,
price - LAG(price) OVER(ORDER BY date) AS daily_change
FROM stock_price; 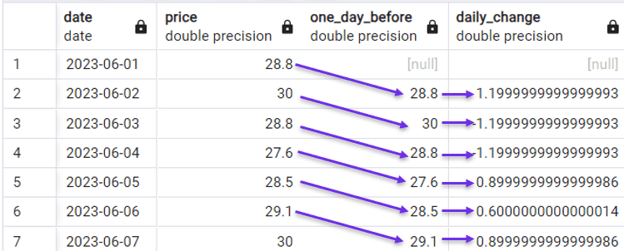
用 LAG() 计算每日变动。作者制图。
我们还可以更进一步,计算每日百分比变化。
SELECT date,
price,
LAG(price) OVER(ORDER BY date) AS one_day_before,
price - LAG(price) OVER(ORDER BY date) AS daily_change,
((price - LAG(price) OVER(ORDER BY date))*100 /
(LAG(price) OVER(ORDER BY date))) AS daily_perc_change
FROM stock_price; 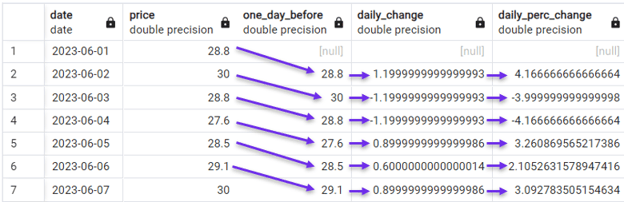
用 LAG() 计算每日百分比变化。作者制图。
LAG() 函数的高级用法
既然已经理解了 LAG() 的基础用法,让我们一步步升级,看看还能做些什么。
这里我们切换到另一个演示数据集,记录了三家虚构公司 Welsh LLC、Jones Group 和 Green-Keebler 自 2022 年初至 2024 年中期的月度营收。数据结构如下:
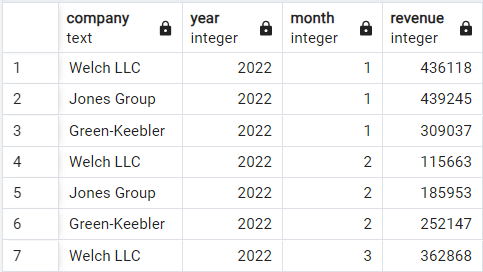
演示营收数据集。作者制图。
按多列排序
在这个新数据集中,滞后列需要基于两列:year 和 month 进行排序。正如前面提到的,这可以通过在 ORDER BY 子句中传入这两列来完成。
在下面的查询中,我们创建了一个滞后列和一个月环比(MoM)营收差值列,均按 year 与 month 排序。同时,我们用 WHERE 子句筛选出其中一家公司以便聚焦:
SELECT *,
LAG(revenue) OVER(ORDER BY year, month) AS one_month_before,
revenue - LAG(revenue) OVER(ORDER BY year, month) AS mom_difference
FROM revenues
WHERE company = 'Welch LLC'; 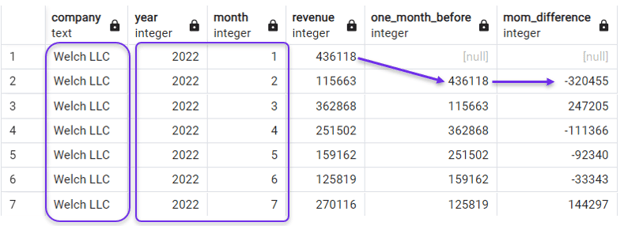
为 LAG() 按年份与月份排序。作者制图。
对 LAG() 窗口进行分区
假设我们想为数据集中的三家公司都计算这两个列。如果仍按之前的方式使用 LAG(),滞后列会跨三家公司运行,差值列也会混合它们的营收,这并非我们所需。
我们期望的结果是:分别针对每家公司取上月营收并计算 MoM 差值,然后在切换到下一家公司时重新开始计算。
为此,我们在 LAG() 语法中引入一个新子句:PARTITION BY,可按如下方式加入到基本语法中:
LAG(column1) OVER(PARTITION BY column3 ORDER BY column2)在我们的示例中,需要按 company 分区。因此,我们将在前一个查询中添加 PARTITION BY 子句,并移除 WHERE 语句。
SELECT *,
LAG(revenue) OVER(PARTITION BY company ORDER BY year, month) AS one_month_before,
revenue - LAG(revenue) OVER(PARTITION BY company ORDER BY year, month) AS mom_difference
FROM revenues;在结果中,您会看到滞后与 MoM 两列现在只在首家公司的月度营收上运行,然后在下一家公司重新开始。下方截图展示了 Green-Keebler 的最后几个月以及 Jones Group 的最初几个月,可以清楚看到这一点。
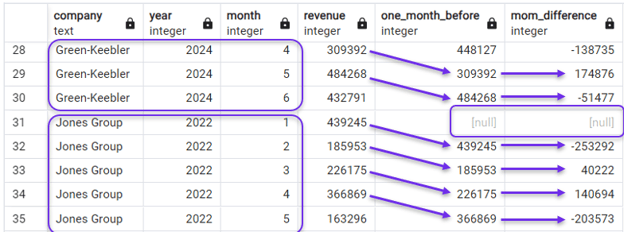
结合 PARTITION BY 使用 LAG()。作者制图。
自定义偏移量
如果我们不是要取前一行的值,而是要取上面第六行或第十二行的值怎么办?换言之,如果我们需要计算同比(YoY)而不是环比(MoM)呢?
此时应在 LAG() 语法中加入一个新参数:偏移量(offset),用于指定相对当前行向上取第几行的值。其在语法中的位置如下:
LAG(column1, offset) OVER(PARTITION BY column3 ORDER BY column2)默认情况下(也是我们此前的用法),偏移量为 1。不过,通过在 LAG() 表达式中显式指定偏移量,我们可以改变这一默认参数。
回到示例,要得到同比营收变化,我们需要取上一年同月的营收。如下查询中,我们将偏移量指定为 12:
SELECT *,
LAG(revenue, 12) OVER(PARTITION BY company ORDER BY year, month) AS one_year_before,
revenue - LAG(revenue, 12) OVER(PARTITION BY company ORDER BY year, month) AS yoy_difference
FROM revenues;结果如下:
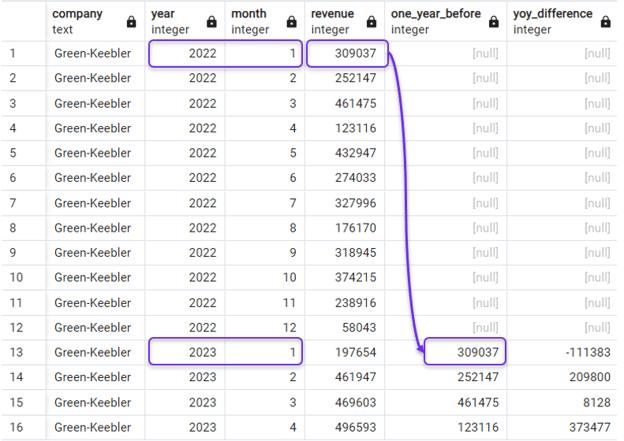
使用 LAG() 计算同比差值。作者制图。
处理 NULL
您可能已经注意到,在没有更早期间可用的行中(例如前面查询中 2022 年的行),LAG() 会返回 NULL。
这是 LAG() 的默认行为,但可以通过显式指定名为 “default” 的新参数来修改。该参数可接受任意整数或浮点数值。在函数语法中的位置如下:
LAG(column1, offset, default) OVER(PARTITION BY column3 ORDER BY column2)“default” 参数的常见用例是:当时间序列中的值在起始时实际上从零开始。
在我们的示例中,可以假设三家公司均创立于 2022 年 1 月(数据集中最早的日期),因此可将创立前的营收视为零。这样能更准确地计算营收变化,因为最初几个月的任何营收增长都应计为正向变化。
在查询中,我们将在两个 LAG() 表达式中都将 “default” 参数设为零:
SELECT *,
LAG(revenue, 12, 0) OVER(PARTITION BY company ORDER BY year, month) AS one_year_before,
revenue - LAG(revenue, 12, 0) OVER(PARTITION BY company ORDER BY year, month) AS yoy_difference
FROM revenues;结果是在滞后列中得到零值,并在同比变化列中得到相对零的净营收:
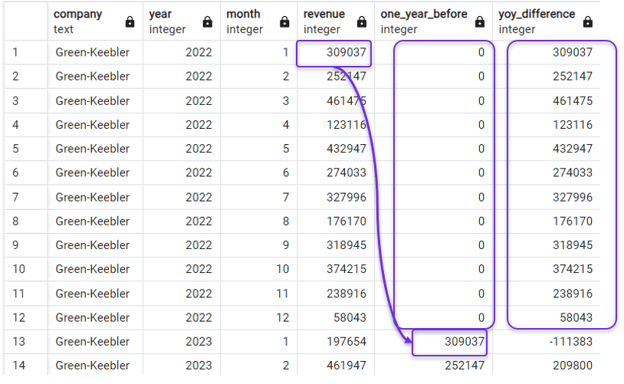
在 LAG() 中用零替换 NULL。作者制图。
请注意:若要显式为 “default” 指定数值,就必须同时显式指定偏移量,因为在 LAG() 中列名之后给出的第一个数字无论如何都会被视为偏移量。
如果您需要更改 “default” 而不想改变偏移量,请将偏移量参数设为 1,这样其行为将与通常情况一致。
在 LAG() 之后重新排序
值得注意的是,LAG() 所依赖的排序并不需要与最终结果视图的排序一致。您始终可以在查询中通过常规 ORDER BY 子句重新设定输出顺序。
在我们的示例中,我们可以在外层 ORDER BY 子句中按年份与月份排序,从而让结果按同一年同一月份展示三家公司的数据,然后再进入下一月份:
SELECT *,
LAG(revenue, 12, 0) OVER(PARTITION BY company ORDER BY year, month) AS one_year_before,
revenue - LAG(revenue, 12, 0) OVER(PARTITION BY company ORDER BY year, month) AS yoy_difference
FROM revenues
ORDER BY year, month;这样就能得到我们想要的排序:
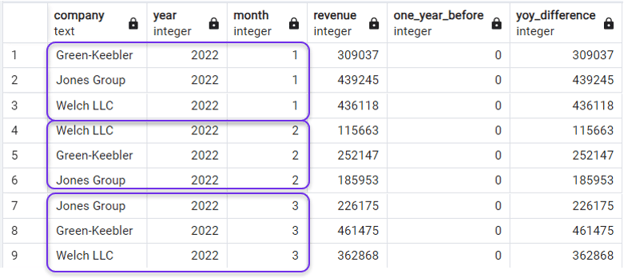
LAG() 之后对查询结果排序。作者制图。
常见错误与最佳实践
如果您在排错,不妨看看这些常见问题。
排序不当
-
陷阱:在
LAG()语句中未指定ORDER BY可能导致结果不正确。即便源表的原始顺序目前“看起来合适”,也不要依赖它,因为顺序可能随时间而变化。 -
最佳实践:始终在
LAG()语句中使用ORDER BY,并确保按正确的列排序。
分区不当
-
陷阱:忽视
PARTITION BY的使用或错误选择分区列,导致LAG()窗口范围不正确。 -
最佳实践:仔细核对
LAG()函数运行时所分区的范围。
偏移量错误
- 陷阱:由于偏移量设置不当而导致滞后值错误。
- 最佳实践:仔细确认所需的偏移量;请记住,默认偏移量在某些场景下可能并不合适。
NULL 处理不当
-
陷阱:当更合适的值存在时,仍在
LAG()输出中保留NULL,却未声明 “default” 参数。 -
最佳实践:始终考虑数据集时间序列开始之前的值意味着什么。在某些情况下,如我们示例所示,用零替代 null 更为合适。
声明 default 却未声明 offset
- 陷阱:声明了 “default” 参数却未声明偏移量,会导致该 “default” 值被当作偏移量。
- 最佳实践:若显式指定了 “default”,务必同时声明偏移量。
用别名替代函数表达式
-
陷阱:如果在多个列中使用相同的
LAG()语句,第二个列中仍需写出完整的LAG()表达式,而不能使用第一个LAG()列的别名。使用别名会报错。 -
最佳实践:在
SELECT语句中始终完整书写LAG()表达式。
忽视索引
-
陷阱:
LAG()和所有窗口函数一样,在大数据集上可能计算成本较高。因此,忽略对PARTITION BY与ORDER BY中使用的列建立索引,可能导致性能不佳。 -
最佳实践:尽可能确保
PARTITION BY与ORDER BY子句所用列建立索引,以提升查询性能。
忽视注释
- 陷阱:缺少注释与文档时,
LAG()及其他窗口函数会变得杂乱且难以阅读或理解,尤其是在使用多个函数时。 - 最佳实践:每当使用
LAG()或其他窗口函数时,请添加注释并记录查询的目标。这有助于后来者(也包括您自己)在回看查询时理解使用LAG()的目的与逻辑。
结语与延伸资源
在本教程中,我们了解了 LAG() 函数是什么,以及它如何成为执行时间序列分析的有力工具。此外,我们还探讨了它的参数及相关子句。下次您在 SQL 中处理与时间相关或任何有序的数据时,不妨考虑使用 LAG(),看看它能为您带来哪些助益。在其他语境下,LAG() 也可用于发现自相关、平滑数据,或在数据清洗中检查不规则间隔。
如果您对一个窗口函数的威力感到好奇,不妨学习整个函数家族,通过我们的交互式课程 PostgreSQL Summary Stats and Window Functions 全面提升 SQL 分析技能。如果您喜欢这篇文章,或许也会喜欢完成 Associate Data Analyst in SQL 职业路径,并最终获得 SQL Associate Certification!

作者
Islam Salahuddin
Islam 是 The KPI Institute 的数据顾问。拥有新闻学背景的他兴趣广泛,涵盖写作、哲学、媒体、技术与文化。
常见问题
LAG() 与 LEAD() 函数有何区别?
LAG() 用于获取前面行的值,而 LEAD() 用于获取后续行的值。
在月度数据集中,LAG() 能否用于同比分析?
可以。LAG() 函数带有可按需调整的偏移量参数。在月度时间序列中,将偏移量设为 12 个月即可进行同比分析。
在 LAG() 语句中必须使用 ORDER BY 吗?
不是强制,但强烈建议使用以确保计算正确。
LAG() 是否可以同时按照多列的顺序进行?
可以,LAG() 语句中的 ORDER BY 子句可同时处理多列。
使用 `LAG()` 时最关键的性能优化措施是什么?
在可能的情况下,为 LAG() 语句中 PARTITION BY 与 ORDER BY 所使用的列建立索引,强烈建议这样做,以提升包含 LAG() 的查询性能。
`LAG()` 的语法在 SQL Server、MySQL、Oracle 等 RDBMS 中是否不同?
不是。LAG() 函数在不同 RDBMS、变体与方言中的语法是一致的。
SQL 查询不仅能检索或操作数据,还能做得更多。SQL 拥有大量函数,可帮助我们进行高级分析,这对商业智能报告至关重要。
其中一个强大的函数就是
LAG(),它是常用的窗口函数之一。它为我们打开了比较与计算序列数据中数值变化的大门。因此,该函数在基于 SQL 的时间序列分析中尤为重要。