

LAG() फ़ंक्शन क्या है?
LAG() फ़ंक्शन SQL के विंडो फ़ंक्शंस में से एक है, जो आपको एक नया कॉलम बनाने देता है जो किसी अन्य कॉलम की पिछली पंक्ति तक पहुंचता है। इसका नाम इसलिए पड़ा क्योंकि आपके द्वारा बनाया गया नया कॉलम हर पंक्ति में उस अन्य कॉलम की पूर्ववर्ती पंक्ति से मान खींचने के लिए “पीछे रहता” है।
आइए इसकी बेसिक सिंटैक्स को एक उदाहरण से समझें। मान लें कि हमारे पास दैनिक स्टॉक कीमतों वाली दो-कालम की एक साधारण तालिका है, जो कुछ इस प्रकार दिखती है:
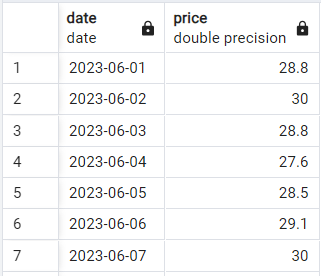
सैंपल स्टॉक प्राइस डेटा। चित्र: लेखक।
हम निम्न क्वेरी का उपयोग करके एक नया कॉलम बना सकते हैं जो हर पंक्ति में पिछले दिन की कीमत लाता है:
SELECT date,
price,
LAG(price) OVER(ORDER BY date) AS one_day_before
FROM stock_price;और हमें निम्न परिणाम मिलेगा:
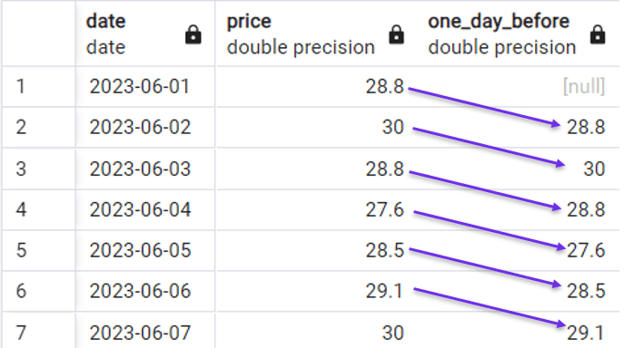
LAG() फ़ंक्शन के उपयोग का त्वरित उदाहरण। चित्र: लेखक।
ध्यान दें कि हमने एक [null] मान पाया है क्योंकि पहली पंक्ति के लिए पिछले दिन का कोई मान उपलब्ध नहीं है।
LAG() फ़ंक्शन की बेसिक सिंटैक्स
LAG() फ़ंक्शन SELECT क्लॉज़ का हिस्सा लिखते हैं। इसकी सबसे मूल सिंटैक्स इस प्रकार है:
LAG(column1) OVER(ORDER BY column2)यहाँ वही LAG() फ़ंक्शन एक स्टैंडअलोन क्वेरी में लागू किया गया है:
SELECT
column1,
column2,
LAG(column1) OVER (ORDER BY column2) AS previous_value
FROM
table_name;जैसा कि आप देख सकते हैं, बेसिक सिंटैक्स कई भागों से मिलकर बना है। आइए उन्हें समझते हैं:
- column1: यह वह कॉलम है जिससे पिछली पंक्ति का मान लिया जाएगा।
- OVER():
OVER()हर विंडो फ़ंक्शन के लिए आवश्यक कीवर्ड है। यह क्लॉज़ उस फ्रेम को परिभाषित करता है जिस पर विंडो फ़ंक्शन चलेगा। ऊपर के उदाहरण में, विंडो फ़ंक्शन क्रमबद्धcolumn2पर चलेगा। - ORDER BY:
ORDER BYअनिवार्य नहीं है लेकिनLAG()के साथ यह अत्यधिक अनुशंसित है; आम तौर पर इसके बिना फ़ंक्शन का अर्थ नहीं बनता। - column2: यह कॉलम निर्धारित करता है कि
LAG()फ़ंक्शन किस क्रम का पालन करेगा। सॉर्टिंग के लिए एक से अधिक कॉलम भी दिए जा सकते हैं।
LAG() फ़ंक्शन का उपयोग क्यों करें
आप सोच सकते हैं कि LAG() फ़ंक्शन में खास क्या है। इसका उत्तर है कि नया “लग” किया गया कॉलम दो अलग-अलग पंक्तियों के मानों की तुलना करने में काम आता है।
इसीलिए LAG() फ़ंक्शन का उपयोग अक्सर टाइम सीरीज़ डेटा के साथ किया जाता है। उदाहरण के लिए, हमारे डेमो डेटासेट में हम निम्न क्वेरी से दैनिक स्टॉक कीमत का परिवर्तन आसानी से निकाल सकते हैं:
SELECT date,
price,
LAG(price) OVER(ORDER BY date) AS one_day_before,
price - LAG(price) OVER(ORDER BY date) AS daily_change
FROM stock_price; 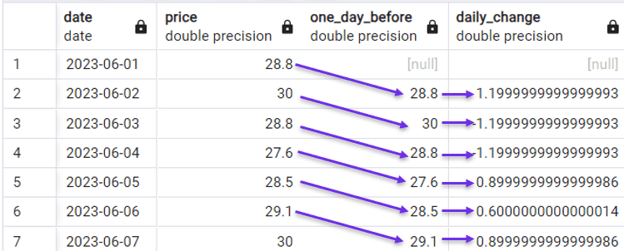
LAG() के साथ दैनिक परिवर्तन की गणना। चित्र: लेखक।
हम इससे अधिक परिष्कृत गणना करते हुए दैनिक प्रतिशत परिवर्तन भी निकाल सकते हैं।
SELECT date,
price,
LAG(price) OVER(ORDER BY date) AS one_day_before,
price - LAG(price) OVER(ORDER BY date) AS daily_change,
((price - LAG(price) OVER(ORDER BY date))*100 /
(LAG(price) OVER(ORDER BY date))) AS daily_perc_change
FROM stock_price; 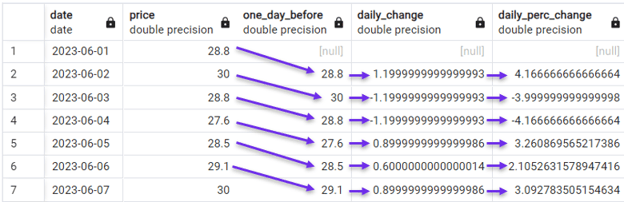
LAG() के साथ दैनिक प्रतिशत परिवर्तन की गणना। चित्र: लेखक।
LAG() फ़ंक्शन का उन्नत उपयोग
अब जब हम LAG() फ़ंक्शन का बेसिक उपयोग समझ चुके हैं, तो आइए कदम-दर-कदम स्तर बढ़ाएँ और देखें कि इससे और क्या किया जा सकता है।
यहाँ हम एक दूसरे डेमो डेटासेट पर स्विच करेंगे जो तीन काल्पनिक कंपनियों—Welsh LLC, Jones Group, और Green-Keebler—की मासिक आय को 2022 की शुरुआत से लेकर 2024 के मध्य तक रिकॉर्ड करता है। डेटा की संरचना कुछ इस प्रकार है:
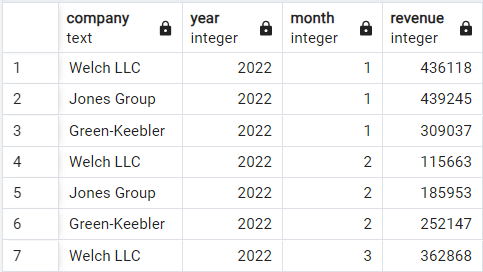
डेमो रेवेन्यूज़ डेटासेट। चित्र: लेखक।
एकाधिक कॉलम के आधार पर ऑर्डर करना
हमारे नए डेटासेट में, लग किया गया कॉलम दो कॉलमों: year और month के आधार पर ऑर्डर किया जाना चाहिए। जैसा कि पहले बताया, इसे ORDER BY क्लॉज़ में दोनों कॉलम देकर किया जा सकता है।
निम्न क्वेरी में हम एक लग कॉलम और माह-दर-माह (MoM) रेवेन्यू अंतर वाला कॉलम बनाते हैं, जिन्हें year और month दोनों के अनुसार क्रमबद्ध किया गया है। हम फिलहाल एक कंपनी पर ध्यान केंद्रित करने के लिए WHERE क्लॉज़ से क्वेरी को फ़िल्टर भी करते हैं।
SELECT *,
LAG(revenue) OVER(ORDER BY year, month) AS one_month_before,
revenue - LAG(revenue) OVER(ORDER BY year, month) AS mom_difference
FROM revenues
WHERE company = 'Welch LLC'; 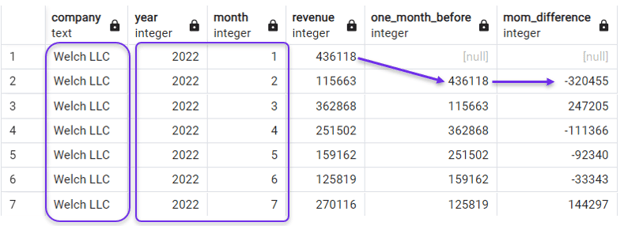
LAG() के लिए वर्ष और माह के अनुसार ऑर्डर करना। चित्र: लेखक।
LAG() फ्रेम का पार्टिशन करना
मान लें कि हम अपने डेटासेट में मौजूद तीनों कंपनियों के लिए यही दो कॉलम निकालना चाहते हैं। यदि हम अब तक की तरह ही LAG() का उपयोग करें, तो लगिंग कॉलम तीनों कंपनियों पर एक साथ चलेगा और अंतर वाला कॉलम उनकी आयों को मिलाकर निकालेगा—जो हमें नहीं चाहिए।
हमें चाहिए कि हर कंपनी के लिए अलग-अलग पिछले माह की आय मिले और उसी के आधार पर MoM अंतर निकले, और फिर अगली कंपनी के लिए गणना पुनः शुरू हो।
ऐसा करने के लिए, हम LAG() सिंटैक्स में एक नया क्लॉज़ जोड़ते हैं—PARTITION BY—जिसे हमारी बेसिक सिंटैक्स में इस प्रकार जोड़ा जा सकता है:
LAG(column1) OVER(PARTITION BY column3 ORDER BY column2)हमारे उदाहरण में जिस कॉलम पर पार्टिशन करना है, वह है company। इसलिए, हम अपनी पिछली क्वेरी में PARTITION BY क्लॉज़ जोड़कर उसे संशोधित करेंगे और WHERE स्टेटमेंट हटा देंगे।
SELECT *,
LAG(revenue) OVER(PARTITION BY company ORDER BY year, month) AS one_month_before,
revenue - LAG(revenue) OVER(PARTITION BY company ORDER BY year, month) AS mom_difference
FROM revenues;परिणाम में आप देखेंगे कि लगिंग और MoM कॉलम अब पहले कंपनी की मासिक आय पर चलकर समाप्त होते हैं, और फिर अगली कंपनी के लिए पुनः शुरू होते हैं। नीचे के स्क्रीनशॉट में हम यह देख सकते हैं, जिसमें Green-Keebler के अंतिम महीनों और Jones Group के शुरुआती महीनों को दिखाया गया है।
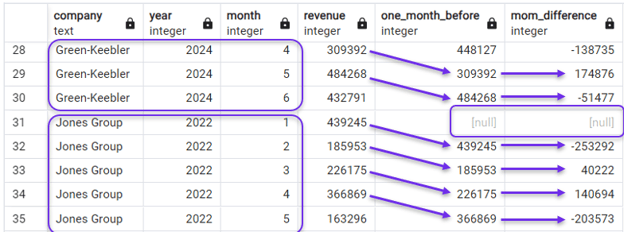
PARTITION BY का LAG() के साथ उपयोग। चित्र: लेखक।
ऑफ़सेट को कस्टमाइज़ करना
यदि हमें पिछली पंक्ति का मान नहीं, बल्कि छह या बारह पंक्तियों ऊपर का मान चाहिए तो? दूसरे शब्दों में, यदि हमें MoM के बजाय वर्ष-दर-वर्ष (YoY) अंतर निकालना हो तो?
ऐसे में हम LAG() सिंटैक्स में एक नया परमिटर जोड़ते हैं—ऑफ़सेट। यह बताता है कि वर्तमान पंक्ति से कितनी पंक्तियाँ ऊपर जाकर LAG() मान लाए। सिंटैक्स में इसकी स्थिति इस प्रकार है:
LAG(column1, offset) OVER(PARTITION BY column3 ORDER BY column2)डिफ़ॉल्ट रूप से, और जैसा कि हमने अब तक इस्तेमाल किया है, ऑफ़सेट का मान एक होता है। लेकिन LAG() अभिव्यक्ति में ऑफ़सेट को स्पष्ट रूप से देकर हम इस डिफ़ॉल्ट को बदल सकते हैं।
अपने उदाहरण में YoY रेवेन्यू परिवर्तन पाने के लिए, हमें पिछले वर्ष के उसी माह का रेवेन्यू चाहिए। इसे हम निम्न क्वेरी से कर सकते हैं, जहाँ हमने ऑफ़सेट 12 दिया है:
SELECT *,
LAG(revenue, 12) OVER(PARTITION BY company ORDER BY year, month) AS one_year_before,
revenue - LAG(revenue, 12) OVER(PARTITION BY company ORDER BY year, month) AS yoy_difference
FROM revenues;और परिणाम होगा:
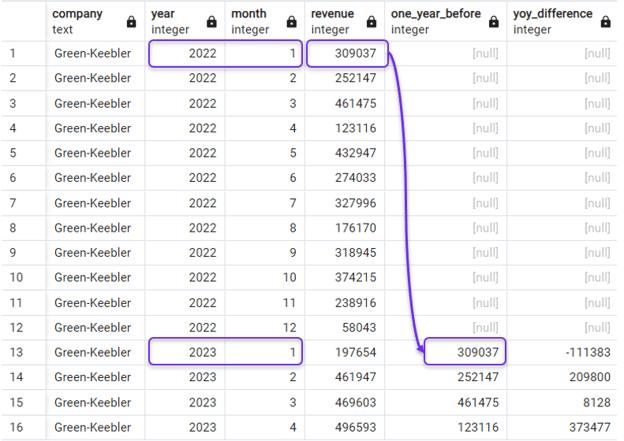
LAG() के साथ वर्ष-दर-वर्ष अंतर। चित्र: लेखक।
NULLs को संभालना
आपने गौर किया होगा कि जहाँ पिछली अवधि उपलब्ध नहीं होती, वहाँ LAG() फ़ंक्शन NULL लौटाता है—जैसे हमारी पिछली क्वेरी में वर्ष 2022 की पंक्तियों में।
यह LAG() फ़ंक्शन का डिफ़ॉल्ट व्यवहार है, लेकिन इसे “डिफ़ॉल्ट” नामक एक नए परमिटर को स्पष्ट रूप से देकर बदला जा सकता है। यह परमिटर कोई भी integer या float संख्यात्मक मान ले सकता है। फ़ंक्शन की सिंटैक्स में इसकी स्थिति इस प्रकार है:
LAG(column1, offset, default) OVER(PARTITION BY column3 ORDER BY column2)“डिफ़ॉल्ट” परमिटर का आम उपयोग तब होता है जब टाइम सीरीज़ डेटा में मान वास्तव में शून्य से शुरू होते हैं।
अपने उदाहरण में, हम मान सकते हैं कि तीनों कंपनियाँ जनवरी 2022 (हमारे डेटासेट की सबसे शुरुआती तारीख) में स्थापित हुई थीं, और इसलिए स्थापना से पहले का रेवेन्यू शून्य था। ऐसा मानकर हम रेवेन्यू में बदलाव अधिक सटीकता से निकालेंगे, क्योंकि शुरुआती महीनों में पाया गया कोई भी रेवेन्यू सकारात्मक बदलाव होगा।
अपनी क्वेरी में, हम दोनों LAG() अभिव्यक्तियों में “डिफ़ॉल्ट” परमिटर के रूप में शून्य निर्दिष्ट करेंगे, इस प्रकार:
SELECT *,
LAG(revenue, 12, 0) OVER(PARTITION BY company ORDER BY year, month) AS one_year_before,
revenue - LAG(revenue, 12, 0) OVER(PARTITION BY company ORDER BY year, month) AS yoy_difference
FROM revenues;और परिणाम में लगिंग कॉलम में शून्य मिलेंगे, तथा YoY रेवेन्यू परिवर्तन वाले कॉलम में शून्य से शुद्ध रेवेन्यू दिखेगा:
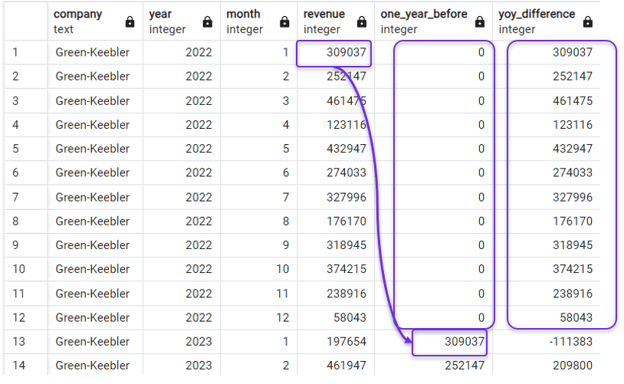
LAG() में NULL को शून्य से बदलना। चित्र: लेखक।
ध्यान दें कि “डिफ़ॉल्ट” परमिटर का मान स्पष्ट रूप से देने के लिए, ऑफ़सेट का मान भी स्पष्ट रूप से देना अनिवार्य हो जाता है, क्योंकि LAG() में कॉलम नाम के बाद दिया गया पहला संख्या मान वैसे भी ऑफ़सेट माना जाएगा।
यदि आपको “डिफ़ॉल्ट” बदलना है पर ऑफ़सेट नहीं, तो ऑफ़सेट परमिटर को एक सेट करें—यह सामान्य व्यवहार करेगा।
LAG() फ़ंक्शन के बाद ऑर्डर करना
यह जानना उपयोगी है कि LAG() जिस क्रम पर निर्भर करता है, वह अंतिम व्यू के क्रम जैसा होना आवश्यक नहीं है। आप अपनी क्वेरी में सामान्य रूप से ORDER BY क्लॉज़ का उपयोग कर वह क्रम बदल सकते हैं।
अपने उदाहरण में, हम बाहरी ORDER BY क्लॉज़ में वर्ष और माह के अनुसार ऑर्डर देकर परिणाम को इस प्रकार पुनः क्रमित कर सकते हैं कि एक ही वर्ष के एक ही माह के लिए तीनों कंपनियों की पंक्तियाँ साथ दिखें, फिर अगले माह पर जाएँ:
SELECT *,
LAG(revenue, 12, 0) OVER(PARTITION BY company ORDER BY year, month) AS one_year_before,
revenue - LAG(revenue, 12, 0) OVER(PARTITION BY company ORDER BY year, month) AS yoy_difference
FROM revenues
ORDER BY year, month;और हमें वही मिलेगा जिसकी जरूरत है:
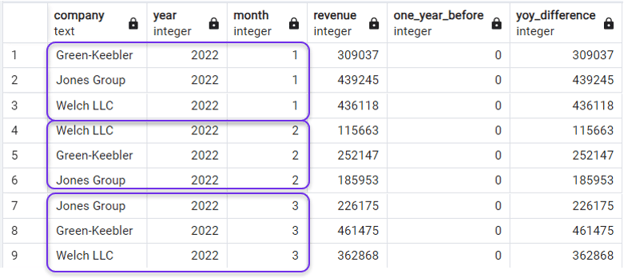
LAG() के बाद क्वेरी को ऑर्डर करना। चित्र: लेखक।
सामान्य गलतियाँ और सर्वोत्तम अभ्यास
यदि आपको ट्रबलशूटिंग में मदद चाहिए, तो सामान्य समस्याओं पर नज़र डालते हैं।
गलत ऑर्डरिंग
-
चूक:
LAG()स्टेटमेंट मेंORDER BYक्लॉज़ निर्दिष्ट न करना गलत परिणाम दे सकता है। भले ही सोर्स टेबल का मूल क्रम फ़ंक्शन के लिए उपयुक्त लगे, उस पर निर्भर न रहें क्योंकि समय के साथ वह बदल सकता है। -
सर्वोत्तम अभ्यास: हमेशा
LAG()स्टेटमेंट मेंORDER BYक्लॉज़ का उपयोग करें, और सुनिश्चित करें कि आप सही कॉलम के अनुसार ऑर्डर कर रहे हैं।
गलत पार्टिशनिंग
-
चूक:
PARTITION BYक्लॉज़ का उपयोग न करने या गलत कॉलम के साथ उपयोग करने सेLAG()फ्रेम गलत हो सकता है। -
सर्वोत्तम अभ्यास: यह दोबारा जाँचें कि आपका
LAG()फ़ंक्शन किन पार्टिशनों पर चल रहा है।
गलत ऑफ़सेट
- चूक: गलत ऑफ़सेट के कारण लग किए गए मान गलत हो सकते हैं।
- सर्वोत्तम अभ्यास: जिस ऑफ़सेट मान की आपको ज़रूरत है, उसे दोबारा जाँचें, और ध्यान रखें कि डिफ़ॉल्ट ऑफ़सेट हर स्थिति में उपयुक्त नहीं होता।
NULLs का अनुचित उपयोग
-
चूक: “डिफ़ॉल्ट” परमिटर घोषित न करने से
LAG()आउटपुट मेंNULLमान वैसे ही छोड़ देना, जबकि कोई और मान अधिक उपयुक्त हो। -
सर्वोत्तम अभ्यास: हमेशा सोचें कि आपके डेटासेट की टाइम सीरीज़ शुरू होने से पहले के मानों का क्या अर्थ है। कुछ मामलों में, जैसा कि हमारे उदाहरण में, nulls की बजाय शून्य अधिक उपयुक्त होते हैं।
ऑफ़सेट घोषित किए बिना डिफ़ॉल्ट घोषित करना
- चूक: “डिफ़ॉल्ट” परमिटर घोषित कर देना लेकिन ऑफ़सेट न बताना—ऐसे में “डिफ़ॉल्ट” मान को ऑफ़सेट मान मान लिया जाएगा।
- सर्वोत्तम अभ्यास: यदि आपने “डिफ़ॉल्ट” परमिटर स्पष्ट रूप से दिया है, तो ऑफ़सेट बताना कभी न भूलें।
फ़ंक्शन स्टेटमेंट की जगह उपनाम (alias) का उपयोग
-
चूक: यदि आप एक से अधिक कॉलम में वही
LAG()स्टेटमेंट उपयोग कर रहे हैं, तो दूसरे कॉलम में भी पूराLAG()स्टेटमेंट ही लिखना होगा, उसका उपनाम नहीं। पहलेLAG()कॉलम के उपनाम का उपयोग करने पर त्रुटि आएगी। -
सर्वोत्तम अभ्यास:
SELECTस्टेटमेंट में हमेशाLAG()स्टेटमेंट्स को पूर्ण रूप में लिखें।
इंडेक्सेस की अनदेखी
-
चूक:
LAG()फ़ंक्शन, अन्य विंडो फ़ंक्शंस की तरह, बड़े डेटासेट पर कम्प्यूटेशनल रूप से महंगा हो सकता है। इसलिएPARTITION BYऔरORDER BYमें उपयोग किए गए कॉलम का इंडेक्स न करना प्रदर्शन को खराब कर सकता है। -
सर्वोत्तम अभ्यास: जहाँ संभव हो,
PARTITION BYऔरORDER BYमें प्रयुक्त कॉलम्स को इंडेक्स करें ताकि क्वेरी प्रदर्शन बेहतर हो सके।
कमेंट्स को नज़रअंदाज़ करना
- चूक: बिना कमेंट और डॉक्युमेंटेशन के,
LAG()और अन्य विंडो फ़ंक्शंस उलझे हुए और पढ़ने-समझने में कठिन हो सकते हैं, खासकर जब एक से अधिक फ़ंक्शंस हों। - सर्वोत्तम अभ्यास: जब भी आप
LAG()और अन्य विंडो फ़ंक्शंस का उपयोग करें, कमेंट जोड़ें और बताएँ कि क्वेरी क्या हासिल करना चाहती है। इससे दूसरों और आपको, क्वेरी दोबारा देखने पर,LAG()के उद्देश्य और तर्क को समझने में मदद मिलती है।
निष्कर्ष और अतिरिक्त संसाधन
इस ट्यूटोरियल में हमने देखा कि LAG() फ़ंक्शन क्या है और यह टाइम सीरीज़ एनालिटिक्स करने के लिए कितना शक्तिशाली टूल हो सकता है। साथ ही, हमने इसके आर्ग्युमेंट्स और जुड़े क्लॉज़ की भी पड़ताल की। अगली बार जब आप SQL में समय-संबंधी या किसी अनुक्रमित डेटा पर काम करें, तो LAG() फ़ंक्शन के उपयोग पर विचार करें और देखें कि यह आपको क्या-क्या करने में सक्षम बनाता है। अन्य संदर्भों में, LAG() आत्म-सहसम्बंध (autocorrelations) खोजने, डेटा स्मूद करने, या डेटा क्लीनिंग के हिस्से के रूप में अनियमित अंतराल जाँचने में भी सहायक होता है।
यदि आपको एक विंडो फ़ंक्शन की क्षमताएँ रोचक लगीं, तो आप पूरे परिवार के बारे में सीख सकते हैं और हमारे व्यापक PostgreSQL Summary Stats and Window Functions इंटरैक्टिव कोर्स के साथ SQL में अपनी विश्लेषणात्मक स्किल्स को निखार सकते हैं। और अगर आपको यह लेख पसंद आया, तो आपको Associate Data Analyst in SQL Career Track से गुजरना और अंत में SQL Associate Certification प्राप्त करना भी अच्छा लगेगा!

लेखक
Islam Salahuddin
इस्लाम The KPI Institute में डेटा कंसल्टेंट हैं। पत्रकारिता के पृष्ठभूमि के साथ, इस्लाम की रुचियाँ विविध हैं, जिनमें लेखन, दर्शन, मीडिया, तकनीक और संस्कृति शामिल हैं।
अक्सर पूछे जाने वाले प्रश्न
LAG() और LEAD() फ़ंक्शंस में क्या अंतर है?
LAG() फ़ंक्शन पूर्ववर्ती पंक्तियों से मान लाता है, जबकि LEAD() फ़ंक्शन अनुवर्ती पंक्तियों से मान लाता है।
क्या LAG() फ़ंक्शन का उपयोग मासिक डेटासेट के साथ वर्ष-दर-वर्ष विश्लेषण करने के लिए किया जा सकता है?
हाँ, LAG() फ़ंक्शन में एक ऑफ़सेट परमिटर होता है जिसे आवश्यकता अनुसार समायोजित किया जा सकता है। मासिक टाइम सीरीज़ डेटा में, ऑफ़सेट को 12 माह पर सेट करके LAG() फ़ंक्शन से वर्ष-दर-वर्ष विश्लेषण किया जा सकता है।
क्या LAG() स्टेटमेंट में ORDER BY का उपयोग अनिवार्य है?
नहीं, लेकिन सही गणना सुनिश्चित करने के लिए यह अत्यधिक अनुशंसित है।
क्या LAG() फ़ंक्शन एक साथ कई कॉलमों के अनुक्रम का पालन कर सकता है?
हाँ, LAG() स्टेटमेंट में ORDER BY क्लॉज़ एक साथ एकाधिक कॉलम संभाल सकता है।
`LAG()` फ़ंक्शन का उपयोग करते समय सबसे महत्वपूर्ण परफॉर्मेंस ऑप्टिमाइज़ेशन उपाय क्या है?
LAG() फ़ंक्शन के साथ क्वेरियों के प्रदर्शन को बेहतर करने के लिए, जहाँ संभव हो, PARTITION BY और ORDER BY क्लॉज़ में उपयोग किए गए कॉलमों को इंडेक्स करना अत्यधिक अनुशंसित है।
क्या `LAG()` फ़ंक्शन की सिंटैक्स SQL Server, MySQL, Oracle और अन्य RDBMS में अलग होती है?
नहीं, LAG() फ़ंक्शन की सिंटैक्स विभिन्न RDBMS, फ्लेवर्स और डाइलेक्ट्स में समान होती है।
SQL क्वेरियाँ केवल डेटा प्राप्त करने या संशोधित करने से कहीं अधिक कर सकती हैं। SQL में कई फ़ंक्शंस होते हैं जो हमें उन्नत विश्लेषण करने में सक्षम बनाते हैं, जो हमारी बिज़नेस इंटेलिजेंस रिपोर्टिंग में अहम हो सकते हैं।
ऐसे ही शक्तिशाली फ़ंक्शंस में से एक है
LAG()फ़ंक्शन, जो आमतौर पर प्रयुक्त विंडो फ़ंक्शंस में आता है। यह डेटा के अनुक्रम में मूल्यों की तुलना और उनमें बदलाव की गणना करने का रास्ता खोलता है। यही कारण है कि यह फ़ंक्शन विशेष रूप से SQL में टाइम सीरीज़ एनालिटिक्स के लिए निर्णायक हो सकता है।