

什么是文本分类?
文本分类是一项常见的 NLP 任务,可用于解决各行业的业务问题。文本分类的目标是对未见过的文本文档进行归类或预测其类别,通常借助有监督机器学习实现。
与在表格数据集上训练分类算法以预测类别类似,文本分类同样使用有监督机器学习。不同之处在于,文本分类所处理的是文本。
您也可以不使用有监督机器学习来进行文本分类。除了算法之外,还可以设计人工的规则系统来完成文本分类任务。下一节我们将比较并评估基于规则与基于机器学习的文本分类系统的优缺点。
想进一步了解有监督机器学习,请查看我们的独立文章。
文本分类的用例与应用
垃圾邮件分类
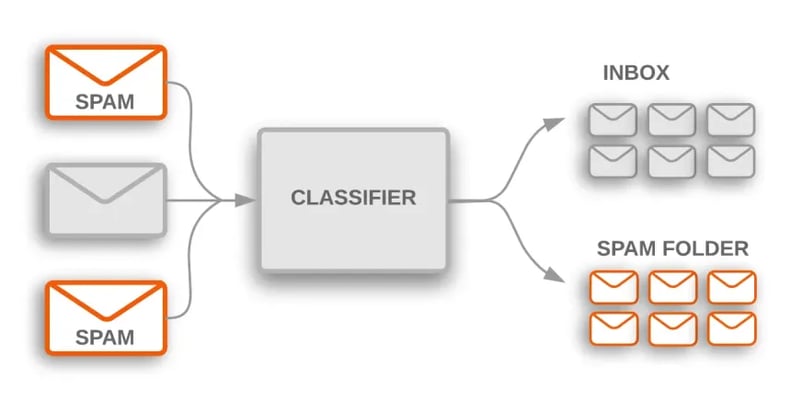
文本分类在许多行业都有实际用例。比如,垃圾邮件过滤器就是一种常见应用,它使用文本分类将电子邮件划分为垃圾和非垃圾两类。
新闻与博客文章分类
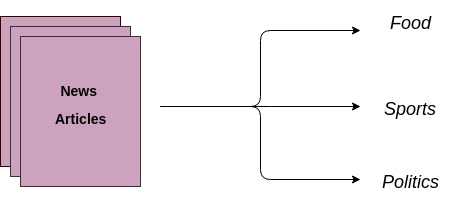
另一个用例是将文本文档自动分配到预定义的类别中。使用带标签的数据(包含原始文本和目标标签)训练有监督机器学习模型。一旦模型训练完成,就可在生产中用于对新的、未见过的数据(未来发布的文章/博客)获取类别(标签)。
客服请求分类
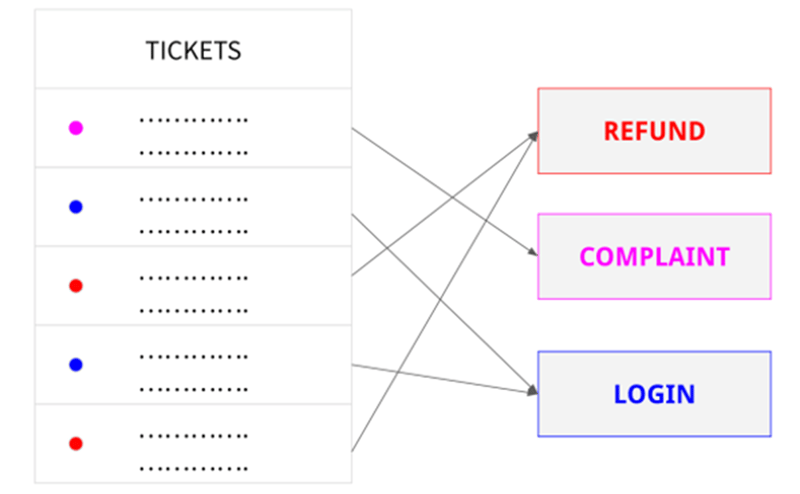
公司可以使用文本分类按主题自动归类客户支持请求,或对请求进行优先级排序并路由到相应部门。
仇恨言论检测
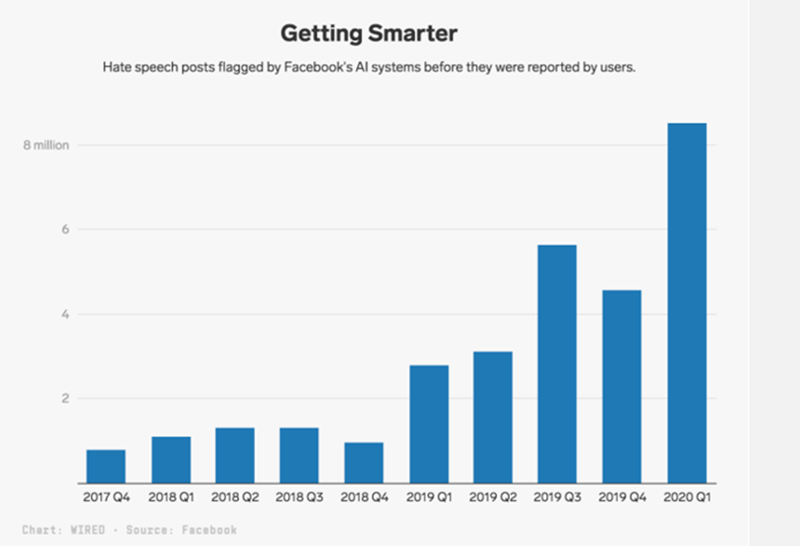
Facebook 每日活跃用户超过 17 亿,平台上难免会出现违规内容,仇恨言论便属于此类不受欢迎的内容。
Facebook 通过对被AI 文本分类器识别为仇恨言论的帖子发起人工复核来应对这一问题。被 AI 标记的帖子会像用户举报的帖子一样接受审查。事实上,仅在 2020 年的前 3 个月,平台就移除了 960 万条被归类为仇恨言论的内容。
文本分类系统的类型
文本分类系统主要分为两类:基于规则和基于机器学习。
基于规则的文本分类
基于规则的方法使用一组人工构建的语言规则,将文本归入某个类别或分组。这些规则通过使用语义相关的文本元素,根据文本内容指示系统将其分类到特定类别。每条规则由一个前件或模式和一个预测类别组成。
例如,假设您有大量新闻文章,目标是将它们分配到体育、政治、经济等相关类别。
采用基于规则的分类系统,您需要人工审阅若干文档,从而总结出类似如下的语言规则:
- 如果文档包含如money、dollar、GDP或inflation等词,则其属于政治组(类别)。
基于规则的系统可以随时间不断完善,且对人类来说易于理解。然而,这种策略也存在一些缺点。
首先,这些系统需要深厚的领域知识。它们非常耗时,因为为复杂系统创建规则可能很困难,且往往需要大量研究与测试。
此外,由于新增规则可能改变既有规则的结果,基于规则的系统也难以维护,且扩展性较差。
基于机器学习的文本分类
基于机器学习的文本分类是一个有监督学习问题。它学习输入数据(原始文本)与标签(亦称目标变量)之间的映射。这与非文本的分类问题相似:我们在表格数据上训练有监督分类算法来预测类别;不同在于文本分类的输入是原始文本而非数值特征。
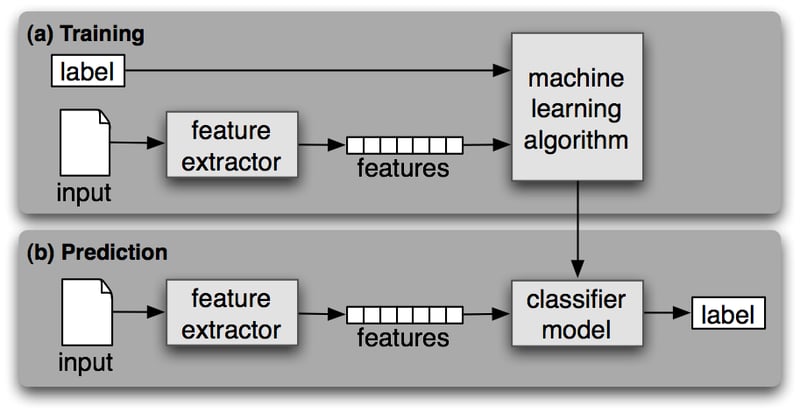
与其他有监督学习一样,文本分类的机器学习过程包含两个阶段:训练与预测。
训练阶段
在训练阶段,将有监督机器学习算法用于带标签的输入数据集。该过程结束时,我们会得到一个训练好的模型,可用于对新的、未见过的数据给出预测(标签)。
预测阶段
一旦模型训练完成,就可以用来对新的、未见过的数据预测标签。通常会将前期选出的最佳模型部署为服务器上的 API 来实现这一点。
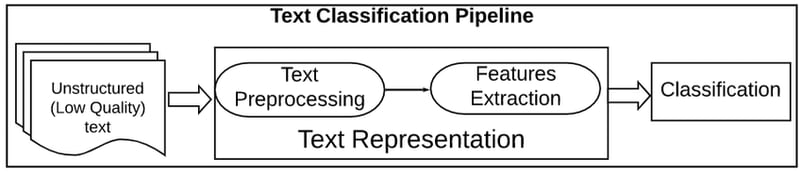
文本预处理流水线
在任何自然语言处理任务中,文本数据的预处理都是重要步骤。它有助于清洗并准备文本数据,以便后续处理或分析。
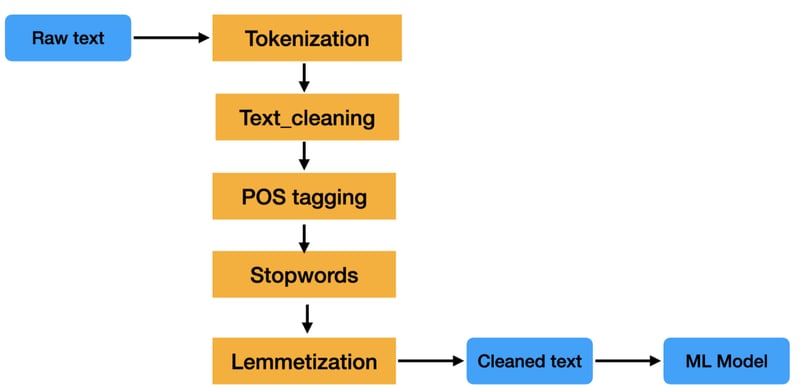
文本预处理流水线是一系列对原始文本数据执行的处理步骤,旨在为自然语言处理任务做准备。
流水线中的步骤可能有所不同,但通常包括分词、停用词移除、词干提取和词形还原等。这些步骤有助于减少文本数据规模,并提升文本分类、信息抽取等 NLP 任务的准确性。
文本数据难以处理,因为它是非结构化的,且常常包含大量噪声。这些噪声可能来自拼写错误、语法错误和非标准格式。文本预处理流水线旨在清理这些噪声,使文本数据更易于分析。
想进一步了解?请查看我们的R 文本挖掘学习路径。
特征提取
从文本中提取特征(换言之,将文本数据(字符串)转换为可用于训练机器学习模型的数值特征)最常见的两种方法是:词袋模型(又称 CountVectorizer)和 Tf-IDF。
词袋模型
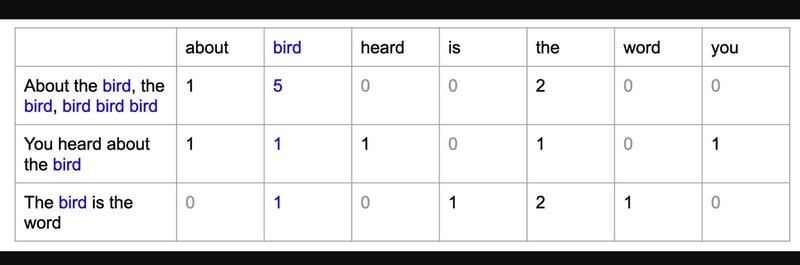
词袋(BoW)模型是一种将文本数据表示为数值特征的简单方法。它先为语料库中已知词语构建词汇表,然后为每个文档创建一个向量,记录各词出现的次数。
TF-IDF
TF-IDF 是“词频-逆文档频率”的缩写,是另一种将文本表示为数值特征的方法。它弥补了词袋模型的一些不足。本文不展开讨论,如需深入了解,请查看我们的Python 自然语言处理入门课程。
TF-IDF 与词袋模型不同之处在于,它同时考虑词语在文档中的出现频率以及逆文档频率。这意味着 TF-IDF 比词袋模型更可能识别出文档中的重要词语。
Python 端到端文本分类示例
导入数据集
首先,通过这个 GitHub 链接直接导入数据集。SMS Spam Collection 数据集包含 5,574 条英文短信,以及其对应的标签Spam或Ham(非垃圾)。我们的目标是训练一个机器学习模型,使其能够从短信文本及其标签中学习,并对短信消息的类别进行预测。
# reading data
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/mohitgupta-omg/Kaggle-SMS-Spam-Collection-Dataset-/master/spam.csv', encoding='latin-1')
data.head()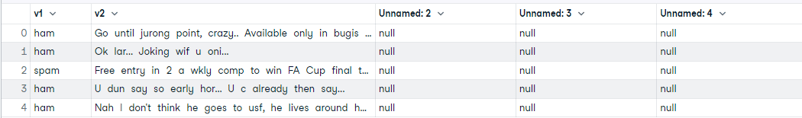
读取数据集后,您会发现有一些不需要的额外列。我们只需要前两列。接下来删除其余列,并重命名前两列。
# drop unnecessary columns and rename cols
data.drop(['Unnamed: 2', 'Unnamed: 3', 'Unnamed: 4'], axis=1, inplace=True)
data.columns = ['label', 'text']
data.head()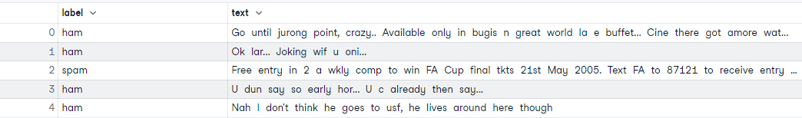
探索性数据分析(EDA)
让我们先做一些基础的 EDA,看看数据集中是否存在缺失值,以及目标标签的分布是否平衡。
# check missing values
data.isna().sum()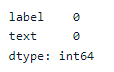
# check data shape
data.shape>>> (5572, 2)# check target balance
data['label'].value_counts(normalize = True).plot.bar()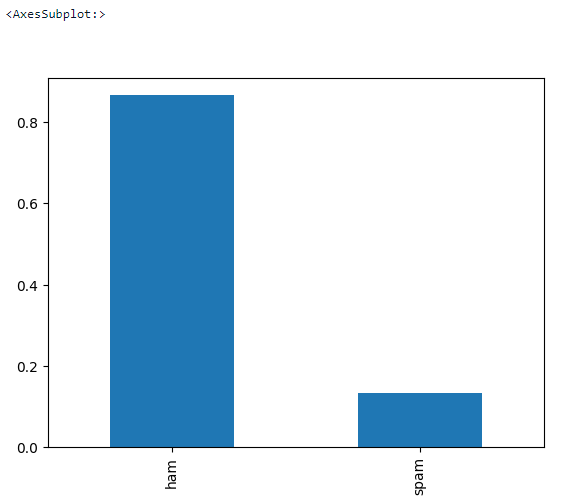
文本预处理
这是进行文本清洗的步骤。它会遍历全部 5,572 条文档,并执行以下操作:
- 移除所有特殊字符
- 将所有单词转为小写
- 分词
- 移除停用词
- 词形还原
# text preprocessing
# download nltk
import nltk
nltk.download('all')
# create a list text
text = list(data['text'])
# preprocessing loop
import re
from nltk.corpus import stopwords
from nltk.stem import WordNetLemmatizer
lemmatizer = WordNetLemmatizer()
corpus = []
for i in range(len(text)):
r = re.sub('[^a-zA-Z]', ' ', text[i])
r = r.lower()
r = r.split()
r = [word for word in r if word not in stopwords.words('english')]
r = [lemmatizer.lemmatize(word) for word in r]
r = ' '.join(r)
corpus.append(r)
#assign corpus to data['text']
data['text'] = corpus
data.head()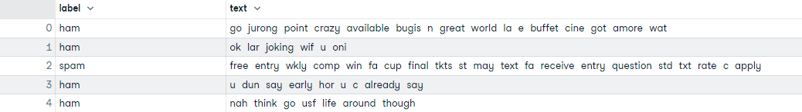
训练/测试集划分
在特征提取之前,先将数据集划分为训练集和测试集。
# Create Feature and Label sets
X = data['text']
y = data['label']
# train test split (66% train - 33% test)
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.33, random_state=123)
print('Training Data :', X_train.shape)
print('Testing Data : ', X_test.shape)>>> Training Data : (3733,)
>>> Testing Data : (1839,)特征提取
这里我们使用词袋模型(CountVectorizer)将清洗后的文本转换为数值特征,以便训练机器学习模型。
# Train Bag of Words model
from sklearn.feature_extraction.text import CountVectorizer
cv = CountVectorizer()
X_train_cv = cv.fit_transform(X_train)
X_train_cv.shape>>> (3733, 7020)模型训练与评估
本部分我们训练一个逻辑回归模型,并评估其混淆矩阵。
# Training Logistic Regression model
from sklearn.linear_model import LogisticRegression
lr = LogisticRegression()
lr.fit(X_train_cv, y_train)
# transform X_test using CV
X_test_cv = cv.transform(X_test)
# generate predictions
predictions = lr.predict(X_test_cv)
predictions>>> array(['ham', 'spam', 'ham', ..., 'ham', 'ham', 'spam'], dtype=object)# confusion matrix
import pandas as pd
from sklearn import metrics
df = pd.DataFrame(metrics.confusion_matrix(y_test,predictions), index=['ham','spam'], columns=['ham','spam'])
df
想了解更多细节,请查看完整的DataLab 工作簿。
结论
NLP 仍是一个活跃的研究与开发领域,许多高校和公司都在致力于开发新的算法和应用。NLP 是跨学科领域,研究者背景多样,包括计算机科学、语言学、心理学和认知科学等。
文本分类是 NLP 中功能强大且广泛使用的一项任务,可用于自动归类或预测未见文本文档的类别,通常借助有监督学习实现。
它并非总是精准,但在正确使用时,能为分析工作带来巨大价值。搭建文本分类器的方法与算法有很多,没有哪一种是万能方案。关键在于不断试验,找到最适合您的数据与目标的方法。
Text Classification FAQs
Can Text Classification be used if there are more than two labels?
可以。如果只有两个标签,则使用二元分类算法;如果超过两个标签,则需要使用多类分类算法。
Is Text Classification task of NLP?
可以。NLP 是一个非常广泛的领域。文本分类是 NLP 的基础用例之一,适用于各行各业。
Is Text Classification a supervised machine learning problem?
文本分类系统也可以是基于规则的,但由于难以维护和扩展,这类系统正在迅速过时。用于文本分类任务的基于机器学习的系统采用有监督学习。
What is Natural Language Processing?
自然语言处理(NLP)是计算机科学和人工智能的一个领域,关注计算机与人类(自然)语言之间的交互,尤其是如何编程使计算机处理和分析海量自然语言数据。
Is Text Classification the same as sentiment analysis?
情感分析是文本分类系统的一个示例。不过,顾名思义,情感分析通常用于当标签是某种情绪(正面或负面、开心或难过等)时。
Can Text Classification be done without using machine learning?
可以,我们也可以使用基于规则的系统进行文本分类。
Can we use deep learning for Text Classification?
可以,我们可以使用任何深度学习算法替代传统机器学习。想进一步了解 NLP 与深度学习,请查看这门精彩课程《用 Python 实现语言建模的循环神经网络(RNN)》。如果您想使用 TensorFlow 构建文本分类模型,请查看 Datacamp 的这篇TensorFlow 2.0 案例研究。
What is the best algorithm for Text Classification?
并不存在“最好的”算法。通常,朴素贝叶斯在高维(文本)数据上表现不错。
Is BERT used for Text Classification?
是的,BERT(Bidirectional Encoder Representations from Transformers)基于 Transformer 架构,这是一种深度学习模型。在众多用例中,BERT 也可用于文本分类系统。详情参见我们的BERT NLP 教程。
Is Text Classification and Text Mining the same thing?
不是。文本挖掘是将非结构化文本转化为结构化格式以识别有意义模式的过程;而文本分类的目标是对未见文本文档进行归类或预测其类别,通常借助有监督学习。
文本数据是当今企业最常用的数据类型之一,但由于其缺乏清晰结构,从文本数据中提取洞见可能既困难又耗时。处理文本数据属于自然语言处理范畴,而自然语言处理是人工智能的一个分支领域。
自然语言处理(NLP)是计算机科学和人工智能的一个领域,研究计算机如何与人类语言交互,以及如何编程使计算机处理和分析海量自然语言数据。
NLP 的应用非常广泛,例如自动回答问题、生成文本摘要、实现跨语言翻译等。NLP 的研究也涉及认知科学、语言学和心理学等领域。文本分类就是 NLP 的一个典型用例。
本文将探讨文本分类的应用场景,并提供一个端到端示例,展示如何构建文本预处理流水线并在 Python 中训练文本分类模型。
如果您想进一步学习自然语言处理,我们的Python 自然语言处理和R 自然语言处理学习路径将很有帮助。您将掌握将文本数据转化为有价值洞见的核心 NLP 技能,并接触到流行的 Python NLP 库,包括 NLTK、scikit-learn、spaCy 和 SpeechRecognition。