

Metin Sınıflandırma Nedir?
Metin sınıflandırma, çeşitli alanlardaki iş problemlerini çözmek için kullanılan yaygın bir NLP görevidir. Metin sınıflandırmanın amacı, sıklıkla gözetimli makine öğrenmesinin yardımıyla, görülmemiş metin belgelerini kategorize etmek veya bir sınıfını tahmin etmektir.
Bir sınıfı tahmin etmek üzere bir tablo verisi üzerinde eğitilmiş bir sınıflandırma algoritmasına benzer şekilde, metin sınıflandırma da gözetimli makine öğrenmesi kullanır. İkisi arasındaki temel fark, metin sınıflandırmada girdinin metin olmasıdır.
Gözetimli makine öğrenmesi kullanmadan da metin sınıflandırması yapabilirsiniz. Algoritmalar yerine, metin sınıflandırma görevini gerçekleştirmek için manuel, kurala dayalı bir sistem tasarlanabilir. Bir sonraki bölümde kurala dayalı ve makine öğrenmesi temelli metin sınıflandırma sistemlerinin artılarını ve eksilerini karşılaştırıp inceleyeceğiz.
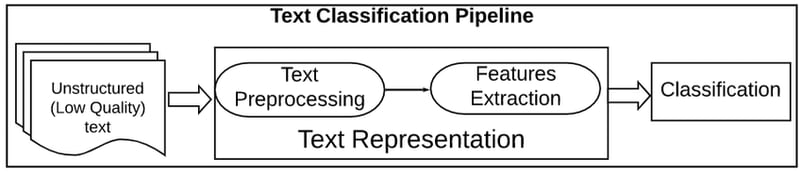
Gözetimli makine öğrenmesi hakkında daha fazla bilgi edinmek isterseniz ayrı makalemize göz atın.
Metin Sınıflandırma Kullanım Alanları ve Uygulamaları
Spam sınıflandırma
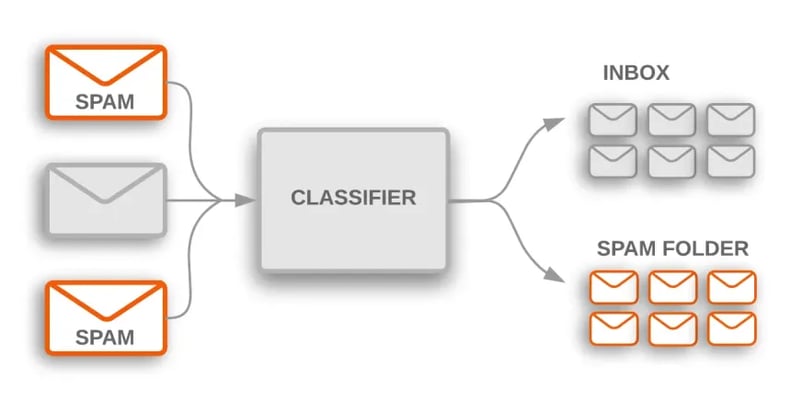
Metin sınıflandırmanın pek çok sektörde birçok pratik kullanım alanı vardır. Örneğin, bir spam filtresi; e-postaları spam ve spam olmayan kategorilerine ayırmak için metin sınıflandırma kullanan yaygın bir uygulamadır.
Haber makalelerini ve blogları sınıflandırma
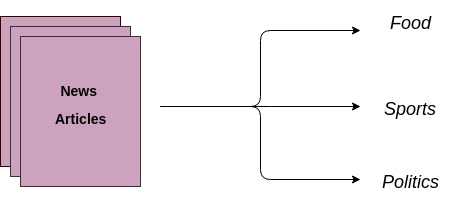
Bir başka kullanım alanı da metin belgelerini önceden belirlenmiş kategorilere otomatik olarak atamaktır. Etiketli veriler üzerinde (hem ham metin hem de hedefi içeren) bir gözetimli makine öğrenmesi modeli eğitilir. Model eğitildikten sonra, üretimde gelecekte yazılacak yeni ve görülmemiş veriler (makaleler/bloglar) için bir kategori (etiket) elde etmek üzere kullanılır.
Müşteri destek taleplerini kategorize etme
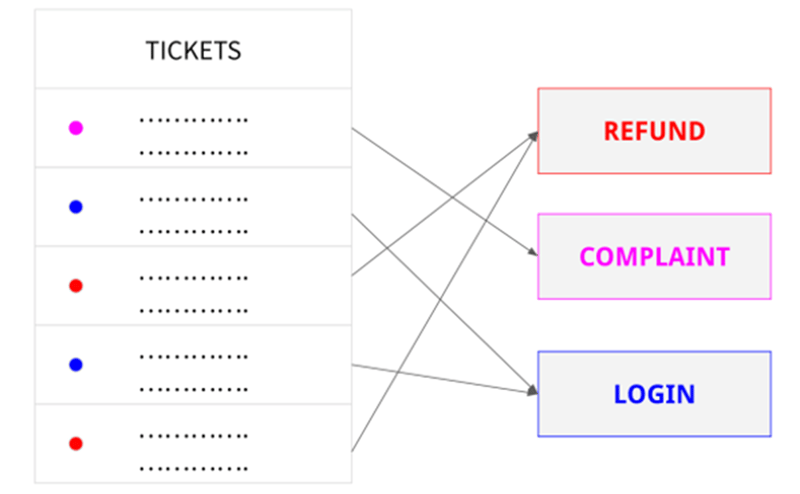
Bir şirket, müşteri destek taleplerini konuya göre otomatik olarak kategorize etmek ya da talepleri önceliklendirip ilgili birime yönlendirmek için metin sınıflandırmayı kullanabilir.
Nefret söylemi tespiti
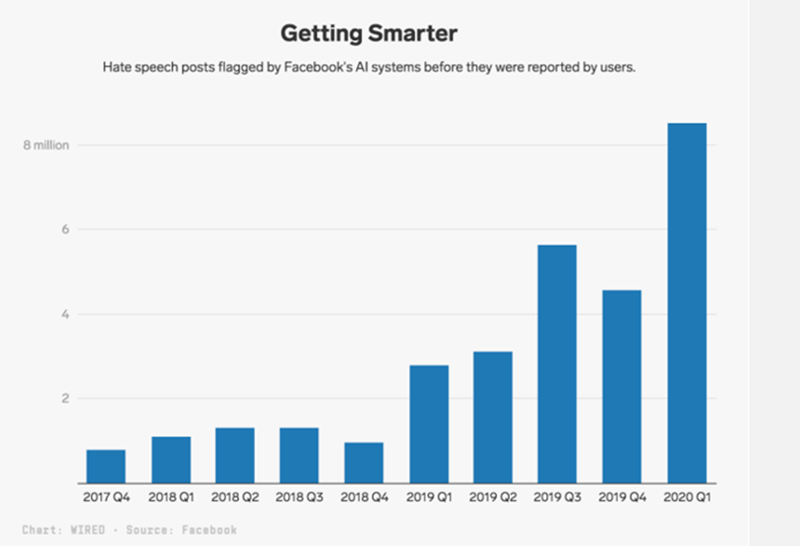
Günlük 1,7 milyardan fazla aktif kullanıcısıyla Facebook'ta kaçınılmaz olarak kurallara aykırı içerikler oluşuyor. Bu istenmeyen içeriklere nefret söylemi de dahildir.
Facebook bu sorunu, Yapay zekâ metin sınıflandırıcısı tarafından nefret söylemi olarak işaretlenen gönderilerin manuel incelemesini isteyerek ele alıyor. Yapay zekâ tarafından işaretlenen gönderiler, kullanıcılar tarafından raporlanan gönderilerle aynı şekilde inceleniyor. Nitekim yalnızca 2020'nin ilk üç ayında, platform nefret söylemi olarak sınıflandırılan 9,6 milyon içeriği kaldırdı.
Metin Sınıflandırma Sistemlerinin Türleri
Temelde iki tür metin sınıflandırma sistemi vardır: kurala dayalı ve makine öğrenmesi temelli metin sınıflandırma.
Kurala dayalı metin sınıflandırma
Kurala dayalı teknikler, metni kategorilere ya da gruplara ayırmak için manuel olarak oluşturulmuş bir dizi dilsel kural kullanır. Bu kurallar, anlamsal olarak ilgili metinsel öğeleri kullanarak, bir metnin içeriğine göre sistemi metni belirli bir kategoriye atamaya yönlendirir. Her kural bir öncül veya örüntü ile öngörülen bir kategoriden oluşur.
Örneğin, elinizde çok sayıda yeni makale olduğunu ve hedefinizin bunları Spor, Politika, Ekonomi vb. gibi ilgili kategorilere atamak olduğunu düşünün.
Kurala dayalı bir sınıflandırma sistemiyle, birkaç belgeyi insan gözüyle inceleyip şu tür dilsel kurallar oluşturursunuz:
- Belge para, dolar, GSYH veya enflasyon gibi kelimeler içeriyorsa Politika grubuna (sınıfına) aittir.
Kurala dayalı sistemler zaman içinde iyileştirilebilir ve insanlar tarafından anlaşılabilirdir. Ancak bu yaklaşımın bazı dezavantajları vardır.
Öncelikle, bu sistemler derin alan uzmanlığı gerektirir. Kuralların oluşturulması zaman alır; çünkü karmaşık bir sistem için kural geliştirmek zordur ve sıklıkla kapsamlı araştırma ve test gerektirir.
Yeni kurallar eklemenin mevcut kuralların sonuçlarını değiştirebilmesi nedeniyle, kurala dayalı sistemleri sürdürmek zordur ve etkin bir şekilde ölçeklenmezler.
Makine öğrenmesi temelli metin sınıflandırma
Makine öğrenmesi temelli metin sınıflandırma, gözetimli bir makine öğrenmesi problemidir. Girdi verisinin (ham metin) etiketlerle (hedef değişkenler olarak da bilinir) eşlenmesini öğrenir. Bu, metin dışı sınıflandırma problemlerine benzer; tablolu bir veri kümesinde bir gözetimli sınıflandırma algoritmasını bir sınıfı tahmin etmek üzere eğitiriz; tek fark, metin sınıflandırmada girdinin sayısal özellikler yerine ham metin olmasıdır.
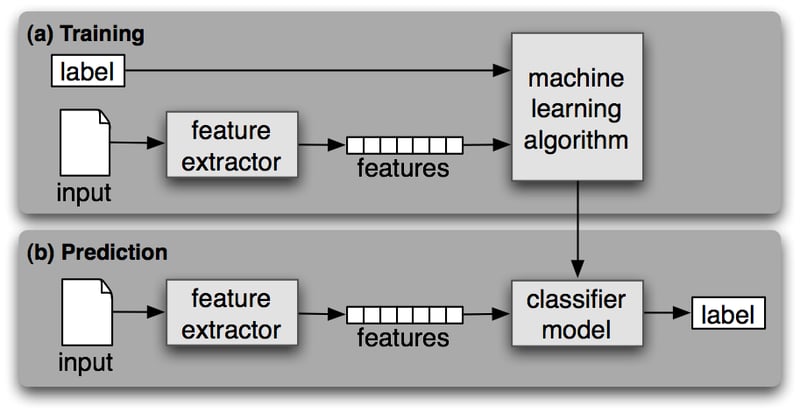
Diğer tüm gözetimli makine öğrenmesi problemleri gibi, metin sınıflandırmanın da iki fazı vardır: eğitim ve tahmin.
Eğitim fazı
Eğitim fazında gözetimli bir makine öğrenmesi algoritması, etiketli girdi veri kümesi üzerinde eğitilir. Bu sürecin sonunda, yeni ve görülmemiş veriler üzerinde tahminler (etiketler) elde etmek için kullanabileceğimiz eğitilmiş bir model elde ederiz.
Tahmin fazı
Bir makine öğrenmesi modeli eğitildiğinde, yeni ve görülmemiş veriler üzerinde etiket tahmin etmek için kullanılabilir. Bu genellikle önceki fazdan seçilen en iyi modelin sunucuda bir API olarak dağıtılmasıyla yapılır.
Metin Ön İşleme Hattı
Metin verisini ön işlemek, herhangi bir doğal dil işleme görevinde önemli bir adımdır. Metin verisini daha ileri işlem veya analiz için temizlemeye ve hazırlamaya yardımcı olur.
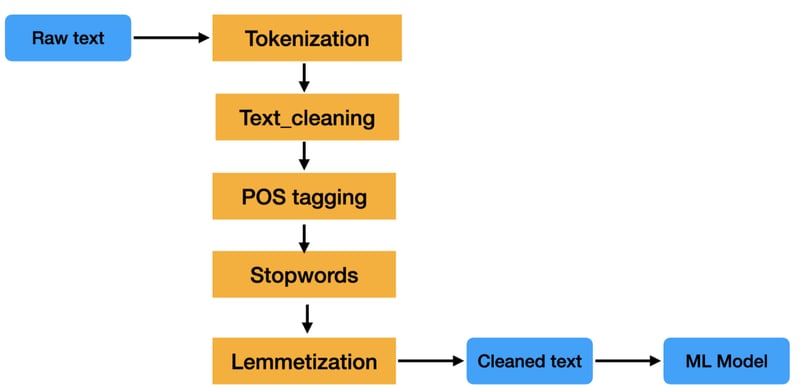
Bir metin ön işleme hattı, doğal dil işleme görevlerinde kullanılmak üzere ham metin verisine uygulanan bir dizi işlem adımıdır.
Bir metin ön işleme hattındaki adımlar değişebilir; ancak genellikle tokenleştirme, durak kelime (stop word) çıkarma, kök bulma (stemming) ve gövdeleme (lemmatization) gibi görevleri içerir. Bu adımlar, metin verisinin boyutunu azaltmaya ve metin sınıflandırma ve bilgi çıkarımı gibi NLP görevlerinin doğruluğunu artırmaya yardımcı olur.
Metin verisi, yapısız olduğu ve çoğu zaman çok fazla gürültü içerdiği için işlenmesi zordur. Bu gürültü; yazım hataları, dilbilgisi hataları ve standart olmayan biçimlendirme şeklinde olabilir. Bir metin ön işleme hattı, bu gürültüyü temizlemeyi ve metin verisinin daha kolay analiz edilebilir hale gelmesini amaçlar.
Daha fazlasını öğrenmek ister misiniz? R ile Metin Madenciliği öğrenim yolumuza göz atın.
Özellik Çıkarımı
Metinden özellik çıkarmanın, başka bir deyişle metin verisini (string) sayısal özelliklere dönüştürerek makine öğrenmesi modelini eğitilebilir hale getirmenin en yaygın iki yöntemi: Kelime Torbası (Bag of Words, diğer adıyla CountVectorizer) ve Tf-IDF'dir.
Bag of Words
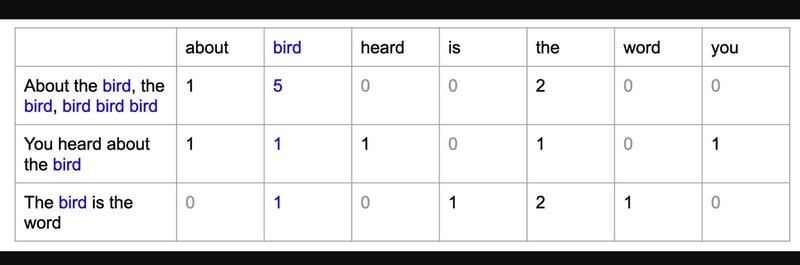
Kelime torbası (BoW) modeli, metin verisini sayısal özellikler olarak temsil etmenin basit bir yoludur. Derlemdeki bilinen kelimelerden bir sözlük oluşturmayı ve ardından her belge için, her kelimenin ne sıklıkta göründüğünü sayan bir vektör üretmeyi içerir.
TF-IDF
TF-IDF, terim sıklığı-ters belge sıklığı ifadesinin kısaltmasıdır ve metni sayısal özellikler olarak temsil etmenin bir başka yoludur. Kelime Torbası (BoW) modelinin bazı eksik yönlerini Tf-IDF giderir. Bu yazıda ayrıntıya girmeyeceğiz; ancak bu kavramı daha fazla keşfetmek isterseniz Python'da Doğal Dil İşlemeye Giriş kursumuza göz atın.
TF-IDF modeli, belge içindeki kelimelerin sıklığını ve ters belge sıklığını hesaba kattığı için kelime torbası modelinden farklıdır. Bu, TF-IDF modelinin, bir belgedeki önemli kelimeleri kelime torbası modeline kıyasla daha olası biçimde belirleyebileceği anlamına gelir.
Python'da Uçtan Uca Metin Sınıflandırma Örneği
Veri Kümesini İçe Aktarma
Öncelikle veri kümesini doğrudan bu GitHub bağlantısından içe aktararak başlayın. SMS Spam Koleksiyonu, İngilizce 5.574 SMS mesajını ve Spam veya Ham (spam değil) etiketini içeren bir veri kümesidir. Amacımız, SMS'in metninden ve etiketinden öğrenen ve SMS mesajlarının sınıfını tahmin edebilen bir makine öğrenmesi modeli eğitmektir.
# reading data
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/mohitgupta-omg/Kaggle-SMS-Spam-Collection-Dataset-/master/spam.csv', encoding='latin-1')
data.head()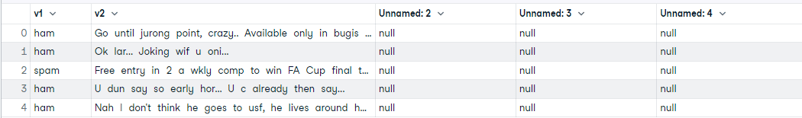
Veri kümesini okuduktan sonra ihtiyacımız olmayan birkaç ek sütun olduğunu fark edin. Yalnızca ilk iki sütuna ihtiyacımız var. Kalan sütunları atıp ilk iki sütunu da yeniden adlandıralım.
# drop unnecessary columns and rename cols
data.drop(['Unnamed: 2', 'Unnamed: 3', 'Unnamed: 4'], axis=1, inplace=True)
data.columns = ['label', 'text']
data.head()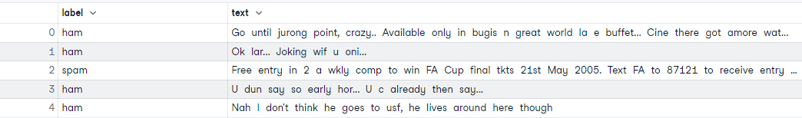
Keşifsel Veri Analizi (EDA)
Veri kümesinde eksik değer olup olmadığını ve hedef dengenin durumunu görmek için bazı temel EDA adımları uygulayalım.
# check missing values
data.isna().sum()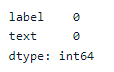
# check data shape
data.shape>>> (5572, 2)# check target balance
data['label'].value_counts(normalize = True).plot.bar()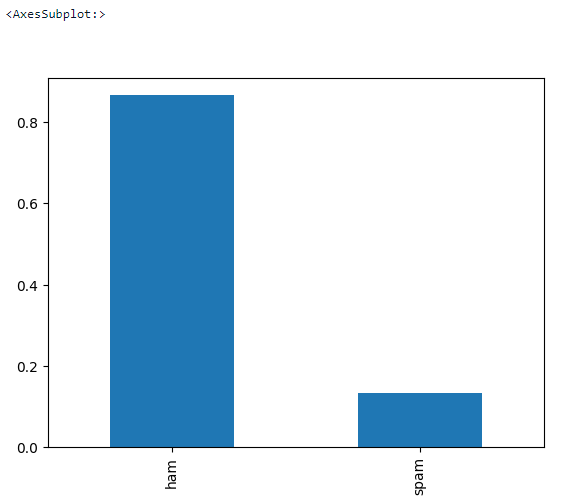
Metin Ön İşleme
Tüm metin temizliğinin yapıldığı bölüm burasıdır. 5.572 belgenin tamamı üzerinden dönen bir döngü şu adımları gerçekleştirir:
- Tüm özel karakterleri kaldırma
- Tüm kelimeleri küçük harfe çevirme
- Tokenleştirme
- Durak kelimeleri kaldırma
- Gövdeleme (lemmatization)
# text preprocessing
# download nltk
import nltk
nltk.download('all')
# create a list text
text = list(data['text'])
# preprocessing loop
import re
from nltk.corpus import stopwords
from nltk.stem import WordNetLemmatizer
lemmatizer = WordNetLemmatizer()
corpus = []
for i in range(len(text)):
r = re.sub('[^a-zA-Z]', ' ', text[i])
r = r.lower()
r = r.split()
r = [word for word in r if word not in stopwords.words('english')]
r = [lemmatizer.lemmatize(word) for word in r]
r = ' '.join(r)
corpus.append(r)
#assign corpus to data['text']
data['text'] = corpus
data.head()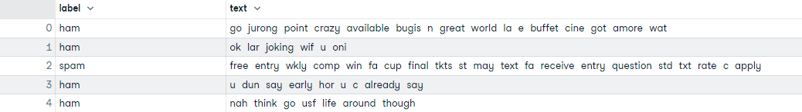
Eğitim-test ayrımı
Özellik çıkarımından önce veri kümesini eğitim ve test olarak ayıralım.
# Create Feature and Label sets
X = data['text']
y = data['label']
# train test split (66% train - 33% test)
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.33, random_state=123)
print('Training Data :', X_train.shape)
print('Testing Data : ', X_test.shape)>>> Training Data : (3733,)
>>> Testing Data : (1839,)Özellik Çıkarımı
Burada, temizlenmiş metni sayısal özelliklere dönüştürmek için Kelime Torbası modelini (CountVectorizer) kullanıyoruz. Bu, makine öğrenmesi modelini eğitmek için gereklidir.
# Train Bag of Words model
from sklearn.feature_extraction.text import CountVectorizer
cv = CountVectorizer()
X_train_cv = cv.fit_transform(X_train)
X_train_cv.shape>>> (3733, 7020)Model Eğitimi ve Değerlendirme
Bu bölümde bir Lojistik Regresyon modeli eğitiyor ve eğitilen modelin karmaşıklık matrisini değerlendiriyoruz.
# Training Logistic Regression model
from sklearn.linear_model import LogisticRegression
lr = LogisticRegression()
lr.fit(X_train_cv, y_train)
# transform X_test using CV
X_test_cv = cv.transform(X_test)
# generate predictions
predictions = lr.predict(X_test_cv)
predictions>>> array(['ham', 'spam', 'ham', ..., 'ham', 'ham', 'spam'], dtype=object)# confusion matrix
import pandas as pd
from sklearn import metrics
df = pd.DataFrame(metrics.confusion_matrix(y_test,predictions), index=['ham','spam'], columns=['ham','spam'])
df
Daha fazla ayrıntı için tam DataLab çalışma kitabına göz atın.
Sonuç
NLP hâlâ pek çok üniversite ve şirketin yeni algoritmalar ve uygulamalar geliştirdiği, aktif bir araştırma ve geliştirme alanıdır. NLP; bilgisayar bilimi, dilbilim, psikoloji ve bilişsel bilim dâhil olmak üzere çeşitli geçmişlere sahip araştırmacıları bir araya getiren disiplinler arası bir alandır.
Metin sınıflandırma, NLP'de yaygın biçimde kullanılan güçlü bir görevdir ve sıklıkla gözetimli makine öğrenmesinin yardımıyla, görülmemiş metin belgelerini otomatik olarak kategorize etmek veya bir sınıfını tahmin etmek için kullanılabilir.
Her zaman yüzde yüz doğru sonuç vermez; ancak doğru kullanıldığında analizlerinize büyük değer katabilir. Bir metin sınıflandırıcıyı kurmanın birçok yolu ve algoritması vardır ve tek bir en iyi yaklaşım yoktur. Veriniz ve amacınız için en iyi çalışan yöntemi bulmak üzere denemeler yapmak önemlidir.
Metin Sınıflandırma SSS
İkiden fazla etiket olduğunda Metin Sınıflandırma kullanılabilir mi?
Evet, yalnızca iki etiket varsa ikili sınıflandırma algoritmaları kullanırsınız. İkiden fazla etiket varsa, çok sınıflı bir sınıflandırma algoritması kullanmanız gerekir.
Metin Sınıflandırma bir NLP görevi midir?
Evet, NLP çok geniş bir alandır. Metin sınıflandırma, çok çeşitli sektörlerde uygulamaları olan, NLP'nin temel kullanım örneklerinden biridir.
Metin Sınıflandırma gözetimli bir makine öğrenmesi problemi midir?
Metin sınıflandırma sistemleri kurala dayalı da olabilir; ancak bakımının ve ölçeklenmesinin zor olması nedeniyle hızla gözden düşmektedir. Metin sınıflandırma görevleri için makine öğrenmesi temelli bir sistem, gözetimli makine öğrenmesi kullanır.
Doğal Dil İşleme nedir?
Doğal dil işleme (NLP), bilgisayar bilimi ve yapay zekâ alanlarında, bilgisayarlarla insan (doğal) dilleri arasındaki etkileşimlerle ilgilenen; özellikle bilgisayarların büyük miktarda doğal dil verisini işlemesi ve analiz etmesi için nasıl programlanacağını inceleyen bir disiplindir.
Metin Sınıflandırma ile duygu analizi aynı şey midir?
Duygu analizi, bir metin sınıflandırma sistemine örnektir. Ancak adından da anlaşılacağı üzere duygu analizi genellikle etiketin bir tür duygu (olumlu ya da olumsuz, mutlu ya da üzgün vb.) olduğu durumlarda yapılır.
Makine öğrenmesi kullanmadan Metin Sınıflandırma yapılabilir mi?
Evet, metin sınıflandırma için kurala dayalı sistemler de kullanabiliriz.
Metin Sınıflandırma için derin öğrenme kullanabilir miyiz?
Evet, makine öğrenmesi yerine herhangi bir derin öğrenme algoritması da kullanabiliriz. NLP ve Derin Öğrenme hakkında daha fazla bilgi edinmek için Python'da Dil Modellemesi için Yinelenen Sinir Ağları (RNN) adlı harika kursa göz atın. TensorFlow kullanarak bir Metin Sınıflandırma Modeli oluşturmak isterseniz, Datacamp'teki şu TensorFlow 2.0 Vaka Çalışmasına bakın.
Metin Sınıflandırma için en iyi algoritma nedir?
En iyi algoritma diye bir şey yoktur. Genellikle naif Bayes algoritmasının yüksek boyutlu (metin) veride iyi performans gösterdiği görülür.
BERT, Metin Sınıflandırmada kullanılır mı?
Evet, Çift Yönlü Kodlayıcı Temsilleri (Bidirectional Encoder Representations) anlamına gelen BERT, Transformer mimarisine dayanan bir derin öğrenme modelidir. Birçok başka kullanımın yanı sıra, BERT metin sınıflandırma sistemlerinde de kullanılabilir. Daha fazla ayrıntı için BERT ile NLP eğitimimize bakın.
Metin Sınıflandırma ve Metin Madenciliği aynı şey midir?
Hayır. Metin Madenciliği, yapısız metni anlamlı örüntüleri belirlemek üzere yapılandırılmış bir biçime dönüştürme sürecidir; metin sınıflandırmanın amacı ise sıklıkla gözetimli makine öğrenmesinin yardımıyla, görülmemiş metin belgelerini kategorize etmek veya bir sınıfını tahmin etmektir.





Metin verisi, şirketlerin bugün en sık kullandığı veri türlerinden biridir; ancak belirgin bir yapısı olmadığı için metin verisinden içgörü çıkarmak zor ve zaman alıcı olabilir. Metin verisiyle çalışmak, Doğal Dil İşleme (Natural Language Processing) alanının kapsamına girer ve bu alan yapay zekânın bir alt dalıdır.
Doğal Dil İşleme (NLP), bilgisayarların insan dilleriyle nasıl etkileşime girdiğini ve bilgisayarların büyük miktarda doğal dil verisini işlemesi ve analiz etmesi için nasıl programlanacağını inceleyen bir bilgisayar bilimi ve yapay zekâ alanıdır.
NLP; soruları otomatik olarak yanıtlamak, metin özetleri üretmek, metinleri bir dilden başka bir dile çevirmek gibi pek çok amaçla kullanılır. NLP araştırmaları bilişsel bilim, dilbilim ve psikoloji gibi alanlarda da yürütülmektedir. Metin sınıflandırma, NLP için böyle bir kullanım örneğidir.
Bu blog yazısında metin sınıflandırma kullanım örneklerini inceleyeceğiz. Ayrıca Python'da bir metin ön işleme hattı kurmayı ve ardından bir metin sınıflandırma modeli oluşturmayı uçtan uca gösteren bir örnek de yer alıyor.
Doğal dil işleme hakkında daha fazla bilgi edinmek isterseniz, Python ile Doğal Dil İşleme ve R ile Doğal Dil İşleme öğrenim yollarımız faydalı olacaktır. Metin verisini değerli içgörülere dönüştürmek için gereken temel NLP becerilerini kazanacaksınız. Ayrıca NLTK, scikit-learn, spaCy ve SpeechRecognition dahil olmak üzere popüler NLP Python kütüphaneleriyle de tanışacaksınız.