

टेक्स्ट क्लासिफिकेशन क्या है?
टेक्स्ट क्लासिफिकेशन एक सामान्य NLP कार्य है जिसका उपयोग विभिन्न क्षेत्रों में व्यावसायिक समस्याओं को हल करने के लिए किया जाता है। टेक्स्ट क्लासिफिकेशन का उद्देश्य अनदेखे टेक्स्ट दस्तावेज़ों के वर्ग का निर्धारण या भविष्यवाणी करना है, जो अक्सर सुपरवाइज़्ड मशीन लर्निंग की मदद से किया जाता है।
जैसे किसी टेब्युलर डेटासेट पर ट्रेन किए गए क्लासिफिकेशन एल्गोरिदम से किसी वर्ग की भविष्यवाणी की जाती है, वैसे ही टेक्स्ट क्लासिफिकेशन भी सुपरवाइज़्ड मशीन लर्निंग का उपयोग करता है। दोनों के बीच मुख्य अंतर यह है कि टेक्स्ट क्लासिफिकेशन में इनपुट के रूप में टेक्स्ट शामिल होता है।
आप बिना सुपरवाइज़्ड मशीन लर्निंग के भी टेक्स्ट क्लासिफिकेशन कर सकते हैं। एल्गोरिदम के बजाय, एक मैनुअल नियम-आधारित सिस्टम डिज़ाइन किया जा सकता है जो टेक्स्ट क्लासिफिकेशन का काम करता है। अगले खंड में हम नियम-आधारित और मशीन-लर्निंग-आधारित टेक्स्ट क्लासिफिकेशन सिस्टम के फायदे और नुकसान की तुलना और समीक्षा करेंगे।
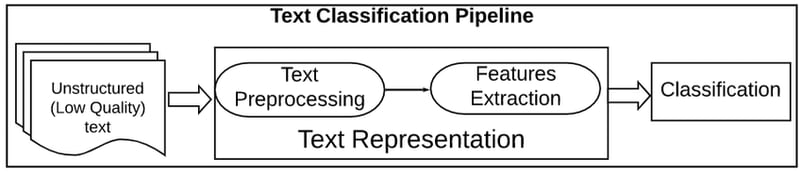
यदि आप सुपरवाइज़्ड मशीन लर्निंग के बारे में और जानना चाहते हैं, तो हमारा अलग लेख देखें।
टेक्स्ट क्लासिफिकेशन के उपयोग और अनुप्रयोग
स्पैम क्लासिफिकेशन
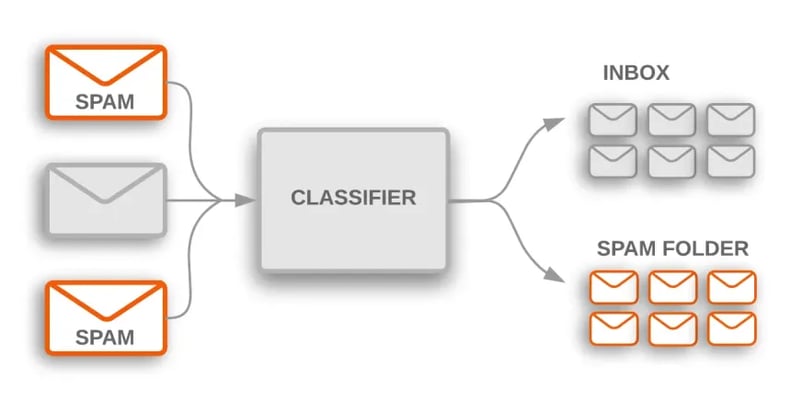
कई उद्योगों में टेक्स्ट क्लासिफिकेशन के कई व्यावहारिक उपयोग होते हैं। उदाहरण के लिए, स्पैम फ़िल्टर एक सामान्य अनुप्रयोग है जो ईमेल को स्पैम और नॉन-स्पैम श्रेणियों में छाँटने के लिए टेक्स्ट क्लासिफिकेशन का उपयोग करता है।
समाचार लेख और ब्लॉग का वर्गीकरण
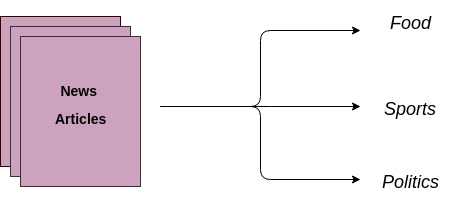
एक और उपयोग यह है कि टेक्स्ट दस्तावेज़ों को स्वचालित रूप से पूर्व-निर्धारित श्रेणियों में असाइन किया जाए। एक सुपरवाइज़्ड मशीन लर्निंग मॉडल को लेबल वाले डेटा पर प्रशिक्षित किया जाता है, जिसमें कच्चा टेक्स्ट और लक्ष्य दोनों शामिल होते हैं। एक बार मॉडल प्रशिक्षित हो जाने पर, इसे प्रोडक्शन में नए और अनदेखे डेटा (भविष्य में लिखे जाने वाले लेख/ब्लॉग) पर श्रेणी (लेबल) प्राप्त करने के लिए उपयोग किया जाता है।
कस्टमर सपोर्ट अनुरोधों का वर्गीकरण
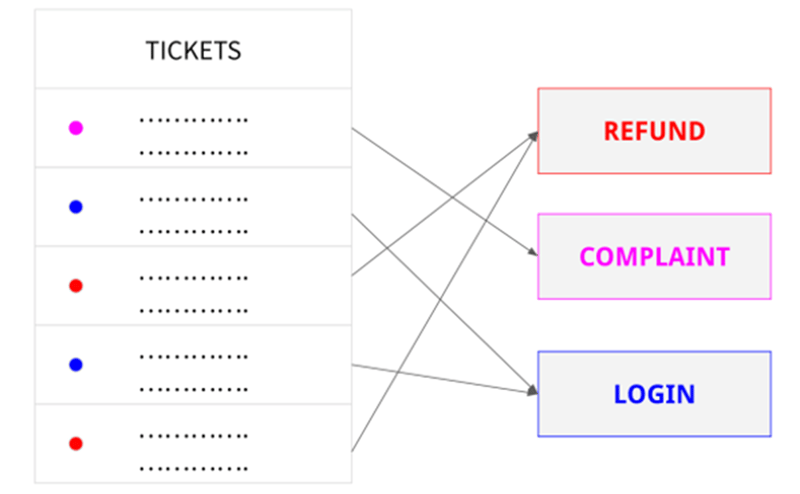
कोई कंपनी विषय के आधार पर कस्टमर सपोर्ट अनुरोधों को स्वचालित रूप से वर्गीकृत करने, या प्राथमिकता तय कर उचित विभाग तक रूट करने के लिए टेक्स्ट क्लासिफिकेशन का उपयोग कर सकती है।
हेट स्पीच डिटेक्शन
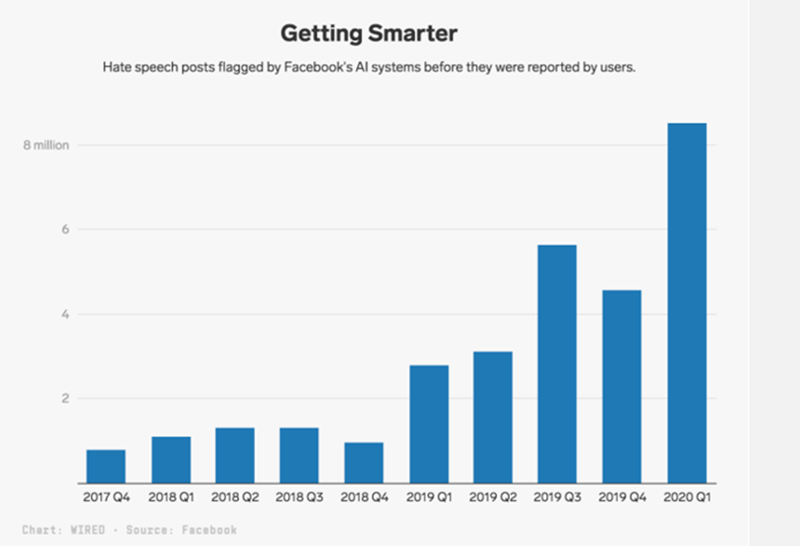
1.7 अरब से अधिक दैनिक सक्रिय उपयोगकर्ताओं के साथ, Facebook पर अनिवार्य रूप से कुछ ऐसा कंटेंट बनता है जो नियमों के खिलाफ होता है। इस अवांछित कंटेंट में हेट स्पीच शामिल है।
Facebook इस समस्या का समाधान इस तरह करता है कि जिन पोस्टों को AI टेक्स्ट क्लासिफायर ने हेट स्पीच के रूप में पहचाना है, उनका मैन्युअल रिव्यू करवाया जाता है। AI द्वारा फ़्लैग की गई पोस्टों की उसी तरह जाँच होती है जैसे उपयोगकर्ताओं द्वारा रिपोर्ट की गई पोस्टों की। दरअसल, केवल 2020 की पहली तिमाही में ही प्लेटफ़ॉर्म ने 9.6 मिलियन ऐसे कंटेंट आइटम हटाए जिन्हें हेट स्पीच के रूप में वर्गीकृत किया गया था।
टेक्स्ट क्लासिफिकेशन सिस्टम के प्रकार
मुख्यतः दो प्रकार के टेक्स्ट क्लासिफिकेशन सिस्टम होते हैं: नियम-आधारित और मशीन लर्निंग-आधारित टेक्स्ट क्लासिफिकेशन।
नियम-आधारित टेक्स्ट क्लासिफिकेशन
नियम-आधारित तकनीकें टेक्स्ट को श्रेणियों या समूहों में वर्गीकृत करने के लिए मैन्युअल रूप से निर्मित भाषा नियमों के सेट का उपयोग करती हैं। ये नियम टेक्स्ट की सामग्री में अर्थपूर्ण रूप से प्रासंगिक तत्वों का उपयोग करके सिस्टम को किसी विशेष श्रेणी में टेक्स्ट को वर्गीकृत करने का निर्देश देते हैं। प्रत्येक नियम एक पूर्ववर्ती या पैटर्न और एक अनुमानित श्रेणी से मिलकर बना होता है।
उदाहरण के लिए, मान लीजिए आपके पास बहुत सारे नए लेख हैं, और आपका लक्ष्य उन्हें खेल, राजनीति, अर्थव्यवस्था आदि जैसी प्रासंगिक श्रेणियों में असाइन करना है।
नियम-आधारित क्लासिफिकेशन सिस्टम के साथ, आप कुछ दस्तावेज़ों की मानव समीक्षा करेंगे और इस तरह के भाषाई नियम बनाएंगे:
- यदि दस्तावेज़ में money, dollar, GDP, या inflation जैसे शब्द हैं, तो यह Politics समूह (क्लास) में आता है।
नियम-आधारित सिस्टम समय के साथ परिष्कृत किए जा सकते हैं और मनुष्यों के लिए समझने योग्य होते हैं। हालांकि, इस रणनीति की कुछ कमियाँ भी हैं।
सबसे पहले, इन सिस्टमों के लिए क्षेत्र में गहन विशेषज्ञता की आवश्यकता होती है। वे समय लेने वाले होते हैं क्योंकि जटिल सिस्टम के लिए नियम बनाना कठिन हो सकता है और अक्सर व्यापक अध्ययन और परीक्षण की आवश्यकता होती है।
चूँकि नए नियम जोड़ने से पहले से मौजूद नियमों के परिणाम बदल सकते हैं, नियम-आधारित सिस्टम का रखरखाव चुनौतीपूर्ण होता है और वे प्रभावी रूप से स्केल नहीं कर पाते।
मशीन लर्निंग-आधारित टेक्स्ट क्लासिफिकेशन
मशीन लर्निंग-आधारित टेक्स्ट क्लासिफिकेशन एक सुपरवाइज़्ड मशीन लर्निंग समस्या है। यह इनपुट डेटा (कच्चा टेक्स्ट) और लेबल (जिन्हें टार्गेट वेरिएबल भी कहते हैं) के बीच मैपिंग सीखता है। यह नॉन-टेक्स्ट क्लासिफिकेशन समस्याओं जैसा ही है जहाँ हम किसी टेब्युलर डेटासेट पर सुपरवाइज़्ड क्लासिफिकेशन एल्गोरिदम को एक क्लास की भविष्यवाणी के लिए ट्रेन करते हैं, फर्क इतना है कि टेक्स्ट क्लासिफिकेशन में इनपुट डेटा संख्यात्मक फीचर्स के बजाय कच्चा टेक्स्ट होता है।
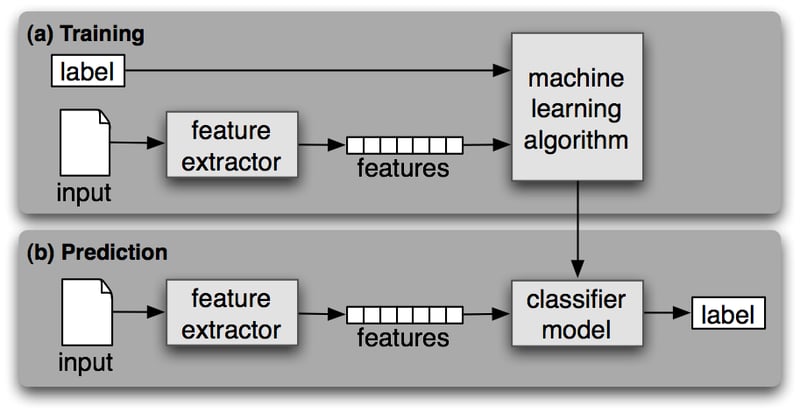
किसी भी अन्य सुपरवाइज़्ड मशीन लर्निंग की तरह, टेक्स्ट क्लासिफिकेशन में भी दो चरण होते हैं: प्रशिक्षण और भविष्यवाणी।
प्रशिक्षण चरण
प्रशिक्षण चरण में एक सुपरवाइज़्ड मशीन लर्निंग एल्गोरिदम को इनपुट-लेबल्ड डेटासेट पर प्रशिक्षित किया जाता है। इस प्रक्रिया के अंत में हमें एक प्रशिक्षित मॉडल मिलता है जिसका उपयोग हम नए और अनदेखे डेटा पर भविष्यवाणी (लेबल) प्राप्त करने के लिए कर सकते हैं।
भविष्यवाणी चरण
एक बार मशीन लर्निंग मॉडल प्रशिक्षित हो जाने पर, इसे नए और अनदेखे डेटा पर लेबल की भविष्यवाणी के लिए उपयोग किया जा सकता है। आमतौर पर पिछले चरण से सर्वश्रेष्ठ मॉडल को सर्वर पर एक API के रूप में डिप्लॉय करके यह किया जाता है।
टेक्स्ट प्रीप्रोसेसिंग पाइपलाइन
किसी भी नैचुरल लैंग्वेज प्रोसेसिंग कार्य में टेक्स्ट डेटा का प्रीप्रोसेसिंग एक महत्वपूर्ण कदम है। यह टेक्स्ट डेटा की सफाई और उसे आगे की प्रोसेसिंग या विश्लेषण के लिए तैयार करने में मदद करता है।
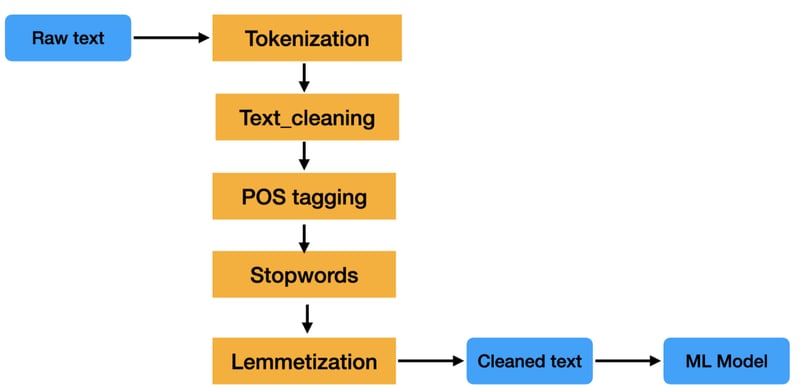
टेक्स्ट प्रीप्रोसेसिंग पाइपलाइन कच्चे टेक्स्ट डेटा पर लागू प्रोसेसिंग चरणों की एक शृंखला है, ताकि उसे नैचुरल लैंग्वेज प्रोसेसिंग कार्यों में उपयोग के लिए तैयार किया जा सके।
पाइपलाइन के चरण अलग-अलग हो सकते हैं, लेकिन आम तौर पर इनमें टोकनाइज़ेशन, स्टॉप वर्ड हटाना, स्टेमिंग और लैमेटाइज़ेशन जैसे कार्य शामिल होते हैं। ये चरण टेक्स्ट डेटा का आकार घटाने में मदद करते हैं और टेक्स्ट क्लासिफिकेशन और सूचना निष्कर्षण जैसे NLP कार्यों की सटीकता भी बढ़ाते हैं।
टेक्स्ट डेटा को प्रोसेस करना मुश्किल होता है क्योंकि यह असंरचित होता है और अक्सर इसमें बहुत शोर होता है। यह शोर गलत वर्तनी, व्याकरणिक त्रुटियों और गैर-मानक फॉर्मेटिंग के रूप में हो सकता है। टेक्स्ट प्रीप्रोसेसिंग पाइपलाइन का उद्देश्य इस शोर को साफ करना है ताकि टेक्स्ट डेटा का विश्लेषण अधिक आसानी से किया जा सके।
और जानना चाहते हैं? हमारा Text Mining with R ट्रैक देखें।
फीचर एक्सट्रैक्शन
टेक्स्ट से फीचर निकालने या दूसरे शब्दों में टेक्स्ट डेटा (स्ट्रिंग्स) को संख्यात्मक फीचर्स में बदलने की दो सबसे आम विधियाँ, ताकि मशीन लर्निंग मॉडल को ट्रेन किया जा सके, ये हैं: Bag of Words (उर्फ CountVectorizer) और Tf-IDF।
Bag of Words
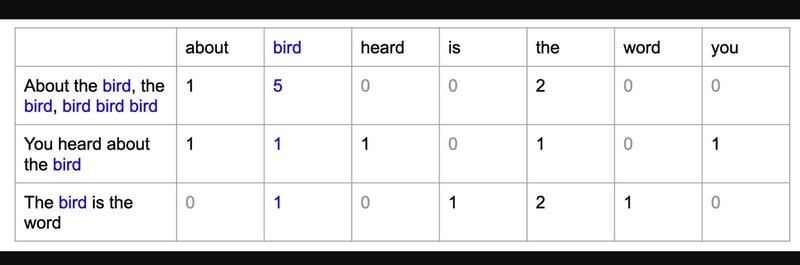
Bag of Words (BoW) मॉडल टेक्स्ट डेटा को संख्यात्मक फीचर्स के रूप में पेश करने का एक सरल तरीका है। इसमें कॉर्पस में ज्ञात शब्दों की एक शब्दावली बनाई जाती है और फिर प्रत्येक दस्तावेज़ के लिए एक वेक्टर बनाया जाता है जिसमें दर्शाया जाता है कि प्रत्येक शब्द कितनी बार आता है।
TF-IDF
TF-IDF का अर्थ है term frequency-inverse document frequency, और यह टेक्स्ट को संख्यात्मक फीचर्स के रूप में प्रस्तुत करने का एक और तरीका है। Bag of Words (BoW) मॉडल की कुछ कमियाँ हैं जिन्हें Tf-IDF दूर करता है। हम इस लेख में उसके विवरण में नहीं जाएँगे, लेकिन यदि आप इस अवधारणा का और अन्वेषण करना चाहते हैं, तो हमारा Introduction to Natural Language Processing in Python कोर्स देखें।
TF-IDF मॉडल bag of words मॉडल से अलग है क्योंकि यह दस्तावेज़ में शब्दों की आवृत्ति के साथ-साथ इनवर्स डॉक्यूमेंट फ्रीक्वेंसी को भी ध्यान में रखता है। इसका मतलब है कि TF-IDF मॉडल किसी दस्तावेज़ में महत्त्वपूर्ण शब्दों की पहचान करने की अधिक संभावना रखता है बनिस्बत bag of words मॉडल के।
Python में एंड-टू-एंड टेक्स्ट क्लासिफिकेशन उदाहरण
डेटासेट इम्पोर्ट करना
सबसे पहले, इस GitHub लिंक से सीधे डेटासेट इम्पोर्ट करें। SMS Spam Collection एक डेटासेट है जिसमें अंग्रेज़ी में 5,574 SMS संदेश हैं और उनके साथ लेबल Spam या Ham (स्पैम नहीं) दिया गया है। हमारा लक्ष्य एक मशीन लर्निंग मॉडल को ट्रेन करना है जो SMS के टेक्स्ट और लेबल से सीखकर SMS संदेशों की क्लास की भविष्यवाणी कर सके।
# reading data
import pandas as pd
data = pd.read_csv('https://raw.githubusercontent.com/mohitgupta-omg/Kaggle-SMS-Spam-Collection-Dataset-/master/spam.csv', encoding='latin-1')
data.head()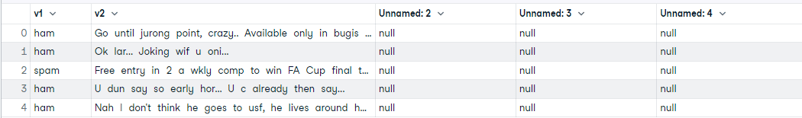
डेटासेट पढ़ने के बाद, ध्यान दें कि कुछ अतिरिक्त कॉलम हैं जिनकी हमें आवश्यकता नहीं है। हमें केवल पहले दो कॉलम चाहिए। आइए बाकी कॉलम ड्रॉप करें और पहले दो कॉलम का नाम भी बदलें।
# drop unnecessary columns and rename cols
data.drop(['Unnamed: 2', 'Unnamed: 3', 'Unnamed: 4'], axis=1, inplace=True)
data.columns = ['label', 'text']
data.head()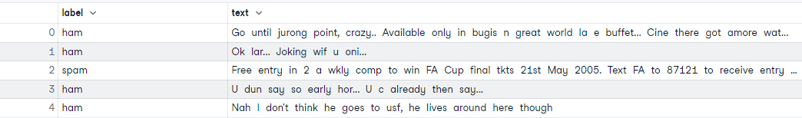
एक्सप्लोरेटरी डेटा एनालिसिस (EDA)
आइए कुछ बुनियादी EDA करें ताकि देखें कि डेटासेट में मिसिंग वैल्यू हैं या नहीं और टार्गेट बैलेंस कैसा है।
# check missing values
data.isna().sum()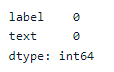
# check data shape
data.shape>>> (5572, 2)# check target balance
data['label'].value_counts(normalize = True).plot.bar()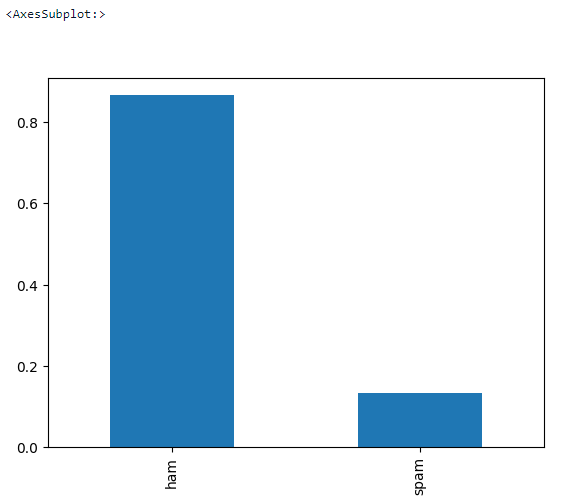
टेक्स्ट प्रीप्रोसेसिंग
यहीं पर पूरी टेक्स्ट सफाई होती है। यह 5,572 दस्तावेज़ों पर चलने वाला एक लूप है जो निम्न करता है:
- सभी विशेष अक्षर हटाना
- सभी शब्दों को लोअरकेस करना
- टोकनाइज़ करना
- स्टॉपवर्ड्स हटाना
- लैमेटाइज़ करना
# text preprocessing
# download nltk
import nltk
nltk.download('all')
# create a list text
text = list(data['text'])
# preprocessing loop
import re
from nltk.corpus import stopwords
from nltk.stem import WordNetLemmatizer
lemmatizer = WordNetLemmatizer()
corpus = []
for i in range(len(text)):
r = re.sub('[^a-zA-Z]', ' ', text[i])
r = r.lower()
r = r.split()
r = [word for word in r if word not in stopwords.words('english')]
r = [lemmatizer.lemmatize(word) for word in r]
r = ' '.join(r)
corpus.append(r)
#assign corpus to data['text']
data['text'] = corpus
data.head()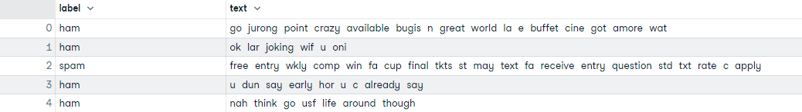
ट्रेन-टेस्ट स्प्लिट
आइए फीचर एक्सट्रैक्शन से पहले डेटासेट को ट्रेन और टेस्ट में बाँटें।
# Create Feature and Label sets
X = data['text']
y = data['label']
# train test split (66% train - 33% test)
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.33, random_state=123)
print('Training Data :', X_train.shape)
print('Testing Data : ', X_test.shape)>>> Training Data : (3733,)
>>> Testing Data : (1839,)फीचर एक्सट्रैक्शन
यहाँ हम Bag of Words मॉडल (CountVectorizer) का उपयोग कर साफ किए गए टेक्स्ट को संख्यात्मक फीचर्स में बदलते हैं। मशीन लर्निंग मॉडल को ट्रेन करने के लिए यह आवश्यक है।
# Train Bag of Words model
from sklearn.feature_extraction.text import CountVectorizer
cv = CountVectorizer()
X_train_cv = cv.fit_transform(X_train)
X_train_cv.shape>>> (3733, 7020)मॉडल प्रशिक्षण और मूल्यांकन
इस भाग में, हम एक Logistic Regression मॉडल को प्रशिक्षित कर रहे हैं और प्रशिक्षित मॉडल के confusion matrix का मूल्यांकन कर रहे हैं।
# Training Logistic Regression model
from sklearn.linear_model import LogisticRegression
lr = LogisticRegression()
lr.fit(X_train_cv, y_train)
# transform X_test using CV
X_test_cv = cv.transform(X_test)
# generate predictions
predictions = lr.predict(X_test_cv)
predictions>>> array(['ham', 'spam', 'ham', ..., 'ham', 'ham', 'spam'], dtype=object)# confusion matrix
import pandas as pd
from sklearn import metrics
df = pd.DataFrame(metrics.confusion_matrix(y_test,predictions), index=['ham','spam'], columns=['ham','spam'])
df
अधिक विवरण के लिए पूरा DataLab वर्कबुक देखें।
निष्कर्ष
NLP अभी भी शोध और विकास का एक सक्रिय क्षेत्र है, जहाँ कई विश्वविद्यालय और कंपनियाँ नए एल्गोरिदम और अनुप्रयोग विकसित करने पर काम कर रही हैं। NLP एक अंतःविषय क्षेत्र है, जिसमें कंप्यूटर विज्ञान, भाषाविज्ञान, मनोविज्ञान, और संज्ञानात्मक विज्ञान सहित विभिन्न पृष्ठभूमि के शोधकर्ता शामिल हैं।
टेक्स्ट वर्गीकरण NLP में एक शक्तिशाली और व्यापक रूप से प्रयुक्त कार्य है, जिसका उपयोग अनदेखे टेक्स्ट दस्तावेज़ों को स्वचालित रूप से वर्गीकृत करने या उनकी श्रेणी का पूर्वानुमान लगाने के लिए किया जा सकता है, अक्सर सुपरवाइज्ड मशीन लर्निंग की मदद से।
यह हमेशा सटीक नहीं होता, लेकिन सही तरीके से उपयोग करने पर यह आपके विश्लेषण में काफी मूल्य जोड़ सकता है। टेक्स्ट क्लासिफायर सेट करने के कई तरीके और एल्गोरिदम हैं, और कोई एकल तरीका सर्वोत्तम नहीं है। अपने डेटा और अपने उद्देश्यों के लिए क्या सबसे अच्छा काम करता है, यह खोजने के लिए प्रयोग करना महत्वपूर्ण है।
Text Classification FAQs
क्या दो से अधिक लेबल होने पर भी Text Classification का उपयोग किया जा सकता है?
हाँ, यदि केवल दो लेबल हैं, तो आप बाइनरी क्लासिफिकेशन एल्गोरिदम का उपयोग करेंगे। यदि दो से अधिक लेबल हैं, तो आपको मल्टी‑क्लास क्लासिफिकेशन एल्गोरिदम का उपयोग करना होगा।
क्या Text Classification, NLP का कार्य है?
हाँ, NLP एक बहुत व्यापक क्षेत्र है। टेक्स्ट वर्गीकरण NLP के मूलभूत उपयोग‑मामलों में से एक है, जिसके अनुप्रयोग कई उद्योगों में हैं।
क्या Text Classification एक supervised machine learning समस्या है?
टेक्स्ट वर्गीकरण प्रणालियाँ नियम‑आधारित भी हो सकती हैं, लेकिन वे तेज़ी से अप्रचलित हो रही हैं क्योंकि उनका रखरखाव और स्केल करना कठिन होता है। टेक्स्ट वर्गीकरण कार्यों के लिए मशीन लर्निंग‑आधारित प्रणाली सुपरवाइज्ड मशीन लर्निंग का उपयोग करती है।
Natural Language Processing क्या है?
नेचुरल लैंग्वेज प्रोसेसिंग (NLP) कंप्यूटर विज्ञान और आर्टिफिशियल इंटेलिजेंस का एक क्षेत्र है जो कंप्यूटर और मानव (प्राकृतिक) भाषाओं के बीच अंतःक्रियाओं से संबंधित है, विशेष रूप से यह कि बड़े पैमाने के प्राकृतिक भाषा डेटा को प्रोसेस और विश्लेषित करने के लिए कंप्यूटरों को कैसे प्रोग्राम किया जाए।
क्या Text Classification और sentiment analysis एक ही हैं?
सेंटिमेंट एनालिसिस टेक्स्ट वर्गीकरण प्रणाली का एक उदाहरण है। हालाँकि, जैसा कि नाम से स्पष्ट है, सेंटिमेंट एनालिसिस आम तौर पर तब किया जाता है जब लेबल किसी प्रकार का भाव होता है (सकारात्मक या नकारात्मक, खुश या उदास, आदि)।
क्या मशीन लर्निंग के बिना Text Classification किया जा सकता है?
हाँ, हम टेक्स्ट वर्गीकरण के लिए नियम‑आधारित प्रणालियों का भी उपयोग कर सकते हैं।
क्या हम Text Classification के लिए डीप लर्निंग का उपयोग कर सकते हैं?
हाँ, हम मशीन लर्निंग के बजाय किसी भी डीप लर्निंग एल्गोरिदम का उपयोग कर सकते हैं। NLP और डीप लर्निंग के बारे में अधिक जानने के लिए इस बेहतरीन कोर्स को देखें Recurrent Neural Networks (RNN) for Language Modeling in Python। यदि आप TensorFlow का उपयोग करके Text Classification मॉडल बनाना चाहते हैं, तो यह TensorFlow 2.0 केस स्टडी Datacamp पर देखें।
Text Classification के लिए सर्वश्रेष्ठ एल्गोरिदम कौन‑सा है?
ऐसा कोई सर्वश्रेष्ठ एल्गोरिदम नहीं है। आमतौर पर, नैव बेयेज़ एल्गोरिदम उच्च-आयामी (टेक्स्ट) डेटा पर अच्छा प्रदर्शन करता दिखता है।
क्या BERT का उपयोग Text Classification के लिए किया जाता है?
हाँ, BERT, जिसका अर्थ है Bidirectional Encoder Representations from Transformers, Transformers आर्किटेक्चर पर आधारित एक डीप लर्निंग मॉडल है। कई अन्य उपयोग‑मामलों के बीच, BERT का उपयोग टेक्स्ट वर्गीकरण प्रणालियों के लिए भी किया जा सकता है। अधिक विवरण के लिए हमारा BERT का उपयोग करते हुए NLP पर ट्यूटोरियल देखें।
क्या Text Classification और Text Mining एक ही चीज़ हैं?
नहीं, Text Mining असंरचित टेक्स्ट को सार्थक पैटर्नों की पहचान के लिए संरचित प्रारूप में रूपांतरित करने की प्रक्रिया है, जबकि टेक्स्ट वर्गीकरण का लक्ष्य अनदेखे टेक्स्ट दस्तावेज़ों को किसी श्रेणी में वर्गीकृत करना या उनकी श्रेणी का पूर्वानुमान लगाना है, जो अक्सर सुपरवाइज्ड मशीन लर्निंग की मदद से किया जाता है।
टेक्स्ट डेटा आज कंपनियों द्वारा उपयोग किए जाने वाले सबसे आम डेटा प्रकारों में से एक है, लेकिन क्योंकि इसका स्पष्ट स्ट्रक्चर नहीं होता, टेक्स्ट डेटा से इनसाइट्स निकालना कठिन और समय-साध्य हो सकता है। टेक्स्ट डेटा के साथ काम करना नेचुरल लैंग्वेज प्रोसेसिंग के अंतर्गत आता है, जो कृत्रिम बुद्धिमत्ता का एक उपक्षेत्र है।
नेचुरल लैंग्वेज प्रोसेसिंग (NLP) कंप्यूटर विज्ञान और कृत्रिम बुद्धिमत्ता का एक क्षेत्र है जो यह देखता है कि कंप्यूटर मानवीय भाषाओं के साथ कैसे इंटरैक्ट करते हैं और कंप्यूटरों को विशाल प्राकृतिक भाषा डेटा को प्रोसेस और विश्लेषित करने के लिए कैसे प्रोग्राम किया जाए।
NLP का उपयोग कई तरीकों से किया जाता है, जैसे स्वचालित रूप से प्रश्नों का उत्तर देना, टेक्स्ट का सार तैयार करना, एक भाषा से दूसरी भाषा में अनुवाद करना, आदि। NLP पर शोध संज्ञानात्मक विज्ञान, भाषाविज्ञान और मनोविज्ञान जैसे क्षेत्रों में भी किया जाता है। टेक्स्ट क्लासीफिकेशन NLP का ऐसा ही एक उपयोग मामला है।
यह ब्लॉग टेक्स्ट क्लासीफिकेशन के उपयोग मामलों का अन्वेषण करेगा। इसमें Python में टेक्स्ट प्रीप्रोसेसिंग पाइपलाइन बनाने और उसके बाद टेक्स्ट क्लासीफिकेशन मॉडल तैयार करने का एक एंड-टू-एंड उदाहरण भी शामिल है।
यदि आप नेचुरल लैंग्वेज प्रोसेसिंग के बारे में और सीखना चाहते हैं, तो हमारे Natural Language Processing in Python और Natural Language Processing in R ट्रैक्स उपयोगी हैं। आप वह मुख्य NLP कौशल सीखेंगे जो टेक्स्ट डेटा को मूल्यवान इनसाइट्स में बदलने के लिए आवश्यक हैं। आपको लोकप्रिय NLP Python लाइब्रेरीज़ से भी परिचित कराया जाएगा, जिनमें NLTK, scikit-learn, spaCy, और SpeechRecognition शामिल हैं।