

正则化
在训练模型时,通常会遇到两个主要问题:过拟合与欠拟合。
- 过拟合是指模型在训练集上表现良好,但在未见过的(测试)数据上表现不佳。
- 欠拟合是指模型在训练集和测试集上都表现不佳。
正则化的目的特别在于避免数据过拟合,尤其是在训练集与测试集性能差异较大时。通过正则化,训练中使用的特征数量保持不变,但等式 1.1 中系数(w)的幅度会被缩小。
考虑下面用于预测房价的系数图。虽然预测变量有不少,但 RM 和 RAD 的系数最大。这意味着房价将更主要地受这两个特征驱动,可能导致过拟合,即未能学到可泛化的模式。
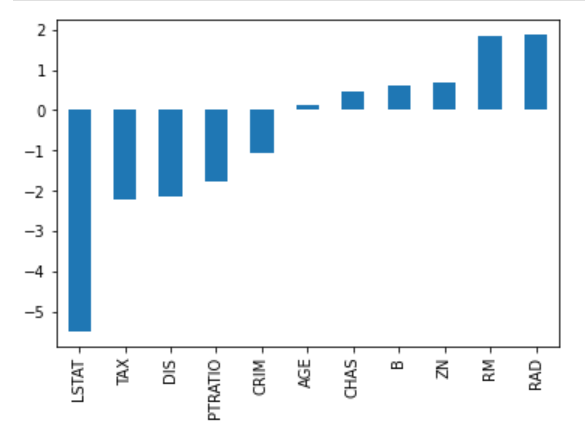
在降低线性模型复杂度、避免过拟合方面有不同方法,其中包括 ridge 和 lasso 回归模型。
Lasso 回归简介
这是一种基于收缩(Shrinkage)的方法进行特征选择的正则化技术,也称为惩罚回归方法。Lasso 是 Least Absolute Shrinkage and Selection Operator 的缩写,同时用于正则化与模型选择。若模型使用L1 正则化技术,则称为 lasso 回归。
用于正则化的 Lasso 回归
在这种收缩技术中,通过引入称为 alpha α(有时写作 lambda)的惩罚因子,将上面等式 1.1 线性模型中确定的系数朝中心点(均值)收缩。
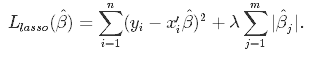
Alpha(α)是惩罚项,表示将在方程中实施的收缩(或约束)程度。当 alpha 为零时,与等式 1.2 的线性回归模型等价;而更大的值会对优化函数施加更强惩罚。因此,lasso 回归会收缩系数,帮助降低模型复杂度与多重共线性。
Alpha(α)可以是零到无穷之间的任意实数;值越大,惩罚越强。
用于模型选择的 Lasso 回归
由于系数会向均值零收缩,被惩罚时,数据集中不太重要的特征会被消除。基于给定 alpha 值对系数进行收缩会产生某种自动特征选择的效果,即有效地移除部分输入变量。
Ridge 回归
与 lasso 回归相似,ridge 回归通过引入惩罚因子对系数施加约束。但不同的是,lasso 以系数的绝对值为惩罚,而 ridge 以系数的平方为惩罚。
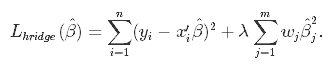
Ridge 回归也称为L2 正则化。
为何 Lasso 可用于模型选择而 Ridge 回归通常不可
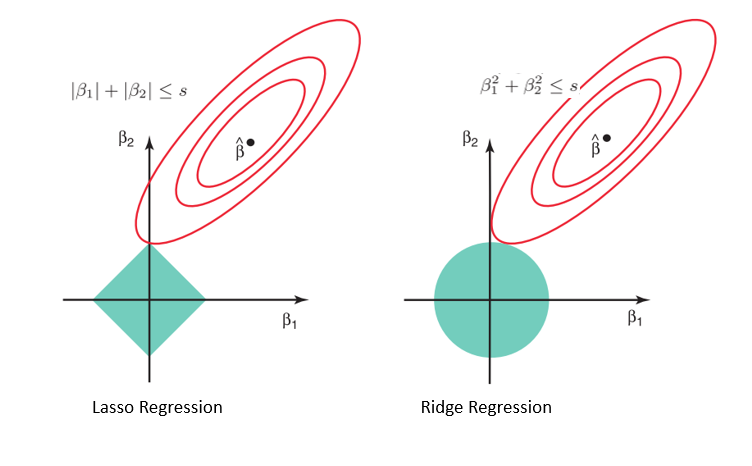
从 lasso(左)与 ridge(右)模型的几何图形来看,椭圆等高线(红色圆环)表示各自的代价函数。放松惩罚因子带来的约束,会扩大受限区域(菱形、圆形)。不断放松时,两者都会到达椭圆中心处,此时 lasso 与 ridge 的结果都与线性回归模型相似。
然而,这两种方法都是在椭圆等高线首次触及约束区域的地方来确定系数。由于 lasso 的受限区域在图中呈菱形,每当等高线与这些角落相交时,至少有一个系数会变为零。对于 ridge 回归而言,这是不可能的,因为其受限区域呈圆形,值可以被收缩到接近零,但永远不会等于零。
Python 实现
在实现中,我们将使用 Sklearn 中的波士顿房价数据集。我们希望了解:
- 如何在Python中执行 ridge 与 lasso 回归
- 将结果与线性回归模型进行比较
数据导入与探索性分析(EDA)
#libraries
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.linear_model import Ridge, RidgeCV, Lasso
from sklearn.preprocessing import StandardScaler
from sklearn.datasets import load_boston
#data
boston = load_boston()
boston_df=pd.DataFrame(boston.data,columns=boston.feature_names)
#target variable
boston_df['Price']=boston.target
#preview
boston_df.head()
#Exploration
plt.figure(figsize = (10, 10))
sns.heatmap(boston_df.corr(), annot = True)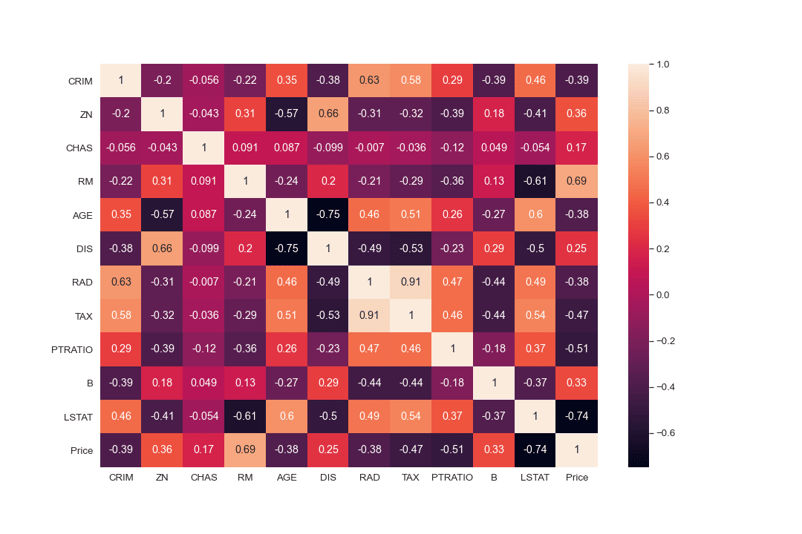
#There are cases of multicolinearity, we will drop a few columns
boston_df.drop(columns = ["INDUS", "NOX"], inplace = True)
#pairplot
sns.pairplot(boston_df)
#we will log the LSTAT Column
boston_df.LSTAT = np.log(boston_df.LSTAT)
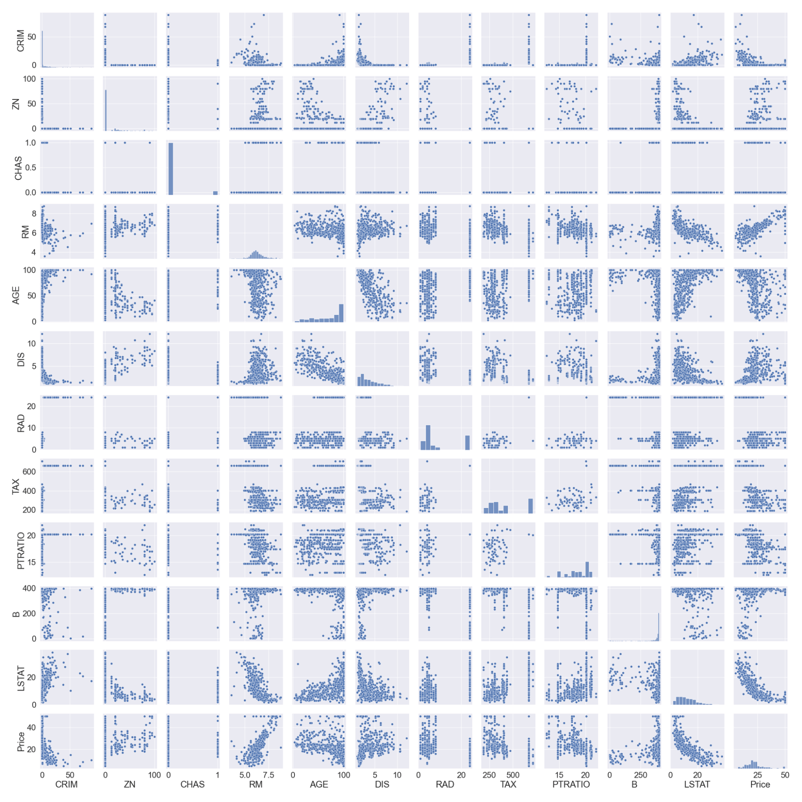
请注意,我们对 LSTAT 列取了对数,因为它与价格列不呈线性关系。线性模型假设 x 与 y 变量之间存在线性关系。
数据划分与缩放
#preview
features = boston_df.columns[0:11]
target = boston_df.columns[-1]
#X and y values
X = boston_df[features].values
y = boston_df[target].values
#splot
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=17)
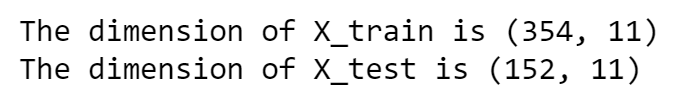
print("The dimension of X_train is {}".format(X_train.shape))
print("The dimension of X_test is {}".format(X_test.shape))
#Scale features
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)
输出:
线性与 Ridge 回归模型
我们将构建线性与 ridge 回归模型,并在图中比较系数。训练集与测试集的得分也将帮助我们评估模型表现。
#Model
lr = LinearRegression()
#Fit model
lr.fit(X_train, y_train)
#predict
#prediction = lr.predict(X_test)
#actual
actual = y_test
train_score_lr = lr.score(X_train, y_train)
test_score_lr = lr.score(X_test, y_test)
print("The train score for lr model is {}".format(train_score_lr))
print("The test score for lr model is {}".format(test_score_lr))
#Ridge Regression Model
ridgeReg = Ridge(alpha=10)
ridgeReg.fit(X_train,y_train)
#train and test scorefor ridge regression
train_score_ridge = ridgeReg.score(X_train, y_train)
test_score_ridge = ridgeReg.score(X_test, y_test)
print("\nRidge Model............................................\n")
print("The train score for ridge model is {}".format(train_score_ridge))
print("The test score for ridge model is {}".format(test_score_ridge))
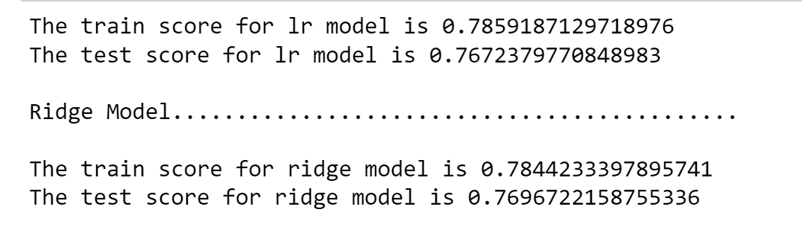
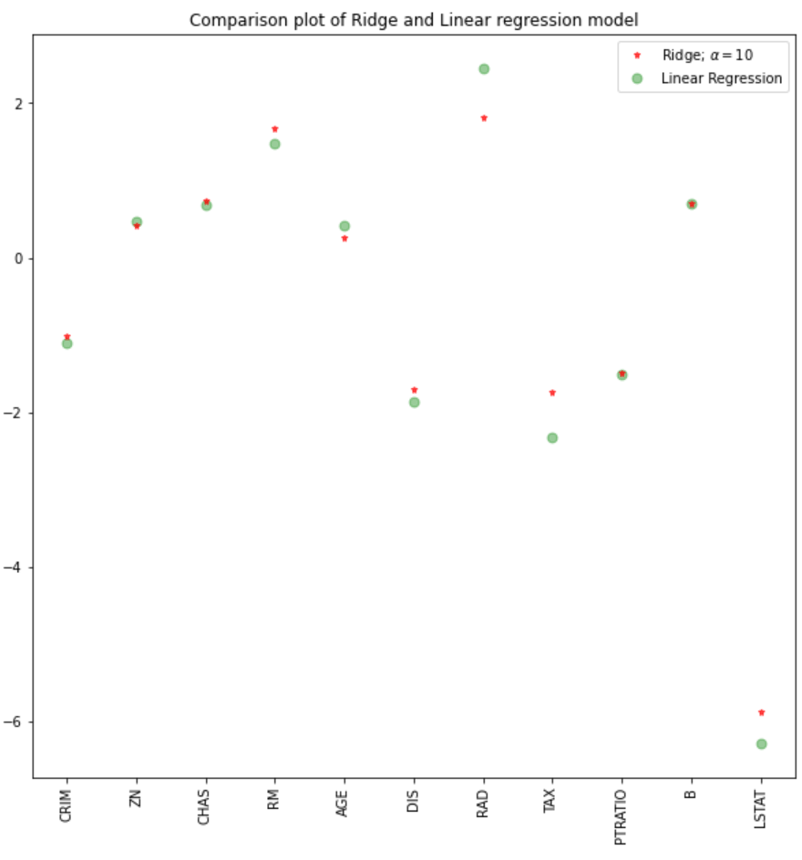
当 alpha 取 10 时,对模型、训练数据与测试数据的评估表明,ridge 模型的表现优于线性回归模型。
我们也可以绘制线性与 ridge 模型的系数。
plt.figure(figsize = (10, 10))
plt.plot(features,ridgeReg.coef_,alpha=0.7,linestyle='none',marker='*',markersize=5,color='red',label=r'Ridge; $\alpha = 10$',zorder=7)
#plt.plot(rr100.coef_,alpha=0.5,linestyle='none',marker='d',markersize=6,color='blue',label=r'Ridge; $\alpha = 100$')
plt.plot(features,lr.coef_,alpha=0.4,linestyle='none',marker='o',markersize=7,color='green',label='Linear Regression')
plt.xticks(rotation = 90)
plt.legend()
plt.show()
Lasso 回归
#Lasso regression model
print("\nLasso Model............................................\n")
lasso = Lasso(alpha = 10)
lasso.fit(X_train,y_train)
train_score_ls =lasso.score(X_train,y_train)
test_score_ls =lasso.score(X_test,y_test)
print("The train score for ls model is {}".format(train_score_ls))
print("The test score for ls model is {}".format(test_score_ls))
我们也可以可视化系数。
pd.Series(lasso.coef_, features).sort_values(ascending = True).plot(kind = "bar")
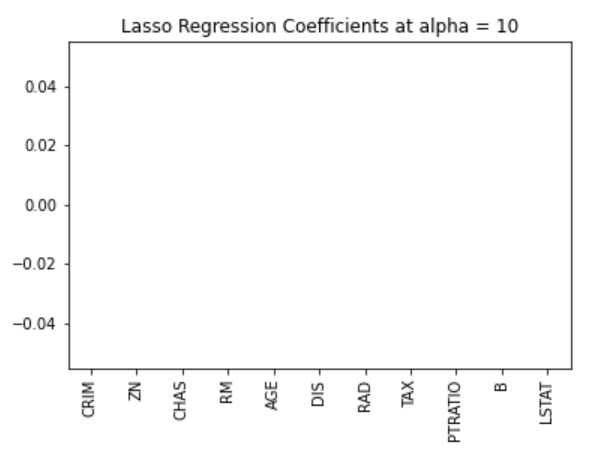
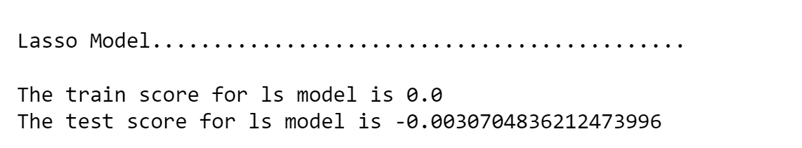
前文我们提到,由于约束区域呈菱形,lasso 模型的系数可收缩为零。在本例中,alpha 取 10 会对模型施加过强惩罚,导致所有系数都被收缩为零。通过上图对模型系数的可视化可以清楚看到这一点。
在 Sklearn 中使用交叉验证选择最优 Alpha 值
我们可能需要尝试不同的 alpha 值以找到最优的约束强度。对此,可以使用sklearn 包中的交叉验证模型。它会尝试不同的 alpha 组合,并选择最佳模型。
#Using the linear CV model
from sklearn.linear_model import LassoCV
#Lasso Cross validation
lasso_cv = LassoCV(alphas = [0.0001, 0.001,0.01, 0.1, 1, 10], random_state=0).fit(X_train, y_train)
#score
print(lasso_cv.score(X_train, y_train))
print(lasso_cv.score(X_test, y_test))
输出:
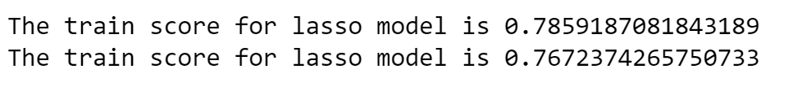
模型会在我在 LassoCV 函数中指定的不同 alpha 值上进行训练。我们可以观察到模型表现更好,同时免去了手动反复调整 alpha 的繁琐工作。
我们可以将 lasso 模型的系数与其余模型(线性与 ridge)的系数进行比较。
#plot size
plt.figure(figsize = (10, 10))
#add plot for ridge regression
plt.plot(features,ridgeReg.coef_,alpha=0.7,linestyle='none',marker='*',markersize=5,color='red',label=r'Ridge; $\alpha = 10$',zorder=7)
#add plot for lasso regression
plt.plot(lasso_cv.coef_,alpha=0.5,linestyle='none',marker='d',markersize=6,color='blue',label=r'lasso; $\alpha = grid$')
#add plot for linear model
plt.plot(features,lr.coef_,alpha=0.4,linestyle='none',marker='o',markersize=7,color='green',label='Linear Regression')
#rotate axis
plt.xticks(rotation = 90)
plt.legend()
plt.title("Comparison plot of Ridge, Lasso and Linear regression model")
plt.show()
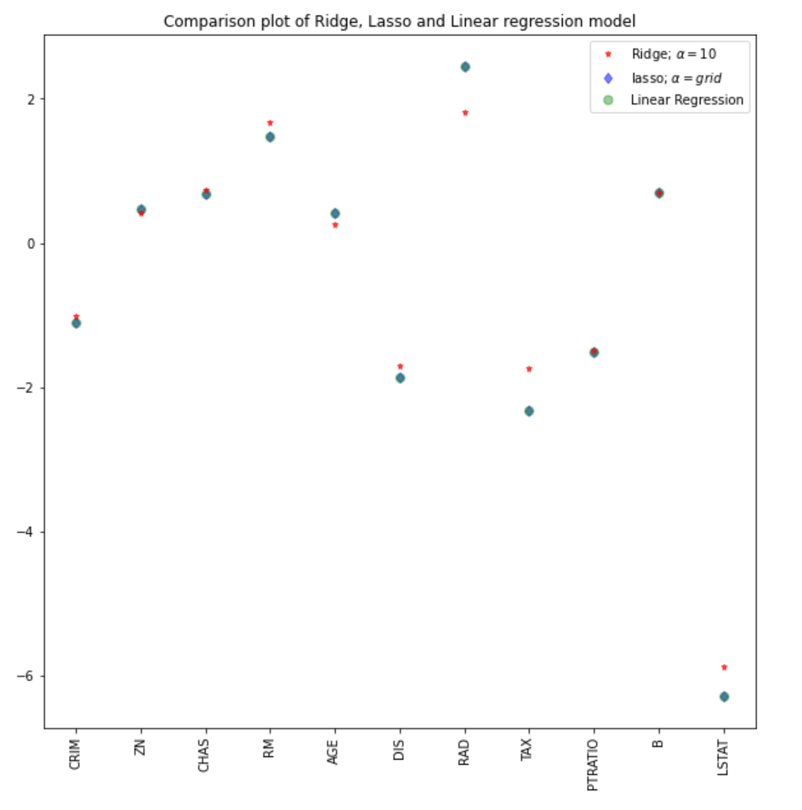
注意:对 ridge 回归也可以采用类似的方法,可能得到更好的结果。在 sklearn 包中,RidgeCV 函数具有类似功能。
#Using the linear CV model from sklearn.linear_model import RidgeCV #Lasso Cross validation ridge_cv = RidgeCV(alphas = [0.0001, 0.001,0.01, 0.1, 1, 10]).fit(X_train, y_train) #score print("The train score for ridge model is {}".format(ridge_cv.score(X_train, y_train))) print("The train score for ridge model is {}".format(ridge_cv.score(X_test, y_test)))
通过我们的Python 逻辑回归和Python 线性回归教程,进一步了解其他类型的回归方法。
结论
我们展示了 ridge 与 lasso 回归模型的实现,以及这些技术背后的理论与数学概念。本教程的要点包括:
- ridge 与 lasso 回归的代价函数相似,但 ridge 使用系数的平方,lasso 使用系数的绝对值。
- lasso 回归可用于自动特征选择,因为其受限区域的几何特性允许系数收缩为零。
- 当 ridge 或 lasso 的 alpha 取零时,结果与回归模型相似。
- alpha 值越大,惩罚越强。
您可以在这里找到更健壮完整的 Python 实现笔记本,或通过我们的Python 回归入门课程深入学习回归。
线性模型简介
通过这个动手练习在 Python 中实践 Lasso 和 Ridge 回归。
线性回归是一类线性模型,被认为是最基础且最常用的预测算法。这与其简单而高效的结构密不可分。线性模型假设输入变量 x 与输出变量 y 之间存在线性关系。线性模型的方程如下所示:
在等式 1.1 中,我们展示了具有 n 个特征的线性模型。w 被视为分配给每个特征的系数(或权重)——用于指示其对结果 y 的重要性。例如,我们假设温度对冰淇淋销量的影响大于是否为公共假日。那么在我们的线性模型中,分配给温度的权重将大于公共假日变量。
因此,线性模型的目标变为通过等式 1.2 中的代价函数来优化权重(b)。代价函数计算预测值与真实值之间的误差,并以一个实数表示。代价函数是数据集中 n 个样本的平均误差,如下所示:
在上面的等式中,yi 为真实值, 为我们线性方程的预测值,其中 M 为行数,P 为特征数。